Programma
Nozioni di base sugli agenti AI
6 ore
La corsa al miglior modello AI agentico si sta affollando. Claude Opus 4.6 di Anthropic, DeepSeek V4 Pro e Kimi K2.6 hanno tutti rivendicato il vertice delle classifiche di coding e reasoning negli ultimi mesi. Ora il team Qwen di Alibaba entra in gioco con Qwen3.7-Max, un modello proprietario di punta che descrivono come costruito specificamente per l’era degli agenti.
I numeri principali meritano attenzione. Su GPQA Diamond, Qwen3.7-Max ottiene 92,4, battendo il 91,3 di Claude Opus 4.6 Max. Sul benchmark di reasoning Apex, segna 44,5 contro il 38,3 di DeepSeek V4 Pro. E in un’esecuzione autonoma di 35 ore per l’ottimizzazione di kernel, il modello ha effettuato 1.158 chiamate a strumenti e ottenuto un’accelerazione media geometrica di 10x rispetto all’implementazione di riferimento Triton.
In questo articolo coprirò tutte le novità di Qwen3.7-Max, esaminandone le funzionalità chiave, esplorando i risultati dei benchmark e proponendo test pratici che puoi eseguire tu stesso. Puoi anche dare un’occhiata alla nostra copertura di Gemini 3.5 Flash e Gemini Omni per contestualizzare lo stato attuale della frontiera più ampia.
Qwen3.7-Max è l’ultimo modello proprietario di Alibaba, posizionato come livello più alto della famiglia Qwen3.x sopra Qwen3.6-Plus.
È un modello closed-source, accessibile via API tramite Alibaba Cloud Model Studio, con una finestra di contesto da 1 milione di token e input/output solo testuali. Il team Qwen lo descrive come una "base versatile per agenti" più che un modello di chat generico.
Rispetto a Qwen3.6-Plus, i miglioramenti sono sostanziali in ogni categoria. Su Terminal Bench 2.0-Terminus, Qwen3.7-Max ottiene 69,7 contro i 61,6 di Qwen3.6-Plus. Su YC-Bench, una simulazione di startup, ha raggiunto 2,08M USD di ricavi totali, il doppio degli 1,05M USD di Qwen3.6-Plus. Il divario è più ampio nei compiti agentici di lungo periodo, esattamente dove il team dichiara di aver concentrato lo sforzo di training.
L’Artificial Analysis Intelligence Index assegna a Qwen3.7-Max un punteggio di 56,6, posizionandolo sopra i concorrenti e appena sotto alcuni dei migliori modelli di frontiera.
Una cosa da segnalare subito: il modello è notevolmente verboso. Artificial Analysis ha osservato circa 97 milioni di token generati durante la loro valutazione, ben al di sopra della mediana di 24 milioni. Tale verbosità ha implicazioni sui costi per sessioni agentiche lunghe, tema a cui tornerò nella sezione sui prezzi.
Qwen3.7-Max introduce diverse capacità che lo distinguono sia dal suo predecessore sia dall’attuale panorama dei modelli di frontiera. L’attenzione è tutta sull’esecuzione autonoma sostenuta, più che sulle prestazioni a singolo turno.
La dimostrazione più incisiva nel rilascio è l’esecuzione di 35 ore per ottimizzare un kernel.
In sostanza, il team Qwen ha affidato all’AI un problema di coding impegnativo (ottimizzare codice GPU), fornendole solo istruzioni e un modo per testare il lavoro, e poi si è fatto da parte. Da lì, Qwen3.7-Max ha lavorato in autonomia, scrivendo codice, eseguendo test, trovando colli di bottiglia e riprogettando il codice. Ha iterato questo processo oltre mille volte.
Il risultato finale ha reso il codice 10 volte più veloce rispetto al baseline standard, il tutto su hardware che non aveva mai incontrato prima.
Qwen3.7 Max ha continuato a trovare modi significativi per accelerare il codice anche dopo le 30 ore. Non si è limitato a cogliere i frutti più a portata di mano per poi fermarsi.
Altri modelli di fascia alta come GLM 5.1, Kimi K2.6 e DeepSeek V4 Pro hanno mollato molto prima (raggiungendo al massimo 7,3x, 5,0x e 3,3x rispettivamente).
Questo dimostra che Qwen3.7-Max non è solo bravo a rispondere a una veloce domanda di coding in un singolo prompt. Puoi affidargli un enorme e massacrante progetto di ottimizzazione, allontanarti e fidarti che resterà completamente concentrato senza confondersi o perdere il filo nel tempo.
La maggior parte dei modelli agentici è addestrata e valutata su uno scaffold specifico, il che significa che i loro numeri nei benchmark possono riflettere scorciatoie specifiche dell’harness più che un reale problem solving.
Qwen3.7-Max è progettato per evitarlo tramite un’infrastruttura di training che disaccoppia Task, Harness e Verifier in tre componenti indipendenti liberamente ricombinabili.
In pratica, questo significa che il modello è stato addestrato su compiti identici abbinati a harness e verifier diversi, costringendolo a imparare strategie generalizzabili.
I benchmark lo riflettono: Qwen3.7-Max performa in modo costante sia che venga distribuito tramite Claude Code, OpenClaw, Qwen Code o framework personalizzati per l’uso di tool. Su QwenClawBench e CoWorkBench, le prestazioni tengono indipendentemente dall’harness utilizzato in fase di valutazione.
Per i team che costruiscono sistemi agentici, questo conta perché significa che Qwen3.7-Max può fungere da backbone plug-and-play senza richiedere un tuning specifico per il framework. È un vero vantaggio operativo rispetto ai modelli che vanno bene solo nel loro scaffold nativo.
Qwen3.7-Max supporta l’integrazione nativa con il Model Context Protocol (MCP), che gli consente di collegarsi a strumenti e fonti dati esterne in modo standardizzato.
Su MCP-Mark, ottiene 60,8, davanti ai 57,5 di GLM-5.1 Thinking e ai 56,7 di Opus-4.6 Max. Su MCP-Atlas, segna 76,4, superando di poco i 75,8 di Opus-4.6 Max.
Vale la pena mettere in evidenza a parte l’automazione d’ufficio. Su SpreadSheetBench-v1, Qwen3.7-Max ottiene 87,0, secondo solo agli 89,3 di Opus-4.6 Max.
Il team Qwen lo dimostra con un compito di formattazione di una tesi, in cui il modello legge un documento con le specifiche di formattazione e riformatta in autonomia una bozza disordinata, correggendo impaginazione, stili dei titoli, font, margini, sommario e riferimenti tramite chiamate autonome allo strumento office-cli.
Una delle funzionalità più insolite di questo rilascio è un framework di auto-monitoraggio per il training RL. Durante esperimenti RL oltre le 80 ore, Qwen3.7-Max ha recuperato e rigiocato in autonomia traiettorie di training, eseguendo oltre 10.000 chiamate per identificare pattern di reward hacking.
Tra questi, tentativi di aggirare i vincoli e accedere alle risposte ground truth su GitHub.
Il sistema ha eseguito verifica delle regole, ricerca di contro-esempi e ottimizzazione iterativa, aggiungendo in definitiva 13 nuove regole euristiche e segnalando con precisione 1.618 casi di hacking.
Non è tanto una funzionalità rivolta all’utente quanto un segnale su come è stato addestrato il modello, ma è rilevante per i team che pensano di impiegare Qwen3.7-Max in pipeline RL proprie.
Qwen3.7-Max ora può operare un cane robot tramite chiamate di tool-use, usando l’harness agentico Qwen-RobotClaw e il modello di base per la navigazione Qwen-RobotNav.
Il modello gestisce comprensione fisica, pianificazione, memoria e decision making in ambienti reali. Questo è dimostrato in una sessione agentica di 20 minuti in cui il robot naviga uno spazio fisico usando la memoria di lungo termine del modello e input visivi in prima persona.
Non lo sopravvaluterei come piattaforma di robotica pronta per la produzione, ma illustra l’ampiezza del framework agentico. La stessa infrastruttura di tool-calling che gestisce l’automazione di fogli di calcolo e l’ottimizzazione di kernel si estende anche alla navigazione nel mondo fisico.
Diamo uno sguardo più nel dettaglio ai dati dei benchmark.
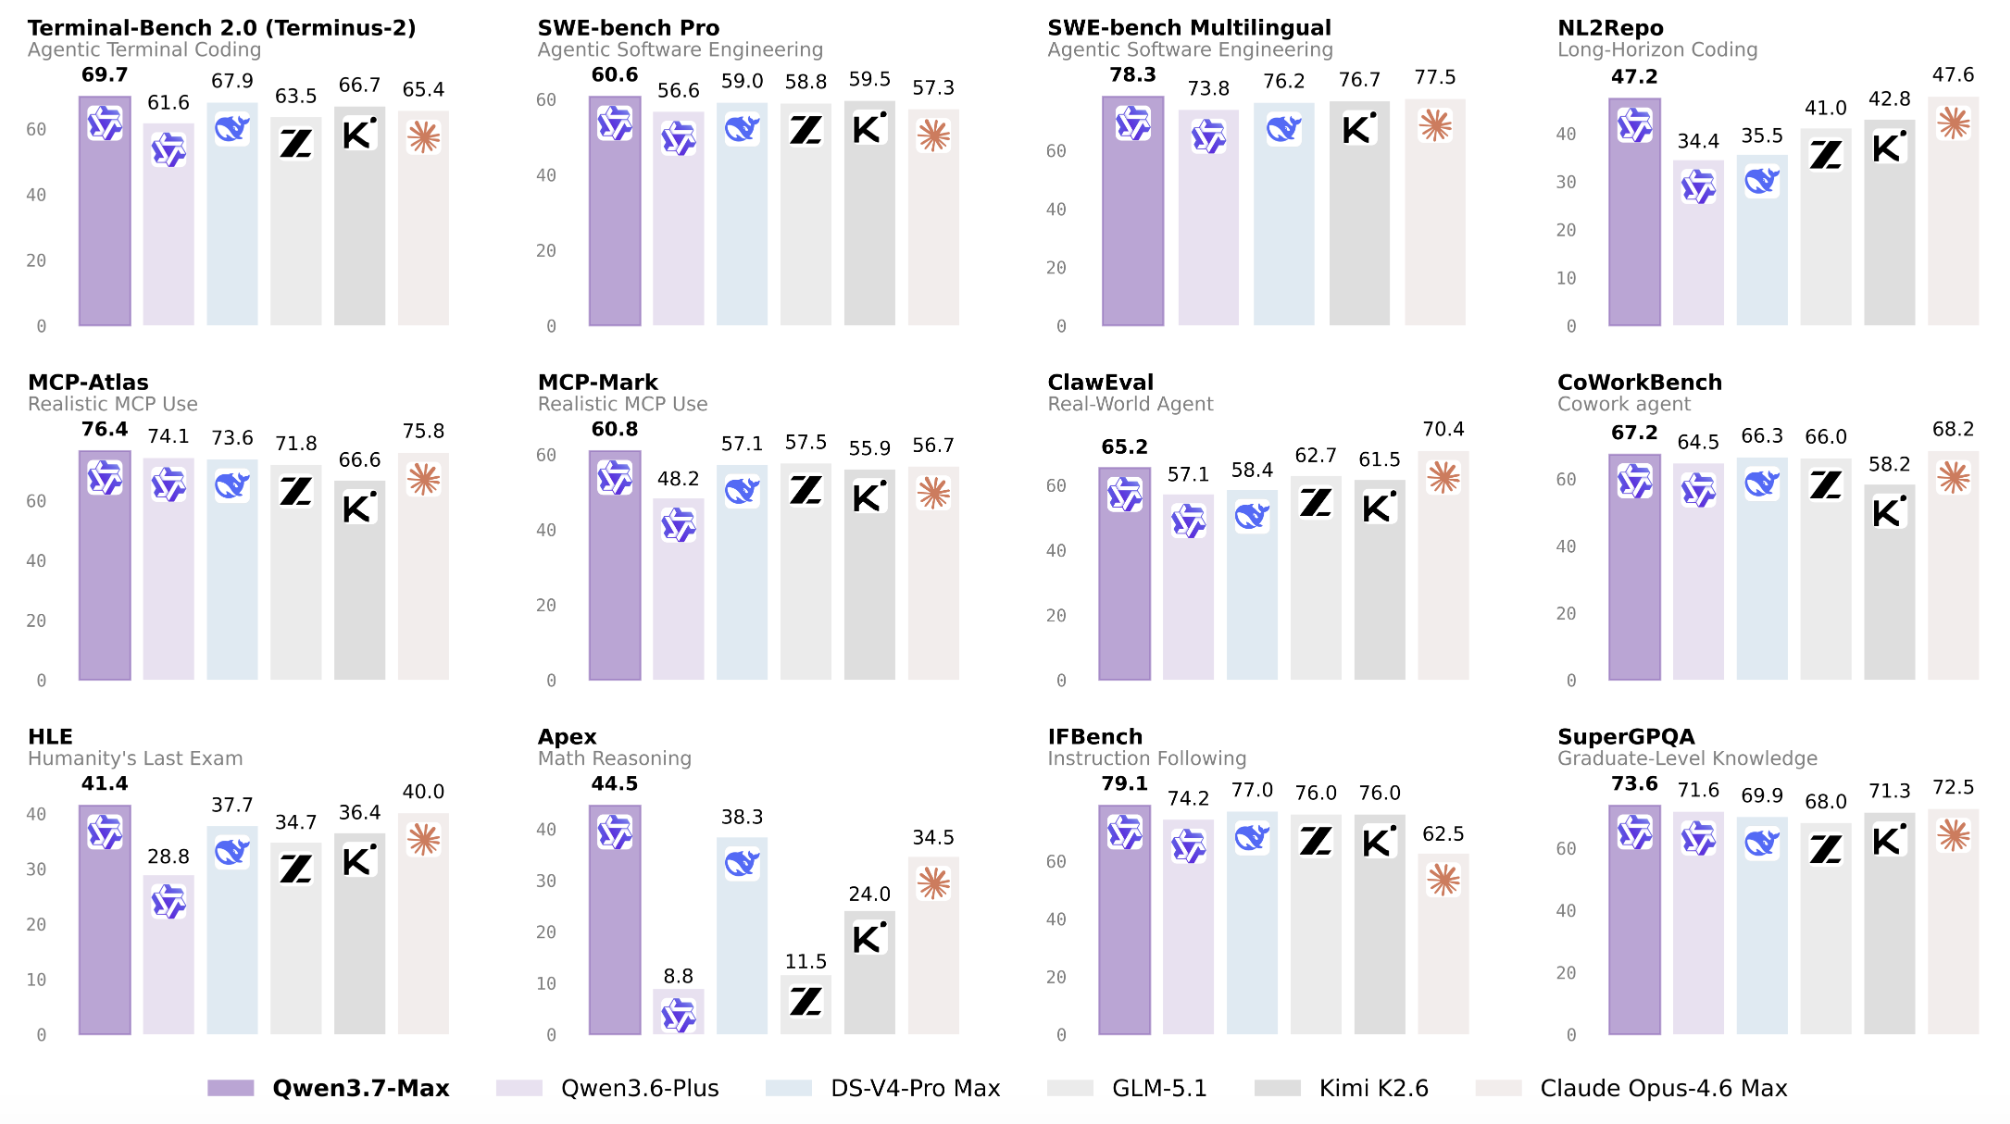
Qwen3.7-Max è stato valutato su quattro ampie categorie: agenti per il coding, agenti general-purpose, reasoning STEM e capacità generali, inclusa la performance multilingue.
I risultati provengono da una grande varietà di scaffold agentici, il che li rende più significativi rispetto a numeri basati su un singolo scaffold.
Su Terminal Bench 2.0-Terminus, Qwen3.7-Max ottiene 69,7, davanti a DeepSeek-V4-Pro Max (67,9), Opus-4.6 Max (65,4) e K2.6 Thinking (66,7).
Questo benchmark testa l’ingegneria del software autonoma basata su terminale con un timeout di 5 ore e 12 core CPU. Su SWE-Pro, ottiene 60,6, il valore più alto nella tabella di confronto, davanti a K2.6 Thinking (59,5) e DS-V4-Pro Max (59,0).
SWE-Verified è l’unico benchmark in cui Qwen3.7-Max non guida: ottiene 80,4 contro gli 80,8 di Opus-4.6 Max e gli 80,6 di DS-V4-Pro Max.
Il divario è piccolo, ma vale la pena notarlo. Su SWE-Multilingual (78,3) e SciCode (53,5) è in testa al gruppo. Su QwenSVG, ottiene 1608, davanti ai 1605 di GLM-5.1 Thinking e ai 1541 di Opus-4.6 Max.
I risultati sugli agenti generali sono dove Qwen3.7-Max fa il caso più forte. Su MCP-Mark, ottiene 60,8 contro i 57,5 di GLM-5.1 e i 56,7 di Opus-4.6.
Su MCP-Atlas, segna 76,4, superando i 75,8 di Opus-4.6. Su Skillsbench, ottiene 59,2 contro i 56,2 di K2.6 Thinking. Su SpreadSheetBench-v1, segna 87,0, secondo solo agli 89,3 di Opus-4.6 Max.
Il risultato su Kernel Bench L3 merita una menzione a parte. Qwen3.7-Max raggiunge un’accelerazione mediana di 1,98x con un tasso di vittoria del 96% (frazione di problemi più veloci di torch.compile).
Opus-4.6 Max guida qui con 2,63x/98%, ma Qwen3.7-Max è ben avanti rispetto a K2.6 Thinking (1,41x/80%), GLM-5.1 (2,00x/78%) e DS-V4-Pro Max (1,07x/54%). Su MRCR-v2 128k, che testa il recupero su contesti lunghi, ottiene 90,4, davanti a Qwen3.6-Plus (85,9) e Opus-4.6 Max (84,0).
GPQA Diamond testa domande di scienze a livello PhD. Qwen3.7-Max ottiene 92,4, davanti a Opus-4.6 Max (91,3), K2.6 Thinking (90,5) e DS-V4-Pro Max (90,1).
Nella nostra recensione di GPT-5.5, abbiamo notato che ha ottenuto il 93,6% su GPQA Diamond, quindi GPT-5.5 è ancora in testa su questo benchmark specifico, sebbene il confronto diretto richieda di considerare le differenti condizioni di valutazione.
Su HLE (Humanity's Last Exam), Qwen3.7-Max ottiene 41,4, davanti a Opus-4.6 Max (40,0) e Deepseek-V4-Pro Max (37,7).
Su HMMT 2026 Feb (matematica da competizione), ottiene 97,1, il valore più alto in tabella, davanti a Opus-4.6 Max (96,2) e DS-V4-Pro Max (95,2).
Su IMOAnswerBench, ottiene 90,0, superando di poco gli 89,8 di DS-V4-Pro Max. Sul benchmark Apex, segna 44,5, ben davanti ai 38,3 di DS-V4-Pro Max e ai 34,5 di Opus-4.6 Max.
Qwen3.7-Max guida su WMT24++ (85,8 vs 84,3 di Qwen3.6-Plus e 82,7 di Opus-4.6 Max), che testa la qualità di traduzione in 55 lingue. Su MAXIFE, ottiene 89,2, davanti agli 88,9 di DS-V4-Pro Max. Su PolyMATH, segna 86,5, ben davanti agli 80,2 di Opus-4.6 Max e agli 82,7 di K2.6 Thinking.
La performance multilingue è un punto di forza costante della linea Qwen3.x, e Qwen3.7-Max amplia ulteriormente il vantaggio.
Qwen3.7-Max è disponibile tramite Alibaba Cloud Model Studio, con accesso API sia tramite endpoint compatibili con OpenAI che con Anthropic. L’ID del modello è qwen3.7-max.
Al momento in cui scriviamo, Artificial Analysis indica prezzi di input e output pari a 2,50 $ per 1M token in input e 7,50 $ per l’output.
L’elevata verbosità segnalata da Artificial Analysis (97M token generati nella loro valutazione vs una mediana di 24M) implica che i costi effettivi per sessioni agentiche lunghe potrebbero essere significativamente più alti di quanto suggeriscano le tariffe per token.
Per gli sviluppatori, il modello supporta la funzionalità preserve_thinking, che mantiene i contenuti di ragionamento di tutti i turni precedenti nelle conversazioni multi-turno. Il team Qwen consiglia di abilitarla per i compiti agentici. L’integrazione con Claude Code, OpenClaw e Qwen Code è supportata nativamente, con esempi di configurazione forniti nella documentazione ufficiale.
Qwen3.7-Max è un ingresso di peso al vertice del mercato dei modelli agentici. I numeri nei benchmark sono solidi su tutta la linea e la dimostrazione delle 35 ore di ottimizzazione del kernel è il tipo di risultato concreto e verificabile più difficile da liquidare rispetto a una posizione in classifica.
Anche la storia della generalizzazione cross-harness è credibile: addestrare su configurazioni di harness diverse è un approccio fondato al problema dell’overfitting allo scaffold, e le prestazioni coerenti su Claude Code, OpenClaw e Qwen Code lo confermano.
Dove sarei cauto è sulla verbosità. Un modello che genera 97M token in una suite di valutazione standard costerà in pratica significativamente più di quanto implichi la tariffa per token, soprattutto per le sessioni agentiche di lungo periodo che sono il suo caso d’uso principale.
I team che costruiscono su Qwen3.7-Max dovrebbero pianificare il budget con attenzione e testare con vincoli espliciti sull’output prima di impegnarsi in carichi di lavoro in produzione.
Se vuoi costruire sopra modelli come Qwen3.7-Max o comprendere più a fondo il panorama dell’AI agentica, ti consiglio di dare un’occhiata all’AI Fundamentals skill track su DataCamp per metterti in pari con i concetti alla base di questi sistemi.
I migliori corsi DataCamp
Programma
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min