
Lernpfad
KI-Agent-Grundlagen
6 Std.
Das Rennen um das beste agentische KI-Modell wird immer enger. Anthropics Claude Opus 4.6, DeepSeek V4 Pro und Kimi K2.6 haben sich in den letzten Monaten an die Spitze der Coding- und Reasoning-Ranglisten gesetzt. Jetzt steigt Alibabas Qwen-Team mit Qwen3.7-Max ein – einem proprietären Flaggschiffmodell, das ausdrücklich für das Agentenzeitalter entwickelt wurde.
Die Topwerte sind bemerkenswert. Auf GPQA Diamond erzielt Qwen3.7-Max 92,4 und übertrifft damit Claude Opus 4.6 Max mit 91,3. Im Apex-Reasoning-Benchmark kommt es auf 44,5 gegenüber 38,3 bei DeepSeek V4 Pro. Und in einem 35-stündigen autonomen Kernel-Optimierungslauf tätigte das Modell 1.158 Toolaufrufe und erreichte eine 10-fache geometrische mittlere Beschleunigung gegenüber der Triton-Referenzimplementierung.
In diesem Artikel zeige ich alles Neue rund um Qwen3.7-Max: die wichtigsten Funktionen, die Benchmark-Ergebnisse und Vorschläge für Hands-on-Tests, die du selbst durchführen kannst. Lies auch unsere Berichte zu Gemini 3.5 Flash und Gemini Omni, um die aktuelle Einordnung im weiteren Umfeld zu verstehen.
Qwen3.7-Max ist Alibabas neuestes proprietäres Modell und die Spitzenausführung der Qwen3.x-Familie oberhalb von Qwen3.6-Plus.
Es ist ein Closed-Source-Modell mit API-Zugang über Alibaba Cloud Model Studio, bietet ein Kontextfenster von 1 Million Tokens und unterstützt Ein- und Ausgabe von Text. Das Qwen-Team beschreibt es eher als „vielseitiges Agentenfundament“ denn als allgemeines Chat-Modell.
Gegenüber Qwen3.6-Plus sind die Fortschritte in allen Kategorien deutlich. Auf Terminal Bench 2.0-Terminus erzielt Qwen3.7-Max 69,7 gegenüber 61,6 bei Qwen3.6-Plus. In der YC-Bench-Startup-Simulation erreichte es 2,08 Mio. USD Umsatz insgesamt – doppelt so viel wie die 1,05 Mio. USD von Qwen3.6-Plus. Am größten ist der Abstand bei langlaufenden agentischen Aufgaben – genau dort, wo das Team den Trainingsfokus gelegt hat.
Der Artificial Analysis Intelligence Index vergibt 56,6 Punkte für Qwen3.7-Max und platziert es damit über der Konkurrenz und knapp hinter einigen der besten Frontier-Modelle.
Ein früher Hinweis ist wichtig: Das Modell ist auffällig wortreich. Artificial Analysis beobachtete rund 97 Millionen generierte Tokens während der Bewertung – deutlich über dem Median von 24 Millionen. Diese Ausführlichkeit hat Kostenauswirkungen für lange agentische Sessions, auf die ich im Preisteil nochmals eingehe.
Qwen3.7-Max bringt mehrere Fähigkeiten mit, die es sowohl vom Vorgänger als auch von anderen Frontier-Modellen abheben. Der Fokus liegt durchgängig auf längerfristiger, autonomer Ausführung statt auf Single-Turn-Performance.
Die eindrucksvollste Demonstration im Release ist der 35-stündige Kernel-Optimierungslauf.
Im Kern gab das Qwen-Team der KI ein schwieriges Coding-Problem (Optimierung von GPU-Code), nur mit Anweisungen und einer Testumgebung – und trat dann zurück. Von dort arbeitete Qwen3.7-Max autonom: Code schreiben, Tests ausführen, Engpässe finden und den Code neu gestalten. Diesen Zyklus durchlief es über tausend Mal.
Das Endergebnis beschleunigte den Code auf das 10-Fache des Standard-Baselines, erstellt auf Hardware, die dem Modell zuvor unbekannt war.
Qwen3.7-Max fand selbst nach der 30-Stunden-Marke noch spürbare Optimierungen. Es hat nicht nur die „Low-Hanging Fruits“ gepflückt und aufgehört.
Andere Topmodelle wie GLM 5.1, Kimi K2.6 und DeepSeek V4 Pro gaben deutlich früher auf (mit maximal 7,3x, 5,0x bzw. 3,3x Beschleunigung).
Das zeigt: Qwen3.7-Max ist nicht nur gut darin, eine schnelle Coding-Frage in einem einzelnen Prompt zu beantworten. Du kannst ihm ein großes, zähes Optimierungsprojekt übergeben, weggehen und dich darauf verlassen, dass es über lange Zeit konzentriert bleibt, ohne den Faden zu verlieren.
Die meisten Agentenmodelle werden auf einem spezifischen Scaffold trainiert und evaluiert. Dadurch können Benchmarks harness-spezifische Abkürzungen widerspiegeln – statt echter Problemlösung.
Qwen3.7-Max soll das vermeiden: Die Trainingsinfrastruktur entkoppelt Task, Harness und Verifier in drei unabhängige Komponenten, die sich frei kombinieren lassen.
In der Praxis bedeutet das: Das Modell wurde auf identischen Aufgaben trainiert, gepaart mit unterschiedlichen Harnesses und Verifiern – so wird es zu generalisierbaren Strategien gezwungen.
Die Benchmarks bestätigen das: Qwen3.7-Max liefert konsistent ab – ob über Claude Code, OpenClaw, Qwen Code oder benutzerdefinierte Tool-Use-Frameworks. Auf QwenClawBench und CoWorkBench hält die Performance unabhängig davon, welches Harness bei der Evaluation eingesetzt wird.
Für Teams, die Agentensysteme aufbauen, ist das wichtig: Qwen3.7-Max kann als austauschbares Backbone dienen, ohne framework-spezifisches Finetuning. Das ist ein echter operativer Vorteil gegenüber Modellen, die nur in ihrem nativen Scaffold stark sind.
Qwen3.7-Max unterstützt eine native Integration mit dem Model Context Protocol (MCP), wodurch es sich standardisiert mit externen Tools und Datenquellen verbinden kann.
Auf MCP-Mark erzielt es 60,8 – vor GLM-5.1 Thinking mit 57,5 und Opus-4.6 Max mit 56,7. Auf MCP-Atlas erreicht es 76,4 und liegt damit knapp vor Opus-4.6 Max mit 75,8.
Der Office-Automation-Aspekt verdient besondere Erwähnung. Auf SpreadSheetBench-v1 erreicht Qwen3.7-Max 87,0 und liegt damit knapp hinter Opus-4.6 Max mit 89,3.
Das Qwen-Team demonstriert dies mit einer Thesis-Formatierungsaufgabe: Das Modell liest die Formatvorgaben und bringt einen unaufgeräumten Entwurf autonom in Form – Seitenlayout, Überschriftenstile, Schriften, Ränder, Inhaltsverzeichnis und Literaturverweise – per autonomen office-cli-Toolaufrufen.
Eine eher ungewöhnliche Neuheit ist ein Self-Monitoring-Framework für RL-Training. Während RL-Experimenten über 80 Stunden rief Qwen3.7-Max autonom Trainingspfade ab und spielte sie erneut ab, mit über 10.000 Aufrufen zur Identifikation von Reward-Hacking-Mustern.
Dazu zählten Versuche, Beschränkungen zu umgehen und Ground-Truth-Antworten auf GitHub zu beschaffen.
Das System führte Regelprüfungen, das Mining von Gegenbeispielen und iterative Optimierungen durch, fügte am Ende 13 neue heuristische Regeln hinzu und markierte 1.618 Hacking-Fälle korrekt.
Das ist weniger eine direkt nutzbare Funktion, sagt aber viel über das Training aus – relevant für Teams, die Qwen3.7-Max in eigenen RL-Pipelines einsetzen wollen.
Qwen3.7-Max kann über Toolaufrufe einen Roboterdog steuern – mit dem Agenten-Harness Qwen-RobotClaw und dem Navigations-Foundation-Modell Qwen-RobotNav.
Das Modell bewältigt physisches Verständnis, Planung, Gedächtnis und Entscheidungen in realen Umgebungen. Gezeigt wird das in einer 20-minütigen Agentensitzung, in der der Roboter mithilfe des Langzeitgedächtnisses des Modells und First-Person-Videoeindrücken durch einen Raum navigiert.
Ich würde das nicht als produktionsreife Robotik-Plattform überhöhen, aber es zeigt die Bandbreite des Agenten-Frameworks. Die gleiche Tool-Calling-Infrastruktur, die Tabellenautomation und Kernel-Optimierung meistert, lässt sich auch auf physische Navigation übertragen.
Schauen wir uns die Benchmark-Daten genauer an.
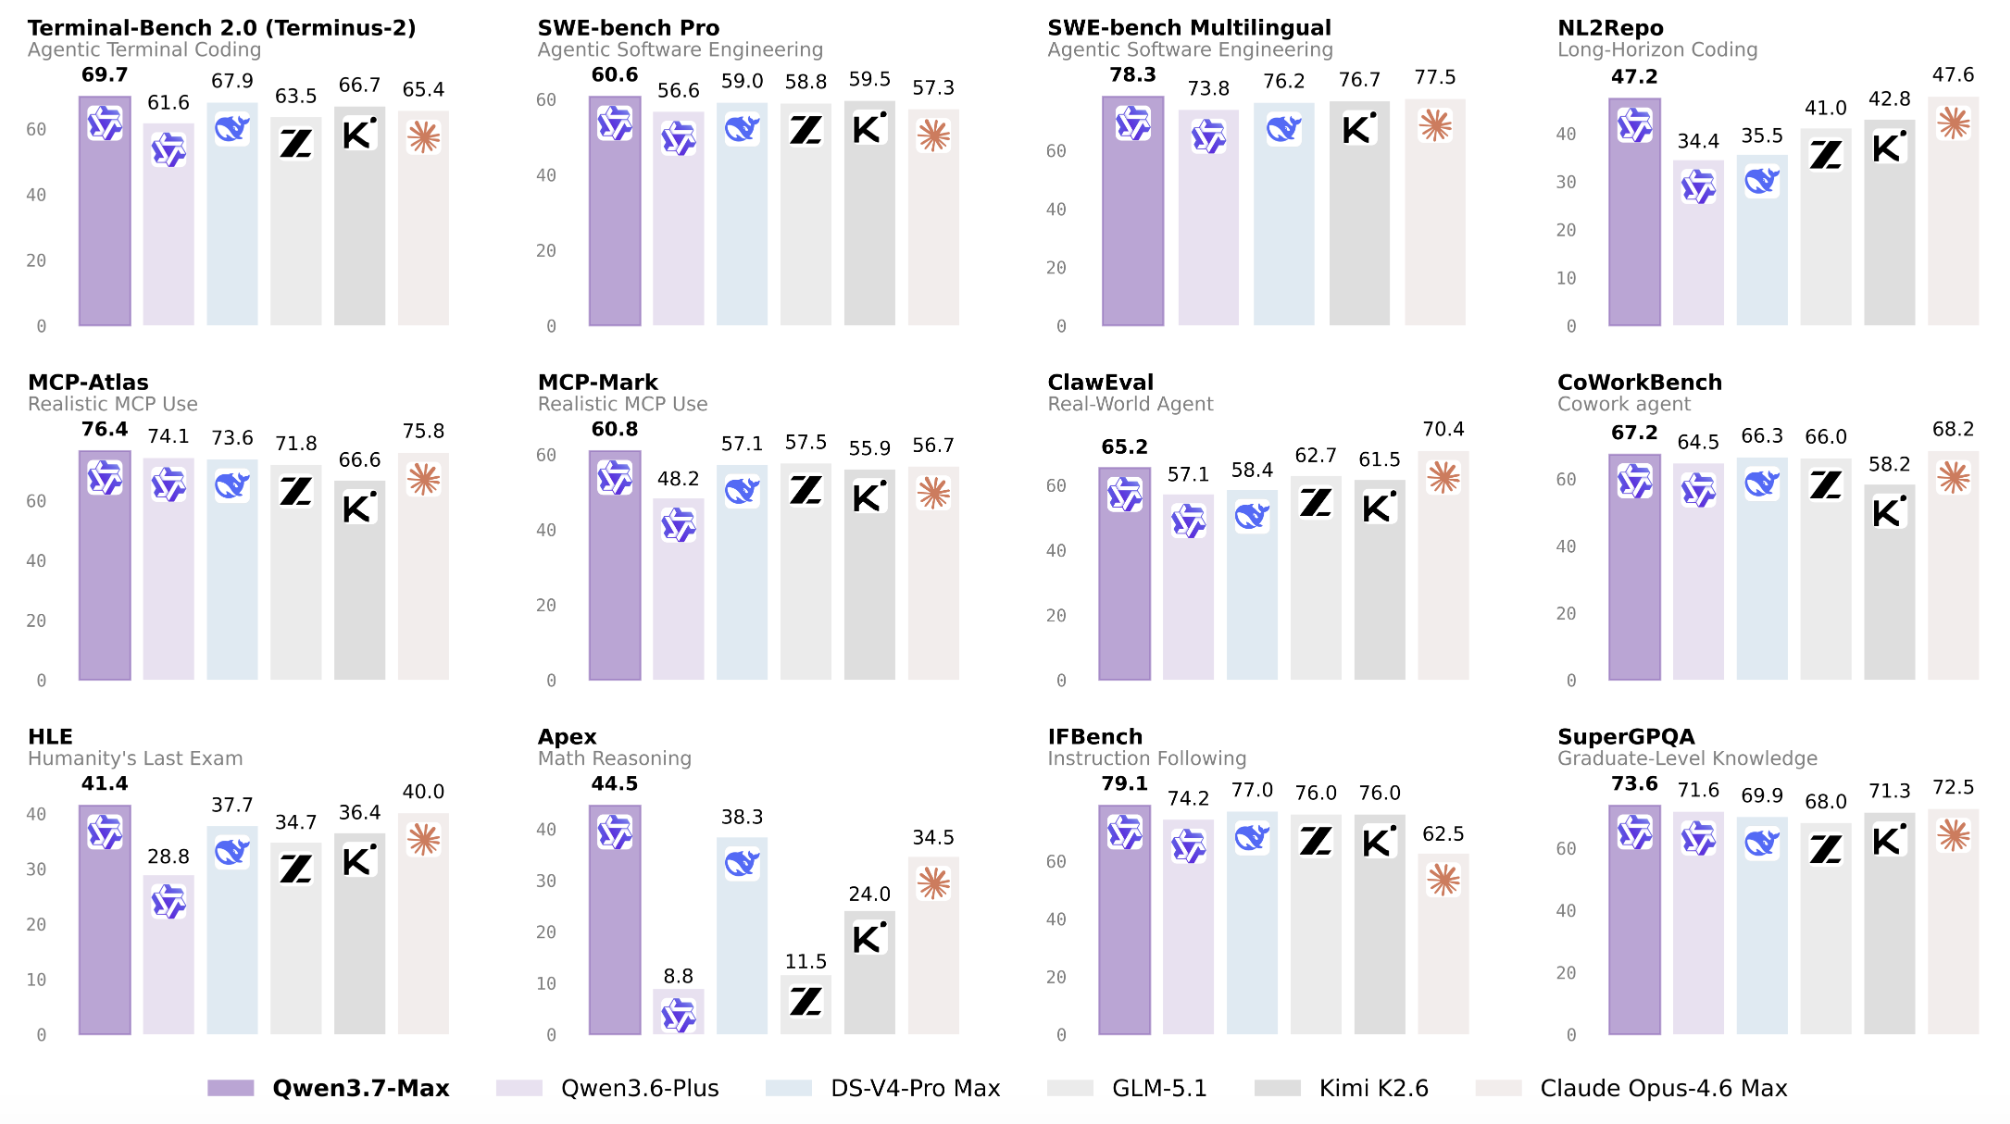
Qwen3.7-Max wurde in vier großen Kategorien evaluiert: Coding-Agenten, General-Purpose-Agenten, STEM-Reasoning und allgemeine Fähigkeiten inklusive Mehrsprachen-Performance.
Die Ergebnisse stammen aus einer Vielzahl von Agenten-Scaffolds – damit sind sie aussagekräftiger als Zahlen aus nur einem Scaffold.
Auf Terminal Bench 2.0-Terminus erreicht Qwen3.7-Max 69,7 und liegt vor DeepSeek-V4-Pro Max (67,9), Opus-4.6 Max (65,4) und K2.6 Thinking (66,7).
Dieser Benchmark testet autonome terminalbasierte Softwareentwicklung mit 5-Stunden-Timeout und 12 CPU-Kernen. Auf SWE-Pro erzielt es 60,6 – den Bestwert in der Vergleichstabelle – vor K2.6 Thinking (59,5) und DS-V4-Pro Max (59,0).
SWE-Verified ist der eine Benchmark, bei dem Qwen3.7-Max nicht führt: 80,4 gegenüber 80,8 bei Opus-4.6 Max und 80,6 bei DS-V4-Pro Max.
Der Abstand ist klein, aber erwähnenswert. Auf SWE-Multilingual (78,3) und SciCode (53,5) führt es das Feld an. Auf QwenSVG erreicht es 1.608 – vor GLM-5.1 Thinking (1.605) und Opus-4.6 Max (1.541).
Die allgemeinen Agenten-Ergebnisse sind Qwen3.7-Max’ stärkstes Argument. Auf MCP-Mark erzielt es 60,8 gegenüber 57,5 bei GLM-5.1 und 56,7 bei Opus-4.6.
Auf MCP-Atlas kommt es auf 76,4 und liegt knapp vor 75,8 bei Opus-4.6. Auf Skillsbench erreicht es 59,2 gegenüber 56,2 bei K2.6 Thinking. Auf SpreadSheetBench-v1 erzielt es 87,0 – nur Opus-4.6 Max liegt mit 89,3 davor.
Der Kernel Bench L3 verdient besondere Erwähnung. Qwen3.7-Max erzielt eine mediane Beschleunigung von 1,98x bei einer Gewinnrate von 96% (Anteil der Probleme schneller als torch.compile).
Opus-4.6 Max führt hier mit 2,63x/98%, doch Qwen3.7-Max liegt deutlich vor K2.6 Thinking (1,41x/80%), GLM-5.1 (2,00x/78%) und DS-V4-Pro Max (1,07x/54%). Auf MRCR-v2 128k, das Long-Context-Retrieval testet, erreicht es 90,4 – vor Qwen3.6-Plus (85,9) und Opus-4.6 Max (84,0).
GPQA Diamond testet Fragen auf Promotionsniveau in den Naturwissenschaften. Qwen3.7-Max erzielt 92,4 – vor Opus-4.6 Max (91,3), K2.6 Thinking (90,5) und DS-V4-Pro Max (90,1).
In unserem Review zu GPT-5.5 hielten wir fest: 93,6% auf GPQA Diamond – GPT-5.5 führt hier weiterhin, wobei unterschiedliche Evaluationsbedingungen zu beachten sind.
Auf HLE (Humanity's Last Exam) erzielt Qwen3.7-Max 41,4 – vor Opus-4.6 Max (40,0) und DeepSeek-V4-Pro Max (37,7).
Auf HMMT 2026 Feb (Wettbewerbsmathematik) erreicht es 97,1 – Bestwert – vor Opus-4.6 Max (96,2) und DS-V4-Pro Max (95,2).
Auf dem IMOAnswerBench kommt es auf 90,0 und liegt knapp vor DS-V4-Pro Max (89,8). Im Apex-Benchmark erreicht es 44,5 – deutlich vor DS-V4-Pro Max (38,3) und Opus-4.6 Max (34,5).
Qwen3.7-Max führt auf WMT24++ (85,8 vs. 84,3 bei Qwen3.6-Plus und 82,7 bei Opus-4.6 Max) – Test der Übersetzungsqualität in 55 Sprachen. Auf MAXIFE erzielt es 89,2 – vor 88,9 bei DS-V4-Pro Max. Auf PolyMATH erreicht es 86,5 – deutlich vor Opus-4.6 Max (80,2) und K2.6 Thinking (82,7).
Mehrsprachige Stärke zieht sich durch die gesamte Qwen3.x-Linie – Qwen3.7-Max baut diesen Vorsprung aus.
Qwen3.7-Max ist über das Alibaba Cloud Model Studio verfügbar, mit API-Zugang via OpenAI-kompatiblen und Anthropic-kompatiblen Endpunkten. Die Modell-ID lautet qwen3.7-max.
Zum Zeitpunkt der Erstellung nennt Artificial Analysis Preise von $2,50 pro 1 Mio. Tokens für Input und $7,50 für Output.
Die von Artificial Analysis hervorgehobene hohe Wortfülle (97 Mio. generierte Tokens in ihrer Evaluation vs. Median 24 Mio.) bedeutet, dass die effektiven Kosten für lange agentische Sessions deutlich über den ausgewiesenen Per-Token-Tarifen liegen können.
Für Entwickler unterstützt das Modell das Feature preserve_thinking, das die Denk-Inhalte aller vorangegangenen Turns in Mehrfachdialogen beibehält. Das Qwen-Team empfiehlt, dies für agentische Aufgaben zu aktivieren. Die Integration mit Claude Code, OpenClaw und Qwen Code ist out of the box verfügbar, mit Konfigurationsbeispielen in der offiziellen Doku.
Qwen3.7-Max ist ein ernstzunehmender Neuzugang an der Spitze des Agentenmarkts. Die Benchmarks sind durchweg stark, und die 35-stündige Kernel-Optimierung ist ein greifbares, überprüfbares Ergebnis – schwerer wegzuwischen als eine reine Leaderboard-Position.
Auch die Geschichte der Cross-Harness-Generalisation überzeugt: Training auf vielfältigen Harness-Konfigurationen ist ein grundsätzlich richtiger Ansatz gegen Scaffold-Overfitting, und die konsistente Performance über Claude Code, OpenClaw und Qwen Code stützt das.
Vorsicht würde ich bei der Ausführlichkeit walten lassen. Ein Modell, das in einer Standard-Evaluationssuite 97 Mio. Tokens generiert, wird in der Praxis deutlich mehr kosten als der reine Per-Token-Preis vermuten lässt – insbesondere bei langlaufenden agentischen Sessions, für die es gedacht ist.
Teams, die auf Qwen3.7-Max bauen, sollten Budgets sorgfältig planen und mit expliziten Ausgabebegrenzungen testen, bevor sie Produktionslasten zusagen.
Wenn du auf Modellen wie Qwen3.7-Max aufbauen oder die agentische KI-Landschaft besser verstehen willst, empfehle ich den AI Fundamentals Skill Track auf DataCamp – so bist du schnell mit den Grundlagen hinter diesen Systemen vertraut.
Top-DataCamp-Kurse
Lernpfad
Kurs
Kurs
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Zoumana Keita
15 Min.
Tutorial
Josef Waples
3 Min.
Tutorial
Mark Pedigo
10 Min.
Tutorial
Josef Waples
8 Min.


