Programa
Fundamentos de agentes de IA
6 h
A disputa pelo melhor modelo de IA com capacidades de agente está esquentando. Claude Opus 4.6 da Anthropic, DeepSeek V4 Pro e Kimi K2.6 já reivindicaram o topo dos rankings de código e raciocínio nos últimos meses. Agora, a equipe Qwen, da Alibaba, entra em cena com o Qwen3.7-Max, um modelo proprietário de ponta descrito como construído especificamente para a era dos agentes.
Os números de destaque merecem atenção. No GPQA Diamond, o Qwen3.7-Max faz 92,4, superando os 91,3 do Claude Opus 4.6 Max. No benchmark Apex de raciocínio, marca 44,5 contra 38,3 do DeepSeek V4 Pro. E, em uma execução autônoma de otimização de kernel por 35 horas, o modelo realizou 1.158 chamadas de ferramentas e alcançou um ganho de velocidade médio geométrico de 10x em relação à implementação de referência em Triton.
Neste artigo, vou cobrir tudo o que há de novo no Qwen3.7-Max, destacando seus recursos, explorando os resultados dos benchmarks e sugerindo testes práticos que você mesmo pode executar. Você também pode conferir nossa cobertura do Gemini 3.5 Flash e do Gemini Omni para entender onde está a fronteira mais ampla neste momento.
Qwen3.7-Max é o novo modelo proprietário da Alibaba, posicionado como o topo da família Qwen3.x, acima do Qwen3.6-Plus.
É um modelo de código fechado, acessível por API via Alibaba Cloud Model Studio, com janela de contexto de 1 milhão de tokens e entradas/saídas apenas em texto. A equipe Qwen o descreve como uma "base versátil para agentes", e não um modelo de chat de uso geral.
Comparado ao Qwen3.6-Plus, os ganhos são substanciais em todas as categorias. No Terminal Bench 2.0-Terminus, o Qwen3.7-Max faz 69,7 contra 61,6 do Qwen3.6-Plus. No YC-Bench (simulação de startup), alcançou receita total de US$ 2,08 milhões, o dobro dos US$ 1,05 milhão do Qwen3.6-Plus. A maior diferença aparece em tarefas agentic de longo prazo — justamente onde a equipe diz ter concentrado o treinamento.
O Artificial Analysis Intelligence Index dá ao Qwen3.7-Max uma pontuação de 56,6, colocando-o acima de concorrentes e pouco abaixo de alguns dos melhores modelos de fronteira.
Um ponto a destacar desde já: o modelo é notavelmente verboso. O Artificial Analysis observou aproximadamente 97 milhões de tokens gerados durante a avaliação, muito acima da mediana de 24 milhões. Essa verbosidade tem impacto em custos para sessões longas com agentes — tema ao qual volto na seção de preços.
O Qwen3.7-Max traz várias capacidades que o diferenciam tanto do antecessor quanto do estado da arte atual. O foco é execução autônoma sustentada, e não desempenho em uma única interação.
A demonstração mais marcante no lançamento é a execução de otimização de kernel por 35 horas.
Basicamente, a equipe Qwen entregou ao modelo um problema de código difícil (otimizar código de GPU), passando apenas instruções e uma forma de testar o trabalho — e então saiu de cena. A partir daí, o Qwen3.7-Max trabalhou de forma autônoma: escreveu código, rodou testes, identificou gargalos e redesenhou o código. Ele repetiu esse ciclo mais de mil vezes.
O resultado final fez o código rodar 10 vezes mais rápido que o baseline padrão, tudo isso em hardware que o modelo nunca tinha visto antes.
O Qwen3.7 Max ainda encontrava maneiras relevantes de acelerar o código mesmo após 30 horas de execução. Não ficou só no "arroz com feijão" e parou.
Outros modelos de ponta, como GLM 5.1, Kimi K2.6 e DeepSeek V4 Pro, desistiram bem antes (atingindo no máximo 7,3x, 5,0x e 3,3x mais rápidos, respectivamente).
Isso mostra que o Qwen3.7-Max não é apenas bom para responder uma pergunta rápida de código em um único prompt. Você pode entregar um projeto pesado e cansativo de otimização, se afastar e confiar que ele vai manter o foco sem se perder ao longo de um período longo.
A maioria dos modelos para agentes é treinada e avaliada em um scaffold específico, o que pode fazer com que os números de benchmark reflitam atalhos do harness, e não uma resolução genuína de problemas.
O Qwen3.7-Max busca evitar isso por meio de uma infraestrutura que desacopla Task, Harness e Verifier em três componentes independentes que podem ser recombinados livremente.
Na prática, isso significa que o modelo foi treinado em tarefas idênticas combinadas com harnesses e verificadores diversos, forçando-o a aprender estratégias generalizáveis.
Os benchmarks refletem isso: o Qwen3.7-Max tem desempenho consistente seja via Claude Code, OpenClaw, Qwen Code ou frameworks customizados de uso de ferramentas. No QwenClawBench e no CoWorkBench, a performance se mantém independentemente do harness usado na avaliação.
Para times que estão construindo sistemas de agentes, isso importa porque significa que o Qwen3.7-Max pode atuar como um backbone plug-and-play, sem exigir ajustes específicos por framework. É uma vantagem operacional real sobre modelos que vão bem apenas no seu scaffold nativo.
O Qwen3.7-Max tem integração nativa com o Model Context Protocol (MCP), o que permite conexão padronizada com ferramentas e fontes de dados externas.
No MCP-Mark, ele marca 60,8, à frente dos 57,5 do GLM-5.1 Thinking e dos 56,7 do Opus-4.6 Max. No MCP-Atlas, faz 76,4, superando os 75,8 do Opus-4.6 Max.
O ângulo de automação de escritório merece destaque à parte. No SpreadSheetBench-v1, o Qwen3.7-Max faz 87,0, ficando atrás apenas dos 89,3 do Opus-4.6 Max.
A equipe Qwen demonstra isso com uma tarefa de formatação de tese, em que o modelo lê um documento de especificação de formatação e reformata um rascunho confuso de forma autônoma, ajustando layout, estilos de títulos, fontes, margens, sumário e referências por meio de chamadas autônomas às ferramentas do office-cli.
Um dos recursos mais incomuns do lançamento é um framework de autoverificação para treinamento por RL. Em experimentos de RL acima de 80 horas, o Qwen3.7-Max recuperou e reproduziu trajetórias de treino de forma autônoma, executando mais de 10.000 chamadas para identificar padrões de reward hacking.
Isso incluiu tentativas de burlar restrições e acessar respostas corretas no GitHub.
O sistema realizou verificação de regras, mineração de contraexemplos e otimização iterativa, adicionando 13 novas regras heurísticas e sinalizando com precisão 1.618 casos de hacking.
Isso é menos um recurso para o usuário final e mais um sinal de como o modelo foi treinado, mas é relevante para times que pensam em usar o Qwen3.7-Max em seus próprios pipelines de RL.
O Qwen3.7-Max agora consegue operar um cão-robô por meio de chamadas de ferramentas, usando o harness de agente Qwen-RobotClaw e o modelo base de navegação Qwen-RobotNav.
O modelo lida com compreensão física, planejamento, memória e tomada de decisão em ambientes reais. Isso é demonstrado em uma sessão de 20 minutos na qual o robô navega por um espaço físico usando a memória de longo prazo do modelo e entrada visual em primeira pessoa.
Eu não exageraria isso como uma plataforma de robótica pronta para produção, mas ilustra o alcance do framework de agentes. A mesma infraestrutura de chamadas de ferramentas que cuida de automação de planilhas e otimização de kernel também se estende à navegação no mundo real.
Vamos olhar os dados dos benchmarks com mais detalhes.
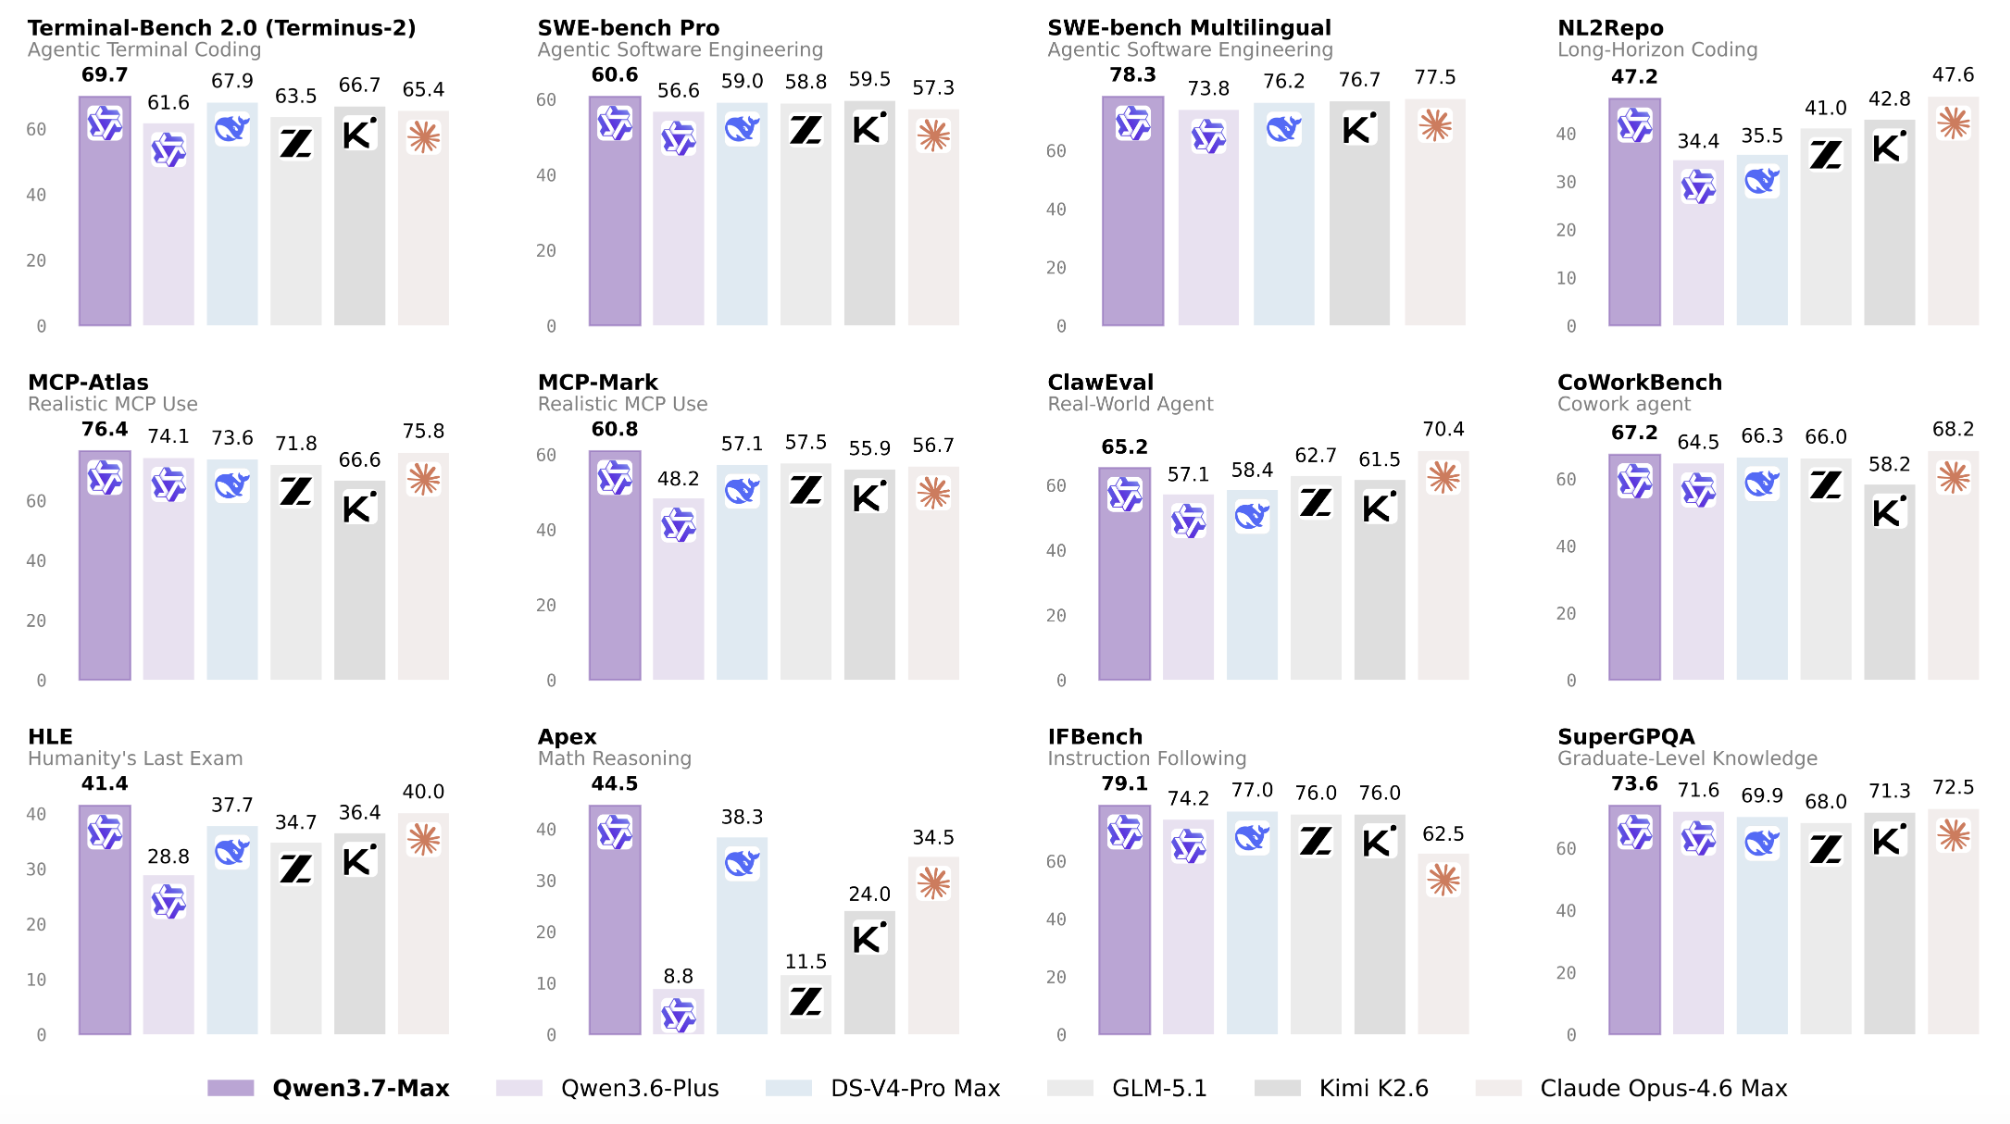
O Qwen3.7-Max foi avaliado em quatro grandes categorias: agentes para código, agentes de uso geral, raciocínio em STEM e capacidades gerais, incluindo desempenho multilíngue.
Os resultados vêm de uma grande variedade de scaffolds de agente, o que os torna mais significativos do que números restritos a um único scaffold.
No Terminal Bench 2.0-Terminus, o Qwen3.7-Max marca 69,7, à frente de DeepSeek-V4-Pro Max (67,9), Opus-4.6 Max (65,4) e K2.6 Thinking (66,7).
Esse benchmark testa engenharia de software autônoma em terminal, com timeout de 5 horas e 12 núcleos de CPU. No SWE-Pro, faz 60,6, a maior pontuação da comparação, à frente de K2.6 Thinking (59,5) e DS-V4-Pro Max (59,0).
O SWE-Verified é o único benchmark em que o Qwen3.7-Max não lidera: ele marca 80,4 contra 80,8 do Opus-4.6 Max e 80,6 do DS-V4-Pro Max.
A diferença é pequena, mas vale notar. No SWE-Multilingual (78,3) e no SciCode (53,5), ele lidera. No QwenSVG, marca 1608, à frente dos 1605 do GLM-5.1 Thinking e dos 1541 do Opus-4.6 Max.
Nos resultados de agentes gerais, o Qwen3.7-Max faz sua defesa mais forte. No MCP-Mark, marca 60,8 contra 57,5 do GLM-5.1 e 56,7 do Opus-4.6.
No MCP-Atlas, faz 76,4, superando os 75,8 do Opus-4.6. No Skillsbench, marca 59,2 contra 56,2 do K2.6 Thinking. No SpreadSheetBench-v1, faz 87,0, atrás apenas dos 89,3 do Opus-4.6 Max.
O resultado no Kernel Bench L3 merece destaque próprio. O Qwen3.7-Max alcança um speedup mediano de 1,98x com taxa de vitória de 96% (fração de problemas mais rápidos que torch.compile).
O Opus-4.6 Max lidera aqui com 2,63x/98%, mas o Qwen3.7-Max fica bem à frente do K2.6 Thinking (1,41x/80%), GLM-5.1 (2,00x/78%) e DS-V4-Pro Max (1,07x/54%). No MRCR-v2 128k, que testa recuperação em longos contextos, ele faz 90,4, superando o Qwen3.6-Plus (85,9) e o Opus-4.6 Max (84,0).
O GPQA Diamond testa questões de ciência em nível de PhD. O Qwen3.7-Max marca 92,4, à frente do Opus-4.6 Max (91,3), K2.6 Thinking (90,5) e DS-V4-Pro Max (90,1).
Na nossa análise do GPT-5.5, apontamos 93,6% no GPQA Diamond, então o GPT-5.5 ainda lidera neste benchmark específico — embora a comparação direta exija observar as condições de avaliação diferentes.
No HLE (Humanity's Last Exam), o Qwen3.7-Max marca 41,4, à frente do Opus-4.6 Max (40,0) e do Deepseek-V4-Pro Max (37,7).
No HMMT 2026 Feb (matemática competitiva), marca 97,1, a maior da tabela, à frente do Opus-4.6 Max (96,2) e do DS-V4-Pro Max (95,2).
No IMOAnswerBench, faz 90,0, superando os 89,8 do DS-V4-Pro Max. No benchmark Apex, marca 44,5, bem à frente dos 38,3 do DS-V4-Pro Max e dos 34,5 do Opus-4.6 Max.
O Qwen3.7-Max lidera no WMT24++ (85,8 vs. 84,3 do Qwen3.6-Plus e 82,7 do Opus-4.6 Max), que avalia qualidade de tradução em 55 idiomas. No MAXIFE, marca 89,2, à frente dos 88,9 do DS-V4-Pro Max. No PolyMATH, faz 86,5, bem acima dos 80,2 do Opus-4.6 Max e dos 82,7 do K2.6 Thinking.
Desempenho multilíngue é um ponto forte consistente na linha Qwen3.x, e o Qwen3.7-Max amplia essa vantagem.
O Qwen3.7-Max está disponível via Alibaba Cloud Model Studio, com acesso por API por endpoints compatíveis com OpenAI e com Anthropic. O ID do modelo é qwen3.7-max.
No momento da escrita, o Artificial Analysis lista os preços de entrada e saída como US$ 2,50 por 1M de tokens de entrada e US$ 7,50 para saída.
A alta verbosidade apontada pelo Artificial Analysis (97M de tokens gerados na avaliação vs. mediana de 24M) indica que os custos efetivos para sessões longas com agentes podem ser bem maiores do que as tarifas por token sugerem.
Para desenvolvedores, o modelo suporta o recurso preserve_thinking, que mantém o conteúdo de raciocínio de todos os turnos anteriores em conversas de múltiplas interações. A equipe Qwen recomenda habilitar isso para tarefas agentic. A integração com Claude Code, OpenClaw e Qwen Code vem pronta, com exemplos de configuração na documentação oficial.
O Qwen3.7-Max chega forte ao topo do mercado de modelos para agentes. Os números de benchmark são consistentes, e a demonstração de otimização de kernel por 35 horas é um resultado concreto e verificável — mais difícil de descartar do que uma posição em leaderboard.
A história de generalização entre harnesses também é convincente: treinar com configurações diversas é uma abordagem sólida para o problema de overfitting ao scaffold, e o desempenho consistente em Claude Code, OpenClaw e Qwen Code reforça isso.
Onde eu teria cautela é na verbosidade. Um modelo que gera 97M de tokens em uma suíte de avaliação padrão vai custar bem mais, na prática, do que a tarifa por token dá a entender — especialmente em sessões longas, que são seu principal caso de uso.
Times que forem adotar o Qwen3.7-Max devem planejar o orçamento com cuidado e testar com limites explícitos de saída antes de levar cargas para produção.
Se você quer construir encima de modelos como o Qwen3.7-Max ou entender mais a fundo o panorama de IA para agentes, recomendo conferir a trilha de habilidades AI Fundamentals da DataCamp para acelerar seu domínio dos conceitos que sustentam esses sistemas.
Os melhores cursos da DataCamp
Programa
Curso
Curso
blog
Bhavishya Pandit
9 min
blog
Javier Canales Luna
9 min
blog
Richie Cotton
7 min
blog
Abid Ali Awan
9 min
blog
Tutorial
Zoumana Keita
14 min