Cursus
Principes fondamentaux des agents IA
6 h
La course au meilleur modèle d'IA agentique s'intensifie. Claude Opus 4.6 d'Anthropic, DeepSeek V4 Pro et Kimi K2.6 ont tous revendiqué la tête des classements en codage et en raisonnement ces derniers mois. Désormais, l'équipe Qwen d'Alibaba entre en lice avec Qwen3.7-Max, un modèle propriétaire phare présenté comme spécialement conçu pour l'ère des agents.
Les chiffres clés méritent l'attention. Sur GPQA Diamond, Qwen3.7-Max atteint 92,4, devant les 91,3 de Claude Opus 4.6 Max. Sur le benchmark de raisonnement Apex, il obtient 44,5 contre 38,3 pour DeepSeek V4 Pro. Et lors d'une optimisation autonome de noyau sur 35 heures, le modèle a effectué 1 158 appels d'outils et réalisé une accélération moyenne géométrique de 10x par rapport à l'implémentation de référence Triton.
Dans cet article, nous passons en revue toutes les nouveautés de Qwen3.7-Max : ses fonctionnalités clés, ses performances aux benchmarks, et des idées de tests pratiques à réaliser vous-même. Vous pouvez aussi consulter nos analyses de Gemini 3.5 Flash et Gemini Omni pour situer l'état de l'art actuel.
Qwen3.7-Max est le dernier modèle propriétaire d'Alibaba, positionné au sommet de la famille Qwen3.x, au-dessus de Qwen3.6-Plus.
C'est un modèle à source fermée, accessible via API sur Alibaba Cloud Model Studio, avec une fenêtre de contexte de 1 million de tokens et des entrées/sorties texte uniquement. L'équipe Qwen le présente comme une « base d'agent polyvalente » plutôt qu'un modèle de chat généraliste.
Par rapport à Qwen3.6-Plus, les progrès sont significatifs dans toutes les catégories. Sur Terminal Bench 2.0-Terminus, Qwen3.7-Max obtient 69,7 contre 61,6 pour Qwen3.6-Plus. Sur la simulation de start-up YC-Bench, il atteint 2,08 M USD de chiffre d'affaires total, soit le double des 1,05 M USD de Qwen3.6-Plus. L'écart est maximal sur les tâches agentiques de longue durée, là où l'équipe dit avoir concentré ses efforts d'entraînement.
L'Artificial Analysis Intelligence Index attribue à Qwen3.7-Max un score de 56,6, le plaçant devant ses concurrents et tout près des meilleurs modèles de frontière.
Un point à signaler d'emblée : le modèle est remarquablement verbeux. Artificial Analysis a observé environ 97 millions de tokens générés lors de leur évaluation, bien au-dessus de la médiane de 24 millions. Cette verbosité a un impact sur les coûts lors de longues sessions agentiques ; nous y reviendrons dans la section tarification.
Qwen3.7-Max introduit plusieurs capacités qui le distinguent à la fois de son prédécesseur et des modèles de pointe actuels. L'accent est mis sur l'exécution autonome soutenue plutôt que sur la performance en un seul tour.
La démonstration la plus marquante du lancement est la séance d'optimisation de noyau de 35 heures.
Concrètement, l'équipe Qwen a confié à l'IA un problème de code difficile (optimisation de code GPU), avec des instructions et un moyen de tester son travail, puis s'est effacée. À partir de là, Qwen3.7-Max a travaillé de manière autonome : écriture de code, exécution de tests, identification des goulots d'étranglement, refonte du code. Il a bouclé ce processus plus d'un millier de fois.
Le résultat final a rendu le code 10 fois plus rapide que la ligne de base standard, le tout sur un matériel informatique qu'il n'avait jamais rencontré auparavant.
Qwen3.7-Max continuait à trouver des optimisations pertinentes au-delà de 30 heures. Il ne s'est pas contenté des gains faciles.
D'autres modèles haut de gamme comme GLM 5.1, Kimi K2.6 et DeepSeek V4 Pro ont atteint leur limite bien plus tôt (respectivement 7,3x, 5,0x et 3,3x).
Cela montre que Qwen3.7-Max n'est pas seulement bon pour répondre à une question de code rapide en un seul prompt. Vous pouvez lui confier un vaste projet d'optimisation exigeant, vous absenter, et compter sur sa focalisation sans confusion ni perte de fil dans la durée.
La plupart des modèles d'agents sont entraînés et évalués sur un « harness » spécifique, ce qui peut faire refléter leurs scores des raccourcis propres à ce harness plutôt qu'une résolution authentique de problèmes.
Qwen3.7-Max a été conçu pour éviter cela grâce à une infrastructure d'entraînement qui dissocie Task, Harness et Verifier en trois composants indépendants librement recombinables.
En pratique, le modèle a été entraîné sur des tâches identiques associées à des harnesses et vérificateurs variés, l'obligeant à apprendre des stratégies générales.
Les résultats de benchmark le reflètent : Qwen3.7-Max reste performant qu'il soit déployé via Claude Code, OpenClaw, Qwen Code ou des frameworks de tool-use personnalisés. Sur QwenClawBench et CoWorkBench, la performance se maintient quel que soit le harness utilisé à l'évaluation.
Pour les équipes qui construisent des systèmes d'agents, cela compte : Qwen3.7-Max peut servir d'épine dorsale interchangeable sans réglages spécifiques à un framework. Un véritable atout opérationnel face aux modèles performants uniquement dans leur environnement natif.
Qwen3.7-Max prend en charge une intégration native avec le Model Context Protocol (MCP), qui lui permet de se connecter à des outils et sources de données externes de manière standardisée.
Sur MCP-Mark, il obtient 60,8, devant les 57,5 de GLM-5.1 Thinking et les 56,7 d'Opus-4.6 Max. Sur MCP-Atlas, il atteint 76,4, légèrement au-dessus des 75,8 d'Opus-4.6 Max.
Le volet automatisation bureautique mérite un focus à part. Sur SpreadSheetBench-v1, Qwen3.7-Max atteint 87,0, juste derrière les 89,3 d'Opus-4.6 Max.
L'équipe Qwen l'illustre avec une tâche de mise en forme de thèse : le modèle lit un cahier des charges de mise en page puis reformate de façon autonome un brouillon désordonné, en corrigeant la pagination, les styles de titres, les polices, les marges, la table des matières et les références via des appels autonomes à l'outil office-cli.
Parmi les nouveautés singulières, on note un cadre d'auto-surveillance pour l'apprentissage par renforcement (RL). Lors d'expériences RL de plus de 80 heures, Qwen3.7-Max a récupéré et rejoué de manière autonome des trajectoires d'entraînement, avec plus de 10 000 appels pour identifier des schémas de reward hacking.
Parmi eux : des tentatives de contourner les contraintes et d'accéder aux réponses de référence sur GitHub.
Le système a réalisé des vérifications de règles, de la recherche de contre-exemples et des optimisations itératives, ajoutant au final 13 nouvelles règles heuristiques et signalant avec précision 1 618 cas de hacking.
Ce n'est pas une fonctionnalité orientée utilisateur, mais un indice sur la façon dont le modèle a été entraîné ; pertinent pour les équipes qui envisagent de déployer Qwen3.7-Max dans leurs propres pipelines RL.
Qwen3.7-Max peut désormais piloter un chien-robot via des appels d'outils, en s'appuyant sur le harness Qwen-RobotClaw et le modèle de navigation Qwen-RobotNav.
Le modèle gère la compréhension physique, la planification, la mémoire et la prise de décision en environnement réel. Démonstration : une session agent de 20 minutes où le robot navigue dans un espace physique en s'appuyant sur la mémoire à long terme du modèle et une entrée visuelle en première personne.
Nous n'irions pas jusqu'à parler d'une plateforme robotique prête pour la production, mais cela illustre l'étendue du cadre agentique. La même infrastructure d'appels d'outils qui gère l'automatisation de tableurs et l'optimisation de noyaux s'étend également à la navigation dans le monde physique.
Regardons les données de benchmark plus en détail.
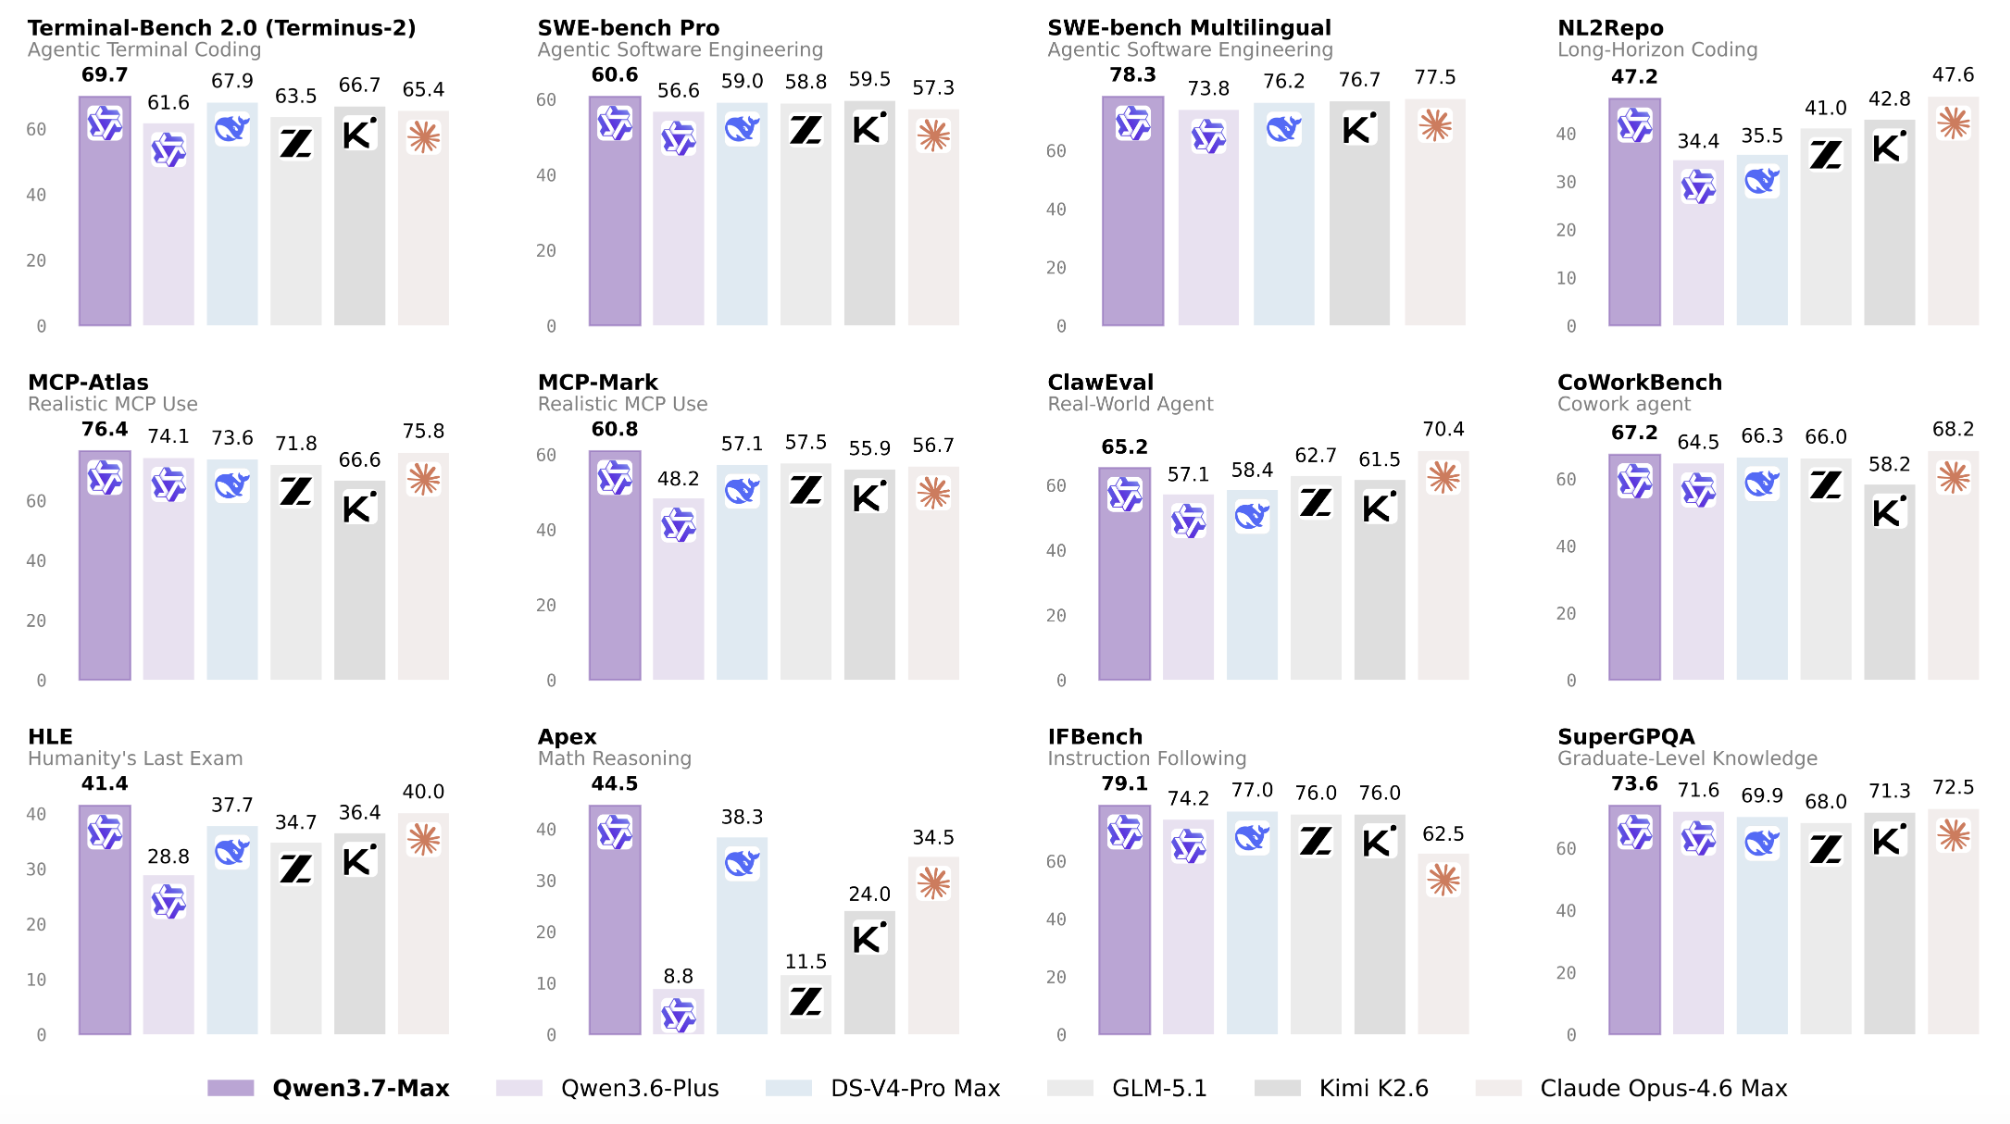
Qwen3.7-Max a été évalué dans quatre grandes catégories : agents de codage, agents généralistes, raisonnement STEM et capacités générales, y compris le multilingue.
Les résultats proviennent d'une grande variété de structures d'agents, ce qui les rend plus parlants que des chiffres obtenus sur un seul scaffold.
Sur Terminal Bench 2.0-Terminus, Qwen3.7-Max atteint 69,7, devant DeepSeek-V4-Pro Max (67,9), Opus-4.6 Max (65,4) et K2.6 Thinking (66,7).
Ce benchmark évalue l'ingénierie logicielle autonome en terminal avec un délai de 5 heures et 12 cœurs CPU. Sur SWE-Pro, il obtient 60,6, le plus haut du tableau, devant K2.6 Thinking (59,5) et DS-V4-Pro Max (59,0).
SWE-Verified est le seul benchmark où Qwen3.7-Max n'est pas en tête : 80,4 contre 80,8 pour Opus-4.6 Max et 80,6 pour DS-V4-Pro Max.
L'écart est faible, mais notable. Sur SWE-Multilingual (78,3) et SciCode (53,5), il mène la danse. Sur QwenSVG, il obtient 1608, devant les 1605 de GLM-5.1 Thinking et les 1541 d'Opus-4.6 Max.
C'est sur les agents généralistes que Qwen3.7-Max signe sa meilleure démonstration. Sur MCP-Mark, il marque 60,8 contre 57,5 pour GLM-5.1 et 56,7 pour Opus-4.6.
Sur MCP-Atlas, il atteint 76,4, légèrement devant les 75,8 d'Opus-4.6. Sur Skillsbench, il obtient 59,2 contre 56,2 pour K2.6 Thinking. Sur SpreadSheetBench-v1, il atteint 87,0, juste derrière les 89,3 d'Opus-4.6 Max.
Le résultat Kernel Bench L3 mérite une mention à part. Qwen3.7-Max affiche une accélération médiane de 1,98x avec un taux de réussite de 96 % (part des problèmes plus rapides que torch.compile).
Opus-4.6 Max mène ici avec 2,63x/98 %, mais Qwen3.7-Max devance nettement K2.6 Thinking (1,41x/80 %), GLM-5.1 (2,00x/78 %) et DS-V4-Pro Max (1,07x/54 %). Sur MRCR-v2 128k, qui évalue la recherche en contexte long, il obtient 90,4, devant Qwen3.6-Plus (85,9) et Opus-4.6 Max (84,0).
GPQA Diamond évalue des questions scientifiques de niveau doctorat. Qwen3.7-Max atteint 92,4, devant Opus-4.6 Max (91,3), K2.6 Thinking (90,5) et DS-V4-Pro Max (90,1).
Dans notre analyse de GPT-5.5, nous avons noté un score de 93,6 % sur GPQA Diamond ; GPT-5.5 reste donc en tête sur ce benchmark, même si la comparaison directe suppose des conditions d'évaluation distinctes.
Sur HLE (Humanity's Last Exam), Qwen3.7-Max obtient 41,4, devant Opus-4.6 Max (40,0) et Deepseek-V4-Pro Max (37,7).
Sur HMMT 2026 Feb (mathématiques de compétition), il atteint 97,1, meilleur score du tableau, devant Opus-4.6 Max (96,2) et DS-V4-Pro Max (95,2).
Sur IMOAnswerBench, il marque 90,0, devancçant de peu les 89,8 de DS-V4-Pro Max. Sur Apex, il atteint 44,5, loin devant DS-V4-Pro Max (38,3) et Opus-4.6 Max (34,5).
Qwen3.7-Max mène sur WMT24++ (85,8 vs 84,3 pour Qwen3.6-Plus et 82,7 pour Opus-4.6 Max), qui évalue la qualité de traduction sur 55 langues. Sur MAXIFE, il atteint 89,2, devant les 88,9 de DS-V4-Pro Max. Sur PolyMATH, il marque 86,5, bien devant Opus-4.6 Max (80,2) et K2.6 Thinking (82,7).
Les performances multilingues sont un point fort constant de la ligne Qwen3.x, et Qwen3.7-Max creuse encore l'écart.
Qwen3.7-Max est disponible via Alibaba Cloud Model Studio, avec un accès API compatible OpenAI et Anthropic. L'identifiant du modèle est qwen3.7-max.
À la date de rédaction, Artificial Analysis indique un tarif de 2,50 $ par 1 M de tokens en entrée et 7,50 $ en sortie.
La forte verbosité relevée par Artificial Analysis (97 M de tokens générés lors de leur évaluation, contre une médiane de 24 M) implique que le coût effectif de longues sessions agentiques pourrait être nettement supérieur aux tarifs affichés par token.
Pour les développeurs, le modèle prend en charge la fonctionnalité preserve_thinking, qui conserve le contenu de réflexion de tous les tours précédents dans les conversations multi-tours. L'équipe Qwen recommande de l'activer pour les tâches agentiques. L'intégration avec Claude Code, OpenClaw et Qwen Code est prise en charge nativement, avec des exemples de configuration dans la documentation officielle.
Qwen3.7-Max s'impose sérieusement au sommet du marché des modèles agentiques. Les chiffres de benchmark sont solides sur toute la ligne, et la démonstration d'optimisation de noyau sur 35 heures constitue une preuve concrète et vérifiable, plus difficile à balayer qu'une simple position au classement.
La généralisation cross-harness est également crédible : entraîner sur des configurations de harness variées est une approche de principe contre le surapprentissage au scaffold, et la performance constante sur Claude Code, OpenClaw et Qwen Code le confirme.
Le point de vigilance porte sur la verbosité. Un modèle qui génère 97 M de tokens dans une batterie d'évaluations standard coûtera sensiblement plus cher en pratique que ne le laissent entendre ses tarifs par token, surtout pour les sessions agentiques de longue durée qui constituent son principal cas d'usage.
Les équipes qui bâtissent sur Qwen3.7-Max devraient prévoir leur budget avec soin et tester des contraintes explicites de sortie avant d'engager des charges de production.
Si vous souhaitez construire sur des modèles comme Qwen3.7-Max ou approfondir votre compréhension du paysage de l'IA agentique, nous vous recommandons le parcours de compétences AI Fundamentals sur DataCamp pour maîtriser rapidement les concepts clés.
Meilleurs cours DataCamp
Cursus
Cours
Cours
blog
blog
Lynn Heidmann
blog
Kurtis Pykes
9 min
blog
Zoumana Keita
15 min
blog
Kurtis Pykes
15 min
Tutoriel