Programa
Fundamentos de agentes de IA
6 h
La carrera por el mejor modelo de IA con capacidades de agente está cada vez más reñida. Claude Opus 4.6 de Anthropic, DeepSeek V4 Pro y Kimi K2.6 han reclamado los primeros puestos en los ránquines de programación y razonamiento en los últimos meses. Ahora, el equipo Qwen de Alibaba se suma con Qwen3.7-Max, un modelo propietario insignia que describen como diseñado específicamente para la era de los agentes.
Los números de portada merecen atención. En GPQA Diamond, Qwen3.7-Max logra 92,4, superando el 91,3 de Claude Opus 4.6 Max. En el benchmark de razonamiento Apex, marca 44,5 frente a 38,3 de DeepSeek V4 Pro. Y en una ejecución autónoma de optimización de kernel de 35 horas, el modelo realizó 1.158 llamadas a herramientas y consiguió una aceleración media geométrica de 10x sobre la implementación de referencia en Triton.
En este artículo, cubro todas las novedades de Qwen3.7-Max: sus funciones clave, los resultados en benchmarks y pruebas prácticas que puedes ejecutar tú mismo. También puedes leer nuestro análisis de Gemini 3.5 Flash y Gemini Omni para situar dónde está ahora mismo la frontera del sector.
Qwen3.7-Max es el último modelo propietario de Alibaba, posicionado como el nivel superior de la familia Qwen3.x por encima de Qwen3.6-Plus.
Es un modelo de código cerrado accesible por API a través de Alibaba Cloud Model Studio, con una ventana de contexto de 1 millón de tokens y entrada y salida solo de texto. El equipo de Qwen lo define como una "base versátil para agentes" más que como un modelo de chat de propósito general.
Frente a Qwen3.6-Plus, las mejoras son sustanciales en todas las categorías. En Terminal Bench 2.0-Terminus, Qwen3.7-Max consigue 69,7 frente a 61,6 de Qwen3.6-Plus. En la simulación de startups YC-Bench, alcanzó 2,08 M USD de ingresos totales, el doble que los 1,05 M USD de Qwen3.6-Plus. La brecha es mayor en tareas agentivas de largo recorrido, que es precisamente donde el equipo dice haber centrado el entrenamiento.
El Artificial Analysis Intelligence Index otorga a Qwen3.7-Max una puntuación de 56,6, situándolo por encima de sus competidores y muy cerca de algunos de los mejores modelos de frontera.
Un punto a destacar desde el principio: el modelo es notablemente verboso. Artificial Analysis observó aproximadamente 97 millones de tokens generados durante su evaluación, muy por encima de la mediana de 24 millones. Esa verbosidad tiene implicaciones de coste en sesiones agentivas largas, algo a lo que volveré en la sección de precios.
Qwen3.7-Max incorpora varias capacidades que lo diferencian tanto de su predecesor como de los modelos de frontera actuales. El foco está en la ejecución sostenida y autónoma, más que en el rendimiento de un solo turno.
La demostración más llamativa del lanzamiento es la optimización de kernel durante 35 horas.
Básicamente, el equipo de Qwen planteó a la IA un problema complejo de programación (optimizar código para GPU), le dio instrucciones y una forma de probar su trabajo, y se apartó. Desde ahí, Qwen3.7-Max trabajó de forma autónoma: escribió código, ejecutó pruebas, detectó cuellos de botella y rediseñó el código. Repitió el proceso más de mil veces.
El resultado final hizo que el código se ejecutara 10 veces más rápido que la base estándar, todo ello creado en hardware que el modelo no había visto antes.
Qwen3.7 Max seguía encontrando mejoras significativas pasada la marca de 30 horas. No se limitó a aprovechar los "frutos fáciles" y parar.
Otros modelos de primer nivel como GLM 5.1, Kimi K2.6 y DeepSeek V4 Pro abandonaron mucho antes (con máximos de 7,3x, 5,0x y 3,3x, respectivamente).
Esto demuestra que Qwen3.7-Max no solo es bueno respondiendo una consulta rápida de programación en un único prompt. Puedes encargarle un proyecto de optimización largo y exigente, desconectar y confiar en que mantendrá el enfoque sin confundirse ni perder el hilo durante un periodo prolongado.
La mayoría de modelos de agente se entrenan y evalúan sobre un andamiaje específico, lo que puede hacer que sus cifras en benchmarks reflejen atajos propios del harness más que una resolución real de problemas.
Qwen3.7-Max está pensado para evitarlo mediante una infraestructura de entrenamiento que desacopla Tarea, Harness y Verificador en tres componentes independientes que pueden recombinarse libremente.
En la práctica, esto significa que el modelo se entrenó en tareas idénticas combinadas con harnesses y verificadores diversos, obligándole a aprender estrategias generalizables.
Los resultados lo reflejan: Qwen3.7-Max rinde de forma consistente tanto si se despliega con Claude Code, OpenClaw, Qwen Code o marcos de uso de herramientas personalizados. En QwenClawBench y CoWorkBench, el rendimiento se mantiene con independencia del harness usado en la evaluación.
Para equipos que construyen sistemas de agentes, esto importa porque Qwen3.7-Max puede actuar como columna vertebral intercambiable sin necesidad de ajustar a un framework concreto. Es una ventaja operativa real frente a modelos que solo rinden bien en su andamiaje nativo.
Qwen3.7-Max ofrece integración nativa con Model Context Protocol (MCP), que le permite conectarse a herramientas y fuentes de datos externas de forma estandarizada.
En MCP-Mark, puntúa 60,8, por delante de 57,5 de GLM-5.1 Thinking y 56,7 de Opus-4.6 Max. En MCP-Atlas, marca 76,4, superando ligeramente el 75,8 de Opus-4.6 Max.
La parte de automatización ofimática merece mención aparte. En SpreadSheetBench-v1, Qwen3.7-Max obtiene 87,0, solo por detrás del 89,3 de Opus-4.6 Max.
El equipo de Qwen lo demuestra con una tarea de maquetación de tesis en la que el modelo lee una especificación de formato y remaqueta de forma autónoma un borrador desordenado, corrigiendo diseño de página, estilos de encabezado, tipografías, márgenes, índice y referencias mediante llamadas autónomas a la herramienta office-cli.
Una de las funciones más singulares de esta versión es un marco de autocontrol para entrenamiento por RL. Durante experimentos de RL de más de 80 horas, Qwen3.7-Max recuperó y reejecutó trayectorias de entrenamiento de forma autónoma, realizando más de 10.000 llamadas para identificar patrones de reward hacking.
Estos incluían intentos de eludir restricciones y acceder a respuestas de referencia en GitHub.
El sistema realizó verificación de reglas, minería de contraejemplos y optimización iterativa, incorporando finalmente 13 reglas heurísticas nuevas y señalando con precisión 1.618 casos de hacking.
No es una función de cara al usuario, pero sí una señal de cómo se entrenó el modelo, relevante para equipos que piensen desplegar Qwen3.7-Max en sus propios pipelines de RL.
Qwen3.7-Max puede operar ahora un perro robot mediante llamadas de uso de herramientas, usando el harness de agente Qwen-RobotClaw y el modelo base de navegación Qwen-RobotNav.
El modelo gestiona comprensión física, planificación, memoria y toma de decisiones en entornos reales. Se demuestra en una sesión de 20 minutos donde el robot navega un espacio físico utilizando la memoria a largo plazo del modelo y entrada visual en primera persona.
No lo presentaría como una plataforma robótica lista para producción, pero sí ilustra el alcance del marco de agente. La misma infraestructura de llamadas a herramientas que gestiona la automatización de hojas de cálculo y la optimización de kernels también se extiende a la navegación en el mundo real.
Veamos los datos de benchmarks con más detalle.
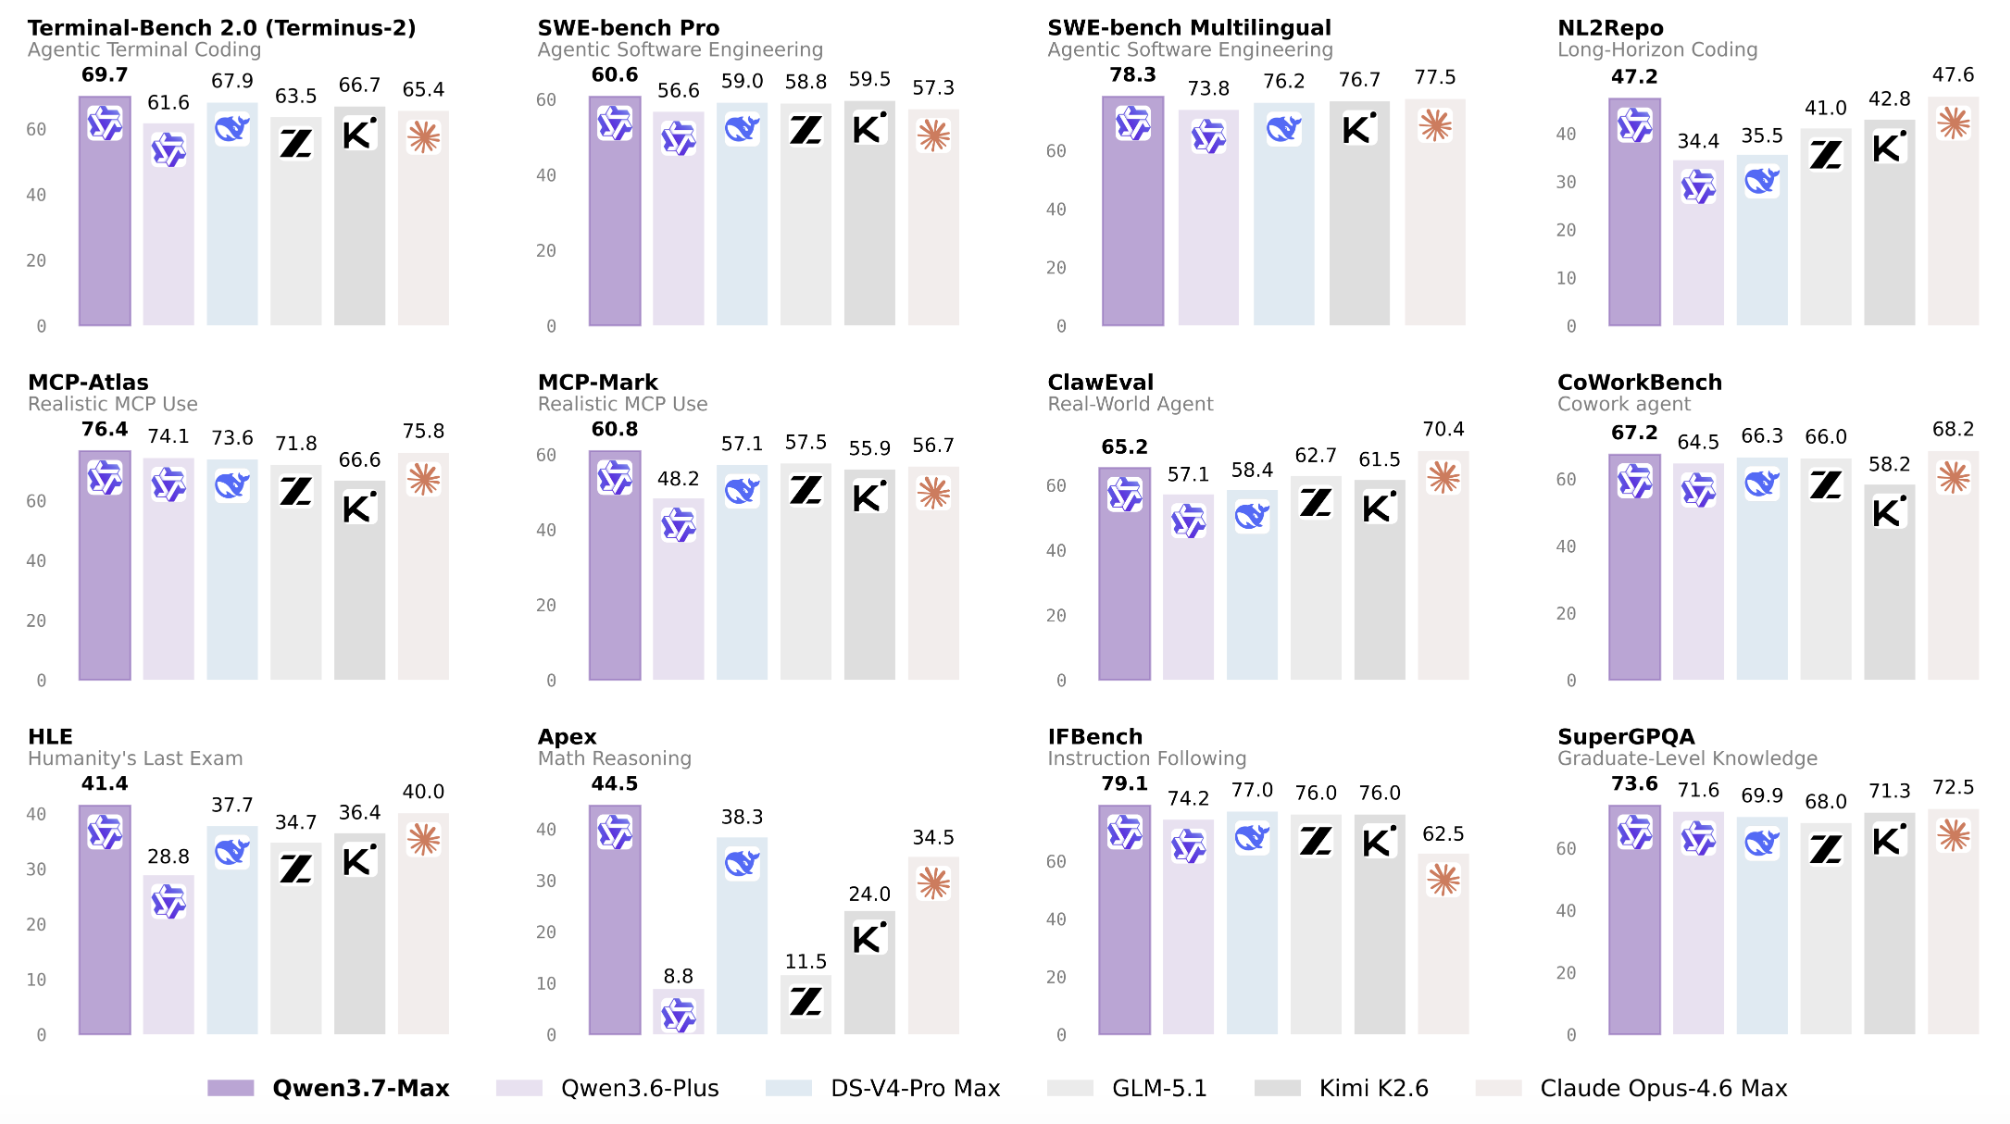
Qwen3.7-Max se evaluó en cuatro grandes categorías: agentes de programación, agentes de propósito general, razonamiento STEM y capacidades generales, incluido el rendimiento multilingüe.
Los resultados provienen de una amplia variedad de andamiajes de agente, lo que los hace más significativos que las cifras de un único andamiaje.
En Terminal Bench 2.0-Terminus, Qwen3.7-Max marca 69,7, por delante de DeepSeek-V4-Pro Max (67,9), Opus-4.6 Max (65,4) y K2.6 Thinking (66,7).
Este benchmark evalúa ingeniería de software autónoma en terminal con un tiempo límite de 5 horas y 12 núcleos de CPU. En SWE-Pro, logra 60,6, la puntuación más alta de la tabla, por delante de K2.6 Thinking (59,5) y DS-V4-Pro Max (59,0).
SWE-Verified es el único benchmark donde Qwen3.7-Max no lidera: obtiene 80,4 frente a 80,8 de Opus-4.6 Max y 80,6 de DS-V4-Pro Max.
La diferencia es pequeña, pero reseñable. En SWE-Multilingual (78,3) y SciCode (53,5), lidera el grupo. En QwenSVG, marca 1608, por delante de los 1605 de GLM-5.1 Thinking y los 1541 de Opus-4.6 Max.
Los resultados de agente general son donde Qwen3.7-Max presenta su argumento más sólido. En MCP-Mark, logra 60,8 frente a 57,5 de GLM-5.1 y 56,7 de Opus-4.6.
En MCP-Atlas, puntúa 76,4, superando ligeramente el 75,8 de Opus-4.6. En Skillsbench, consigue 59,2 frente a 56,2 de K2.6 Thinking. En SpreadSheetBench-v1, obtiene 87,0, solo por detrás del 89,3 de Opus-4.6 Max.
El resultado en Kernel Bench L3 merece mención aparte. Qwen3.7-Max alcanza una aceleración mediana de 1,98x con una tasa de aciertos del 96% (fracción de problemas más rápidos que torch.compile).
Opus-4.6 Max lidera aquí con 2,63x/98%, pero Qwen3.7-Max queda bien por delante de K2.6 Thinking (1,41x/80%), GLM-5.1 (2,00x/78%) y DS-V4-Pro Max (1,07x/54%). En MRCR-v2 128k, que evalúa recuperación en contextos largos, marca 90,4, por delante de Qwen3.6-Plus (85,9) y Opus-4.6 Max (84,0).
GPQA Diamond evalúa preguntas de ciencias a nivel de doctorado. Qwen3.7-Max logra 92,4, por delante de Opus-4.6 Max (91,3), K2.6 Thinking (90,5) y DS-V4-Pro Max (90,1).
En nuestra reseña de GPT-5.5, señalamos que obtuvo un 93,6% en GPQA Diamond, así que GPT-5.5 aún lidera en este benchmark concreto, aunque la comparación directa requiere tener en cuenta las condiciones de evaluación.
En HLE (Humanity's Last Exam), Qwen3.7-Max puntúa 41,4, por delante de Opus-4.6 Max (40,0) y Deepseek-V4-Pro Max (37,7).
En HMMT 2026 Feb (matemática de competición), logra 97,1, la mejor de la tabla, por delante de Opus-4.6 Max (96,2) y DS-V4-Pro Max (95,2).
En IMOAnswerBench, consigue 90,0, superando por poco el 89,8 de DS-V4-Pro Max. En el benchmark Apex, marca 44,5, por delante de 38,3 de DS-V4-Pro Max y 34,5 de Opus-4.6 Max.
Qwen3.7-Max lidera en WMT24++ (85,8 frente a 84,3 de Qwen3.6-Plus y 82,7 de Opus-4.6 Max), que evalúa la calidad de traducción en 55 idiomas. En MAXIFE, logra 89,2, por delante del 88,9 de DS-V4-Pro Max. En PolyMATH, puntúa 86,5, muy por encima del 80,2 de Opus-4.6 Max y el 82,7 de K2.6 Thinking.
El rendimiento multilingüe es una fortaleza constante en la línea Qwen3.x, y Qwen3.7-Max amplía esa ventaja.
Qwen3.7-Max está disponible a través de Alibaba Cloud Model Studio, con acceso por API mediante endpoints compatibles con OpenAI y con Anthropic. El ID del modelo es qwen3.7-max.
En el momento de escribir estas líneas, Artificial Analysis indica un precio de entrada y salida de 2,50 $ por 1 M de tokens de entrada y 7,50 $ para la salida.
La alta verbosidad señalada por Artificial Analysis (97 M de tokens generados en su evaluación frente a una mediana de 24 M) implica que los costes efectivos en sesiones agentivas largas pueden ser significativamente superiores a lo que sugieren las tarifas por token.
Para desarrolladores, el modelo admite la función preserve_thinking, que conserva el contenido de pensamiento de todos los turnos previos en conversaciones multi-turno. El equipo de Qwen recomienda activarla para tareas agentivas. La integración con Claude Code, OpenClaw y Qwen Code está soportada de serie, con ejemplos de configuración en la documentación oficial.
Qwen3.7-Max es una apuesta seria en la parte alta del mercado de modelos con capacidades de agente. Sus números en benchmarks son sólidos en todos los frentes, y la demostración de optimización de kernel durante 35 horas es el tipo de resultado concreto y verificable que cuesta más desestimar que una posición en un ránquin.
La historia de generalización entre harnesses también es creíble: entrenar con configuraciones diversas es un enfoque con fundamento al problema del sobreajuste al andamiaje, y el rendimiento consistente en Claude Code, OpenClaw y Qwen Code lo respalda.
Donde sería prudente es en la verbosidad. Un modelo que genera 97 M de tokens en una batería estándar de evaluación va a costar bastante más en la práctica de lo que su tarifa por token sugiere, sobre todo en sesiones agentivas largas, que son su principal caso de uso.
Los equipos que construyan sobre Qwen3.7-Max deberían presupuestar con cuidado y probar con límites explícitos de salida antes de comprometerse con cargas de trabajo en producción.
Si quieres construir sobre modelos como Qwen3.7-Max o entender mejor el panorama de la IA agentiva, te recomiendo el itinerario de aprendizaje AI Fundamentals en DataCamp para ponerte al día con los conceptos que sustentan estos sistemas.
Los cursos destacados de DataCamp
Programa
Curso
Curso
blog
Abid Ali Awan
8 min
blog
Tutorial
Moez Ali
11 min
Tutorial
Zoumana Keita
15 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Zoumana Keita
12 min