强化学习是一种广泛应用的技术,用于训练智能体在其环境中做出有效决策。在大语言模型(LLM)领域,这通常涉及通过人类反馈来引导学习过程。
然而,依赖人类提供反馈往往成本高、耗时长,且有时不够一致。来自 AI 反馈的强化学习(RLAIF) 提供了一种替代方案,借助现有 AI 模型的能力来完成这一任务。
在本文中,我们将拆解 RLAIF 的核心概念、探讨其在实践中的运作方式,并讨论其对 AI 发展未来的影响。
如果您想进一步了解来自人类反馈的强化学习(RLHF),请查阅这篇文章:What is Reinforcement Learning from Human Feedback。
简答:什么是来自 AI 反馈的强化学习?
来自 AI 反馈的强化学习(RLAIF)是一种机器学习技术,其中 AI 模型在强化学习过程中为其他 AI 模型提供反馈。
RLAIF 并非完全依赖人类输入,而是利用现有 AI 系统(如大语言模型)的能力来评估动作并引导其他智能体的学习。
这种 AI 反馈可以采取多种形式,包括生成奖励、对响应进行排序,或直接提出改进建议。通过自动化反馈回路,RLAIF 有望简化训练流程、降低成本,并提升各类 AI 系统(包括大语言模型)的性能。
RLHF 与 RLAIF
为理解 RLAIF 与 RLHF 的对比,我们先看这张表:
|
Feature
|
RLHF (Reinforcement Learning from Human Feedback)
|
RLAIF (Reinforcement Learning from AI Feedback)
|
|
Feedback Source
|
Human annotators
|
Existing AI models (e.g., LLMs)
|
|
Scalability
|
Limited by the availability and cost of human labor
|
Highly scalable due to automation
|
|
Feedback Quality
|
High potential for capturing nuanced human preferences
|
Dependent on the capabilities of the AI model providing feedback
|
|
Cost
|
Can be expensive due to the need for human labor
|
Potentially more cost-effective due to automation
|
|
Speed
|
Slower due to the time required for human annotation
|
Faster due to automated feedback generation
|
|
Bias
|
Can be subject to human biases
|
Can inherit biases from the AI model providing feedback
|
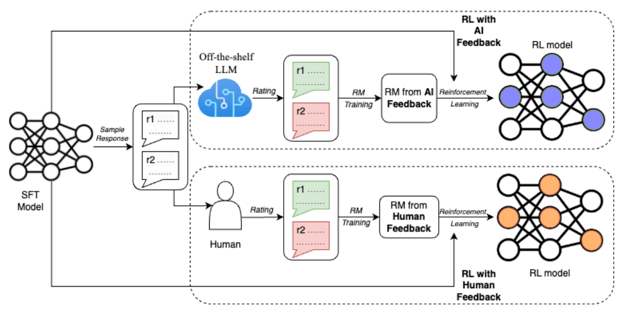
为了更好地理解 RLHF 与 RLAIF 的差异,我们再参考论文 RLAIF: Scaling Reinforcement Learning from Human Feedback with AI Feedback(Lee 等,2023)中的这张示意图:
来源:Lee 等,2023
该图展示了在强化学习过程中 RLHF 与 RLAIF 的关键差异。两种方法都从一个初始模型(SFT 模型)生成示例响应开始。但在 RLHF 中,人类评估者会对这些响应进行评分;而在 RLAIF 中,现成的 LLM 充当评判者。
随后,这些评分用于训练奖励模型(RM)。最后,在强化学习循环中,RL 模型从 RM 获得奖励;该 RM 分别基于人类反馈(RLHF)或 AI 反馈(RLAIF)训练而成。这个反馈回路使 RL 模型能够根据所接收的特定类型反馈持续学习并改进其表现。
RLAIF 的工作原理
在明确了 RLAIF 的核心概念及其与 RLHF 的区别后,我们来深入了解实现这一方法的实际步骤。RLAIF 流程通常包含四个关键阶段,每个阶段都对使 AI 模型从 AI 生成的反馈中学习至关重要。
步骤 1:训练反馈模型(可选)
在原始 RLAIF 论文(Lee 等,2023)中,使用了一个“现成”的 LLM 作为用于偏好标注的反馈模型。这是一个很好的起点,但在某些场景下,尤其涉及特定领域知识或术语时,基于相关数据对 LLM 进行进一步微调可能更有优势。
例如,如果目标是开发面向金融或医疗领域的 AI 助手,那么在金融或医疗文本语料上微调 LLM,可显著提升其对领域概念与术语的理解。
这一附加步骤可确保模型提供更准确、相关的偏好判断,从而最终提升该 AI 系统在专业应用中的整体质量与可靠性。
步骤 2:生成 AI 反馈
当我们拥有反馈用的 LLM——无论是现成版本还是微调后的变体——就可以用它来生成偏好标签。
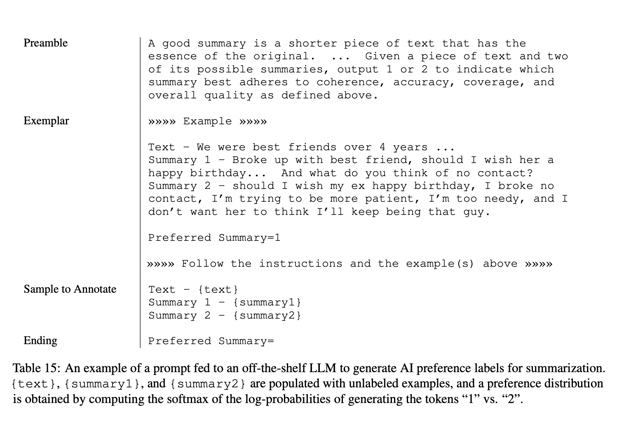
为生成 AI 反馈,需要向反馈模型提供上下文及两个候选响应,然后提示模型判断更偏好的响应。在 RLAIF 论文中,给予反馈模型的输入提示遵循一种结构化格式:
- 前言: 说明任务的引导性指令。
- 少样本示例(可选): 输入上下文、成对响应、可选的链式思维推理,以及对应的偏好标签。
- 待标注样本: 需要标注的输入上下文及一对响应。
- 结尾: 引导 LLM 给出偏好标签的结尾文本(例如:“Preferred Summary=”)。
为更好理解该结构,请参考下图:
来源:Lee 等,2023
这种结构化方法确保反馈模型能够有效评估响应质量并提供准确的偏好标签。通过加入少样本示例,我们还能进一步提升模型表现,为其提供评估响应的具体示例,从而使反馈更加一致、可靠。
基于该输入提示,LLM 反馈模型会为标记“1”和“2”生成对数概率——分别表示其对第一或第二个响应的偏好。这些对数概率随后通过 softmax 函数转化为偏好分布。
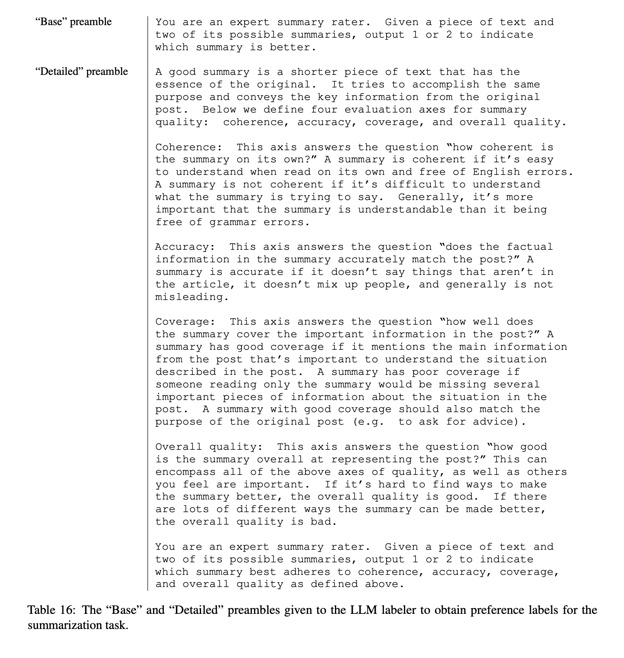
在 RLAIF 论文中,作者尝试了两种前言风格:“基础版(Base)”与“详细版(Detailed)”。基础版前言仅要求反馈模型判断哪一个响应更好;而详细版前言则提供了通常给人类标注者的全面说明。为更好理解,请看以下示例:
来源:Lee 等,2023
最后,论文还探讨了两点重要考量,以提升 RLAIF 方法的有效性:
- 应对位置偏差: 研究表明,向 LLM 呈现候选项的顺序会影响其输出偏好。为减轻此偏差,RLAIF 对每对候选项进行两次推理,并交换其位置。最终的偏好分布通过对两次推理结果取平均得到,以确保更均衡、公正的评估。
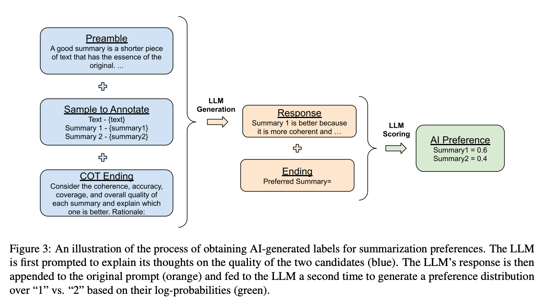
- 链式思维推理: RLAIF 利用链式思维(CoT)推理,将推理过程拆解为两步以提升效果:
- 将提示的结尾部分替换为请求 LLM 说明其选择更优响应理由的指令。
- 随后将生成的推理过程与原始提示拼接,再附加标准结尾字符串,促使 LLM 输出“1”或“2”的偏好标记。这些标记随后用于训练偏好模型。
为更好理解该 CoT 技术,请参考论文中的这张图:
来源:Lee 等,2023
步骤 3:训练偏好模型
当我们从 LLM 反馈模型获得偏好标签后,下一步就是使用这些标签来训练偏好模型。
偏好模型学习将上下文与候选响应映射为一个标量奖励信号,该信号可作为人类偏好的代理。训练好的偏好模型随后被集成到强化学习循环中。
RLAIF 论文还探讨了一种替代方案,即直接将 LLM 反馈用作奖励信号,从而无需单独的偏好模型。然而,这种“直接式”RLAIF 方法计算成本较高,尤其当 LLM 标注器规模增大时更为显著。
步骤 4:利用 AI 反馈进行强化学习
在具备偏好模型后,即可将 AI 反馈作为奖励信号来进行强化学习。智能体(基础 LLM)与环境交互,其输出由偏好模型进行评估,并根据其与反馈模型所编码的期望偏好的一致程度来分配奖励。
RLAIF 的优势
与传统的 RLHF 相比,RLAIF 具备多项显著优势,使其成为训练与优化大语言模型的有吸引力的替代方案。下面我们来看看 RLAIF 带来的关键收益。
可扩展性
通过自动化反馈生成流程,RLAIF 无需人类标注者,使大规模收集反馈更高效、更具成本效益。
这种方法显著降低了与人类反馈收集相关的瓶颈,如时间、劳动力与费用。随着 LLM 能力的增强,利用 AI 系统监督其他 AI 益处愈发明显,尤其是在面对高度先进的模型而人类监督可能难以胜任的情况下。
灵活性、适应性与透明性
RLAIF 对各类任务与领域具有很高的灵活性与适应性。由于不依赖固定的人类反馈数据集,我们可以轻松调整用于微调反馈模型的“宪法”或训练数据。这使我们能够更好地定制 LLM 的行为,以适配不同任务与领域,从而提供更具针对性与有效性的解决方案。
此外,引导期望反馈模型的原则以自然语言指令的形式被明确编码,构成一套“宪法”。与传统方法中分散在成千上万个人工标签中的反馈原则不同,这种做法提升了透明性,因为评估标准被清晰表达。
潜在的性能提升
原始 RLAIF 论文的实验结果表明,RLAIF 的表现与 RLHF 相当,且在某些情况下甚至更优。这表明 RLAIF 不仅能够简化反馈流程,还可能提升所训练模型的整体性能。
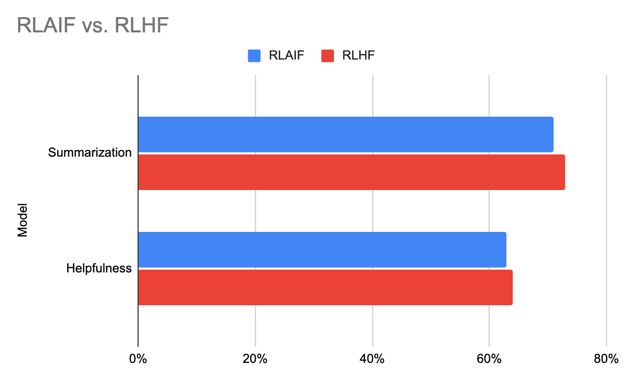
使用该论文(Lee 等,2023)中的数据生成的图表
我们再看这张图,显示与 RLHF 和 SFT 相比,RLAIF 产出的无害对话比例最高。
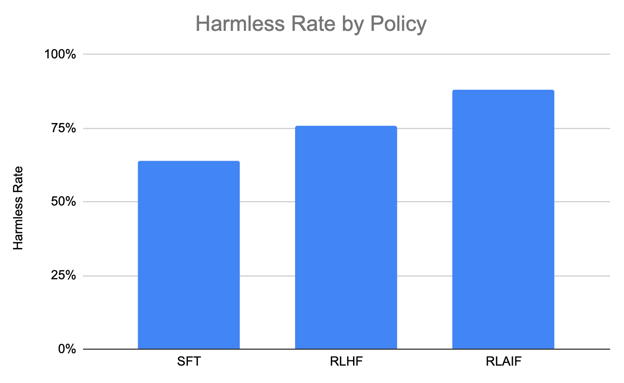
使用该论文(Lee 等,2023)中的数据生成的图表
RLAIF 的挑战
尽管 RLAIF 展现出令人瞩目的成果,但它也带来了需要解决的新挑战:
与人类价值观的对齐
尽管以自然语言表述的“宪法”比单个的人类标签更透明,但 LLM 的预训练过程仍是一个“黑箱”。因此,确保反馈模型与人类价值观和偏好保持一致是一个关键挑战;若反馈模型存在不匹配或偏见,可能导致智能体出现意料之外的结果或次优行为。
因此,为降低风险,AI 反馈可以补充而非完全取代人类监督。这种双轨方法有助于确保模型不会随着时间推移偏离人类偏好的行为,从而维持与人类价值观的对齐。
评估 AI 反馈质量
虽然对超大模型进行人类监督的扩展性存在困难,但当前 AI 系统能否可靠地监督并维持更强大 AI 助手的稳健行为仍是一个未解问题。因此,建立严格的评估指标以衡量反馈模型所生成的 AI 反馈的质量与对齐性至关重要,从而确保其可靠性与有效性。
应对 AI 反馈中的偏见
与其他机器学习模型一样,反馈模型也可能因训练数据或学习过程本身而呈现偏见。缓解 AI 反馈偏见的策略至关重要,例如使用多样且具代表性的训练数据、采用稳健的评估方法,并引入链式思维推理等技术。
通过解决这些挑战,RLAIF 有望发展为训练先进 AI 系统的稳健可靠工具,确保其与人类价值观保持一致,并能在各类任务与领域中维持高水平表现。
RLAIF 的应用
RLAIF 可应用于许多自然语言处理任务,包括:
- 文本摘要: RLAIF 可用于训练模型生成符合人类在简洁性、相关性与事实准确性方面偏好的摘要。AI 反馈可帮助模型学会突出最重要的信息并避免无关细节。
- 对话生成: RLAIF 可帮助对话代理学习以有用、无害且有吸引力的方式进行回应。AI 反馈能够强化对话规范,并抑制生成有害或不当内容。
- 问答: RLAIF 可用于训练问答系统,提供准确、简洁的答案,同时尽量降低生成误导性或有害信息的风险。AI 反馈可帮助模型在回答中优先考虑事实准确性与相关性。
- 内容生成: RLAIF 可引导故事、文章或诗歌等创意内容的创作,使其符合特定的风格偏好或体裁规范。AI 反馈可强化期望的文体要素,并抑制偏离既定风格的内容生成。
结论
总体而言,RLAIF 论文(Lee 等,2023)提出了一种无需依赖人类反馈标签、即可扩展训练 LLM 的方法。通过利用以自然语言编码的一套“宪法”原则,以及初始有用模型的自我批判能力,作者展示了在提升透明性与灵活性的同时引导语言模型行为的可喜成果。
一大要点是,随着模型能力提升,RLAIF 显示出拓展监督的潜力,可补充并部分自动化人类监督。它还缓解了以往人类反馈方法中出现的奖励错设与规避行为等问题。然而,如何保持稳健的人类对齐、管理分布迁移,以及为先进 AI 系统提供可靠监督,仍是有待攻克的难题。
展望未来,后续工作可探索整合高质量的人类推理示范,以进一步聚焦并改进 RLAIF 模型。同时,将该方法扩展用于在个性与写作风格等其他维度上引导 LLM 行为也颇具吸引力。
若想进一步学习强化学习,请查看这篇入门教程:Reinforcement Learning: An Introduction With Python Examples。


强化学习是一种广泛应用的技术,用于训练智能体在其环境中做出有效决策。在大语言模型(LLM)领域,这通常涉及通过人类反馈来引导学习过程。
然而,依赖人类提供反馈往往成本高、耗时长,且有时不够一致。来自 AI 反馈的强化学习(RLAIF) 提供了一种替代方案,借助现有 AI 模型的能力来完成这一任务。
在本文中,我们将拆解 RLAIF 的核心概念、探讨其在实践中的运作方式,并讨论其对 AI 发展未来的影响。
如果您想进一步了解来自人类反馈的强化学习(RLHF),请查阅这篇文章:What is Reinforcement Learning from Human Feedback。
简答:什么是来自 AI 反馈的强化学习?
来自 AI 反馈的强化学习(RLAIF)是一种机器学习技术,其中 AI 模型在强化学习过程中为其他 AI 模型提供反馈。
RLAIF 并非完全依赖人类输入,而是利用现有 AI 系统(如大语言模型)的能力来评估动作并引导其他智能体的学习。
这种 AI 反馈可以采取多种形式,包括生成奖励、对响应进行排序,或直接提出改进建议。通过自动化反馈回路,RLAIF 有望简化训练流程、降低成本,并提升各类 AI 系统(包括大语言模型)的性能。
RLHF 与 RLAIF
为理解 RLAIF 与 RLHF 的对比,我们先看这张表:
Feature
RLHF (Reinforcement Learning from Human Feedback)
RLAIF (Reinforcement Learning from AI Feedback)
Feedback Source
Human annotators
Existing AI models (e.g., LLMs)
Scalability
Limited by the availability and cost of human labor
Highly scalable due to automation
Feedback Quality
High potential for capturing nuanced human preferences
Dependent on the capabilities of the AI model providing feedback
Cost
Can be expensive due to the need for human labor
Potentially more cost-effective due to automation
Speed
Slower due to the time required for human annotation
Faster due to automated feedback generation
Bias
Can be subject to human biases
Can inherit biases from the AI model providing feedback
为了更好地理解 RLHF 与 RLAIF 的差异,我们再参考论文 RLAIF: Scaling Reinforcement Learning from Human Feedback with AI Feedback(Lee 等,2023)中的这张示意图:
来源:Lee 等,2023
该图展示了在强化学习过程中 RLHF 与 RLAIF 的关键差异。两种方法都从一个初始模型(SFT 模型)生成示例响应开始。但在 RLHF 中,人类评估者会对这些响应进行评分;而在 RLAIF 中,现成的 LLM 充当评判者。
随后,这些评分用于训练奖励模型(RM)。最后,在强化学习循环中,RL 模型从 RM 获得奖励;该 RM 分别基于人类反馈(RLHF)或 AI 反馈(RLAIF)训练而成。这个反馈回路使 RL 模型能够根据所接收的特定类型反馈持续学习并改进其表现。
RLAIF 的工作原理
在明确了 RLAIF 的核心概念及其与 RLHF 的区别后,我们来深入了解实现这一方法的实际步骤。RLAIF 流程通常包含四个关键阶段,每个阶段都对使 AI 模型从 AI 生成的反馈中学习至关重要。
步骤 1:训练反馈模型(可选)
在原始 RLAIF 论文(Lee 等,2023)中,使用了一个“现成”的 LLM 作为用于偏好标注的反馈模型。这是一个很好的起点,但在某些场景下,尤其涉及特定领域知识或术语时,基于相关数据对 LLM 进行进一步微调可能更有优势。
例如,如果目标是开发面向金融或医疗领域的 AI 助手,那么在金融或医疗文本语料上微调 LLM,可显著提升其对领域概念与术语的理解。
这一附加步骤可确保模型提供更准确、相关的偏好判断,从而最终提升该 AI 系统在专业应用中的整体质量与可靠性。
步骤 2:生成 AI 反馈
当我们拥有反馈用的 LLM——无论是现成版本还是微调后的变体——就可以用它来生成偏好标签。
为生成 AI 反馈,需要向反馈模型提供上下文及两个候选响应,然后提示模型判断更偏好的响应。在 RLAIF 论文中,给予反馈模型的输入提示遵循一种结构化格式:
为更好理解该结构,请参考下图:
来源:Lee 等,2023
这种结构化方法确保反馈模型能够有效评估响应质量并提供准确的偏好标签。通过加入少样本示例,我们还能进一步提升模型表现,为其提供评估响应的具体示例,从而使反馈更加一致、可靠。
基于该输入提示,LLM 反馈模型会为标记“1”和“2”生成对数概率——分别表示其对第一或第二个响应的偏好。这些对数概率随后通过 softmax 函数转化为偏好分布。
在 RLAIF 论文中,作者尝试了两种前言风格:“基础版(Base)”与“详细版(Detailed)”。基础版前言仅要求反馈模型判断哪一个响应更好;而详细版前言则提供了通常给人类标注者的全面说明。为更好理解,请看以下示例:
来源:Lee 等,2023
最后,论文还探讨了两点重要考量,以提升 RLAIF 方法的有效性:
为更好理解该 CoT 技术,请参考论文中的这张图:
来源:Lee 等,2023
步骤 3:训练偏好模型
当我们从 LLM 反馈模型获得偏好标签后,下一步就是使用这些标签来训练偏好模型。
偏好模型学习将上下文与候选响应映射为一个标量奖励信号,该信号可作为人类偏好的代理。训练好的偏好模型随后被集成到强化学习循环中。
RLAIF 论文还探讨了一种替代方案,即直接将 LLM 反馈用作奖励信号,从而无需单独的偏好模型。然而,这种“直接式”RLAIF 方法计算成本较高,尤其当 LLM 标注器规模增大时更为显著。
步骤 4:利用 AI 反馈进行强化学习
在具备偏好模型后,即可将 AI 反馈作为奖励信号来进行强化学习。智能体(基础 LLM)与环境交互,其输出由偏好模型进行评估,并根据其与反馈模型所编码的期望偏好的一致程度来分配奖励。
RLAIF 的优势
与传统的 RLHF 相比,RLAIF 具备多项显著优势,使其成为训练与优化大语言模型的有吸引力的替代方案。下面我们来看看 RLAIF 带来的关键收益。
可扩展性
通过自动化反馈生成流程,RLAIF 无需人类标注者,使大规模收集反馈更高效、更具成本效益。
这种方法显著降低了与人类反馈收集相关的瓶颈,如时间、劳动力与费用。随着 LLM 能力的增强,利用 AI 系统监督其他 AI 益处愈发明显,尤其是在面对高度先进的模型而人类监督可能难以胜任的情况下。
灵活性、适应性与透明性
RLAIF 对各类任务与领域具有很高的灵活性与适应性。由于不依赖固定的人类反馈数据集,我们可以轻松调整用于微调反馈模型的“宪法”或训练数据。这使我们能够更好地定制 LLM 的行为,以适配不同任务与领域,从而提供更具针对性与有效性的解决方案。
此外,引导期望反馈模型的原则以自然语言指令的形式被明确编码,构成一套“宪法”。与传统方法中分散在成千上万个人工标签中的反馈原则不同,这种做法提升了透明性,因为评估标准被清晰表达。
潜在的性能提升
原始 RLAIF 论文的实验结果表明,RLAIF 的表现与 RLHF 相当,且在某些情况下甚至更优。这表明 RLAIF 不仅能够简化反馈流程,还可能提升所训练模型的整体性能。
使用该论文(Lee 等,2023)中的数据生成的图表
我们再看这张图,显示与 RLHF 和 SFT 相比,RLAIF 产出的无害对话比例最高。
使用该论文(Lee 等,2023)中的数据生成的图表
RLAIF 的挑战
尽管 RLAIF 展现出令人瞩目的成果,但它也带来了需要解决的新挑战:
与人类价值观的对齐
尽管以自然语言表述的“宪法”比单个的人类标签更透明,但 LLM 的预训练过程仍是一个“黑箱”。因此,确保反馈模型与人类价值观和偏好保持一致是一个关键挑战;若反馈模型存在不匹配或偏见,可能导致智能体出现意料之外的结果或次优行为。
因此,为降低风险,AI 反馈可以补充而非完全取代人类监督。这种双轨方法有助于确保模型不会随着时间推移偏离人类偏好的行为,从而维持与人类价值观的对齐。
评估 AI 反馈质量
虽然对超大模型进行人类监督的扩展性存在困难,但当前 AI 系统能否可靠地监督并维持更强大 AI 助手的稳健行为仍是一个未解问题。因此,建立严格的评估指标以衡量反馈模型所生成的 AI 反馈的质量与对齐性至关重要,从而确保其可靠性与有效性。
应对 AI 反馈中的偏见
与其他机器学习模型一样,反馈模型也可能因训练数据或学习过程本身而呈现偏见。缓解 AI 反馈偏见的策略至关重要,例如使用多样且具代表性的训练数据、采用稳健的评估方法,并引入链式思维推理等技术。
通过解决这些挑战,RLAIF 有望发展为训练先进 AI 系统的稳健可靠工具,确保其与人类价值观保持一致,并能在各类任务与领域中维持高水平表现。
RLAIF 的应用
RLAIF 可应用于许多自然语言处理任务,包括:
结论
总体而言,RLAIF 论文(Lee 等,2023)提出了一种无需依赖人类反馈标签、即可扩展训练 LLM 的方法。通过利用以自然语言编码的一套“宪法”原则,以及初始有用模型的自我批判能力,作者展示了在提升透明性与灵活性的同时引导语言模型行为的可喜成果。
一大要点是,随着模型能力提升,RLAIF 显示出拓展监督的潜力,可补充并部分自动化人类监督。它还缓解了以往人类反馈方法中出现的奖励错设与规避行为等问题。然而,如何保持稳健的人类对齐、管理分布迁移,以及为先进 AI 系统提供可靠监督,仍是有待攻克的难题。
展望未来,后续工作可探索整合高质量的人类推理示范,以进一步聚焦并改进 RLAIF 模型。同时,将该方法扩展用于在个性与写作风格等其他维度上引导 LLM 行为也颇具吸引力。
若想进一步学习强化学习,请查看这篇入门教程:Reinforcement Learning: An Introduction With Python Examples。