Cours
Reinforcement Learning avec Gymnasium en Python
4 h
13.6K
L’apprentissage par renforcement est une technique largement utilisée pour entraîner des agents intelligents à prendre des décisions efficaces dans leur environnement. Dans le domaine des grands modèles de langage (LLM), cela implique souvent d’orienter l’apprentissage à l’aide de retours humains.
Cependant, s’appuyer sur des humains pour fournir ces retours peut s’avérer coûteux, chronophage et parfois incohérent. Le reinforcement learning from AI feedback (RLAIF) propose une alternative en exploitant la puissance de modèles d’IA existants.
Dans cet article, nous décryptons les concepts clés du RLAIF, expliquons son fonctionnement concret et discutons de ses implications pour l’avenir du développement de l’IA.
Pour en savoir plus sur le reinforcement learning from human feedback (RLHF), consultez cet article : What is Reinforcement Learning from Human Feedback.
Le reinforcement learning from AI feedback (RLAIF) est une technique d’apprentissage automatique où des modèles d’IA fournissent un retour à d’autres modèles d’IA pendant le processus d’apprentissage par renforcement.
Au lieu de s’en remettre uniquement à l’intervention humaine, le RLAIF met à profit les capacités de systèmes d’IA existants, comme les LLM, pour évaluer des actions et guider l’apprentissage d’autres agents.
Ce retour peut prendre différentes formes : génération de récompenses, classement de réponses ou suggestions d’amélioration. En automatisant la boucle de retour, le RLAIF a le potentiel de fluidifier l’entraînement, de réduire les coûts et d’améliorer les performances de divers systèmes d’IA, y compris les LLM.
Pour comprendre comment le RLAIF se compare au RLHF, partons de ce tableau :
|
Caractéristique |
RLHF (Reinforcement Learning from Human Feedback) |
RLAIF (Reinforcement Learning from AI Feedback) |
|
Source du retour |
Annotateurs humains |
Modèles d’IA existants (p. ex. : LLM) |
|
Passage à l’échelle |
Limité par la disponibilité et le coût du travail humain |
Très scalable grâce à l’automatisation |
|
Qualité du retour |
Forte capacité à capturer des préférences humaines nuancées |
Dépend des capacités du modèle d’IA fournissant le retour |
|
Coût |
Potentiellement élevé en raison du recours à l’humain |
Potentiellement plus économique grâce à l’automatisation |
|
Vitesse |
Plus lent à cause du temps d’annotation humaine |
Plus rapide grâce à la génération automatique de retours |
|
Biais |
Peut refléter des biais humains |
Peut hériter des biais du modèle d’IA évaluateur |
Pour mieux saisir les différences entre RLHF et RLAIF, considérons aussi ce schéma de l’article RLAIF: Scaling Reinforcement Learning from Human Feedback with AI Feedback (Lee et al., 2023) :
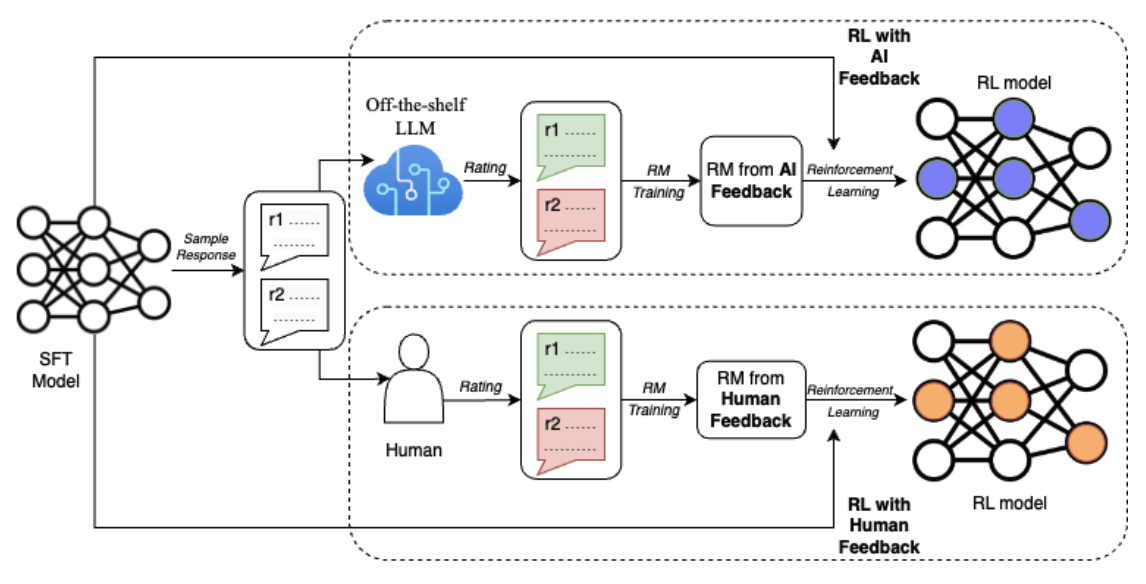
Source : Lee et al., 2023
Le schéma illustre la différence clé entre RLHF et RLAIF dans le processus d’apprentissage par renforcement. Les deux approches commencent par un modèle initial (modèle SFT) qui génère des réponses. Cependant, dans le RLHF, des évaluateurs humains notent ces réponses, tandis que dans le RLAIF, un LLM prêt à l’emploi sert de juge.
Ces notes servent ensuite à entraîner un modèle de récompense (RM). Enfin, dans la boucle d’apprentissage par renforcement, le modèle RL reçoit des récompenses du RM, entraîné soit sur des retours humains (RLHF), soit sur des retours d’IA (RLAIF). Cette boucle de retour permet au modèle RL d’apprendre en continu et d’améliorer ses performances en fonction du type de retour reçu.
Maintenant que nous avons posé les bases du RLAIF et de sa différenciation avec le RLHF, examinons les étapes pratiques pour le mettre en œuvre. Le processus RLAIF comporte généralement quatre étapes clés, chacune jouant un rôle essentiel pour permettre aux modèles d’IA d’apprendre à partir de retours générés par l’IA.
Dans l’article RLAIF original (Lee et al., 2023), un LLM « off-the-shelf » a été utilisé comme modèle de retour pour l’étiquetage des préférences. C’est un bon point de départ, mais dans certains cas, notamment avec des domaines spécifiques, il peut être avantageux d’affiner davantage le LLM sur des données pertinentes.
Par exemple, si l’objectif est de développer un assistant d’IA pour la finance ou la médecine, affiner le LLM sur un corpus de textes financiers ou médicaux peut considérablement améliorer sa compréhension des concepts et du jargon du domaine.
Cette étape supplémentaire permet au modèle de rendre des jugements de préférence plus précis et pertinents, améliorant in fine la qualité et la fiabilité globales du système d’IA dans des applications spécialisées.
Une fois notre modèle de retour prêt — qu’il soit « off-the-shelf » ou affuté — nous pouvons l’utiliser pour générer des étiquettes de préférence.
Pour produire le retour d’IA, on présente au modèle de retour le contexte et deux réponses candidates. Le modèle est ensuite invité à déterminer quelle réponse est préférée. Dans l’article RLAIF, l’invite d’entrée du modèle de retour suit un format structuré :
Pour mieux comprendre cette structure, voyez l’illustration ci-dessous :
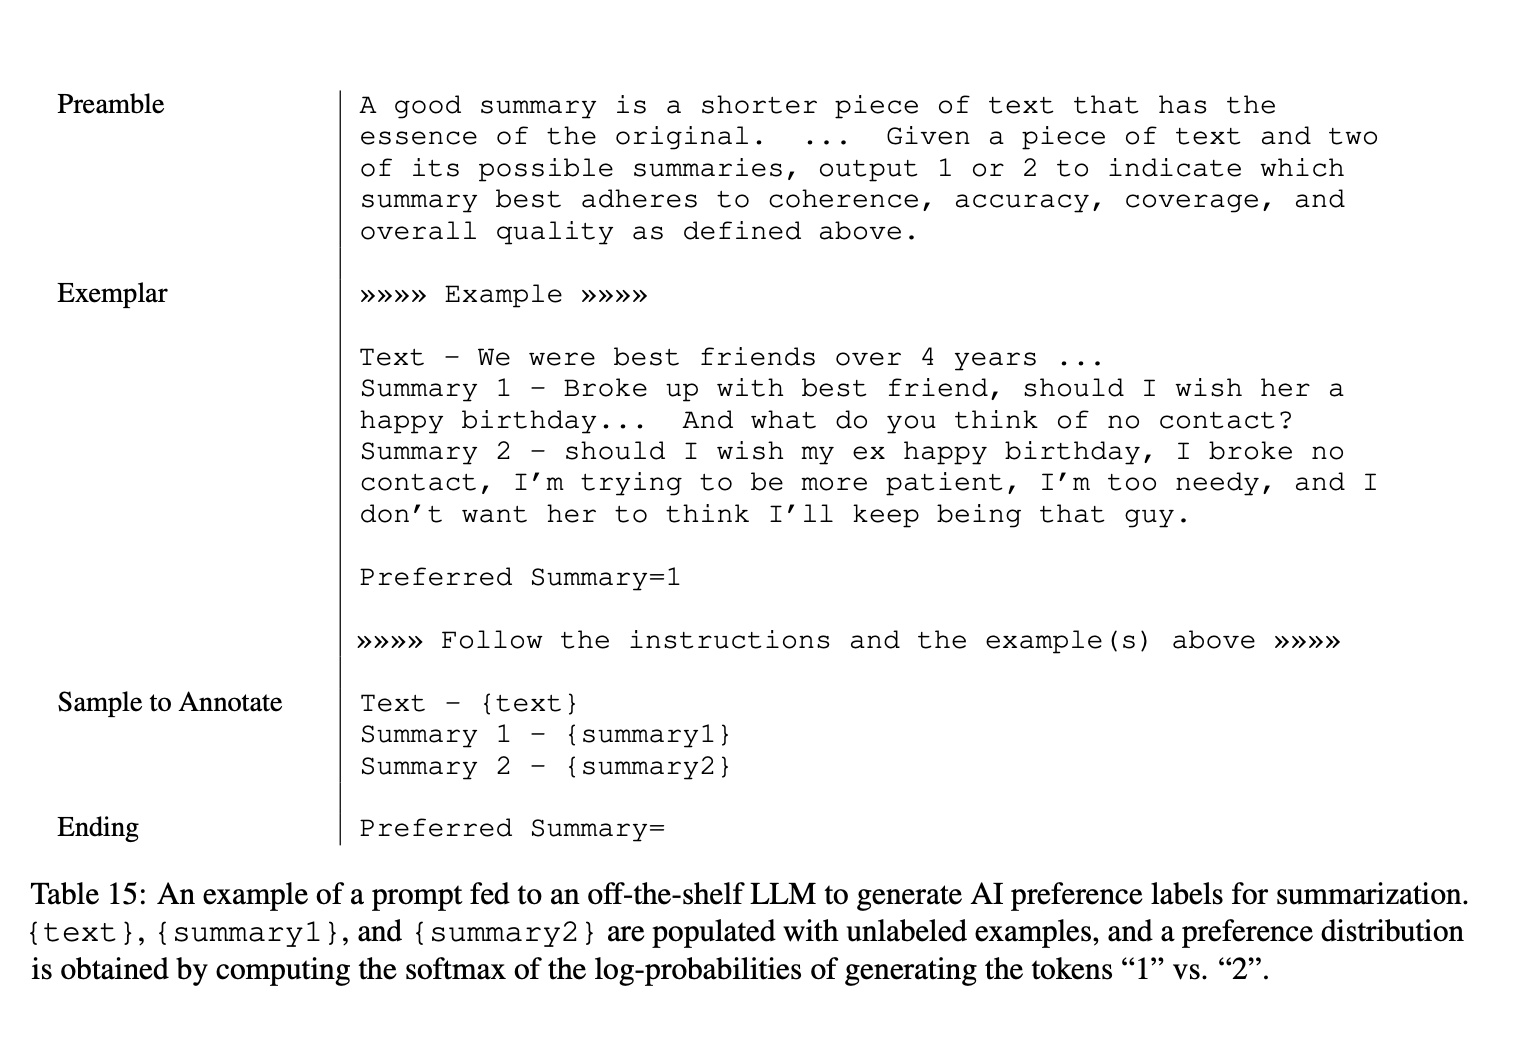
Source : Lee et al., 2023
Cette approche structurée aide le modèle de retour à évaluer efficacement la qualité des réponses et à fournir des étiquettes fiables. En ajoutant des exemples few-shot, on améliore encore ses performances, avec des cas concrets d’évaluation qui rendent le retour plus cohérent.
Avec cette invite, le modèle de retour LLM génère les log-probabilités des jetons « 1 » et « 2 » — représentant la préférence pour la première ou la seconde réponse. Ces log-probabilités sont ensuite passées dans une fonction softmax pour obtenir une distribution de préférence.
Dans l’article RLAIF, deux styles de préambules sont testés : « Base » et « Détaillé ». Un préambule Base demande simplement d’indiquer la meilleure réponse, tandis qu’un préambule Détaillé fournit des consignes exhaustives, comme celles données à des annotateurs humains. Exemple :
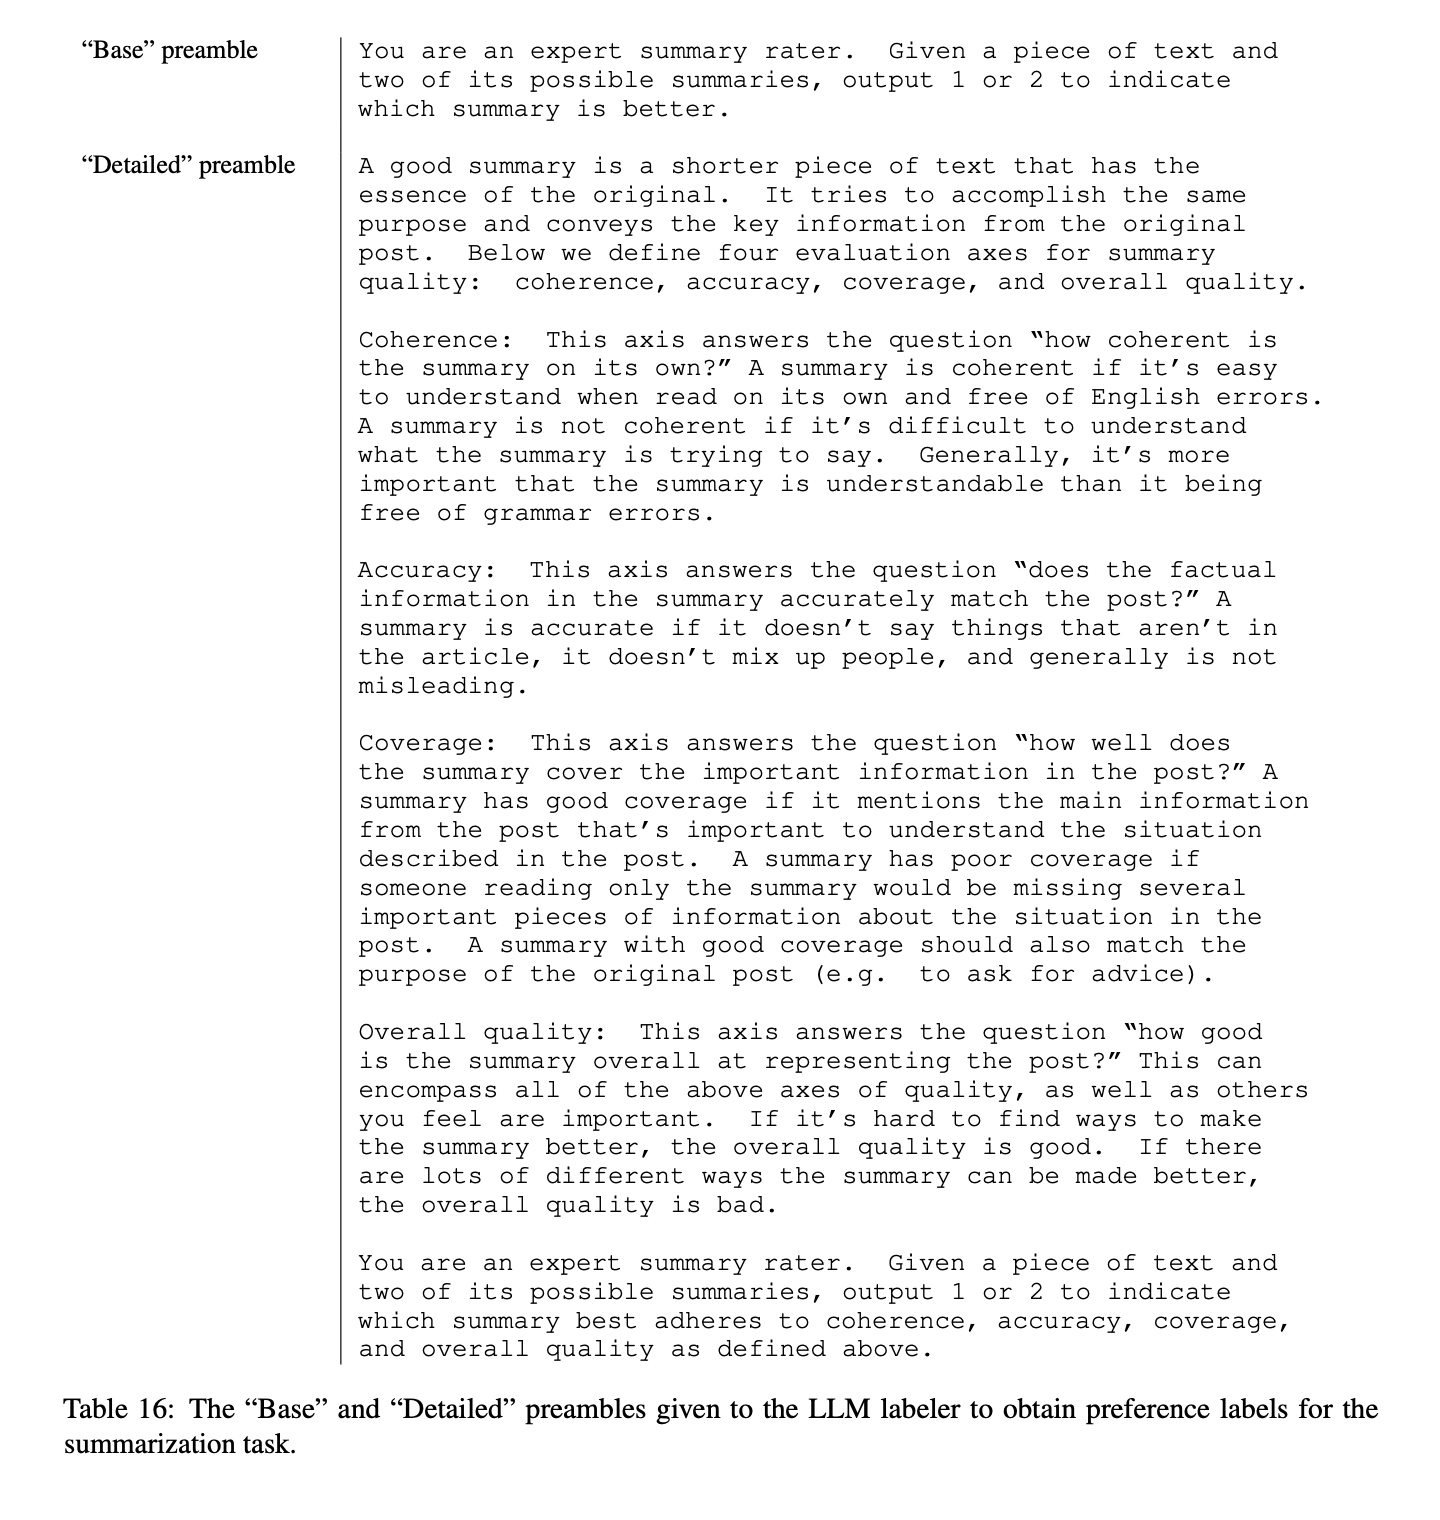
Source : Lee et al., 2023
Enfin, deux points importants ont été explorés pour renforcer l’efficacité de la méthode RLAIF :
Pour mieux comprendre cette technique CoT, voyez ce schéma tiré de l’article :
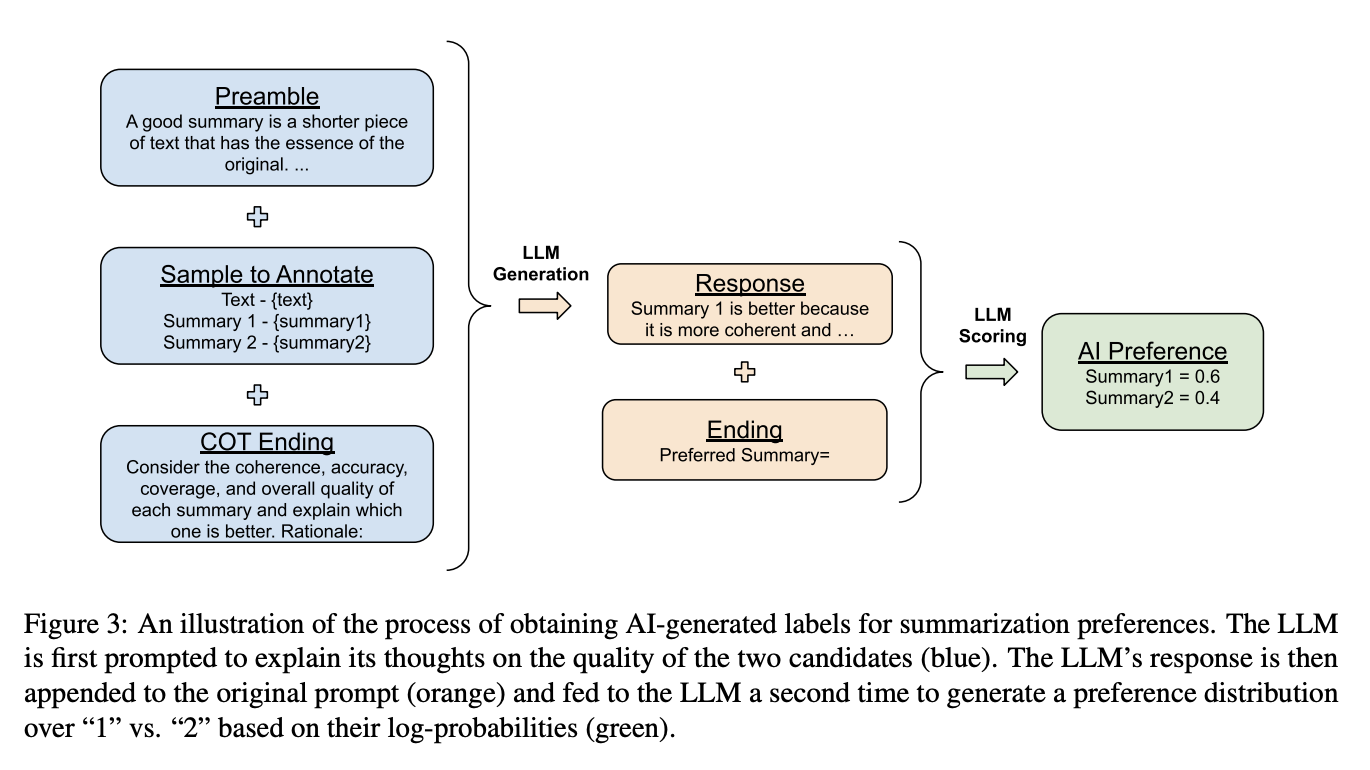
Source : Lee et al., 2023
Une fois les étiquettes de préférence obtenues du modèle de retour LLM, l’étape suivante consiste à entraîner un modèle de préférence.
Ce modèle apprend à associer contexte et réponses candidates à un signal de récompense scalaire, servant de proxy aux préférences humaines. Il est ensuite intégré dans la boucle d’apprentissage par renforcement.
L’article RLAIF explore une variante où le retour du LLM sert directement de signal de récompense, sans modèle de préférence distinct. Mais cette méthode « directe » est coûteuse en calcul, surtout quand la taille du LLM étiqueteur augmente.
Une fois le modèle de préférence en place, l’apprentissage par renforcement peut s’effectuer en utilisant le retour d’IA comme signal de récompense. L’agent (LLM de base) interagit avec l’environnement, et ses sorties sont évaluées par le modèle de préférence, qui attribue une récompense selon l’adéquation avec les préférences définies par le modèle de retour.
RLAIF présente plusieurs avantages convaincants par rapport au RLHF traditionnel, ce qui en fait une alternative attrayante pour entraîner et affiner des LLM. Voici les principaux bénéfices.
En automatisant la génération de retours, RLAIF supprime le besoin d’annotateurs humains, ce qui rend la collecte à grande échelle plus efficace et plus abordable.
Cette approche réduit fortement les goulets d’étranglement liés aux retours humains : délais, main-d’œuvre, coûts. Et à mesure que les LLM gagnent en capacité, mobiliser des IA pour superviser d’autres IA devient d’autant plus pertinent, surtout lorsque la supervision humaine atteint ses limites.
RLAIF est très flexible et s’adapte à divers usages et domaines. En ne dépendant pas d’un jeu fixe de retours humains, on peut ajuster facilement la « constitution » ou les données d’entraînement utilisées pour affiner le modèle de retour. On adapte ainsi le comportement du LLM aux spécificités de chaque tâche ou domaine.
De plus, les principes qui guident le modèle de retour sont explicitement énoncés en langage naturel, sous forme de « constitution ». Cette démarche renforce la transparence, contrairement aux méthodes traditionnelles où les principes d’évaluation se dispersent dans des milliers d’étiquettes humaines.
Les résultats expérimentaux de l’article original indiquent que RLAIF égale les performances du RLHF et, parfois, les dépasse. De quoi montrer que RLAIF peut à la fois rationaliser le processus de retour et améliorer les performances des modèles entraînés.
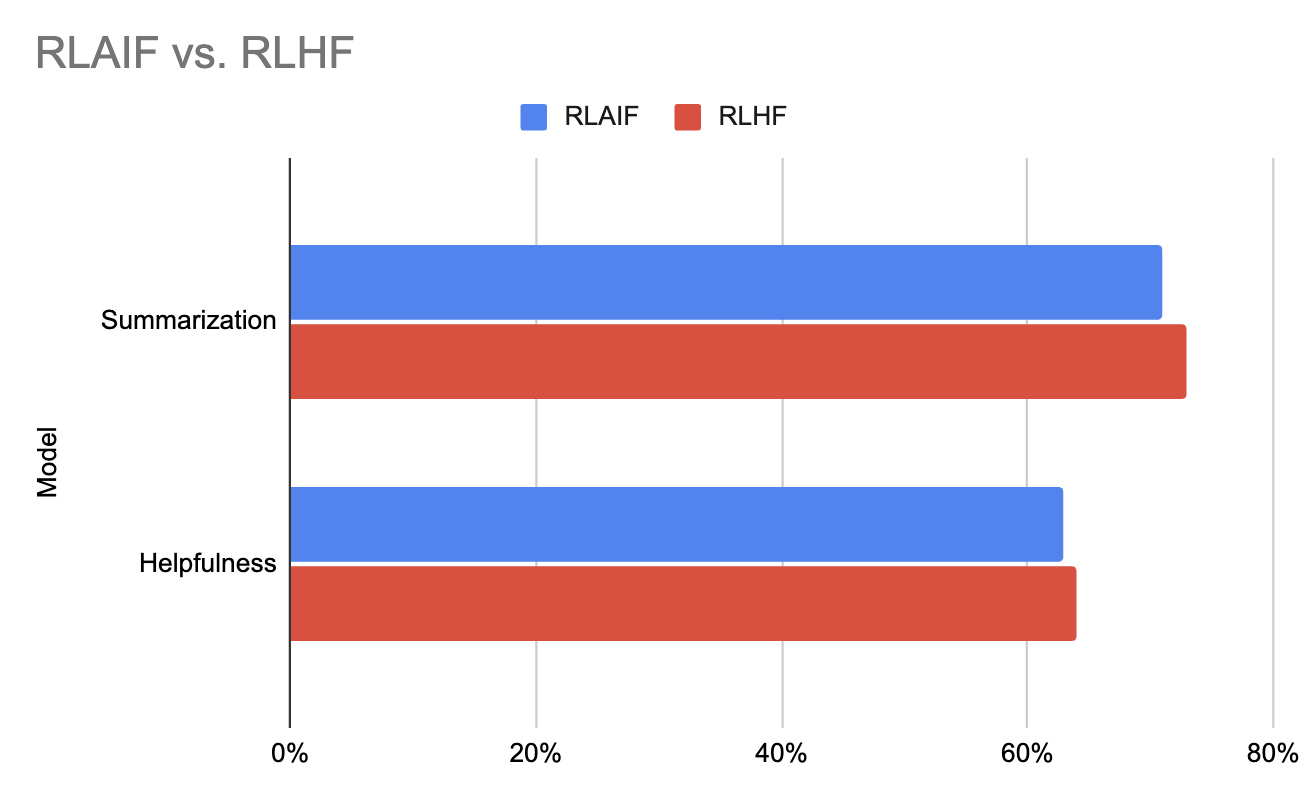
Graphique généré à partir des données de cet article (Lee et al., 2023)
Observons aussi ce graphique, qui montre que RLAIF produit la plus forte proportion de dialogues inoffensifs, comparé à RLHF et SFT.
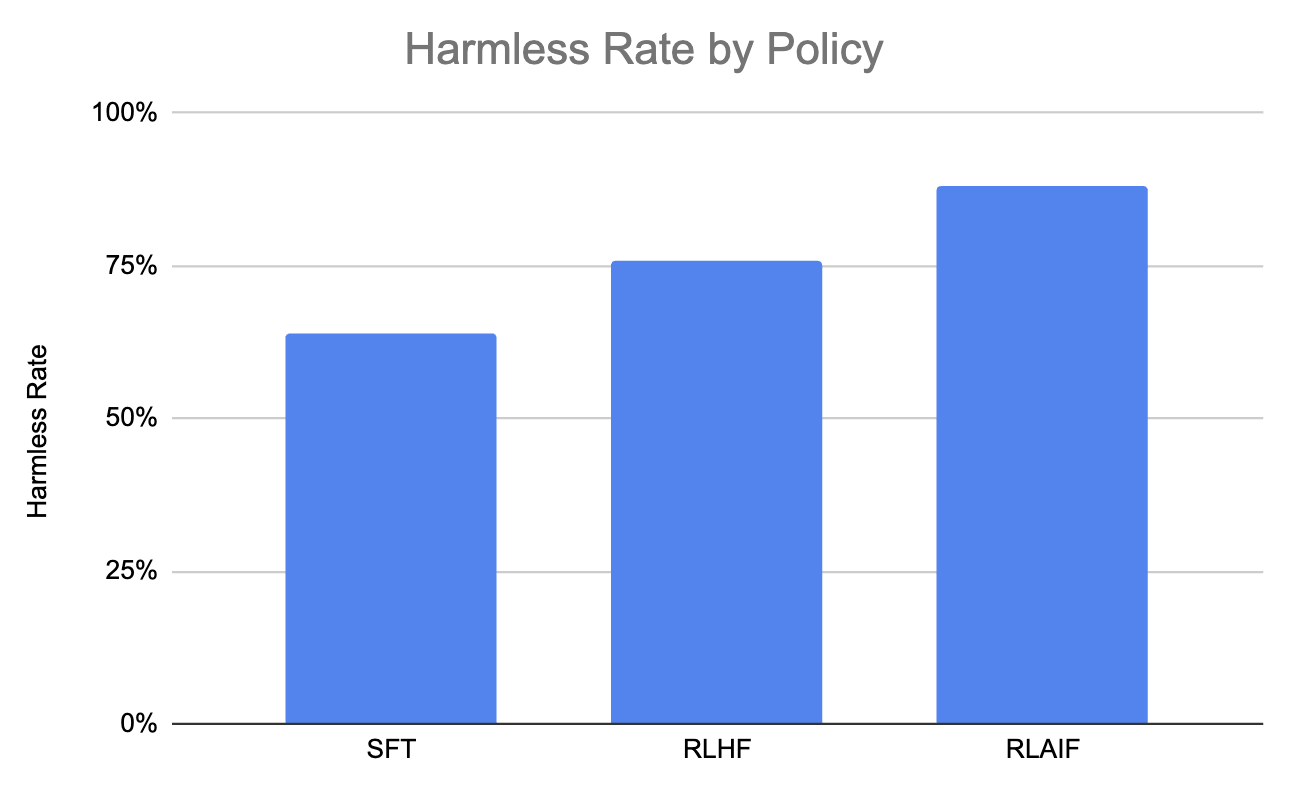
Graphique généré à partir des données de cet article (Lee et al., 2023)
Malgré des résultats prometteurs, RLAIF introduit aussi de nouveaux défis :
Même si la « constitution » en langage naturel est plus transparente que des étiquettes humaines individuelles, la phase de prééducation d’un LLM reste une « boîte noire ». Garantir l’alignement du modèle de retour avec les valeurs et préférences humaines demeure donc critique : des décalages ou biais peuvent entraîner des effets inattendus ou des comportements sous-optimaux de l’agent.
Pour limiter ce risque, le retour d’IA peut compléter la supervision humaine, sans la remplacer totalement. Ce double dispositif aide à éviter que les modèles ne s’écartent, avec le temps, des comportements préférés par les humains.
Si la supervision humaine à grande échelle est difficile pour des modèles très puissants, la capacité des systèmes d’IA actuels à superviser de manière fiable des assistants d’IA encore plus capables reste une question ouverte. Des métriques rigoureuses sont donc essentielles pour juger la qualité et l’alignement des retours générés par le modèle d’évaluation.
Comme tout modèle d’apprentissage, les modèles de retour peuvent présenter des biais issus des données ou du processus d’entraînement. Il est crucial de mettre en place des stratégies d’atténuation : données d’entraînement diversifiées et représentatives, évaluations robustes, et techniques comme le chain-of-thought.
En relevant ces défis, RLAIF peut devenir un outil solide et fiable pour entraîner des systèmes d’IA avancés, alignés sur les valeurs humaines et performants sur divers usages et domaines.
RLAIF s’applique à de nombreuses tâches de traitement du langage :
Globalement, l’article RLAIF (Lee et al., 2023) présente une approche scalable pour entraîner des LLM sans dépendre de labels humains. En s’appuyant sur une « constitution » de principes en langage naturel et sur l’autocritique d’un modèle initial utile, les auteurs montrent qu’il est possible d’orienter le comportement des LLM tout en améliorant transparence et flexibilité.
En substance, RLAIF offre un moyen de passer à l’échelle de la supervision à mesure que les modèles montent en puissance, en complément et en partie en automatisation de la supervision humaine. Il aide également à réduire des problèmes comme la mauvaise spécification des récompenses et les comportements évitants observés avec les approches basées sur des retours humains. Mais l’alignement robuste avec l’humain, la gestion des décalages de distribution et une supervision fiable pour des systèmes d’IA avancés restent des chantiers ouverts.
Pour la suite, il serait intéressant d’intégrer des démonstrations humaines de haute qualité pour mieux focaliser et améliorer les modèles RLAIF. Étendre l’approche pour piloter d’autres dimensions (personnalité, style d’écriture) est également une piste prometteuse.
Pour approfondir l’apprentissage par renforcement, découvrez ce tutoriel d’initiation : Reinforcement Learning: An Introduction With Python Examples.
Approfondissez vos connaissances en apprentissage par renforcement et en IA !
Cours
Cours
Cursus