Kurs
Reinforcement Learning mit Gymnasium in Python
4 Std.
13.6K
Reinforcement Learning ist eine weit verbreitete Methode, um intelligente Agenten so zu trainieren, dass sie in ihrer Umgebung gute Entscheidungen treffen. Bei großen Sprachmodellen (LLMs) bedeutet das oft, das Lernen durch menschliches Feedback zu steuern.
Menschen als Feedbackgeber einzusetzen, ist jedoch teuer, zeitaufwendig und bisweilen inkonsistent. Reinforcement Learning mit KI-Feedback (RLAIF) bietet hier eine Alternative, die die Stärken bestehender KI-Modelle nutzt.
In diesem Artikel erklären wir die Grundideen von RLAIF, zeigen, wie es praktisch funktioniert, und beleuchten die Auswirkungen auf die künftige KI-Entwicklung.
Wenn du mehr über Reinforcement Learning mit menschlichem Feedback (RLHF) erfahren möchtest, lies diesen Beitrag: What is Reinforcement Learning from Human Feedback.
Reinforcement Learning mit KI-Feedback (RLAIF) ist eine Machine-Learning-Technik, bei der KI-Modelle während des Reinforcement-Learning-Prozesses anderen KI-Modellen Feedback geben.
Anstatt sich nur auf menschlichen Input zu verlassen, nutzt RLAIF die Fähigkeiten bestehender KI-Systeme, etwa große Sprachmodelle, um Aktionen zu bewerten und das Lernen anderer Agenten zu steuern.
Dieses KI-Feedback kann verschiedene Formen annehmen: von Belohnungssignalen über das Ranking von Antworten bis hin zu konkreten Verbesserungsvorschlägen. Durch die Automatisierung der Feedbackschleife kann RLAIF das Training beschleunigen, Kosten senken und die Leistungsfähigkeit verschiedener KI-Systeme – inklusive großer Sprachmodelle – steigern.
Um zu verstehen, wie RLAIF im Vergleich zu RLHF abschneidet, hilft diese Tabelle als Einstieg:
|
Merkmal |
RLHF (Reinforcement Learning from Human Feedback) |
RLAIF (Reinforcement Learning from AI Feedback) |
|
Feedbackquelle |
Menschliche Annotatorinnen und Annotatoren |
Bestehende KI-Modelle (z. B. LLMs) |
|
Skalierbarkeit |
Begrenzt durch Verfügbarkeit und Kosten menschlicher Arbeit |
Sehr gut skalierbar dank Automatisierung |
|
Feedback-Qualität |
Hohe Fähigkeit, nuancierte menschliche Präferenzen abzubilden |
Abhängig von der Leistungsfähigkeit des feedbackgebenden KI-Modells |
|
Kosten |
Oft teuer durch den Einsatz menschlicher Arbeit |
Potentiell kostengünstiger durch Automatisierung |
|
Tempo |
Langsamer durch den Aufwand für menschliche Annotation |
Schneller dank automatischer Feedback-Generierung |
|
Bias |
Anfällig für menschliche Verzerrungen |
Kann Verzerrungen des feedbackgebenden KI-Modells übernehmen |
Zur weiteren Veranschaulichung der Unterschiede zwischen RLHF und RLAIF hilft dieses Diagramm aus dem Paper RLAIF: Scaling Reinforcement Learning from Human Feedback with AI Feedback (Lee et al., 2023):
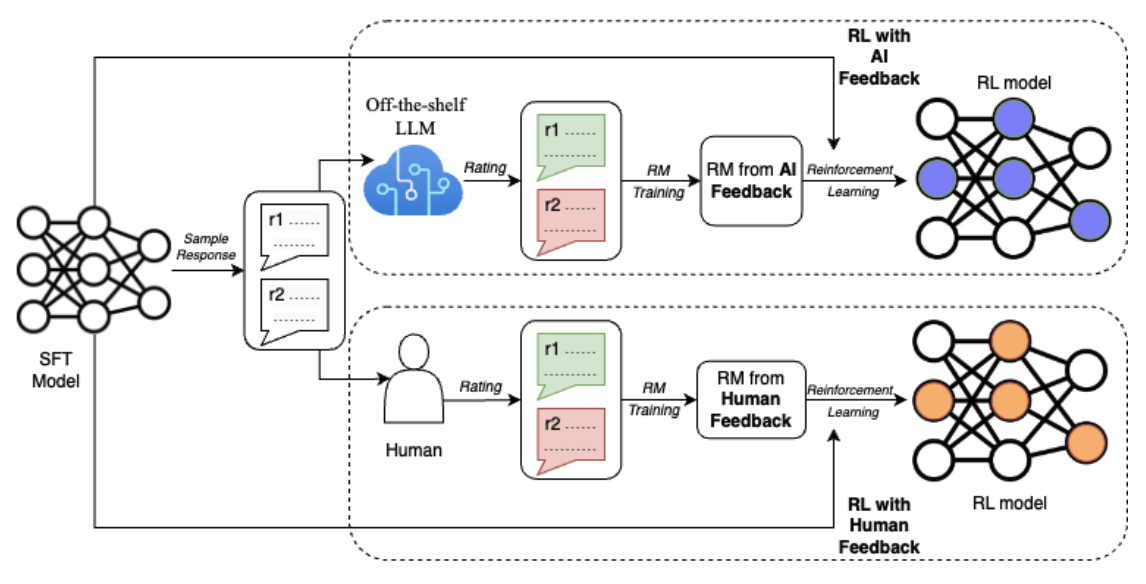
Quelle: Lee et al., 2023
Das Diagramm zeigt den zentralen Unterschied zwischen RLHF und RLAIF im Reinforcement-Learning-Prozess. Beide Ansätze starten mit einem Ausgangsmodell (SFT Model), das Beispielantworten erzeugt. Bei RLHF bewerten Menschen diese Antworten, während bei RLAIF ein vortrainiertes LLM als Richter fungiert.
Diese Bewertungen dienen dann zum Training eines Reward-Modells (RM). In der anschließenden Reinforcement-Learning-Schleife erhält das RL-Modell Belohnungen vom RM, das entweder auf menschlichem Feedback (RLHF) oder KI-Feedback (RLAIF) trainiert wurde. Diese Feedbackschleife ermöglicht es dem RL-Modell, kontinuierlich zu lernen und seine Leistung auf Basis der jeweiligen Feedbackquelle zu verbessern.
Nachdem wir die Kernideen von RLAIF und die Abgrenzung zu RLHF geklärt haben, schauen wir uns die praktischen Schritte der Umsetzung an. Der RLAIF-Prozess umfasst typischerweise vier Phasen, die jeweils entscheidend sind, damit KI-Modelle aus KI-generiertem Feedback lernen.
Im ursprünglichen RLAIF-Paper (Lee et al., 2023) wurde ein „von-der-Stange“-LLM als Feedback-Modell für Präferenzlabels eingesetzt. Das ist ein guter Startpunkt. In Szenarien mit domänenspezifischem Wissen oder Fachterminologie kann es jedoch sinnvoll sein, das LLM zusätzlich auf relevanten Daten feinzujustieren.
Wenn du zum Beispiel einen KI-Assistenten für Finanz- oder Medizinanwendungen entwickeln willst, kann ein Fine-Tuning auf einem Korpus aus Finanz- bzw. Medizint exten das Verständnis für Fachkonzepte und Jargon deutlich verbessern.
Dieser zusätzliche Schritt sorgt dafür, dass das Modell präzisere und relevantere Präferenzurteile liefern kann – und so die Gesamtqualität und Zuverlässigkeit in spezialisierten Anwendungen steigt.
Sobald das LLM-Feedback-Modell bereitsteht – ob von der Stange oder feinjustiert –, können wir damit Präferenzlabels erzeugen.
Hierzu erhält das Feedback-Modell den Kontext sowie zwei Antwortvorschläge. Anschließend wird es aufgefordert, die bevorzugte Antwort zu bestimmen. Im RLAIF-Paper folgt der Eingabeprompt für das Feedback-Modell einem strukturierten Aufbau:
Zur Veranschaulichung dient folgende Grafik:
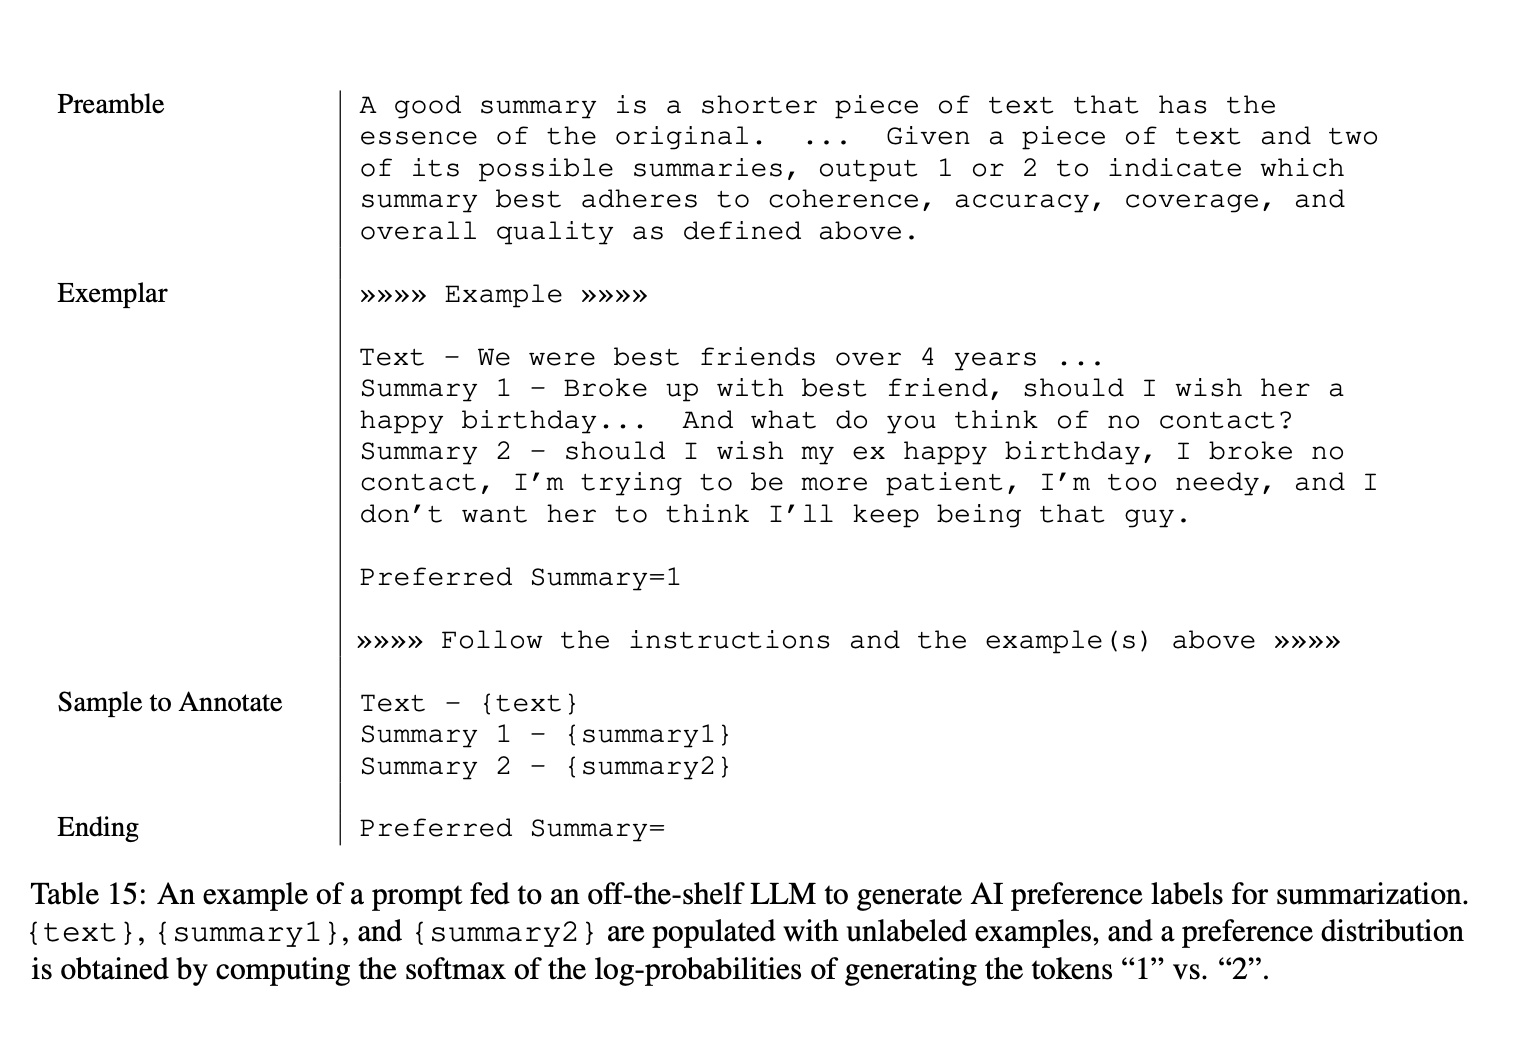
Quelle: Lee et al., 2023
Diese Struktur hilft dem Feedback-Modell, die Qualität der Antworten zu bewerten und treffende Präferenzlabels zu vergeben. Few-Shot-Beispiele können die Leistung zusätzlich steigern, weil sie konkrete Bewertungsmaßstäbe vorgeben und das Feedback konsistenter machen.
Auf Basis des Prompts erzeugt das LLM-Feedback-Modell die Log-Wahrscheinlichkeiten für die Tokens „1“ und „2“ – also seine Präferenz für die erste oder zweite Antwort. Diese Log-Wahrscheinlichkeiten werden über eine Softmax-Funktion in eine Präferenzverteilung überführt.
Im RLAIF-Paper wurden zwei Varianten der Präambel getestet: „Base“ und „Detailed“. Eine Base-Präambel bittet das Feedback-Modell schlicht, die bessere Antwort zu wählen; eine Detailed-Präambel enthält ausführliche Anweisungen, wie sie typischerweise Menschen erhalten. Dazu dieses Beispiel:
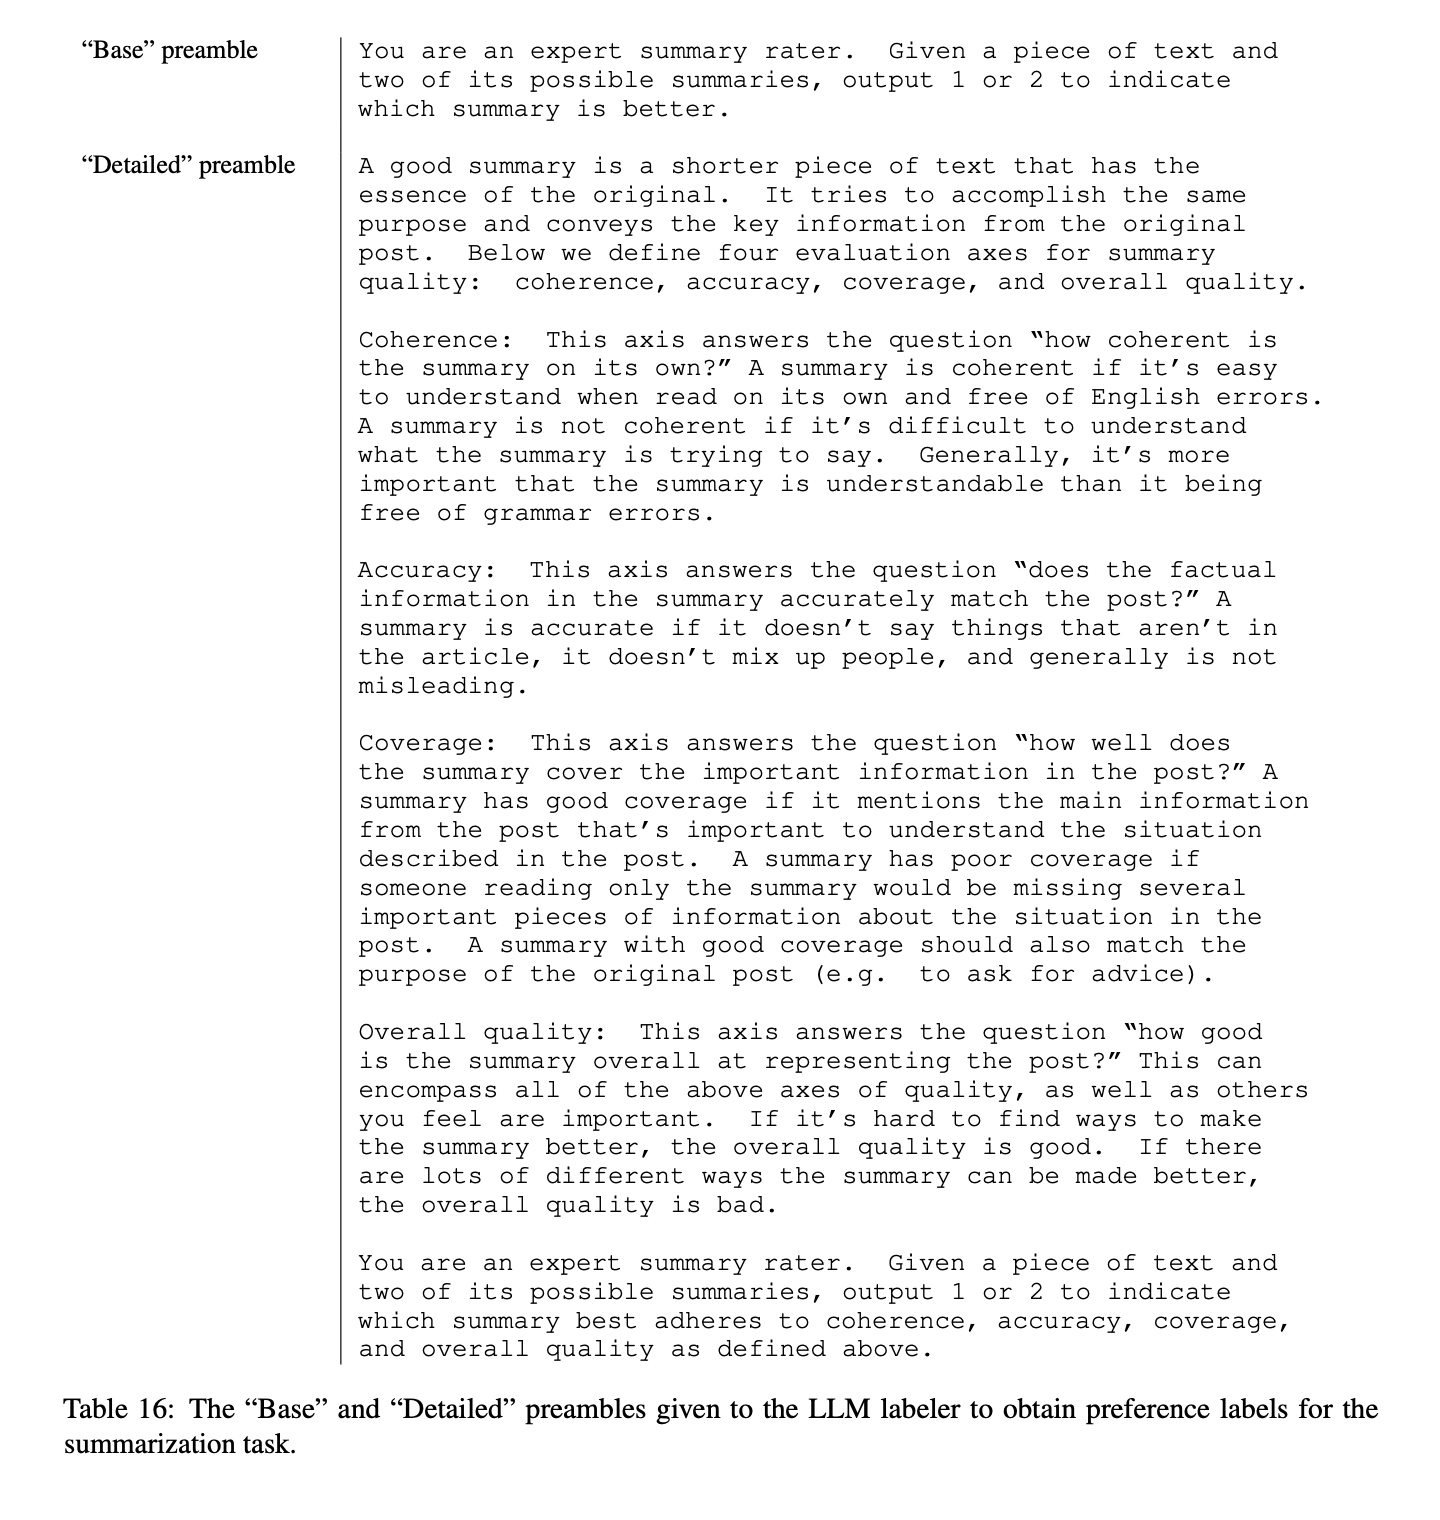
Quelle: Lee et al., 2023
Zudem wurden zwei wichtige Maßnahmen untersucht, um die Wirksamkeit von RLAIF zu erhöhen:
Zur Verdeutlichung der CoT-Technik dient dieses Diagramm aus dem Paper:
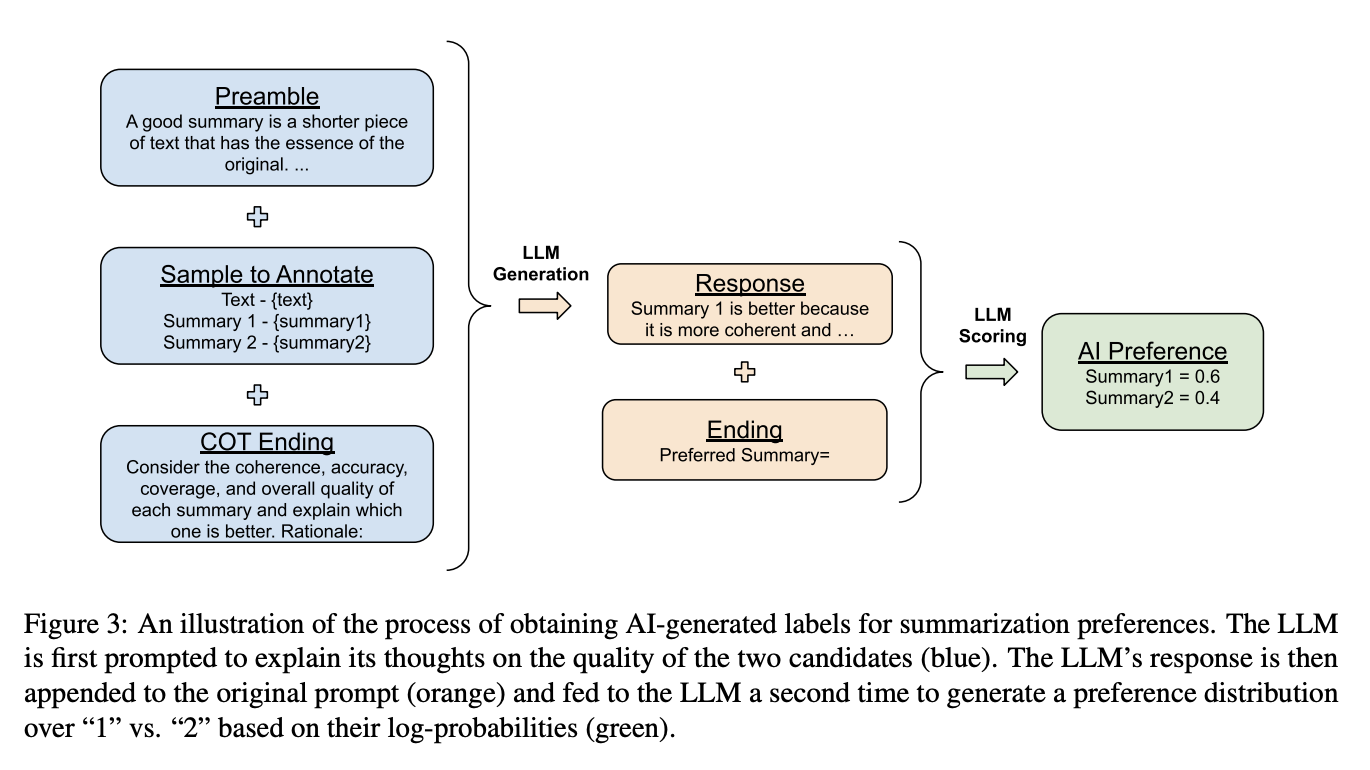
Quelle: Lee et al., 2023
Sind die Präferenzlabels des LLM-Feedback-Modells vorhanden, werden sie zum Training eines Präferenzmodells genutzt.
Dieses Modell lernt, Kontext und Kandidatenantworten auf ein skalares Belohnungssignal abzubilden – als Stellvertreter für menschliche Präferenzen. Anschließend wird das trainierte Präferenzmodell in den Reinforcement-Learning-Zyklus integriert.
Das RLAIF-Paper untersucht auch eine Alternative, bei der das LLM-Feedback direkt als Belohnungssignal dient – ohne separates Präferenzmodell. Diese „direkte“ RLAIF-Variante ist jedoch rechenaufwendig, insbesondere bei größeren LLM-Labelern.
Mit dem Präferenzmodell als Grundlage kann Reinforcement Learning erfolgen, wobei das KI-Feedback als Belohnungssignal dient. Der Agent (Basis-LLM) interagiert mit der Umgebung, und seine Ausgaben werden durch das Präferenzmodell bewertet, das eine Belohnung vergibt – je nachdem, wie gut die Aktion zu den im Feedback-Modell kodierten Präferenzen passt.
RLAIF bietet gegenüber klassischem RLHF mehrere überzeugende Vorteile und ist daher eine attraktive Option für das Training und die Verfeinerung großer Sprachmodelle. Hier sind die wichtigsten Pluspunkte.
Durch die automatisierte Feedback-Generierung entfällt der Bedarf an menschlicher Annotation – Feedback lässt sich so deutlich effizienter und kostengünstiger in großem Umfang sammeln.
Damit entfallen Engpässe menschlicher Feedbacksammlung wie Zeit, Personal und Kosten. Je leistungsfähiger LLMs werden, desto sinnvoller ist es, KI-Systeme zur Überwachung anderer KIs einzusetzen – besonders dann, wenn menschliche Aufsicht bei sehr fortgeschrittenen Modellen an Grenzen stößt.
RLAIF ist sehr flexibel und lässt sich an unterschiedliche Aufgaben und Domänen anpassen. Da wir nicht an starre menschliche Feedback-Datensätze gebunden sind, können wir die „Konstitution“ oder die Trainingsdaten für das Feedback-Modell leicht variieren. So lässt sich das LLM-Verhalten für verschiedene Einsatzzwecke gezielt steuern.
Zudem werden die Leitprinzipien des gewünschten Feedback-Modells explizit in natürlicher Sprache festgehalten – eine Art „Konstitution“. Das steigert die Transparenz, weil die Bewertungskriterien klar formuliert sind, während sie bei herkömmlichen Verfahren oft über Tausende einzelner menschlicher Labels verteilt sind.
Die Experimente im Originalpaper zeigen, dass RLAIF die Leistung von RLHF erreicht und teils übertrifft. RLAIF kann also nicht nur den Feedbackprozess verschlanken, sondern auch die Gesamtleistung der trainierten Modelle steigern.
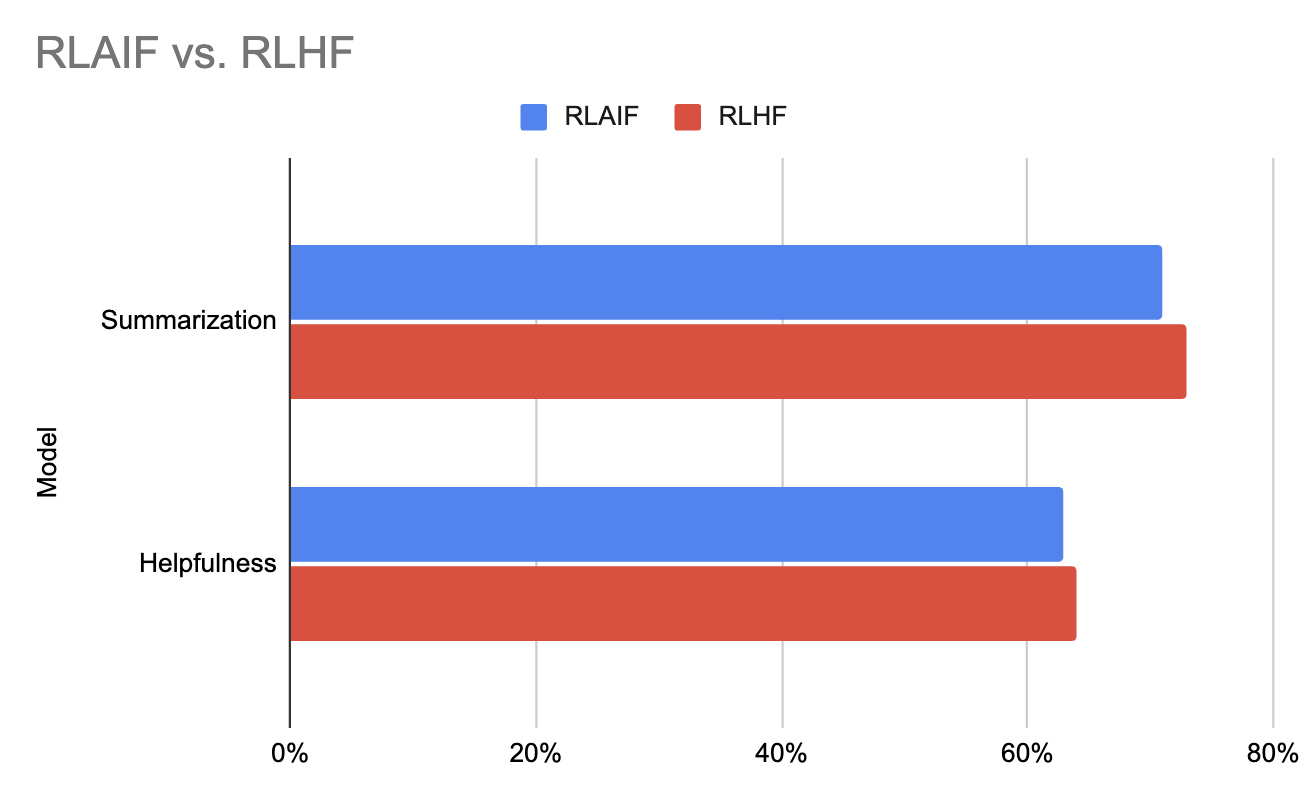
Grafik erstellt auf Basis der Daten aus diesem Paper (Lee et al., 2023)
Auch diese Grafik zeigt: RLAIF erzeugt im Vergleich zu RLHF und SFT den höchsten Anteil an harmlosen Dialogen.
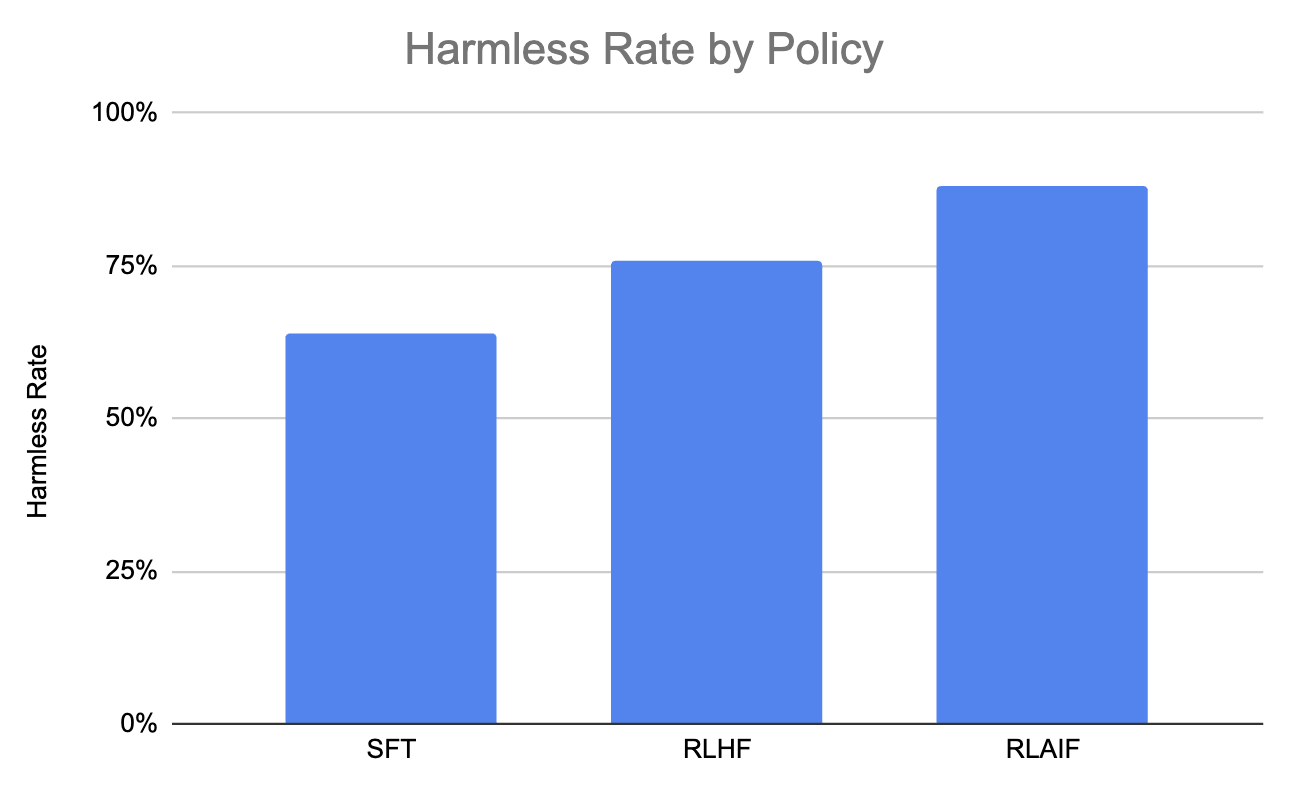
Grafik erstellt auf Basis der Daten aus diesem Paper (Lee et al., 2023)
Trotz der starken Ergebnisse bringt RLAIF auch neue Herausforderungen mit sich, die adressiert werden müssen:
Obwohl die sprachliche „Konstitution“ transparenter ist als einzelne menschliche Labels, bleibt das Pretraining von LLMs eine „Black Box“. Entsprechend kritisch ist es, das Feedback-Modell an menschlichen Werten und Präferenzen auszurichten. Fehlanpassungen oder Bias im Feedback-Modell können zu unerwünschtem oder suboptimalem Verhalten des Agenten führen.
Um dieses Risiko zu mindern, sollte KI-Feedback menschliche Aufsicht ergänzen statt vollständig zu ersetzen. Dieser Doppelansatz hilft, Modelle langfristig auf menschlich bevorzugtes Verhalten auszurichten.
Auch wenn menschliche Aufsicht für sehr große Modelle schwer zu skalieren ist, bleibt offen, ob heutige KI-Systeme zuverlässig leistungsstarke Assistenten überwachen können. Daher sind belastbare Evaluationsmetriken entscheidend, um Qualität und Alignment des KI-Feedbacks zu prüfen und seine Zuverlässigkeit sicherzustellen.
Wie jedes ML-Modell können auch Feedback-Modelle Verzerrungen aus Trainingsdaten oder Lernprozess übernehmen. Gegenmaßnahmen sind z. B. diverse, repräsentative Trainingsdaten, robuste Evaluation sowie Techniken wie Chain-of-Thought.
Wenn diese Herausforderungen gelöst werden, kann RLAIF zu einem robusten, zuverlässigen Werkzeug für das Training fortgeschrittener KI-Systeme reifen – im Einklang mit menschlichen Werten und mit starker Leistung über verschiedene Aufgaben hinweg.
RLAIF lässt sich auf viele Aufgaben der Sprachverarbeitung anwenden, unter anderem:
In Summe stellt das RLAIF-Paper (Lee et al., 2023) einen skalierbaren Ansatz vor, LLMs ohne menschliche Feedback-Labels zu trainieren. Mit einer in Sprache formulierten „Konstitution“ von Prinzipien und der Selbstkritik eines anfänglich hilfreichen Modells gelingt es, das Verhalten von Sprachmodellen zu steuern – transparenter und flexibler.
Ein zentrales Learning: RLAIF bietet Potenzial, die Aufsicht mit der steigenden Leistungsfähigkeit von Modellen mitzuskalieren – als Ergänzung und partielle Automatisierung menschlicher Überwachung. Probleme wie „Reward Misspecification“ oder ausweichendes Verhalten, die bei menschlichem Feedback auftraten, werden gemindert. Offene Punkte bleiben jedoch die robuste menschliche Ausrichtung, der Umgang mit Veränderungen in den Datenverteilungen und zuverlässige Aufsicht bei sehr fortgeschrittenen Systemen.
Künftig könnte man hochwertige Demonstrationen menschlichen Denkens integrieren, um RLAIF-Modelle weiter zu fokussieren und zu verbessern. Ebenso spannend: das Vorgehen nutzen, um LLM-Verhalten entlang weiterer Dimensionen wie Persönlichkeit oder Schreibstil zu steuern.
Wenn du tiefer in Reinforcement Learning einsteigen willst, schau dir dieses Einführungstutorial an: Reinforcement Learning: An Introduction With Python Examples.
Erfahre mehr über Reinforcement Learning und KI!
Kurs
Kurs
Lernpfad