

Kursus
Reinforcement Learning dengan Gymnasium di Python
4 jam
14K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleReinforcement learning adalah teknik yang banyak digunakan untuk melatih agen cerdas agar membuat keputusan yang efektif dalam lingkungannya. Dalam ranah large language models (LLM), ini sering melibatkan pengarahaan proses pembelajaran melalui umpan balik manusia.
Namun, mengandalkan manusia untuk memberikan umpan balik bisa mahal, memakan waktu, dan terkadang tidak konsisten. Reinforcement learning from AI feedback (RLAIF) menyajikan solusi alternatif dengan memanfaatkan kekuatan model AI yang sudah ada.
Dalam artikel ini, kami akan menguraikan konsep inti RLAIF, mengeksplorasi cara kerjanya dalam praktik, dan membahas implikasinya bagi masa depan pengembangan AI.
Jika Anda ingin mempelajari lebih lanjut tentang reinforcement learning from human feedback (RLHF), baca artikel ini: What is Reinforcement Learning from Human Feedback.
Reinforcement learning from AI feedback (RLAIF) adalah teknik machine learning di mana model AI memberikan umpan balik kepada model AI lain selama proses reinforcement learning.
Alih-alih hanya mengandalkan masukan manusia, RLAIF memanfaatkan kapabilitas sistem AI yang ada, seperti large language models, untuk mengevaluasi tindakan dan membimbing pembelajaran agen lain.
Umpan balik AI ini dapat berbentuk beragam, termasuk menghasilkan reward, memberi peringkat respons, atau langsung menyarankan perbaikan. Dengan mengotomatisasi loop umpan balik, RLAIF berpotensi merampingkan pelatihan, menurunkan biaya, dan meningkatkan kinerja berbagai sistem AI, termasuk large language models.
Untuk memahami bagaimana RLAIF dibandingkan dengan RLHF, mari mulai dengan mempertimbangkan tabel berikut:
|
Fitur |
RLHF (Reinforcement Learning from Human Feedback) |
RLAIF (Reinforcement Learning from AI Feedback) |
|
Sumber Umpan Balik |
Anotator manusia |
Model AI yang ada (mis., LLM) |
|
Skalabilitas |
Dibatasi oleh ketersediaan dan biaya tenaga manusia |
Sangat skalabel karena otomatisasi |
|
Kualitas Umpan Balik |
Potensi tinggi untuk menangkap preferensi manusia yang bernuansa |
Bergantung pada kapabilitas model AI yang memberikan umpan balik |
|
Biaya |
Dapat mahal karena memerlukan tenaga manusia |
Berpotensi lebih hemat biaya karena otomatisasi |
|
Kecepatan |
Lebih lambat karena waktu yang dibutuhkan untuk anotasi manusia |
Lebih cepat karena generasi umpan balik terotomatisasi |
|
Bias |
Dapat terpengaruh bias manusia |
Dapat mewarisi bias dari model AI yang memberikan umpan balik |
Untuk lebih memahami perbedaan antara RLHF dan RLAIF, mari pertimbangkan juga diagram dari makalah RLAIF: Scaling Reinforcement Learning from Human Feedback with AI Feedback (Lee dkk., 2023) berikut:
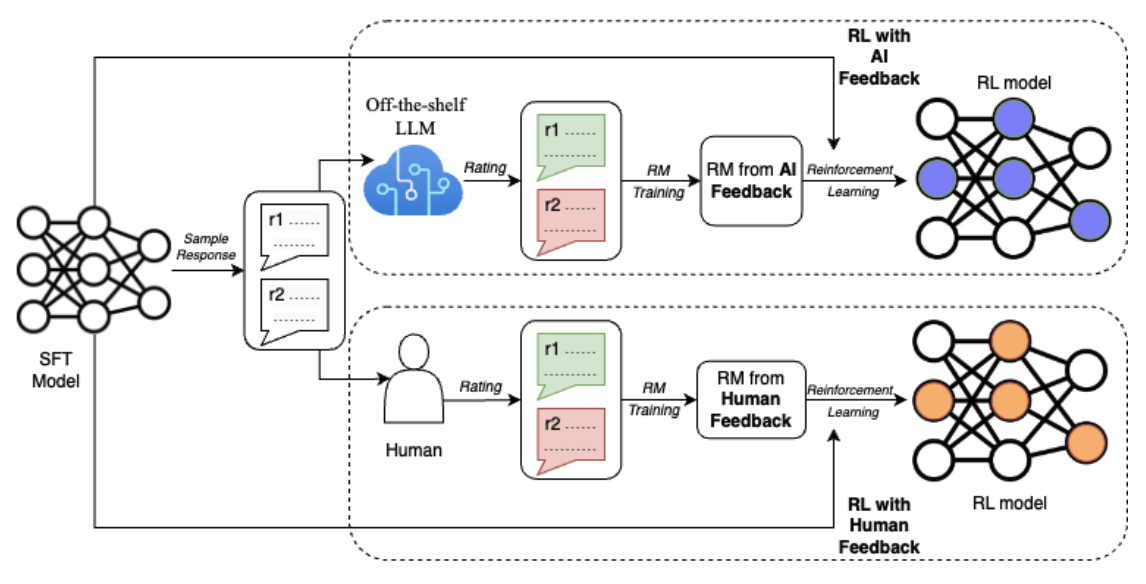
Sumber: Lee dkk., 2023
Diagram ini menggambarkan perbedaan kunci antara RLHF dan RLAIF dalam proses reinforcement learning. Kedua pendekatan dimulai dengan model awal (SFT Model) yang menghasilkan contoh respons. Namun, pada RLHF, evaluator manusia memberikan penilaian untuk respons tersebut, sedangkan pada RLAIF, sebuah LLM siap pakai bertindak sebagai juri.
Penilaian ini kemudian digunakan untuk melatih reward model (RM). Terakhir, dalam loop reinforcement learning, model RL menerima reward dari RM, yang dilatih berdasarkan umpan balik manusia (RLHF) atau umpan balik AI (RLAIF). Loop umpan balik ini memungkinkan model RL untuk terus belajar dan meningkatkan kinerjanya berdasarkan jenis umpan balik spesifik yang diterimanya.
Setelah kita menetapkan konsep inti RLAIF dan pembedaannya dari RLHF, mari selami langkah-langkah praktis dalam menerapkan pendekatan ini. Proses RLAIF biasanya terdiri dari empat tahap kunci, masing-masing memainkan peran penting dalam memungkinkan model AI belajar dari umpan balik yang dihasilkan AI.
Dalam makalah RLAIF asli (Lee dkk., 2023), sebuah LLM "siap pakai" digunakan sebagai model umpan balik untuk pelabelan preferensi. Ini menjadi titik awal yang baik, tetapi dalam skenario tertentu, khususnya yang melibatkan pengetahuan atau terminologi spesifik domain, akan menguntungkan untuk melakukan fine-tuning lebih lanjut pada LLM dengan data yang relevan.
Sebagai contoh, jika tujuannya adalah mengembangkan asisten AI yang disesuaikan untuk bidang keuangan atau medis, melakukan fine-tuning LLM pada korpus teks keuangan atau medis dapat secara signifikan meningkatkan pemahamannya terhadap konsep dan jargon spesifik domain.
Langkah tambahan ini memastikan model dapat memberikan penilaian preferensi yang lebih akurat dan relevan, pada akhirnya meningkatkan kualitas dan keandalan keseluruhan sistem AI dalam aplikasi khusus.
Setelah kita memiliki model umpan balik LLM—baik versi siap pakai maupun varian yang di-fine-tune—kita dapat menggunakannya untuk menghasilkan label preferensi.
Untuk menghasilkan umpan balik AI, model umpan balik diberikan konteks dan dua kandidat respons. Model kemudian diminta menentukan respons mana yang lebih disukai. Dalam makalah RLAIF, prompt input ke model umpan balik mengikuti format terstruktur:
Untuk lebih memahami struktur ini, perhatikan gambar di bawah:
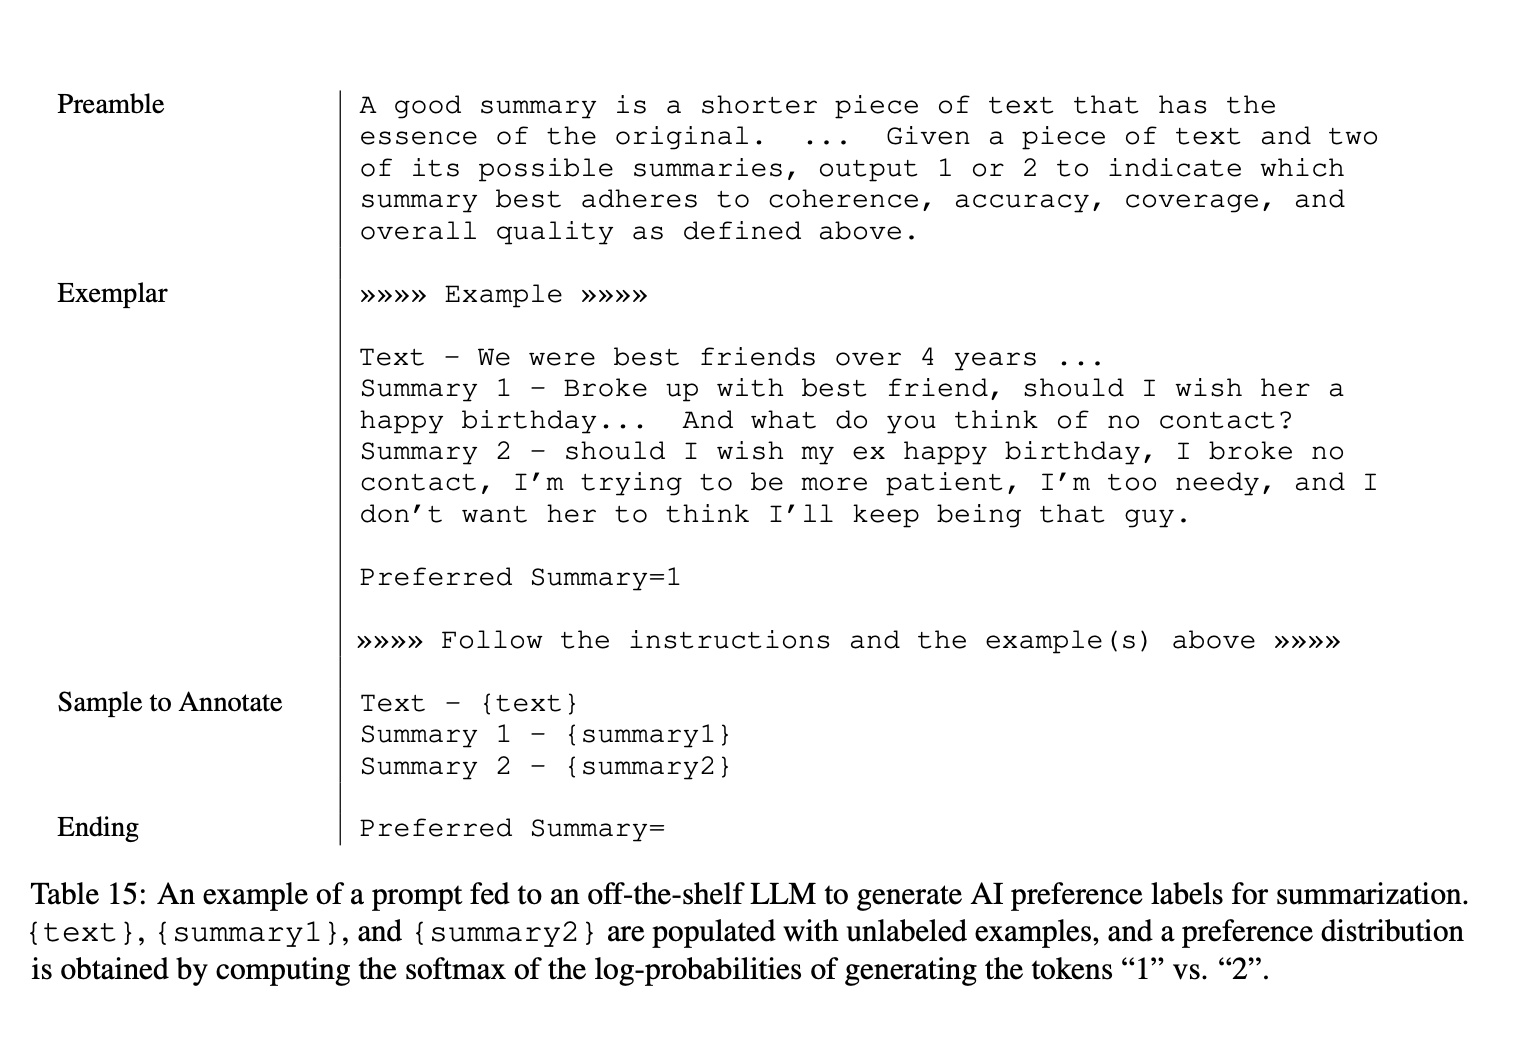
Sumber: Lee dkk., 2023
Pendekatan terstruktur ini memastikan model umpan balik dapat secara efektif menilai kualitas respons dan memberikan label preferensi yang akurat. Dengan memasukkan contoh few-shot, kita dapat semakin meningkatkan kinerja model, dengan menunjukkan contoh konkret cara mengevaluasi respons, sehingga membuat umpan balik lebih konsisten dan andal.
Berdasarkan prompt input, model umpan balik LLM menghasilkan log-probabilitas untuk token "1" dan "2"—mewakili preferensi model terhadap respons pertama atau kedua. Log-probabilitas ini kemudian dilewatkan melalui fungsi softmax untuk memperoleh distribusi preferensi.
Dalam makalah RLAIF, dua gaya prambel diuji: “Base” dan “Detailed”. Prambel Base meminta model umpan balik menilai respons mana yang lebih baik, sedangkan prambel Detailed memberikan instruksi komprehensif yang biasanya diberikan kepada anotator manusia. Untuk lebih memahaminya, mari pertimbangkan contoh berikut:
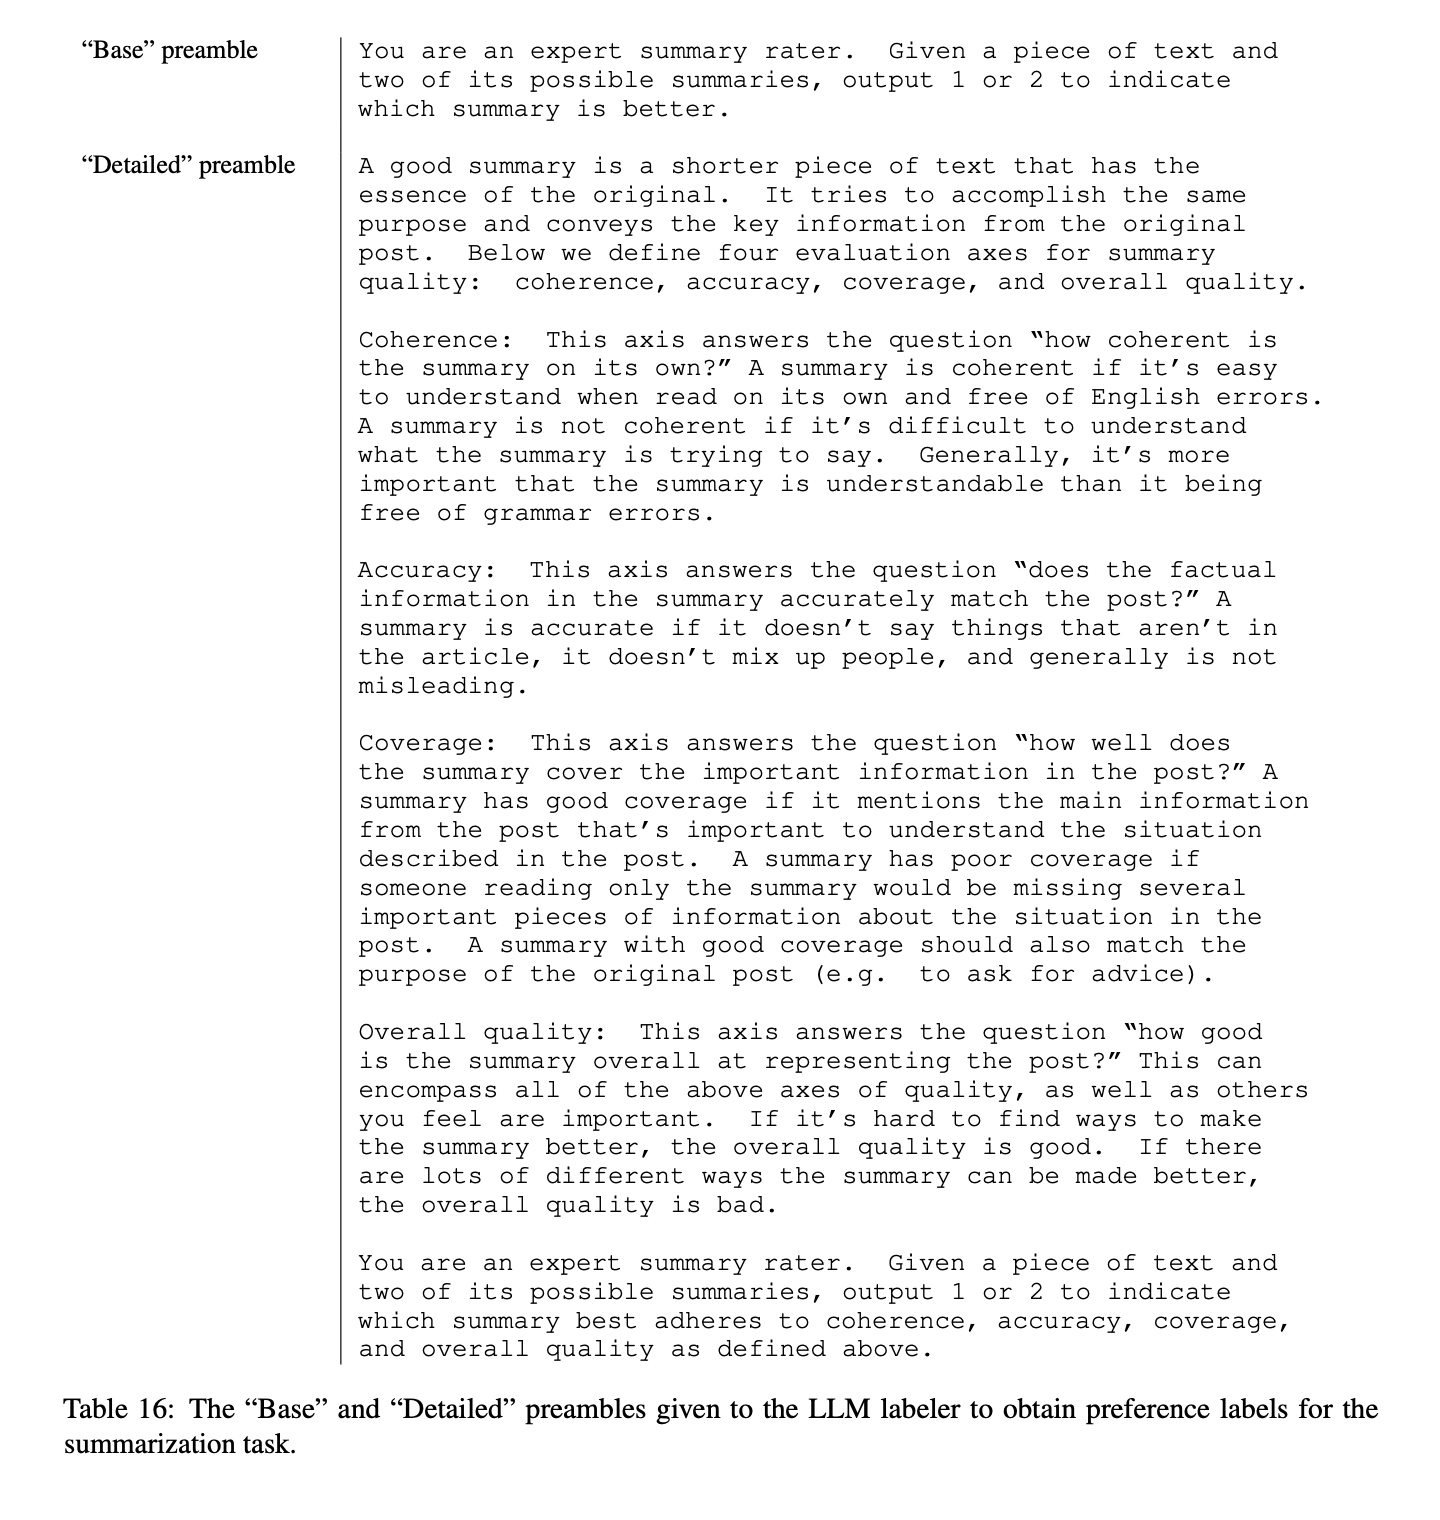
Sumber: Lee dkk., 2023
Terakhir, dua pertimbangan penting dieksplorasi untuk meningkatkan efektivitas metodologi RLAIF:
Untuk lebih memahami teknik CoT ini, perhatikan diagram dari makalah berikut:
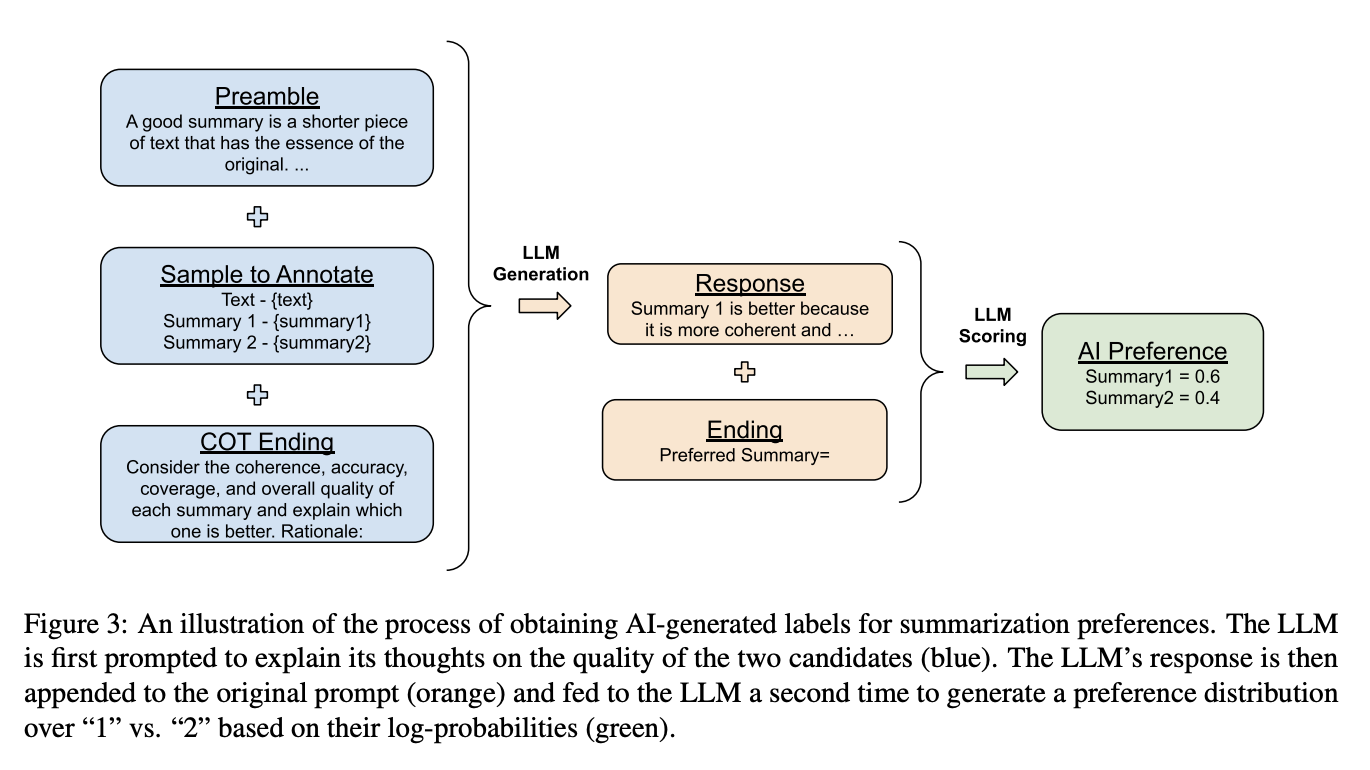
Sumber: Lee dkk., 2023
Setelah kita memperoleh label preferensi dari model umpan balik LLM, langkah berikutnya adalah menggunakan label ini untuk melatih model preferensi.
Model preferensi belajar memetakan konteks dan respons kandidat ke sinyal reward skalar, yang berfungsi sebagai proxy untuk preferensi manusia. Model preferensi yang telah dilatih ini kemudian diintegrasikan ke dalam siklus reinforcement learning.
Makalah RLAIF mengeksplorasi pendekatan alternatif di mana umpan balik LLM digunakan langsung sebagai sinyal reward, sehingga menghilangkan kebutuhan akan model preferensi terpisah. Namun, metode RLAIF "langsung" ini mahal secara komputasi, khususnya seiring meningkatnya ukuran LLM pelabel.
Dengan model preferensi yang tersedia, reinforcement learning dapat dilakukan menggunakan umpan balik AI sebagai sinyal reward. Agen (LLM dasar) berinteraksi dengan lingkungan, dan keluarannya dievaluasi oleh model preferensi, yang menetapkan reward berdasarkan seberapa baik tindakan tersebut selaras dengan preferensi yang diinginkan yang terenkode dalam model umpan balik.
RLAIF menawarkan sejumlah keunggulan yang meyakinkan dibanding RLHF tradisional, menjadikannya alternatif menarik untuk melatih dan menyempurnakan large language models. Mari telaah beberapa manfaat utama yang dibawa RLAIF.
Dengan mengotomatisasi proses pembuatan umpan balik, RLAIF menghilangkan kebutuhan akan anotator manusia, sehingga pengumpulan umpan balik dalam skala besar menjadi lebih efisien dan hemat biaya.
Pendekatan ini secara signifikan mengurangi hambatan terkait pengumpulan umpan balik manusia, seperti waktu, tenaga, dan biaya. Seiring LLM menjadi lebih andal, memanfaatkan sistem AI untuk mengawasi AI lain menjadi semakin bermanfaat, terutama ketika pengawasan manusia mungkin tidak memadai untuk model yang sangat canggih.
RLAIF sangat fleksibel dan mudah diadaptasikan untuk berbagai tugas dan domain. Dengan tidak bergantung pada dataset umpan balik manusia yang tetap, kita dapat dengan mudah menyesuaikan konstitusi atau data pelatihan yang digunakan untuk melakukan fine-tuning pada model umpan balik. Ini memungkinkan kita menyesuaikan perilaku LLM agar paling sesuai untuk berbagai tugas dan domain, memberikan solusi yang lebih terarah dan efektif.
Selain itu, prinsip-prinsip yang membimbing model umpan balik yang diinginkan secara eksplisit terenkode dalam instruksi bahasa alami, membentuk sebuah "konstitusi." Pendekatan ini meningkatkan transparansi, karena kriteria evaluasi diartikulasikan dengan jelas, berbeda dengan metode tradisional di mana prinsip umpan balik mungkin tersebar di ribuan label manusia individual.
Hasil eksperimen dari makalah RLAIF asli menunjukkan bahwa RLAIF menyamai kinerja RLHF dan, dalam beberapa kasus, bahkan melampauinya. Ini menunjukkan potensi RLAIF tidak hanya untuk merampingkan proses umpan balik, tetapi juga meningkatkan kinerja keseluruhan model yang dilatihnya.
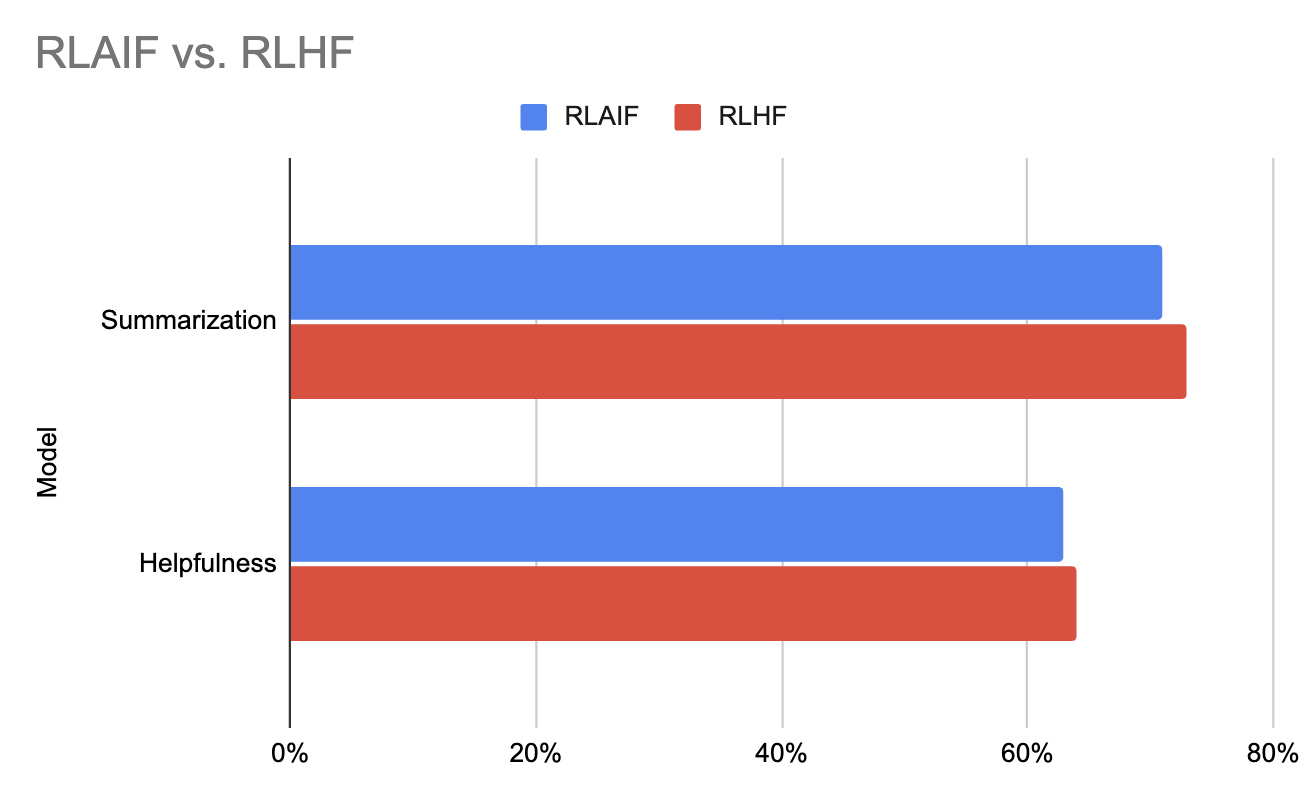
Grafik dibuat menggunakan data dalam makalah ini (Lee dkk., 2023)
Mari pertimbangkan juga grafik ini, yang menunjukkan bahwa RLAIF menghasilkan persentase dialog yang paling tidak berbahaya dibandingkan RLHF dan SFT.
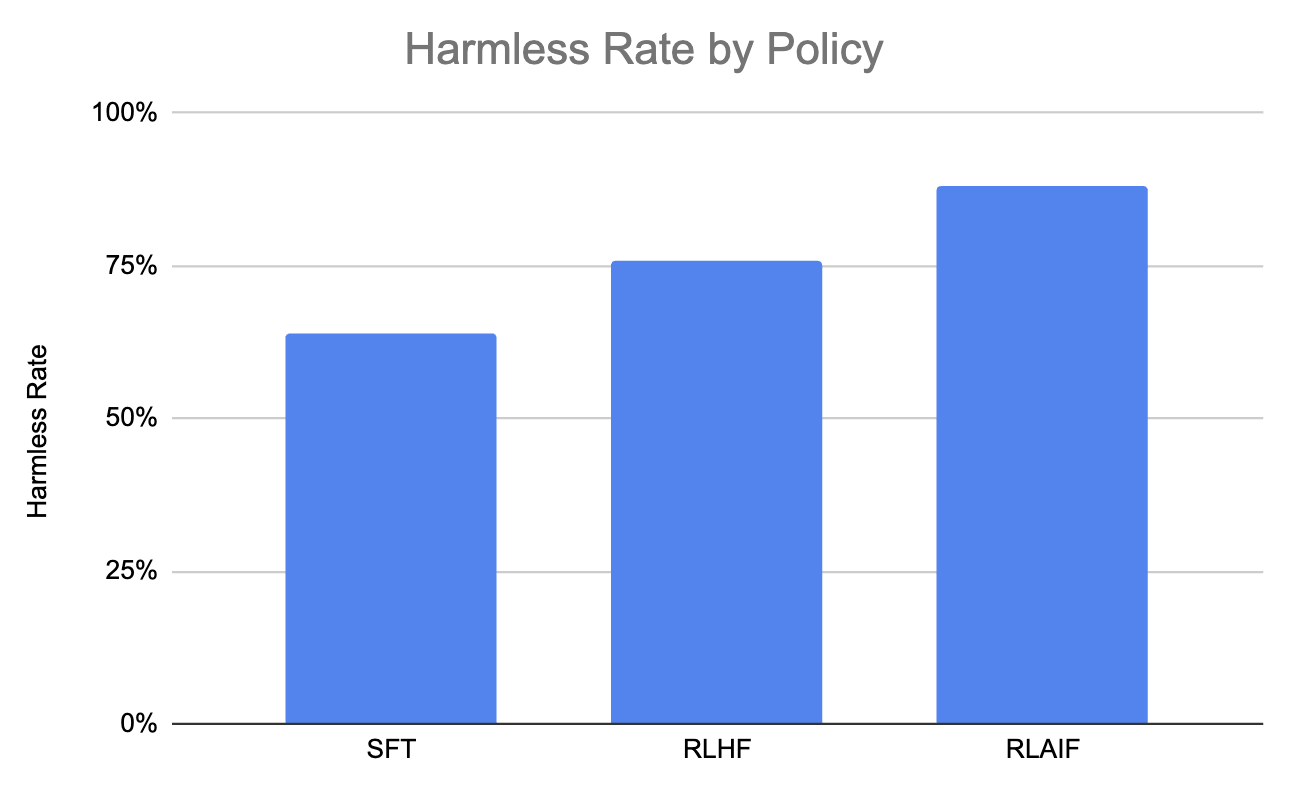
Grafik dibuat menggunakan data dalam makalah ini (Lee dkk., 2023)
Meskipun RLAIF menunjukkan hasil yang mengesankan, pendekatan ini juga menghadirkan tantangan baru yang harus diatasi:
Walaupun "konstitusi" bahasa alami memberikan transparansi lebih dibanding label manusia individual, pretraining LLM tetap merupakan sebuah “kotak hitam.” Karena itu, memastikan bahwa model umpan balik selaras dengan nilai dan preferensi manusia adalah tantangan krusial, karena ketidaksesuaian atau bias dalam model umpan balik dapat menimbulkan konsekuensi yang tidak diinginkan atau perilaku suboptimal dari agen.
Karena itu, untuk mengurangi risiko ini, umpan balik AI dapat melengkapi pengawasan manusia alih-alih menggantikannya sepenuhnya. Pendekatan ganda ini dapat membantu memastikan model tidak menyimpang dari perilaku yang disukai manusia seiring waktu, sehingga menjaga keselarasan dengan nilai-nilai manusia.
Walaupun penskalaan pengawasan manusia untuk model yang sangat besar itu menantang, kemampuan sistem AI saat ini untuk secara andal mengawasi dan mempertahankan perilaku yang tangguh pada asisten AI yang lebih andal masih menjadi pertanyaan terbuka. Oleh karena itu, metrik evaluasi yang ketat sangat penting untuk menilai kualitas dan keselarasan umpan balik AI yang dihasilkan oleh model umpan balik, guna memastikan keandalan dan efektivitasnya.
Seperti halnya model machine learning lainnya, model umpan balik dapat menunjukkan bias yang berasal dari data pelatihan atau proses pembelajaran itu sendiri. Strategi untuk mengurangi bias dalam umpan balik AI, seperti menggunakan data pelatihan yang beragam dan representatif, menerapkan metode evaluasi yang tangguh, serta memasukkan teknik seperti penalaran chain-of-thought, sangatlah krusial.
Dengan mengatasi tantangan-tantangan ini, RLAIF dapat dikembangkan menjadi alat yang tangguh dan andal untuk melatih sistem AI tingkat lanjut, memastikan keselarasan dengan nilai manusia dan kemampuan mempertahankan kinerja tinggi di berbagai tugas dan domain.
Kita dapat menerapkan RLAIF pada banyak tugas pemrosesan bahasa alami, termasuk:
Secara keseluruhan, makalah RLAIF (Lee dkk., 2023) memperkenalkan pendekatan yang dapat diskalakan untuk melatih LLM tanpa bergantung pada label umpan balik manusia. Dengan memanfaatkan "konstitusi" prinsip yang dienkode dalam bahasa alami dan kemampuan model awal yang membantu untuk mengkritik dirinya sendiri, para penulis menunjukkan hasil yang menjanjikan dalam mengarahkan perilaku model bahasa sambil meningkatkan transparansi dan fleksibilitas.
Poin pentingnya adalah bahwa RLAIF menunjukkan potensi untuk menskalakan pengawasan seiring model menjadi lebih andal, melengkapi dan sebagian mengotomatiskan pengawasan manusia. Pendekatan ini juga mengurangi masalah seperti spesifikasi reward yang keliru dan perilaku mengelak yang terlihat pada pendekatan umpan balik manusia sebelumnya. Namun, menjaga keselarasan manusia yang kuat, mengelola pergeseran distribusi, dan memastikan pengawasan yang andal untuk sistem AI tingkat lanjut tetap menjadi tantangan yang terbuka.
Ke depan, pekerjaan masa depan dapat mengeksplorasi integrasi demonstrasi penalaran manusia berkualitas tinggi untuk semakin memfokuskan dan meningkatkan model RLAIF. Memperluas pendekatan untuk mengarahkan perilaku LLM di sumbu lain seperti kepribadian dan gaya penulisan juga merupakan arah yang menarik.
Untuk mempelajari lebih lanjut tentang reinforcement learning, lihat tutorial pengantar ini: Reinforcement Learning: An Introduction With Python Examples.
Pelajari lebih lanjut tentang reinforcement learning dan AI!
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt




