

Khóa học
Reinforcement Learning với Gymnasium trong Python
4 giờ
14K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleHọc tăng cường là một kỹ thuật được sử dụng rộng rãi để huấn luyện các tác tử thông minh đưa ra quyết định hiệu quả trong môi trường của chúng. Trong lĩnh vực các mô hình ngôn ngữ lớn (LLM), điều này thường liên quan đến việc dẫn dắt quá trình học thông qua phản hồi của con người.
Tuy nhiên, dựa vào con người để cung cấp phản hồi có thể tốn kém, mất thời gian và đôi khi thiếu nhất quán. Học tăng cường từ phản hồi của AI (RLAIF) đưa ra một giải pháp thay thế bằng cách tận dụng sức mạnh của các mô hình AI hiện có.
Trong bài viết này, chúng tôi sẽ phân tích các khái niệm cốt lõi của RLAIF, khám phá cách nó hoạt động trong thực tế và thảo luận về những tác động của nó đối với tương lai phát triển AI.
Nếu bạn muốn tìm hiểu thêm về học tăng cường từ phản hồi của con người (RLHF), hãy xem bài viết này: Học tăng cường từ phản hồi của con người là gì.
Học tăng cường từ phản hồi của AI (RLAIF) là một kỹ thuật máy học trong đó các mô hình AI cung cấp phản hồi cho các mô hình AI khác trong quá trình học tăng cường.
Thay vì chỉ dựa vào đầu vào của con người, RLAIF tận dụng khả năng của các hệ thống AI hiện có, như các mô hình ngôn ngữ lớn, để đánh giá hành động và dẫn hướng việc học của các tác tử khác.
Phản hồi của AI có thể ở nhiều dạng, bao gồm tạo phần thưởng, xếp hạng phản hồi hoặc đề xuất cải thiện trực tiếp. Bằng cách tự động hóa vòng lặp phản hồi, RLAIF có tiềm năng hợp lý hóa quá trình huấn luyện, giảm chi phí và nâng cao hiệu suất của nhiều hệ thống AI, bao gồm cả các mô hình ngôn ngữ lớn.
Để hiểu RLAIF so với RLHF như thế nào, hãy bắt đầu bằng cách xem xét bảng sau:
|
Tính năng |
RLHF (Học tăng cường từ phản hồi của con người) |
RLAIF (Học tăng cường từ phản hồi của AI) |
|
Nguồn phản hồi |
Người gán nhãn |
Các mô hình AI hiện có (ví dụ: LLM) |
|
Khả năng mở rộng |
Bị giới hạn bởi nguồn cung và chi phí lao động con người |
Rất dễ mở rộng nhờ tự động hóa |
|
Chất lượng phản hồi |
Khả năng cao trong việc nắm bắt các sở thích tinh tế của con người |
Phụ thuộc vào năng lực của mô hình AI cung cấp phản hồi |
|
Chi phí |
Có thể đắt đỏ do cần lao động con người |
Tiết kiệm chi phí hơn nhờ tự động hóa |
|
Tốc độ |
Chậm hơn do thời gian cần cho việc gán nhãn của con người |
Nhanh hơn nhờ tạo phản hồi tự động |
|
Thiên lệch |
Có thể chịu ảnh hưởng bởi thiên kiến của con người |
Có thể kế thừa thiên kiến từ mô hình AI cung cấp phản hồi |
Để hiểu rõ hơn sự khác biệt giữa RLHF và RLAIF, hãy xem sơ đồ này từ bài báo RLAIF: Mở rộng học tăng cường từ phản hồi của con người bằng phản hồi của AI (Lee và cộng sự, 2023):
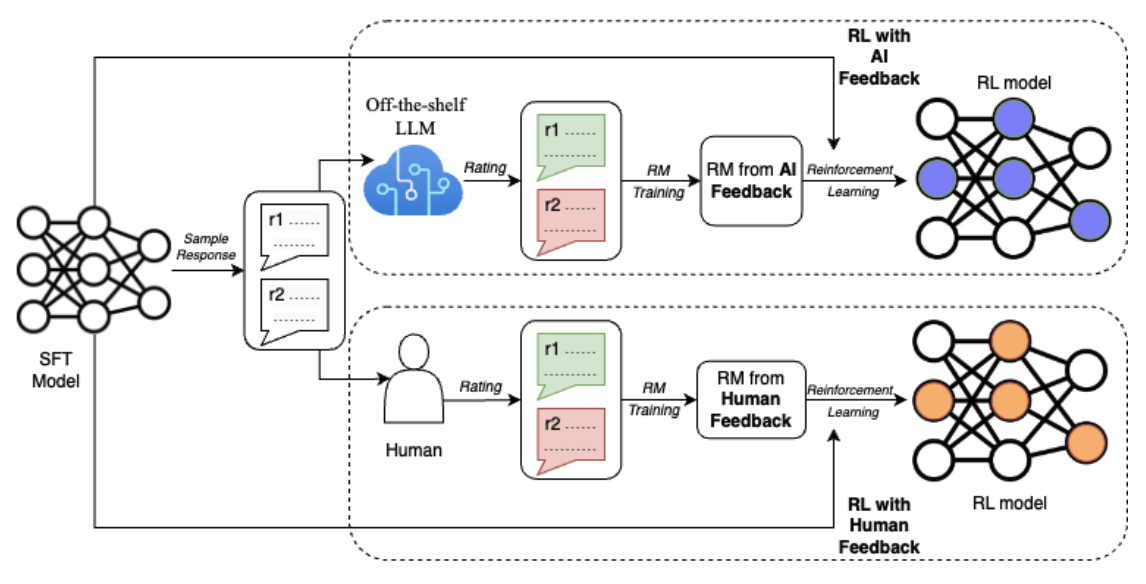
Nguồn: Lee và cộng sự, 2023
Sơ đồ minh họa khác biệt chính giữa RLHF và RLAIF trong quá trình học tăng cường. Cả hai phương pháp đều bắt đầu với một mô hình ban đầu (Mô hình SFT) tạo ra các phản hồi mẫu. Tuy nhiên, trong RLHF, con người đánh giá và chấm điểm các phản hồi này, còn trong RLAIF, một LLM có sẵn đóng vai trò giám khảo.
Các điểm số này sau đó được dùng để huấn luyện mô hình phần thưởng (RM). Cuối cùng, trong vòng lặp học tăng cường, mô hình RL nhận phần thưởng từ RM, được huấn luyện dựa trên phản hồi của con người (RLHF) hoặc phản hồi của AI (RLAIF). Vòng lặp phản hồi này cho phép mô hình RL liên tục học và cải thiện hiệu suất dựa trên loại phản hồi cụ thể mà nó nhận được.
Sau khi đã nắm các khái niệm cốt lõi của RLAIF và sự khác biệt của nó so với RLHF, hãy đi vào các bước thực tiễn để triển khai phương pháp này. Quy trình RLAIF thường gồm bốn giai đoạn chính, mỗi giai đoạn đóng vai trò quan trọng giúp mô hình AI học từ phản hồi do AI tạo ra.
Trong bài báo RLAIF gốc (Lee và cộng sự, 2023), một LLM "có sẵn" được dùng làm mô hình phản hồi cho gán nhãn sở thích. Đây là điểm khởi đầu tốt, nhưng trong một số tình huống, đặc biệt liên quan đến kiến thức hay thuật ngữ chuyên ngành, việc tinh chỉnh thêm LLM trên dữ liệu phù hợp có thể mang lại lợi thế.
Ví dụ, nếu mục tiêu là phát triển một trợ lý AI dành riêng cho lĩnh vực tài chính hoặc y tế, tinh chỉnh LLM trên kho văn bản tài chính hoặc y khoa có thể cải thiện đáng kể khả năng hiểu các khái niệm và biệt ngữ chuyên ngành.
Bước bổ sung này giúp mô hình đưa ra các đánh giá sở thích chính xác và phù hợp hơn, từ đó nâng cao chất lượng và độ tin cậy tổng thể của hệ thống AI trong các ứng dụng chuyên biệt.
Khi đã có mô hình LLM dùng cho phản hồi—dù là bản có sẵn hay đã tinh chỉnh—chúng ta có thể dùng nó để tạo nhãn sở thích.
Để tạo phản hồi AI, mô hình phản hồi được cung cấp ngữ cảnh và hai phản hồi ứng viên. Sau đó, mô hình được nhắc chọn phản hồi được ưa thích hơn. Trong bài báo RLAIF, lời nhắc đầu vào cho mô hình phản hồi tuân theo một cấu trúc:
Để hiểu rõ cấu trúc này, hãy xem hình dưới đây:
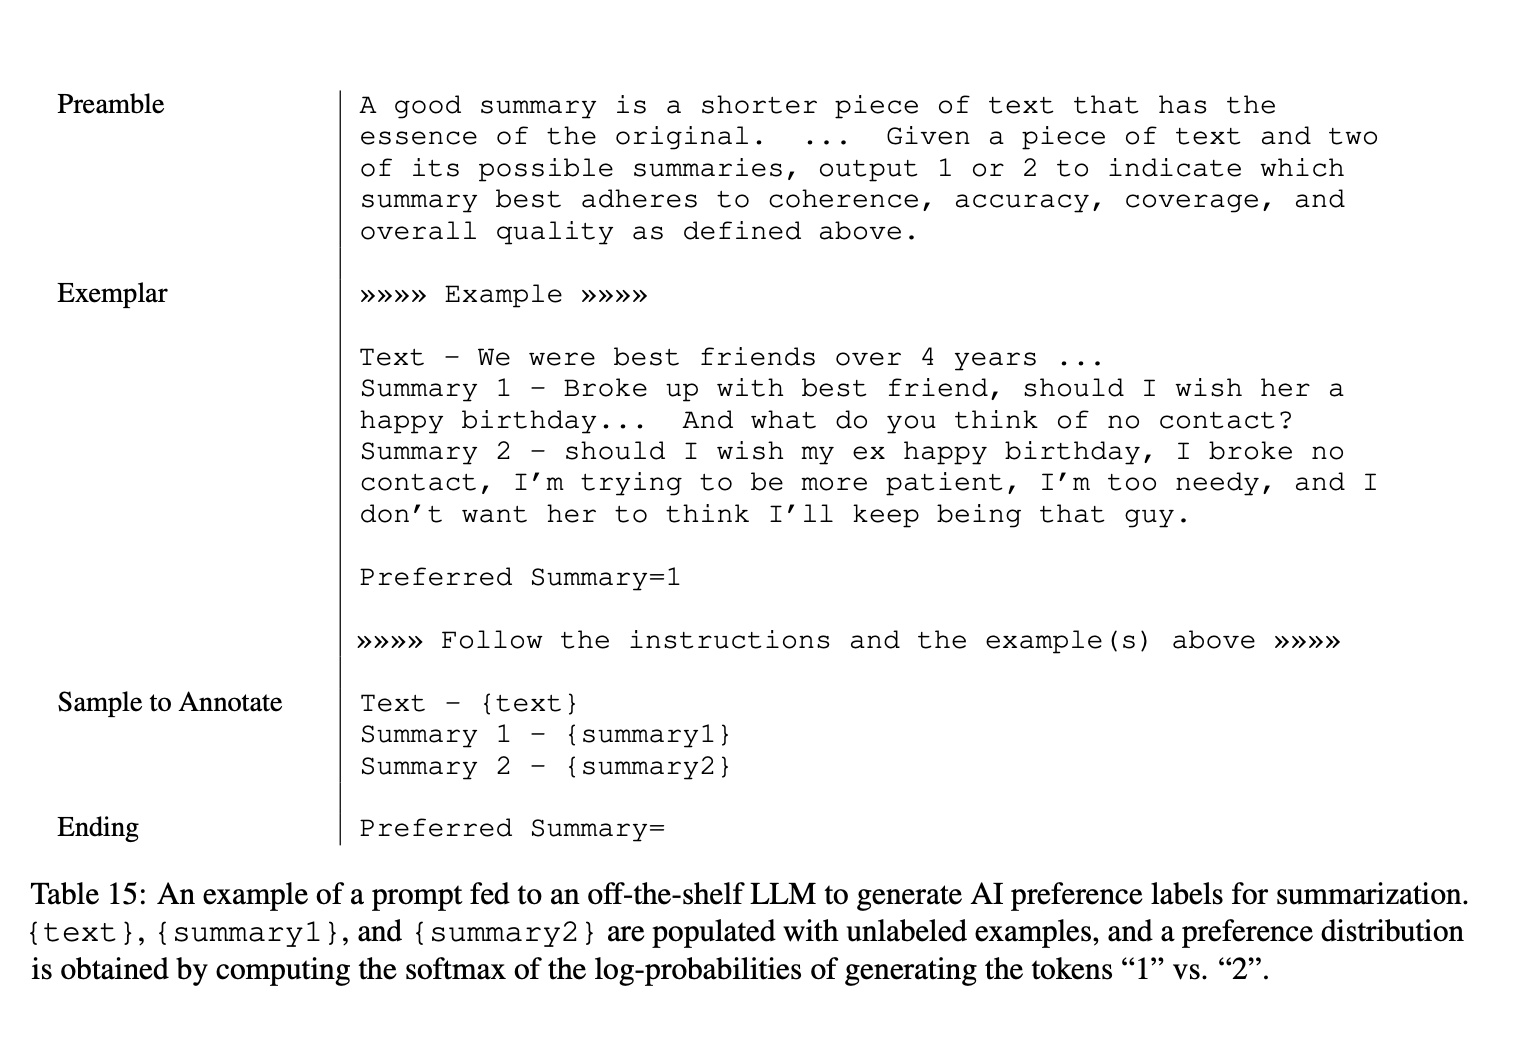
Nguồn: Lee và cộng sự, 2023
Cách tiếp cận có cấu trúc này giúp mô hình phản hồi đánh giá hiệu quả chất lượng các phản hồi và cung cấp nhãn sở thích chính xác. Bằng cách bổ sung các ví dụ mẫu, chúng ta có thể tăng hiệu quả của mô hình, đưa ra những ví dụ cụ thể về cách đánh giá phản hồi, từ đó làm cho phản hồi nhất quán và đáng tin cậy hơn.
Với lời nhắc đầu vào, mô hình LLM phản hồi sẽ tạo ra log-xác suất cho các token "1" và "2"—đại diện cho mức ưu tiên của mô hình đối với phản hồi thứ nhất hoặc thứ hai. Các log-xác suất này sau đó được đưa qua hàm softmax để thu được phân phối sở thích.
Trong bài báo RLAIF, hai phong cách mở đầu đã được thử nghiệm: “Cơ bản” và “Chi tiết”. Mở đầu Cơ bản yêu cầu mô hình phản hồi đánh giá phản hồi nào tốt hơn, trong khi Mở đầu Chi tiết đưa ra hướng dẫn toàn diện thường dùng cho người gán nhãn. Để hiểu rõ hơn, hãy xem ví dụ này:
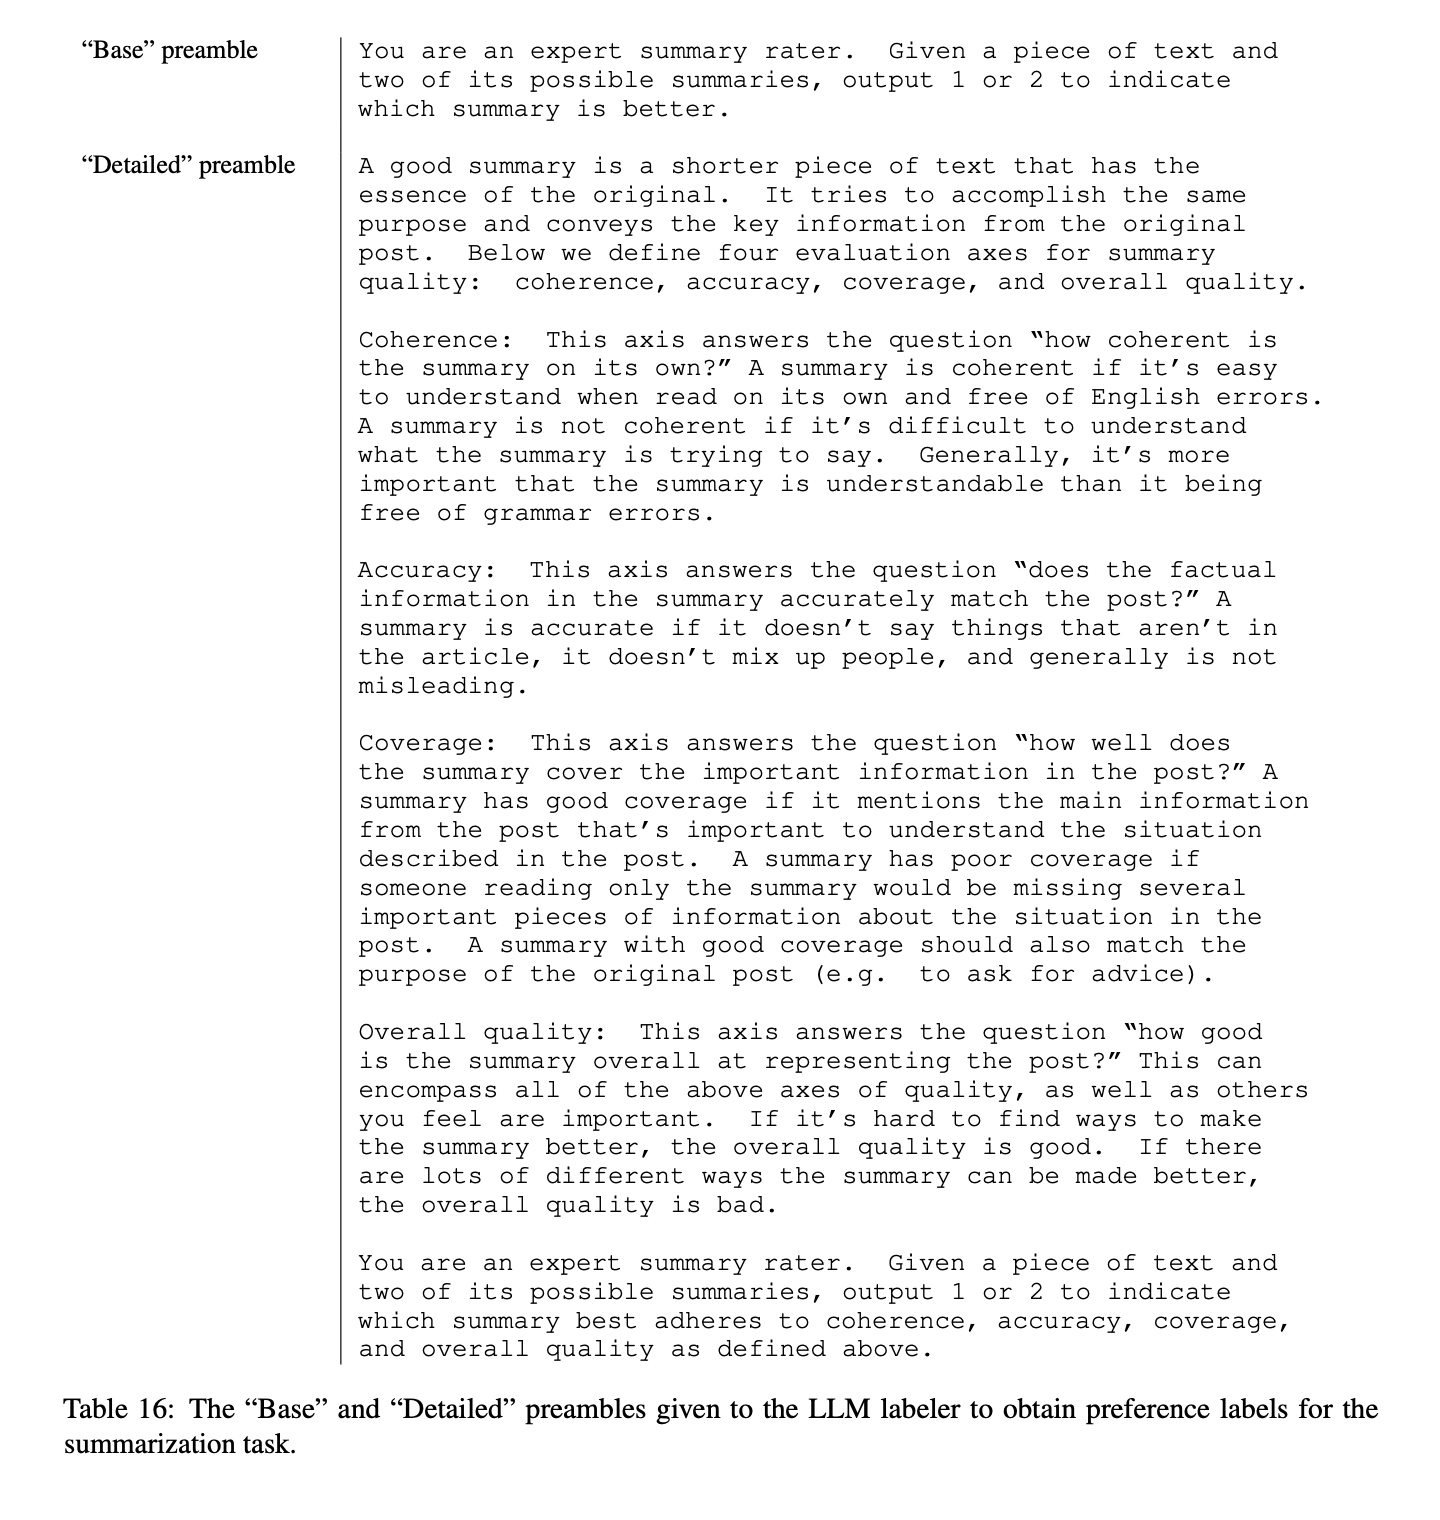
Nguồn: Lee và cộng sự, 2023
Cuối cùng, hai cân nhắc quan trọng đã được nghiên cứu để tăng hiệu quả của phương pháp RLAIF:
Để hiểu rõ hơn kỹ thuật CoT này, hãy xem sơ đồ từ bài báo:
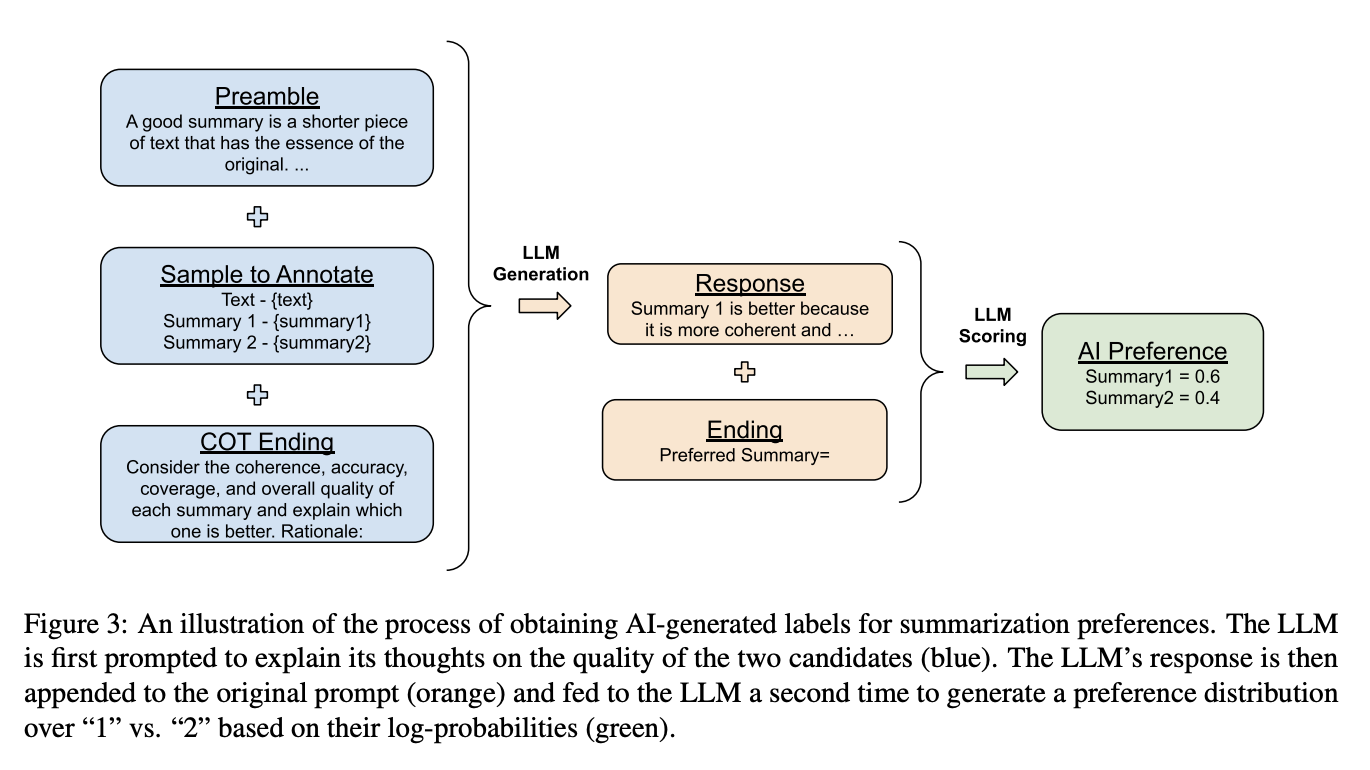
Nguồn: Lee và cộng sự, 2023
Khi đã có các nhãn sở thích từ mô hình LLM phản hồi, bước tiếp theo là sử dụng các nhãn này để huấn luyện mô hình sở thích.
Mô hình sở thích học cách ánh xạ ngữ cảnh và các phản hồi ứng viên thành một tín hiệu phần thưởng vô hướng, đóng vai trò như một đại diện cho sở thích của con người. Mô hình sở thích đã huấn luyện sau đó được tích hợp vào vòng lặp học tăng cường.
Bài báo RLAIF cũng khám phá một cách tiếp cận thay thế, trong đó phản hồi của LLM được dùng trực tiếp làm tín hiệu phần thưởng, loại bỏ nhu cầu về mô hình sở thích riêng biệt. Tuy nhiên, phương pháp RLAIF "trực tiếp" này tốn kém về tính toán, đặc biệt khi kích thước LLM gán nhãn tăng lên.
Khi đã có mô hình sở thích, có thể tiến hành học tăng cường bằng cách sử dụng phản hồi của AI làm tín hiệu phần thưởng. Tác tử (LLM nền) tương tác với môi trường, và đầu ra của nó được mô hình sở thích đánh giá, gán phần thưởng dựa trên mức độ hành động phù hợp với các sở thích mong muốn được mã hóa trong mô hình phản hồi.
RLAIF mang đến một số lợi thế thuyết phục so với RLHF truyền thống, khiến nó trở thành lựa chọn hấp dẫn để huấn luyện và tinh chỉnh các mô hình ngôn ngữ lớn. Hãy cùng xem một số lợi ích chính mà RLAIF đem lại.
Bằng cách tự động hóa quá trình tạo phản hồi, RLAIF loại bỏ nhu cầu về người gán nhãn, giúp thu thập phản hồi ở quy mô lớn hiệu quả và tiết kiệm chi phí hơn.
Cách tiếp cận này giảm đáng kể các nút thắt cổ chai liên quan đến việc thu thập phản hồi của con người, như thời gian, nhân lực và chi phí. Khi LLM ngày càng mạnh, việc tận dụng các hệ thống AI để giám sát các AI khác trở nên ngày càng hữu ích, đặc biệt khi giám sát của con người có thể không đủ cho các mô hình rất tiên tiến.
RLAIF có tính linh hoạt cao và có thể thích ứng với nhiều nhiệm vụ, lĩnh vực khác nhau. Vì không phụ thuộc vào các bộ dữ liệu phản hồi cố định của con người, chúng ta có thể dễ dàng điều chỉnh "hiến pháp" hoặc dữ liệu huấn luyện dùng để tinh chỉnh mô hình phản hồi. Điều này cho phép điều chỉnh hành vi LLM để phù hợp nhất với từng nhiệm vụ và lĩnh vực, mang lại giải pháp tùy biến và hiệu quả hơn.
Hơn nữa, các nguyên tắc dẫn dắt mô hình phản hồi mong muốn được mã hóa rõ ràng trong các hướng dẫn ngôn ngữ tự nhiên, tạo thành một "hiến pháp". Cách tiếp cận này tăng tính minh bạch, vì tiêu chí đánh giá được diễn đạt rõ ràng, khác với phương pháp truyền thống, nơi các nguyên tắc phản hồi có thể rải rác trong hàng nghìn nhãn lẻ của con người.
Kết quả thực nghiệm từ bài báo RLAIF gốc cho thấy RLAIF đạt hiệu suất tương đương RLHF và, trong một số trường hợp, còn vượt trội. Điều này chứng minh tiềm năng của RLAIF không chỉ hợp lý hóa quy trình phản hồi mà còn nâng cao hiệu suất tổng thể của các mô hình được huấn luyện.
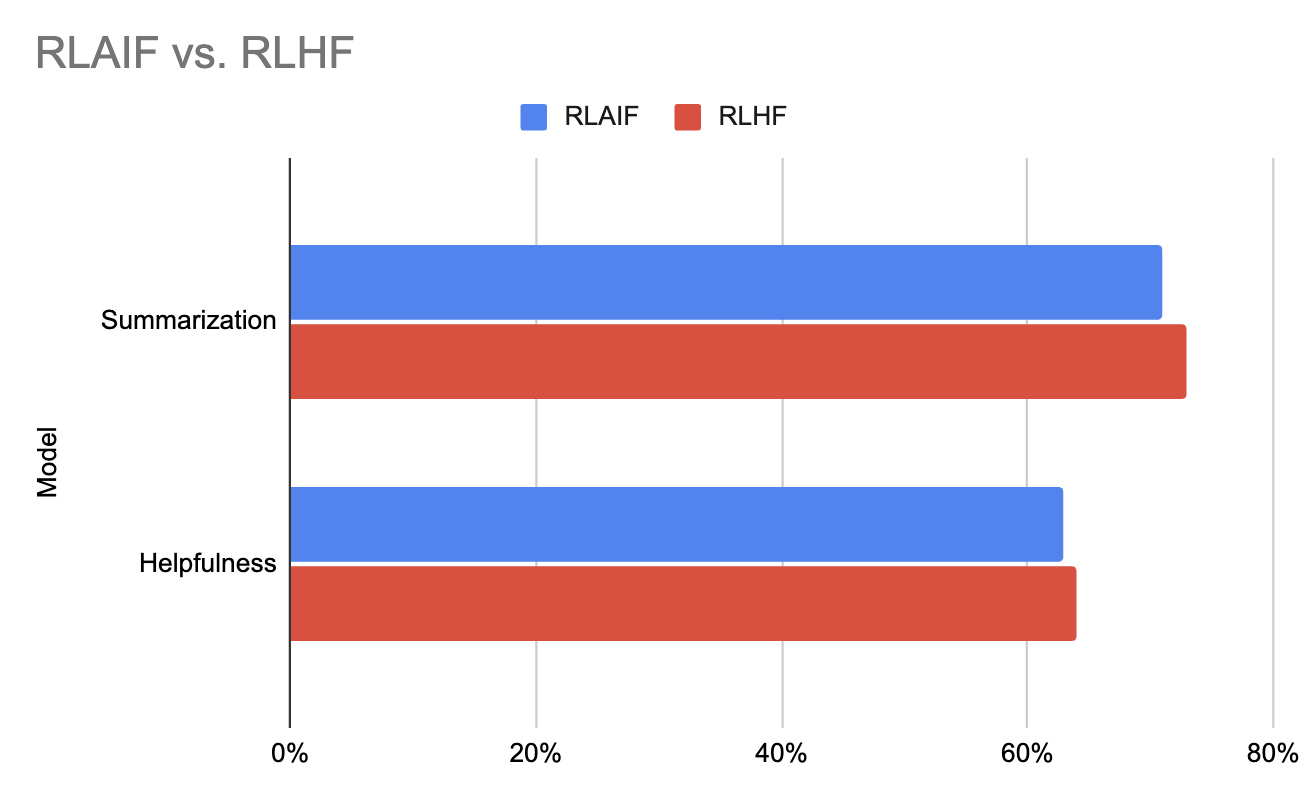
Biểu đồ được tạo từ dữ liệu trong bài báo này (Lee và cộng sự, 2023)
Hãy xem thêm biểu đồ này, cho thấy RLAIF tạo ra tỷ lệ đối thoại vô hại cao nhất so với RLHF và SFT.
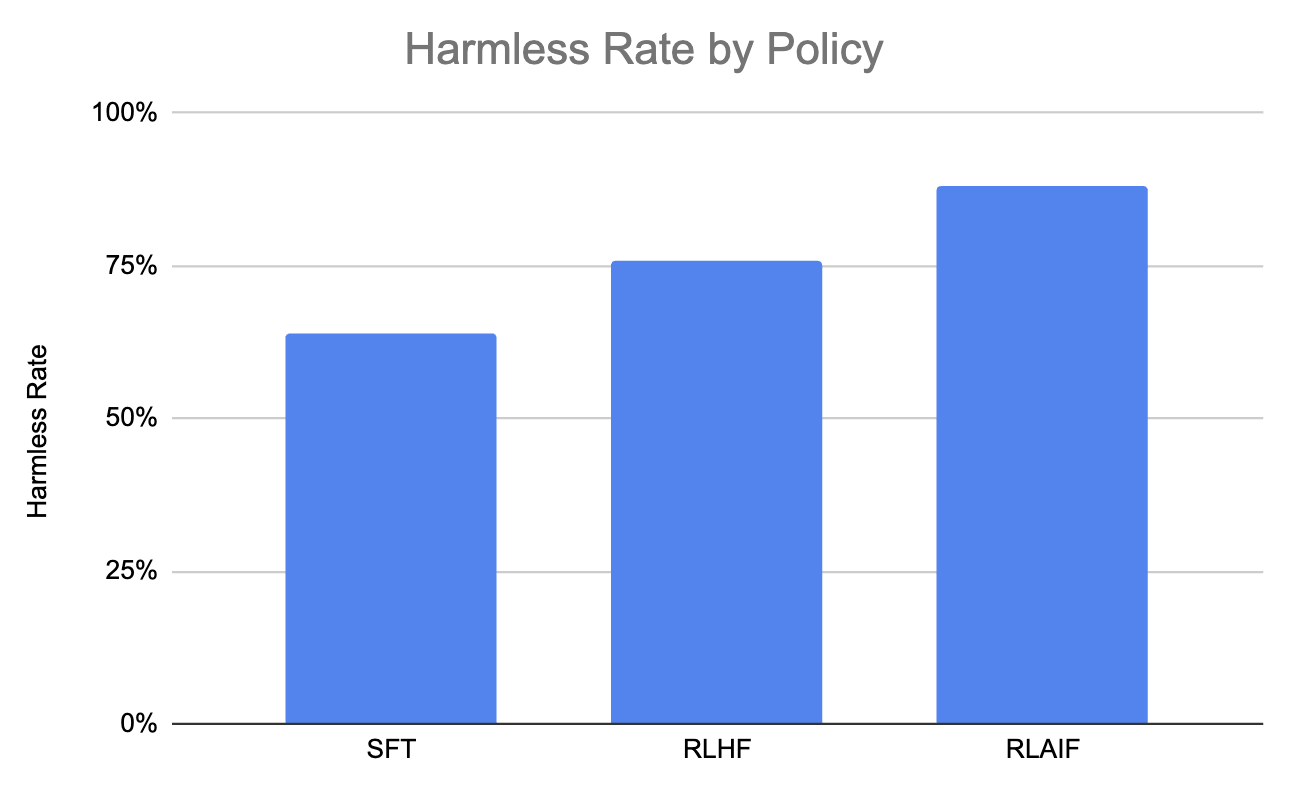
Biểu đồ được tạo từ dữ liệu trong bài báo này (Lee và cộng sự, 2023)
Mặc dù RLAIF cho thấy kết quả ấn tượng, nó cũng mang đến những thách thức mới cần được giải quyết:
Mặc dù "hiến pháp" bằng ngôn ngữ tự nhiên mang lại nhiều minh bạch hơn so với các nhãn lẻ của con người, quá trình tiền huấn luyện LLM vẫn là một “hộp đen”. Do đó, đảm bảo mô hình phản hồi phù hợp với các giá trị và sở thích của con người là một thách thức trọng yếu, vì lệch chuẩn hoặc thiên kiến trong mô hình phản hồi có thể dẫn đến hệ quả ngoài ý muốn hoặc hành vi kém tối ưu của tác tử.
Vì vậy, để giảm rủi ro, phản hồi của AI có thể bổ trợ cho giám sát của con người thay vì thay thế hoàn toàn. Cách tiếp cận kép này có thể giúp đảm bảo các mô hình không trôi xa khỏi hành vi được con người ưa thích theo thời gian, duy trì sự phù hợp với giá trị của con người.
Trong khi việc mở rộng giám sát của con người cho các mô hình rất lớn là khó khăn, khả năng của các hệ thống AI hiện nay trong việc giám sát đáng tin cậy và duy trì hành vi vững chắc ở các trợ lý AI có năng lực cao hơn vẫn là câu hỏi bỏ ngỏ. Do đó, cần có các chỉ số đánh giá nghiêm ngặt để thẩm định chất lượng và mức độ phù hợp của phản hồi AI do mô hình phản hồi tạo ra, bảo đảm độ tin cậy và hiệu quả.
Giống như bất kỳ mô hình học máy nào, các mô hình phản hồi có thể thể hiện thiên kiến bắt nguồn từ dữ liệu huấn luyện hoặc chính quá trình học. Các chiến lược giảm thiên kiến trong phản hồi AI, như sử dụng dữ liệu huấn luyện đa dạng và đại diện, áp dụng phương pháp đánh giá vững chắc, và tích hợp các kỹ thuật như lập luận chuỗi, là rất quan trọng.
Bằng cách giải quyết những thách thức này, RLAIF có thể được phát triển thành một công cụ mạnh mẽ và đáng tin cậy để huấn luyện các hệ thống AI tiên tiến, đảm bảo chúng phù hợp với giá trị của con người và duy trì hiệu suất cao trên nhiều nhiệm vụ, lĩnh vực.
Chúng ta có thể áp dụng RLAIF cho nhiều tác vụ xử lý ngôn ngữ tự nhiên, bao gồm:
Tổng thể, bài báo RLAIF (Lee và cộng sự, 2023) giới thiệu một cách tiếp cận có thể mở rộng để huấn luyện LLM mà không phụ thuộc vào nhãn phản hồi của con người. Bằng cách tận dụng một "hiến pháp" các nguyên tắc được mã hóa bằng ngôn ngữ tự nhiên và khả năng tự phê bình của một mô hình hữu ích ban đầu, các tác giả cho thấy kết quả đầy hứa hẹn trong việc dẫn dắt hành vi của mô hình ngôn ngữ, đồng thời cải thiện tính minh bạch và linh hoạt.
Một điểm cốt lõi là RLAIF cho thấy tiềm năng mở rộng giám sát khi các mô hình trở nên mạnh hơn, bổ trợ và tự động hóa một phần giám sát của con người. Nó cũng giảm thiểu các vấn đề như đặc tả phần thưởng sai và hành vi né tránh từng thấy ở các phương pháp phản hồi của con người trước đây. Tuy nhiên, duy trì sự phù hợp bền vững với con người, xử lý dịch chuyển phân phối và đảm bảo giám sát đáng tin cậy cho các hệ thống AI tiên tiến vẫn là những thách thức bỏ ngỏ.
Trong tương lai, các nghiên cứu có thể khám phá việc tích hợp các minh họa lập luận chất lượng cao của con người để tập trung và cải thiện hơn nữa các mô hình RLAIF. Mở rộng cách tiếp cận để điều hướng hành vi LLM trên các trục khác như tính cách và phong cách viết cũng là một hướng thú vị.
Để tìm hiểu thêm về học tăng cường, hãy xem hướng dẫn nhập môn này: Học tăng cường: Giới thiệu với các ví dụ Python.
Tìm hiểu thêm về học tăng cường và AI!
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
