

Kurs
Python ile Gymnasium'da Reinforcement Learning
4 sa
14K
Alıştırma and program your progress.
Google Ile Devam EdinPekiştirmeli öğrenme, zeki ajanları bulundukları ortamda etkili kararlar almaya yönelik eğitmek için yaygın olarak kullanılan bir tekniktir. Büyük dil modelleri (LLM'ler) alanında bu, çoğunlukla öğrenme sürecini insan geri bildirimiyle yönlendirmeyi içerir.
Ancak geri bildirim için insanlara güvenmek pahalı, zaman alıcı ve kimi zaman tutarsız olabilir. Yapay zeka geri bildiriminden pekiştirmeli öğrenme (RLAIF), mevcut yapay zeka modellerinin gücünden yararlanan alternatif bir çözüm sunar.
Bu yazıda RLAIF'in temel kavramlarını parçalara ayıracak, pratikte nasıl çalıştığını inceleyecek ve yapay zeka geliştirmesinin geleceği için ne anlama geldiğini tartışacağız.
İnsan geri bildiriminden pekiştirmeli öğrenme (RLHF) hakkında daha fazla bilgi edinmek isterseniz, İnsan Geri Bildiriminden Pekiştirmeli Öğrenme Nedir başlıklı bu makaleye göz atın.
Yapay zeka geri bildiriminden pekiştirmeli öğrenme (RLAIF), pekiştirmeli öğrenme sürecinde yapay zeka modellerinin diğer yapay zeka modellerine geri bildirim sağladığı bir makine öğrenimi tekniğidir.
Sadece insan girdisine dayanmak yerine, RLAIF mevcut yapay zeka sistemlerinin (örneğin büyük dil modelleri) yeteneklerinden yararlanarak eylemleri değerlendirir ve diğer ajanların öğrenmesini yönlendirir.
Bu yapay zeka geri bildirimi; ödül üretme, yanıtları sıralama veya doğrudan iyileştirme önerme gibi çeşitli biçimler alabilir. Geri bildirim döngüsünü otomatikleştirerek RLAIF, eğitimi kolaylaştırma, maliyetleri düşürme ve büyük dil modelleri de dahil olmak üzere çeşitli yapay zeka sistemlerinin performansını artırma potansiyeline sahiptir.
RLAIF'in RLHF ile nasıl karşılaştırıldığını anlamak için şu tabloyla başlayalım:
|
Özellik |
RLHF (İnsan Geri Bildiriminden Pekiştirmeli Öğrenme) |
RLAIF (Yapay Zeka Geri Bildiriminden Pekiştirmeli Öğrenme) |
|
Geri Bildirim Kaynağı |
İnsan anotatörler |
Mevcut yapay zeka modelleri (örn. LLM'ler) |
|
Ölçeklenebilirlik |
İnsan emeğinin bulunabilirliği ve maliyetiyle sınırlı |
Otomasyon sayesinde yüksek düzeyde ölçeklenebilir |
|
Geri Bildirim Kalitesi |
İnce insan tercihlerini yakalama potansiyeli yüksek |
Geri bildirim sağlayan yapay zeka modelinin yeteneklerine bağlı |
|
Maliyet |
İnsan emeği gerektirdiği için pahalı olabilir |
Otomasyon sayesinde potansiyel olarak daha uygun maliyetli |
|
Hız |
İnsan anotasyonu için gereken süre nedeniyle daha yavaş |
Otomatik geri bildirim üretimi sayesinde daha hızlı |
|
Önyargı |
İnsan önyargılarına tabi olabilir |
Geri bildirim sağlayan yapay zekadan önyargılar miras alınabilir |
RLHF ile RLAIF arasındaki farkları daha iyi anlamak için, RLAIF: Scaling Reinforcement Learning from Human Feedback with AI Feedback (Lee ve diğ., 2023) makalesinden bu diyagramı da ele alalım:
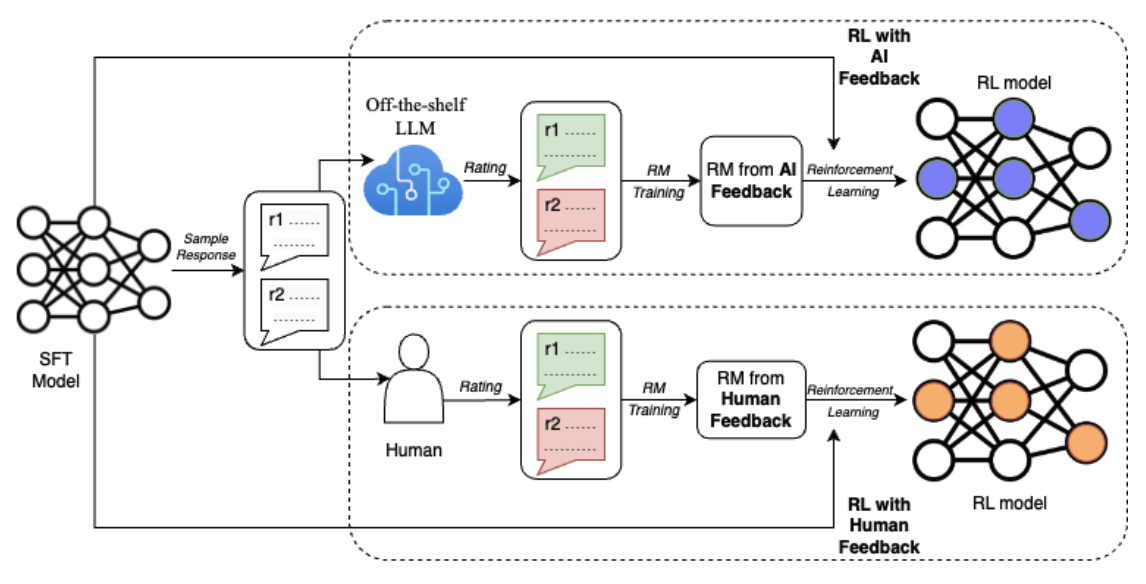
Kaynak: Lee ve diğ., 2023
Diyagram, pekiştirmeli öğrenme sürecinde RLHF ile RLAIF arasındaki temel farkı göstermektedir. Her iki yaklaşım da örnek yanıtlar üreten bir başlangıç modelinden (SFT Modeli) başlar. Ancak RLHF'de bu yanıtlara insan değerlendiriciler puan verirken, RLAIF'de raftan alınan bir LLM hakem görevi görür.
Bu puanlar daha sonra bir ödül modelini (RM) eğitmek için kullanılır. Son olarak, pekiştirmeli öğrenme döngüsünde RL modeli, ya insan geri bildirimi (RLHF) ya da yapay zeka geri bildirimi (RLAIF) üzerinde eğitilmiş olan RM'den ödüller alır. Bu geri bildirim döngüsü, RL modelinin aldığı geri bildirimin türüne bağlı olarak performansını sürekli öğrenip iyileştirmesini sağlar.
Artık RLAIF'in temel kavramlarını ve RLHF'den farkını belirlediğimize göre, bu yaklaşımın uygulanmasında yer alan pratik adımlara geçelim. RLAIF süreci genellikle, yapay zeka modellerinin yapay zeka tarafından üretilen geri bildirimlerden öğrenmesini mümkün kılan dört temel aşamadan oluşur.
Orijinal RLAIF makalesinde (Lee ve diğ., 2023), tercih etiketleme için geri bildirim modeli olarak "raftan alınan" bir LLM kullanılmıştır. Bu iyi bir başlangıç noktasıdır; ancak özellikle alan-özgü bilgi veya terminolojinin söz konusu olduğu senaryolarda, LLM'i ilgili veriler üzerinde daha da ince ayar yapmak avantaj sağlayabilir.
Örneğin amaç, finans veya sağlık gibi alanlara özel bir yapay zeka asistanı geliştirmekse, LLM'in finans veya tıp metinlerinden oluşan bir külliyat üzerinde ince ayar yapılması, alan-özgü kavram ve jargonu anlama yeteneğini önemli ölçüde artırabilir.
Bu ek adım, modelin daha doğru ve ilgili tercih yargıları sunmasını sağlar ve nihayetinde, uzmanlaşmış uygulamalarda yapay zeka sisteminin genel kalite ve güvenilirliğini artırır.
Geri bildirim modelimiz—ister raftan alınan bir sürüm ister ince ayarlı bir varyant olsun—hazır olduğunda, bunu tercih etiketleri üretmek için kullanabiliriz.
Yapay zeka geri bildirimi oluşturmak için, geri bildirim modeline bağlam ve iki aday yanıt sunulur. Ardından modelden hangi yanıtın tercih edildiğini belirlemesi istenir. RLAIF makalesinde, geri bildirim modeline verilen girdi istemi yapılandırılmış bir formata uyar:
Bu yapıyı daha iyi anlamak için aşağıdaki görseli inceleyin:
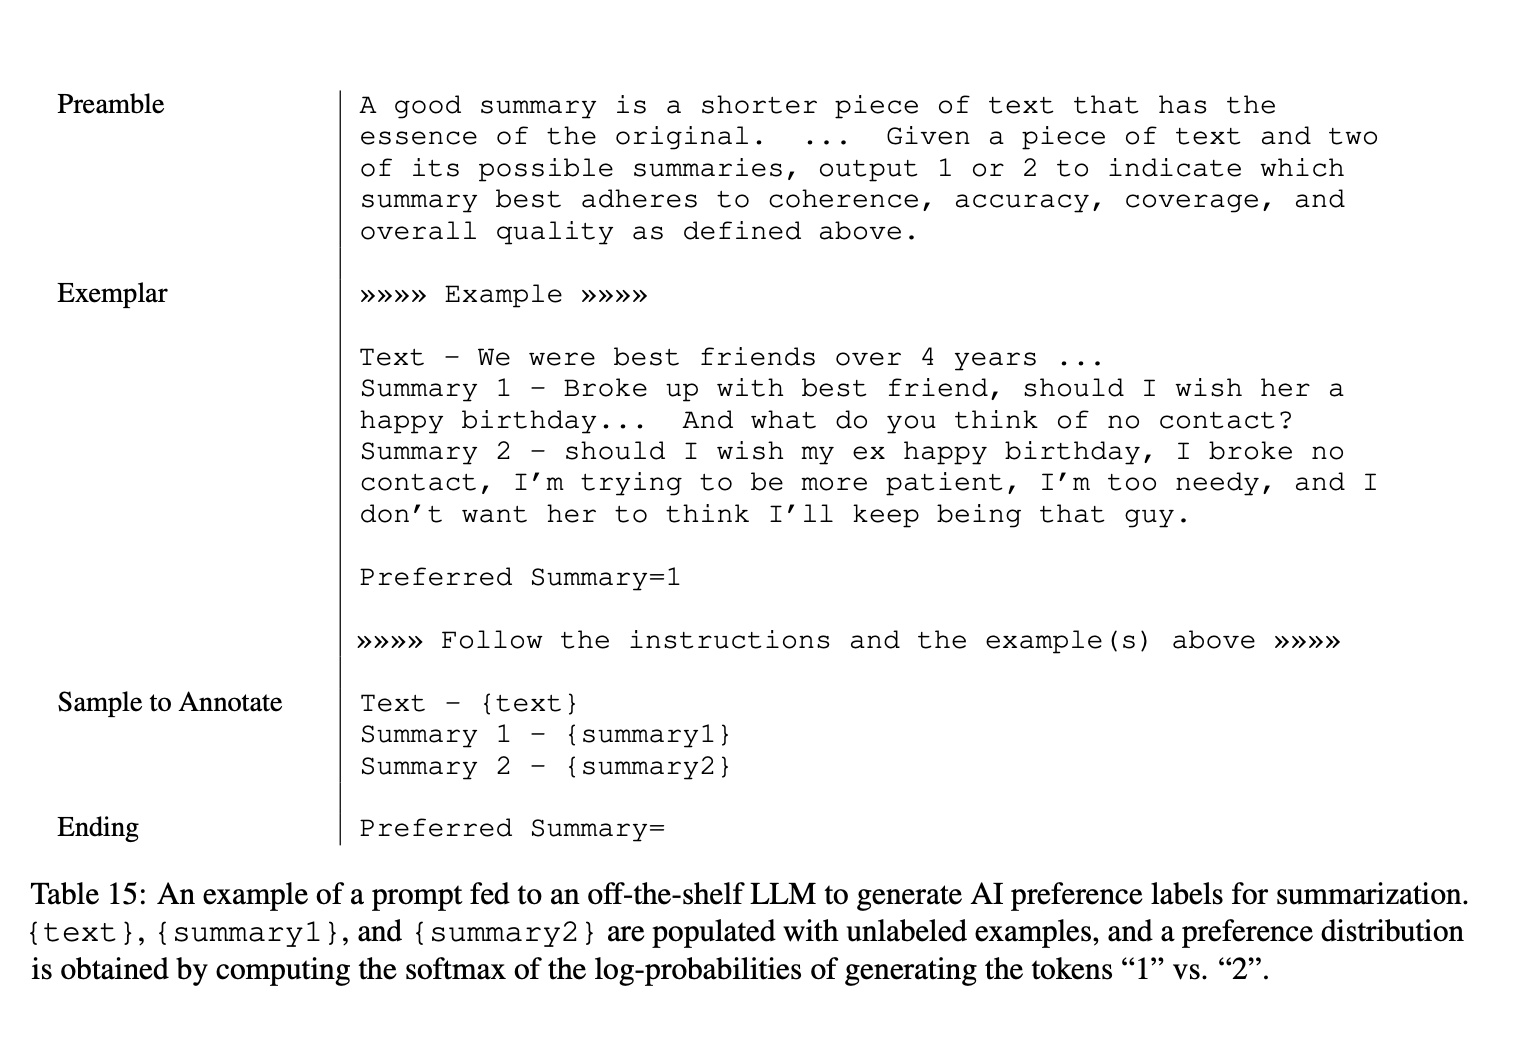
Kaynak: Lee ve diğ., 2023
Bu yapılandırılmış yaklaşım, geri bildirim modelinin yanıtların kalitesini etkin biçimde değerlendirmesini ve doğru tercih etiketleri vermesini sağlar. Az sayıda örnek eklemek, modele somut değerlendirme örnekleri göstererek performansını daha da artırır; böylece geri bildirim daha tutarlı ve güvenilir hale gelir.
Girdi istemi verildiğinde, LLM geri bildirim modeli "1" ve "2" belirteçleri için log-olasılıklar üretir—bu, modelin ilk ya da ikinci yanıta olan tercihinin bir göstergesidir. Bu log-olasılıklar daha sonra bir softmax fonksiyonundan geçirilerek bir tercih dağılımı elde edilir.
RLAIF makalesinde, iki tür önsözle denemeler yapılmıştır: “Temel” ve “Ayrıntılı”. Temel bir önsöz, geri bildirim modelinden hangi yanıtın daha iyi olduğunu yargılamasını isterken, Ayrıntılı önsöz tipik olarak insan anotatörlere verilen kapsamlı talimatları sunar. Bunu daha iyi anlamak için şu örneği ele alalım:
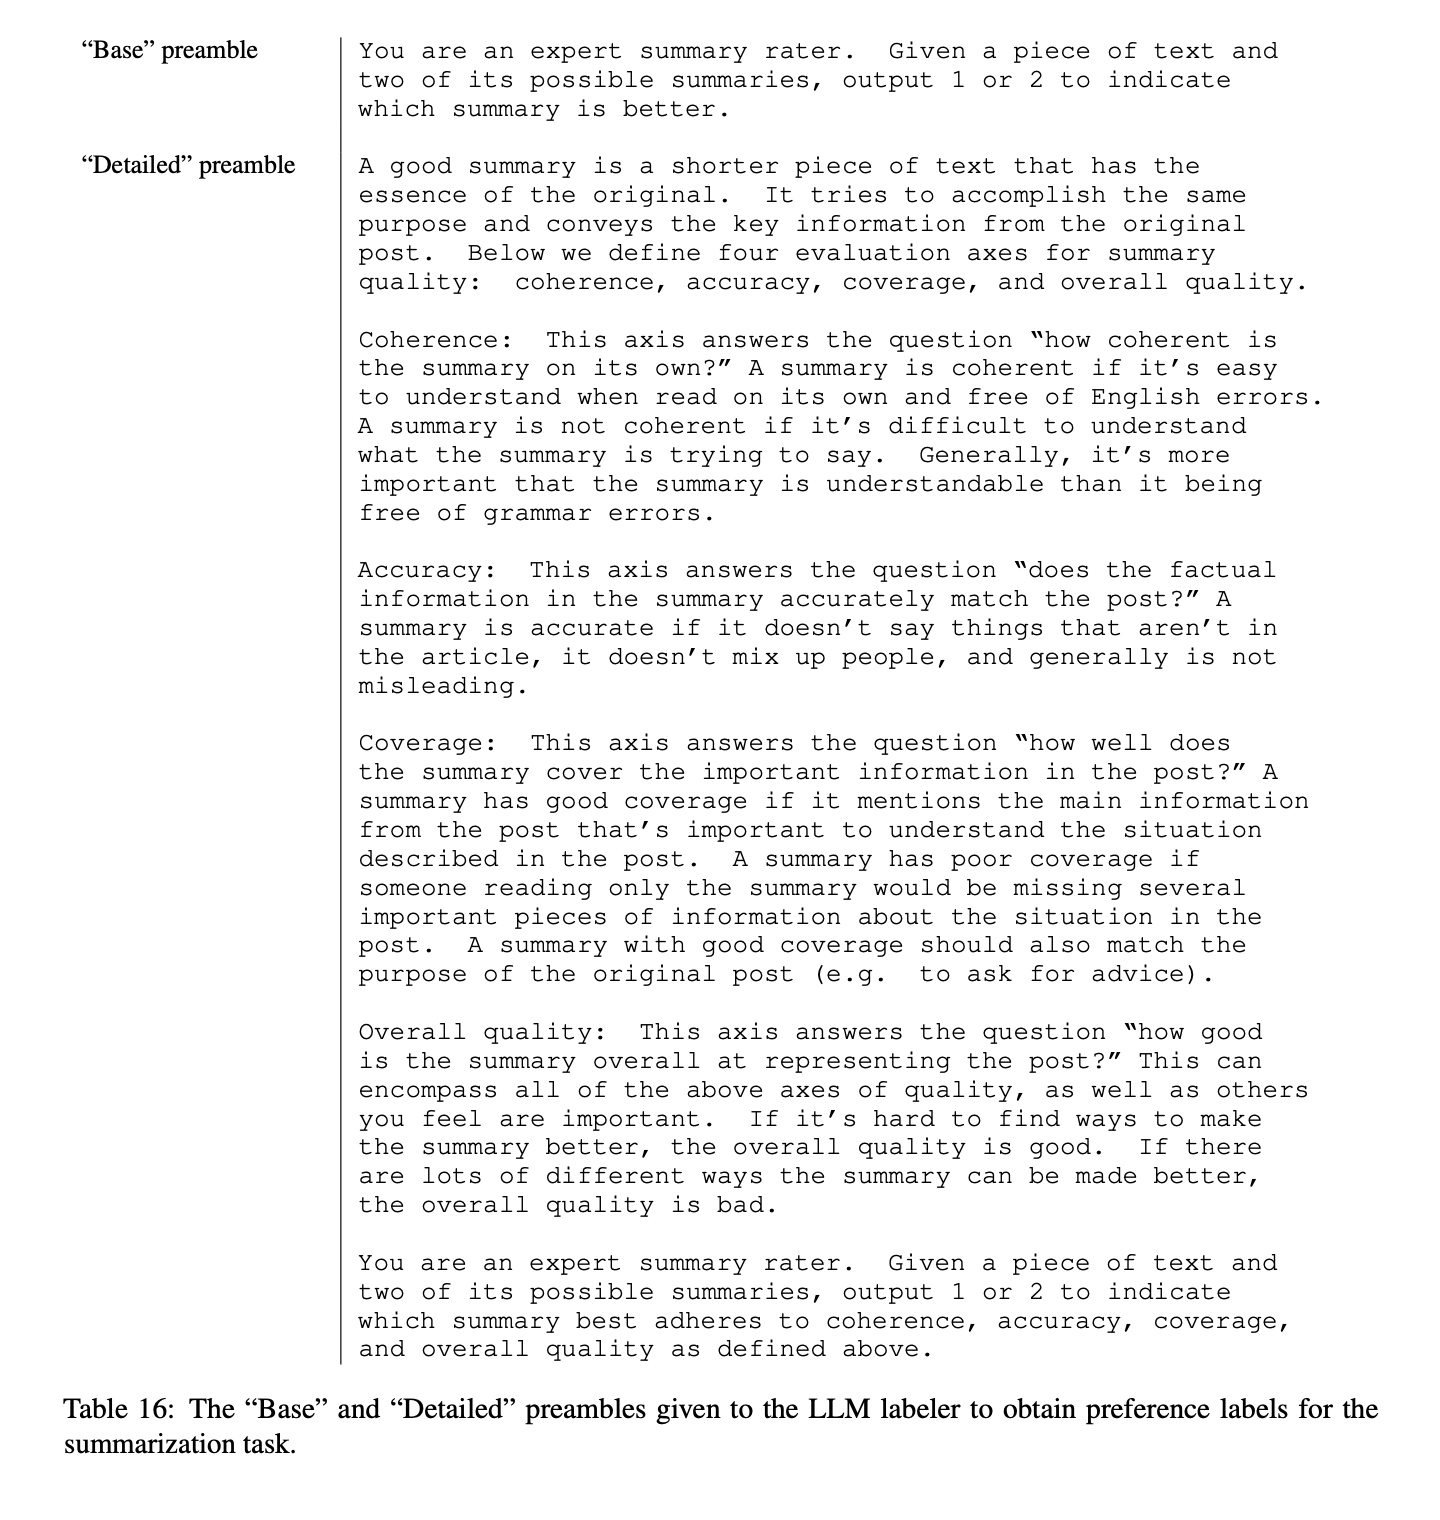
Kaynak: Lee ve diğ., 2023
Son olarak, RLAIF metodolojisinin etkinliğini artırmak için iki önemli husus ele alınmıştır:
Bu CoT tekniğini daha iyi anlamak için makaledeki şu diyagrama bakın:
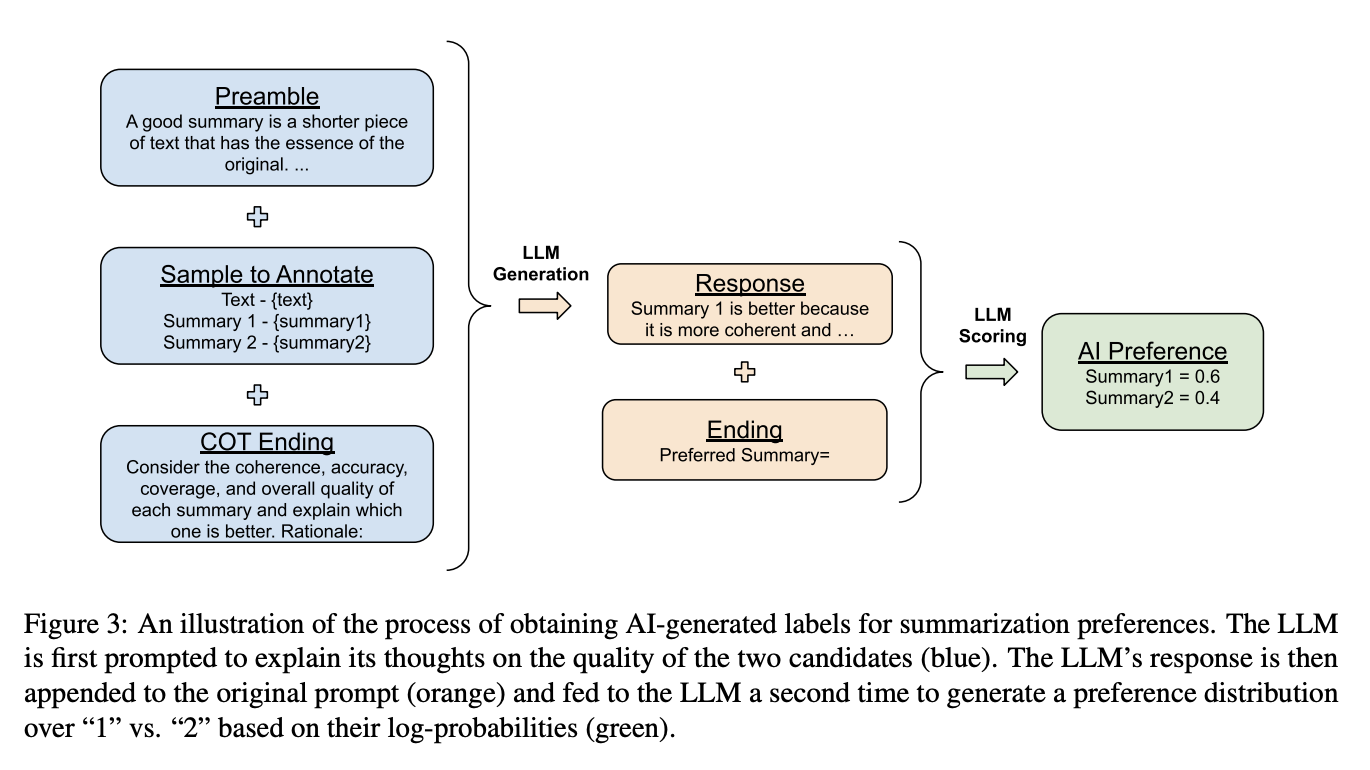
Kaynak: Lee ve diğ., 2023
LLM geri bildirim modelinden tercih etiketlerini elde ettikten sonra, sıradaki adım bu etiketleri kullanarak bir tercih modeli eğitmektir.
Tercih modeli, bağlam ve aday yanıtları, insan tercihinin vekili olarak hizmet eden skaler bir ödül sinyaline eşlemeyi öğrenir. Bu eğitilmiş tercih modeli daha sonra pekiştirmeli öğrenme döngüsüne entegre edilir.
RLAIF makalesi, ayrı bir tercih modeline ihtiyaç bırakmadan LLM geri bildirimini doğrudan ödül sinyali olarak kullanan alternatif bir yaklaşımı da inceler. Ancak bu "doğrudan" RLAIF yöntemi, özellikle LLM etiketleyicinin boyutu büyüdükçe hesaplama açısından maliyetlidir.
Tercih modeli hazır olduğunda, yapay zeka geri bildirimi ödül sinyali olarak kullanılarak pekiştirmeli öğrenme gerçekleştirilebilir. Ajan (temel LLM) çevreyle etkileşime girer ve çıktıları, geri bildirim modelinde kodlanan arzu edilen tercihlerle ne kadar uyumlu olduğuna göre ödül atayan tercih modeli tarafından değerlendirilir.
RLAIF, geleneksel RLHF'ye kıyasla bir dizi güçlü avantaj sunar ve büyük dil modellerini eğitmek ve iyileştirmek için cazip bir alternatif haline gelir. RLAIF'in sunduğu başlıca faydalardan bazılarına bakalım.
Geri bildirim üretim sürecini otomatikleştirerek RLAIF, insan anotatörlere duyulan ihtiyacı ortadan kaldırır; böylece büyük ölçekte geri bildirim toplamak daha verimli ve maliyet etkin hale gelir.
Bu yaklaşım, zaman, emek ve maliyet gibi insan geri bildirimi toplamayla ilişkili darboğazları önemli ölçüde azaltır. LLM'ler daha yetkin hale geldikçe, yapay zeka sistemlerini diğer yapay zekaları denetlemek için kullanmak özellikle insani denetimin çok gelişmiş modeller için yetersiz kalabildiği durumlarda giderek daha faydalı olur.
RLAIF, çeşitli görev ve alanlara son derece esnek ve uyarlanabilirdir. Sabit insan geri bildirim veri kümelerine bağlı kalınmadığı için, geri bildirim modelini ince ayarlamada kullanılan anayasa veya eğitim verilerini kolaylıkla değiştirebiliriz. Bu da LLM davranışını farklı görev ve alanlara en uygun hale getirmemize olanak tanır ve daha kişiselleştirilmiş, etkili bir çözüm sağlar.
Ayrıca, istenen geri bildirim modelini yönlendiren ilkeler, doğal dilde yazılmış yönergeler halinde açıkça kodlanır ve bir "anayasa" oluşturur. Bu yaklaşım, değerlendirme ölçütlerinin açıkça ifade edilmesi sayesinde şeffaflığı artırır; geleneksel yöntemlerde ise geri bildirim ilkeleri binlerce bireysel insan etiketi arasında dağılmış olabilir.
Orijinal RLAIF makalesinin deneysel sonuçları, RLAIF'in RLHF ile benzer performans sergilediğini ve bazı durumlarda onu aştığını göstermektedir. Bu, RLAIF'in yalnızca geri bildirim sürecini kolaylaştırmakla kalmayıp aynı zamanda eğittiği modellerin genel performansını da artırma potansiyeline sahip olduğunu göstermektedir.
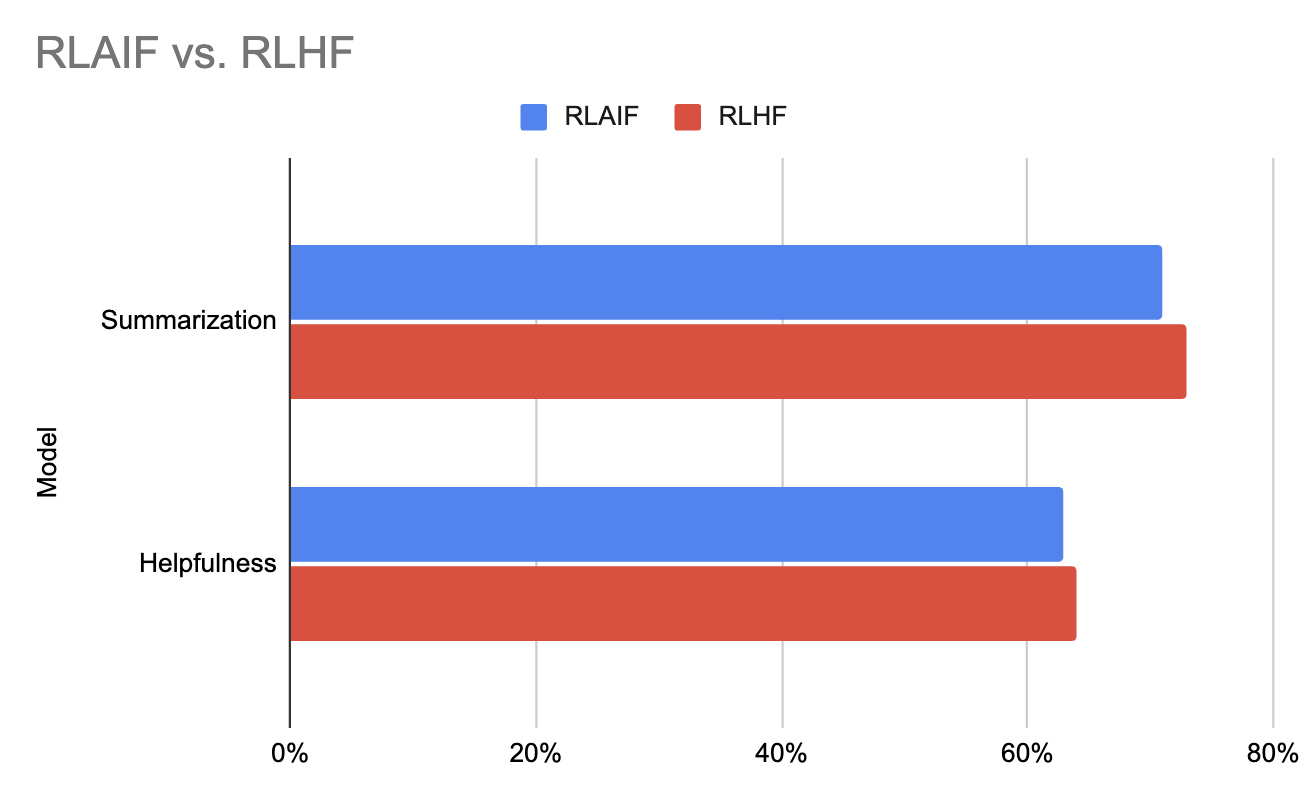
Grafik, bu makaledeki veriler kullanılarak oluşturulmuştur (Lee ve diğ., 2023)
Ayrıca, RLAIF'in RLHF ve SFT'ye kıyasla en yüksek oranda zararsız diyalog ürettiğini gösteren şu grafiği de ele alalım.
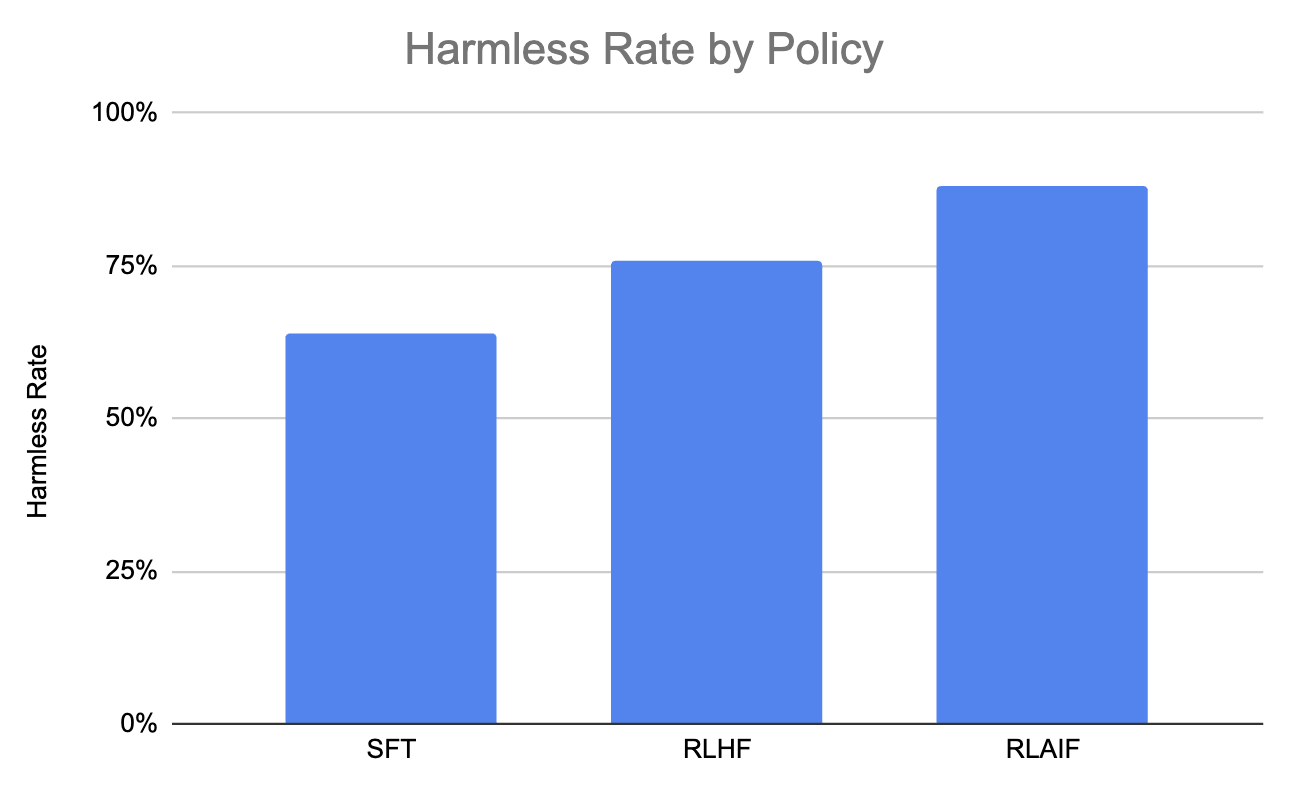
Grafik, bu makaledeki veriler kullanılarak oluşturulmuştur (Lee ve diğ., 2023)
RLAIF etkileyici sonuçlar göstermesine rağmen, ele alınması gereken yeni zorlukları da beraberinde getirir:
Doğal dilde yazılmış "anayasa", bireysel insan etiketlerine kıyasla daha fazla şeffaflık sağlasa da, LLM ön eğitimi hâlâ bir “kara kutu”dur. Bu nedenle, geri bildirim modelinin insan değerleri ve tercihleriyle uyumlu olmasını sağlamak kritik bir zorluktur; zira geri bildirim modelindeki uyumsuzluklar veya önyargılar, ajanın istenmeyen sonuçlar üretmesine ya da düşük performans göstermesine yol açabilir.
Bu riski azaltmak için, yapay zeka geri bildirimi insan denetiminin yerini tamamen almak yerine onu tamamlayabilir. Bu ikili yaklaşım, modellerin zaman içinde insanın tercih ettiği davranıştan uzaklaşmamasını ve insan değerleriyle hizalamanın korunmasını sağlayabilir.
Çok büyük modeller için insan denetimini ölçeklendirmek zor olsa da, mevcut yapay zeka sistemlerinin daha yetkin yapay zeka asistanlarını güvenilir biçimde denetleme ve sağlam davranışı sürdürme kabiliyeti hâlâ açık bir sorudur. Bu nedenle, geri bildirim modelinin ürettiği yapay zeka geri bildiriminin kalitesini ve hizasını değerlendirmek için sıkı ölçütler kritik önemdedir; böylece güvenilirlik ve etkinlik sağlanır.
Her makine öğrenimi modeli gibi, geri bildirim modelleri de eğitim verilerinden veya öğrenme sürecinin kendisinden kaynaklanan önyargılar sergileyebilir. Yapay zeka geri bildirimindeki önyargıları azaltmaya yönelik stratejiler—çeşitli ve temsili eğitim verileri kullanmak, sağlam değerlendirme yöntemleri uygulamak ve düşünce zinciri akıl yürütme gibi teknikleri dahil etmek—hayati öneme sahiptir.
Bu zorluklar ele alındığında, RLAIF gelişmiş yapay zeka sistemlerini eğitmek için sağlam ve güvenilir bir araç haline gelebilir; böylece bu sistemler insan değerleriyle hizalı kalır ve çeşitli görev ve alanlarda yüksek performansı sürdürebilir.
RLAIF'i aşağıdakiler de dahil olmak üzere birçok doğal dil işleme görevine uygulayabiliriz:
Genel olarak, RLAIF makalesi (Lee ve diğ., 2023), insan geri bildirim etiketlerine dayanmadan LLM'leri eğitmek için ölçeklenebilir bir yaklaşım sunar. Doğal dilde kodlanmış ilke "anayasası"ndan ve başlangıçta yardımcı bir modelin öz-eleştiri yeteneklerinden yararlanarak, yazarlar dil modeli davranışını yönlendirme konusunda şeffaflık ve esnekliği artırırken umut verici sonuçlar göstermektedir.
Önemli bir çıkarım, modeller daha yetkin hale geldikçe RLAIF'in denetimi ölçeklendirme potansiyeli taşıması, insan gözetimini tamamlaması ve kısmen otomatikleştirmesidir. Ayrıca, önceki insan geri bildirim yaklaşımlarında görülen ödül yanlış belirtimi ve kaçamak davranış gibi sorunları hafifletir. Ancak, sağlam insan hizasını korumak, dağılımsal kaymayı yönetmek ve gelişmiş yapay zeka sistemleri için güvenilir denetim sağlamak hâlâ açık zorluklardır.
İleriye dönük olarak, gelecekteki çalışmalar, RLAIF modellerini daha fazla odaklamak ve geliştirmek amacıyla yüksek kaliteli insan akıl yürütme gösterimlerinin entegrasyonunu keşfedebilir. Yaklaşımın, kişilik ve yazı üslubu gibi diğer eksenlerde LLM davranışını yönlendirecek şekilde genişletilmesi de ilgi çekici bir yönelimdir.
Pekiştirmeli öğrenme hakkında daha fazla bilgi edinmek için, Pekiştirmeli Öğrenme: Python Örnekleriyle Bir Giriş başlıklı bu giriş niteliğindeki eğitimi inceleyin.
Pekiştirmeli öğrenme ve yapay zeka hakkında daha fazlasını keşfedin!
Kurs
Kurs
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




