

Cursus
Reinforcement Learning met Gymnasium in Python
4 uur
14K
Oefen en volg je voortgang.
Ga Verder Met GoogleReinforcement learning is een veelgebruikte techniek om intelligente agenten te trainen om effectieve beslissingen te nemen binnen hun omgeving. In de wereld van large language models (LLM’s) houdt dit vaak in dat het leerproces wordt gestuurd door menselijke feedback.
Het inschakelen van mensen voor feedback kan echter duur, tijdrovend en soms inconsistent zijn. Reinforcement learning from AI feedback (RLAIF) biedt een alternatief dat de kracht van bestaande AI-modellen benut.
In dit artikel leggen we de kernconcepten van RLAIF uit, bekijken we hoe het in de praktijk werkt en bespreken we de implicaties voor de toekomst van AI-ontwikkeling.
Wil je meer weten over reinforcement learning from human feedback (RLHF)? Lees dan dit artikel: What is Reinforcement Learning from Human Feedback.
Reinforcement learning from AI feedback (RLAIF) is een machinelearningtechniek waarbij AI-modellen feedback geven aan andere AI-modellen tijdens het reinforcement learning-proces.
In plaats van uitsluitend te vertrouwen op menselijke input, benut RLAIF de mogelijkheden van bestaande AI-systemen, zoals large language models, om acties te beoordelen en het leren van andere agenten te sturen.
Deze AI-feedback kan verschillende vormen aannemen, zoals het genereren van beloningen, het rangschikken van antwoorden of het rechtstreeks suggereren van verbeteringen. Door de feedbacklus te automatiseren, kan RLAIF de training stroomlijnen, kosten verlagen en de prestaties van diverse AI-systemen, waaronder large language models, verbeteren.
Om te begrijpen hoe RLAIF zich verhoudt tot RLHF, beginnen we met deze tabel:
|
Kenmerk |
RLHF (Reinforcement Learning from Human Feedback) |
RLAIF (Reinforcement Learning from AI Feedback) |
|
Bron van feedback |
Menselijke annotators |
Bestaande AI-modellen (bijv. LLM’s) |
|
Schaalbaarheid |
Beperkt door beschikbaarheid en kosten van menselijk werk |
Zeer schaalbaar dankzij automatisering |
|
Kwaliteit van feedback |
Grote kans om genuanceerde menselijke voorkeuren vast te leggen |
Afhankelijk van de capaciteiten van het AI-model dat feedback geeft |
|
Kosten |
Kunnen hoog zijn door de inzet van menselijk werk |
Potentieel kostenefficiënter dankzij automatisering |
|
Snelheid |
Langzamer door de tijd die menselijke annotatie vergt |
Sneller dankzij geautomatiseerde feedbackgeneratie |
|
Bias |
Kan onderhevig zijn aan menselijke vooroordelen |
Kan vooroordelen erven van het AI-model dat feedback geeft |
Om de verschillen tussen RLHF en RLAIF beter te begrijpen, bekijken we ook dit diagram uit de paper RLAIF: Scaling Reinforcement Learning from Human Feedback with AI Feedback (Lee et al., 2023):
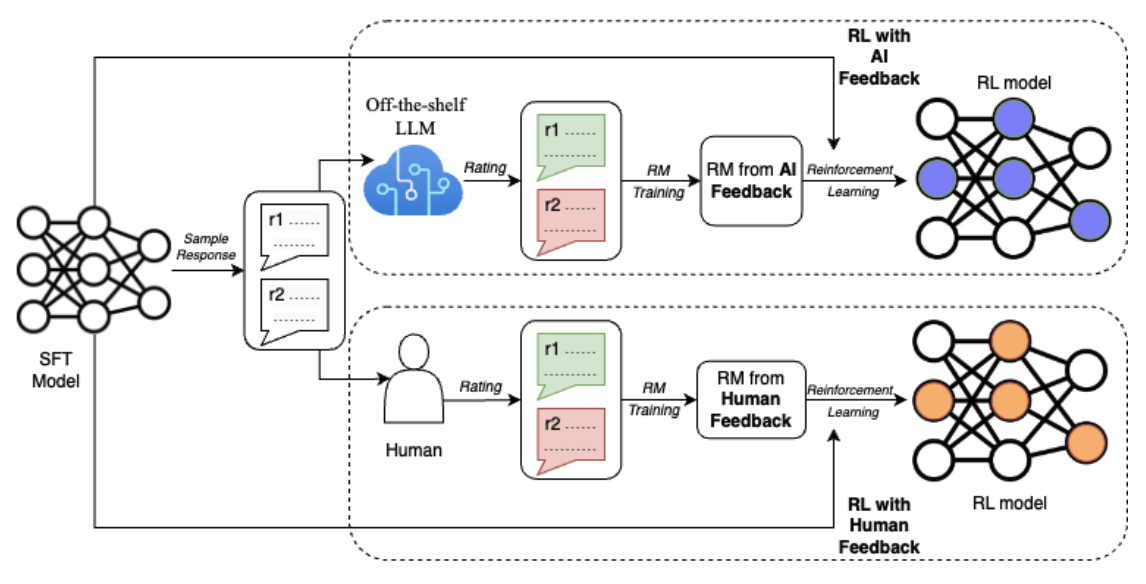
Bron: Lee et al., 2023
Het diagram laat het belangrijkste verschil zien tussen RLHF en RLAIF binnen het reinforcement learning-proces. Beide benaderingen beginnen met een initiëel model (SFT Model) dat voorbeeldantwoorden genereert. Bij RLHF geven menselijke beoordelaars vervolgens ratings voor deze antwoorden, terwijl bij RLAIF een kant-en-klaar LLM optreedt als scheidsrechter.
Deze ratings worden gebruikt om een rewardmodel (RM) te trainen. Ten slotte ontvangt het RL-model in de reinforcement learning-lus beloningen van de RM, die is getraind op ofwel menselijke feedback (RLHF) of AI-feedback (RLAIF). Deze feedbacklus stelt het RL-model in staat om continu te leren en zijn prestaties te verbeteren op basis van het specifieke type feedback dat het ontvangt.
Nu we de kernconcepten van RLAIF en het verschil met RLHF hebben vastgesteld, duiken we in de praktische stappen om deze aanpak te implementeren. Het RLAIF-proces bestaat doorgaans uit vier fasen, die elk een cruciale rol spelen om AI-modellen te laten leren van door AI gegenereerde feedback.
In de oorspronkelijke RLAIF-paper (Lee et al., 2023) werd een “off-the-shelf” LLM gebruikt als feedbackmodel voor voorkeurlabeling. Dat is een goed startpunt, maar in bepaalde scenario’s, vooral bij domeinspecifieke kennis of terminologie, kan het nuttig zijn het LLM verder te fine-tunen op relevante data.
Als het doel bijvoorbeeld is om een AI-assistent te ontwikkelen voor de financiële of medische sector, kan fine-tuning van het LLM op een corpus van financiële of medische teksten het begrip van domeinspecifieke concepten en jargon aanzienlijk verbeteren.
Deze extra stap zorgt ervoor dat het model nauwkeurigere en relevantere voorkeursoordelen kan geven, wat uiteindelijk de algemene kwaliteit en betrouwbaarheid van het AI-systeem in gespecialiseerde toepassingen verbetert.
Zodra we ons LLM-feedbackmodel hebben—ofwel een off-the-shelf versie of een getunede variant—kunnen we het gebruiken om voorkeurlabels te genereren.
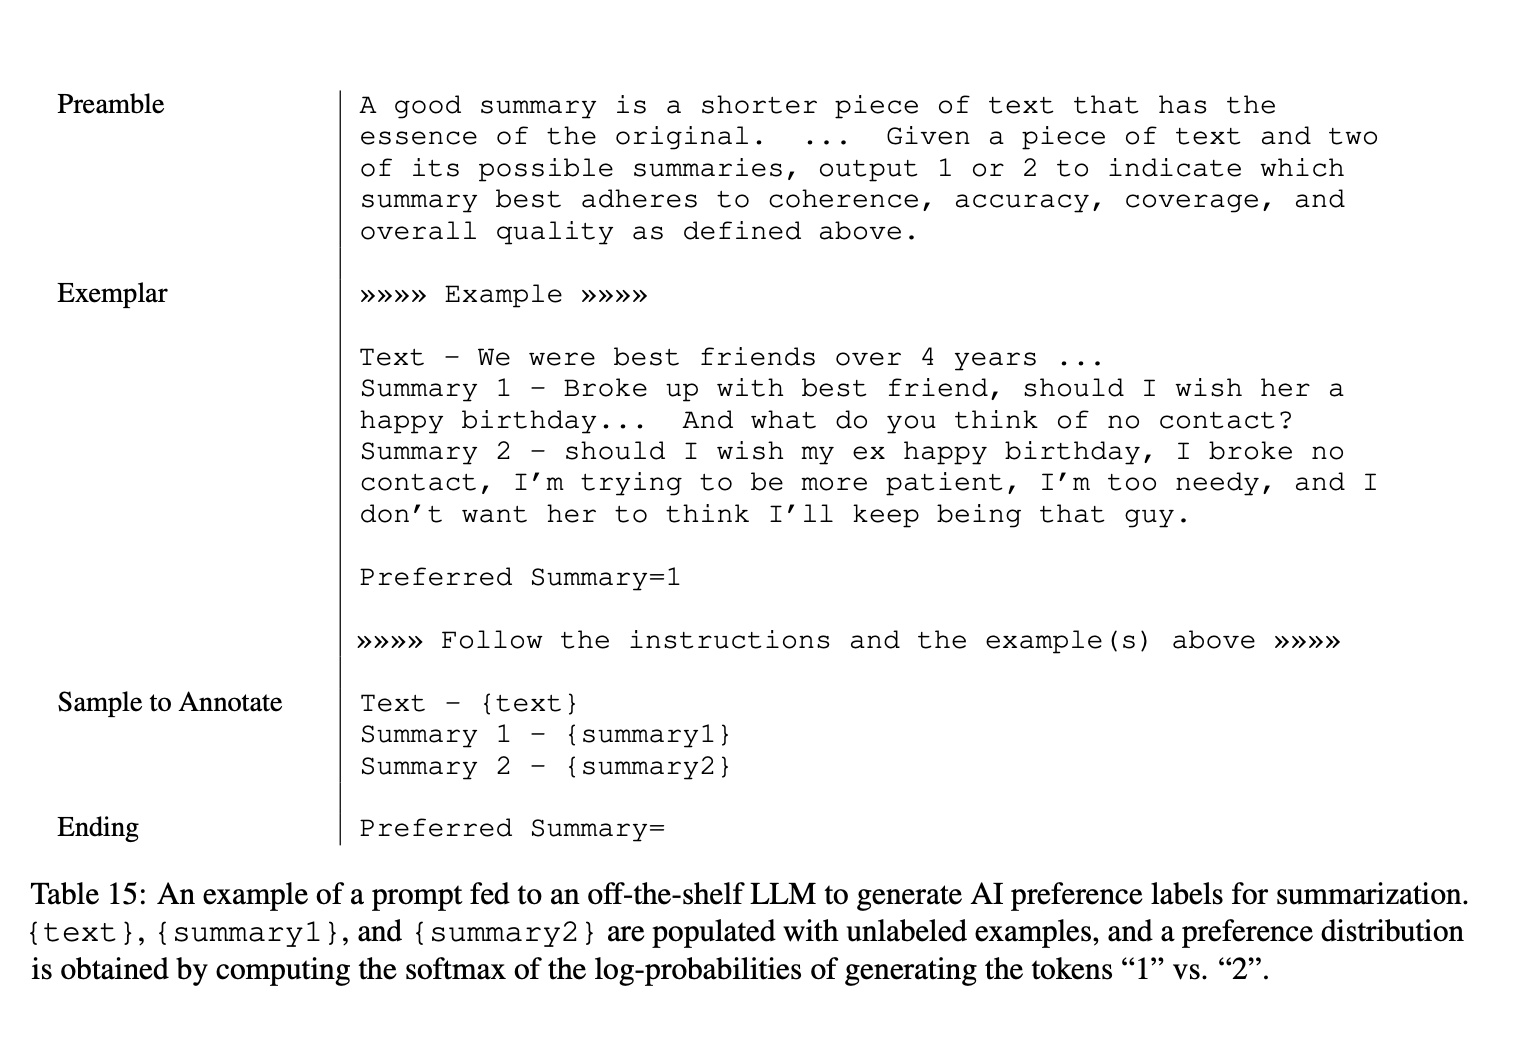
Om AI-feedback te genereren, krijgt het feedbackmodel de context en twee kandidaatantwoorden aangeboden. Het model wordt dan gevraagd te bepalen welk antwoord de voorkeur heeft. In de RLAIF-paper volgt de invoerprompt aan het feedbackmodel een gestructureerd format:
Om deze structuur beter te begrijpen, bekijk de onderstaande afbeelding:
Bron: Lee et al., 2023
Deze gestructureerde aanpak zorgt ervoor dat het feedbackmodel de kwaliteit van de antwoorden effectief kan beoordelen en nauwkeurige voorkeurslabels kan geven. Door few-shot-voorbeelden op te nemen, kunnen we de prestaties van het model verder verbeteren, met concrete voorbeelden van hoe te evalueren, waardoor de feedback consistenter en betrouwbaarder wordt.
Gezien de invoerprompt genereert het LLM-feedbackmodel de logwaarschijnlijkheden voor de tokens "1" en "2"—die de voorkeur voor respectievelijk het eerste of tweede antwoord representeren. Deze logwaarschijnlijkheden gaan vervolgens door een softmax-functie om een voorkeursverdeling te verkrijgen.
In de RLAIF-paper zijn twee stijlen inleidingen getest: “Base” en “Detailed”. Een Base-inleiding vraagt het feedbackmodel te beoordelen welk antwoord beter is, terwijl een Detailed-inleiding uitgebreide instructies bevat die doorgaans aan menselijke annotators worden gegeven. Om dit beter te begrijpen, bekijken we dit voorbeeld:
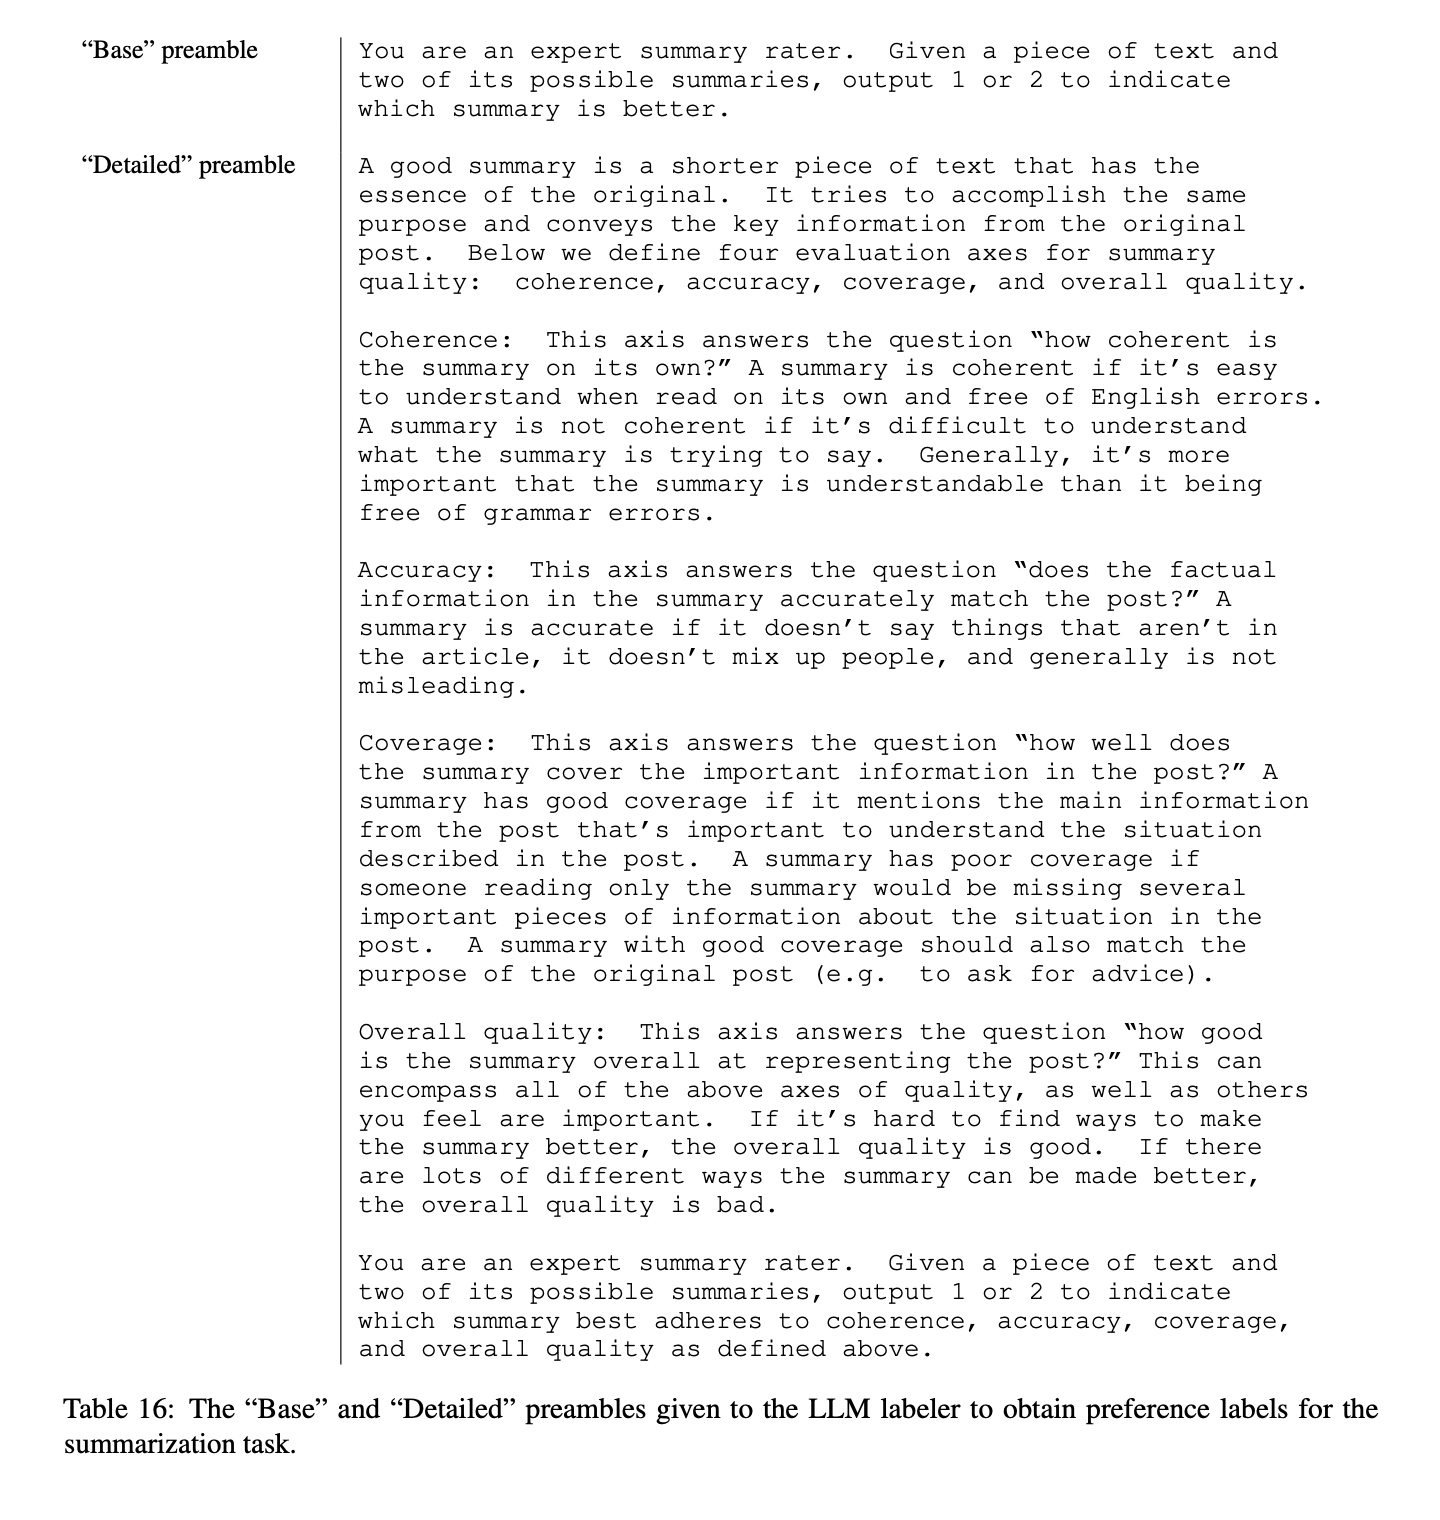
Bron: Lee et al., 2023
Tot slot zijn twee belangrijke overwegingen onderzocht om de effectiviteit van de RLAIF-methodologie te vergroten:
Om deze CoT-techniek beter te begrijpen, bekijk dit diagram uit de paper:
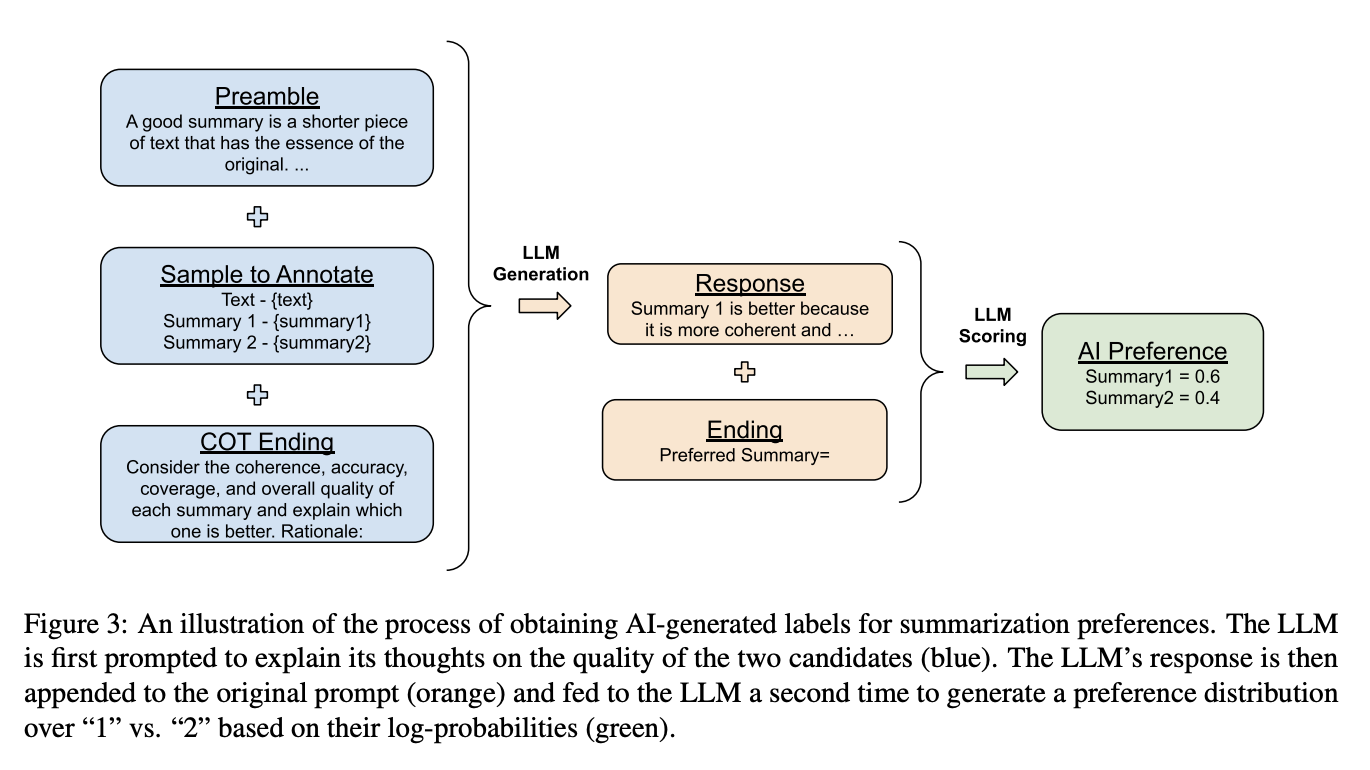
Bron: Lee et al., 2023
Zodra we voorkeurslabels van het LLM-feedbackmodel hebben, is de volgende stap om deze labels te gebruiken voor het trainen van een voorkeursmodel.
Het voorkeursmodel leert de context en kandidaatantwoorden te koppelen aan een scalair beloningssignaal, dat fungeert als proxy voor menselijke voorkeuren. Dit getrainde voorkeursmodel wordt vervolgens geïntegreerd in de reinforcement learning-cyclus.
De RLAIF-paper onderzoekt een alternatieve aanpak waarbij de LLM-feedback direct als beloningssignaal wordt gebruikt, waardoor een apart voorkeursmodel overbodig is. Deze “directe” RLAIF-methode is echter computationeel duur, vooral naarmate de LLM-labeler groter wordt.
Met het voorkeursmodel op zijn plaats kan reinforcement learning worden uitgevoerd met AI-feedback als beloningssignaal. De agent (basis-LLM) interacteert met de omgeving en zijn output wordt beoordeeld door het voorkeursmodel, dat een beloning toekent op basis van hoe goed de actie aansluit bij de gewenste voorkeuren die in het feedbackmodel zijn vastgelegd.
RLAIF biedt verschillende overtuigende voordelen ten opzichte van traditioneel RLHF en is daarmee een aantrekkelijke optie voor het trainen en verfijnen van large language models. Laten we enkele belangrijke pluspunten bekijken.
Door de feedbackgeneratie te automatiseren, elimineert RLAIF de noodzaak van menselijke annotators, waardoor het verzamelen van feedback op schaal efficiënter en kosteneffectiever wordt.
Deze aanpak vermindert de knelpunten die gepaard gaan met het verzamelen van menselijke feedback aanzienlijk, zoals tijd, arbeid en kosten. Naarmate LLM’s capabeler worden, wordt het steeds waardevoller om AI-systemen andere AI’s te laten superviseren, vooral wanneer menselijke supervisie mogelijk tekortschiet bij zeer geavanceerde modellen.
RLAIF is zeer flexibel en aanpasbaar aan verschillende taken en domeinen. Doordat we niet afhankelijk zijn van vaste datasets met menselijke feedback, kunnen we de constitutie of trainingsdata die gebruikt worden om het feedbackmodel te fine-tunen eenvoudig aanpassen. Zo kunnen we het gedrag van het LLM afstemmen op uiteenlopende taken en domeinen voor een meer op maat gemaakte en effectieve oplossing.
Bovendien worden de principes die het gewenste feedbackmodel sturen expliciet vastgelegd in instructies in natuurlijke taal, een “constitutie”. Dit bevordert de transparantie, omdat de evaluatiecriteria duidelijk zijn verwoord, in tegenstelling tot traditionele methoden waarbij feedbackprincipes verspreid zijn over duizenden individuele menselijke labels.
De experimentele resultaten uit de oorspronkelijke RLAIF-paper laten zien dat RLAIF de prestaties van RLHF evenaart en in sommige gevallen zelfs overtreft. Dit toont het potentieel van RLAIF om niet alleen het feedbackproces te stroomlijnen, maar ook de algehele prestaties van de getrainde modellen te verbeteren.
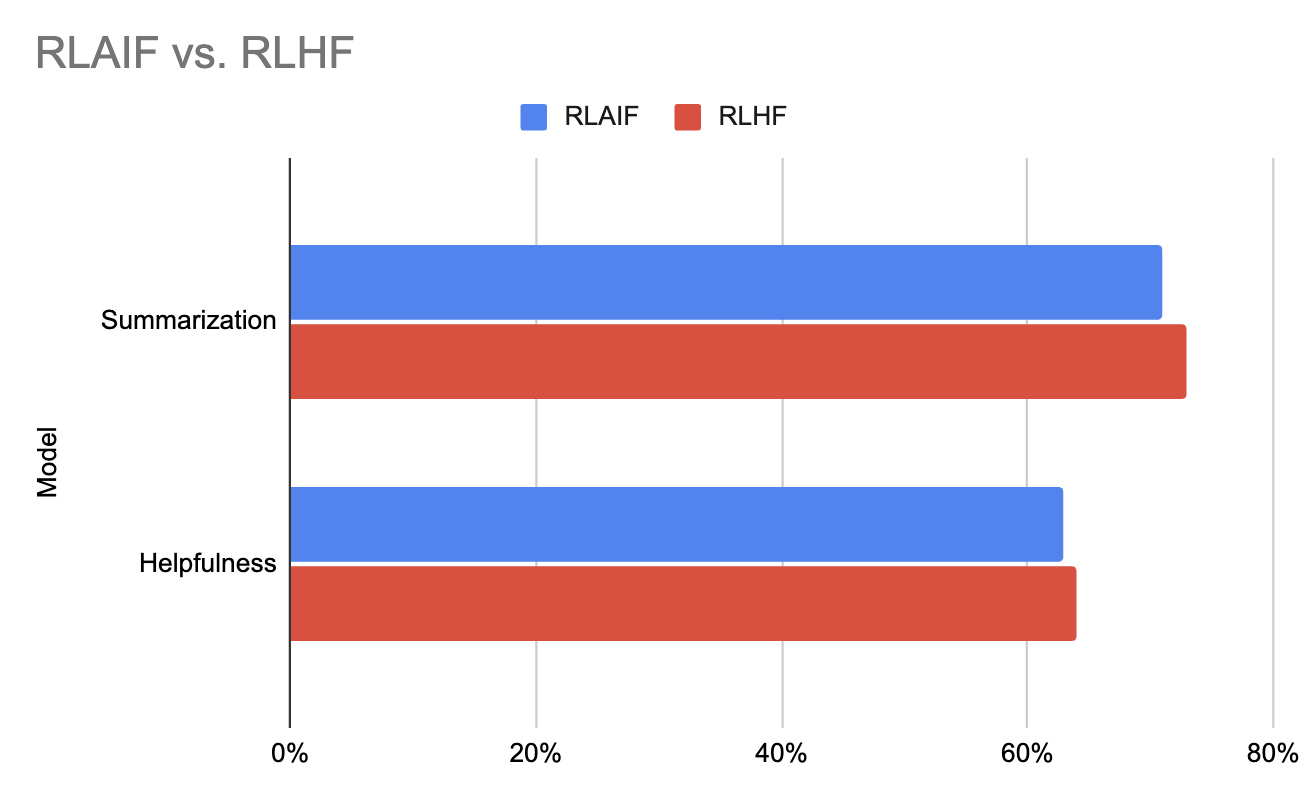
Grafiek opgesteld met de data in deze paper (Lee et al., 2023)
Bekijk ook deze grafiek, die laat zien dat RLAIF het hoogste percentage onschadelijke dialogen produceert vergeleken met RLHF en SFT.
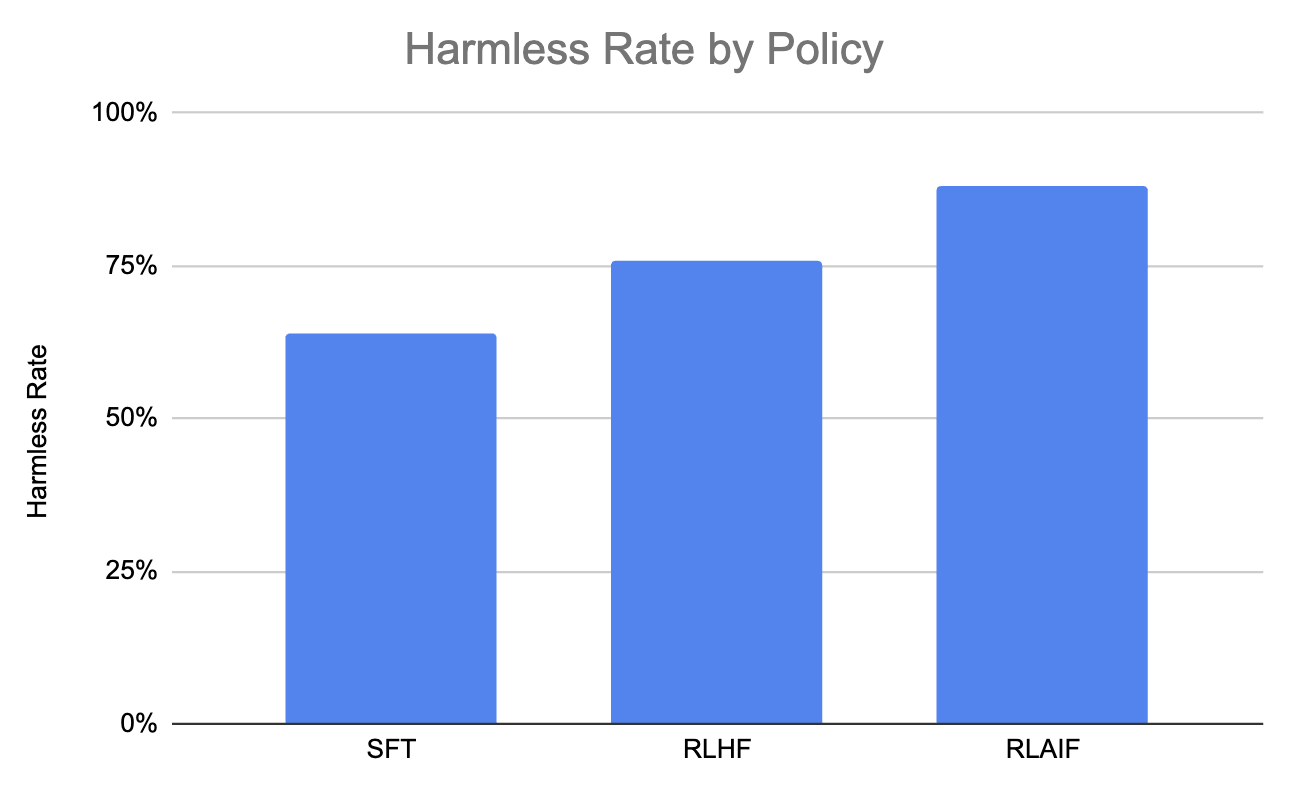
Grafiek opgesteld met de data in deze paper (Lee et al., 2023)
Hoewel RLAIF indrukwekkende resultaten liet zien, brengt het ook nieuwe uitdagingen met zich mee die moeten worden aangepakt:
Hoewel de “constitutie” in natuurlijke taal meer transparantie biedt dan individuele menselijke labels, blijft de pretraining van LLM’s een “black box”. Het waarborgen dat het feedbackmodel is afgestemd op menselijke waarden en voorkeuren is daarom een cruciale uitdaging, aangezien misalignments of biases in het feedbackmodel kunnen leiden tot onbedoelde gevolgen of suboptimaal gedrag van de agent.
Om dit risico te beperken, kan AI-feedback daarom beter dienen als aanvulling op menselijke supervisie dan als volledige vervanging. Deze dubbele aanpak kan helpen voorkomen dat modellen na verloop van tijd afdrijven van menselijk geprefereerd gedrag, en de afstemming met menselijke waarden behouden.
Hoewel het opschalen van menselijke supervisie voor zeer grote modellen lastig is, is het nog de vraag in hoeverre huidige AI-systemen betrouwbaar toezicht kunnen houden op en robuust gedrag kunnen waarborgen bij capabelere AI-assistenten. Daarom zijn strikte evaluatiemaatstaven essentieel om de kwaliteit en afstemming van AI-feedback van het feedbackmodel te beoordelen en de betrouwbaarheid en effectiviteit ervan te waarborgen.
Zoals bij elk machinelearningmodel kunnen feedbackmodellen vooroordelen vertonen die voortkomen uit de trainingsdata of het leerproces zelf. Strategieën om biases in AI-feedback te beperken—zoals het gebruik van diverse en representatieve trainingsdata, robuuste evaluatiemethoden en technieken zoals chain-of-thought-redeneren—zijn cruciaal.
Door deze uitdagingen aan te pakken kan RLAIF uitgroeien tot een robuust en betrouwbaar hulpmiddel voor het trainen van geavanceerde AI-systemen, zodat ze aansluiten bij menselijke waarden en hoge prestaties behouden over uiteenlopende taken en domeinen.
We kunnen RLAIF toepassen op veel taken in natuurlijke taalverwerking, waaronder:
Al met al introduceert de RLAIF-paper (Lee et al., 2023) een schaalbare aanpak om LLM’s te trainen zonder afhankelijk te zijn van menselijke feedbacklabels. Door een “constitutie” van principes in natuurlijke taal en het zelfkritische vermogen van een aanvankelijk behulpzaam model te benutten, laten de auteurs veelbelovende resultaten zien in het sturen van het gedrag van taalmodellen, met meer transparantie en flexibiliteit.
Een belangrijke les is dat RLAIF potentie toont om supervisie op te schalen naarmate modellen capabeler worden, als aanvulling op en gedeeltelijke automatisering van menselijke supervisie. Het beperkt ook problemen zoals verkeerd gespecificeerde beloningen en ontwijkend gedrag die in eerdere benaderingen met menselijke feedback zijn gezien. Tegelijk blijven robuuste menselijke afstemming, het omgaan met distribution shift en betrouwbare supervisie voor geavanceerde AI-systemen open uitdagingen.
Vooruitkijkend zou toekomstig werk het integreren van hoogwaardige voorbeelden van menselijke redenering kunnen verkennen om RLAIF-modellen verder te focussen en te verbeteren. Het uitbreiden van de aanpak om LLM-gedrag te sturen langs andere assen, zoals persoonlijkheid en schrijfstijl, is ook een interessante richting.
Wil je meer leren over reinforcement learning? Bekijk dan deze introductietutorial: Reinforcement Learning: An Introduction With Python Examples.
Leer meer over reinforcement learning en AI!
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

