रिइनफोर्समेंट लर्निंग एक व्यापक रूप से उपयोग की जाने वाली तकनीक है जिसके द्वारा बुद्धिमान एजेंटों को अपने परिवेश में प्रभावी निर्णय लेने के लिए प्रशिक्षित किया जाता है। बड़े भाषा मॉडल (LLMs) के संदर्भ में, यह अक्सर मानव फीडबैक के माध्यम से सीखने की प्रक्रिया का मार्गदर्शन करने से जुड़ा होता है।
हालांकि, फीडबैक के लिए केवल मनुष्यों पर निर्भर रहना महंगा, समय-साध्य और कभी-कभी असंगत हो सकता है। एआई फीडबैक से रिइनफोर्समेंट लर्निंग (RLAIF) मौजूदा एआई मॉडलों की शक्ति का लाभ उठाते हुए एक वैकल्पिक समाधान प्रस्तुत करता है।
इस लेख में, हम RLAIF की मुख्य अवधारणाओं को सरल करेंगे, यह व्यावहारिक रूप से कैसे काम करता है, इसे समझेंगे और एआई विकास के भविष्य पर इसके प्रभावों पर चर्चा करेंगे।
यदि आप मानव फीडबैक से रिइनफोर्समेंट लर्निंग (RLHF) के बारे में और जानना चाहते हैं, तो What is Reinforcement Learning from Human Feedback पर यह लेख देखें।
संक्षिप्त उत्तर: एआई फीडबैक से रिइनफोर्समेंट लर्निंग क्या है?
एआई फीडबैक से रिइनफोर्समेंट लर्निंग (RLAIF) एक मशीन लर्निंग तकनीक है जिसमें रिइनफोर्समेंट लर्निंग प्रक्रिया के दौरान एक एआई मॉडल दूसरे एआई मॉडलों को फीडबैक देता है।
मानव इनपुट पर पूरी तरह निर्भर रहने के बजाय, RLAIF मौजूदा एआई सिस्टमों, जैसे कि बड़े भाषा मॉडलों, की क्षमताओं का उपयोग करके कार्यों का मूल्यांकन करता है और अन्य एजेंटों के सीखने का मार्गदर्शन करता है।
यह एआई फीडबैक कई रूप ले सकता है, जैसे रिवॉर्ड उत्पन्न करना, प्रत्युत्तरों की रैंकिंग करना, या सीधे सुधार सुझाना। फीडबैक लूप को स्वचालित कर, RLAIF प्रशिक्षण को सुगम बना सकता है, लागत घटा सकता है, और बड़े भाषा मॉडलों सहित विभिन्न एआई सिस्टमों के प्रदर्शन में सुधार कर सकता है।
RLHF बनाम RLAIF
यह समझने के लिए कि RLAIF, RLHF की तुलना में कैसा है, आइए इस तालिका पर विचार करें:
|
विशेषता
|
RLHF (मानव फीडबैक से रिइनफोर्समेंट लर्निंग)
|
RLAIF (एआई फीडबैक से रिइनफोर्समेंट लर्निंग)
|
|
फीडबैक का स्रोत
|
मानव एनोटेटर
|
मौजूदा एआई मॉडल (जैसे, LLMs)
|
|
स्केलेबिलिटी
|
मानव श्रम की उपलब्धता और लागत से सीमित
|
स्वचालन के कारण अत्यधिक स्केलेबल
|
|
फीडबैक की गुणवत्ता
|
सूक्ष्म मानवीय वरीयताओं को कैप्चर करने की उच्च क्षमता
|
फीडबैक देने वाले एआई मॉडल की क्षमताओं पर निर्भर
|
|
लागत
|
मानव श्रम की आवश्यकता के कारण महंगी हो सकती है
|
स्वचालन के कारण संभावित रूप से अधिक किफायती
|
|
गति
|
मानव एनोटेशन में लगने वाले समय के कारण धीमी
|
स्वचालित फीडबैक जनरेशन के कारण तेज
|
|
पक्षपात
|
मानवीय पक्षपात का शिकार हो सकता है
|
फीडबैक देने वाले एआई मॉडल के पक्षपात को विरासत में ले सकता है
|
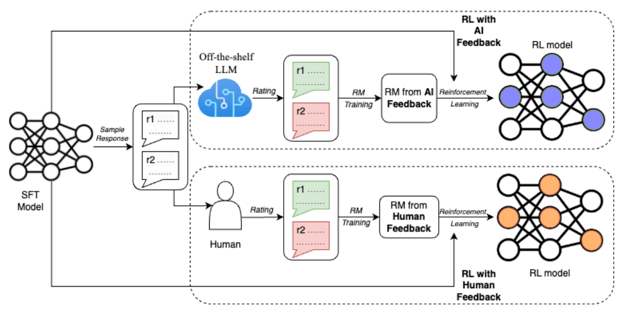
RLHF और RLAIF के अंतर को बेहतर समझने के लिए, इस शोधपत्र RLAIF: Scaling Reinforcement Learning from Human Feedback with AI Feedback (Lee et al., 2023) का यह आरेख भी देखें:
स्रोत: Lee et al., 2023
यह आरेख रिइनफोर्समेंट लर्निंग प्रक्रिया में RLHF और RLAIF के बीच मुख्य अंतर दिखाता है। दोनों दृष्टिकोण एक प्रारंभिक मॉडल (SFT Model) से शुरू होते हैं जो नमूना उत्तर उत्पन्न करता है। हालांकि, RLHF में इन उत्तरों के लिए मानव मूल्यांकनकर्ता रेटिंग देते हैं, जबकि RLAIF में एक तैयार-उपलब्ध LLM न्यायाधीश की भूमिका निभाता है।
इन रेटिंग्स का उपयोग फिर एक रिवॉर्ड मॉडल (RM) को प्रशिक्षित करने के लिए किया जाता है। अंततः, रिइनफोर्समेंट लर्निंग लूप में, RL मॉडल को RM से रिवॉर्ड मिलते हैं, जिसे या तो मानव फीडबैक (RLHF) या एआई फीडबैक (RLAIF) पर प्रशिक्षित किया गया होता है। यह फीडबैक लूप RL मॉडल को प्राप्त फीडबैक के प्रकार के आधार पर लगातार सीखने और अपने प्रदर्शन में सुधार करने में सक्षम बनाता है।
RLAIF कैसे काम करता है
अब जबकि हमने RLAIF की मुख्य अवधारणाएँ और RLHF से उसका भेद समझ लिया है, आइए इस दृष्टिकोण के कार्यान्वयन में शामिल व्यावहारिक चरणों पर गहराई से नज़र डालें। RLAIF प्रक्रिया आम तौर पर चार प्रमुख चरणों से बनी होती है, जिनमें से प्रत्येक एआई-जनित फीडबैक से एआई मॉडलों को सीखने में अहम भूमिका निभाता है।
चरण 1: फीडबैक मॉडल का प्रशिक्षण (वैकल्पिक)
मूल RLAIF शोधपत्र (Lee इत्यादि, 2023) में प्राथमिकता-लेबलिंग के लिए एक "तैयार-उपलब्ध" LLM को फीडबैक मॉडल के रूप में उपयोग किया गया था। यह एक अच्छा प्रारंभिक बिंदु है, लेकिन कुछ परिस्थितियों में, खासकर जहाँ डोमेन-विशिष्ट ज्ञान या शब्दावली शामिल हो, प्रासंगिक डेटा पर LLM को और फाइन-ट्यून करना लाभकारी हो सकता है।
उदाहरण के लिए, यदि लक्ष्य वित्त या चिकित्सा क्षेत्रों के लिए अनुकूलित एआई सहायक विकसित करना है, तो वित्त या चिकित्सा पाठों के संकलन पर LLM को फाइन-ट्यून करने से डोमेन-विशिष्ट अवधारणाओं और पारिभाषिक शब्दों की समझ में उल्लेखनीय सुधार हो सकता है।
यह अतिरिक्त चरण सुनिश्चित करता है कि मॉडल अधिक सटीक और प्रासंगिक प्राथमिकता-निर्णय दे सके, जिससे विशेष अनुप्रयोगों में एआई प्रणाली की समग्र गुणवत्ता और विश्वसनीयता बेहतर होती है।
चरण 2: एआई फीडबैक उत्पन्न करना
जब हमारे पास LLM फीडबैक मॉडल होता है—चाहे तैयार-उपलब्ध संस्करण हो या फाइन-ट्यून किया गया—तो हम इसका उपयोग प्राथमिकता लेबल उत्पन्न करने के लिए कर सकते हैं।
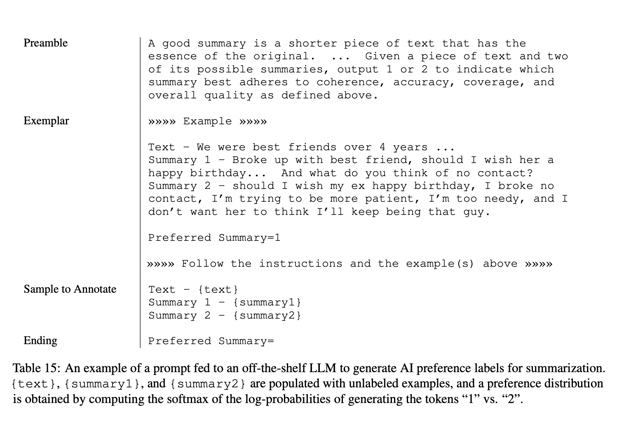
एआई फीडबैक उत्पन्न करने के लिए, फीडबैक मॉडल को संदर्भ और दो प्रत्याशी उत्तर दिए जाते हैं। फिर मॉडल से पूछा जाता है कि कौन-सा उत्तर वांछनीय है। RLAIF शोधपत्र में, फीडबैक मॉडल के लिए इनपुट प्रॉम्प्ट एक संरचित प्रारूप का पालन करता है:
- प्रस्तावना: कार्य का वर्णन करने वाला आरंभिक निर्देश।
- फ्यू-शॉट उदाहरण (वैकल्पिक): उदाहरण इनपुट संदर्भ, उत्तरों के जोड़े, वैकल्पिक चेन-ऑफ-थॉट तर्क, और संबंधित प्राथमिकता लेबल।
- एनोटेट करने हेतु सैंपल: वह इनपुट संदर्भ और उत्तरों की जोड़ी जिन्हें लेबल करना है।
- समापन: LLM से प्राथमिकता लेबल माँगने वाला समापन पाठ (उदा., "Preferred Summary=").
इस संरचना को बेहतर समझने के लिए नीचे दी गई छवि देखें:
स्रोत: Lee et al., 2023
यह संरचित तरीका सुनिश्चित करता है कि फीडबैक मॉडल उत्तरों की गुणवत्ता का प्रभावी आकलन कर सके और सटीक प्राथमिकता लेबल दे सके। फ्यू-शॉट उदाहरण शामिल करके, हम मॉडल के प्रदर्शन को और बढ़ा सकते हैं—उसे ठोस उदाहरण दिखाकर कि उत्तरों का मूल्यांकन कैसे करना है—जिससे फीडबैक अधिक सुसंगत और विश्वसनीय बनता है।
इनपुट प्रॉम्प्ट मिलने पर, LLM फीडबैक मॉडल "1" और "2" टोकनों के लिए लॉग-प्रायिकताएँ उत्पन्न करता है—जो क्रमशः पहले या दूसरे उत्तर की प्राथमिकता दर्शाती हैं। इन लॉग-प्रायिकताओं को सॉफ्टमैक्स फ़ंक्शन से गुजारा जाता है ताकि प्राथमिकता वितरण प्राप्त हो सके।
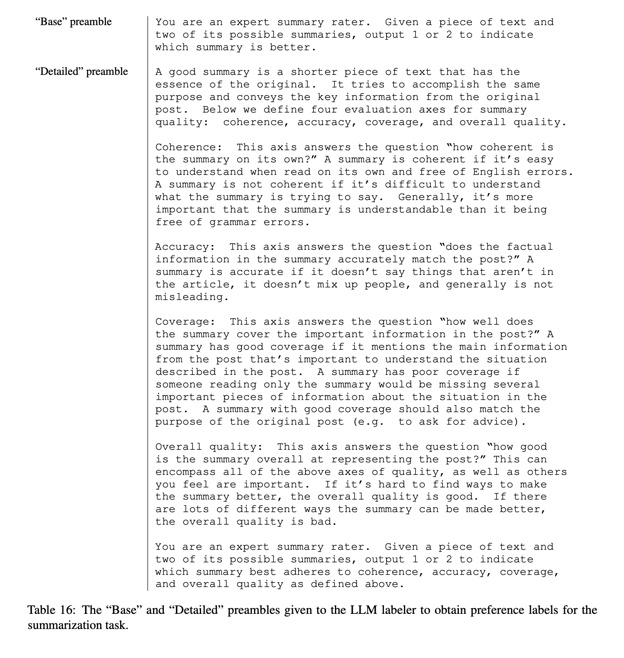
RLAIF शोधपत्र में प्रस्तावनाओं की दो शैलियों—“Base” और “Detailed”—पर प्रयोग किया गया। Base प्रस्तावना फीडबैक मॉडल से पूछती है कि कौन-सा उत्तर बेहतर है, जबकि Detailed प्रस्तावना मानव एनोटेटर को दी जाने वाली विस्तृत निर्देशिका प्रदान करती है। इसे बेहतर समझने के लिए यह उदाहरण देखें:
स्रोत: Lee et al., 2023
अंत में, RLAIF पद्धति की प्रभावशीलता बढ़ाने के लिए दो महत्वपूर्ण बातों पर विचार किया गया:
- स्थिति-पक्षपात का समाधान: शोध से पता चला है कि LLM को प्रत्याशियों की जो क्रम में प्रस्तुति दी जाती है, वह उसकी प्राथमिकता को प्रभावित कर सकती है। इस पक्षपात को कम करने के लिए, RLAIF प्रत्येक जोड़ी के लिए उनकी स्थिति बदलकर दो इनफ़ेरेंस चलाता है। अंतिम प्राथमिकता वितरण दोनों इनफ़ेरेंस के औसत से बनता है, जिससे मूल्यांकन अधिक संतुलित और निष्पक्ष होता है।
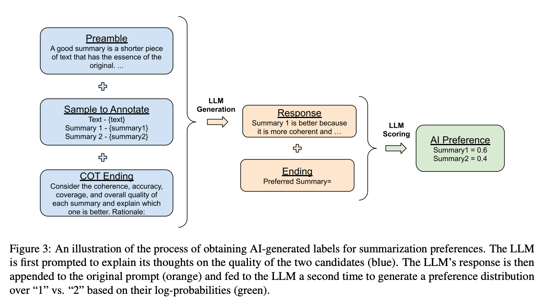
- चेन-ऑफ-थॉट तर्क: RLAIF इनफ़ेरेंस प्रक्रिया को दो चरणों में बांटकर चेन-ऑफ-थॉट (CoT) तर्क का लाभ उठाता है:
- प्रॉम्प्ट के समापन भाग को इस अनुरोध से बदल दिया जाता है कि LLM बेहतर उत्तर चुनने के पीछे अपना तर्क समझाए।
- उत्पन्न तर्क को मूल प्रॉम्प्ट के साथ जोड़ा जाता है, और उसके बाद मानक समापन स्ट्रिंग जोड़कर LLM को "1" या "2" का प्राथमिकता टोकन आउटपुट करने के लिए प्रेरित किया जाता है। ये टोकन आगे चलकर प्रेफरेंस मॉडल को प्रशिक्षित करने में उपयोग होते हैं।
इस CoT तकनीक को बेहतर समझने के लिए, शोधपत्र का यह आरेख देखें:
स्रोत: Lee et al., 2023
चरण 3: प्रेफरेंस मॉडल का प्रशिक्षण
जब हमें LLM फीडबैक मॉडल से प्राथमिकता लेबल मिल जाते हैं, तब अगला कदम इन लेबलों का उपयोग करके एक प्रेफरेंस मॉडल को प्रशिक्षित करना होता है।
प्रेफरेंस मॉडल संदर्भ और प्रत्याशी उत्तरों को एक स्केलर रिवॉर्ड सिग्नल से मैप करना सीखता है, जो मानवीय वरीयताओं का प्रॉक्सी होता है। यह प्रशिक्षित प्रेफरेंस मॉडल फिर रिइनफोर्समेंट लर्निंग चक्र में समाहित किया जाता है।
RLAIF शोधपत्र एक वैकल्पिक दृष्टिकोण भी परीक्षण करता है, जिसमें LLM फीडबैक को सीधे रिवॉर्ड सिग्नल के रूप में उपयोग किया जाता है, और अलग प्रेफरेंस मॉडल की आवश्यकता नहीं रहती। हालांकि, यह "डायरेक्ट" RLAIF तरीका संगणनात्मक रूप से महंगा है, विशेषकर जब LLM लेबलर का आकार बढ़ता है।
चरण 4: एआई फीडबैक के साथ रिइनफोर्समेंट लर्निंग
प्रेफरेंस मॉडल स्थापित होने पर, एआई फीडबैक को रिवॉर्ड सिग्नल के रूप में उपयोग करके रिइनफोर्समेंट लर्निंग की जा सकती है। एजेंट (आधार LLM) पर्यावरण के साथ अंतःक्रिया करता है, और उसके आउटपुट का प्रेफरेंस मॉडल द्वारा मूल्यांकन किया जाता है, जो इस आधार पर रिवॉर्ड देता है कि क्रिया फीडबैक मॉडल में कूटबद्ध वांछित वरीयताओं के साथ कितनी अच्छी तरह मेल खाती है।
RLAIF के लाभ
RLAIF पारंपरिक RLHF की तुलना में कई महत्वपूर्ण लाभ प्रदान करता है, जिससे यह बड़े भाषा मॉडलों के प्रशिक्षण और परिष्करण के लिए एक आकर्षक विकल्प बनता है। आइए RLAIF के कुछ प्रमुख फायदों पर नज़र डालें।
स्केलेबिलिटी
फीडबैक जनरेशन प्रक्रिया को स्वचालित करके, RLAIF मानव एनोटेटरों की आवश्यकता को समाप्त कर देता है, जिससे बड़े पैमाने पर फीडबैक एकत्र करना अधिक कुशल और किफायती हो जाता है।
यह तरीका मानव फीडबैक संग्रह से जुड़ी रुकावटों—जैसे समय, श्रम और खर्च—को काफी कम कर देता है। जैसे-जैसे LLM अधिक सक्षम होते जाते हैं, अन्य एआई की निगरानी के लिए एआई सिस्टमों का लाभ उठाना और भी फायदेमंद होता है, खासकर तब जब अत्यधिक उन्नत मॉडलों के लिए मानवीय निगरानी अपर्याप्त पड़ सकती है।
लचीलापन, अनुकूलनशीलता और पारदर्शिता
RLAIF विभिन्न कार्यों और डोमेनों के लिए अत्यधिक लचीला और अनुकूलनीय है। स्थिर मानव फीडबैक डेटासेट पर निर्भर न होकर, हम आसानी से उस संविधान या प्रशिक्षण डेटा को समायोजित कर सकते हैं जिसका उपयोग फीडबैक मॉडल को फाइन-ट्यून करने में होता है। इससे हम LLM के व्यवहार को अलग-अलग कार्यों और डोमेनों के अनुरूप बेहतर ढंग से ढाल सकते हैं और अधिक कस्टमाइज़्ड व प्रभावी समाधान दे सकते हैं।
इसके अलावा, वांछित फीडबैक मॉडल को निर्देशित करने वाले सिद्धांत प्राकृतिक भाषा में स्पष्ट रूप से कूटबद्ध होते हैं, जो एक "संविधान" बनाते हैं। यह तरीका पारदर्शिता बढ़ाता है, क्योंकि मूल्यांकन मानदंड स्पष्ट रूप से व्यक्त होते हैं—उन पारंपरिक तरीकों के विपरीत, जहाँ फीडबैक सिद्धांत हजारों व्यक्तिगत मानवीय लेबलों में बिखरे हो सकते हैं।
बेहतर प्रदर्शन की संभावनाएँ
मूल RLAIF शोधपत्र के प्रायोगिक परिणाम दर्शाते हैं कि RLAIF का प्रदर्शन RLHF के बराबर है और कुछ मामलों में उससे आगे निकल जाता है। यह दर्शाता है कि RLAIF न केवल फीडबैक प्रक्रिया को सुव्यवस्थित कर सकता है, बल्कि जिन मॉडलों को यह प्रशिक्षित करता है, उनके समग्र प्रदर्शन में भी सुधार ला सकता है।
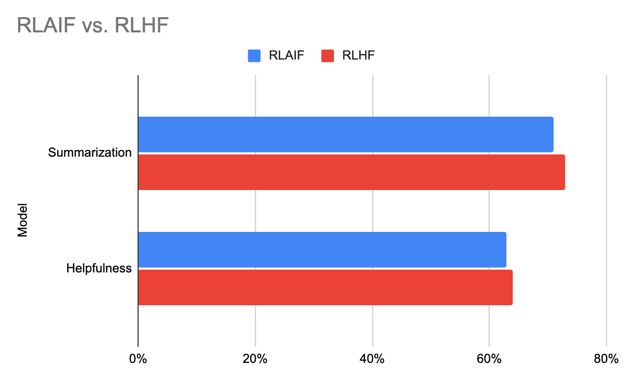
यह ग्राफ इस शोधपत्र (Lee et al., 2023) के डेटा का उपयोग करके बनाया गया है
आइए इस ग्राफ पर भी नज़र डालें, जो दिखाता है कि RLHF और SFT की तुलना में RLAIF सबसे अधिक प्रतिशत में हानिरहित संवाद उत्पन्न करता है।
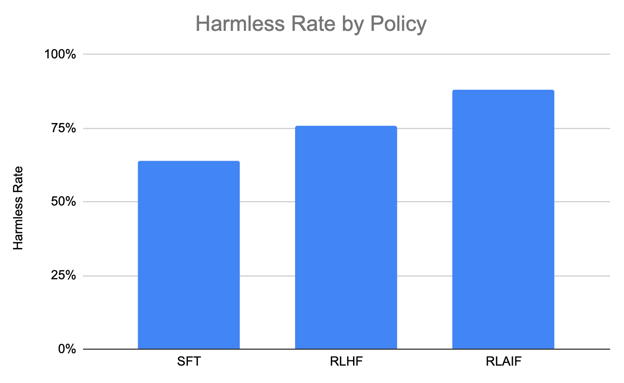
यह ग्राफ इस शोधपत्र (Lee et al., 2023) के डेटा का उपयोग करके बनाया गया है
RLAIF की चुनौतियाँ
जहाँ RLAIF ने प्रभावशाली परिणाम दिखाए हैं, वहीं यह कुछ नई चुनौतियाँ भी प्रस्तुत करता है जिनका समाधान आवश्यक है:
मानवीय मूल्यों के साथ संरेखण
हालाँकि प्राकृतिक भाषा का "संविधान" व्यक्तिगत मानवीय लेबलों की तुलना में अधिक पारदर्शिता देता है, LLM का प्री-ट्रेनिंग अब भी एक “ब्लैक बॉक्स” बना रहता है। इस प्रकार, यह सुनिश्चित करना कि फीडबैक मॉडल मानव मूल्यों और वरीयताओं के अनुरूप हो, एक महत्वपूर्ण चुनौती है—क्योंकि फीडबैक मॉडल में असंगति या पक्षपात एजेंट के अनपेक्षित या उप-इष्टतम व्यवहार का कारण बन सकता है।
अतः इस जोखिम को कम करने के लिए, एआई फीडबैक को मानव पर्यवेक्षण का पूरक बनना चाहिए, न कि उसका पूर्ण प्रतिस्थापन। यह द्विआयामी दृष्टिकोण सुनिश्चित करने में मदद कर सकता है कि समय के साथ मॉडल मानव-प्राथमिक व्यवहार से दूर न भटके और मानवीय मूल्यों के साथ संरेखित बना रहे।
एआई फीडबैक की गुणवत्ता का मूल्यांकन
हालाँकि बहुत बड़े मॉडलों के लिए मानव पर्यवेक्षण का स्केलिंग चुनौतीपूर्ण है, फिर भी मौजूदा एआई सिस्टमों की यह क्षमता कि वे अधिक सक्षम एआई सहायकों की विश्वसनीय निगरानी कर सकें और उनका सुदृढ़ व्यवहार बनाए रख सकें—एक खुला प्रश्न है। अतः, फीडबैक मॉडल द्वारा उत्पन्न एआई फीडबैक की गुणवत्ता और संरेखण का आकलन करने हेतु कठोर मूल्यांकन मेट्रिक्स आवश्यक हैं, ताकि उसकी विश्वसनीयता और प्रभावशीलता सुनिश्चित हो सके।
एआई फीडबैक में पक्षपात का समाधान
किसी भी मशीन लर्निंग मॉडल की तरह, फीडबैक मॉडल में भी प्रशिक्षण डेटा या स्वयं सीखने की प्रक्रिया से उपजे हुए पक्षपात दिखाई दे सकते हैं। एआई फीडबैक में पक्षपात कम करने की रणनीतियाँ—जैसे विविध और प्रतिनिधिक प्रशिक्षण डेटा का उपयोग, सुदृढ़ मूल्यांकन विधियाँ अपनाना, और चेन-ऑफ-थॉट जैसी तकनीकों को शामिल करना—अत्यंत महत्वपूर्ण हैं।
इन चुनौतियों का समाधान करके, RLAIF को उन्नत एआई सिस्टमों के प्रशिक्षण के लिए एक सुदृढ़ और विश्वसनीय उपकरण के रूप में विकसित किया जा सकता है, जो मानवीय मूल्यों के अनुरूप हों और विभिन्न कार्यों व डोमेनों में उच्च प्रदर्शन बनाए रखने में सक्षम हों।
RLAIF के अनुप्रयोग
हम RLAIF को अनेक प्राकृतिक भाषा प्रसंस्करण कार्यों पर लागू कर सकते हैं, जिनमें शामिल हैं:
- टेक्स्ट संक्षेपण: RLAIF का उपयोग ऐसे मॉडल प्रशिक्षित करने में किया जा सकता है जो संक्षिप्तता, प्रासंगिकता और तथ्यात्मक शुद्धता के प्रति मानवीय वरीयताओं के अनुरूप सार प्रस्तुत करें। एआई फीडबैक मॉडल को सबसे महत्वपूर्ण जानकारी को प्राथमिकता देना और अनावश्यक विवरणों से बचना सिखा सकता है।
- संवाद जनरेशन: RLAIF संवाद एजेंटों को सहायक, हानिरहित और आकर्षक तरीके से प्रत्युत्तर देना सिखाने में मदद कर सकता है। एआई फीडबैक वार्तालाप मानदंडों को सुदृढ़ कर सकता है और हानिकारक या अनुचित सामग्री के सृजन को हतोत्साहित कर सकता है।
- प्रश्नोत्तर: RLAIF का उपयोग प्रश्नोत्तर प्रणालियों को सटीक और संक्षिप्त उत्तर देने के लिए प्रशिक्षित करने में किया जा सकता है, साथ ही भ्रामक या हानिकारक जानकारी उत्पन्न करने के जोखिम को न्यूनतम किया जा सकता है। एआई फीडबैक मॉडल को अपनी प्रतिक्रियाओं में तथ्यात्मक शुद्धता और प्रासंगिकता को प्राथमिकता देना सिखा सकता है।
- सामग्री निर्माण: RLAIF कहानियाँ, लेख या कविताओं जैसी रचनात्मक सामग्री के सृजन का मार्गदर्शन कर सकता है, ताकि वह विशिष्ट शैलीगत वरीयताओं या शैली-परंपराओं के अनुरूप हो। एआई फीडबैक वांछित शैलीगत तत्वों को सुदृढ़ कर सकता है और लक्षित शैली से भटकने वाली सामग्री के सृजन को हतोत्साहित कर सकता है।
निष्कर्ष
समग्र रूप से, RLAIF शोधपत्र (Lee et al., 2023) LLMs को मानव फीडबैक लेबलों पर निर्भर हुए बिना प्रशिक्षित करने के लिए एक स्केलेबल तरीका प्रस्तुत करता है। प्राकृतिक भाषा में कूटबद्ध सिद्धांतों के "संविधान" और एक प्रारंभिक सहायक मॉडल की आत्म-आलोचनात्मक क्षमताओं का लाभ उठाकर, लेखक भाषा मॉडल के व्यवहार को दिशा देने में आशाजनक परिणाम दिखाते हैं, साथ ही पारदर्शिता और लचीलेपन में सुधार करते हैं।
मुख्य निष्कर्ष यह है कि जैसे-जैसे मॉडल अधिक सक्षम होते जाते हैं, RLAIF पर्यवेक्षण को स्केल करने की क्षमता दिखाता है—मानव पर्यवेक्षण का पूरक बनते हुए उसे आंशिक रूप से स्वचालित करता है। यह पूर्व मानव फीडबैक दृष्टिकोणों में दिखी रिवॉर्ड मिसस्पेसिफिकेशन और टालमटोल जैसे मुद्दों को भी कम करता है। हालांकि, मज़बूत मानवीय संरेखण बनाए रखना, वितरणीय बदलाव का प्रबंधन करना, और उन्नत एआई प्रणालियों के लिए विश्वसनीय पर्यवेक्षण सुनिश्चित करना अब भी खुली चुनौतियाँ हैं।
आगे देखते हुए, भविष्य का कार्य उच्च-गुणवत्ता वाली मानवीय तर्क-प्रदर्शनों को एकीकृत करके RLAIF मॉडलों को और केंद्रित व बेहतर बनाने की दिशा में हो सकता है। व्यक्तित्व और लेखन शैली जैसी अन्य धाराओं पर LLM के व्यवहार को निर्देशित करने के लिए इस दृष्टिकोण का विस्तार करना भी एक रोचक दिशा है।
रिइनफोर्समेंट लर्निंग के बारे में अधिक जानने के लिए, यह शुरुआती ट्यूटोरियल देखें: Reinforcement Learning: An Introduction With Python Examples.


रिइनफोर्समेंट लर्निंग एक व्यापक रूप से उपयोग की जाने वाली तकनीक है जिसके द्वारा बुद्धिमान एजेंटों को अपने परिवेश में प्रभावी निर्णय लेने के लिए प्रशिक्षित किया जाता है। बड़े भाषा मॉडल (LLMs) के संदर्भ में, यह अक्सर मानव फीडबैक के माध्यम से सीखने की प्रक्रिया का मार्गदर्शन करने से जुड़ा होता है।
हालांकि, फीडबैक के लिए केवल मनुष्यों पर निर्भर रहना महंगा, समय-साध्य और कभी-कभी असंगत हो सकता है। एआई फीडबैक से रिइनफोर्समेंट लर्निंग (RLAIF) मौजूदा एआई मॉडलों की शक्ति का लाभ उठाते हुए एक वैकल्पिक समाधान प्रस्तुत करता है।
इस लेख में, हम RLAIF की मुख्य अवधारणाओं को सरल करेंगे, यह व्यावहारिक रूप से कैसे काम करता है, इसे समझेंगे और एआई विकास के भविष्य पर इसके प्रभावों पर चर्चा करेंगे।
यदि आप मानव फीडबैक से रिइनफोर्समेंट लर्निंग (RLHF) के बारे में और जानना चाहते हैं, तो What is Reinforcement Learning from Human Feedback पर यह लेख देखें।
संक्षिप्त उत्तर: एआई फीडबैक से रिइनफोर्समेंट लर्निंग क्या है?
एआई फीडबैक से रिइनफोर्समेंट लर्निंग (RLAIF) एक मशीन लर्निंग तकनीक है जिसमें रिइनफोर्समेंट लर्निंग प्रक्रिया के दौरान एक एआई मॉडल दूसरे एआई मॉडलों को फीडबैक देता है।
मानव इनपुट पर पूरी तरह निर्भर रहने के बजाय, RLAIF मौजूदा एआई सिस्टमों, जैसे कि बड़े भाषा मॉडलों, की क्षमताओं का उपयोग करके कार्यों का मूल्यांकन करता है और अन्य एजेंटों के सीखने का मार्गदर्शन करता है।
यह एआई फीडबैक कई रूप ले सकता है, जैसे रिवॉर्ड उत्पन्न करना, प्रत्युत्तरों की रैंकिंग करना, या सीधे सुधार सुझाना। फीडबैक लूप को स्वचालित कर, RLAIF प्रशिक्षण को सुगम बना सकता है, लागत घटा सकता है, और बड़े भाषा मॉडलों सहित विभिन्न एआई सिस्टमों के प्रदर्शन में सुधार कर सकता है।
RLHF बनाम RLAIF
यह समझने के लिए कि RLAIF, RLHF की तुलना में कैसा है, आइए इस तालिका पर विचार करें:
विशेषता
RLHF (मानव फीडबैक से रिइनफोर्समेंट लर्निंग)
RLAIF (एआई फीडबैक से रिइनफोर्समेंट लर्निंग)
फीडबैक का स्रोत
मानव एनोटेटर
मौजूदा एआई मॉडल (जैसे, LLMs)
स्केलेबिलिटी
मानव श्रम की उपलब्धता और लागत से सीमित
स्वचालन के कारण अत्यधिक स्केलेबल
फीडबैक की गुणवत्ता
सूक्ष्म मानवीय वरीयताओं को कैप्चर करने की उच्च क्षमता
फीडबैक देने वाले एआई मॉडल की क्षमताओं पर निर्भर
लागत
मानव श्रम की आवश्यकता के कारण महंगी हो सकती है
स्वचालन के कारण संभावित रूप से अधिक किफायती
गति
मानव एनोटेशन में लगने वाले समय के कारण धीमी
स्वचालित फीडबैक जनरेशन के कारण तेज
पक्षपात
मानवीय पक्षपात का शिकार हो सकता है
फीडबैक देने वाले एआई मॉडल के पक्षपात को विरासत में ले सकता है
RLHF और RLAIF के अंतर को बेहतर समझने के लिए, इस शोधपत्र RLAIF: Scaling Reinforcement Learning from Human Feedback with AI Feedback (Lee et al., 2023) का यह आरेख भी देखें:
स्रोत: Lee et al., 2023
यह आरेख रिइनफोर्समेंट लर्निंग प्रक्रिया में RLHF और RLAIF के बीच मुख्य अंतर दिखाता है। दोनों दृष्टिकोण एक प्रारंभिक मॉडल (SFT Model) से शुरू होते हैं जो नमूना उत्तर उत्पन्न करता है। हालांकि, RLHF में इन उत्तरों के लिए मानव मूल्यांकनकर्ता रेटिंग देते हैं, जबकि RLAIF में एक तैयार-उपलब्ध LLM न्यायाधीश की भूमिका निभाता है।
इन रेटिंग्स का उपयोग फिर एक रिवॉर्ड मॉडल (RM) को प्रशिक्षित करने के लिए किया जाता है। अंततः, रिइनफोर्समेंट लर्निंग लूप में, RL मॉडल को RM से रिवॉर्ड मिलते हैं, जिसे या तो मानव फीडबैक (RLHF) या एआई फीडबैक (RLAIF) पर प्रशिक्षित किया गया होता है। यह फीडबैक लूप RL मॉडल को प्राप्त फीडबैक के प्रकार के आधार पर लगातार सीखने और अपने प्रदर्शन में सुधार करने में सक्षम बनाता है।
RLAIF कैसे काम करता है
अब जबकि हमने RLAIF की मुख्य अवधारणाएँ और RLHF से उसका भेद समझ लिया है, आइए इस दृष्टिकोण के कार्यान्वयन में शामिल व्यावहारिक चरणों पर गहराई से नज़र डालें। RLAIF प्रक्रिया आम तौर पर चार प्रमुख चरणों से बनी होती है, जिनमें से प्रत्येक एआई-जनित फीडबैक से एआई मॉडलों को सीखने में अहम भूमिका निभाता है।
चरण 1: फीडबैक मॉडल का प्रशिक्षण (वैकल्पिक)
मूल RLAIF शोधपत्र (Lee इत्यादि, 2023) में प्राथमिकता-लेबलिंग के लिए एक "तैयार-उपलब्ध" LLM को फीडबैक मॉडल के रूप में उपयोग किया गया था। यह एक अच्छा प्रारंभिक बिंदु है, लेकिन कुछ परिस्थितियों में, खासकर जहाँ डोमेन-विशिष्ट ज्ञान या शब्दावली शामिल हो, प्रासंगिक डेटा पर LLM को और फाइन-ट्यून करना लाभकारी हो सकता है।
उदाहरण के लिए, यदि लक्ष्य वित्त या चिकित्सा क्षेत्रों के लिए अनुकूलित एआई सहायक विकसित करना है, तो वित्त या चिकित्सा पाठों के संकलन पर LLM को फाइन-ट्यून करने से डोमेन-विशिष्ट अवधारणाओं और पारिभाषिक शब्दों की समझ में उल्लेखनीय सुधार हो सकता है।
यह अतिरिक्त चरण सुनिश्चित करता है कि मॉडल अधिक सटीक और प्रासंगिक प्राथमिकता-निर्णय दे सके, जिससे विशेष अनुप्रयोगों में एआई प्रणाली की समग्र गुणवत्ता और विश्वसनीयता बेहतर होती है।
चरण 2: एआई फीडबैक उत्पन्न करना
जब हमारे पास LLM फीडबैक मॉडल होता है—चाहे तैयार-उपलब्ध संस्करण हो या फाइन-ट्यून किया गया—तो हम इसका उपयोग प्राथमिकता लेबल उत्पन्न करने के लिए कर सकते हैं।
एआई फीडबैक उत्पन्न करने के लिए, फीडबैक मॉडल को संदर्भ और दो प्रत्याशी उत्तर दिए जाते हैं। फिर मॉडल से पूछा जाता है कि कौन-सा उत्तर वांछनीय है। RLAIF शोधपत्र में, फीडबैक मॉडल के लिए इनपुट प्रॉम्प्ट एक संरचित प्रारूप का पालन करता है:
इस संरचना को बेहतर समझने के लिए नीचे दी गई छवि देखें:
स्रोत: Lee et al., 2023
यह संरचित तरीका सुनिश्चित करता है कि फीडबैक मॉडल उत्तरों की गुणवत्ता का प्रभावी आकलन कर सके और सटीक प्राथमिकता लेबल दे सके। फ्यू-शॉट उदाहरण शामिल करके, हम मॉडल के प्रदर्शन को और बढ़ा सकते हैं—उसे ठोस उदाहरण दिखाकर कि उत्तरों का मूल्यांकन कैसे करना है—जिससे फीडबैक अधिक सुसंगत और विश्वसनीय बनता है।
इनपुट प्रॉम्प्ट मिलने पर, LLM फीडबैक मॉडल "1" और "2" टोकनों के लिए लॉग-प्रायिकताएँ उत्पन्न करता है—जो क्रमशः पहले या दूसरे उत्तर की प्राथमिकता दर्शाती हैं। इन लॉग-प्रायिकताओं को सॉफ्टमैक्स फ़ंक्शन से गुजारा जाता है ताकि प्राथमिकता वितरण प्राप्त हो सके।
RLAIF शोधपत्र में प्रस्तावनाओं की दो शैलियों—“Base” और “Detailed”—पर प्रयोग किया गया। Base प्रस्तावना फीडबैक मॉडल से पूछती है कि कौन-सा उत्तर बेहतर है, जबकि Detailed प्रस्तावना मानव एनोटेटर को दी जाने वाली विस्तृत निर्देशिका प्रदान करती है। इसे बेहतर समझने के लिए यह उदाहरण देखें:
स्रोत: Lee et al., 2023
अंत में, RLAIF पद्धति की प्रभावशीलता बढ़ाने के लिए दो महत्वपूर्ण बातों पर विचार किया गया:
इस CoT तकनीक को बेहतर समझने के लिए, शोधपत्र का यह आरेख देखें:
स्रोत: Lee et al., 2023
चरण 3: प्रेफरेंस मॉडल का प्रशिक्षण
जब हमें LLM फीडबैक मॉडल से प्राथमिकता लेबल मिल जाते हैं, तब अगला कदम इन लेबलों का उपयोग करके एक प्रेफरेंस मॉडल को प्रशिक्षित करना होता है।
प्रेफरेंस मॉडल संदर्भ और प्रत्याशी उत्तरों को एक स्केलर रिवॉर्ड सिग्नल से मैप करना सीखता है, जो मानवीय वरीयताओं का प्रॉक्सी होता है। यह प्रशिक्षित प्रेफरेंस मॉडल फिर रिइनफोर्समेंट लर्निंग चक्र में समाहित किया जाता है।
RLAIF शोधपत्र एक वैकल्पिक दृष्टिकोण भी परीक्षण करता है, जिसमें LLM फीडबैक को सीधे रिवॉर्ड सिग्नल के रूप में उपयोग किया जाता है, और अलग प्रेफरेंस मॉडल की आवश्यकता नहीं रहती। हालांकि, यह "डायरेक्ट" RLAIF तरीका संगणनात्मक रूप से महंगा है, विशेषकर जब LLM लेबलर का आकार बढ़ता है।
चरण 4: एआई फीडबैक के साथ रिइनफोर्समेंट लर्निंग
प्रेफरेंस मॉडल स्थापित होने पर, एआई फीडबैक को रिवॉर्ड सिग्नल के रूप में उपयोग करके रिइनफोर्समेंट लर्निंग की जा सकती है। एजेंट (आधार LLM) पर्यावरण के साथ अंतःक्रिया करता है, और उसके आउटपुट का प्रेफरेंस मॉडल द्वारा मूल्यांकन किया जाता है, जो इस आधार पर रिवॉर्ड देता है कि क्रिया फीडबैक मॉडल में कूटबद्ध वांछित वरीयताओं के साथ कितनी अच्छी तरह मेल खाती है।
RLAIF के लाभ
RLAIF पारंपरिक RLHF की तुलना में कई महत्वपूर्ण लाभ प्रदान करता है, जिससे यह बड़े भाषा मॉडलों के प्रशिक्षण और परिष्करण के लिए एक आकर्षक विकल्प बनता है। आइए RLAIF के कुछ प्रमुख फायदों पर नज़र डालें।
स्केलेबिलिटी
फीडबैक जनरेशन प्रक्रिया को स्वचालित करके, RLAIF मानव एनोटेटरों की आवश्यकता को समाप्त कर देता है, जिससे बड़े पैमाने पर फीडबैक एकत्र करना अधिक कुशल और किफायती हो जाता है।
यह तरीका मानव फीडबैक संग्रह से जुड़ी रुकावटों—जैसे समय, श्रम और खर्च—को काफी कम कर देता है। जैसे-जैसे LLM अधिक सक्षम होते जाते हैं, अन्य एआई की निगरानी के लिए एआई सिस्टमों का लाभ उठाना और भी फायदेमंद होता है, खासकर तब जब अत्यधिक उन्नत मॉडलों के लिए मानवीय निगरानी अपर्याप्त पड़ सकती है।
लचीलापन, अनुकूलनशीलता और पारदर्शिता
RLAIF विभिन्न कार्यों और डोमेनों के लिए अत्यधिक लचीला और अनुकूलनीय है। स्थिर मानव फीडबैक डेटासेट पर निर्भर न होकर, हम आसानी से उस संविधान या प्रशिक्षण डेटा को समायोजित कर सकते हैं जिसका उपयोग फीडबैक मॉडल को फाइन-ट्यून करने में होता है। इससे हम LLM के व्यवहार को अलग-अलग कार्यों और डोमेनों के अनुरूप बेहतर ढंग से ढाल सकते हैं और अधिक कस्टमाइज़्ड व प्रभावी समाधान दे सकते हैं।
इसके अलावा, वांछित फीडबैक मॉडल को निर्देशित करने वाले सिद्धांत प्राकृतिक भाषा में स्पष्ट रूप से कूटबद्ध होते हैं, जो एक "संविधान" बनाते हैं। यह तरीका पारदर्शिता बढ़ाता है, क्योंकि मूल्यांकन मानदंड स्पष्ट रूप से व्यक्त होते हैं—उन पारंपरिक तरीकों के विपरीत, जहाँ फीडबैक सिद्धांत हजारों व्यक्तिगत मानवीय लेबलों में बिखरे हो सकते हैं।
बेहतर प्रदर्शन की संभावनाएँ
मूल RLAIF शोधपत्र के प्रायोगिक परिणाम दर्शाते हैं कि RLAIF का प्रदर्शन RLHF के बराबर है और कुछ मामलों में उससे आगे निकल जाता है। यह दर्शाता है कि RLAIF न केवल फीडबैक प्रक्रिया को सुव्यवस्थित कर सकता है, बल्कि जिन मॉडलों को यह प्रशिक्षित करता है, उनके समग्र प्रदर्शन में भी सुधार ला सकता है।
यह ग्राफ इस शोधपत्र (Lee et al., 2023) के डेटा का उपयोग करके बनाया गया है
आइए इस ग्राफ पर भी नज़र डालें, जो दिखाता है कि RLHF और SFT की तुलना में RLAIF सबसे अधिक प्रतिशत में हानिरहित संवाद उत्पन्न करता है।
यह ग्राफ इस शोधपत्र (Lee et al., 2023) के डेटा का उपयोग करके बनाया गया है
RLAIF की चुनौतियाँ
जहाँ RLAIF ने प्रभावशाली परिणाम दिखाए हैं, वहीं यह कुछ नई चुनौतियाँ भी प्रस्तुत करता है जिनका समाधान आवश्यक है:
मानवीय मूल्यों के साथ संरेखण
हालाँकि प्राकृतिक भाषा का "संविधान" व्यक्तिगत मानवीय लेबलों की तुलना में अधिक पारदर्शिता देता है, LLM का प्री-ट्रेनिंग अब भी एक “ब्लैक बॉक्स” बना रहता है। इस प्रकार, यह सुनिश्चित करना कि फीडबैक मॉडल मानव मूल्यों और वरीयताओं के अनुरूप हो, एक महत्वपूर्ण चुनौती है—क्योंकि फीडबैक मॉडल में असंगति या पक्षपात एजेंट के अनपेक्षित या उप-इष्टतम व्यवहार का कारण बन सकता है।
अतः इस जोखिम को कम करने के लिए, एआई फीडबैक को मानव पर्यवेक्षण का पूरक बनना चाहिए, न कि उसका पूर्ण प्रतिस्थापन। यह द्विआयामी दृष्टिकोण सुनिश्चित करने में मदद कर सकता है कि समय के साथ मॉडल मानव-प्राथमिक व्यवहार से दूर न भटके और मानवीय मूल्यों के साथ संरेखित बना रहे।
एआई फीडबैक की गुणवत्ता का मूल्यांकन
हालाँकि बहुत बड़े मॉडलों के लिए मानव पर्यवेक्षण का स्केलिंग चुनौतीपूर्ण है, फिर भी मौजूदा एआई सिस्टमों की यह क्षमता कि वे अधिक सक्षम एआई सहायकों की विश्वसनीय निगरानी कर सकें और उनका सुदृढ़ व्यवहार बनाए रख सकें—एक खुला प्रश्न है। अतः, फीडबैक मॉडल द्वारा उत्पन्न एआई फीडबैक की गुणवत्ता और संरेखण का आकलन करने हेतु कठोर मूल्यांकन मेट्रिक्स आवश्यक हैं, ताकि उसकी विश्वसनीयता और प्रभावशीलता सुनिश्चित हो सके।
एआई फीडबैक में पक्षपात का समाधान
किसी भी मशीन लर्निंग मॉडल की तरह, फीडबैक मॉडल में भी प्रशिक्षण डेटा या स्वयं सीखने की प्रक्रिया से उपजे हुए पक्षपात दिखाई दे सकते हैं। एआई फीडबैक में पक्षपात कम करने की रणनीतियाँ—जैसे विविध और प्रतिनिधिक प्रशिक्षण डेटा का उपयोग, सुदृढ़ मूल्यांकन विधियाँ अपनाना, और चेन-ऑफ-थॉट जैसी तकनीकों को शामिल करना—अत्यंत महत्वपूर्ण हैं।
इन चुनौतियों का समाधान करके, RLAIF को उन्नत एआई सिस्टमों के प्रशिक्षण के लिए एक सुदृढ़ और विश्वसनीय उपकरण के रूप में विकसित किया जा सकता है, जो मानवीय मूल्यों के अनुरूप हों और विभिन्न कार्यों व डोमेनों में उच्च प्रदर्शन बनाए रखने में सक्षम हों।
RLAIF के अनुप्रयोग
हम RLAIF को अनेक प्राकृतिक भाषा प्रसंस्करण कार्यों पर लागू कर सकते हैं, जिनमें शामिल हैं:
निष्कर्ष
समग्र रूप से, RLAIF शोधपत्र (Lee et al., 2023) LLMs को मानव फीडबैक लेबलों पर निर्भर हुए बिना प्रशिक्षित करने के लिए एक स्केलेबल तरीका प्रस्तुत करता है। प्राकृतिक भाषा में कूटबद्ध सिद्धांतों के "संविधान" और एक प्रारंभिक सहायक मॉडल की आत्म-आलोचनात्मक क्षमताओं का लाभ उठाकर, लेखक भाषा मॉडल के व्यवहार को दिशा देने में आशाजनक परिणाम दिखाते हैं, साथ ही पारदर्शिता और लचीलेपन में सुधार करते हैं।
मुख्य निष्कर्ष यह है कि जैसे-जैसे मॉडल अधिक सक्षम होते जाते हैं, RLAIF पर्यवेक्षण को स्केल करने की क्षमता दिखाता है—मानव पर्यवेक्षण का पूरक बनते हुए उसे आंशिक रूप से स्वचालित करता है। यह पूर्व मानव फीडबैक दृष्टिकोणों में दिखी रिवॉर्ड मिसस्पेसिफिकेशन और टालमटोल जैसे मुद्दों को भी कम करता है। हालांकि, मज़बूत मानवीय संरेखण बनाए रखना, वितरणीय बदलाव का प्रबंधन करना, और उन्नत एआई प्रणालियों के लिए विश्वसनीय पर्यवेक्षण सुनिश्चित करना अब भी खुली चुनौतियाँ हैं।
आगे देखते हुए, भविष्य का कार्य उच्च-गुणवत्ता वाली मानवीय तर्क-प्रदर्शनों को एकीकृत करके RLAIF मॉडलों को और केंद्रित व बेहतर बनाने की दिशा में हो सकता है। व्यक्तित्व और लेखन शैली जैसी अन्य धाराओं पर LLM के व्यवहार को निर्देशित करने के लिए इस दृष्टिकोण का विस्तार करना भी एक रोचक दिशा है।
रिइनफोर्समेंट लर्निंग के बारे में अधिक जानने के लिए, यह शुरुआती ट्यूटोरियल देखें: Reinforcement Learning: An Introduction With Python Examples.