

Corso
Reinforcement Learning con Gymnasium in Python
4 ore
14K
Pratica and corso your progress.
Continua Con GoogleIl reinforcement learning è una tecnica ampiamente utilizzata per addestrare agenti intelligenti a prendere decisioni efficaci nel proprio ambiente. Nel campo dei large language model (LLM), questo spesso comporta guidare il processo di apprendimento tramite feedback umano.
Tuttavia, affidarsi agli esseri umani per fornire feedback può essere costoso, richiedere molto tempo e risultare talvolta incoerente. Reinforcement learning from AI feedback (RLAIF) offre un'alternativa che sfrutta la potenza dei modelli di IA esistenti.
In questo articolo analizzeremo i concetti chiave di RLAIF, vedremo come funziona nella pratica e discuteremo le sue implicazioni per il futuro dello sviluppo dell'IA.
Se vuoi saperne di più sul reinforcement learning from human feedback (RLHF), dai un'occhiata a questo articolo: What is Reinforcement Learning from Human Feedback.
Il reinforcement learning from AI feedback (RLAIF) è una tecnica di machine learning in cui modelli di IA forniscono feedback ad altri modelli di IA durante il processo di reinforcement learning.
Invece di basarsi esclusivamente sull'input umano, RLAIF sfrutta le capacità di sistemi di IA esistenti, come i large language model, per valutare le azioni e guidare l'apprendimento di altri agenti.
Questo feedback generato dall'IA può assumere varie forme, tra cui la generazione di ricompense, il ranking delle risposte o il suggerimento diretto di miglioramenti. Automatizzando il ciclo di feedback, RLAIF può semplificare l'addestramento, ridurre i costi e migliorare le prestazioni di vari sistemi di IA, inclusi i large language model.
Per capire come RLAIF si confronta con RLHF, partiamo da questa tabella:
|
Caratteristica |
RLHF (Reinforcement Learning from Human Feedback) |
RLAIF (Reinforcement Learning from AI Feedback) |
|
Fonte del feedback |
Annotatori umani |
Modelli di IA esistenti (ad es., LLM) |
|
Scalabilità |
Limitata dalla disponibilità e dal costo del lavoro umano |
Altamente scalabile grazie all'automazione |
|
Qualità del feedback |
Grande potenziale nel catturare preferenze umane sfumate |
Dipende dalle capacità del modello di IA che fornisce il feedback |
|
Costo |
Può essere elevato a causa del lavoro umano necessario |
Potenzialmente più conveniente grazie all'automazione |
|
Velocità |
Più lenta per il tempo richiesto all'annotazione umana |
Più rapida grazie alla generazione automatizzata del feedback |
|
Bias |
Può essere soggetto a bias umani |
Può ereditare i bias del modello di IA che fornisce il feedback |
Per comprendere meglio le differenze tra RLHF e RLAIF, consideriamo anche questo diagramma tratto dal paper RLAIF: Scaling Reinforcement Learning from Human Feedback with AI Feedback (Lee et al., 2023):
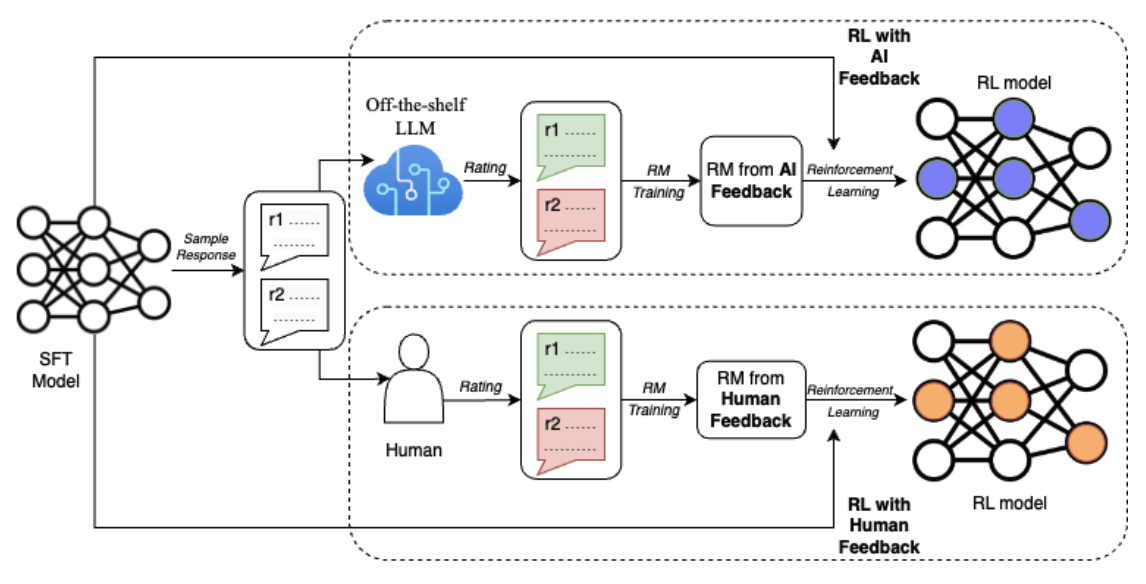
Fonte: Lee et al., 2023
Il diagramma evidenzia la differenza chiave tra RLHF e RLAIF nel processo di reinforcement learning. Entrambi gli approcci partono da un modello iniziale (SFT Model) che genera risposte di esempio. Tuttavia, in RLHF sono i valutatori umani a fornire i punteggi per queste risposte, mentre in RLAIF un LLM disponibile "off-the-shelf" funge da giudice.
Queste valutazioni vengono poi utilizzate per addestrare un reward model (RM). Infine, nel ciclo di reinforcement learning, il modello RL riceve ricompense dall'RM, addestrato su feedback umano (RLHF) oppure su feedback di IA (RLAIF). Questo ciclo di feedback consente al modello RL di apprendere in modo continuo e migliorare le proprie prestazioni in base al tipo specifico di feedback ricevuto.
Ora che abbiamo chiarito i concetti di base di RLAIF e la sua differenziazione rispetto a RLHF, entriamo nei passaggi pratici necessari per implementare questo approccio. Il processo RLAIF in genere comprende quattro fasi chiave, ognuna delle quali svolge un ruolo cruciale nel consentire ai modelli di IA di apprendere da feedback generati dall'IA.
Nel paper RLAIF originale (Lee et al., 2023), è stato utilizzato un LLM "off-the-shelf" come modello di feedback per l'etichettatura delle preferenze. Questo è un buon punto di partenza, ma in alcuni scenari, soprattutto quelli che coinvolgono conoscenze o terminologia di dominio, può essere utile fare un ulteriore fine-tuning dell'LLM su dati pertinenti.
Ad esempio, se l'obiettivo è sviluppare un assistente di IA su misura per la finanza o per il settore medico, il fine-tuning dell'LLM su un corpus di testi finanziari o medici può migliorare in modo significativo la comprensione di concetti e gergo specifici del dominio.
Questo passaggio aggiuntivo garantisce che il modello possa fornire giudizi di preferenza più accurati e pertinenti, migliorando in definitiva la qualità e l'affidabilità complessive del sistema di IA in applicazioni specialistiche.
Una volta che abbiamo il nostro modello di feedback LLM — sia in versione off-the-shelf sia in variante fine-tuned — possiamo usarlo per generare etichette di preferenza.
Per generare feedback di IA, al modello di feedback vengono presentati il contesto e due risposte candidate. Al modello viene quindi chiesto di determinare quale risposta sia preferita. Nel paper RLAIF, il prompt di input al modello di feedback segue un formato strutturato:
Per comprendere meglio questa struttura, guarda l'immagine qui sotto:
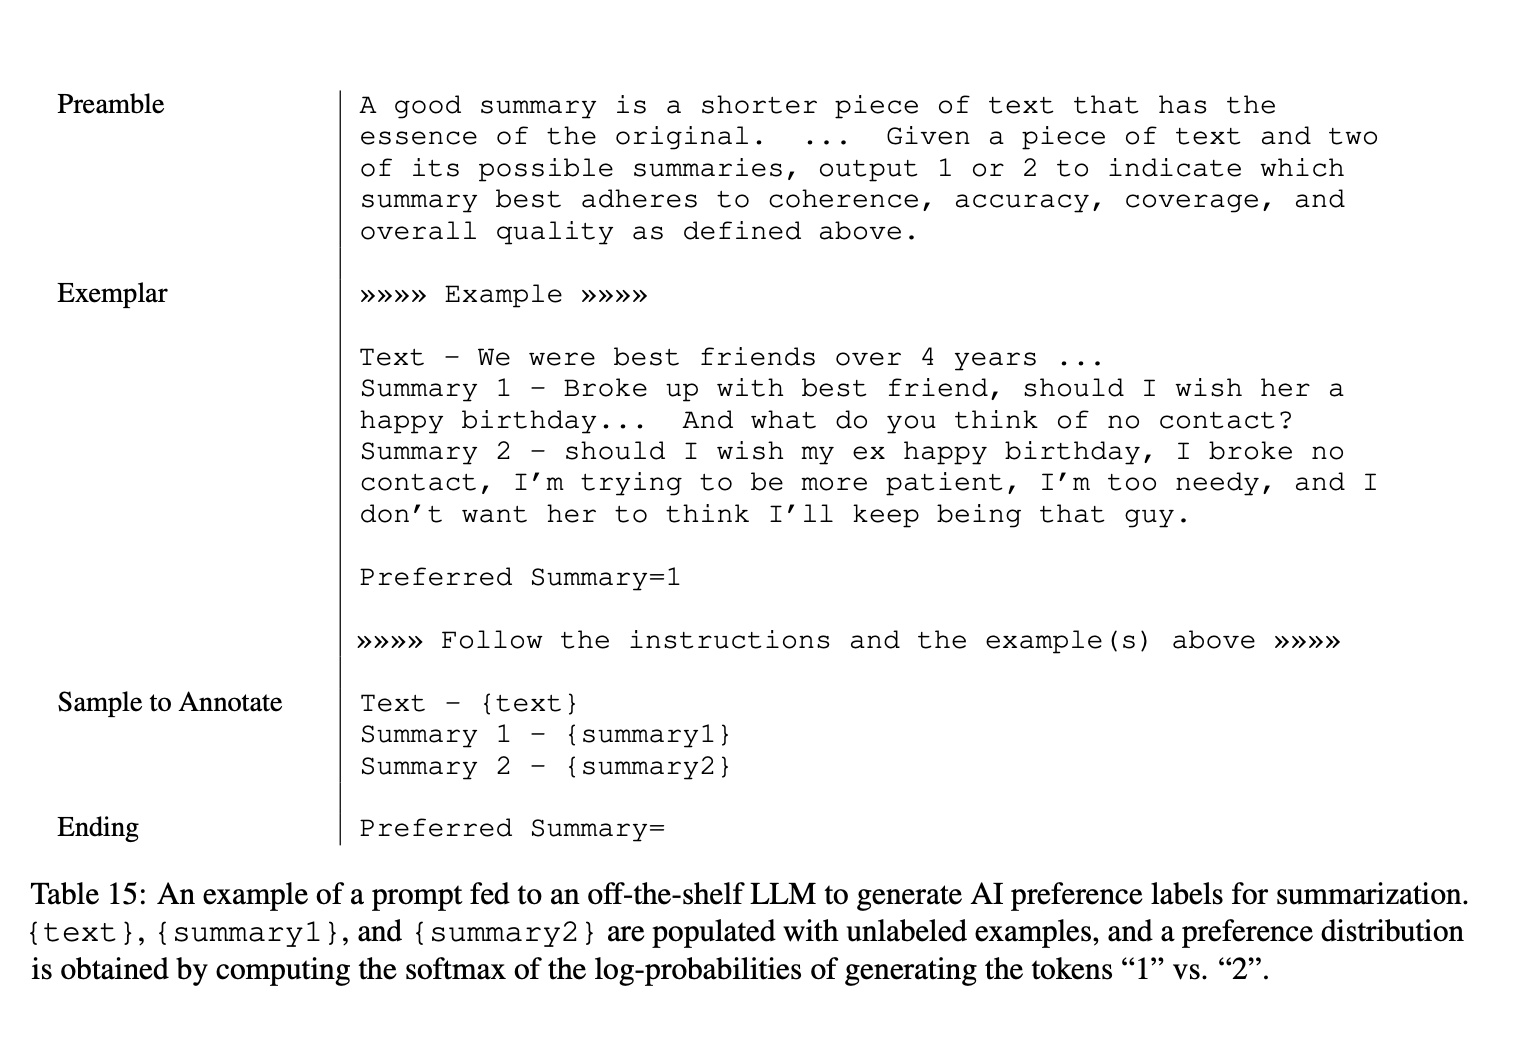
Fonte: Lee et al., 2023
Questo approccio strutturato assicura che il modello di feedback possa valutare efficacemente la qualità delle risposte e fornire etichette di preferenza accurate. Includendo esempi few-shot, è possibile migliorare ulteriormente le prestazioni del modello, mostrando esempi concreti di come valutare le risposte e rendendo il feedback più coerente e affidabile.
Dato il prompt di input, il modello di feedback LLM genera le log-probabilità per i token "1" e "2" — che rappresentano la preferenza del modello per la prima o la seconda risposta. Queste log-probabilità vengono quindi passate attraverso una funzione softmax per ottenere una distribuzione di preferenza.
Nel paper RLAIF sono stati sperimentati due tipi di preamboli: "Base" e "Detailed". Un preambolo Base chiede al modello di feedback di giudicare quale risposta sia migliore, mentre un preambolo Detailed fornisce istruzioni approfondite tipiche per gli annotatori umani. Per capirlo meglio, consideriamo questo esempio:
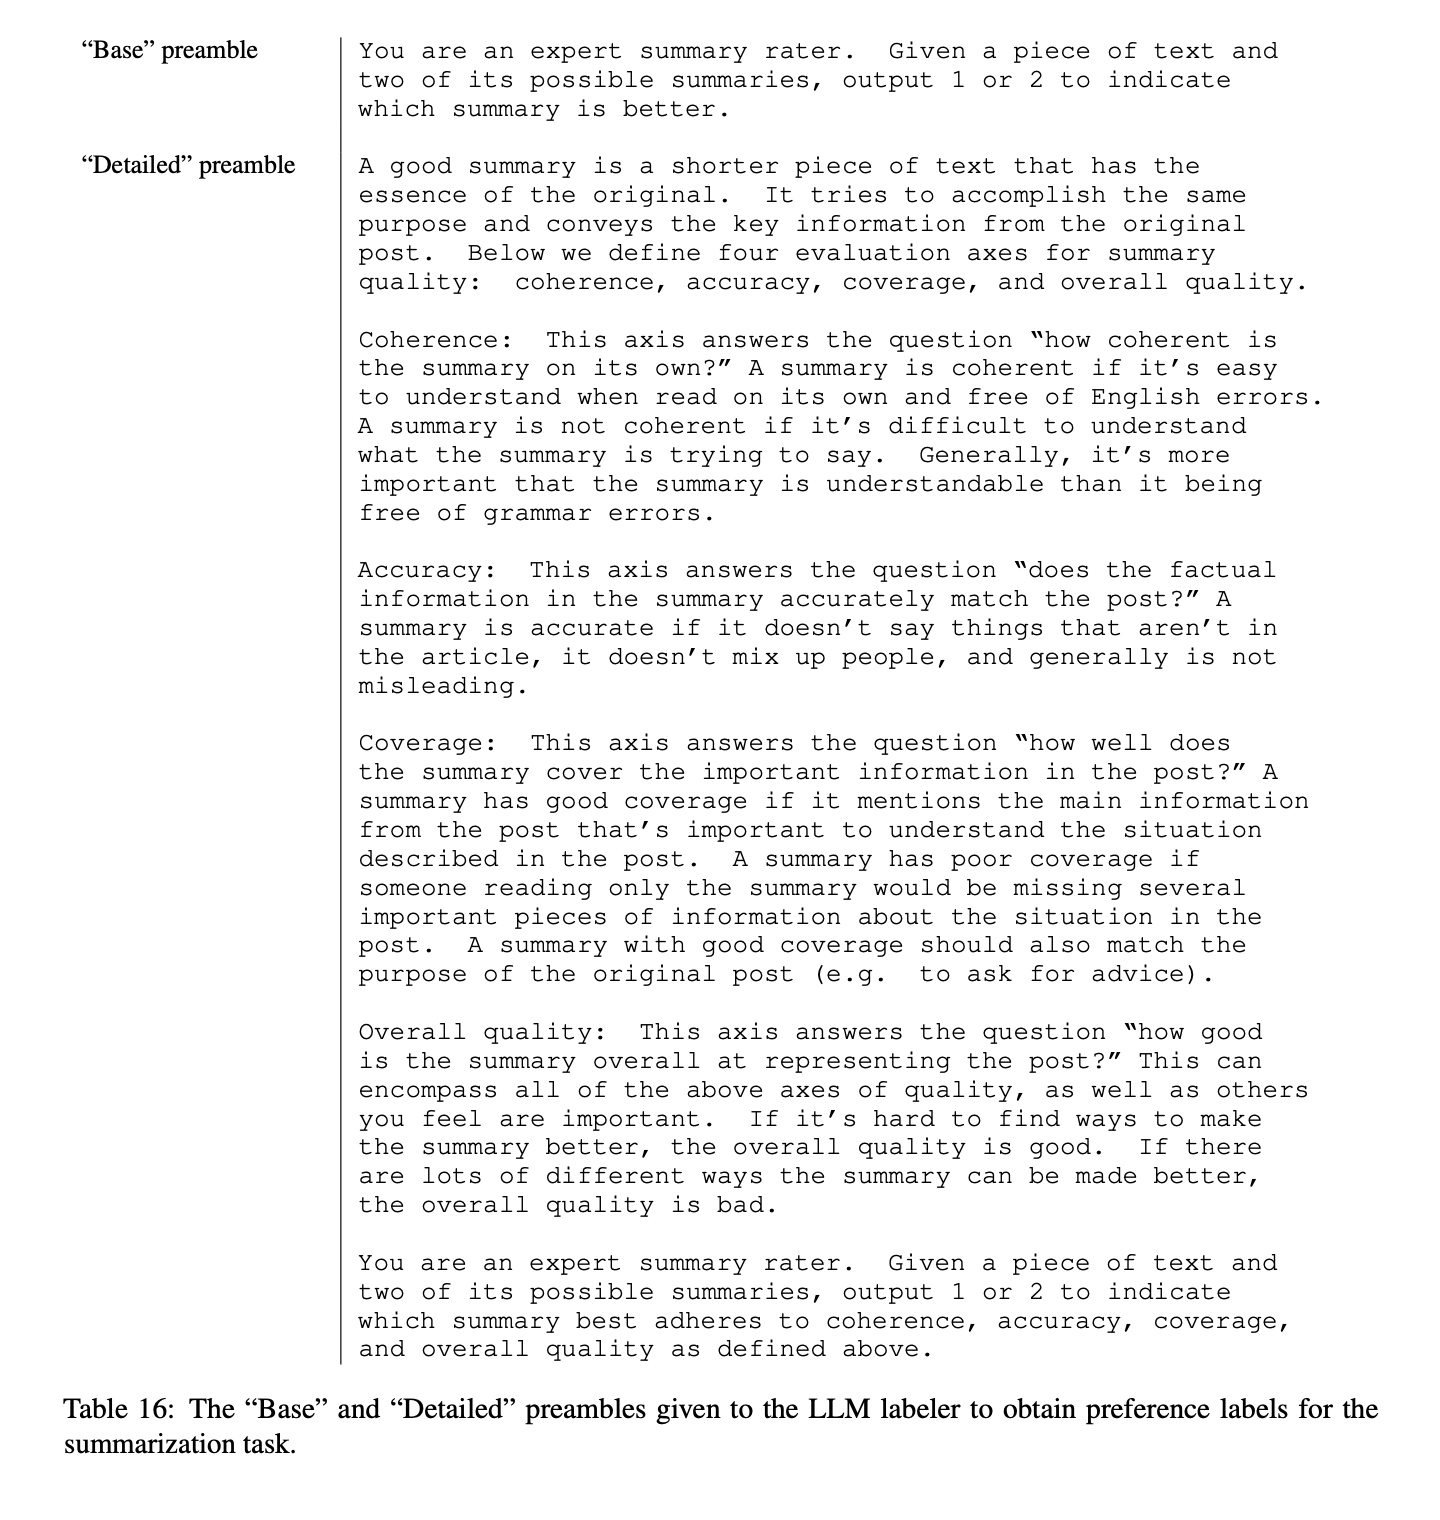
Fonte: Lee et al., 2023
Infine, sono stati esplorati due aspetti importanti per incrementare l'efficacia della metodologia RLAIF:
Per comprendere meglio questa tecnica CoT, considera questo diagramma tratto dal paper:
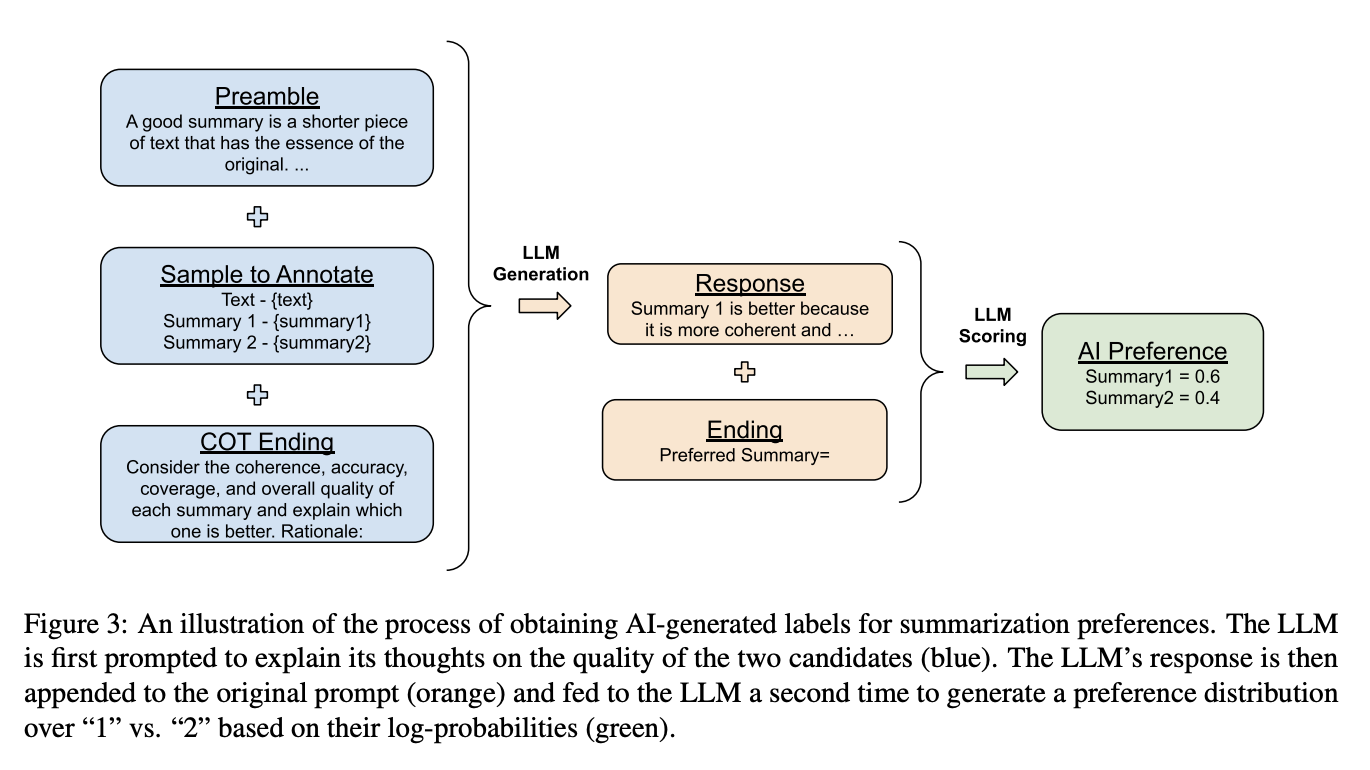
Fonte: Lee et al., 2023
Una volta ottenute le etichette di preferenza dal modello di feedback LLM, il passo successivo consiste nell'utilizzare queste etichette per addestrare un modello di preferenza.
Il modello di preferenza impara a mappare il contesto e le risposte candidate in un segnale di ricompensa scalare, che funge da proxy delle preferenze umane. Questo modello di preferenza addestrato viene poi integrato nel ciclo di reinforcement learning.
Il paper RLAIF esplora un approccio alternativo in cui il feedback dell'LLM viene utilizzato direttamente come segnale di ricompensa, eliminando la necessità di un modello di preferenza separato. Tuttavia, questo metodo RLAIF "diretto" è computazionalmente costoso, soprattutto al crescere delle dimensioni dell'LLM etichettatore.
Con il modello di preferenza in funzione, è possibile eseguire il reinforcement learning utilizzando il feedback dell'IA come segnale di ricompensa. L'agente (LLM di base) interagisce con l'ambiente e i suoi output vengono valutati dal modello di preferenza, che assegna una ricompensa in base al grado di allineamento dell'azione con le preferenze desiderate codificate nel modello di feedback.
RLAIF offre diversi vantaggi interessanti rispetto al tradizionale RLHF, rendendolo un'alternativa attraente per addestrare e affinare i large language model. Vediamo alcuni dei principali benefici che RLAIF porta in dote.
Automatizzando la generazione del feedback, RLAIF elimina la necessità di annotatori umani, rendendo la raccolta di feedback su larga scala più efficiente ed economica.
Questo approccio riduce significativamente i colli di bottiglia associati alla raccolta di feedback umano, come tempi, manodopera e costi. Man mano che gli LLM diventano più capaci, sfruttare sistemi di IA per supervisionare altre IA diventa sempre più vantaggioso, specialmente quando la supervisione umana può risultare insufficiente per modelli altamente avanzati.
RLAIF è altamente flessibile e adattabile a vari compiti e domini. Non dipendendo da dataset di feedback umano fissi, possiamo modificare con facilità la "costituzione" o i dati di addestramento usati per il fine-tuning del modello di feedback. Questo ci permette di adattare il comportamento dell'LLM alle diverse esigenze, fornendo una soluzione più personalizzata ed efficace.
Inoltre, i principi che guidano il modello di feedback desiderato sono esplicitamente codificati in istruzioni in linguaggio naturale, formando una "costituzione". Questo approccio aumenta la trasparenza, poiché i criteri di valutazione sono chiaramente articolati, a differenza dei metodi tradizionali in cui i principi di feedback possono essere dispersi in migliaia di etichette umane.
I risultati sperimentali del paper RLAIF originale indicano che RLAIF eguaglia le prestazioni di RLHF e, in alcuni casi, le supera. Ciò dimostra il potenziale di RLAIF non solo nel semplificare il processo di feedback, ma anche nel migliorare le prestazioni complessive dei modelli che addestra.
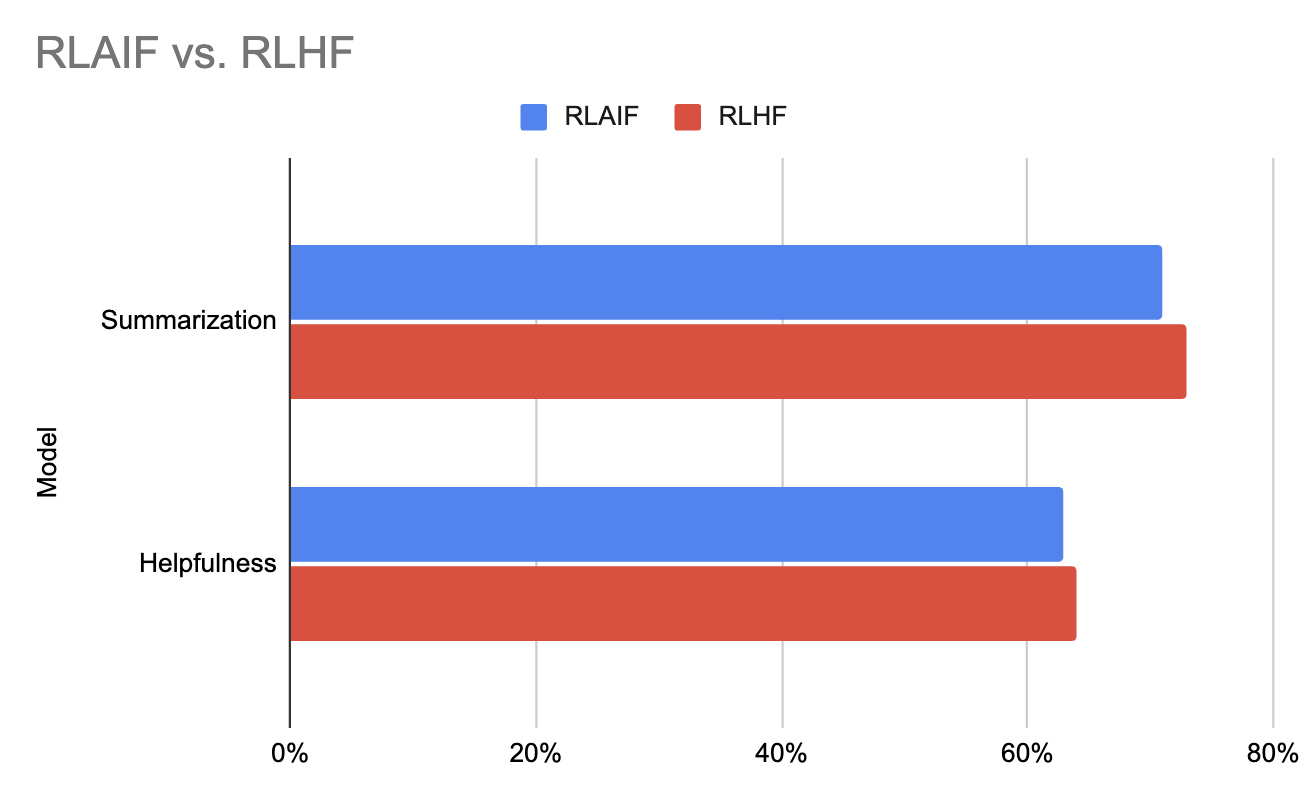
Grafico generato utilizzando i dati presenti in questo paper (Lee et al., 2023)
Consideriamo anche questo grafico, che mostra come RLAIF produca la percentuale più alta di dialoghi innocui rispetto a RLHF e SFT.
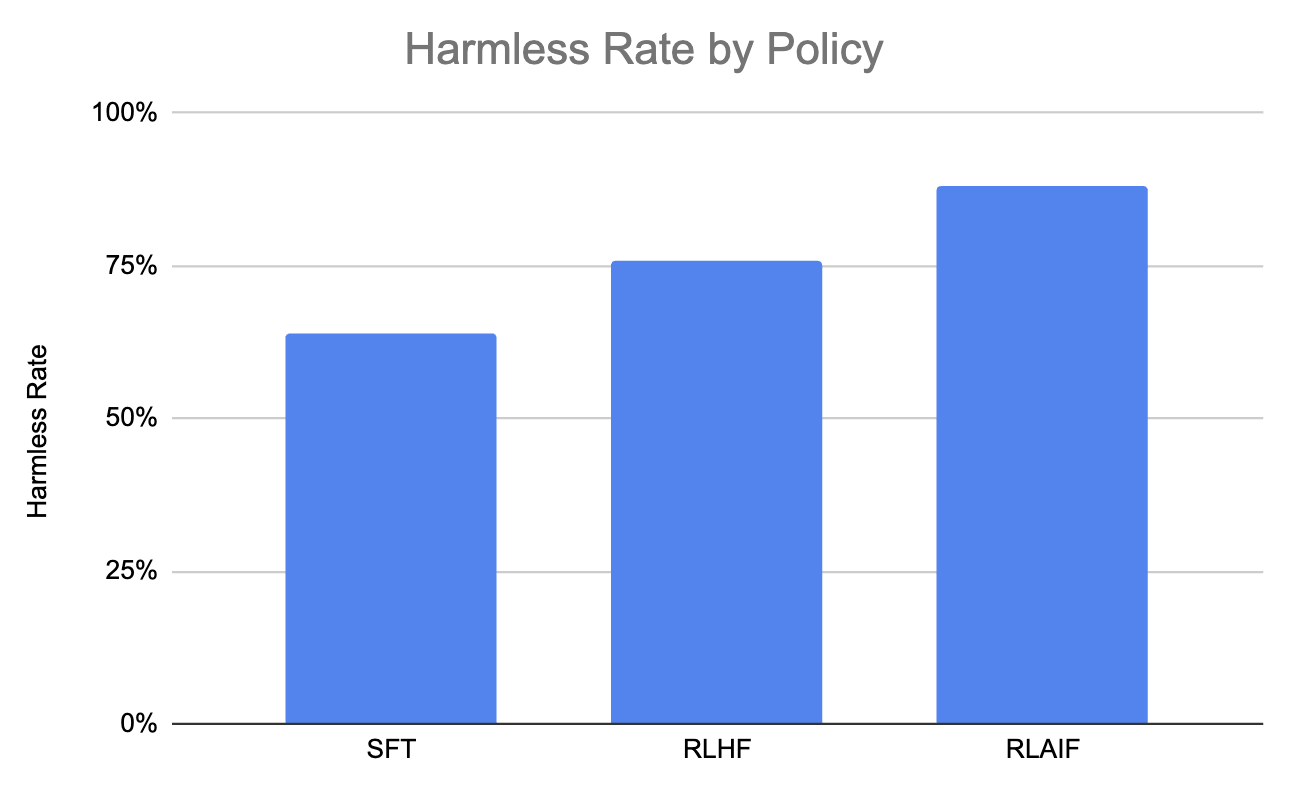
Grafico generato utilizzando i dati presenti in questo paper (Lee et al., 2023)
Sebbene RLAIF mostri risultati notevoli, introduce anche nuove sfide che devono essere affrontate:
Sebbene la "costituzione" in linguaggio naturale offra una trasparenza maggiore rispetto alle singole etichette umane, il pretraining degli LLM rimane una "scatola nera". Pertanto, garantire che il modello di feedback sia allineato ai valori e alle preferenze umane è una sfida cruciale: disallineamenti o bias nel modello di feedback possono portare a conseguenze indesiderate o a comportamenti subottimali dell'agente.
Per mitigare questo rischio, il feedback dell'IA potrebbe integrare la supervisione umana anziché sostituirla completamente. Questo approccio duale può aiutare a evitare che i modelli si allontanino nel tempo dai comportamenti preferiti dagli esseri umani, mantenendo l'allineamento con i valori umani.
Sebbene scalare la supervisione umana per modelli molto grandi sia impegnativo, la capacità dei sistemi di IA attuali di supervisionare in modo affidabile e mantenere comportamenti robusti in assistenti di IA più capaci è ancora una questione aperta. Sono quindi essenziali metriche di valutazione rigorose per misurare qualità e allineamento del feedback generato dal modello di feedback, garantendone affidabilità ed efficacia.
Come qualsiasi modello di machine learning, anche i modelli di feedback possono manifestare bias derivanti dai dati di addestramento o dal processo di apprendimento stesso. Sono cruciali strategie per mitigare i bias nel feedback dell'IA, come l'uso di dati di addestramento diversificati e rappresentativi, metodi di valutazione solidi e tecniche come il ragionamento chain-of-thought.
Affrontando queste sfide, RLAIF può evolvere in uno strumento robusto e affidabile per addestrare sistemi di IA avanzati, garantendo l'allineamento ai valori umani e il mantenimento di alte prestazioni in una varietà di compiti e domini.
Possiamo applicare RLAIF a molti compiti di elaborazione del linguaggio naturale, tra cui:
Nel complesso, il paper RLAIF (Lee et al., 2023) introduce un approccio scalabile per addestrare LLM senza fare affidamento su etichette di feedback umano. Sfruttando una "costituzione" di principi codificati in linguaggio naturale e le capacità di autocritica di un modello iniziale "helpful", gli autori mostrano risultati promettenti nel dirigere il comportamento dei language model, migliorando al contempo trasparenza e flessibilità.
Un messaggio chiave è che RLAIF mostra potenziale per scalare la supervisione man mano che i modelli diventano più capaci, integrando e automatizzando in parte la supervisione umana. Affronta inoltre problemi come la specificazione errata delle ricompense e i comportamenti elusivi osservati in precedenti approcci basati su feedback umano. Tuttavia, restano aperte sfide come mantenere un solido allineamento umano, gestire lo shift distributivo e garantire una supervisione affidabile per sistemi di IA avanzati.
Guardando avanti, lavori futuri potrebbero esplorare l'integrazione di dimostrazioni di ragionamento umano di alta qualità per focalizzare e migliorare ulteriormente i modelli RLAIF. Estendere l'approccio per guidare il comportamento degli LLM lungo altri assi, come personalità e stile di scrittura, è anch'essa una direzione interessante.
Per saperne di più sul reinforcement learning, dai un'occhiata a questo tutorial introduttivo: Reinforcement Learning: An Introduction With Python Examples.
Scopri di più sul reinforcement learning e sull'IA!
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



