
स्नोफ्लेक स्कीमा क्या है?
स्नोफ्लेक स्कीमा डेटा को व्यवस्थित करने का एक और तरीका है। इस स्कीमा में डायमेंशन टेबल्स को छोटे उप-डायमेंशन में बाँटा जाता है ताकि डेटा अधिक व्यवस्थित और विस्तृत रहे — ठीक वैसे ही जैसे एक बड़े झील में बर्फ़ के फाहे।
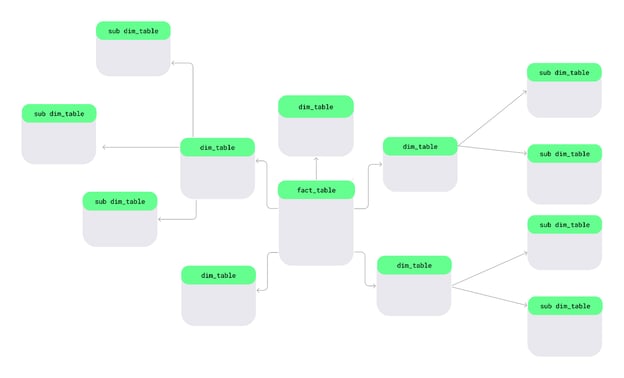
स्नोफ्लेक स्कीमा लेआउट। चित्र: लेखक।
आइए देखें कि स्नोफ्लेक स्कीमा की वे प्रमुख विशेषताएँ क्या हैं जो इसे अन्य स्कीमाओं से अलग बनाती हैं:
- मल्टी-लेवल डायमेंशन टेबल्स: हम अपनी डायमेंशन टेबल्स को छोटे, अधिक विशिष्ट टेबल्स में बाँट सकते हैं। उदाहरण के लिए, यदि मैं स्टोर लोकेशन ट्रैक करना चाहूँ, तो सभी लोकेशन विवरण एक बड़ी टेबल में रखने के बजाय, मैं उन्हें देश, राज्य और शहर के लिए अलग-अलग टेबल्स में बाँट सकता हूँ। इस तरह हर टेबल में केवल आवश्यक जानकारी होगी, जिससे अतिरेक घटेगा और संगठन बेहतर होगा।
- स्टोरेज दक्षता के लिए नॉर्मलाइज़ेशन: स्टार स्कीमा के विपरीत, स्नोफ्लेक स्कीमा एक नॉर्मलाइज़्ड डिज़ाइन का पालन करता है, जो डेटा डुप्लीकेशन से बचाता है। उदाहरण के लिए, हर प्रोडक्ट के लिए
Electronicsजैसी श्रेणी दोहराने के बजाय, मैं श्रेणी को अलग टेबल में रख सकता हूँ और उसे व्यक्तिगत प्रोडक्ट्स से लिंक कर सकता हूँ। - जटिल डेटा परिवेश के लिए उपयुक्तता: स्नोफ्लेक स्कीमा जटिल डेटा परिवेश में सबसे अच्छा काम करता है क्योंकि यह बहु-स्तरीय टेबल्स का उपयोग करके जटिल संबंधों और पदानुक्रमित डेटा संरचनाओं को संभालता है।
इसे एक सरल स्नोफ्लेक स्कीमा आरेख से समझते हैं। केंद्र में फैक्ट टेबल होती है, जिसमें मापनीय डेटा होता है। यह उन डायमेंशन टेबल्स से जुड़ती है जो फैक्ट्स का वर्णन करती हैं, और ये डायमेंशन टेबल्स आगे उप-डायमेंशन टेबल्स में शाखाबद्ध हो जाती हैं, जो स्नोफ्लेक जैसा ढाँचा बनाती हैं।
उदाहरण के लिए, यहाँ मैंने Product को Manufacturer और Category टेबल्स में और Customer टेबल को Transaction और Location टेबल्स में बाँटा है:
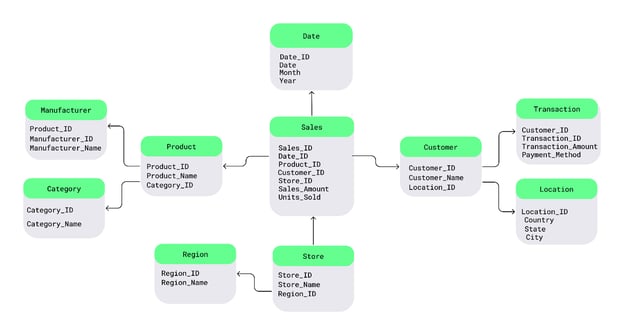
स्नोफ्लेक स्कीमा उदाहरण। चित्र: लेखक।
यहाँ एक SQL उदाहरण है जो स्नोफ्लेक स्कीमा दिखाता है, जहाँ Product टेबल को आगे Category और Manufacturer टेबल्स में नॉर्मलाइज़ किया गया है:
-- Fact table remains the same
CREATE TABLE Sales (
Sales_ID INT PRIMARY KEY,
Product_ID INT,
Customer_ID INT,
Date_ID INT,
Sales_Amount DECIMAL(10, 2),
FOREIGN KEY (Product_ID) REFERENCES Products(Product_ID),
FOREIGN KEY (Customer_ID) REFERENCES Customers(Customer_ID),
FOREIGN KEY (Date_ID) REFERENCES Dates(Date_ID)
);
-- Dimension table: Product
CREATE TABLE Product (
Product_ID INT PRIMARY KEY,
Product_Name VARCHAR(100),
Category_ID INT,
Manufacturer_ID INT,
FOREIGN KEY (Category_ID) REFERENCES Category(Category_ID),
FOREIGN KEY (Manufacturer_ID) REFERENCES Manufacturer(Manufacturer_ID)
);
-- Sub-dimension table: Category
CREATE TABLE Category (
Category_ID INT PRIMARY KEY,
Category_Name VARCHAR(50)
);
-- Sub-dimension table: Manufacturer
CREATE TABLE Manufacturer (
Manufacturer_ID INT PRIMARY KEY,
Manufacturer_Name VARCHAR(100)
);निम्नलिखित क्वेरी प्रोडक्ट श्रेणी के अनुसार कुल बिक्री की गणना करती है। यद्यपि इसमें स्टार स्कीमा की तुलना में अधिक जॉइन होते हैं, फिर भी यह स्टोरेज के दृष्टिकोण से अधिक कुशल है:
SELECT cat.Category_Name, SUM(s.Sales_Amount) AS TotalSales
FROM Sales s
JOIN Product p ON s.Product_ID = p.Product_ID
JOIN Category cat ON p.Category_ID = cat.Category_ID
GROUP BY cat.Category_Name;स्नोफ्लेक स्कीमा के फायदे और सीमाएँ
स्टार स्कीमा की तरह, स्नोफ्लेक स्कीमा के भी अपने लाभ हैं। आइए देखें वे क्या हैं:
- कम डेटा अतिरेक: नॉर्मलाइज़ेशन सुनिश्चित करता है कि वही डेटा कई बार संग्रहीत न हो, जिससे डुप्लीकेशन घटता है।
- बड़े डेटासेट के लिए कुशल स्टोरेज: यह स्कीमा दोहराए गए डेटा से बचकर स्टोरेज बचाता है, जिससे बड़े डेटासेट का प्रबंधन आसान होता है।
हालाँकि, फायदों के बावजूद कुछ सीमाएँ भी हैं। उदाहरण के लिए, क्वेरियाँ धीमी हो सकती हैं क्योंकि टेबल्स के बीच अधिक जॉइन होते हैं। इसके अलावा, मल्टी-लेवल संरचना डिज़ाइन और मेंटेन करने में अधिक चुनौतीपूर्ण है, बनिस्बत स्टार स्कीमा जैसे सरल स्कीमा के। इसलिए, इसे तभी अपनाएँ जब आपके पास अनुभवी DBA टीम हो।
यदि आप विश्लेषण के लिए डेटा को कुशलतापूर्वक संरचित करना सीखना चाहते हैं, तो Database Design कोर्स ज़रूर देखें।
हाइब्रिड दृष्टिकोण अपनाना
वास्तविक प्रोजेक्ट्स में, दोनों पैटर्न को अलग-अलग लेयर्स पर उपयोग करना आम है ताकि दोनों दृष्टिकोणों की खूबियाँ मिल सकें:
- वेयरहाउस लेयर में अधिक नॉर्मलाइज़्ड (स्नोफ्लेक्ड) संरचनाएँ रखें ताकि निरंतरता और रखरखाव आसान रहे
- BI और रिपोर्टिंग के लिए स्टार-आकार के मार्ट्स या डीनॉर्मलाइज़्ड व्यूज़ प्रकाशित करें
यह टीमों को डेटा अखंडता और गवर्नेंस को तेज़, सरल एनालिटिक्स कंजम्प्शन के साथ संतुलित करने देता है।
स्टार स्कीमा बनाम स्नोफ्लेक स्कीमा
डेटा वेयरहाउसिंग में स्टार और स्नोफ्लेक दोनों स्कीमाएँ व्यापक रूप से उपयोग होती हैं, लेकिन उनकी विशिष्ट विशेषताएँ उन्हें अलग-अलग जरूरतों के लिए उपयुक्त बनाती हैं। आइए देखें कि संरचना, परफ़ॉर्मेंस, स्टोरेज आवश्यकताओं और उपयोग के मामलों में ये स्कीमाएँ कैसे भिन्न हैं।
संरचना
स्टार स्कीमा में सभी डायमेंशन टेबल्स एक केंद्रीय फैक्ट टेबल से सीधे जुड़ती हैं। यानी आपका सारा रेफ़रेंस डेटा मुख्य डेटा से सिर्फ एक कदम दूर रहता है, जिससे इसे समझना और उपयोग करना आसान होता है।
इसके विपरीत, स्नोफ्लेक स्कीमा डायमेंशन टेबल्स को छोटे, अधिक विशिष्ट उप-डायमेंशन टेबल्स में बाँट देता है। उदाहरण के लिए, एक लोकेशन टेबल की जगह देशों, राज्यों और शहरों के लिए अलग-अलग टेबल्स हो सकती हैं। यह अधिक व्यवस्थित और विस्तृत संरचना बनाता है, लेकिन डेटा तक पहुँचने के लिए अधिक कनेक्शन (या जॉइन) चाहिए होते हैं — यही कारण है कि स्नोफ्लेक स्कीमा, स्टार स्कीमा की तुलना में अधिक जटिल है।
परफ़ॉर्मेंस
गति की बात आए तो स्टार स्कीमा अक्सर बेहतर होते हैं। चूँकि सभी डायमेंशन टेबल्स सीधे फैक्ट टेबल से जुड़ी होती हैं, इसलिए क्वेरियों में सामान्यतः कम जॉइन लगते हैं, जिससे परफ़ॉर्मेंस तेज़ रहती है। मान लीजिए आप क्षेत्रवार बिक्री का विश्लेषण करना चाहते हैं — इस स्थिति में, स्टार स्कीमा न्यूनतम प्रोसेसिंग के साथ डेटा प्राप्त करने देता है।
इसके विपरीत, स्नोफ्लेक स्कीमा अक्सर धीमे होते हैं क्योंकि डेटा प्राप्त करने के लिए आपको कई टेबल्स के माध्यम से जुड़ना पड़ता है। हर जॉइन प्रोसेसिंग समय बढ़ाता है, जिससे तेज़ क्वेरी परिणामों की ज़रूरत वाले कार्यों के लिए स्नोफ्लेक स्कीमा कम कुशल रहता है।
कोर्स Joining Data in SQL टेबल्स को जोड़ना, रिलेशनल सेट थ्योरी लागू करना और सबक्वेरियों के साथ काम करना सीखने के लिए उत्कृष्ट शुरुआती सामग्री है।
स्टोरेज आवश्यकताएँ
स्टार स्कीमा अधिक स्टोरेज लेते हैं क्योंकि वे डायमेंशन टेबल्स में दोहराई गई जानकारी रखते हैं। उदाहरण के लिए, यदि कई प्रोडक्ट्स एक ही श्रेणी में आते हैं, तो श्रेणी का नाम हर प्रोडक्ट के साथ दोहराया जाएगा, जिससे स्टोरेज की ज़रूरत बढ़ेगी।
इसके विपरीत, स्नोफ्लेक स्कीमा डेटा को नॉर्मलाइज़ करते हैं ताकि सारी जानकारी केवल एक बार संग्रहीत हो। उदाहरण के लिए, श्रेणी नाम दोहराने के बजाय, उन्हें एक अलग टेबल में रखा जाता है और फ़ॉरेन कीज़ के ज़रिये प्रोडक्ट टेबल से जोड़ा जाता है। यह डिज़ाइन स्टोरेज बचाता है और बड़े डेटासेट के लिए आदर्श है।
उपयोग के मामले
स्टार स्कीमा ऑनलाइन एनालिटिकल प्रोसेसिंग (OLAP) सिस्टम, रिपोर्टिंग और बिज़नेस इंटेलिजेंस कार्यों के लिए आदर्श हैं। इनकी सादगी उन्हें उन परिदृश्यों के लिए उपयुक्त बनाती है जहाँ गति और उपयोग में आसानी महत्वपूर्ण है, जैसे त्वरित डैशबोर्ड या बिक्री रिपोर्ट बनाना।
स्नोफ्लेक स्कीमा अक्सर वित्तीय विश्लेषण या कस्टमर रिलेशनशिप मैनेजमेंट (CRM) सिस्टम्स के लिए उपयोग होते हैं। ऐसे मामलों में विस्तृत पदानुक्रमों का संगठन और स्टोरेज की बचत क्वेरी गति से अधिक महत्वपूर्ण होती है।
तुलनात्मक तालिका
यहाँ स्टार और स्नोफ्लेक स्कीमा की एक त्वरित तुलना दी गई है, जो आपकी डेटा ज़रूरतों के लिए सही विकल्प चुनने में मदद करेगी। मैंने इस तालिका में उनकी संरचना, परफ़ॉर्मेंस, स्टोरेज और उपयोग के मामलों पर ध्यान देते हुए प्रमुख अंतर रेखांकित किए हैं:
|
विशेषता |
स्टार स्कीमा |
स्नोफ्लेक स्कीमा |
हाइब्रिड दृष्टिकोण |
|
संरचना |
केंद्रीय फैक्ट टेबल, डीनॉर्मलाइज़्ड डायमेंशन्स से लिंक |
केंद्रीय फैक्ट टेबल, नॉर्मलाइज़्ड डायमेंशन्स से लिंक |
नॉर्मलाइज़्ड कोर मॉडल, साथ में उपभोग के लिए स्टार-आकार के मार्ट्स या डीनॉर्मलाइज़्ड व्यूज़ |
|
जटिलता |
सरल, कम जॉइनों के साथ |
जटिल, अधिक जॉइनों के साथ |
मध्यम, अधिक मूविंग पार्ट्स के साथ, पर हर लेयर अपने उद्देश्य के लिए सरल |
|
डेटा अतिरेक |
डीनॉर्मलाइज़्ड डायमेंशन्स के कारण अधिक अतिरेक |
नॉर्मलाइज़्ड डायमेंशन्स के कारण कम अतिरेक |
चयनात्मक डीनॉर्मलाइज़ेशन के कारण मध्यम अतिरेक |
|
क्वेरी परफ़ॉर्मेंस |
सरल संरचना के कारण तेज़ क्वेरियाँ |
अतिरिक्त जॉइनों के कारण धीमी क्वेरियाँ |
BI के लिए तेज़, क्योंकि कंजम्प्शन लेयर डीनॉर्मलाइज़्ड है |
|
स्टोरेज |
अतिरेक के कारण अधिक स्टोरेज चाहिए |
नॉर्मलाइज़ेशन के कारण कम स्टोरेज चाहिए |
मध्यम स्टोरेज, क्योंकि मार्ट्स/व्यूज़ कुछ डुप्लीकेशन जोड़ सकते हैं |
|
मेंटेनेंस की आसानी |
डिज़ाइन और मेंटेन करना आसान |
डिज़ाइन और मेंटेन करना अधिक जटिल |
मेंटेन करना आसान, क्योंकि मार्ट्स को नियंत्रित कोर से फिर बनाया जा सकता है |
|
किसके लिए सर्वाधिक उपयुक्त |
छोटे से मध्यम आकार के डेटासेट |
बड़े और जटिल डेटासेट |
आधुनिक डेटा प्लेटफॉर्म जहाँ गवर्नेंस और BI परफ़ॉर्मेंस दोनों की ज़रूरत हो |
सही स्कीमा कैसे चुनें
स्टार स्कीमा कब उपयोग करें
यदि आप मुख्यतः अपना डेटा सरल और जल्दी व्यवस्थित करना चाहते हैं, तो स्टार स्कीमा उपयुक्त रहेगा। इसे इन स्थितियों में उपयोग करें:
- यदि आप BI टूल्स (उदाहरण के लिए, Power BI) के लिए सेमान्टिक मॉडल बना रहे हैं और टेबल्स व रिलेशनशिप की संख्या कम रखना चाहते हैं। यह सहज फ़िल्टरिंग/ग्रुपिंग का समर्थन करता है और इंटरऐक्टिव विज़ुअल्स के लिए अच्छा परफ़ॉर्म करता है।
- यदि आप क्षेत्र के अनुसार कुल बिक्री जैसी सरल क्वेरियाँ चलाना चाहते हैं, तो स्टार स्कीमा अपनाएँ। चूँकि सभी डायमेंशन टेबल्स सीधे फैक्ट टेबल से जुड़ती हैं, यह अनावश्यक जटिलता से बचाता है और उत्तर तेज़ देता है।
- जब गति प्राथमिकता हो, तब भी आप स्टार स्कीमा का उपयोग कर सकते हैं। यह टेबल जॉइनों की संख्या घटाता है, जिससे क्वेरियाँ तेज़ चलती हैं। मैंने इसे एक बार कई बिक्री रिपोर्ट्स जनरेट करने के लिए उपयोग किया था और अन्य डिज़ाइनों की तुलना में काफ़ी समय बचा।
- यदि आपका डेटासेट छोटा से मध्यम है, तो स्टार स्कीमा का अतिरेक समस्या नहीं बनेगा। दोहराए गए डेटा के बावजूद, यह आपके स्टोरेज पर अधिक भार डाले बिना अच्छी तरह काम करेगा।
स्नोफ्लेक स्कीमा कब उपयोग करें
स्नोफ्लेक स्कीमा पदानुक्रमों और साझा संदर्भ डेटा को दर्शाने के लिए अधिक उपयुक्त है, विशेषकर जब कई पंक्तियों में डायमेंशन एट्रिब्यूट्स बार-बार दोहरते हों। इसे इन स्थितियों में उपयोग करें:
- जब आपकी डायमेंशन्स में स्पष्ट पदानुक्रम हों (उदाहरण के लिए, Country → State/Region → City) और आप उन स्तरों को अलग-अलग टेबल्स के रूप में साफ़-सुथरे ढंग से मॉडल करना चाहें।
- यदि आप साझा संदर्भ डेटा (उदाहरण: श्रेणियाँ, निर्माता, या भू-भाग जैसी मानक सूचियाँ) पर अधिक मज़बूत नियंत्रण चाहते हैं ताकि डुप्लीकेशन घटे और वेयरहाउस में परिभाषाएँ सुसंगत रखना आसान हो।
- यदि आपका डेटा अक्सर बदलता है, जैसे क्षेत्र नाम अपडेट होना, तो भी आप स्नोफ्लेक स्कीमा अपना सकते हैं। यह संबंधित सभी डेटा में सुसंगत अपडेट सुनिश्चित करता है ताकि त्रुटियाँ और मेंटेनेंस प्रयास कम हों।
- यदि आपके विश्लेषण में डेटा के कई स्तर शामिल हों, तो स्नोफ्लेक स्कीमा इन संबंधों को व्यवस्थित करने और दर्शाने में मदद करता है।
क्लाउड डेटा वेयरहाउस में स्कीमा चयन
कई आधुनिक क्लाउड डेटा वेयरहाउस में, स्टोरेज की लागत कंप्यूट की तुलना में अपेक्षाकृत कम होती है। इसका अर्थ है कि डीनॉर्मलाइज़्ड डायमेंशन्स से आने वाला “अतिरिक्त स्टोरेज” अक्सर डेटा स्कैन और जॉइन करने की कंप्यूट लागत से कम मायने रखता है।
स्टार और स्नोफ्लेक के बीच चुनते समय, अपने प्लेटफॉर्म के प्राइसिंग मॉडल (कंप्यूट बनाम स्टोरेज), क्वेरी कंकरेन्सी, और क्या आप कैशिंग/मैटेरियलाइज़्ड व्यूज़ का उपयोग करके क्वेरी कॉस्ट घटा सकते हैं, इन बातों पर विचार करें।
अंतिम विचार
इस ब्लॉग में, मैंने स्टार और स्नोफ्लेक स्कीमा के बीच के अंतर, उनकी खूबियों और कब किसका उपयोग करना है, को कवर किया है। उम्मीद है कि अब आपको स्पष्ट समझ और अपने काम के लिए व्यावहारिक सुझाव मिल गए होंगे! और अधिक जानना चाहें, तो DataCamp पर ये संसाधन देखें:
- Introduction to Data Modeling in Snowflake कोर्स आपको Snowflake के साथ काम करने की बुनियाद मजबूत करने में मदद करेगा।
- Data Modeling in Power BI कोर्स, Power BI में डेटा को व्यवस्थित और प्रबंधित करने के लिए।
- Associate Data Engineer in SQL स्किल ट्रैक, अपनी SQL स्किल्स अगले स्तर पर ले जाने के लिए।
FAQs
इन स्कीमाओं में इंडेक्सिंग का उद्देश्य क्या है?
इंडेक्सिंग, डेटा प्राप्ति को तेज़ बनाकर, दोनों स्कीमाओं में क्वेरी परफ़ॉर्मेंस में सुधार करती है।
डायमेंशन टेबल्स और फैक्ट टेबल्स से क्या अभिप्राय है?
डायमेंशन टेबल्स वर्णनात्मक एट्रिब्यूट्स (जैसे प्रोडक्ट नाम या तिथियाँ) संग्रहीत करती हैं, जो फैक्ट टेबल में मौजूद डेटा का वर्णन करती हैं।
दूसरी ओर, फैक्ट टेबल्स मात्रात्मक डेटा जैसे बिक्री आँकड़े या लेन-देन राशि संग्रहीत करती हैं और डायमेंशन टेबल्स से जुड़ती हैं।
क्या ये स्कीमाएँ असंरचित डेटा के लिए उपयुक्त हैं?
नहीं, ये स्कीमाएँ संरचित डेटा के लिए बनी हैं। असंरचित डेटा के लिए NoSQL या डेटा लेक्स जैसे अलग मॉडल आवश्यक होते हैं।
मैं स्टार और स्नोफ्लेक स्कीमा कैसे डिज़ाइन कर सकता/सकती हूँ?
इन स्कीमाओं को बनाने और विज़ुअलाइज़ करने के लिए आप डेटा मॉडलिंग टूल्स (ERDPlus), BI टूल्स (Tableau, Power BI, QlikView), या क्लाउड प्लेटफॉर्म (Databricks) का उपयोग कर सकते हैं।
क्या स्टार और स्नोफ्लेक स्कीमा के अलावा कोई विकल्प हैं?
हाँ, आप Galaxy स्कीमा, Data Vault मॉडलिंग, या अधिक जटिल डायमेंशनल मॉडल्स का उपयोग कर सकते हैं। ये विकल्प मुख्यतः डेटा को व्यवस्थित करने और अलग-अलग जानकारी के बीच संबंधों को संभालने के तरीकों में भिन्न होते हैं।

मैं एक कंटेंट स्ट्रैटेजिस्ट हूँ जिसे जटिल विषयों को सरल बनाना पसंद है। मैंने Splunk, Hackernoon, और Tiiny Host जैसी कंपनियों को अपने दर्शकों के लिए आकर्षक और सूचनात्मक सामग्री बनाने में मदद की है।
यदि आप डेटा वेयरहाउस के साथ काम करते हैं, तो आप जानते हैं कि डेटा को इस तरह संरचित करना कितना महत्वपूर्ण है कि वह कुशल और सरलता से संभालने योग्य हो। लेकिन क्या आपने कभी सोचा है कि कौन-सा डेटाबेस स्कीमा आपकी ज़रूरतों के लिए सबसे अधिक उपयुक्त है? इसके लिए आप दो प्रमुख फ्रेमवर्क इस्तेमाल कर सकते हैं: स्टार स्कीमा और स्नोफ्लेक स्कीमा।
स्टार स्कीमा सरल और तेज़ होता है — जब आपको विश्लेषण के लिए डेटा शीघ्र निकालना हो, तब यह आदर्श है। दूसरी ओर, स्नोफ्लेक स्कीमा अधिक विस्तृत होता है। यह स्टोरेज दक्षता और जटिल डेटा संबंधों के प्रबंधन को प्राथमिकता देता है।
इस लेख में, मैं आपको इन स्कीमाओं की संरचनाओं से परिचित कराऊंगा, उनके अंतरों पर प्रकाश डालूंगा, और उनके लाभ समझाऊंगा। अंत तक, आप जान जाएंगे कि किस स्कीमा का उपयोग कहाँ करना है और अपने डेटा प्रोजेक्ट्स के लिए कौन-सा बेहतर है।
स्टार स्कीमा क्या है?
स्टार स्कीमा डेटाबेस में डेटा व्यवस्थित करने का एक तरीका है, खासतौर पर डेटा वेयरहाउस में (data warehouses), ताकि विश्लेषण आसान और तेज़ हो सके। केंद्र में एक मुख्य टेबल होती है जिसे फैक्ट टेबल कहते हैं, जिसमें बिक्री या राजस्व जैसे मापनीय डेटा होते हैं। इसके चारों ओर डायमेंशन टेबल्स होती हैं, जो प्रोडक्ट नाम, ग्राहक जानकारी या तारीखों जैसी जानकारियाँ जोड़ती हैं। यह लेआउट तारे जैसा आकार बनाता है।
स्टार स्कीमा लेआउट। चित्र: लेखक।
आइए स्टार स्कीमा की प्रमुख विशेषताएँ देखें:
इसे एक सरल स्टार स्कीमा आरेख से समझते हैं। फैक्ट टेबल
Salesकेंद्र में है। इसमें वे संख्यात्मक डेटा होते हैं जिनका आप विश्लेषण करना चाहते हैं, जैसे बिक्री या मुनाफ़ा। इससे जुड़ी होती हैं डायमेंशन टेबल्स जिनमें वर्णनात्मक विवरण होते हैं, जैसे प्रोडक्ट नाम, ग्राहक का स्थान, या तिथियाँ:नमूना स्टार स्कीमा। चित्र: लेखक।
यहाँ
Salesफैक्ट टेबल औरProduct,CustomerऔरDateडायमेंशन टेबल्स के साथ एक स्टार स्कीमा सेटअप करने का सरल SQL उदाहरण दिया गया है:यह लेआउट क्वेरियों को तेज़ करता है क्योंकि जटिल जॉइन नहीं होते। उदाहरण के लिए, निम्नलिखित क्वेरी ग्राहक के स्थान के अनुसार कुल बिक्री निकालती है, जो स्टार स्कीमा के सरल जॉइन का लाभ उठाती है:
हालाँकि, आपको कुछ डेटा अतिरेक स्वीकार करना होगा क्योंकि डायमेंशन टेबल्स में दोहराई गई जानकारी हो सकती है।
स्टार स्कीमा के फायदे और सीमाएँ
अब जब आप स्टार स्कीमा समझ चुके हैं, तो देखें कि यह क्यों अलग दिखता है:
सभी लाभों के बावजूद, स्टार स्कीमा की एक कमी है। जैसा कि पहले बताया, डीनॉर्मलाइज़ेशन के कारण डायमेंशन टेबल्स में अक्सर दोहराई गई जानकारी होती है, जिससे स्टोरेज उपयोग बढ़ता है। उदाहरण के लिए, यदि कई प्रोडक्ट्स एक ही श्रेणी में आते हैं, तो प्रत्येक प्रोडक्ट का नाम दोहर सकता है, जिससे अधिक स्थान लगेगा।