人工智能(AI)的发展热潮显著提升了计算需求,推动了对强大硬件解决方案的必要性。图形处理器(GPU)与张量处理器(TPU)已成为应对这些需求的关键技术。
GPU 最初用于图形渲染,如今凭借并行处理能力,已演变为能够高效处理 AI 任务的多功能处理器。相比之下,由 Google 开发的 TPU 专为 AI 计算而优化,针对诸如机器学习项目等任务提供更优性能。
本文将围绕性能、成本、生态系统等指标探讨 GPU 与 TPU 的差异,并比较两种技术。我们还将概述它们的能效、环境影响以及在企业级应用中的可扩展性。
什么是 GPU?
GPU 是专用处理器,最初为计算机和游戏主机中的图像与图形渲染而开发。与逐条顺序处理任务的 CPU 不同,GPU 会将复杂问题拆分为多个任务并同时处理。
得益于并行处理能力,GPU 的功能已远超图形处理,成为多种计算应用(如 AI 模型开发)的关键组件。
不过,让我们先回顾一下。
GPU 于 20 世纪 80 年代首次亮相,作为用于加速图形渲染的专用硬件。像 NVIDIA 和 ATI(现为 AMD 一部分)等公司在其发展中发挥了关键作用。然而,直到 1990 年代末和 2000 年代初,GPU 才开始广泛普及。这得益于可编程着色器的引入,使开发者能够将并行处理用于图形以外的任务。
进入 2000 年代,更多研究开始探索将 GPU 用于图形之外的通用计算任务。NVIDIA 的 CUDA(统一计算架构)和 AMD 的 Stream SDK 让开发者能将 GPU 计算力用于科学仿真、数据分析等领域。
随后,AI 和深度学习兴起。
由于能够处理海量数据并进行并行计算,GPU 成为训练和部署深度学习模型的必备工具。
TensorFlow 和 PyTorch 等框架利用 GPU 加速,使深度学习在全球范围内对研究人员和开发者更加可及。
什么是 TPU?
张量处理器(TPU)是一类由 Google 首创的专用集成电路(ASIC),旨在应对机器学习日益增长的计算需求。
与最初为图形处理而生、后又被改造以满足 AI 需求的 GPU 不同,TPU 从一开始就专为加速机器学习工作负载而设计。
由于面向机器学习而生,TPU 专门针对张量运算进行工程优化,而张量运算是深度学习算法的基础。
凭借针对矩阵乘法(神经网络中的关键操作)进行优化的定制架构,TPU 擅长处理海量数据并高效执行复杂神经网络,实现快速训练与推理。
这种专门化优化使 TPU 成为 AI 应用不可或缺的一环,推动了机器学习研究与部署的进步。
TPU vs GPU:性能对比
TPU 与 GPU 各有所长,并针对不同的计算任务进行了优化。二者虽都能加速机器学习工作负载,但由于架构与优化侧重点不同,在具体任务上的性能表现也会有所差异。
计算架构
首先,GPU 和 TPU 都是为提升 AI 任务性能而设计的专用硬件加速器,但它们的计算架构不同,从而显著影响在特定类型计算中的效率与效果。
GPU
GPU 由成千上万个小而高效的核心组成,用于并行处理。
这种架构使其能够同时执行多项任务,非常适合可并行化的工作,如图形渲染和深度学习。
GPU 尤其擅长矩阵运算,而矩阵运算在神经网络计算中非常常见。其处理海量数据与并行执行计算的能力,使其非常适合涉及大规模数据集与复杂数学运算的 AI 任务。
TPU
相比之下,TPU 更侧重张量运算,使其能够高效执行相关计算。尽管 TPU 的核心数量可能不及 GPU,但其专用架构使其在某些高度依赖张量运算的 AI 任务中能够超越 GPU。
话虽如此,GPU 在受益于并行处理的任务上表现突出,并且适合 AI 之外的多种计算,如图形渲染和科学仿真。
另一方面,TPU 针对张量处理优化,在涉及矩阵运算的深度学习任务上效率极高。根据具体 AI 工作负载的需求,GPU 或 TPU 可能分别在性能与效率上更具优势。
性能
速度与效率
GPU 以其在处理各类 AI 任务(包括训练深度学习模型与执行推理)方面的多面性而闻名。这是因为依赖并行处理的 GPU 架构能够显著提升众多 AI 模型的训练与推理速度。例如,使用 BERT 模型处理 128 个序列,V100 GPU 需时 3.8 毫秒,而 TPU v3 需时 1.7 毫秒。
相反,TPU 针对神经网络关键组成部分——张量运算——进行了精细调校。这种专门化常使 TPU 在特定深度学习任务上优于 GPU,尤其是那些由 Google 优化的,如大规模神经网络训练和复杂机器学习模型。
基准测试
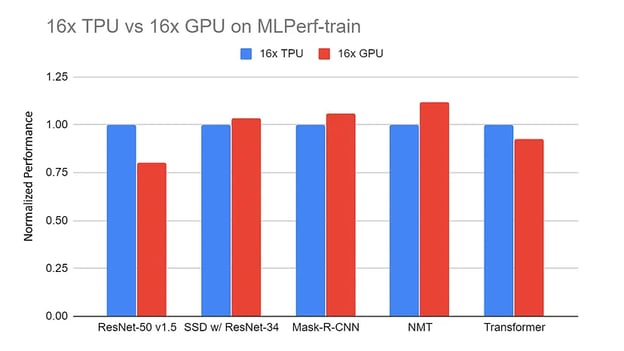
16x GPU 服务器(DGX-2H)与 16x TPU v3 服务器在 MLPerf-train 基准中的归一化性能对比。数据来自 MLPerf 官网。所有 TPU 结果使用 TensorFlow。除 ResNet 使用 MxNet 外,所有 GPU 结果使用 Pytorch |
来源:TPU vs. GPU vs Cerebras vs. Graphcore: A Fair Comparison between ML Hardware,作者 Mahmoud Khairy
在类似任务的对比中,TPU 常在针对其架构优化的任务中胜过 GPU,带来更快的训练时长和更高效的处理。
例如,在 CIFAR-10 数据集上用 ResNet-50 训练 10 个 epoch,使用 NVIDIA Tesla V100 GPU 大约需要 40 分钟,平均每个 epoch 4 分钟;而使用 Google Cloud TPU v3,则仅需约 15 分钟,平均每个 epoch 1.5 分钟。
尽管如此,得益于其适应性和社区的大量优化投入,GPU 在更广泛的应用领域中依然保持着竞争力。
GPU vs TPU:成本与可用性
在 GPU 与 TPU 之间做出选择,取决于预算、计算需求与可获得性。每种选项在不同应用中各有优势。本节将比较 GPU 与 TPU 在成本与市场可达性方面的表现。
硬件成本
在成本方面,GPU 比 TPU 灵活得多。首先,TPU 不单独售卖;只能通过Google Cloud Platform(GCP)等提供商以云服务形式获取。相比之下,GPU 可以单独购买。
NVIDIA Tesla V100 GPU 的单价约为 8,000 至 10,000 美元,NVIDIA A100 GPU 的单价约为 10,000 至 15,000 美元。但您也可以选择按需云计费。
使用 NVIDIA Tesla V100 GPU 训练一个深度学习模型,按小时计费约为 2.48 美元;NVIDIA A100 约为 2.93 美元。另一方面,Google Cloud TPU V3 约为每小时 4.50 美元,Google Cloud TPU V4 约为每小时 8.00 美元。
换言之,TPU 在灵活性上不如 GPU,且通常在按需云计算中的小时成本高于 GPU。然而,TPU 往往提供更快的性能,可缩短大规模机器学习任务所需的总计算时间,尽管小时费用更高,但总体成本可能因此下降。
市场可达性
TPU 与 GPU 在市场上的可用性差异较大,这会影响它们在不同行业与地区的采用……
由 Google 开发的 TPU 主要通过 Google Cloud Platform(GCP)用于云端 AI 任务。这意味着它们主要被依赖 GCP 进行计算的人群使用,因此在注重云计算的地区和行业(如科技中心或网络基础设施完善的地区)更受欢迎。
与此同时,GPU 由 NVIDIA、AMD 和 Intel 等公司生产,面向消费者与企业提供多种选择。这种更广泛的可获得性使 GPU 在游戏、科学、金融、医疗与制造等多个行业中都很受欢迎。GPU 既可本地部署,也可部署至云端,为用户的计算架构提供灵活性。
因此,无论技术基础设施或计算需求如何,GPU 更有可能在不同行业与地区被采用。总体而言,TPU 与 GPU 的市场可用性影响了其采用方式:TPU 更常见于以云为中心的领域与行业(如机器学习),而 GPU 则在不同领域与地域广泛使用。
生态系统与开发工具
软件与库
Google 的 TPU 与其主导的开源机器学习框架 TensorFlow 深度集成。另一款用于高性能数值计算的库 JAX 也支持 TPU,可用于高效的机器学习与科学计算。
TPU 无缝融入 TensorFlow 生态,使 TensorFlow 用户能够直接利用 TPU 能力。例如,TensorFlow 提供了 TensorFlow XLA(加速线性代数)编译器,可为 TPU 优化计算。
本质上,TPU 旨在加速 TensorFlow 运算,为训练与推理提供优化性能。它们也支持 TensorFlow 的高级 API,便于将模型迁移并优化为在 TPU 上执行。
相比之下,GPU 在各行各业与研究领域被广泛采用,因而在多样化的机器学习应用中更受欢迎。这意味着它们拥有比 GPU 更多的集成与更广泛的深度学习框架支持,包括 TensorFlow、PyTorch、Keras、MXNet 和 Caffe。
GPU 还受益于 CUDA、cuDNN 和 RAPIDS 等丰富的库与工具,进一步提升了其在各类机器学习与数据科学工作流中的通用性与易集成性。
社区支持与资源
在社区支持方面,GPU 拥有更广泛的生态系统,来自 NVIDIA、AMD 以及社区驱动平台的大量论坛、教程与文档可供参考。开发者可以接入活跃的在线社区、论坛与用户群组,寻求帮助、分享知识并协作项目。此外,还有大量教程、课程与文档涵盖 GPU 编程、深度学习框架与优化技术。
TPU 的社区支持更多集中于 Google 生态,资源主要通过 GCP 文档、论坛与支持渠道提供。尽管 Google 为在 TensorFlow 中使用 TPU 提供了面向性的全面文档与教程,但与更广泛的 GPU 生态相比,社区支持可能相对有限。不过,Google 的官方支持渠道与开发者资源仍能为使用 TPU 执行 AI 工作负载的开发者提供有价值的帮助。
能效与环境影响
功耗
GPU 与 TPU 的能源效率取决于其架构与目标应用。总体而言,TPU 比 GPU 更节能,尤其是 Google Cloud TPU v3,相较高端 NVIDIA GPU 具有显著的能效优势。
具体情况如下:
- NVIDIA Tesla V100:每卡约 250 瓦。
- NVIDIA A100:每卡约 400 瓦。
- Google Cloud TPU v3:每芯片约 120–150 瓦。
- Google Cloud TPU v4:每芯片约 200–250 瓦。
TPU 较低的功耗可显著降低运营成本并提升能源效率,尤其适用于大规模机器学习部署。
针对 AI 任务的优化
TPU 与 GPU 都通过特定优化来提升大规模 AI 操作时的能源效率。
如前文所述,TPU 架构优先处理神经网络中常用的张量运算,从而以更低能耗高效执行 AI 任务。TPU 还具备针对 AI 计算优化的定制内存层级,降低内存访问时延与能耗开销。
它们利用量化与稀疏等技术优化算术操作,在不牺牲精度的前提下尽可能降低功耗。这些因素使 TPU 能在节能的同时提供高性能。
同样,GPU 也采用能效优化以提升 AI 操作性能。现代 GPU 架构引入了如电源门控与动态电压频率调节(DVFS)等特性,可根据负载需求调节功耗。它们还利用并行处理技术,将计算任务分配到多个核心,最大化吞吐量并最小化单次操作能耗。
GPU 厂商还开发了高能效的内存架构与缓存层级,以优化内存访问模式并降低数据传输时的能耗。这些优化与内核融合、循环展开等软件技术相结合,进一步提升了 GPU 加速 AI 工作负载的能源效率。
企业应用的可扩展性
扩展 AI 项目
TPU 与 GPU 都能为大型 AI 项目提供可扩展性,但路径不同。TPU 与云基础设施(尤其是 Google Cloud Platform,GCP)深度集成,为 AI 工作负载提供可扩展资源。用户可按需访问 TPU,依据计算需求弹性扩缩,这对于高效处理大规模 AI 项目至关重要。Google 还提供用于在 TPU 上部署 AI 模型的托管服务与预配置环境,简化了与云基础设施的集成流程。
另一方面,GPU 也能高效扩展大型 AI 项目,可选择在本地部署,或使用 Amazon Web Services(AWS)和 Microsoft Azure 等提供商的云环境。GPU 在扩展方面更具灵活性,允许并行部署多块 GPU 以提升计算能力。
此外,GPU 以其高内存带宽与并行处理能力,擅长处理大规模数据集。这使其能够高效进行数据处理与模型训练,对于需要处理海量数据集的大型 AI 项目尤为关键。
总体而言,TPU 与 GPU 都能为大型 AI 项目提供可扩展性:TPU 与云基础设施深度集成,GPU 则为本地或云端部署提供灵活选择。二者在处理大数据集与扩展计算资源方面的能力,使其在大规模应对复杂 AI 任务时不可或缺。
GPU 与 TPU 对比概览
| Feature | GPUs | TPUs |
|---|
| Computational Architecture | Thousands of small, efficient cores for parallel processing | Prioritize tensor operations, specialized architecture |
| Performance | Versatile, excel in various AI tasks, including deep learning and inference | Optimized for tensor operations, often outperform GPUs in specific deep learning tasks |
| Speed and Efficiency | E.g., 128 sequences with BERT model: 3.8 ms on V100 GPU | E.g., 128 sequences with BERT model: 1.7 ms on TPU v3 |
| Benchmarks | ResNet-50 on CIFAR-10: 40 minutes for 10 epochs (4 minutes/epoch) on Tesla V100 GPU | ResNet-50 on CIFAR-10: 15 minutes for 10 epochs (1.5 minutes/epoch) on Google Cloud TPU v3 |
| Cost | NVIDIA Tesla V100: $8,000 - $10,000/unit, $2.48/hour; NVIDIA A100: $10,000 - $15,000/unit, $2.93/hour | Google Cloud TPU v3: $4.50/hour; TPU v4: $8.00/hour |
| Availability | Widely available from multiple vendors (NVIDIA, AMD, Intel), for consumers and businesses | Mainly accessible through Google Cloud Platform (GCP) |
| Ecosystem and Development Tools | Supported by many frameworks (TensorFlow, PyTorch, Keras, MXNet, Caffe), extensive libraries (CUDA, cuDNN, RAPIDS) | Integrated with TensorFlow, supports JAX, optimized by TensorFlow XLA compiler |
| Community Support and Resources | Broad ecosystem with extensive forums, tutorials, and documentation from NVIDIA, AMD, and communities | Centralized around Google's ecosystem with GCP documentation, forums, and support channels |
| Energy Efficiency | NVIDIA Tesla V100: 250 watts; NVIDIA A100: 400 watts | Google Cloud TPU v3: 120-150 watts; TPU v4: 200-250 watts |
| Optimization for AI Tasks | Energy-efficient optimizations (power gating, DVFS, parallel processing, kernel fusion) | Custom memory hierarchies, quantization, and sparsity for efficient AI computation |
| Scalability in Enterprise Applications | Scalable for large AI projects, on-premises or cloud (AWS, Azure), high memory bandwidth, parallel processing | Tightly integrated into cloud infrastructure (GCP), on-demand scalability, managed services for deploying AI models |
建议
在以下情况下选择 GPU:
- 您的项目需要 TensorFlow 之外的广泛框架支持,如 PyTorch、MXNet 或 Keras。
- 您需要多样化的计算能力,包括机器学习、科学计算与图形渲染。
- 您希望拥有高度可定制的优化选项与对性能调优的精细控制。
- 部署需要在本地、数据中心与云环境间灵活切换。
在以下情况下选择 TPU:
- 您的项目主要基于 TensorFlow,并可从与 TensorFlow 的深度集成与优化性能中受益。
- 高吞吐训练与快速推理至关重要,例如大规模深度学习模型训练或实时应用。
- 能效与降低功耗是重要考量,尤其是在大规模部署中。
- 您倾向于使用具备无缝扩展能力的托管云服务,并希望在 Google Cloud 中便捷访问 TPU 资源。
结论
GPU 与 TPU 都是用于 AI 应用的专用硬件加速器。GPU 源于图形渲染,擅长并行处理,并已被改造用于 AI 任务,在各行业展现出多面性。相比之下,TPU 由 Google 为 AI 工作负载定制打造,优先处理神经网络中常见的张量运算。
本文从性能、成本与可用性、生态与开发、能效与环境影响,以及在 AI 应用中的可扩展性等方面比较了 GPU 与 TPU。若您希望继续学习 TPU 与 GPU,欢迎查看以下资源:


人工智能(AI)的发展热潮显著提升了计算需求,推动了对强大硬件解决方案的必要性。图形处理器(GPU)与张量处理器(TPU)已成为应对这些需求的关键技术。
GPU 最初用于图形渲染,如今凭借并行处理能力,已演变为能够高效处理 AI 任务的多功能处理器。相比之下,由 Google 开发的 TPU 专为 AI 计算而优化,针对诸如机器学习项目等任务提供更优性能。
本文将围绕性能、成本、生态系统等指标探讨 GPU 与 TPU 的差异,并比较两种技术。我们还将概述它们的能效、环境影响以及在企业级应用中的可扩展性。
什么是 GPU?
GPU 是专用处理器,最初为计算机和游戏主机中的图像与图形渲染而开发。与逐条顺序处理任务的 CPU 不同,GPU 会将复杂问题拆分为多个任务并同时处理。
得益于并行处理能力,GPU 的功能已远超图形处理,成为多种计算应用(如 AI 模型开发)的关键组件。
不过,让我们先回顾一下。
GPU 于 20 世纪 80 年代首次亮相,作为用于加速图形渲染的专用硬件。像 NVIDIA 和 ATI(现为 AMD 一部分)等公司在其发展中发挥了关键作用。然而,直到 1990 年代末和 2000 年代初,GPU 才开始广泛普及。这得益于可编程着色器的引入,使开发者能够将并行处理用于图形以外的任务。
进入 2000 年代,更多研究开始探索将 GPU 用于图形之外的通用计算任务。NVIDIA 的 CUDA(统一计算架构)和 AMD 的 Stream SDK 让开发者能将 GPU 计算力用于科学仿真、数据分析等领域。
随后,AI 和深度学习兴起。
由于能够处理海量数据并进行并行计算,GPU 成为训练和部署深度学习模型的必备工具。
TensorFlow 和 PyTorch 等框架利用 GPU 加速,使深度学习在全球范围内对研究人员和开发者更加可及。
什么是 TPU?
张量处理器(TPU)是一类由 Google 首创的专用集成电路(ASIC),旨在应对机器学习日益增长的计算需求。
与最初为图形处理而生、后又被改造以满足 AI 需求的 GPU 不同,TPU 从一开始就专为加速机器学习工作负载而设计。
由于面向机器学习而生,TPU 专门针对张量运算进行工程优化,而张量运算是深度学习算法的基础。
凭借针对矩阵乘法(神经网络中的关键操作)进行优化的定制架构,TPU 擅长处理海量数据并高效执行复杂神经网络,实现快速训练与推理。
这种专门化优化使 TPU 成为 AI 应用不可或缺的一环,推动了机器学习研究与部署的进步。
TPU vs GPU:性能对比
TPU 与 GPU 各有所长,并针对不同的计算任务进行了优化。二者虽都能加速机器学习工作负载,但由于架构与优化侧重点不同,在具体任务上的性能表现也会有所差异。
计算架构
首先,GPU 和 TPU 都是为提升 AI 任务性能而设计的专用硬件加速器,但它们的计算架构不同,从而显著影响在特定类型计算中的效率与效果。
GPU
GPU 由成千上万个小而高效的核心组成,用于并行处理。
这种架构使其能够同时执行多项任务,非常适合可并行化的工作,如图形渲染和深度学习。
GPU 尤其擅长矩阵运算,而矩阵运算在神经网络计算中非常常见。其处理海量数据与并行执行计算的能力,使其非常适合涉及大规模数据集与复杂数学运算的 AI 任务。
TPU
相比之下,TPU 更侧重张量运算,使其能够高效执行相关计算。尽管 TPU 的核心数量可能不及 GPU,但其专用架构使其在某些高度依赖张量运算的 AI 任务中能够超越 GPU。
话虽如此,GPU 在受益于并行处理的任务上表现突出,并且适合 AI 之外的多种计算,如图形渲染和科学仿真。
另一方面,TPU 针对张量处理优化,在涉及矩阵运算的深度学习任务上效率极高。根据具体 AI 工作负载的需求,GPU 或 TPU 可能分别在性能与效率上更具优势。
性能
速度与效率
GPU 以其在处理各类 AI 任务(包括训练深度学习模型与执行推理)方面的多面性而闻名。这是因为依赖并行处理的 GPU 架构能够显著提升众多 AI 模型的训练与推理速度。例如,使用 BERT 模型处理 128 个序列,V100 GPU 需时 3.8 毫秒,而 TPU v3 需时 1.7 毫秒。
相反,TPU 针对神经网络关键组成部分——张量运算——进行了精细调校。这种专门化常使 TPU 在特定深度学习任务上优于 GPU,尤其是那些由 Google 优化的,如大规模神经网络训练和复杂机器学习模型。
基准测试
16x GPU 服务器(DGX-2H)与 16x TPU v3 服务器在 MLPerf-train 基准中的归一化性能对比。数据来自 MLPerf 官网。所有 TPU 结果使用 TensorFlow。除 ResNet 使用 MxNet 外,所有 GPU 结果使用 Pytorch |
来源:TPU vs. GPU vs Cerebras vs. Graphcore: A Fair Comparison between ML Hardware,作者 Mahmoud Khairy
在类似任务的对比中,TPU 常在针对其架构优化的任务中胜过 GPU,带来更快的训练时长和更高效的处理。
例如,在 CIFAR-10 数据集上用 ResNet-50 训练 10 个 epoch,使用 NVIDIA Tesla V100 GPU 大约需要 40 分钟,平均每个 epoch 4 分钟;而使用 Google Cloud TPU v3,则仅需约 15 分钟,平均每个 epoch 1.5 分钟。
尽管如此,得益于其适应性和社区的大量优化投入,GPU 在更广泛的应用领域中依然保持着竞争力。
GPU vs TPU:成本与可用性
在 GPU 与 TPU 之间做出选择,取决于预算、计算需求与可获得性。每种选项在不同应用中各有优势。本节将比较 GPU 与 TPU 在成本与市场可达性方面的表现。
硬件成本
在成本方面,GPU 比 TPU 灵活得多。首先,TPU 不单独售卖;只能通过Google Cloud Platform(GCP)等提供商以云服务形式获取。相比之下,GPU 可以单独购买。
NVIDIA Tesla V100 GPU 的单价约为 8,000 至 10,000 美元,NVIDIA A100 GPU 的单价约为 10,000 至 15,000 美元。但您也可以选择按需云计费。
使用 NVIDIA Tesla V100 GPU 训练一个深度学习模型,按小时计费约为 2.48 美元;NVIDIA A100 约为 2.93 美元。另一方面,Google Cloud TPU V3 约为每小时 4.50 美元,Google Cloud TPU V4 约为每小时 8.00 美元。
换言之,TPU 在灵活性上不如 GPU,且通常在按需云计算中的小时成本高于 GPU。然而,TPU 往往提供更快的性能,可缩短大规模机器学习任务所需的总计算时间,尽管小时费用更高,但总体成本可能因此下降。
市场可达性
TPU 与 GPU 在市场上的可用性差异较大,这会影响它们在不同行业与地区的采用……
由 Google 开发的 TPU 主要通过 Google Cloud Platform(GCP)用于云端 AI 任务。这意味着它们主要被依赖 GCP 进行计算的人群使用,因此在注重云计算的地区和行业(如科技中心或网络基础设施完善的地区)更受欢迎。
与此同时,GPU 由 NVIDIA、AMD 和 Intel 等公司生产,面向消费者与企业提供多种选择。这种更广泛的可获得性使 GPU 在游戏、科学、金融、医疗与制造等多个行业中都很受欢迎。GPU 既可本地部署,也可部署至云端,为用户的计算架构提供灵活性。
因此,无论技术基础设施或计算需求如何,GPU 更有可能在不同行业与地区被采用。总体而言,TPU 与 GPU 的市场可用性影响了其采用方式:TPU 更常见于以云为中心的领域与行业(如机器学习),而 GPU 则在不同领域与地域广泛使用。
生态系统与开发工具
软件与库
Google 的 TPU 与其主导的开源机器学习框架 TensorFlow 深度集成。另一款用于高性能数值计算的库 JAX 也支持 TPU,可用于高效的机器学习与科学计算。
TPU 无缝融入 TensorFlow 生态,使 TensorFlow 用户能够直接利用 TPU 能力。例如,TensorFlow 提供了 TensorFlow XLA(加速线性代数)编译器,可为 TPU 优化计算。
本质上,TPU 旨在加速 TensorFlow 运算,为训练与推理提供优化性能。它们也支持 TensorFlow 的高级 API,便于将模型迁移并优化为在 TPU 上执行。
相比之下,GPU 在各行各业与研究领域被广泛采用,因而在多样化的机器学习应用中更受欢迎。这意味着它们拥有比 GPU 更多的集成与更广泛的深度学习框架支持,包括 TensorFlow、PyTorch、Keras、MXNet 和 Caffe。
GPU 还受益于 CUDA、cuDNN 和 RAPIDS 等丰富的库与工具,进一步提升了其在各类机器学习与数据科学工作流中的通用性与易集成性。
社区支持与资源
在社区支持方面,GPU 拥有更广泛的生态系统,来自 NVIDIA、AMD 以及社区驱动平台的大量论坛、教程与文档可供参考。开发者可以接入活跃的在线社区、论坛与用户群组,寻求帮助、分享知识并协作项目。此外,还有大量教程、课程与文档涵盖 GPU 编程、深度学习框架与优化技术。
TPU 的社区支持更多集中于 Google 生态,资源主要通过 GCP 文档、论坛与支持渠道提供。尽管 Google 为在 TensorFlow 中使用 TPU 提供了面向性的全面文档与教程,但与更广泛的 GPU 生态相比,社区支持可能相对有限。不过,Google 的官方支持渠道与开发者资源仍能为使用 TPU 执行 AI 工作负载的开发者提供有价值的帮助。
能效与环境影响
功耗
GPU 与 TPU 的能源效率取决于其架构与目标应用。总体而言,TPU 比 GPU 更节能,尤其是 Google Cloud TPU v3,相较高端 NVIDIA GPU 具有显著的能效优势。
具体情况如下:
TPU 较低的功耗可显著降低运营成本并提升能源效率,尤其适用于大规模机器学习部署。
针对 AI 任务的优化
TPU 与 GPU 都通过特定优化来提升大规模 AI 操作时的能源效率。
如前文所述,TPU 架构优先处理神经网络中常用的张量运算,从而以更低能耗高效执行 AI 任务。TPU 还具备针对 AI 计算优化的定制内存层级,降低内存访问时延与能耗开销。
它们利用量化与稀疏等技术优化算术操作,在不牺牲精度的前提下尽可能降低功耗。这些因素使 TPU 能在节能的同时提供高性能。
同样,GPU 也采用能效优化以提升 AI 操作性能。现代 GPU 架构引入了如电源门控与动态电压频率调节(DVFS)等特性,可根据负载需求调节功耗。它们还利用并行处理技术,将计算任务分配到多个核心,最大化吞吐量并最小化单次操作能耗。
GPU 厂商还开发了高能效的内存架构与缓存层级,以优化内存访问模式并降低数据传输时的能耗。这些优化与内核融合、循环展开等软件技术相结合,进一步提升了 GPU 加速 AI 工作负载的能源效率。
企业应用的可扩展性
扩展 AI 项目
TPU 与 GPU 都能为大型 AI 项目提供可扩展性,但路径不同。TPU 与云基础设施(尤其是 Google Cloud Platform,GCP)深度集成,为 AI 工作负载提供可扩展资源。用户可按需访问 TPU,依据计算需求弹性扩缩,这对于高效处理大规模 AI 项目至关重要。Google 还提供用于在 TPU 上部署 AI 模型的托管服务与预配置环境,简化了与云基础设施的集成流程。
另一方面,GPU 也能高效扩展大型 AI 项目,可选择在本地部署,或使用 Amazon Web Services(AWS)和 Microsoft Azure 等提供商的云环境。GPU 在扩展方面更具灵活性,允许并行部署多块 GPU 以提升计算能力。
此外,GPU 以其高内存带宽与并行处理能力,擅长处理大规模数据集。这使其能够高效进行数据处理与模型训练,对于需要处理海量数据集的大型 AI 项目尤为关键。
总体而言,TPU 与 GPU 都能为大型 AI 项目提供可扩展性:TPU 与云基础设施深度集成,GPU 则为本地或云端部署提供灵活选择。二者在处理大数据集与扩展计算资源方面的能力,使其在大规模应对复杂 AI 任务时不可或缺。
GPU 与 TPU 对比概览
建议
在以下情况下选择 GPU:
在以下情况下选择 TPU:
结论
GPU 与 TPU 都是用于 AI 应用的专用硬件加速器。GPU 源于图形渲染,擅长并行处理,并已被改造用于 AI 任务,在各行业展现出多面性。相比之下,TPU 由 Google 为 AI 工作负载定制打造,优先处理神经网络中常见的张量运算。
本文从性能、成本与可用性、生态与开发、能效与环境影响,以及在 AI 应用中的可扩展性等方面比较了 GPU 与 TPU。若您希望继续学习 TPU 与 GPU,欢迎查看以下资源: