在现代企业中,人们越来越需要缩短产出数据洞见的时间。为了加速从数据采集到分析、人工智能与机器学习落地的全过程,需要一种更快速的方法。
传统的 ETL(抽取、转换、加载)架构在满足大数据与实时数据分析的技术需求方面面临挑战。因此,一种名为 Zero-ETL 的新型数据管理架构应运而生,以尽量减少甚至消除对 ETL 流程的依赖。
什么是 Zero-ETL?
Zero-ETL 是一套集成机制,旨在消除或减少构建ETL 数据管道的需求。通过在不物理移动数据的情况下跨不同数据孤岛执行查询,Zero-ETL 旨在简化数据处理并提升效率。
“Zero-ETL”一词首次出现在 2022 年的 AWS re:Invent 大会上,当时宣布了 Amazon Aurora 与Amazon Redshift 的集成。自那以后,AWS 主要通过在数据平台内直接支持数据分析与转换的服务推动了这一理念,无需独立的 ETL 管道。
在典型的 ETL 数据处理管道中,数据专业人士(如数据工程师或数据科学家)会从某个数据源(如数据库、API、JSON 或 XML 文件)收集数据。
在抽取数据后,会应用多种转换,例如合并数据、执行计算、合并表,或移除诸如时间戳或用户 ID 等不必要信息。
最后,将转换后的数据加载到某个平台进行进一步分析,例如机器学习、统计分析或数据可视化。由于流程复杂,这一过程往往需要大量时间、成本与投入。
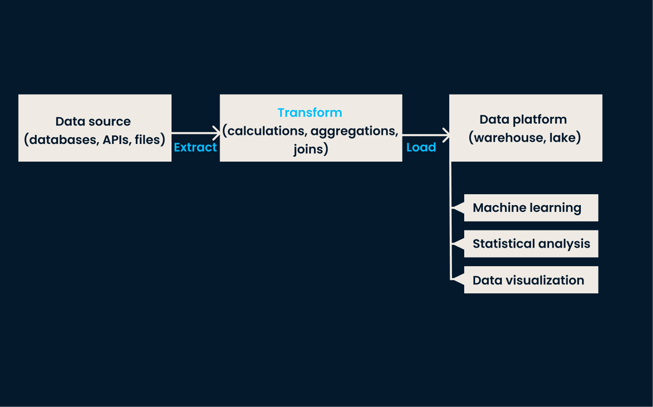
传统 ETL 架构
可以这样打个比方:在传统摄影中,先用底片记录影像(数据抽取),再在暗房冲洗(转换),最后显影并展示(加载)。而数码相机则是在同一处完成拍摄、显影与展示(甚至可在直播中即时传输)。
同理,Zero-ETL 通过消除抽取、转换与加载三个环节来改变数据处理方式。该架构最大限度减少数据移动,使我们能够在单一平台内完成所有数据的转换与分析。
Zero-ETL 为数据科学家和业务相关方带来实时或最低延迟的数据分析能力。
Zero-ETL 如何运作?
Zero-ETL 通过将数据源直接连接到数据仓库或数据湖来简化数据集成,确保分析与报表所需的数据能够实时可用。这得益于多种云端技术与服务,例如:
数据库复制
数据库复制是将数据从一个数据库复制并同步到另一个数据库的过程。
在数据库与数据仓库之间的 Zero-ETL 场景中,复制可确保数据仓库中的数据实时或准实时自动更新,从而无需单独的 ETL 流程。Amazon Aurora 与 Amazon Redshift 的集成就是这种做法的一个例子。
联邦查询
联邦查询是指能够跨多个数据源(如数据库、数据仓库或数据湖)运行查询,而无需将数据移动或复制到单一位置。
在 Zero-ETL 语境中,联邦查询允许数据专业人士直接访问并分析存储在不同数据平台上的数据,无需传统 ETL 的开销即可获得统一视图。
数据流处理
数据流处理是指对数据在生成过程中进行持续的实时处理与传输。
在 Zero-ETL 中,数据流处理会从多个来源(如数据库、物联网设备或应用)捕获数据,并即时将其投递到数据仓库或数据湖。这样可确保数据几乎即时可供分析与查询,无需批处理式的 ETL 流程。
就地数据分析
为实现就地数据分析,需要将必要的转换能力集成进云端数据平台(如数据湖)。这种集成使得数据可以在其所在位置被实时处理与分析,从而降低延迟并提升效率。
例如,以 JSON 或 XML 格式收集的非结构化数据会利用数据湖内部的“读时模式(schema-on-read)”技术进行转换与分析,从而无需将数据中转至可报表的存储位置。
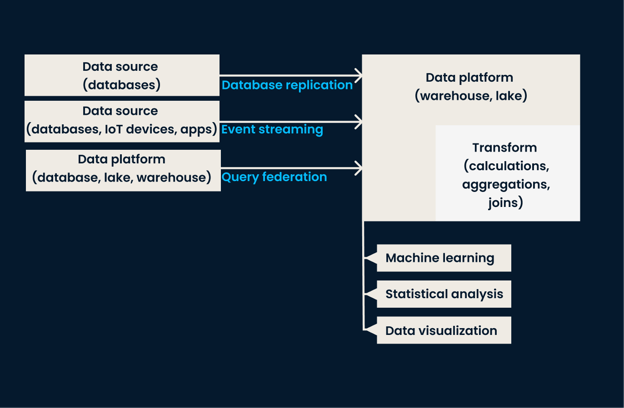
Zero-ETL 数据架构示例
Zero-ETL 的组成部分
虽然 Zero-ETL 架构听起来似乎没有组件或所有组件都已统一,但仍可根据目标分析与资源需求采用不同的要素与服务。这些服务包括:
直接数据集成服务
云服务商提供可自动化 Zero-ETL 集成的专业服务。如前所述,AWS 提供了 Amazon Aurora 与 Amazon Redshift 的集成,写入 Aurora 的数据会自动复制到 Redshift。这些服务在内部管理数据复制与转换,无需传统 ETL 流程。
变更数据捕获(CDC)
CDC 技术是 Zero-ETL 架构的核心要素。它持续监控并捕获源数据库中的变更(插入、更新、删除),并将这些变更实时复制到目标系统。
流式数据管道
流式管道可将来自不同来源的数据实时传送到目标系统。诸如Amazon Kinesis 与Apache Kafka 等平台可实现持续数据流,确保低延迟更新。
无服务器计算
无服务器架构通过自动管理所需基础设施并按需扩缩资源来支持 Zero-ETL。诸如AWS Lambda 与 Google Cloud Functions 等服务体现了这种方式,能够在数据事件发生时触发执行函数。
读时模式(Schema-on-read)技术
通过在读取数据时而非写入时应用模式,读时模式可灵活处理 JSON 与 XML 等非结构化与半结构化数据格式。这种方式减少了对预定义模式的需求,支持动态的数据分析。
数据联邦与抽象
Zero-ETL 通过数据联邦来促进来自不同源的数据摄取与复制。这涉及使用数据湖与跨平台的数据虚拟化来创建抽象对象层,从而在无需大量转换与数据移动的情况下简化数据复制。数据虚拟化允许用户像在单一位置一样访问和查询跨不同系统的数据。
数据湖
在 Zero-ETL 方法中,转换与分析在数据平台内部完成。这样便能在多格式的数据存储系统(如数据湖)中管理多种非结构化数据(视频、图像、文本与数值),且往往无需中间转换。
Zero-ETL 的优缺点
Zero-ETL 似乎是提升数据科学效率的有前景方法。然而,比较 Zero-ETL 带来的优势与劣势同样重要。
Zero-ETL 的优势
Zero-ETL 为数据管理与数据分析带来多项益处,包括:
- 工程流程更精简:Zero-ETL 通过将抽取、转换与加载整合为单一流程,或彻底省略,从而简化数据管道架构。这种精简降低了复杂度,加速数据分析与机器学习任务,有助于数据科学家更快获得洞见。
- 实时分析:Zero-ETL 将抽取、转换与加载环节直接并入数据平台,从而实现实时数据分析。新数据一经采集即可立即分析,支持更快速的决策与及时的洞见。
Zero-ETL 的劣势
尽管具备优势,Zero-ETL 也可能带来一些挑战,包括:
- 排错更复杂:由于所有数据处理都在一个集成步骤中完成,定位与排查问题可能更困难。隔离问题根源需要对整个系统有深刻理解。
- 学习曲线更陡:消除传统 ETL 管道可能减少对中间层数据工程角色的需求。这种转变会使数据科学家与机器学习工程师面临更陡峭的学习曲线,因为他们需要接手此前由数据工程师负责的任务。
- 对云的依赖:Zero-ETL 方案通常以云为中心设计。尚未准备好将云技术纳入体系的组织在采纳 Zero-ETL 时可能面临挑战。这种依赖也可能引发关于数据安全、合规与控制的担忧。
Zero-ETL 的典型用例
Zero-ETL 在多种实时数据处理与分析场景中具备显著优势。以下为一些典型用例:
- 实时分析:Zero-ETL 消除了传统的批处理式 ETL 流程,使对新生成的数据(包括客户交互、用户行为与车辆交通模式)的实时访问成为可能。该自动化让团队能够即时做出数据驱动决策,提升响应速度与运营效率。
- 即时数据传输:在 Zero-ETL 的数据管理架构中,消除 ETL 管道意味着复制到另一个仓库以供数据科学家访问的过程会显著加速,甚至可实时完成。
- 机器学习与人工智能:Zero-ETL 尤其有利于机器学习与人工智能应用,其中时效性至关重要。实时数据流与即时可用性支持以最新数据持续训练与更新模型,从而提高 AI 预测与洞见的准确性与相关性。
Zero-ETL 与传统 ETL 的比较
下表提供了 Zero-ETL 与传统 ETL 流程的详细比较。
|
|
Zero-ETL
|
传统 ETL
|
|
数据虚拟化
|
使用数据虚拟化技术来简化跨数据仓库的数据复制。
|
由于 ETL 中数据会从转换阶段移至加载阶段,数据虚拟化可能显得多余或实现有难度。
|
|
数据质量监控
|
本质上是一种自动化数据管理方法,因此可能出现数据质量问题。
|
由于 ETL 的数据移动管道是离散的,数据质量更易被监控并加以修复。
|
|
数据类型多样性
|
基于云的数据湖在架构上不受限制,可支持多种数据类型与格式。
|
抽取与转换架构可能限制数据类型(不同类型数据在抽取与转换阶段需要额外工程投入)。
|
|
实时部署
|
可在平台内完成数据分析,从数据生成到转换与分析的延迟极低。
|
管道的定时批处理特性阻碍了实时数据分析。
|
|
成本与维护
|
由于所需计算组件与编码更少,因而更具成本效益且更易维护。数据转换与加载可按需完成。
|
由于需要更多计算资源与经验丰富的数据专业人士,成本更高。
|
|
扩展性
|
由于消除了用于数据移动的中间硬件,扩展更快且成本更低。
|
由于需要更强的硬件与代码优化以容纳更大规模的数据源,扩展可能缓慢且昂贵。
|
|
数据移动
|
无或极少。
|
由于管道是离散的,数据必须传送到加载阶段,因此需要数据移动。
|
Zero-ETL 与其他数据集成技术
以下比较了 Zero-ETL 与其他主要数据集成技术,突出其共性与核心差异。
Zero-ETL 与 ELT
- 共性:Zero-ETL 与ELT(抽取、加载、转换)通过将数据转换过程推迟到数据加载至目标系统之后,来减少数据分析时间与复杂性。ELT 被视为 Zero-ETL 的前身,因为它为将转换延后至数据处理管道的后期奠定了基础。
- 主要差异:Zero-ETL 消除了 ELT 方法中所需的中间暂存阶段,从而将延迟降至最低并提升实时数据可用性。Zero-ETL 通过减少步骤与基础设施需求,使数据管道进一步简化。
Zero-ETL 与 API
- 共性:Zero-ETL 与 API 均可对多个数据源执行查询,促进跨系统的数据集成。
- 主要差异:Zero-ETL 主要是一种“无代码”技术,在数据集成与管理中几乎无需手动编码。相较之下,API 需要自定义代码来连接并与不同数据源交互。此外,由于基于代码的集成方式,API 更容易出现安全漏洞;若未妥善管理与加固,可能引入脆弱点。
主流 Zero-ETL 工具
正如本文所述,Zero-ETL 是一种前沿的数据管理工具,在业界获得了广泛关注,主要由AWS 推广,并被其他云服务商采纳。
以下是当下主流 Zero-ETL 工具的简要概览:
AWS 的 Zero-ETL 工具
- Aurora 与 Redshift 的直接集成:AWS 集成了 Amazon Aurora 与 Amazon Redshift,从而在无需传统 ETL 流程的情况下实现实时分析。
- Redshift Spectrum:允许用户对Amazon S3 中的 EB 级数据运行 SQL 查询,而无需加载或转换数据。该服务支持对结构化与非结构化数据的无缝查询,适用于多样化数据集。
- Amazon Athena:一款无服务器分析方案,使用 SQL 或 Python 连接云端流数据,执行就地分析(包括机器学习与 AI)并处理海量数据。
- Amazon Redshift Streaming Ingestion:从 Amazon Kinesis Data Streams 或 Amazon MSK 实现实时数据摄取的服务,支持高强度的实时机器学习任务。
其他云服务商的 Zero-ETL 工具
除 AWS 外,其他云服务商也提供具备 Zero-ETL 能力的一体化数据平台:
- Snowflake:支持基于 Zero-ETL 架构构建可处理非结构化数据的数据仓库与数据湖。Snowflake 简化数据工作流,支持实时分析与机器学习。
- Google BigQuery:可在大型数据集上实时执行复杂 SQL 查询,并与其他 Google Cloud 服务无缝集成以支持实时分析。BigQuery 专为高效处理海量数据而设计。
- Microsoft Azure Synapse Analytics:提供一体化分析平台,实现实时数据摄取与分析,支持高级分析与商业智能应用。Synapse 可与多种Azure 服务集成。
结语
在数据分析与机器学习管道中消除传统 ETL 阶段,标志着数据工程范式的重大转变。引入 Zero-ETL 架构可带来显著收益,包括更高速度、增强安全性与更强可扩展性。
但这种转变也带来挑战。对传统数据工程技能的需求可能降低,要求数据分析师、机器学习研究员与数据科学家掌握更高级的数据集成理念与技能。
Zero-ETL 聚焦于数据分析师与机器学习工程师的需求,预示着这些角色将更为核心,进而可能重塑就业市场的需求与技能结构。
若您希望进一步了解数据架构,请查看我们的课程:用 Python 实现 ETL 与 ELT!


在现代企业中,人们越来越需要缩短产出数据洞见的时间。为了加速从数据采集到分析、人工智能与机器学习落地的全过程,需要一种更快速的方法。
传统的 ETL(抽取、转换、加载)架构在满足大数据与实时数据分析的技术需求方面面临挑战。因此,一种名为 Zero-ETL 的新型数据管理架构应运而生,以尽量减少甚至消除对 ETL 流程的依赖。
什么是 Zero-ETL?
Zero-ETL 是一套集成机制,旨在消除或减少构建ETL 数据管道的需求。通过在不物理移动数据的情况下跨不同数据孤岛执行查询,Zero-ETL 旨在简化数据处理并提升效率。
“Zero-ETL”一词首次出现在 2022 年的 AWS re:Invent 大会上,当时宣布了 Amazon Aurora 与Amazon Redshift 的集成。自那以后,AWS 主要通过在数据平台内直接支持数据分析与转换的服务推动了这一理念,无需独立的 ETL 管道。
在典型的 ETL 数据处理管道中,数据专业人士(如数据工程师或数据科学家)会从某个数据源(如数据库、API、JSON 或 XML 文件)收集数据。
在抽取数据后,会应用多种转换,例如合并数据、执行计算、合并表,或移除诸如时间戳或用户 ID 等不必要信息。
最后,将转换后的数据加载到某个平台进行进一步分析,例如机器学习、统计分析或数据可视化。由于流程复杂,这一过程往往需要大量时间、成本与投入。
传统 ETL 架构
可以这样打个比方:在传统摄影中,先用底片记录影像(数据抽取),再在暗房冲洗(转换),最后显影并展示(加载)。而数码相机则是在同一处完成拍摄、显影与展示(甚至可在直播中即时传输)。
同理,Zero-ETL 通过消除抽取、转换与加载三个环节来改变数据处理方式。该架构最大限度减少数据移动,使我们能够在单一平台内完成所有数据的转换与分析。
Zero-ETL 为数据科学家和业务相关方带来实时或最低延迟的数据分析能力。
Zero-ETL 如何运作?
Zero-ETL 通过将数据源直接连接到数据仓库或数据湖来简化数据集成,确保分析与报表所需的数据能够实时可用。这得益于多种云端技术与服务,例如:
数据库复制
数据库复制是将数据从一个数据库复制并同步到另一个数据库的过程。
在数据库与数据仓库之间的 Zero-ETL 场景中,复制可确保数据仓库中的数据实时或准实时自动更新,从而无需单独的 ETL 流程。Amazon Aurora 与 Amazon Redshift 的集成就是这种做法的一个例子。
联邦查询
联邦查询是指能够跨多个数据源(如数据库、数据仓库或数据湖)运行查询,而无需将数据移动或复制到单一位置。
在 Zero-ETL 语境中,联邦查询允许数据专业人士直接访问并分析存储在不同数据平台上的数据,无需传统 ETL 的开销即可获得统一视图。
数据流处理
数据流处理是指对数据在生成过程中进行持续的实时处理与传输。
在 Zero-ETL 中,数据流处理会从多个来源(如数据库、物联网设备或应用)捕获数据,并即时将其投递到数据仓库或数据湖。这样可确保数据几乎即时可供分析与查询,无需批处理式的 ETL 流程。
就地数据分析
为实现就地数据分析,需要将必要的转换能力集成进云端数据平台(如数据湖)。这种集成使得数据可以在其所在位置被实时处理与分析,从而降低延迟并提升效率。
例如,以 JSON 或 XML 格式收集的非结构化数据会利用数据湖内部的“读时模式(schema-on-read)”技术进行转换与分析,从而无需将数据中转至可报表的存储位置。
Zero-ETL 数据架构示例
Zero-ETL 的组成部分
虽然 Zero-ETL 架构听起来似乎没有组件或所有组件都已统一,但仍可根据目标分析与资源需求采用不同的要素与服务。这些服务包括:
直接数据集成服务
云服务商提供可自动化 Zero-ETL 集成的专业服务。如前所述,AWS 提供了 Amazon Aurora 与 Amazon Redshift 的集成,写入 Aurora 的数据会自动复制到 Redshift。这些服务在内部管理数据复制与转换,无需传统 ETL 流程。
变更数据捕获(CDC)
CDC 技术是 Zero-ETL 架构的核心要素。它持续监控并捕获源数据库中的变更(插入、更新、删除),并将这些变更实时复制到目标系统。
流式数据管道
流式管道可将来自不同来源的数据实时传送到目标系统。诸如Amazon Kinesis 与Apache Kafka 等平台可实现持续数据流,确保低延迟更新。
无服务器计算
无服务器架构通过自动管理所需基础设施并按需扩缩资源来支持 Zero-ETL。诸如AWS Lambda 与 Google Cloud Functions 等服务体现了这种方式,能够在数据事件发生时触发执行函数。
读时模式(Schema-on-read)技术
通过在读取数据时而非写入时应用模式,读时模式可灵活处理 JSON 与 XML 等非结构化与半结构化数据格式。这种方式减少了对预定义模式的需求,支持动态的数据分析。
数据联邦与抽象
Zero-ETL 通过数据联邦来促进来自不同源的数据摄取与复制。这涉及使用数据湖与跨平台的数据虚拟化来创建抽象对象层,从而在无需大量转换与数据移动的情况下简化数据复制。数据虚拟化允许用户像在单一位置一样访问和查询跨不同系统的数据。
数据湖
在 Zero-ETL 方法中,转换与分析在数据平台内部完成。这样便能在多格式的数据存储系统(如数据湖)中管理多种非结构化数据(视频、图像、文本与数值),且往往无需中间转换。
Zero-ETL 的优缺点
Zero-ETL 似乎是提升数据科学效率的有前景方法。然而,比较 Zero-ETL 带来的优势与劣势同样重要。
Zero-ETL 的优势
Zero-ETL 为数据管理与数据分析带来多项益处,包括:
Zero-ETL 的劣势
尽管具备优势,Zero-ETL 也可能带来一些挑战,包括:
Zero-ETL 的典型用例
Zero-ETL 在多种实时数据处理与分析场景中具备显著优势。以下为一些典型用例:
Zero-ETL 与传统 ETL 的比较
下表提供了 Zero-ETL 与传统 ETL 流程的详细比较。
Zero-ETL
传统 ETL
数据虚拟化
使用数据虚拟化技术来简化跨数据仓库的数据复制。
由于 ETL 中数据会从转换阶段移至加载阶段,数据虚拟化可能显得多余或实现有难度。
数据质量监控
本质上是一种自动化数据管理方法,因此可能出现数据质量问题。
由于 ETL 的数据移动管道是离散的,数据质量更易被监控并加以修复。
数据类型多样性
基于云的数据湖在架构上不受限制,可支持多种数据类型与格式。
抽取与转换架构可能限制数据类型(不同类型数据在抽取与转换阶段需要额外工程投入)。
实时部署
可在平台内完成数据分析,从数据生成到转换与分析的延迟极低。
管道的定时批处理特性阻碍了实时数据分析。
成本与维护
由于所需计算组件与编码更少,因而更具成本效益且更易维护。数据转换与加载可按需完成。
由于需要更多计算资源与经验丰富的数据专业人士,成本更高。
扩展性
由于消除了用于数据移动的中间硬件,扩展更快且成本更低。
由于需要更强的硬件与代码优化以容纳更大规模的数据源,扩展可能缓慢且昂贵。
数据移动
无或极少。
由于管道是离散的,数据必须传送到加载阶段,因此需要数据移动。
Zero-ETL 与其他数据集成技术
以下比较了 Zero-ETL 与其他主要数据集成技术,突出其共性与核心差异。
Zero-ETL 与 ELT
Zero-ETL 与 API
主流 Zero-ETL 工具
正如本文所述,Zero-ETL 是一种前沿的数据管理工具,在业界获得了广泛关注,主要由AWS 推广,并被其他云服务商采纳。
以下是当下主流 Zero-ETL 工具的简要概览:
AWS 的 Zero-ETL 工具
其他云服务商的 Zero-ETL 工具
除 AWS 外,其他云服务商也提供具备 Zero-ETL 能力的一体化数据平台:
结语
在数据分析与机器学习管道中消除传统 ETL 阶段,标志着数据工程范式的重大转变。引入 Zero-ETL 架构可带来显著收益,包括更高速度、增强安全性与更强可扩展性。
但这种转变也带来挑战。对传统数据工程技能的需求可能降低,要求数据分析师、机器学习研究员与数据科学家掌握更高级的数据集成理念与技能。
Zero-ETL 聚焦于数据分析师与机器学习工程师的需求,预示着这些角色将更为核心,进而可能重塑就业市场的需求与技能结构。
若您希望进一步了解数据架构,请查看我们的课程:用 Python 实现 ETL 与 ELT!