Dalam dunia bisnis modern, kebutuhan untuk meminimalkan waktu penyajian wawasan data semakin meningkat. Diperlukan pendekatan cepat untuk mempercepat transisi dari pengumpulan data ke analitik, kecerdasan buatan, dan penerapan pembelajaran mesin.
Arsitektur ETL (extract, transform, load) tradisional menghadapi tantangan untuk memenuhi tuntutan teknis big data dan analisis data real-time. Karena itu, muncul arsitektur manajemen data baru bernama zero-ETL untuk meminimalkan atau menghilangkan kebutuhan proses ETL.
Apa itu Zero-ETL?
Zero-ETL adalah sistem integrasi yang dirancang untuk menghilangkan atau mengurangi kebutuhan membangun pipeline data ETL. Dengan memungkinkan kueri lintas silo data berbeda tanpa perlu memindahkan data secara fisik, zero-ETL bertujuan merampingkan pemrosesan data dan meningkatkan efisiensi.
Istilah “zero-ETL” diperkenalkan pada konferensi AWS re:Invent tahun 2022, saat diumumkannya integrasi Amazon Aurora dengan Amazon Redshift. Sejak itu, AWS mengembangkan konsep ini, terutama melalui layanan yang mendukung analisis dan transformasi data langsung di dalam platform data tanpa memerlukan pipeline ETL terpisah.
Dalam pipeline pemrosesan data ETL yang umum, seorang profesional data, seperti data engineer atau data scientist, mengumpulkan data dari sumber seperti basis data, API, file JSON, atau XML.
Setelah mengekstrak data, berbagai transformasi diterapkan, seperti menggabungkan data, melakukan perhitungan, menggabungkan tabel, atau menghapus informasi yang tidak diperlukan seperti timestamp atau ID pengguna.
Terakhir, data yang telah ditransformasi dimuat ke sebuah platform untuk analisis lebih lanjut, seperti pembelajaran mesin, analisis statistik, atau visualisasi data. Proses ini menuntut waktu, biaya, dan upaya yang signifikan karena kompleksitasnya.
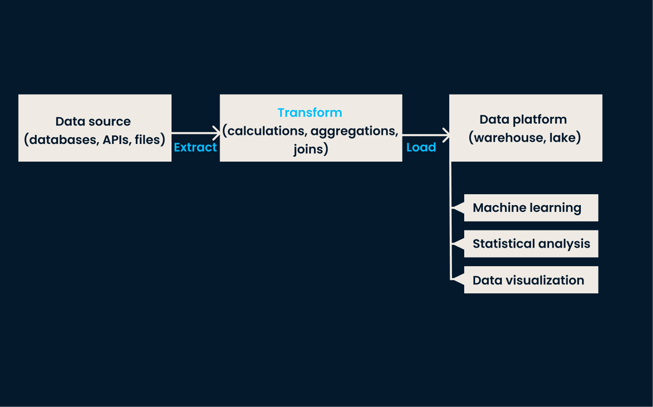
Arsitektur ETL tradisional
Pertimbangkan analogi ini: Dalam fotografi tradisional, gambar diambil dengan film negatif (ekstraksi data), diproses di kamar gelap (transformasi), lalu dicetak dan ditampilkan (pemuatan). Kini, bayangkan kamera digital di mana gambar diambil, diproses, dan siap ditampilkan (atau langsung ditransmisikan dalam siaran langsung) semuanya di satu tempat.
Serupa dengan itu, zero-ETL mengubah pemrosesan data dengan menghilangkan ekstraksi, transformasi, dan pemuatan. Arsitektur ini meminimalkan perpindahan data dan memungkinkan kita mentransformasikan serta menganalisis seluruh data dalam satu platform.
Zero-ETL menjanjikan analitik data real-time atau dengan latensi minimum bagi data scientist dan pemangku kepentingan bisnis.
Bagaimana Zero-ETL Bekerja?
Zero-ETL menyederhanakan integrasi data dengan menghubungkan langsung sumber data ke gudang atau danau data, sehingga memastikan ketersediaan data real-time untuk analitik dan pelaporan. Ini dimungkinkan oleh sejumlah teknologi dan layanan berbasis cloud, seperti:
Replikasi basis data
Replikasi basis data adalah proses menyalin dan menyinkronkan data dari satu basis data ke basis data lain.
Dalam konteks zero-ETL antara basis data dan gudang data, replikasi memastikan bahwa data di gudang data diperbarui secara otomatis secara real-time atau mendekati real-time, sehingga menghilangkan kebutuhan proses ETL terpisah. Ini terjadi pada integrasi antara Amazon Aurora dan Amazon Redshift.
Federated querying
Federated querying mengacu pada kemampuan menjalankan kueri di berbagai sumber data, seperti basis data, gudang data, atau danau data, tanpa perlu memindahkan atau mereplikasi data ke satu lokasi.
Terkait zero-ETL, federated querying memungkinkan profesional data mengakses dan menganalisis data yang tersimpan di berbagai platform data secara langsung, sehingga memberikan pandangan terpadu atas data tanpa beban proses ETL tradisional.
Streaming data
Streaming data mengacu pada pemrosesan dan transfer data secara berkelanjutan dan real-time saat data dihasilkan.
Dalam zero-ETL, streaming data melibatkan penangkapan data dari berbagai sumber (seperti basis data, perangkat IoT, atau aplikasi) dan segera mengirimkannya ke gudang data atau danau data. Ini memastikan data hampir seketika siap untuk dianalisis dan di-kueri, tanpa proses ETL batch.
Analitik data in-place
Untuk mencapai analitik data in-place, transformasi yang diperlukan diintegrasikan ke dalam platform data cloud, seperti danau data. Integrasi ini memungkinkan pemrosesan dan analisis data secara real-time langsung di lokasi data berada, sehingga mengurangi latensi dan meningkatkan efisiensi.
Sebagai contoh, data tidak terstruktur yang dikumpulkan dalam format JSON atau XML akan ditransformasikan dan dianalisis menggunakan teknologi “schema-on-read” di dalam danau data itu sendiri, sehingga menghilangkan langkah perantara perpindahan data ke penyimpanan yang siap pelaporan.
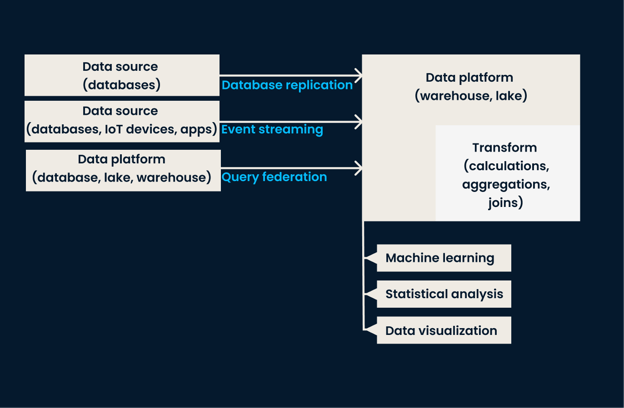
Contoh arsitektur data Zero-ETL
Komponen-Komponen Zero-ETL
Meskipun arsitektur zero-ETL terdengar seolah tidak memiliki komponen atau semua komponen disatukan, berbagai elemen dan layanan dapat digunakan tergantung kebutuhan analitik dan sumber daya target. Layanan tersebut meliputi:
Layanan integrasi data langsung
Penyedia cloud menawarkan layanan khusus yang mengotomatiskan integrasi zero-ETL. Seperti disebutkan sebelumnya, AWS menyediakan integrasi Amazon Aurora dengan Amazon Redshift, di mana data yang ditulis ke Aurora secara otomatis direplikasi ke Redshift. Layanan ini mengelola replikasi dan transformasi data secara internal, menghilangkan kebutuhan proses ETL tradisional.
Change Data Capture (CDC)
Teknologi CDC adalah elemen inti arsitektur zero-ETL. Teknologi ini terus memantau dan menangkap perubahan (insert, update, delete) di basis data sumber dan mereplikasi perubahan tersebut secara real-time ke sistem target.
Streaming data pipelines
Pipeline streaming memindahkan data secara real-time dari berbagai sumber ke sistem target. Platform seperti Amazon Kinesis dan Apache Kafka memungkinkan aliran data berkelanjutan, memastikan pembaruan berlatensi rendah.
Komputasi tanpa server (serverless)
Arsitektur serverless mendukung zero-ETL dengan secara otomatis mengelola infrastruktur yang diperlukan dan menyesuaikan skala sumber daya berdasarkan permintaan. Layanan seperti AWS Lambda dan Google Cloud Functions mencontohkan pendekatan ini dengan memungkinkan fungsi dieksekusi sebagai respons terhadap peristiwa data.
Teknologi schema-on-read
Dengan menerapkan skema saat membaca data alih-alih saat ditulis, schema-on-read mendukung fleksibilitas dalam menangani format data tidak terstruktur dan semi-terstruktur seperti JSON dan XML. Pendekatan ini mengurangi kebutuhan skema yang telah ditentukan dan memungkinkan analisis data secara dinamis.
Federasi dan abstraksi data
Zero-ETL memfasilitasi pemasukan dan duplikasi data dari berbagai sumber melalui federasi data. Ini melibatkan penggunaan danau data dan virtualisasi data lintas platform untuk menciptakan lapisan objek abstrak, menyederhanakan duplikasi data tanpa memerlukan transformasi dan perpindahan data yang ekstensif. Virtualisasi data memungkinkan pengguna mengakses dan menjalankan kueri atas data di berbagai sistem seolah-olah berada di satu lokasi.
Danau data
Dalam pendekatan zero-ETL, transformasi dan analisis dilakukan di dalam platform data. Ini memungkinkan pengelolaan data tidak terstruktur dalam berbagai format (video, gambar, teks, dan numerik) di dalam sistem penyimpanan data multi-format, seperti danau data, sering kali tanpa perlu transformasi perantara.
Kelebihan dan Kekurangan Zero-ETL
Zero-ETL mungkin terdengar menjanjikan untuk meningkatkan efisiensi dalam data science. Namun, penting untuk membandingkan baik kelebihan maupun kekurangan yang mungkin muncul dari penerapan zero-ETL.
Kelebihan zero-ETL
Zero-ETL membawa beberapa manfaat bagi manajemen data dan analitik data, termasuk:
- Rekayasa lebih ringkas: Zero-ETL menyederhanakan arsitektur pipeline data dengan mengintegrasikan ekstraksi, transformasi, dan pemuatan ke satu proses atau menghilangkannya sama sekali. Perampingan ini mengurangi kompleksitas dan mempercepat tugas analitik data dan pembelajaran mesin, sehingga memudahkan data scientist memperoleh wawasan dengan cepat.
- Analitik real-time: Zero-ETL memungkinkan analitik data real-time dengan menggabungkan fase ekstraksi, transformasi, dan pemuatan langsung ke dalam platform data. Saat data baru dikumpulkan, data tersebut bisa langsung dianalisis, memungkinkan pengambilan keputusan lebih cepat dan wawasan yang tepat waktu.
Kekurangan zero-ETL
Terlepas dari manfaatnya, zero-ETL dapat menimbulkan beberapa tantangan, termasuk:
- Troubleshooting yang rumit: Mengidentifikasi dan menangani masalah bisa lebih kompleks karena semua proses data dilakukan dalam satu langkah terintegrasi. Mengisolasi sumber masalah memerlukan pemahaman mendalam atas seluruh sistem.
- Kurva pembelajaran yang lebih terjal: Menghilangkan pipeline ETL tradisional mungkin mengurangi kebutuhan peran rekayasa data tingkat menengah. Perubahan ini dapat menyebabkan kurva pembelajaran lebih terjal bagi data scientist dan machine learning engineer, yang kini harus menangani tugas yang sebelumnya dilakukan oleh data engineer.
- Ketergantungan pada cloud: Solusi zero-ETL umumnya berbasis cloud secara desain. Organisasi yang belum siap mengintegrasikan teknologi cloud ke dalam sistem mereka mungkin menghadapi tantangan dalam mengadopsi zero-ETL. Ketergantungan ini dapat menimbulkan kekhawatiran atas keamanan data, kepatuhan, dan kontrol.
Penggunaan Umum Zero-ETL
Zero-ETL menawarkan keunggulan signifikan dalam berbagai skenario pemrosesan dan analitik data real-time. Berikut beberapa kasus penggunaan tipikal:
- Analitik real-time: Zero-ETL menghilangkan proses ETL batch tradisional dan memungkinkan akses real-time ke data yang baru dihasilkan, termasuk interaksi pelanggan, perilaku pengguna, dan pola lalu lintas kendaraan. Otomatisasi ini memungkinkan tim membuat keputusan berbasis data secara instan, meningkatkan responsivitas dan efisiensi operasional.
- Transfer data instan: Dalam arsitektur manajemen data zero-ETL, penghapusan pipeline ETL berarti duplikasi data ke gudang lain, tempat data scientist mengaksesnya, terjadi jauh lebih cepat atau bahkan secara real-time.
- Machine learning dan AI: Zero-ETL sangat bermanfaat untuk aplikasi pembelajaran mesin dan kecerdasan buatan, di mana ketepatan waktu data sangat penting. Streaming data real-time dan ketersediaan instan memungkinkan pelatihan dan pembaruan model pembelajaran mesin secara berkelanjutan dengan data terbaru, meningkatkan akurasi dan relevansi prediksi serta wawasan AI.
Perbandingan Zero-ETL vs ETL Tradisional
Tabel berikut memberikan perbandingan mendetail antara Zero-ETL dan proses ETL tradisional.
|
|
Zero-ETL
|
ETL Tradisional
|
|
Virtualisasi data
|
Menggunakan teknologi virtualisasi data untuk mempermudah duplikasi data antar gudang.
|
Virtualisasi data bisa menjadi berlebihan atau menantang untuk diterapkan karena dalam ETL data dipindahkan dari fase transformasi ke fase pemuatan.
|
|
Pemantauan kualitas data
|
Pada dasarnya merupakan pendekatan manajemen data otomatis; oleh karena itu, masalah kualitas data dapat muncul.
|
Karena sifat pipeline perpindahan data yang diskret dalam ETL, kualitas data lebih mudah dipantau dan diperbaiki.
|
|
Keberagaman tipe data
|
Danau data berbasis cloud memungkinkan berbagai tipe dan format data tanpa kendala arsitektur.
|
Arsitektur ekstraksi dan transformasi dapat membatasi tipe data (diperlukan upaya rekayasa tambahan pada fase ekstraksi dan transformasi untuk berbagai jenis data).
|
|
Penerapan real-time
|
Analisis data dapat dilakukan di dalam platform dengan latensi minimal dari pembuatan data hingga transformasi dan analisis.
|
Sifat pipeline yang dijadwalkan secara batch menghambat analisis data real-time.
|
|
Biaya dan pemeliharaan
|
Lebih hemat biaya dan lebih mudah dipelihara karena memerlukan lebih sedikit komponen komputasi dan pengkodean. Transformasi dan pemuatan data dapat dilakukan sesuai kebutuhan.
|
Lebih mahal karena memerlukan lebih banyak sumber daya komputasi dan profesional data berpengalaman.
|
|
Skalabilitas
|
Lebih cepat dan lebih murah untuk diskalakan karena menghilangkan perangkat keras perantara untuk perpindahan data.
|
Dapat lambat dan mahal karena meningkatnya kebutuhan perangkat keras yang lebih baik dan optimasi kode untuk menampung sumber data yang lebih luas.
|
|
Perpindahan data
|
Tidak ada atau minimal.
|
Perpindahan data diperlukan karena pipeline bersifat diskret dan data harus dipindahkan ke tahap pemuatan.
|
Zero-ETL vs Teknik Integrasi Data Lainnya
Di bawah ini adalah perbandingan zero-ETL dengan teknik integrasi data terkemuka lainnya, menyoroti kesamaan dan perbedaan utamanya.
Zero-ETL vs ELT
- Kesamaan: Zero-ETL dan ELT (Extract, Load, Transform) mengurangi waktu dan kompleksitas analitik data dengan menunda proses transformasi data hingga data dimuat ke sistem target. ELT dianggap sebagai pendahulu zero-ETL, karena meletakkan dasar untuk menunda transformasi ke tahap selanjutnya dalam pipeline pemrosesan data.
- Perbedaan utama: Zero-ETL menghilangkan fase staging perantara yang diperlukan dalam pendekatan ELT, sehingga meminimalkan latensi dan meningkatkan ketersediaan data real-time. Zero-ETL semakin menyederhanakan pipeline data dengan mengurangi jumlah langkah dan kebutuhan infrastruktur.
Zero-ETL vs API
- Kesamaan: Zero-ETL dan API memungkinkan kueri ke banyak sumber data, memfasilitasi integrasi data lintas sistem yang berbeda.
- Perbedaan utama: Zero-ETL pada dasarnya adalah teknologi tanpa kode yang memerlukan pengkodean manual minimal untuk integrasi dan manajemen data. Sebaliknya, API memerlukan kode kustom untuk menghubungkan dan berinteraksi dengan berbagai sumber data. Selain itu, API bisa lebih rentan terhadap pelanggaran keamanan karena sifat integrasi berbasis kode, yang dapat menimbulkan kerentanan jika tidak dikelola dan diamankan dengan baik.
Perangkat Zero-ETL Teratas
Seperti yang telah kita lihat sepanjang artikel ini, zero-ETL adalah alat manajemen data mutakhir yang semakin populer di industri, banyak dipopulerkan oleh AWS dan diadopsi oleh penyedia cloud lainnya.
Berikut gambaran singkat perangkat zero-ETL teratas yang tersedia saat ini:
Perangkat zero-ETL dari AWS
- Integrasi langsung Aurora dan Redshift: AWS telah mengintegrasikan Amazon Aurora dan Amazon Redshift untuk memungkinkan analitik real-time tanpa perlu proses ETL tradisional.
- Redshift Spectrum: Memungkinkan pengguna menjalankan kueri SQL terhadap eksabita data di Amazon S3 tanpa memuat atau mentransformasikan data. Layanan ini mendukung kueri mulus atas data terstruktur dan tidak terstruktur, sehingga ideal untuk set data yang beragam.
- Amazon Athena: Solusi analitik serverless yang memproses volume data besar untuk analitik in-place, termasuk pembelajaran mesin dan AI, menggunakan SQL atau Python untuk menghubungkan streaming data dari layanan cloud.
- Amazon Redshift Streaming Ingestion: Layanan yang menyediakan pemasukan data real-time dari Amazon Kinesis Data Streams atau Amazon MSK, mendukung tugas pembelajaran mesin real-time yang intensif.
Perangkat Zero-ETL dari penyedia cloud lain
Selain AWS, penyedia cloud lain menawarkan platform data terpadu dengan kapabilitas zero-ETL:
- Snowflake: Mendukung pembuatan gudang dan danau data yang mampu menangani data tidak terstruktur menggunakan arsitektur zero-ETL. Snowflake menyederhanakan alur kerja data dan mendukung analitik real-time serta pembelajaran mesin.
- Google BigQuery: Menjalankan kueri SQL kompleks pada set data besar secara real-time, mendukung integrasi mulus dengan layanan Google Cloud lainnya untuk analitik real-time. BigQuery dirancang untuk menangani data dalam jumlah sangat besar secara efisien.
- Microsoft Azure Synapse Analytics: Menyediakan pemasukan dan analisis data real-time dengan platform analitik terpadu, mendukung analitik lanjutan dan aplikasi business intelligence. Synapse terintegrasi dengan berbagai layanan Azure.
Kesimpulan
Menghilangkan fase ETL tradisional dalam pipeline analitik data dan pembelajaran mesin secara signifikan menggeser paradigma rekayasa data. Mengintegrasikan arsitektur zero-ETL menawarkan manfaat substansial, termasuk peningkatan kecepatan, keamanan yang lebih baik, dan skalabilitas yang lebih tinggi.
Namun, pergeseran ini juga membawa tantangan. Kebutuhan akan keterampilan rekayasa data tradisional mungkin berkurang, sehingga analis data, ilmuwan pembelajaran mesin, dan data scientist perlu menguasai konsep dan keterampilan integrasi data yang lebih maju.
Zero-ETL berfokus pada kebutuhan analis data dan machine learning engineer, mengisyaratkan masa depan di mana peran-peran ini menjadi lebih sentral, yang berpotensi membentuk ulang permintaan pasar kerja dan set keterampilan.
Jika Anda tertarik mempelajari lebih lanjut tentang arsitektur data, lihat kursus kami tentang ETL dan ELT di Python!




Dalam dunia bisnis modern, kebutuhan untuk meminimalkan waktu penyajian wawasan data semakin meningkat. Diperlukan pendekatan cepat untuk mempercepat transisi dari pengumpulan data ke analitik, kecerdasan buatan, dan penerapan pembelajaran mesin.
Arsitektur ETL (extract, transform, load) tradisional menghadapi tantangan untuk memenuhi tuntutan teknis big data dan analisis data real-time. Karena itu, muncul arsitektur manajemen data baru bernama zero-ETL untuk meminimalkan atau menghilangkan kebutuhan proses ETL.
Apa itu Zero-ETL?
Zero-ETL adalah sistem integrasi yang dirancang untuk menghilangkan atau mengurangi kebutuhan membangun pipeline data ETL. Dengan memungkinkan kueri lintas silo data berbeda tanpa perlu memindahkan data secara fisik, zero-ETL bertujuan merampingkan pemrosesan data dan meningkatkan efisiensi.
Istilah “zero-ETL” diperkenalkan pada konferensi AWS re:Invent tahun 2022, saat diumumkannya integrasi Amazon Aurora dengan Amazon Redshift. Sejak itu, AWS mengembangkan konsep ini, terutama melalui layanan yang mendukung analisis dan transformasi data langsung di dalam platform data tanpa memerlukan pipeline ETL terpisah.
Dalam pipeline pemrosesan data ETL yang umum, seorang profesional data, seperti data engineer atau data scientist, mengumpulkan data dari sumber seperti basis data, API, file JSON, atau XML.
Setelah mengekstrak data, berbagai transformasi diterapkan, seperti menggabungkan data, melakukan perhitungan, menggabungkan tabel, atau menghapus informasi yang tidak diperlukan seperti timestamp atau ID pengguna.
Terakhir, data yang telah ditransformasi dimuat ke sebuah platform untuk analisis lebih lanjut, seperti pembelajaran mesin, analisis statistik, atau visualisasi data. Proses ini menuntut waktu, biaya, dan upaya yang signifikan karena kompleksitasnya.
Arsitektur ETL tradisional
Pertimbangkan analogi ini: Dalam fotografi tradisional, gambar diambil dengan film negatif (ekstraksi data), diproses di kamar gelap (transformasi), lalu dicetak dan ditampilkan (pemuatan). Kini, bayangkan kamera digital di mana gambar diambil, diproses, dan siap ditampilkan (atau langsung ditransmisikan dalam siaran langsung) semuanya di satu tempat.
Serupa dengan itu, zero-ETL mengubah pemrosesan data dengan menghilangkan ekstraksi, transformasi, dan pemuatan. Arsitektur ini meminimalkan perpindahan data dan memungkinkan kita mentransformasikan serta menganalisis seluruh data dalam satu platform.
Zero-ETL menjanjikan analitik data real-time atau dengan latensi minimum bagi data scientist dan pemangku kepentingan bisnis.
Bagaimana Zero-ETL Bekerja?
Zero-ETL menyederhanakan integrasi data dengan menghubungkan langsung sumber data ke gudang atau danau data, sehingga memastikan ketersediaan data real-time untuk analitik dan pelaporan. Ini dimungkinkan oleh sejumlah teknologi dan layanan berbasis cloud, seperti:
Replikasi basis data
Replikasi basis data adalah proses menyalin dan menyinkronkan data dari satu basis data ke basis data lain.
Dalam konteks zero-ETL antara basis data dan gudang data, replikasi memastikan bahwa data di gudang data diperbarui secara otomatis secara real-time atau mendekati real-time, sehingga menghilangkan kebutuhan proses ETL terpisah. Ini terjadi pada integrasi antara Amazon Aurora dan Amazon Redshift.
Federated querying
Federated querying mengacu pada kemampuan menjalankan kueri di berbagai sumber data, seperti basis data, gudang data, atau danau data, tanpa perlu memindahkan atau mereplikasi data ke satu lokasi.
Terkait zero-ETL, federated querying memungkinkan profesional data mengakses dan menganalisis data yang tersimpan di berbagai platform data secara langsung, sehingga memberikan pandangan terpadu atas data tanpa beban proses ETL tradisional.
Streaming data
Streaming data mengacu pada pemrosesan dan transfer data secara berkelanjutan dan real-time saat data dihasilkan.
Dalam zero-ETL, streaming data melibatkan penangkapan data dari berbagai sumber (seperti basis data, perangkat IoT, atau aplikasi) dan segera mengirimkannya ke gudang data atau danau data. Ini memastikan data hampir seketika siap untuk dianalisis dan di-kueri, tanpa proses ETL batch.
Analitik data in-place
Untuk mencapai analitik data in-place, transformasi yang diperlukan diintegrasikan ke dalam platform data cloud, seperti danau data. Integrasi ini memungkinkan pemrosesan dan analisis data secara real-time langsung di lokasi data berada, sehingga mengurangi latensi dan meningkatkan efisiensi.
Sebagai contoh, data tidak terstruktur yang dikumpulkan dalam format JSON atau XML akan ditransformasikan dan dianalisis menggunakan teknologi “schema-on-read” di dalam danau data itu sendiri, sehingga menghilangkan langkah perantara perpindahan data ke penyimpanan yang siap pelaporan.
Contoh arsitektur data Zero-ETL
Komponen-Komponen Zero-ETL
Meskipun arsitektur zero-ETL terdengar seolah tidak memiliki komponen atau semua komponen disatukan, berbagai elemen dan layanan dapat digunakan tergantung kebutuhan analitik dan sumber daya target. Layanan tersebut meliputi:
Layanan integrasi data langsung
Penyedia cloud menawarkan layanan khusus yang mengotomatiskan integrasi zero-ETL. Seperti disebutkan sebelumnya, AWS menyediakan integrasi Amazon Aurora dengan Amazon Redshift, di mana data yang ditulis ke Aurora secara otomatis direplikasi ke Redshift. Layanan ini mengelola replikasi dan transformasi data secara internal, menghilangkan kebutuhan proses ETL tradisional.
Change Data Capture (CDC)
Teknologi CDC adalah elemen inti arsitektur zero-ETL. Teknologi ini terus memantau dan menangkap perubahan (insert, update, delete) di basis data sumber dan mereplikasi perubahan tersebut secara real-time ke sistem target.
Streaming data pipelines
Pipeline streaming memindahkan data secara real-time dari berbagai sumber ke sistem target. Platform seperti Amazon Kinesis dan Apache Kafka memungkinkan aliran data berkelanjutan, memastikan pembaruan berlatensi rendah.
Komputasi tanpa server (serverless)
Arsitektur serverless mendukung zero-ETL dengan secara otomatis mengelola infrastruktur yang diperlukan dan menyesuaikan skala sumber daya berdasarkan permintaan. Layanan seperti AWS Lambda dan Google Cloud Functions mencontohkan pendekatan ini dengan memungkinkan fungsi dieksekusi sebagai respons terhadap peristiwa data.
Teknologi schema-on-read
Dengan menerapkan skema saat membaca data alih-alih saat ditulis, schema-on-read mendukung fleksibilitas dalam menangani format data tidak terstruktur dan semi-terstruktur seperti JSON dan XML. Pendekatan ini mengurangi kebutuhan skema yang telah ditentukan dan memungkinkan analisis data secara dinamis.
Federasi dan abstraksi data
Zero-ETL memfasilitasi pemasukan dan duplikasi data dari berbagai sumber melalui federasi data. Ini melibatkan penggunaan danau data dan virtualisasi data lintas platform untuk menciptakan lapisan objek abstrak, menyederhanakan duplikasi data tanpa memerlukan transformasi dan perpindahan data yang ekstensif. Virtualisasi data memungkinkan pengguna mengakses dan menjalankan kueri atas data di berbagai sistem seolah-olah berada di satu lokasi.
Danau data
Dalam pendekatan zero-ETL, transformasi dan analisis dilakukan di dalam platform data. Ini memungkinkan pengelolaan data tidak terstruktur dalam berbagai format (video, gambar, teks, dan numerik) di dalam sistem penyimpanan data multi-format, seperti danau data, sering kali tanpa perlu transformasi perantara.
Kelebihan dan Kekurangan Zero-ETL
Zero-ETL mungkin terdengar menjanjikan untuk meningkatkan efisiensi dalam data science. Namun, penting untuk membandingkan baik kelebihan maupun kekurangan yang mungkin muncul dari penerapan zero-ETL.
Kelebihan zero-ETL
Zero-ETL membawa beberapa manfaat bagi manajemen data dan analitik data, termasuk:
Kekurangan zero-ETL
Terlepas dari manfaatnya, zero-ETL dapat menimbulkan beberapa tantangan, termasuk:
Penggunaan Umum Zero-ETL
Zero-ETL menawarkan keunggulan signifikan dalam berbagai skenario pemrosesan dan analitik data real-time. Berikut beberapa kasus penggunaan tipikal:
Perbandingan Zero-ETL vs ETL Tradisional
Tabel berikut memberikan perbandingan mendetail antara Zero-ETL dan proses ETL tradisional.
Zero-ETL
ETL Tradisional
Virtualisasi data
Menggunakan teknologi virtualisasi data untuk mempermudah duplikasi data antar gudang.
Virtualisasi data bisa menjadi berlebihan atau menantang untuk diterapkan karena dalam ETL data dipindahkan dari fase transformasi ke fase pemuatan.
Pemantauan kualitas data
Pada dasarnya merupakan pendekatan manajemen data otomatis; oleh karena itu, masalah kualitas data dapat muncul.
Karena sifat pipeline perpindahan data yang diskret dalam ETL, kualitas data lebih mudah dipantau dan diperbaiki.
Keberagaman tipe data
Danau data berbasis cloud memungkinkan berbagai tipe dan format data tanpa kendala arsitektur.
Arsitektur ekstraksi dan transformasi dapat membatasi tipe data (diperlukan upaya rekayasa tambahan pada fase ekstraksi dan transformasi untuk berbagai jenis data).
Penerapan real-time
Analisis data dapat dilakukan di dalam platform dengan latensi minimal dari pembuatan data hingga transformasi dan analisis.
Sifat pipeline yang dijadwalkan secara batch menghambat analisis data real-time.
Biaya dan pemeliharaan
Lebih hemat biaya dan lebih mudah dipelihara karena memerlukan lebih sedikit komponen komputasi dan pengkodean. Transformasi dan pemuatan data dapat dilakukan sesuai kebutuhan.
Lebih mahal karena memerlukan lebih banyak sumber daya komputasi dan profesional data berpengalaman.
Skalabilitas
Lebih cepat dan lebih murah untuk diskalakan karena menghilangkan perangkat keras perantara untuk perpindahan data.
Dapat lambat dan mahal karena meningkatnya kebutuhan perangkat keras yang lebih baik dan optimasi kode untuk menampung sumber data yang lebih luas.
Perpindahan data
Tidak ada atau minimal.
Perpindahan data diperlukan karena pipeline bersifat diskret dan data harus dipindahkan ke tahap pemuatan.
Zero-ETL vs Teknik Integrasi Data Lainnya
Di bawah ini adalah perbandingan zero-ETL dengan teknik integrasi data terkemuka lainnya, menyoroti kesamaan dan perbedaan utamanya.
Zero-ETL vs ELT
Zero-ETL vs API
Perangkat Zero-ETL Teratas
Seperti yang telah kita lihat sepanjang artikel ini, zero-ETL adalah alat manajemen data mutakhir yang semakin populer di industri, banyak dipopulerkan oleh AWS dan diadopsi oleh penyedia cloud lainnya.
Berikut gambaran singkat perangkat zero-ETL teratas yang tersedia saat ini:
Perangkat zero-ETL dari AWS
Perangkat Zero-ETL dari penyedia cloud lain
Selain AWS, penyedia cloud lain menawarkan platform data terpadu dengan kapabilitas zero-ETL:
Kesimpulan
Menghilangkan fase ETL tradisional dalam pipeline analitik data dan pembelajaran mesin secara signifikan menggeser paradigma rekayasa data. Mengintegrasikan arsitektur zero-ETL menawarkan manfaat substansial, termasuk peningkatan kecepatan, keamanan yang lebih baik, dan skalabilitas yang lebih tinggi.
Namun, pergeseran ini juga membawa tantangan. Kebutuhan akan keterampilan rekayasa data tradisional mungkin berkurang, sehingga analis data, ilmuwan pembelajaran mesin, dan data scientist perlu menguasai konsep dan keterampilan integrasi data yang lebih maju.
Zero-ETL berfokus pada kebutuhan analis data dan machine learning engineer, mengisyaratkan masa depan di mana peran-peran ini menjadi lebih sentral, yang berpotensi membentuk ulang permintaan pasar kerja dan set keterampilan.
Jika Anda tertarik mempelajari lebih lanjut tentang arsitektur data, lihat kursus kami tentang ETL dan ELT di Python!