
Cours
ETL et ELT en Python
4 h
39.5K
Dans les entreprises modernes, la pression augmente pour réduire le délai entre la collecte des données et leur exploitation. Il faut une approche rapide pour accélérer le passage de la collecte à l'analyse, à l'intelligence artificielle et à la mise en œuvre de l'apprentissage automatique.
Les architectures ETL (extract, transform, load) traditionnelles peinent à répondre aux exigences techniques du big data et de l'analyse en temps réel. Une nouvelle architecture de gestion des données, dite zero-ETL, a donc émergé pour minimiser, voire supprimer, le besoin de processus ETL.
Le Zero-ETL désigne un ensemble d'intégrations conçues pour éliminer ou réduire la nécessité de créer des pipelines de données ETL. En permettant d'interroger différents silos sans déplacer physiquement les données, le Zero-ETL vise à rationaliser le traitement des données et à améliorer l'efficacité.
Le terme « zero-ETL » a été présenté lors de la conférence AWS re:Invent en 2022, quand l'intégration d'Amazon Aurora avec Amazon Redshift a été annoncée. Depuis, AWS a fait évoluer ce concept, principalement via des services permettant l'analyse et la transformation des données directement dans les plateformes, sans pipelines ETL séparés.
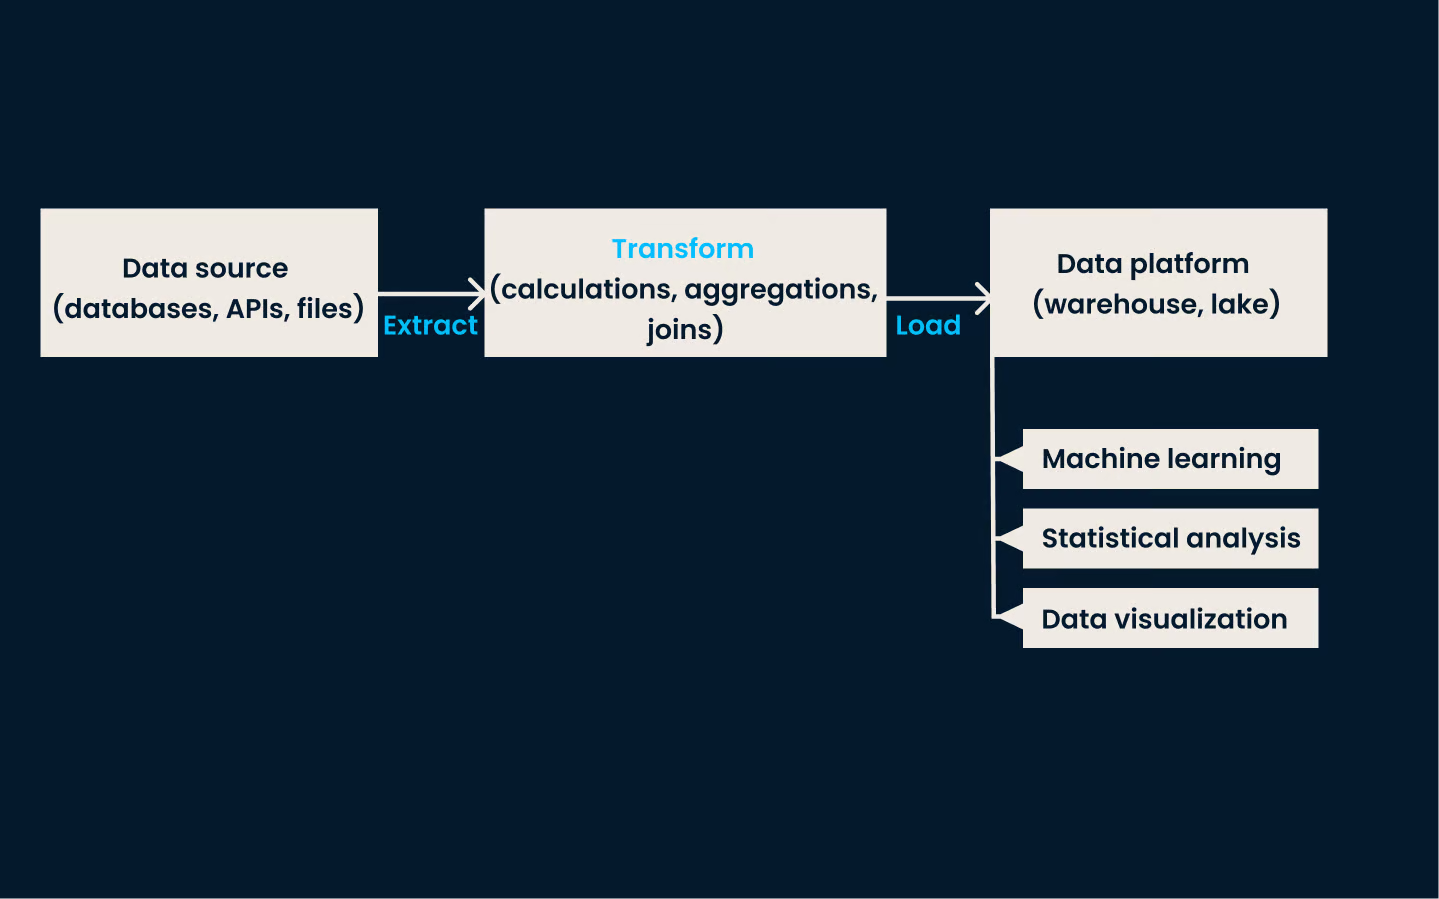
Dans un pipeline ETL classique, un professionnel des données (data engineer ou data scientist) collecte des données depuis une source, comme une base de données, une API, un fichier JSON ou XML.
Après l'extraction, diverses transformations sont appliquées : combiner des jeux de données, effectuer des calculs, fusionner des tables ou supprimer des informations non essentielles telles que des horodatages ou des identifiants utilisateur.
Enfin, les données transformées sont chargées dans une plateforme pour des analyses complémentaires, comme l'apprentissage automatique, l'analyse statistique ou la visualisation de données. Ce processus est coûteux en temps, en budget et en effort, du fait de sa complexité.
Architecture ETL traditionnelle
Prenons une analogie : en photographie argentique, on capture une image sur pellicule (extraction), on la développe en chambre noire (transformation), puis on l'agrandit et on l'expose (chargement). À l'inverse, imaginez un appareil photo numérique où la prise de vue, le développement et l'affichage (ou la diffusion immédiate en direct) se font au même endroit.
De même, le Zero-ETL transforme le traitement des données en supprimant l'extraction, la transformation et le chargement. Cette architecture limite les mouvements de données et permet de les transformer et de les analyser au sein d'une seule et même plateforme.
Le Zero-ETL promet des analyses en temps réel ou à très faible latence pour les data scientists et les parties prenantes métiers.
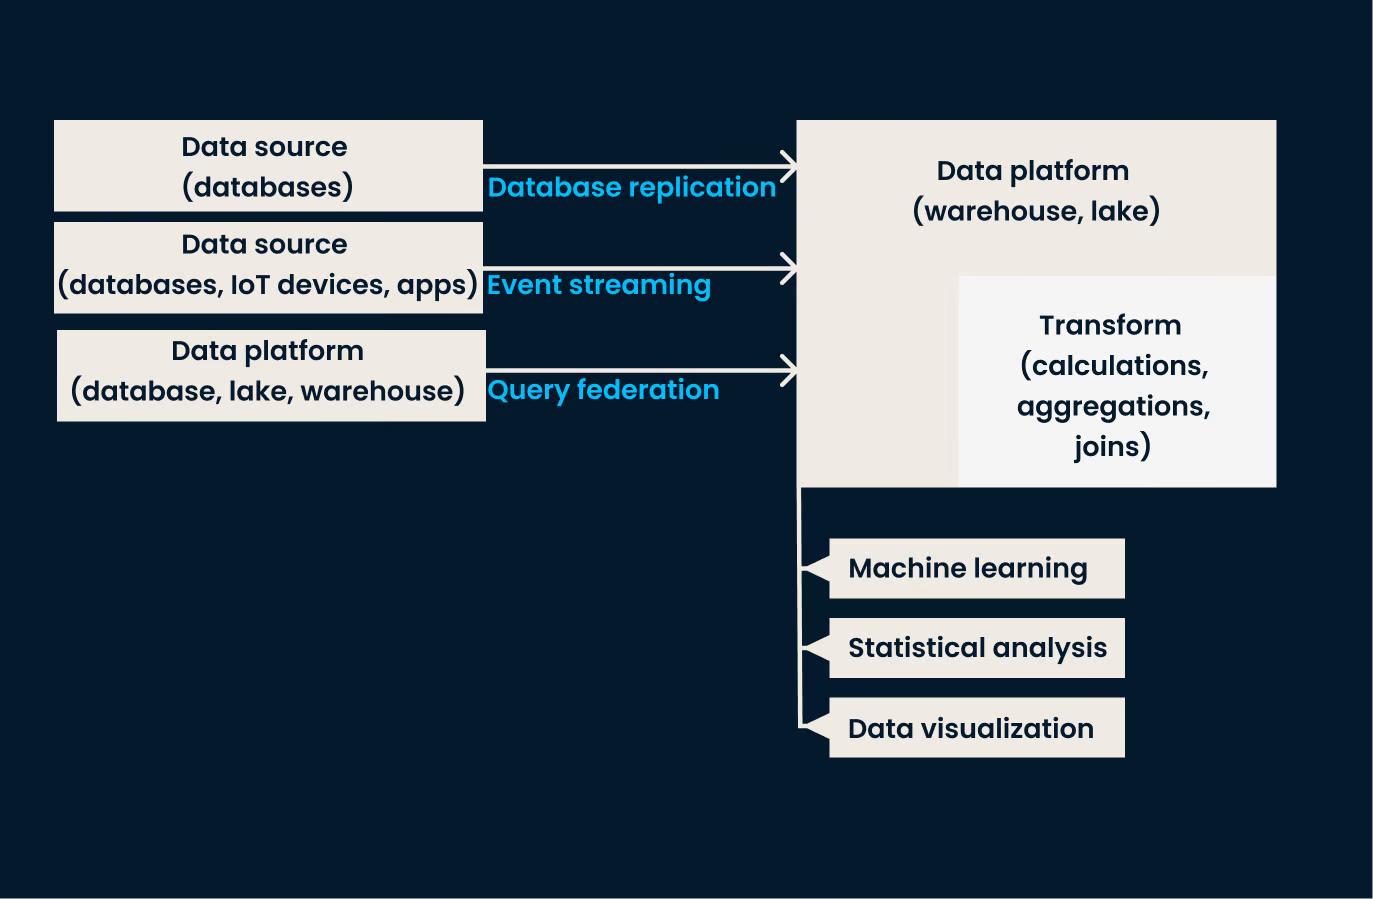
Le Zero-ETL simplifie l'intégration des données en reliant directement les sources aux entrepôts et lacs de données, pour rendre les données disponibles en temps réel pour l'analyse et le reporting. Cela s'appuie sur plusieurs technologies et services cloud, parmi lesquels :
La réplication consiste à copier et synchroniser les données d'une base vers une autre.
Dans un contexte Zero-ETL entre une base et un entrepôt, elle garantit la mise à jour automatique des données dans l'entrepôt en temps réel ou quasi-réel, supprimant le besoin de processus ETL distincts. C'est le cas de l'intégration entre Amazon Aurora et Amazon Redshift.
Les requêtes fédérées permettent d'exécuter des requêtes sur plusieurs sources (bases de données, entrepôts, lacs) sans déplacer ni répliquer les données dans un emplacement unique.
Dans le Zero-ETL, elles offrent aux professionnels la possibilité d'accéder et d'analyser directement des données stockées sur différentes plateformes, proposant une vue unifiée sans la lourdeur d'un ETL traditionnel.
Le streaming désigne le traitement et le transfert continus de données en temps réel, à mesure qu'elles sont générées.
En Zero-ETL, il s'agit de capter des données issues de multiples sources (bases, objets connectés, applications) et de les envoyer immédiatement vers un entrepôt ou un lac de données. Les données sont ainsi quasi instantanément disponibles pour l'analyse et l'interrogation, sans traitements ETL par lots.
Pour réaliser de l'analytique in-place, les transformations nécessaires sont intégrées à la plateforme de données cloud, comme un data lake. Cette intégration permet de traiter et d'analyser les données en temps réel là où elles résident, réduisant la latence et améliorant l'efficacité.
Par exemple, des données non structurées collectées en JSON ou XML seront transformées et analysées via des technologies « schema-on-read » au sein même du lac, sans étapes intermédiaires de déplacement vers un stockage prêt pour le reporting.
Exemple d'architecture Zero-ETL
Même si l'architecture Zero-ETL peut laisser penser qu'il n'y a pas de composants ou qu'ils sont unifiés, différents éléments et services peuvent être mobilisés selon les besoins analytiques et les ressources. Parmi eux :
Les fournisseurs cloud proposent des services spécialisés qui automatisent l'intégration Zero-ETL. Comme indiqué, AWS offre l'intégration d'Amazon Aurora avec Amazon Redshift, où les données écrites dans Aurora sont automatiquement répliquées dans Redshift. Ces services gèrent en interne la réplication et la transformation, supprimant le besoin d'ETL traditionnel.
La technologie CDC est un pilier des architectures Zero-ETL. Elle surveille et capture en continu les changements (insertions, mises à jour, suppressions) dans les bases sources et les réplique en temps réel vers les systèmes cibles.
Ces pipelines transfèrent les données en temps réel de sources variées vers le système cible. Des plateformes comme Amazon Kinesis et Apache Kafka assurent un flux continu et des mises à jour à faible latence.
Les architectures serverless soutiennent le Zero-ETL en gérant automatiquement l'infrastructure et en adaptant les ressources à la demande. Des services comme AWS Lambda et Google Cloud Functions illustrent cette approche en exécutant des fonctions en réponse à des événements de données.
En appliquant le schéma à la lecture plutôt qu'à l'écriture, le schema-on-read offre une grande flexibilité pour traiter des formats non ou semi-structurés comme JSON et XML. Cette approche réduit le besoin de schémas prédéfinis et permet une analyse dynamique.
Le Zero-ETL facilite l'ingestion et la duplication de données issues de différentes sources grâce à la fédération de données. Il s'appuie sur des data lakes et la virtualisation interplateformes pour créer une couche d'objets abstraite, simplifiant la duplication sans recourir à d'importantes transformations ni à des mouvements de données. La virtualisation permet d'accéder et d'interroger des données réparties comme si elles se trouvaient au même endroit.
Dans une approche Zero-ETL, les transformations et analyses sont réalisées au sein de la plateforme de données. On peut ainsi gérer des données non structurées dans divers formats (vidéo, images, texte, numérique) dans un stockage multi-format, tel qu'un data lake, souvent sans transformations intermédiaires.
Le Zero-ETL apparaît comme une voie prometteuse pour gagner en efficacité en data science. Il convient toutefois d'en peser les avantages et les limites avant de se lancer.
Le Zero-ETL apporte plusieurs bénéfices à la gestion et à l'analyse des données, notamment :
Malgré ses atouts, le Zero-ETL comporte aussi des défis :
Le Zero-ETL apporte des avantages significatifs dans divers scénarios de traitement et d'analyse en temps réel. Exemples :
Le tableau suivant propose une comparaison détaillée entre le Zero-ETL et les processus ETL traditionnels.
Ci-dessous, une comparaison du Zero-ETL avec d'autres approches d'intégration, en soulignant leurs points communs et différences clés.
Comme nous l'avons vu, le Zero-ETL est une approche de gestion des données de pointe, popularisée par AWS et désormais adoptée par d'autres clouds.
Voici un aperçu des principaux outils Zero-ETL disponibles aujourd'hui :
Au-delà d'AWS, d'autres fournisseurs offrent des plateformes unifiées avec des capacités Zero-ETL :
La suppression des phases ETL traditionnelles dans les pipelines d'analytique et de machine learning marque un changement profond de paradigme pour l'ingénierie des données. L'adoption d'une architecture Zero-ETL apporte des gains substantiels en vitesse, sécurité et scalabilité.
Mais cette évolution s'accompagne de défis. Les compétences d'ingénierie data classiques pourraient être moins sollicitées, tandis que les analystes, scientifiques des données et ingénieurs ML devront acquérir des notions et compétences d'intégration plus avancées.
Le Zero-ETL répond d'abord aux besoins des analystes et des ingénieurs ML, laissant entrevoir un avenir où ces rôles gagneraient en centralité, influençant les attentes du marché et les référentiels de compétences.
Pour approfondir l'architecture des données, découvrez notre cours ETL and ELT in Python !
Approfondissez l'architecture et la gestion des données avec ces cours !
Cours
Cours
Cours