Ga naar hoofdinhoud
Data-engineering

Wat is Zero-ETL? Nieuwe benaderingen voor dataintegratie geïntroduceerd

Ontdek hoe zero-ETL-architectuur dataverwerking kan veranderen door ETL-pijplijnen te elimineren en data-analyse en AI-implementatie te stroomlijnen.
Vahab Khademi's photo
Vahab Khademi
Bijgewerkt · 11 min lezen

Verken met AI

ChatGPTClaudePerplexity

Maak je gratis account aan

Oefen en volg je voortgang.

Ga Verder Met Google
Door verder te gaan accepteer je onze Gebruiksvoorwaarden, ons Privacybeleid en dat je gegevens worden opgeslagen in de VS.

In moderne bedrijven is er een groeiende behoefte om de tijd tot inzet van datainsights te verkorten. Er is een snelle aanpak nodig om de overgang van dataverzameling naar analytics, kunstmatige intelligentie en machine learning te versnellen.

Traditionele ETL-architecturen (extract, transform, load) hebben moeite om te voldoen aan de technische eisen van big data en realtime data-analyse. Daarom is een nieuwe data-architectuur ontstaan, zero-ETL, die tot doel heeft de behoefte aan ETL-processen te minimaliseren of te elimineren.

Wat is Zero-ETL?

Zero-ETL is een systeem van integraties dat is ontworpen om de noodzaak om ETL-datapijplijnen te bouwen weg te nemen of te verminderen. Door query’s over verschillende datasilo’s mogelijk te maken zonder de data fysiek te verplaatsen, wil zero-ETL de dataverwerking stroomlijnen en de efficiëntie verbeteren.

De term "zero-ETL" werd geïntroduceerd tijdens de AWS re:Invent-conferentie in 2022, toen de integratie van Amazon Aurora met Amazon Redshift werd aangekondigd. Sindsdien heeft AWS dit concept verder ontwikkeld, vooral via diensten die directe data-analyse en -transformatie binnen de dataplatforms ondersteunen, zonder aparte ETL-pijplijnen.

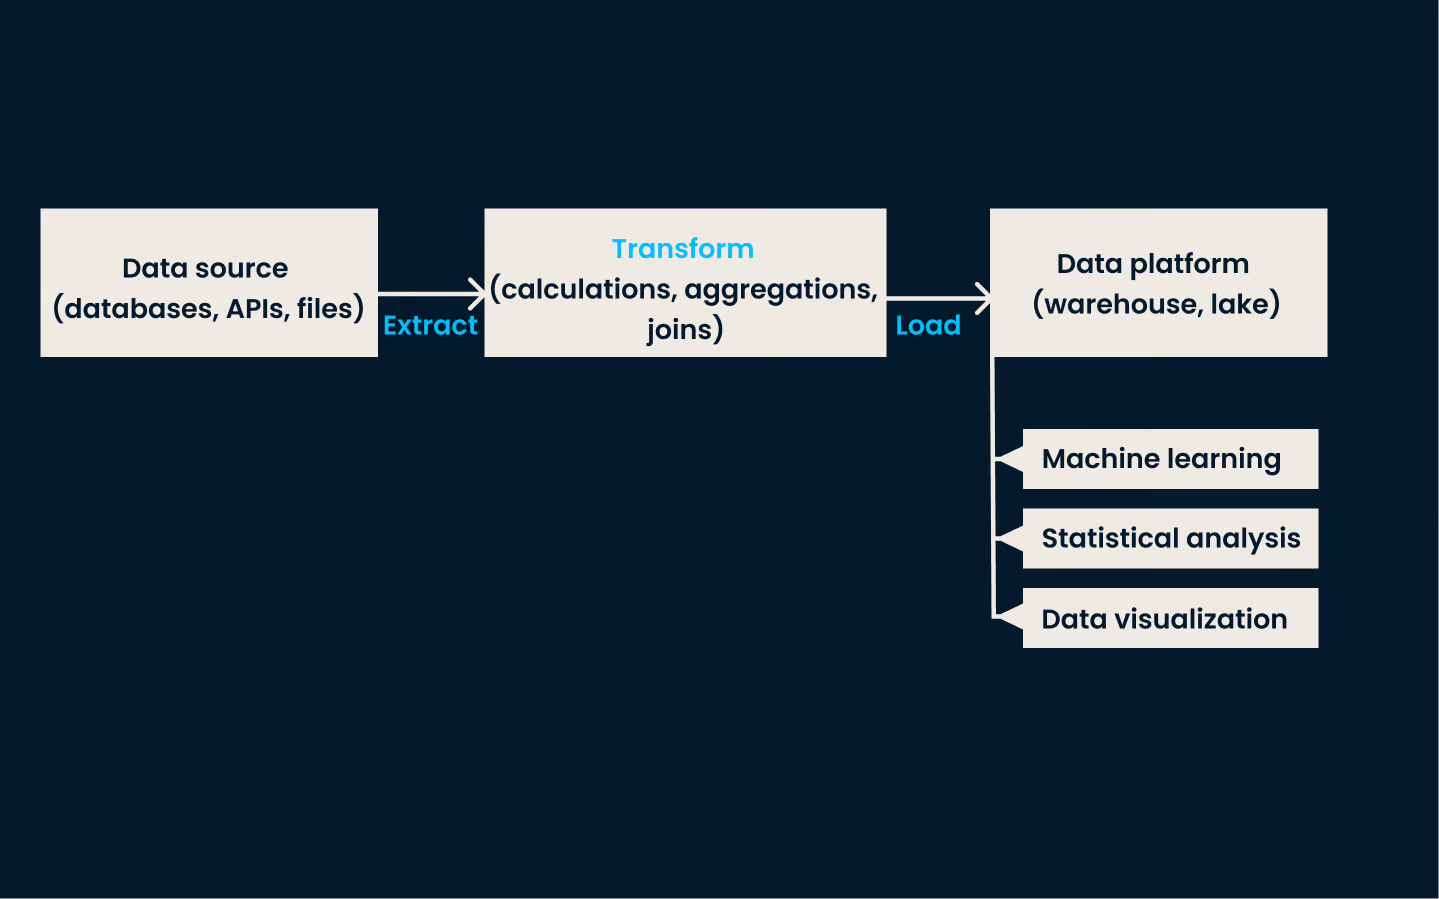
In een typische ETL-dataverwerkingspijplijn verzamelt een dataprofessional, zoals een data engineer of data scientist, data uit een bron, zoals een database, een API, een JSON- of een XML-bestand. 

Na het extraheren van de data worden verschillende transformaties toegepast, zoals data samenvoegen, berekeningen uitvoeren, tabellen mergen of onnodige informatie verwijderen, zoals tijdstempels of gebruikers-ID’s. 

Tot slot wordt de getransformeerde data geladen in een platform voor verdere analyse, zoals machine learning, statistische analyse of datavisualisatie. Dit proces vergt door zijn complexiteit veel tijd, kosten en inspanning.

Traditionele ETL-pijplijn

Traditionele ETL-architectuur

Denk aan deze analogie: bij traditionele fotografie wordt een foto gemaakt op negatieffilm (data-extractie), ontwikkeld in een donkere kamer (transformatie) en daarna afgedrukt en getoond (laden). Stel je nu een digitale camera voor, waarbij de foto wordt vastgelegd, ontwikkeld en klaar is om te tonen (of direct te versturen in een live-uitzending) — allemaal op één plek.

Op vergelijkbare wijze verandert zero-ETL de dataverwerking door het extraheren, transformeren en laden te elimineren. Deze architectuur minimaliseert databeweging en stelt ons in staat alle data binnen één platform te transformeren en te analyseren. 

Zero-ETL belooft realtime of minimaal vertraagde data-analyse voor data scientists en zakelijke stakeholders.

Hoe werkt Zero-ETL?

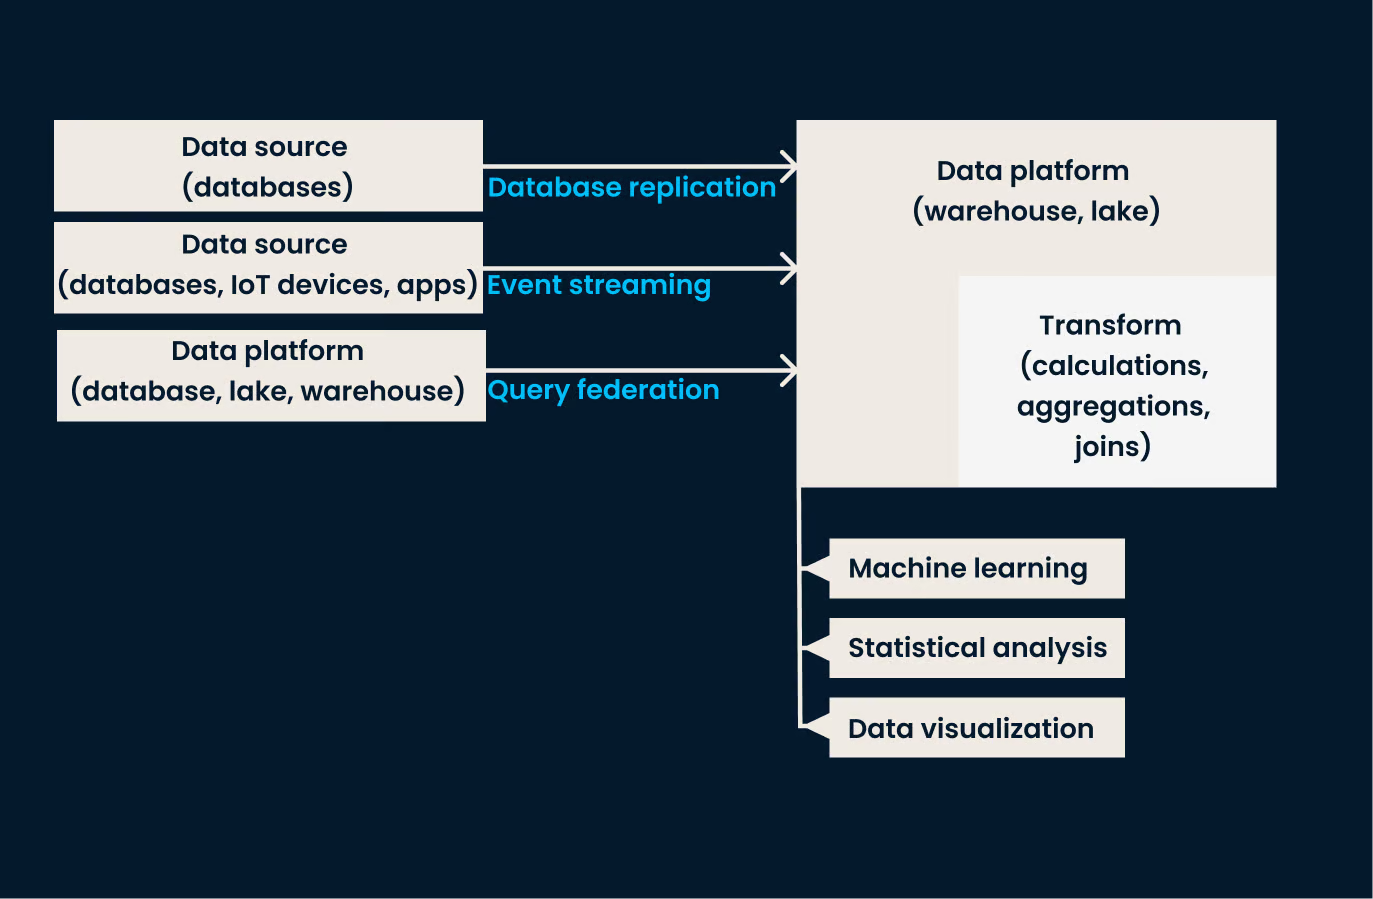
Zero-ETL vereenvoudigt dataintegratie door databronnen direct te koppelen aan datawarehouses of -lakes, zodat data in realtime beschikbaar is voor analytics en rapportage. Dit wordt mogelijk gemaakt door diverse cloudgebaseerde technologieën en diensten, zoals:

Databasereplicatie

Databasereplicatie is het kopiëren en synchroniseren van data van de ene database naar de andere. 

In de context van zero-ETL tussen een database en een datawarehouse zorgt replicatie ervoor dat de data in het datawarehouse automatisch in realtime of bijna realtime wordt bijgewerkt, waardoor aparte ETL-processen overbodig worden. Dit geldt bijvoorbeeld voor de integratie tussen Amazon Aurora en Amazon Redshift.

Gefedereerde query’s

Gefedereerde query’s verwijzen naar de mogelijkheid om query’s uit te voeren over meerdere databronnen, zoals databases, datawarehouses of datalakes, zonder de data te hoeven verplaatsen of repliceren naar één locatie. 

Wat betreft zero-ETL stelt gefedereerd query’en dataprofessionals in staat om data die in verschillende dataplatforms is opgeslagen rechtstreeks te benaderen en te analyseren, voor een uniform beeld van de data zonder de overhead van traditionele ETL-processen.

Datastreaming

Datastreaming verwijst naar het continu, in realtime verwerken en overdragen van data zodra deze wordt gegenereerd. 

In zero-ETL betekent datastreaming dat data uit meerdere bronnen (zoals databases, IoT-apparaten of applicaties) wordt vastgelegd en onmiddellijk wordt afgeleverd aan een datawarehouse of datalake. Zo is de data vrijwel direct beschikbaar voor analyse en query’s, zonder batch-ETL-processen.

In-place data-analyse

Om in-place data-analyse te bereiken, worden de benodigde transformaties geïntegreerd in het clouddataplatform, zoals een datalake. Deze integratie maakt realtime dataverwerking en -analyse mogelijk direct waar de data zich bevindt, wat de latentie vermindert en de efficiëntie verhoogt.

Zo zal ongestructureerde data die in JSON- of XML-formaat is verzameld, worden getransformeerd en geanalyseerd met "schema-on-read"-technologieën binnen het datalake zelf, waardoor tussenstappen van databeweging naar rapportageklare opslag vervallen.

Zero-ETL data-architectuur

Voorbeeld van een Zero-ETL data-architectuur

De verschillende componenten van Zero-ETL

Hoewel de zero-ETL-architectuur misschien klinkt alsof er geen componenten zijn of dat alle componenten verenigd zijn, kunnen afhankelijk van de behoeften van de beoogde analytics en middelen verschillende elementen en diensten worden ingezet. Deze diensten omvatten:

Directe dataintegratiediensten

Cloudproviders bieden gespecialiseerde diensten die zero-ETL-integratie automatiseren. Zoals eerder genoemd, levert AWS integratie van Amazon Aurora met Amazon Redshift, waarbij data die naar Aurora wordt geschreven automatisch wordt gerepliceerd naar Redshift. Deze diensten beheren intern datareplicatie en -transformatie, waardoor traditionele ETL-processen overbodig worden.

Change Data Capture (CDC)

CDC-technologie is een kernelement van zero-ETL-architecturen. Het bewaakt en vangt continu wijzigingen (inserts, updates, deletes) in de brondatabases en repliceert deze wijzigingen in realtime naar de doelsystemen.

Streaming datapijplijnen

Streamingpijplijnen verplaatsen data in realtime van verschillende bronnen naar het doelsysteem. Platforms zoals Amazon Kinesis en Apache Kafka maken continue datastromen mogelijk en zorgen voor updates met lage latentie.

Serverless computing

Serverless-architecturen ondersteunen zero-ETL door de benodigde infrastructuur automatisch te beheren en resources te schalen op basis van de vraag. Diensten zoals AWS Lambda en Google Cloud Functions zijn hier voorbeelden van doordat functies worden uitgevoerd als reactie op data-evenementen.

Schema-on-read-technologieën

Door het schema toe te passen bij het lezen van de data in plaats van bij het schrijven, ondersteunt schema-on-read flexibiliteit bij het verwerken van ongestructureerde en semi-gestructureerde dataformaten zoals JSON en XML. Deze aanpak vermindert de noodzaak van vooraf gedefinieerde schema’s en maakt dynamische data-analyse mogelijk.

Datafederatie en abstractie

Zero-ETL faciliteert de opname en duplicatie van data uit verschillende bronnen via datafederatie. Dit omvat het gebruik van datalakes en cross-platform datavirtualisatie om een abstracte objectlaag te creëren, waardoor dataduplicatie wordt vereenvoudigd zonder uitgebreide transformatie en databeweging. Datavirtualisatie stelt gebruikers in staat data uit verschillende systemen te benaderen en te bevragen alsof deze zich op één locatie bevindt.

Datalakes

In een zero-ETL-benadering worden transformaties en analyses uitgevoerd binnen het dataplatform. Dit maakt het mogelijk om ongestructureerde data in diverse formaten (video, afbeeldingen, tekst en numeriek) te beheren binnen een opslag met meerdere formaten, zoals een datalake, vaak zonder dat tussentijdse transformaties nodig zijn.

Voordelen en nadelen van Zero-ETL

Zero-ETL klinkt als een veelbelovende aanpak om de efficiëntie in data science te vergroten. Het is echter belangrijk om zowel de voordelen als de nadelen van een zero-ETL-implementatie te vergelijken.

Voordelen van zero-ETL

Zero-ETL biedt verschillende voordelen voor databeheer en data-analyse, waaronder:

  • Minder complexe engineering: Zero-ETL vereenvoudigt de architectuur van datapijplijnen door extractie, transformatie en laden te integreren tot één proces of het geheel te elimineren. Deze stroomlijning vermindert de complexiteit en versnelt data-analyse en machinelearningtaken, waardoor data scientists sneller inzichten kunnen verkrijgen.
  • Realtime-analyses: Zero-ETL maakt realtime data-analyse mogelijk door de fasen van extractie, transformatie en laden direct in het dataplatform samen te brengen. Wanneer nieuwe data wordt verzameld, kan deze meteen worden geanalyseerd, wat snellere besluitvorming en tijdige inzichten mogelijk maakt.

Nadelen van zero-ETL

Ondanks de voordelen kan zero-ETL ook enkele uitdagingen met zich meebrengen, waaronder:

  • Complexere troubleshooting: Problemen identificeren en oplossen kan ingewikkelder zijn omdat alle dataprocessen in één geïntegreerde stap plaatsvinden. Het isoleren van de bron van problemen vereist een grondig begrip van het hele systeem.
  • Steilere leercurve: Het elimineren van traditionele ETL-pijplijnen kan de behoefte aan tussentijdse data-engineeringrollen verminderen. Deze verschuiving kan leiden tot een steilere leercurve voor data scientists en machine learning engineers, die nu taken moeten beheren die voorheen door data engineers werden uitgevoerd.
  • Cloudafhankelijkheid: Zero-ETL-oplossingen zijn doorgaans cloudgebaseerd van opzet. Organisaties die nog niet klaar zijn om cloudtechnologieën te integreren, kunnen uitdagingen ondervinden bij het adopteren van zero-ETL. Deze afhankelijkheid kan zorgen oproepen over databeveiliging, compliance en controle.

Typische use-cases van Zero-ETL

Zero-ETL biedt aanzienlijke voordelen in verschillende scenario’s voor realtime dataverwerking en -analyse. Enkele typische use-cases zijn:

  • Realtime-analyses: Zero-ETL elimineert het traditionele batch-ETL-proces en maakt realtime toegang mogelijk tot nieuw gegenereerde data, waaronder klantinteracties, gebruikersgedrag en verkeerspatronen. Deze automatisering stelt teams in staat om direct datagedreven beslissingen te nemen, wat de responstijd en operationele efficiëntie verbetert.
  • Directe dataoverdracht: In een zero-ETL-data-architectuur betekent het wegvallen van de ETL-pijplijn dat dataduplicatie naar een ander warehouse, waar data scientists erbij kunnen, aanzienlijk sneller of zelfs realtime gebeurt.
  • Machine learning en AI: Zero-ETL is bijzonder nuttig voor machine learning- en AI-toepassingen, waar tijdigheid van data cruciaal is. Realtime datastreaming en onmiddellijke beschikbaarheid maken continue training en updates van ML-modellen met de nieuwste data mogelijk, wat de nauwkeurigheid en relevantie van AI-voorspellingen en -inzichten verbetert.

Vergelijking van Zero-ETL vs. traditionele ETL

De onderstaande tabel geeft een gedetailleerde vergelijking tussen Zero-ETL en traditionele ETL-processen.


Zero-ETL

Traditionele ETL

Datavirtualisatie

Maakt gebruik van datavirtualisatietechnologieën om het dupliceren van data over warehouses te vergemakkelijken.

Datavirtualisatie kan overbodig of lastig te implementeren zijn, omdat data in ETL wordt verplaatst van transformatie naar de laadfase.

Datakwaliteitsmonitoring

Het is in wezen een geautomatiseerde aanpak van databeheer; daardoor kunnen er datakwaliteitsproblemen ontstaan.

Door de discrete aard van de databeweging in ETL wordt datakwaliteit beter gemonitord en verholpen.

Diversiteit aan datatypes

Cloudgebaseerde datalakes ondersteunen meerdere datatypes en -formaten zonder architecturale beperkingen.

De extractie- en transformatiearchitectuur kan de datatypes beperken (extra engineering is nodig in de extractie- en transformatiefase voor verschillende soorten data).

Realtime-implementatie

Data-analyse kan op het platform worden uitgevoerd met minimale latentie tussen datageneratie, transformatie en analyse.

Het geplande batchkarakter van de pijplijn verhindert realtime data-analyse.

Kosten en onderhoud

Is kostenefficiënter en eenvoudiger te onderhouden omdat er minder computationele componenten en code nodig zijn. Datatransformatie en -laden kunnen on demand worden uitgevoerd.

Is duurder omdat er meer computationele resources en ervaren dataprofessionals nodig zijn.

Schaal

Sneller en goedkoper op te schalen doordat tussenliggende hardware voor databeweging wordt geëlimineerd. 

Kan traag en kostbaar zijn door de toenemende behoefte aan betere hardware en codeoptimalisatie om grotere databronnen te accommoderen.

Databeweging

Geen of minimaal.

Databeweging is vereist omdat de pijplijn discreet is en data naar de laadfase moet worden overgebracht.

Zero-ETL vs. andere dataintegratietechnieken

Hieronder volgt een vergelijking van zero-ETL met andere prominente dataintegratietechnieken, met hun overeenkomsten en centrale verschillen.

Zero-ETL vs. ELT

  • Overeenkomsten: Zero-ETL en ELT (Extract, Load, Transform) verkorten de tijd en complexiteit van data-analyse door de datatransformatie uit te stellen tot nadat de data in het doelsysteem is geladen. ELT wordt gezien als een voorloper van zero-ETL, omdat het de basis legde voor het uitstellen van transformatie naar een latere fase in de dataverwerkingspijplijn.
  • Belangrijkste verschillen: Zero-ETL elimineert de tussenliggende stagingfase die in de ELT-benadering nodig is, waardoor de latentie wordt geminimaliseerd en realtime databeschikbaarheid wordt verbeterd. Zero-ETL vereenvoudigt de datapijplijn verder door het aantal stappen en de infrastructuurbehoeften te verminderen.

Zero-ETL vs. API

  • Overeenkomsten: Zero-ETL en API’s maken query’s naar meerdere databronnen mogelijk en faciliteren dataintegratie over verschillende systemen.
  • Belangrijkste verschillen: Zero-ETL is primair een codeloze technologie die minimale handmatige code vereist voor dataintegratie en -beheer. API’s daarentegen vereisen aangepaste code om verschillende databronnen te verbinden en ermee te communiceren. Bovendien zijn API’s gevoeliger voor beveiligingslekken vanwege het codegebonden karakter van hun integratie, wat kwetsbaarheden kan introduceren als ze niet goed worden beheerd en beveiligd.

Top Zero-ETL-tools

Zoals we in deze blogpost hebben gezien, is zero-ETL een geavanceerd databeheerconcept dat aan terrein wint in de industrie, grotendeels gepopulariseerd door AWS en overgenomen door andere cloudproviders. 

Hier is een kort overzicht van de belangrijkste zero-ETL-tools van dit moment:

AWS zero-ETL-tools

  • Directe integratie tussen Aurora en Redshift: AWS heeft Amazon Aurora en Amazon Redshift geïntegreerd om realtime analytics mogelijk te maken zonder traditionele ETL-processen.
  • Redshift Spectrum: Stelt gebruikers in staat SQL-query’s uit te voeren op exabytes aan data in Amazon S3 zonder de data te laden of te transformeren. Deze dienst ondersteunt naadloos query’en van gestructureerde en ongestructureerde data, ideaal voor diverse datasets.
  • Amazon Athena: Een serverless-analyticstool die grote hoeveelheden data verwerkt voor in-place analytics, waaronder machine learning en AI, met SQL of Python om streamingdata van clouddiensten te verbinden.
  • Amazon Redshift Streaming Ingestion: Een dienst die realtime data-inname biedt vanuit Amazon Kinesis Data Streams of Amazon MSK, ter ondersteuning van intensieve realtime machinelearningtaken.

Zero-ETL-tools van andere cloudproviders

Naast AWS bieden andere cloudproviders uniforme dataplatforms met zero-ETL-mogelijkheden:

  • Snowflake: Ondersteunt het bouwen van datawarehouses en -lakes die ongestructureerde data aankunnen met een zero-ETL-architectuur. Snowflake vereenvoudigt dataworkflows en ondersteunt realtime analytics en machine learning.
  • Google BigQuery: Voert complexe SQL-query’s uit op grote datasets in realtime en integreert naadloos met andere Google Cloud-diensten voor realtime analytics. BigQuery is ontworpen om enorme hoeveelheden data efficiënt te verwerken.
  • Microsoft Azure Synapse Analytics: Biedt realtime data-inname en -analyse met een uniform analyticsplatform, ter ondersteuning van geavanceerde analytics en business intelligence-toepassingen. Synapse integreert met diverse Azure-diensten.

Conclusie

Het elimineren van traditionele ETL-fasen in de data-analyse- en machine learning-pijplijn betekent een sterke verschuiving in het data-engineeringparadigma. Het integreren van een zero-ETL-architectuur biedt aanzienlijke voordelen, waaronder hogere snelheid, betere beveiliging en grotere schaalbaarheid.

Toch brengt deze verschuiving ook uitdagingen met zich mee. De behoefte aan traditionele data-engineeringsvaardigheden kan afnemen, waardoor data-analisten, machine learning scientists en data scientists zich meer geavanceerde dataintegratieconcepten en -vaardigheden eigen moeten maken. 

Zero-ETL richt zich op de behoeften van data-analisten en machine learning-engineers en hint op een toekomst waarin deze rollen centraler staan, wat mogelijk de vraag op de arbeidsmarkt en de vereiste skillsets hertekent.

Als je meer wilt leren over data-architectuur, bekijk dan onze cursus ETL en ELT in Python!

FAQs

Hoe kan een bedrijf overstappen van traditionele ETL naar een Zero-ETL-architectuur?

Om de overstap te maken, beoordeel je huidige dataprocessen en identificeer je gebieden waar databeweging kan worden verminderd. Richt je op het adopteren van cloudgebaseerde technologieën zoals datalakes en realtime streaming. Het omscholen van je team om zich aan te passen aan nieuwe tools en methodologieën is ook essentieel voor deze overgang.

Voor welk type organisaties of projecten is Zero-ETL het meest geschikt?

Zero-ETL past goed bij organisaties die behoefte hebben aan realtime data-analyse, zoals e-commerce, financiële diensten en telecom. Projecten die baat hebben, zijn onder meer realtime monitoring, dynamische prijsstelling en onmiddellijke fraudedetectie.

Wat zijn de langetermijngevolgen van het adopteren van Zero-ETL voor databeheer en analytics?

Op de lange termijn kan Zero-ETL de wendbaarheid van een organisatie vergroten en snellere reacties op datainsights mogelijk maken. Het kan ook datagerelateerde functies verschuiven richting meer integratiegerichte verantwoordelijkheden. Regelmatige updates van beveiligings- en compliancemaatregelen blijven essentieel naarmate dataprocessen worden gestroomlijnd.


Vahab Khademi's photo
Author
Vahab Khademi
LinkedIn

Mijn opleiding is in wiskunde en statistiek. Ik heb uitgebreide ervaring met statistische modellering en toepassingen van machine learning. Daarnaast doe ik onderzoek naar de wiskunde achter ML.

Onderwerpen
Data-engineering

Leer meer over data-architectuur en -beheer met deze cursussen!

Cursus

ETL en ELT in Python

4 uur
40.5K
Leer effectieve, krachtige en betrouwbare data pipelines bouwen met behulp van Extract, Transform, and Load-principes.
Bekijk detailsStart Cursus

Maak je gratis account aan

Oefen en volg je voortgang.

Ga Verder Met Google
Door verder te gaan accepteer je onze Gebruiksvoorwaarden, ons Privacybeleid en dat je gegevens worden opgeslagen in de VS.
Meer bekijken
Gerelateerd

blog

AI vanaf nul leren in 2026: een complete gids van de experts

Ontdek alles wat je moet weten om in 2026 AI te leren, van tips om te beginnen tot handige resources en inzichten van industrie-experts.
Adel Nehme's photo

Adel Nehme

15 min

Meer bekijken

