आधुनिक व्यवसायों में डेटा इनसाइट्स को तैनात करने में लगने वाले समय को न्यूनतम करने की आवश्यकता तेजी से बढ़ रही है। डेटा संग्रह से एनालिटिक्स, आर्टिफ़िशियल इंटेलिजेंस, और मशीन लर्निंग के कार्यान्वयन तक के संक्रमण को तेज करने के लिए एक तेज़ दृष्टिकोण आवश्यक है।
पारंपरिक ETL (extract, transform, load) आर्किटेक्चर को बिग डेटा और रियल-टाइम डेटा विश्लेषण की तकनीकी मांगों को पूरा करने में चुनौतियों का सामना करना पड़ता है। इसलिए, ETL प्रक्रियाओं की आवश्यकता को न्यूनतम या समाप्त करने के लिए zero-ETL नामक एक नया डेटा प्रबंधन आर्किटेक्चर उभरा है।
Zero-ETL क्या है?
Zero-ETL एक इंटीग्रेशन प्रणाली है जिसे ETL डेटा पाइपलाइनों को बनाने की आवश्यकता को समाप्त या कम करने के लिए डिज़ाइन किया गया है। विभिन्न डेटा साइलोज़ में बिना डेटा को भौतिक रूप से स्थानांतरित किए क्वेरी सक्षम करके, zero-ETL का लक्ष्य डेटा प्रोसेसिंग को सुव्यवस्थित करना और दक्षता में सुधार करना है।
“zero-ETL” शब्द 2022 में AWS re:Invent सम्मेलन के दौरान पेश किया गया था, जब Amazon Aurora का Amazon Redshift के साथ एकीकरण की घोषणा की गई थी। तब से, AWS ने इस अवधारणा को आगे बढ़ाया है, मुख्य रूप से ऐसी सेवाओं के माध्यम से जो डेटा प्लेटफ़ॉर्म के भीतर सीधे डेटा विश्लेषण और रूपांतरण का समर्थन करती हैं, जिनके लिए अलग ETL पाइपलाइनों की आवश्यकता नहीं होती।
एक सामान्य ETL डेटा प्रोसेसिंग पाइपलाइन में, कोई डेटा प्रोफेशनल, जैसे डेटा इंजीनियर या डेटा वैज्ञानिक, किसी स्रोत से डेटा एकत्र करता है, जैसे कि कोई डेटाबेस, कोई API, कोई JSON, या कोई XML फ़ाइल।
डेटा निकालने के बाद, विभिन्न रूपांतरण लागू किए जाते हैं, जैसे डेटा को संयोजित करना, गणनाएँ करना, तालिकाओं का मर्ज करना, या टाइमस्टैम्प या यूज़र IDs जैसी अनावश्यक जानकारी को हटाना।
अंततः, रूपांतरित डेटा को आगे के विश्लेषण के लिए किसी प्लेटफ़ॉर्म पर लोड किया जाता है, जैसे मशीन लर्निंग, सांख्यिकीय विश्लेषण, या डेटा विज़ुअलाइज़ेशन। इस प्रक्रिया में जटिलता के कारण काफ़ी समय, लागत और प्रयास लगता है।
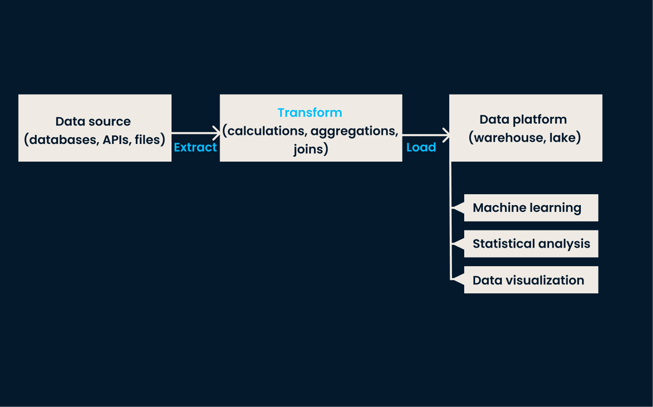
पारंपरिक ETL आर्किटेक्चर
यह उपमा देखें: पारंपरिक फ़ोटोग्राफ़ी में, एक तस्वीर नेगेटिव फ़िल्म पर ली जाती है (डेटा एक्सट्रैक्शन), डार्क रूम में प्रोसेस होती है (ट्रांसफ़ॉर्मेशन), और फिर डेवलप करके प्रदर्शित की जाती है (लोडिंग)। अब एक डिजिटल कैमरे की कल्पना करें, जहाँ तस्वीर एक ही जगह पर कैप्चर, डेवलप, और प्रदर्शित करने के लिए तैयार हो जाती है (या लाइव प्रसारण में तुरंत प्रेषित हो जाती है)।
इसी तरह, zero-ETL डेटा प्रोसेसिंग को बदल देता है—एक्सट्रैक्शन, ट्रांसफ़ॉर्मेशन, और लोडिंग को समाप्त करके। यह आर्किटेक्चर डेटा मूवमेंट को न्यूनतम करता है और हमें एक ही प्लेटफ़ॉर्म में सभी डेटा को ट्रांसफ़ॉर्म और विश्लेषित करने में सक्षम बनाता है।
Zero-ETL डेटा वैज्ञानिकों और व्यवसायिक हितधारकों के लिए रियल-टाइम या न्यूनतम विलंबता के साथ डेटा एनालिटिक्स का वादा करता है।
Zero-ETL कैसे काम करता है?
Zero-ETL डेटा स्रोतों को सीधे डेटा वेयरहाउस या लेक से जोड़कर डेटा इंटीग्रेशन को सरल बनाता है, जिससे एनालिटिक्स और रिपोर्टिंग के लिए रियल-टाइम डेटा उपलब्धता सुनिश्चित होती है। यह कई क्लाउड-आधारित तकनीकों और सेवाओं के माध्यम से संभव होता है, जैसे:
डेटाबेस रेप्लिकेशन
डेटाबेस रेप्लिकेशन एक डेटाबेस से दूसरे में डेटा की कॉपी और सिंक्रोनाइज़ेशन की प्रक्रिया है।
डेटाबेस और डेटा वेयरहाउस के बीच zero-ETL के संदर्भ में, रेप्लिकेशन सुनिश्चित करता है कि डेटा वेयरहाउस में डेटा रियल-टाइम या लगभग रियल-टाइम में स्वचालित रूप से अपडेट हो जाए, जिससे अलग ETL प्रक्रियाओं की आवश्यकता समाप्त हो। यह Amazon Aurora और Amazon Redshift के बीच इंटीग्रेशन के मामले में देखा जाता है।
फ़ेडरेटेड क्वेरींग
फ़ेडरेटेड क्वेरींग से तात्पर्य है कि आप कई डेटा स्रोतों—जैसे डेटाबेस, डेटा वेयरहाउस, या डेटा लेक—पर बिना डेटा को एक ही स्थान पर ले जाए या रेप्लिकेट किए क्वेरी चला सकते हैं।
Zero-ETL के संदर्भ में, फ़ेडरेटेड क्वेरींग डेटा प्रोफेशनल्स को विभिन्न डेटा प्लेटफ़ॉर्म पर संग्रहीत डेटा तक सीधे पहुँचने और उसका विश्लेषण करने में सक्षम बनाता है, जिससे पारंपरिक ETL प्रक्रियाओं के ओवरहेड के बिना डेटा का एकीकृत दृश्य मिलता है।
डेटा स्ट्रीमिंग
डेटा स्ट्रीमिंग का अर्थ है जैसे-जैसे डेटा उत्पन्न होता है, उसका सतत, रियल-टाइम प्रोसेसिंग और ट्रांसफ़र।
Zero-ETL में, डेटा स्ट्रीमिंग में कई स्रोतों (जैसे डेटाबेस, IoT डिवाइसेज़, या एप्लिकेशन) से डेटा कैप्चर करना और उसे तुरंत डेटा वेयरहाउस या डेटा लेक तक पहुँचाना शामिल है। इससे डेटा लगभग तुरंत विश्लेषण और क्वेरी के लिए उपलब्ध हो जाता है, बैच ETL प्रक्रियाओं के बिना।
इन-प्लेस डेटा एनालिटिक्स
इन-प्लेस डेटा एनालिटिक्स प्राप्त करने के लिए आवश्यक ट्रांसफ़ॉर्मेशन को क्लाउड डेटा प्लेटफ़ॉर्म, जैसे डेटा लेक, में एकीकृत किया जाता है। यह एकीकरण डेटा जहाँ स्थित है वहीं पर रियल-टाइम प्रोसेसिंग और विश्लेषण की अनुमति देता है, जिससे विलंबता कम होती है और दक्षता बढ़ती है।
उदाहरण के लिए, JSON या XML फ़ॉर्मेट में एकत्र किया गया असंरचित डेटा “schema-on-read” तकनीकों का उपयोग करके स्वयं डेटा लेक के भीतर ही रूपांतरित और विश्लेषित किया जाएगा, जिससे रिपोर्टिंग-रेडी स्टोरेज तक डेटा मूवमेंट के मध्यवर्ती चरण समाप्त हो जाते हैं।
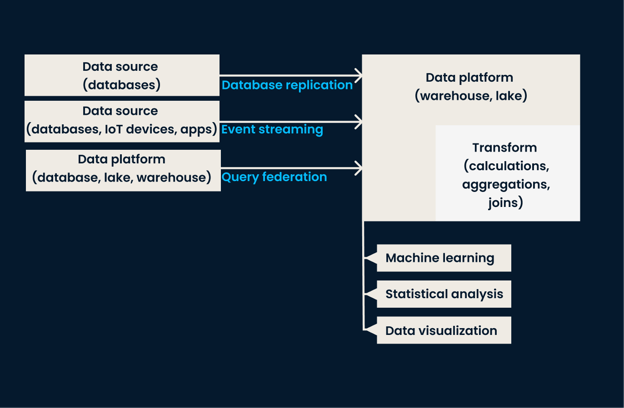
उदाहरण Zero-ETL डेटा आर्किटेक्चर
Zero-ETL के विभिन्न घटक
यद्यपि zero-ETL आर्किटेक्चर सुनने में ऐसा लग सकता है कि इसमें कोई घटक नहीं हैं या सभी घटक एकीकृत हैं, फिर भी लक्ष्य एनालिटिक्स और संसाधनों की आवश्यकताओं के अनुसार विभिन्न तत्व और सेवाएँ उपयोग की जा सकती हैं। इन सेवाओं में शामिल हैं:
डायरेक्ट डेटा इंटीग्रेशन सेवाएँ
क्लाउड प्रदाता ऐसी विशेष सेवाएँ प्रदान करते हैं जो zero-ETL इंटीग्रेशन को स्वचालित करती हैं। जैसा कि पहले उल्लेख किया गया, AWS Amazon Aurora का Amazon Redshift के साथ इंटीग्रेशन प्रदान करता है, जहाँ Aurora में लिखा गया डेटा स्वतः Redshift में रेप्लिकेट हो जाता है। ये सेवाएँ आंतरिक रूप से डेटा रेप्लिकेशन और ट्रांसफ़ॉर्मेशन का प्रबंधन करती हैं, जिससे पारंपरिक ETL प्रक्रियाओं की आवश्यकता समाप्त हो जाती है।
चेंज डेटा कैप्चर (CDC)
CDC तकनीक zero-ETL आर्किटेक्चर का एक मुख्य तत्व है। यह स्रोत डेटाबेस में होने वाले परिवर्तनों (इन्सर्ट, अपडेट, डिलीट) की निरंतर निगरानी और कैप्चर करती है और इन परिवर्तनों को रियल-टाइम में लक्ष्य प्रणालियों में रेप्लिकेट करती है।
स्ट्रीमिंग डेटा पाइपलाइंस
स्ट्रीमिंग पाइपलाइंस विभिन्न स्रोतों से डेटा को रियल-टाइम में लक्ष्य प्रणाली तक ले जाती हैं। Amazon Kinesis और Apache Kafka जैसे प्लेटफ़ॉर्म सतत डेटा प्रवाह सक्षम करते हैं, जिससे कम-विलंबता अपडेट सुनिश्चित होते हैं।
सर्वरलेस कंप्यूटिंग
सर्वरलेस आर्किटेक्चर आवश्यक इन्फ्रास्ट्रक्चर को स्वतः प्रबंधित करके और मांग के आधार पर संसाधनों को स्केल करके zero-ETL का समर्थन करते हैं। AWS Lambda और Google Cloud Functions जैसी सेवाएँ डेटा इवेंट्स के प्रत्युत्तर में फ़ंक्शंस चलने की अनुमति देकर इस दृष्टिकोण का उदाहरण हैं।
स्कीमा-ऑन-रीड तकनीकें
डेटा लिखते समय के बजाय पढ़ते समय स्कीमा लागू करके, स्कीमा-ऑन-रीड JSON और XML जैसे असंरचित तथा अर्ध-संरचित डेटा फ़ॉर्मेट्स को संभालने में लचीलापन प्रदान करता है। यह दृष्टिकोण पूर्वपरिभाषित स्कीमाओं की आवश्यकता को कम करता है और गतिशील डेटा विश्लेषण की अनुमति देता है।
डेटा फ़ेडरेशन और एब्स्ट्रैक्शन
Zero-ETL डेटा फ़ेडरेशन के माध्यम से विभिन्न स्रोतों से डेटा के इन्गेशन और डुप्लीकेशन को सुगम बनाता है। इसमें डेटा लेक और क्रॉस-प्लेटफ़ॉर्म डेटा वर्चुअलाइज़ेशन का उपयोग करके एक अमूर्त ऑब्जेक्ट लेयर बनाना शामिल है, जो व्यापक ट्रांसफ़ॉर्मेशन और डेटा मूवमेंट की आवश्यकता के बिना डेटा डुप्लीकेशन को सरल बनाता है। डेटा वर्चुअलाइज़ेशन उपयोगकर्ताओं को ऐसे अलग-अलग सिस्टम में मौजूद डेटा तक पहुँचने और क्वेरी करने की अनुमति देता है मानो वह एक ही स्थान पर हो।
डेटा लेक
Zero-ETL दृष्टिकोण में ट्रांसफ़ॉर्मेशन और विश्लेषण डेटा प्लेटफ़ॉर्म के भीतर किए जाते हैं। यह मल्टी-फ़ॉर्मेट डेटा स्टोरेज सिस्टम, जैसे डेटा लेक, में विभिन्न फ़ॉर्मेट (वीडियो, इमेज, टेक्स्ट और संख्यात्मक) में असंरचित डेटा के प्रबंधन की अनुमति देता है, अक्सर मध्यवर्ती ट्रांसफ़ॉर्मेशन की आवश्यकता के बिना।
Zero-ETL के लाभ और सीमाएँ
Zero-ETL डेटा साइंस में दक्षता बढ़ाने का एक आशाजनक दृष्टिकोण लग सकता है। हालाँकि, यह महत्वपूर्ण है कि zero-ETL के कार्यान्वयन से होने वाले लाभों और सीमाओं—दोनों—की तुलना की जाए।
Zero-ETL के लाभ
Zero-ETL डेटा प्रबंधन और डेटा एनालिटिक्स में कई लाभ लाता है, जिनमें शामिल हैं:
- सुव्यवस्थित इंजीनियरिंग: Zero-ETL डेटा पाइपलाइन आर्किटेक्चर को सरल बनाता है—एक्सट्रैक्शन, ट्रांसफ़ॉर्मेशन, और लोडिंग को एक ही प्रक्रिया में एकीकृत करके या इसे पूरी तरह समाप्त करके। यह सुव्यवस्थापन जटिलता कम करता है और डेटा एनालिटिक्स तथा मशीन लर्निंग कार्यों को तेज़ करता है, जिससे डेटा वैज्ञानिक तेजी से इनसाइट्स प्राप्त कर सकें।
- रियल-टाइम एनालिटिक्स: Zero-ETL डेटा प्लेटफ़ॉर्म में सीधे एक्सट्रैक्शन, ट्रांसफ़ॉर्मेशन और लोडिंग चरणों को समाहित करके रियल-टाइम डेटा एनालिटिक्स सक्षम करता है। जैसे ही नया डेटा एकत्र होता है, उसका तुरंत विश्लेषण किया जा सकता है, जिससे तेज़ निर्णय-निर्माण और समय पर इनसाइट्स संभव होते हैं।
Zero-ETL की सीमाएँ
इसके लाभों के बावजूद, zero-ETL कुछ चुनौतियाँ भी प्रस्तुत कर सकता है, जिनमें शामिल हैं:
- जटिल ट्रबलशूटिंग: समस्याओं की पहचान और समाधान अधिक जटिल हो सकता है क्योंकि सभी डेटा प्रक्रियाएँ एक ही समेकित चरण में होती हैं। समस्याओं के स्रोत को अलग-थलग करने के लिए पूरे सिस्टम की गहरी समझ आवश्यक होती है।
- कठिन सीखने की वक्र: पारंपरिक ETL पाइपलाइनों को समाप्त करना मध्यवर्ती डेटा इंजीनियरिंग भूमिकाओं की आवश्यकता को कम कर सकता है। यह बदलाव डेटा वैज्ञानिकों और मशीन लर्निंग इंजीनियरों के लिए सीखने की अधिक तीखी वक्र का कारण बन सकता है, जिन्हें अब वे कार्य भी संभालने होंगे जो पहले डेटा इंजीनियर करते थे।
- क्लाउड पर निर्भरता: Zero-ETL समाधान आमतौर पर डिज़ाइन से ही क्लाउड-आधारित होते हैं। जो संगठन अभी अपने सिस्टम में क्लाउड तकनीकों को एकीकृत करने के लिए तैयार नहीं हैं, उन्हें zero-ETL अपनाने में चुनौतियों का सामना करना पड़ सकता है। यह निर्भरता डेटा सुरक्षा, अनुपालन, और नियंत्रण के बारे में चिंताएँ बढ़ा सकती है।
Zero-ETL के सामान्य उपयोग-परिदृश्य
Zero-ETL विभिन्न रियल-टाइम डेटा प्रोसेसिंग और एनालिटिक्स परिदृश्यों में महत्वपूर्ण लाभ प्रदान करता है। यहाँ कुछ सामान्य उपयोग-परिदृश्य हैं:
- रियल-टाइम एनालिटिक्स: Zero-ETL पारंपरिक बैच ETL प्रक्रिया को समाप्त करता है और नए उत्पन्न डेटा—जैसे ग्राहक इंटरैक्शन, उपयोगकर्ता व्यवहार, और वाहन ट्रैफिक पैटर्न—तक रियल-टाइम पहुँच सक्षम करता है। यह स्वचालन टीमों को तुरंत डेटा-आधारित निर्णय लेने देता है, जिससे प्रतिक्रियाशीलता और परिचालन दक्षता में सुधार होता है।
- तत्काल डेटा ट्रांसफ़र: Zero-ETL डेटा प्रबंधन आर्किटेक्चर में, ETL पाइपलाइन को समाप्त करने का अर्थ है कि डेटा वैज्ञानिकों की पहुँच के लिए किसी अन्य वेयरहाउस में डेटा का डुप्लीकेशन काफ़ी तेज़ी से या यहाँ तक कि रियल-टाइम में हो जाता है।
- मशीन लर्निंग और AI: Zero-ETL विशेष रूप से मशीन लर्निंग और आर्टिफ़िशियल इंटेलिजेंस अनुप्रयोगों के लिए उपयोगी है, जहाँ समय पर डेटा प्रमुख होता है। रियल-टाइम डेटा स्ट्रीमिंग और तत्काल उपलब्धता नवीनतम डेटा से मशीन लर्निंग मॉडलों के सतत प्रशिक्षण और अपडेटिंग में सक्षम बनाती है, जिससे AI भविष्यवाणियों और इनसाइट्स की सटीकता और प्रासंगिकता में सुधार होता है।
Zero-ETL बनाम पारंपरिक ETL की तुलना
निम्न तालिका Zero-ETL और पारंपरिक ETL प्रक्रियाओं के बीच विस्तृत तुलना प्रदान करती है।
|
|
Zero-ETL
|
पारंपरिक ETL
|
|
डेटा वर्चुअलाइज़ेशन
|
यह वेयरहाउस में डेटा के डुप्लीकेशन को सरल बनाने के लिए डेटा वर्चुअलाइज़ेशन तकनीकों का उपयोग करता है।
|
ETL में डेटा रूपांतरण से लोडिंग चरण तक ले जाया जाता है, इसलिए डेटा वर्चुअलाइज़ेशन अनावश्यक या लागू करने में चुनौतीपूर्ण हो सकता है।
|
|
डेटा गुणवत्ता निगरानी
|
यह मूलतः एक स्वचालित डेटा प्रबंधन दृष्टिकोण है; इसलिए डेटा गुणवत्ता के मुद्दे उत्पन्न हो सकते हैं।
|
ETL में डेटा मूवमेंट पाइपलाइन की डिस्क्रीट प्रकृति के कारण डेटा गुणवत्ता का बेहतर निगरानी और निवारण किया जा सकता है।
|
|
डेटा प्रकार विविधता
|
क्लाउड-आधारित डेटा लेक आर्किटेक्चरल बाधाओं के बिना कई डेटा प्रकारों और फ़ॉर्मेट्स की अनुमति देते हैं।
|
एक्सट्रैक्शन और ट्रांसफ़ॉर्मेशन आर्किटेक्चर डेटा प्रकारों को सीमित कर सकता है (विभिन्न प्रकार के डेटा के लिए एक्सट्रैक्शन और ट्रांसफ़ॉर्मेशन चरणों में अतिरिक्त इंजीनियरिंग प्रयास की आवश्यकता होती है)।
|
|
रियल-टाइम परिनियोजन
|
डेटा जनरेशन से लेकर ट्रांसफ़ॉर्मेशन और विश्लेषण तक न्यूनतम विलंबता के साथ प्लेटफ़ॉर्म में ही डेटा विश्लेषण किया जा सकता है।
|
पाइपलाइन की अनुसूचित बैच प्रकृति रियल-टाइम डेटा विश्लेषण को रोकती है।
|
|
लागत और मेंटेनेंस
|
यह अधिक किफ़ायती और मेंटेन करना आसान होता है क्योंकि इसमें कम कंप्यूटेशनल कंपोनेंट्स और कोडिंग की आवश्यकता होती है। डेटा ट्रांसफ़ॉर्मेशन और लोडिंग ऑन-डिमांड की जा सकती है।
|
यह अधिक महँगा है क्योंकि इसमें अधिक कंप्यूटेशनल संसाधन और अनुभवी डेटा प्रोफेशनल्स की आवश्यकता होती है।
|
|
स्केल
|
मध्यवर्ती हार्डवेयर के उन्मूलन के कारण स्केल करना तेज़ और कम महँगा होता है।
|
अधिक डेटा स्रोतों को समायोजित करने के लिए बेहतर हार्डवेयर और कोड ऑप्टिमाइज़ेशन की बढ़ी हुई आवश्यकता के कारण यह धीमा और महँगा हो सकता है।
|
|
डेटा मूवमेंट
|
न के बराबर या न्यूनतम।
|
पाइपलाइन डिस्क्रीट होने के कारण डेटा को लोडिंग चरण तक स्थानांतरित करना आवश्यक होता है, इसलिए डेटा मूवमेंट आवश्यक है।
|
Zero-ETL बनाम अन्य डेटा इंटीग्रेशन तकनीकें
नीचे zero-ETL और अन्य प्रमुख डेटा इंटीग्रेशन तकनीकों की तुलना दी गई है, जो उनकी समानताओं और प्रमुख अंतरों को उजागर करती है।
Zero-ETL बनाम ELT
- समानताएँ: Zero-ETL और ELT (Extract, Load, Transform) डेटा ट्रांसफ़ॉर्मेशन प्रक्रिया को लक्ष्य प्रणाली में डेटा लोड होने तक टालकर डेटा एनालिटिक्स के समय और जटिलता को कम करते हैं। ELT को zero-ETL का पूर्ववर्ती माना जाता है, क्योंकि इसने डेटा प्रोसेसिंग पाइपलाइन में ट्रांसफ़ॉर्मेशन को बाद के चरण तक टालने की नींव रखी।
- मुख्य अंतर: Zero-ETL, ELT दृष्टिकोण में आवश्यक मध्यवर्ती स्टेजिंग चरण को समाप्त कर देता है, इस प्रकार विलंबता को न्यूनतम करता है और रियल-टाइम डेटा उपलब्धता में सुधार करता है। Zero-ETL कदमों और इन्फ्रास्ट्रक्चर आवश्यकताओं की संख्या घटाकर डेटा पाइपलाइन को और सरल बनाता है।
Zero-ETL बनाम API
- समानताएँ: Zero-ETL और APIs कई डेटा स्रोतों पर क्वेरियों को सक्षम करते हैं, जिससे विभिन्न सिस्टम्स में डेटा इंटीग्रेशन सुगम होता है।
- मुख्य अंतर: Zero-ETL मुख्यतः एक “codeless” तकनीक है, जिसमें डेटा इंटीग्रेशन और प्रबंधन के लिए न्यूनतम मैनुअल कोडिंग की आवश्यकता होती है। इसके विपरीत, APIs को विभिन्न डेटा स्रोतों से कनेक्ट करने और इंटरेक्ट करने के लिए कस्टम कोड की आवश्यकता होती है। इसके अतिरिक्त, इंटीग्रेशन की कोड-आधारित प्रकृति के कारण APIs सुरक्षा उल्लंघनों के प्रति अधिक संवेदनशील हो सकते हैं, जो उचित रूप से प्रबंधित और सुरक्षित न होने पर कमजोरियाँ प्रस्तुत कर सकते हैं।
शीर्ष Zero-ETL टूल्स
जैसा कि हमने इस ब्लॉग पोस्ट में देखा, zero-ETL एक अत्याधुनिक डेटा प्रबंधन टूल है जिसने उद्योग में पकड़ बनाई है, जिसे बड़े पैमाने पर AWS ने लोकप्रिय बनाया है और अन्य क्लाउड प्रदाताओं ने अपनाया है।
आज उपलब्ध शीर्ष zero-ETL टूल्स का एक संक्षिप्त अवलोकन प्रस्तुत है:
AWS के zero-ETL टूल्स
- Aurora और Redshift का डायरेक्ट इंटीग्रेशन: AWS ने Amazon Aurora और Amazon Redshift को इस तरह एकीकृत किया है कि पारंपरिक ETL प्रक्रियाओं की आवश्यकता के बिना रियल-टाइम एनालिटिक्स संभव हो सके।
- Redshift Spectrum: उपयोगकर्ताओं को Amazon S3 में एग्ज़ाबाइट्स डेटा पर बिना डेटा लोड या ट्रांसफ़ॉर्म किए SQL क्वेरी चलाने की अनुमति देता है। यह सेवा संरचित और असंरचित डेटा की सहज क्वेरींग को सपोर्ट करती है, जो विविध डेटा सेट्स के लिए आदर्श है।
- Amazon Athena: एक सर्वरलेस एनालिटिक्स समाधान जो इन-प्लेस एनालिटिक्स के लिए बड़े पैमाने पर डेटा प्रोसेस करता है, जिसमें मशीन लर्निंग और AI भी शामिल हैं, तथा क्लाउड सेवाओं से स्ट्रीमिंग डेटा को जोड़ने के लिए SQL या Python का उपयोग करता है।
- Amazon Redshift Streaming Ingestion: एक सेवा जो Amazon Kinesis Data Streams या Amazon MSK से रियल-टाइम डेटा इन्गेशन प्रदान करती है, और गहन रियल-टाइम मशीन लर्निंग कार्यों का समर्थन करती है।
अन्य क्लाउड प्रदाताओं के Zero-ETL टूल्स
AWS के अलावा, अन्य क्लाउड प्रदाता भी zero-ETL क्षमताओं वाले एकीकृत डेटा प्लेटफ़ॉर्म प्रदान करते हैं:
- Snowflake: zero-ETL आर्किटेक्चर का उपयोग करके असंरचित डेटा को संभालने में सक्षम डेटा वेयरहाउस और लेक बनाने का समर्थन करता है। Snowflake डेटा वर्कफ़्लोज़ को सरल बनाता है और रियल-टाइम एनालिटिक्स तथा मशीन लर्निंग को सपोर्ट करता है।
- Google BigQuery: बड़े डेटा सेट्स पर रियल-टाइम में जटिल SQL क्वेरी निष्पादित करता है, और रियल-टाइम एनालिटिक्स के लिए अन्य Google Cloud सेवाओं के साथ सहज इंटीग्रेशन को सपोर्ट करता है। BigQuery बेहद बड़े पैमाने के डेटा को कुशलतापूर्वक संभालने के लिए डिज़ाइन किया गया है।
- Microsoft Azure Synapse Analytics: एकीकृत एनालिटिक्स प्लेटफ़ॉर्म के साथ रियल-टाइम डेटा इन्गेशन और विश्लेषण प्रदान करता है, जो उन्नत एनालिटिक्स और बिज़नेस इंटेलिजेंस अनुप्रयोगों का समर्थन करता है। Synapse विभिन्न Azure सेवाओं के साथ इंटीग्रेट होता है।
निष्कर्ष
डेटा एनालिटिक्स और मशीन लर्निंग पाइपलाइन में पारंपरिक ETL चरणों को समाप्त करना डेटा इंजीनियरिंग प्रतिमान में एक महत्वपूर्ण बदलाव है। Zero-ETL आर्किटेक्चर का एकीकरण उल्लेखनीय लाभ प्रदान करता है, जिनमें बढ़ी हुई गति, उन्नत सुरक्षा, और अधिक स्केलेबिलिटी शामिल हैं।
हालाँकि, यह बदलाव चुनौतियाँ भी लाता है। पारंपरिक डेटा इंजीनियरिंग कौशल की आवश्यकता कम हो सकती है, जिससे डेटा विश्लेषकों, मशीन लर्निंग वैज्ञानिकों, और डेटा वैज्ञानिकों को अधिक उन्नत डेटा इंटीग्रेशन अवधारणाएँ और कौशल हासिल करने की आवश्यकता होगी।
Zero-ETL डेटा विश्लेषकों और मशीन लर्निंग इंजीनियरों की आवश्यकताओं पर केंद्रित है, और यह संकेत देता है कि भविष्य में ये भूमिकाएँ अधिक केंद्रीय हो सकती हैं, जो संभावित रूप से नौकरी बाजार की मांगों और कौशल सेट्स को पुनः आकार देंगी।
यदि आप डेटा आर्किटेक्चर के बारे में और सीखने में रुचि रखते हैं, तो हमारा ETL और ELT in Python कोर्स देखें!


आधुनिक व्यवसायों में डेटा इनसाइट्स को तैनात करने में लगने वाले समय को न्यूनतम करने की आवश्यकता तेजी से बढ़ रही है। डेटा संग्रह से एनालिटिक्स, आर्टिफ़िशियल इंटेलिजेंस, और मशीन लर्निंग के कार्यान्वयन तक के संक्रमण को तेज करने के लिए एक तेज़ दृष्टिकोण आवश्यक है।
पारंपरिक ETL (extract, transform, load) आर्किटेक्चर को बिग डेटा और रियल-टाइम डेटा विश्लेषण की तकनीकी मांगों को पूरा करने में चुनौतियों का सामना करना पड़ता है। इसलिए, ETL प्रक्रियाओं की आवश्यकता को न्यूनतम या समाप्त करने के लिए zero-ETL नामक एक नया डेटा प्रबंधन आर्किटेक्चर उभरा है।
Zero-ETL क्या है?
Zero-ETL एक इंटीग्रेशन प्रणाली है जिसे ETL डेटा पाइपलाइनों को बनाने की आवश्यकता को समाप्त या कम करने के लिए डिज़ाइन किया गया है। विभिन्न डेटा साइलोज़ में बिना डेटा को भौतिक रूप से स्थानांतरित किए क्वेरी सक्षम करके, zero-ETL का लक्ष्य डेटा प्रोसेसिंग को सुव्यवस्थित करना और दक्षता में सुधार करना है।
“zero-ETL” शब्द 2022 में AWS re:Invent सम्मेलन के दौरान पेश किया गया था, जब Amazon Aurora का Amazon Redshift के साथ एकीकरण की घोषणा की गई थी। तब से, AWS ने इस अवधारणा को आगे बढ़ाया है, मुख्य रूप से ऐसी सेवाओं के माध्यम से जो डेटा प्लेटफ़ॉर्म के भीतर सीधे डेटा विश्लेषण और रूपांतरण का समर्थन करती हैं, जिनके लिए अलग ETL पाइपलाइनों की आवश्यकता नहीं होती।
एक सामान्य ETL डेटा प्रोसेसिंग पाइपलाइन में, कोई डेटा प्रोफेशनल, जैसे डेटा इंजीनियर या डेटा वैज्ञानिक, किसी स्रोत से डेटा एकत्र करता है, जैसे कि कोई डेटाबेस, कोई API, कोई JSON, या कोई XML फ़ाइल।
डेटा निकालने के बाद, विभिन्न रूपांतरण लागू किए जाते हैं, जैसे डेटा को संयोजित करना, गणनाएँ करना, तालिकाओं का मर्ज करना, या टाइमस्टैम्प या यूज़र IDs जैसी अनावश्यक जानकारी को हटाना।
अंततः, रूपांतरित डेटा को आगे के विश्लेषण के लिए किसी प्लेटफ़ॉर्म पर लोड किया जाता है, जैसे मशीन लर्निंग, सांख्यिकीय विश्लेषण, या डेटा विज़ुअलाइज़ेशन। इस प्रक्रिया में जटिलता के कारण काफ़ी समय, लागत और प्रयास लगता है।
पारंपरिक ETL आर्किटेक्चर
यह उपमा देखें: पारंपरिक फ़ोटोग्राफ़ी में, एक तस्वीर नेगेटिव फ़िल्म पर ली जाती है (डेटा एक्सट्रैक्शन), डार्क रूम में प्रोसेस होती है (ट्रांसफ़ॉर्मेशन), और फिर डेवलप करके प्रदर्शित की जाती है (लोडिंग)। अब एक डिजिटल कैमरे की कल्पना करें, जहाँ तस्वीर एक ही जगह पर कैप्चर, डेवलप, और प्रदर्शित करने के लिए तैयार हो जाती है (या लाइव प्रसारण में तुरंत प्रेषित हो जाती है)।
इसी तरह, zero-ETL डेटा प्रोसेसिंग को बदल देता है—एक्सट्रैक्शन, ट्रांसफ़ॉर्मेशन, और लोडिंग को समाप्त करके। यह आर्किटेक्चर डेटा मूवमेंट को न्यूनतम करता है और हमें एक ही प्लेटफ़ॉर्म में सभी डेटा को ट्रांसफ़ॉर्म और विश्लेषित करने में सक्षम बनाता है।
Zero-ETL डेटा वैज्ञानिकों और व्यवसायिक हितधारकों के लिए रियल-टाइम या न्यूनतम विलंबता के साथ डेटा एनालिटिक्स का वादा करता है।
Zero-ETL कैसे काम करता है?
Zero-ETL डेटा स्रोतों को सीधे डेटा वेयरहाउस या लेक से जोड़कर डेटा इंटीग्रेशन को सरल बनाता है, जिससे एनालिटिक्स और रिपोर्टिंग के लिए रियल-टाइम डेटा उपलब्धता सुनिश्चित होती है। यह कई क्लाउड-आधारित तकनीकों और सेवाओं के माध्यम से संभव होता है, जैसे:
डेटाबेस रेप्लिकेशन
डेटाबेस रेप्लिकेशन एक डेटाबेस से दूसरे में डेटा की कॉपी और सिंक्रोनाइज़ेशन की प्रक्रिया है।
डेटाबेस और डेटा वेयरहाउस के बीच zero-ETL के संदर्भ में, रेप्लिकेशन सुनिश्चित करता है कि डेटा वेयरहाउस में डेटा रियल-टाइम या लगभग रियल-टाइम में स्वचालित रूप से अपडेट हो जाए, जिससे अलग ETL प्रक्रियाओं की आवश्यकता समाप्त हो। यह Amazon Aurora और Amazon Redshift के बीच इंटीग्रेशन के मामले में देखा जाता है।
फ़ेडरेटेड क्वेरींग
फ़ेडरेटेड क्वेरींग से तात्पर्य है कि आप कई डेटा स्रोतों—जैसे डेटाबेस, डेटा वेयरहाउस, या डेटा लेक—पर बिना डेटा को एक ही स्थान पर ले जाए या रेप्लिकेट किए क्वेरी चला सकते हैं।
Zero-ETL के संदर्भ में, फ़ेडरेटेड क्वेरींग डेटा प्रोफेशनल्स को विभिन्न डेटा प्लेटफ़ॉर्म पर संग्रहीत डेटा तक सीधे पहुँचने और उसका विश्लेषण करने में सक्षम बनाता है, जिससे पारंपरिक ETL प्रक्रियाओं के ओवरहेड के बिना डेटा का एकीकृत दृश्य मिलता है।
डेटा स्ट्रीमिंग
डेटा स्ट्रीमिंग का अर्थ है जैसे-जैसे डेटा उत्पन्न होता है, उसका सतत, रियल-टाइम प्रोसेसिंग और ट्रांसफ़र।
Zero-ETL में, डेटा स्ट्रीमिंग में कई स्रोतों (जैसे डेटाबेस, IoT डिवाइसेज़, या एप्लिकेशन) से डेटा कैप्चर करना और उसे तुरंत डेटा वेयरहाउस या डेटा लेक तक पहुँचाना शामिल है। इससे डेटा लगभग तुरंत विश्लेषण और क्वेरी के लिए उपलब्ध हो जाता है, बैच ETL प्रक्रियाओं के बिना।
इन-प्लेस डेटा एनालिटिक्स
इन-प्लेस डेटा एनालिटिक्स प्राप्त करने के लिए आवश्यक ट्रांसफ़ॉर्मेशन को क्लाउड डेटा प्लेटफ़ॉर्म, जैसे डेटा लेक, में एकीकृत किया जाता है। यह एकीकरण डेटा जहाँ स्थित है वहीं पर रियल-टाइम प्रोसेसिंग और विश्लेषण की अनुमति देता है, जिससे विलंबता कम होती है और दक्षता बढ़ती है।
उदाहरण के लिए, JSON या XML फ़ॉर्मेट में एकत्र किया गया असंरचित डेटा “schema-on-read” तकनीकों का उपयोग करके स्वयं डेटा लेक के भीतर ही रूपांतरित और विश्लेषित किया जाएगा, जिससे रिपोर्टिंग-रेडी स्टोरेज तक डेटा मूवमेंट के मध्यवर्ती चरण समाप्त हो जाते हैं।
उदाहरण Zero-ETL डेटा आर्किटेक्चर
Zero-ETL के विभिन्न घटक
यद्यपि zero-ETL आर्किटेक्चर सुनने में ऐसा लग सकता है कि इसमें कोई घटक नहीं हैं या सभी घटक एकीकृत हैं, फिर भी लक्ष्य एनालिटिक्स और संसाधनों की आवश्यकताओं के अनुसार विभिन्न तत्व और सेवाएँ उपयोग की जा सकती हैं। इन सेवाओं में शामिल हैं:
डायरेक्ट डेटा इंटीग्रेशन सेवाएँ
क्लाउड प्रदाता ऐसी विशेष सेवाएँ प्रदान करते हैं जो zero-ETL इंटीग्रेशन को स्वचालित करती हैं। जैसा कि पहले उल्लेख किया गया, AWS Amazon Aurora का Amazon Redshift के साथ इंटीग्रेशन प्रदान करता है, जहाँ Aurora में लिखा गया डेटा स्वतः Redshift में रेप्लिकेट हो जाता है। ये सेवाएँ आंतरिक रूप से डेटा रेप्लिकेशन और ट्रांसफ़ॉर्मेशन का प्रबंधन करती हैं, जिससे पारंपरिक ETL प्रक्रियाओं की आवश्यकता समाप्त हो जाती है।
चेंज डेटा कैप्चर (CDC)
CDC तकनीक zero-ETL आर्किटेक्चर का एक मुख्य तत्व है। यह स्रोत डेटाबेस में होने वाले परिवर्तनों (इन्सर्ट, अपडेट, डिलीट) की निरंतर निगरानी और कैप्चर करती है और इन परिवर्तनों को रियल-टाइम में लक्ष्य प्रणालियों में रेप्लिकेट करती है।
स्ट्रीमिंग डेटा पाइपलाइंस
स्ट्रीमिंग पाइपलाइंस विभिन्न स्रोतों से डेटा को रियल-टाइम में लक्ष्य प्रणाली तक ले जाती हैं। Amazon Kinesis और Apache Kafka जैसे प्लेटफ़ॉर्म सतत डेटा प्रवाह सक्षम करते हैं, जिससे कम-विलंबता अपडेट सुनिश्चित होते हैं।
सर्वरलेस कंप्यूटिंग
सर्वरलेस आर्किटेक्चर आवश्यक इन्फ्रास्ट्रक्चर को स्वतः प्रबंधित करके और मांग के आधार पर संसाधनों को स्केल करके zero-ETL का समर्थन करते हैं। AWS Lambda और Google Cloud Functions जैसी सेवाएँ डेटा इवेंट्स के प्रत्युत्तर में फ़ंक्शंस चलने की अनुमति देकर इस दृष्टिकोण का उदाहरण हैं।
स्कीमा-ऑन-रीड तकनीकें
डेटा लिखते समय के बजाय पढ़ते समय स्कीमा लागू करके, स्कीमा-ऑन-रीड JSON और XML जैसे असंरचित तथा अर्ध-संरचित डेटा फ़ॉर्मेट्स को संभालने में लचीलापन प्रदान करता है। यह दृष्टिकोण पूर्वपरिभाषित स्कीमाओं की आवश्यकता को कम करता है और गतिशील डेटा विश्लेषण की अनुमति देता है।
डेटा फ़ेडरेशन और एब्स्ट्रैक्शन
Zero-ETL डेटा फ़ेडरेशन के माध्यम से विभिन्न स्रोतों से डेटा के इन्गेशन और डुप्लीकेशन को सुगम बनाता है। इसमें डेटा लेक और क्रॉस-प्लेटफ़ॉर्म डेटा वर्चुअलाइज़ेशन का उपयोग करके एक अमूर्त ऑब्जेक्ट लेयर बनाना शामिल है, जो व्यापक ट्रांसफ़ॉर्मेशन और डेटा मूवमेंट की आवश्यकता के बिना डेटा डुप्लीकेशन को सरल बनाता है। डेटा वर्चुअलाइज़ेशन उपयोगकर्ताओं को ऐसे अलग-अलग सिस्टम में मौजूद डेटा तक पहुँचने और क्वेरी करने की अनुमति देता है मानो वह एक ही स्थान पर हो।
डेटा लेक
Zero-ETL दृष्टिकोण में ट्रांसफ़ॉर्मेशन और विश्लेषण डेटा प्लेटफ़ॉर्म के भीतर किए जाते हैं। यह मल्टी-फ़ॉर्मेट डेटा स्टोरेज सिस्टम, जैसे डेटा लेक, में विभिन्न फ़ॉर्मेट (वीडियो, इमेज, टेक्स्ट और संख्यात्मक) में असंरचित डेटा के प्रबंधन की अनुमति देता है, अक्सर मध्यवर्ती ट्रांसफ़ॉर्मेशन की आवश्यकता के बिना।
Zero-ETL के लाभ और सीमाएँ
Zero-ETL डेटा साइंस में दक्षता बढ़ाने का एक आशाजनक दृष्टिकोण लग सकता है। हालाँकि, यह महत्वपूर्ण है कि zero-ETL के कार्यान्वयन से होने वाले लाभों और सीमाओं—दोनों—की तुलना की जाए।
Zero-ETL के लाभ
Zero-ETL डेटा प्रबंधन और डेटा एनालिटिक्स में कई लाभ लाता है, जिनमें शामिल हैं:
Zero-ETL की सीमाएँ
इसके लाभों के बावजूद, zero-ETL कुछ चुनौतियाँ भी प्रस्तुत कर सकता है, जिनमें शामिल हैं:
Zero-ETL के सामान्य उपयोग-परिदृश्य
Zero-ETL विभिन्न रियल-टाइम डेटा प्रोसेसिंग और एनालिटिक्स परिदृश्यों में महत्वपूर्ण लाभ प्रदान करता है। यहाँ कुछ सामान्य उपयोग-परिदृश्य हैं:
Zero-ETL बनाम पारंपरिक ETL की तुलना
निम्न तालिका Zero-ETL और पारंपरिक ETL प्रक्रियाओं के बीच विस्तृत तुलना प्रदान करती है।
Zero-ETL
पारंपरिक ETL
डेटा वर्चुअलाइज़ेशन
यह वेयरहाउस में डेटा के डुप्लीकेशन को सरल बनाने के लिए डेटा वर्चुअलाइज़ेशन तकनीकों का उपयोग करता है।
ETL में डेटा रूपांतरण से लोडिंग चरण तक ले जाया जाता है, इसलिए डेटा वर्चुअलाइज़ेशन अनावश्यक या लागू करने में चुनौतीपूर्ण हो सकता है।
डेटा गुणवत्ता निगरानी
यह मूलतः एक स्वचालित डेटा प्रबंधन दृष्टिकोण है; इसलिए डेटा गुणवत्ता के मुद्दे उत्पन्न हो सकते हैं।
ETL में डेटा मूवमेंट पाइपलाइन की डिस्क्रीट प्रकृति के कारण डेटा गुणवत्ता का बेहतर निगरानी और निवारण किया जा सकता है।
डेटा प्रकार विविधता
क्लाउड-आधारित डेटा लेक आर्किटेक्चरल बाधाओं के बिना कई डेटा प्रकारों और फ़ॉर्मेट्स की अनुमति देते हैं।
एक्सट्रैक्शन और ट्रांसफ़ॉर्मेशन आर्किटेक्चर डेटा प्रकारों को सीमित कर सकता है (विभिन्न प्रकार के डेटा के लिए एक्सट्रैक्शन और ट्रांसफ़ॉर्मेशन चरणों में अतिरिक्त इंजीनियरिंग प्रयास की आवश्यकता होती है)।
रियल-टाइम परिनियोजन
डेटा जनरेशन से लेकर ट्रांसफ़ॉर्मेशन और विश्लेषण तक न्यूनतम विलंबता के साथ प्लेटफ़ॉर्म में ही डेटा विश्लेषण किया जा सकता है।
पाइपलाइन की अनुसूचित बैच प्रकृति रियल-टाइम डेटा विश्लेषण को रोकती है।
लागत और मेंटेनेंस
यह अधिक किफ़ायती और मेंटेन करना आसान होता है क्योंकि इसमें कम कंप्यूटेशनल कंपोनेंट्स और कोडिंग की आवश्यकता होती है। डेटा ट्रांसफ़ॉर्मेशन और लोडिंग ऑन-डिमांड की जा सकती है।
यह अधिक महँगा है क्योंकि इसमें अधिक कंप्यूटेशनल संसाधन और अनुभवी डेटा प्रोफेशनल्स की आवश्यकता होती है।
स्केल
मध्यवर्ती हार्डवेयर के उन्मूलन के कारण स्केल करना तेज़ और कम महँगा होता है।
अधिक डेटा स्रोतों को समायोजित करने के लिए बेहतर हार्डवेयर और कोड ऑप्टिमाइज़ेशन की बढ़ी हुई आवश्यकता के कारण यह धीमा और महँगा हो सकता है।
डेटा मूवमेंट
न के बराबर या न्यूनतम।
पाइपलाइन डिस्क्रीट होने के कारण डेटा को लोडिंग चरण तक स्थानांतरित करना आवश्यक होता है, इसलिए डेटा मूवमेंट आवश्यक है।
Zero-ETL बनाम अन्य डेटा इंटीग्रेशन तकनीकें
नीचे zero-ETL और अन्य प्रमुख डेटा इंटीग्रेशन तकनीकों की तुलना दी गई है, जो उनकी समानताओं और प्रमुख अंतरों को उजागर करती है।
Zero-ETL बनाम ELT
Zero-ETL बनाम API
शीर्ष Zero-ETL टूल्स
जैसा कि हमने इस ब्लॉग पोस्ट में देखा, zero-ETL एक अत्याधुनिक डेटा प्रबंधन टूल है जिसने उद्योग में पकड़ बनाई है, जिसे बड़े पैमाने पर AWS ने लोकप्रिय बनाया है और अन्य क्लाउड प्रदाताओं ने अपनाया है।
आज उपलब्ध शीर्ष zero-ETL टूल्स का एक संक्षिप्त अवलोकन प्रस्तुत है:
AWS के zero-ETL टूल्स
अन्य क्लाउड प्रदाताओं के Zero-ETL टूल्स
AWS के अलावा, अन्य क्लाउड प्रदाता भी zero-ETL क्षमताओं वाले एकीकृत डेटा प्लेटफ़ॉर्म प्रदान करते हैं:
निष्कर्ष
डेटा एनालिटिक्स और मशीन लर्निंग पाइपलाइन में पारंपरिक ETL चरणों को समाप्त करना डेटा इंजीनियरिंग प्रतिमान में एक महत्वपूर्ण बदलाव है। Zero-ETL आर्किटेक्चर का एकीकरण उल्लेखनीय लाभ प्रदान करता है, जिनमें बढ़ी हुई गति, उन्नत सुरक्षा, और अधिक स्केलेबिलिटी शामिल हैं।
हालाँकि, यह बदलाव चुनौतियाँ भी लाता है। पारंपरिक डेटा इंजीनियरिंग कौशल की आवश्यकता कम हो सकती है, जिससे डेटा विश्लेषकों, मशीन लर्निंग वैज्ञानिकों, और डेटा वैज्ञानिकों को अधिक उन्नत डेटा इंटीग्रेशन अवधारणाएँ और कौशल हासिल करने की आवश्यकता होगी।
Zero-ETL डेटा विश्लेषकों और मशीन लर्निंग इंजीनियरों की आवश्यकताओं पर केंद्रित है, और यह संकेत देता है कि भविष्य में ये भूमिकाएँ अधिक केंद्रीय हो सकती हैं, जो संभावित रूप से नौकरी बाजार की मांगों और कौशल सेट्स को पुनः आकार देंगी।
यदि आप डेटा आर्किटेक्चर के बारे में और सीखने में रुचि रखते हैं, तो हमारा ETL और ELT in Python कोर्स देखें!