

Corso
ETL and ELT in Python
4 ore
40.5K
Pratica and corso your progress.
Continua Con GoogleNelle aziende moderne cresce l'esigenza di ridurre al minimo il tempo necessario per ottenere insight dai dati. Serve un approccio rapido per accelerare il passaggio dalla raccolta dei dati all'analisi, all'intelligenza artificiale e all'implementazione del machine learning.
Le architetture ETL (extract, transform, load) tradizionali faticano a soddisfare le esigenze tecniche del big data e dell'analisi in tempo reale. Per questo è emersa una nuova architettura di gestione dei dati, chiamata zero-ETL, che mira a ridurre o eliminare la necessità di processi ETL.
Lo Zero-ETL è un sistema di integrazioni progettato per eliminare o ridurre la necessità di creare pipeline ETL dei dati. Consentendo interrogazioni tra diversi silos di dati senza spostare fisicamente i dati, lo zero-ETL punta a snellire l'elaborazione e a migliorarne l'efficienza.
Il termine “zero-ETL” è stato introdotto durante la conferenza AWS re:Invent del 2022, quando è stata annunciata l'integrazione di Amazon Aurora con Amazon Redshift. Da allora, AWS ha sviluppato ulteriormente questo concetto, principalmente tramite servizi che supportano analisi e trasformazioni direttamente all'interno delle piattaforme dati, senza richiedere pipeline ETL separate.
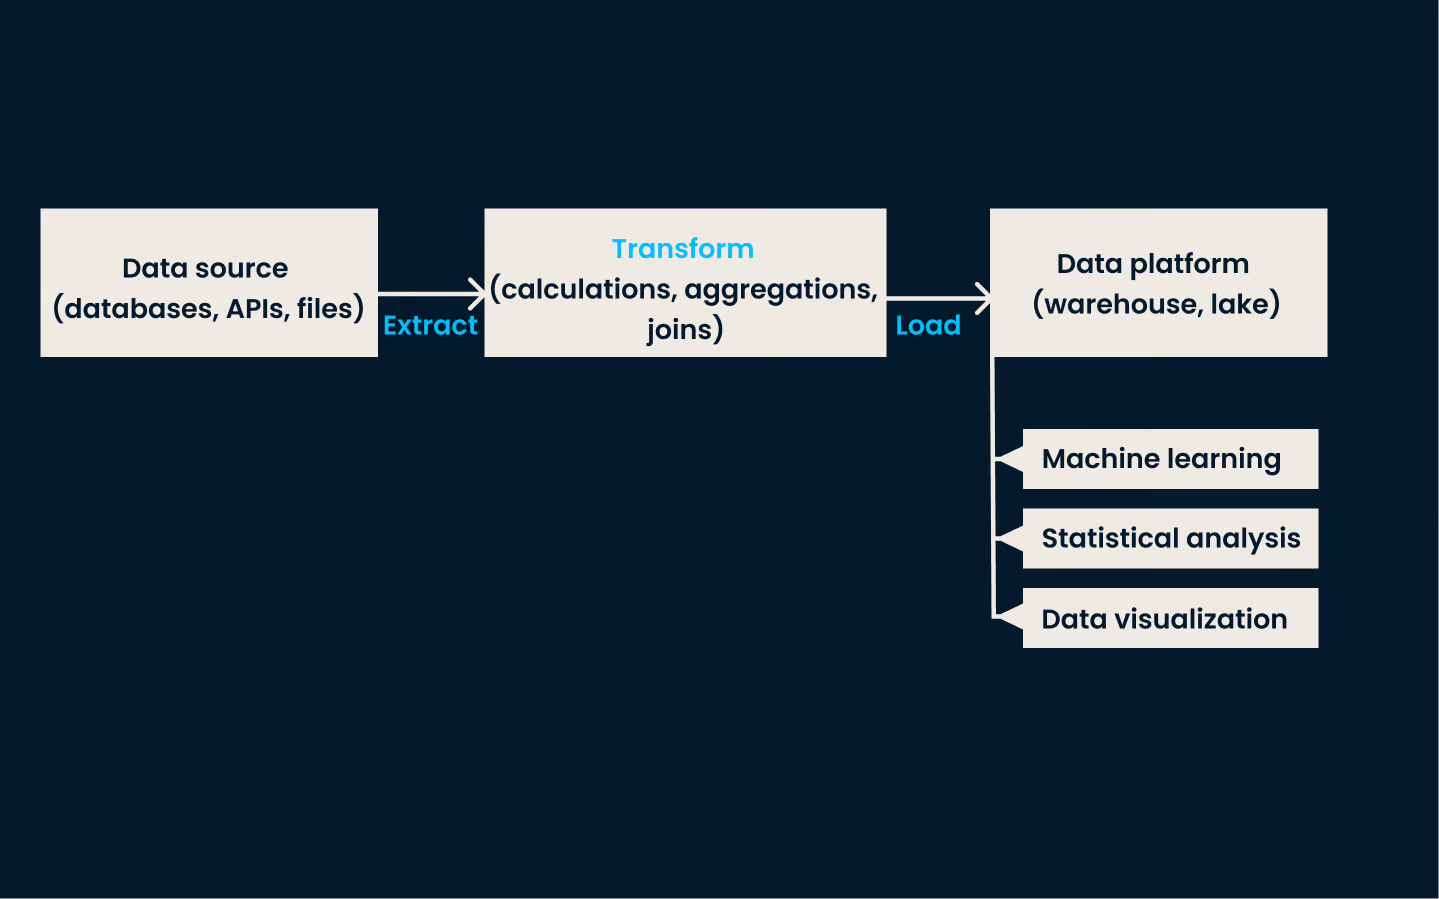
In una tipica pipeline ETL, un professionista dei dati, come un data engineer o un data scientist, raccoglie dati da una sorgente, ad esempio un database, un'API, un file JSON o XML.
Dopo l'estrazione, si applicano varie trasformazioni, come combinare dati, eseguire calcoli, unire tabelle o rimuovere informazioni non necessarie come timestamp o ID utente.
Infine, i dati trasformati vengono caricati su una piattaforma per ulteriori analisi, come machine learning, analisi statistiche o visualizzazione dei dati. A causa della sua complessità, questo processo richiede tempi, costi e sforzi significativi.
Architettura ETL tradizionale
Considera questa analogia: nella fotografia tradizionale, si scatta una foto su pellicola negativa (estrazione dei dati), la si sviluppa in camera oscura (trasformazione) e poi la si stampa ed espone (caricamento). Ora immagina una fotocamera digitale in cui la foto viene catturata, elaborata e pronta per essere mostrata (o trasmessa in diretta) tutto nello stesso luogo.
Allo stesso modo, lo zero-ETL cambia l'elaborazione dei dati eliminando estrazione, trasformazione e caricamento. Questa architettura riduce al minimo lo spostamento dei dati e consente di trasformare e analizzare tutto all'interno di un'unica piattaforma.
Lo Zero-ETL promette analisi dei dati in tempo reale o con latenza minima per data scientist e stakeholder di business.
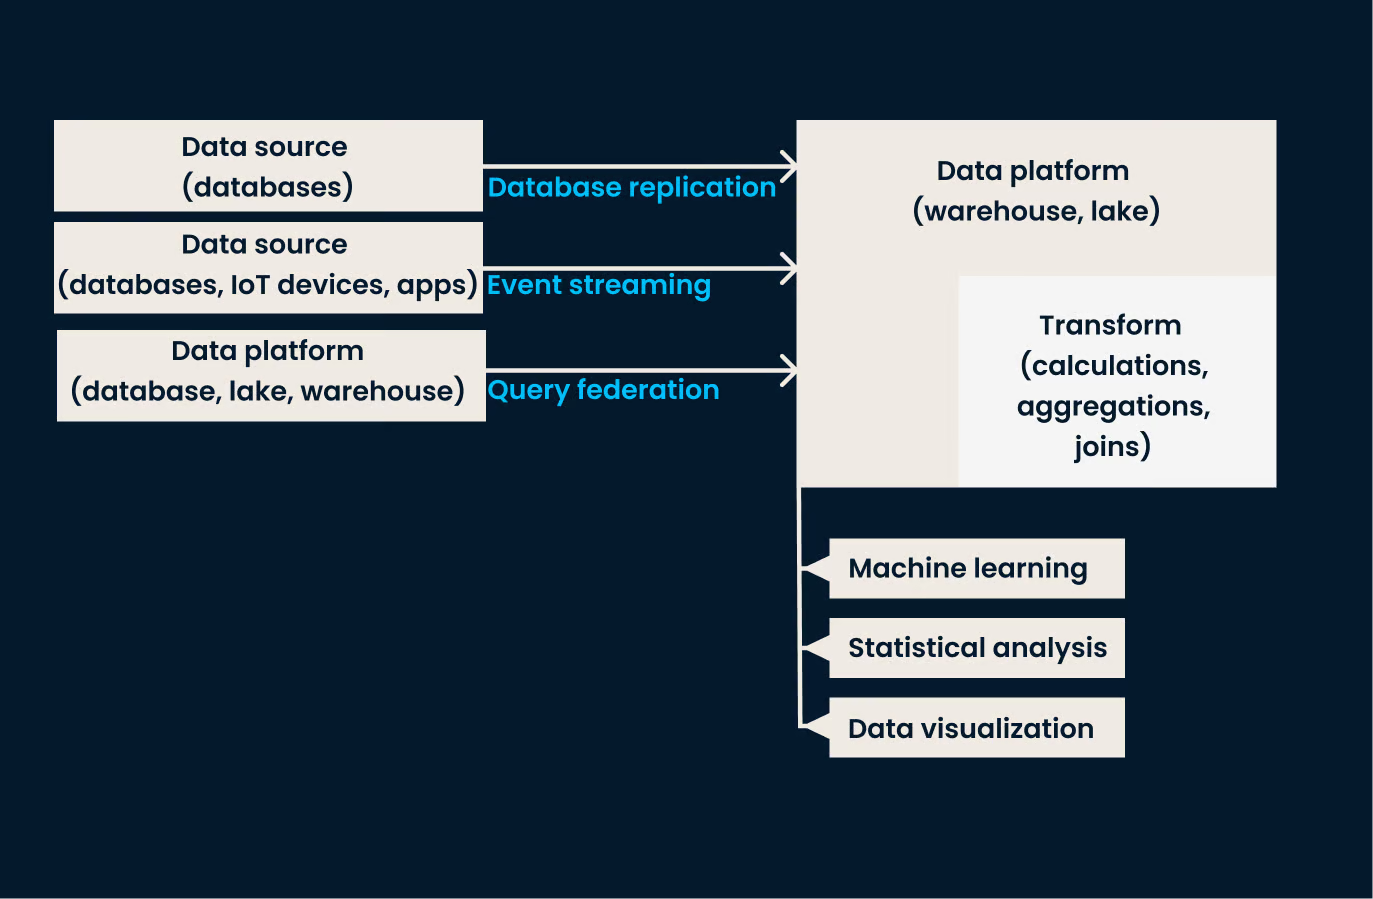
Lo Zero-ETL semplifica l'integrazione dei dati collegando direttamente le sorgenti ai data warehouse o data lake, garantendo la disponibilità dei dati in tempo reale per analisi e reportistica. Ciò è reso possibile da diverse tecnologie e servizi cloud, come:
La replica del database è il processo di copia e sincronizzazione dei dati da un database a un altro.
Nel contesto dello zero-ETL tra un database e un data warehouse, la replica assicura che i dati nel data warehouse si aggiornino automaticamente in tempo reale o quasi, eliminando la necessità di processi ETL separati. È il caso dell'integrazione tra Amazon Aurora e Amazon Redshift.
Le query federate permettono di eseguire interrogazioni su più sorgenti dati, come database, data warehouse o data lake, senza dover spostare o replicare i dati in un'unica posizione.
In ambito zero-ETL, le query federate consentono ai professionisti dei dati di accedere e analizzare direttamente i dati archiviati in diverse piattaforme, offrendo una vista unificata senza l'onere dei processi ETL tradizionali.
Il data streaming è l'elaborazione e il trasferimento continuo, in tempo reale, dei dati man mano che vengono generati.
Nello zero-ETL, lo streaming prevede di catturare i dati da varie fonti (come database, dispositivi IoT o applicazioni) e recapitarli immediatamente a un data warehouse o data lake. Questo assicura che i dati siano disponibili quasi istantaneamente per analisi e interrogazioni, senza processi ETL a batch.
Per ottenere analisi in-place, le trasformazioni necessarie vengono integrate nella piattaforma dati cloud, come un data lake. Questa integrazione consente l'elaborazione e l'analisi in tempo reale direttamente dove i dati risiedono, riducendo la latenza e migliorando l'efficienza.
Per esempio, i dati non strutturati raccolti in formato JSON o XML verranno trasformati e analizzati con tecnologie “schema-on-read” all'interno del data lake stesso, eliminando i passaggi intermedi di spostamento verso archivi pronti per la reportistica.
Esempio di architettura dati Zero-ETL
Sebbene l'architettura zero-ETL possa sembrare priva di componenti o completamente unificata, diversi elementi e servizi possono essere utilizzati in base alle esigenze delle analisi e alle risorse disponibili. Questi servizi includono:
I provider cloud offrono servizi specializzati che automatizzano l'integrazione zero-ETL. Come detto, AWS fornisce l'integrazione tra Amazon Aurora e Amazon Redshift, in cui i dati scritti su Aurora vengono replicati automaticamente su Redshift. Questi servizi gestiscono internamente replica e trasformazione, eliminando la necessità di processi ETL tradizionali.
La tecnologia CDC è un elemento centrale delle architetture zero-ETL. Monitora e cattura in continuo le modifiche (insert, update, delete) nei database sorgente e le replica in tempo reale nei sistemi di destinazione.
Le pipeline di streaming spostano i dati in tempo reale da diverse fonti al sistema di destinazione. Piattaforme come Amazon Kinesis e Apache Kafka abilitano un flusso continuo di dati, garantendo aggiornamenti a bassa latenza.
Le architetture serverless supportano lo zero-ETL gestendo automaticamente l'infrastruttura necessaria e scalando le risorse in base alla domanda. Servizi come AWS Lambda e Google Cloud Functions ne sono un esempio, consentendo di eseguire funzioni in risposta a eventi sui dati.
Applicando lo schema in lettura anziché in scrittura, lo schema-on-read supporta la gestione flessibile di formati di dati non strutturati e semi-strutturati come JSON e XML. Questo approccio riduce la necessità di schemi predefiniti e consente analisi dinamiche.
Lo Zero-ETL facilita l'ingestione e la duplicazione dei dati da fonti diverse tramite la data federation. Ciò comporta l'uso di data lake e virtualizzazione dei dati cross-platform per creare un livello di oggetti astratti, semplificando la duplicazione senza richiedere trasformazioni estese e spostamenti di dati. La virtualizzazione dei dati consente di accedere e interrogare dati attraverso sistemi diversi come se fossero in un'unica posizione.
In un approccio zero-ETL, trasformazioni e analisi vengono eseguite all'interno della piattaforma dati. Ciò consente di gestire dati non strutturati in vari formati (video, immagini, testo e numerici) in un sistema di archiviazione multi-formato, come un data lake, spesso senza necessità di trasformazioni intermedie.
Lo Zero-ETL può sembrare un approccio promettente per aumentare l'efficienza nella data science. Tuttavia, è importante confrontare vantaggi e svantaggi che un'implementazione zero-ETL può comportare.
Lo Zero-ETL porta diversi benefici alla gestione e all'analisi dei dati, tra cui:
Nonostante i benefici, lo zero-ETL può presentare alcune sfide, tra cui:
Lo Zero-ETL offre vantaggi significativi in diversi scenari di elaborazione e analisi dei dati in tempo reale. Ecco alcuni casi d'uso tipici:
La tabella seguente fornisce un confronto dettagliato tra Zero-ETL e processi ETL tradizionali.
Di seguito un confronto tra zero-ETL e altre tecniche di integrazione dei dati, con le loro somiglianze e le principali differenze.
Come abbiamo visto in questo articolo, lo zero-ETL è uno strumento all'avanguardia per la gestione dei dati che ha guadagnato terreno nel settore, largamente promosso da AWS e adottato da altri provider cloud.
Ecco una breve panoramica dei principali strumenti zero-ETL disponibili oggi:
Oltre ad AWS, altri provider offrono piattaforme dati unificate con funzionalità zero-ETL:
Eliminare le fasi ETL tradizionali nella pipeline di analytics e machine learning rappresenta un cambiamento significativo nel paradigma del data engineering. Integrare un'architettura zero-ETL offre benefici sostanziali, tra cui maggiore velocità, sicurezza rafforzata e più ampia scalabilità.
Tuttavia, questo cambiamento porta anche sfide. La necessità di competenze di data engineering tradizionali può ridursi, richiedendo a data analyst, machine learning scientist e data scientist di acquisire concetti e competenze di integrazione dati più avanzati.
Lo Zero-ETL mette al centro le esigenze di data analyst e machine learning engineer, suggerendo un futuro in cui questi ruoli diventeranno più centrali, con potenziali ricadute su domanda di lavoro e skillset.
Se vuoi approfondire l'architettura dei dati, dai un'occhiata al nostro corso su ETL ed ELT in Python!
Approfondisci l'architettura e la gestione dei dati con questi corsi!
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



