Trong các doanh nghiệp hiện đại, nhu cầu rút ngắn thời gian triển khai insight từ dữ liệu ngày càng tăng. Cần có một cách tiếp cận nhanh để đẩy nhanh quá trình chuyển đổi từ thu thập dữ liệu sang phân tích, trí tuệ nhân tạo và triển khai học máy.
Các kiến trúc ETL (trích xuất, biến đổi, nạp) truyền thống gặp nhiều thách thức trong việc đáp ứng các yêu cầu kỹ thuật của dữ liệu lớn và phân tích dữ liệu thời gian thực. Do đó, một kiến trúc quản lý dữ liệu mới có tên zero-ETL đã xuất hiện nhằm giảm thiểu hoặc loại bỏ nhu cầu thực hiện các quy trình ETL.
Zero-ETL là gì?
Zero-ETL là một hệ thống tích hợp được thiết kế để loại bỏ hoặc giảm nhu cầu tạo pipeline dữ liệu ETL. Bằng cách cho phép truy vấn trên các silo dữ liệu khác nhau mà không cần di chuyển dữ liệu vật lý, zero-ETL hướng tới việc hợp lý hóa xử lý dữ liệu và nâng cao hiệu quả.
Thuật ngữ “zero-ETL” được giới thiệu tại hội nghị AWS re:Invent năm 2022, khi công bố tích hợp giữa Amazon Aurora và Amazon Redshift. Kể từ đó, AWS đã phát triển khái niệm này, chủ yếu thông qua các dịch vụ hỗ trợ phân tích và biến đổi dữ liệu trực tiếp ngay trong nền tảng dữ liệu mà không cần các pipeline ETL riêng biệt.
Trong một pipeline xử lý dữ liệu ETL điển hình, một chuyên gia dữ liệu, như kỹ sư dữ liệu hoặc nhà khoa học dữ liệu, thu thập dữ liệu từ nguồn như cơ sở dữ liệu, API, tệp JSON hoặc XML.
Sau khi trích xuất dữ liệu, áp dụng các biến đổi khác nhau như kết hợp dữ liệu, thực hiện tính toán, hợp nhất bảng hoặc loại bỏ những thông tin không cần thiết như dấu thời gian hoặc ID người dùng.
Cuối cùng, dữ liệu đã biến đổi được nạp vào một nền tảng để phân tích sâu hơn, như học máy, phân tích thống kê hoặc trực quan hóa dữ liệu. Quy trình này đòi hỏi nhiều thời gian, chi phí và công sức do tính phức tạp của nó.
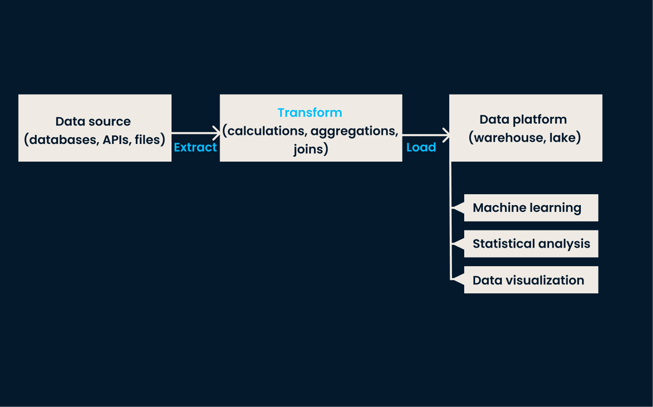
Kiến trúc ETL truyền thống
Hãy xem phép so sánh sau: Trong nhiếp ảnh truyền thống, ảnh được chụp bằng phim (trích xuất dữ liệu), xử lý trong buồng tối (biến đổi), rồi tráng và hiển thị (nạp). Giờ hãy hình dung máy ảnh kỹ thuật số nơi bức ảnh được chụp, xử lý và sẵn sàng hiển thị (hoặc truyền trực tiếp) ngay tại một nơi.
Tương tự, zero-ETL thay đổi cách xử lý dữ liệu bằng cách loại bỏ trích xuất, biến đổi và nạp. Kiến trúc này giảm thiểu việc di chuyển dữ liệu và cho phép chúng ta biến đổi, phân tích toàn bộ dữ liệu trong một nền tảng duy nhất.
Zero-ETL hứa hẹn khả năng phân tích dữ liệu theo thời gian thực hoặc độ trễ tối thiểu cho các nhà khoa học dữ liệu và các bên liên quan trong doanh nghiệp.
Zero-ETL hoạt động như thế nào?
Zero-ETL đơn giản hóa tích hợp dữ liệu bằng cách liên kết trực tiếp các nguồn dữ liệu với kho hoặc hồ dữ liệu, đảm bảo dữ liệu luôn sẵn sàng theo thời gian thực cho phân tích và báo cáo. Điều này khả thi nhờ nhiều công nghệ và dịch vụ dựa trên đám mây, chẳng hạn như:
Nhân bản cơ sở dữ liệu
Nhân bản cơ sở dữ liệu là quá trình sao chép và đồng bộ dữ liệu từ một cơ sở dữ liệu sang cơ sở dữ liệu khác.
Trong bối cảnh zero-ETL giữa cơ sở dữ liệu và kho dữ liệu, nhân bản đảm bảo dữ liệu trong kho dữ liệu được cập nhật tự động theo thời gian thực hoặc gần thời gian thực, loại bỏ nhu cầu về các quy trình ETL riêng. Đây là trường hợp tích hợp giữa Amazon Aurora và Amazon Redshift.
Truy vấn liên kết (federated querying)
Truy vấn liên kết đề cập đến khả năng chạy truy vấn trên nhiều nguồn dữ liệu, như cơ sở dữ liệu, kho dữ liệu hoặc hồ dữ liệu, mà không cần di chuyển hoặc nhân bản dữ liệu vào một vị trí duy nhất.
Đối với zero-ETL, truy vấn liên kết cho phép các chuyên gia dữ liệu truy cập và phân tích trực tiếp dữ liệu lưu trữ ở các nền tảng khác nhau, cung cấp cái nhìn hợp nhất về dữ liệu mà không phải gánh chi phí quy trình ETL truyền thống.
Streaming dữ liệu
Streaming dữ liệu là việc xử lý và truyền dữ liệu liên tục, theo thời gian thực ngay khi dữ liệu được tạo ra.
Trong zero-ETL, streaming dữ liệu bao gồm việc thu nhận dữ liệu từ nhiều nguồn (như cơ sở dữ liệu, thiết bị IoT hoặc ứng dụng) và ngay lập tức chuyển vào kho dữ liệu hoặc hồ dữ liệu. Điều này đảm bảo dữ liệu gần như lập tức sẵn sàng cho phân tích và truy vấn, không cần các quy trình ETL theo lô.
Phân tích dữ liệu tại chỗ (in-place)
Để đạt được phân tích dữ liệu tại chỗ, các biến đổi cần thiết được tích hợp ngay trong nền tảng dữ liệu đám mây, như hồ dữ liệu. Sự tích hợp này cho phép xử lý và phân tích dữ liệu theo thời gian thực ngay tại nơi dữ liệu lưu trữ, giảm độ trễ và cải thiện hiệu quả.
Ví dụ, dữ liệu phi cấu trúc thu thập ở định dạng JSON hoặc XML sẽ được biến đổi và phân tích bằng công nghệ “schema-on-read” ngay trong chính hồ dữ liệu, loại bỏ các bước trung gian di chuyển dữ liệu tới kho lưu trữ sẵn sàng cho báo cáo.
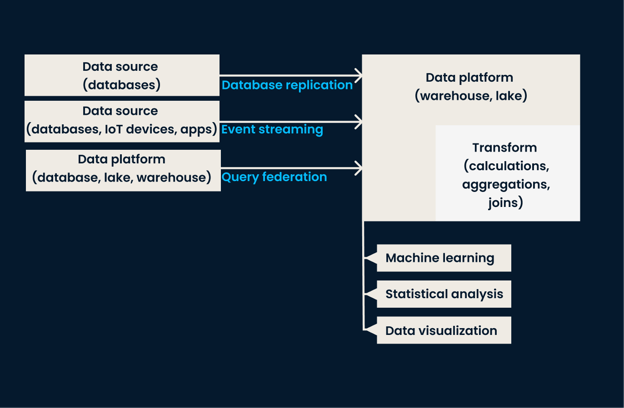
Ví dụ kiến trúc dữ liệu Zero-ETL
Các thành phần khác nhau của Zero-ETL
Mặc dù kiến trúc zero-ETL có thể nghe như không có thành phần hoặc tất cả thành phần được hợp nhất, vẫn có những yếu tố và dịch vụ khác nhau có thể sử dụng tùy theo nhu cầu phân tích mục tiêu và nguồn lực. Các dịch vụ này bao gồm:
Dịch vụ tích hợp dữ liệu trực tiếp
Các nhà cung cấp đám mây cung cấp những dịch vụ chuyên biệt tự động hóa tích hợp zero-ETL. Như đã đề cập, AWS cung cấp tích hợp giữa Amazon Aurora và Amazon Redshift, trong đó dữ liệu ghi vào Aurora được tự động nhân bản sang Redshift. Các dịch vụ này quản lý việc nhân bản và biến đổi dữ liệu ở bên trong, loại bỏ nhu cầu về quy trình ETL truyền thống.
Change Data Capture (CDC)
Công nghệ CDC là một thành phần cốt lõi của các kiến trúc zero-ETL. Nó liên tục giám sát và ghi nhận các thay đổi (thêm, cập nhật, xóa) trong cơ sở dữ liệu nguồn và nhân bản các thay đổi này theo thời gian thực sang hệ thống đích.
Pipeline dữ liệu streaming
Các pipeline streaming di chuyển dữ liệu theo thời gian thực từ những nguồn khác nhau tới hệ thống đích. Các nền tảng như Amazon Kinesis và Apache Kafka cho phép luồng dữ liệu liên tục, đảm bảo cập nhật với độ trễ thấp.
Điện toán không máy chủ (serverless)
Kiến trúc serverless hỗ trợ zero-ETL bằng cách tự động quản lý hạ tầng cần thiết và mở rộng tài nguyên theo nhu cầu. Các dịch vụ như AWS Lambda và Google Cloud Functions minh họa cách tiếp cận này bằng việc cho phép thực thi hàm để phản hồi các sự kiện dữ liệu.
Công nghệ schema-on-read
Bằng cách áp dụng schema khi đọc dữ liệu thay vì khi ghi, schema-on-read hỗ trợ linh hoạt trong xử lý dữ liệu phi cấu trúc và bán cấu trúc như JSON và XML. Cách tiếp cận này giảm nhu cầu schema định trước và cho phép phân tích dữ liệu động.
Liên kết và trừu tượng hóa dữ liệu
Zero-ETL tạo điều kiện tiếp nhận và nhân bản dữ liệu từ các nguồn khác nhau thông qua liên kết dữ liệu (data federation). Điều này bao gồm việc sử dụng hồ dữ liệu và ảo hóa dữ liệu đa nền tảng để tạo một lớp đối tượng trừu tượng, đơn giản hóa việc nhân bản dữ liệu mà không đòi hỏi biến đổi và di chuyển dữ liệu quá nhiều. Ảo hóa dữ liệu cho phép người dùng truy cập và truy vấn dữ liệu trên các hệ thống khác nhau như thể ở một vị trí duy nhất.
Hồ dữ liệu
Trong cách tiếp cận zero-ETL, các biến đổi và phân tích được thực hiện trong chính nền tảng dữ liệu. Điều này cho phép quản lý dữ liệu phi cấu trúc ở nhiều định dạng (video, hình ảnh, văn bản và số) trong một hệ lưu trữ đa định dạng như hồ dữ liệu, thường không cần các biến đổi trung gian.
Ưu điểm và nhược điểm của Zero-ETL
Zero-ETL nghe có vẻ là một cách tiếp cận hứa hẹn để tăng hiệu quả trong khoa học dữ liệu. Tuy nhiên, cần so sánh cả ưu và nhược điểm mà việc triển khai zero-ETL có thể mang lại.
Ưu điểm của zero-ETL
Zero-ETL mang lại nhiều lợi ích cho quản lý và phân tích dữ liệu, bao gồm:
- Kỹ thuật được tinh gọn: Zero-ETL đơn giản hóa kiến trúc pipeline dữ liệu bằng cách tích hợp các bước trích xuất, biến đổi và nạp vào một quy trình duy nhất hoặc loại bỏ hoàn toàn. Sự tinh gọn này giảm độ phức tạp và tăng tốc các tác vụ phân tích dữ liệu, học máy, giúp nhà khoa học dữ liệu rút ra insight nhanh hơn.
- Phân tích thời gian thực: Zero-ETL cho phép phân tích dữ liệu thời gian thực bằng cách hợp nhất các giai đoạn trích xuất, biến đổi và nạp trực tiếp trong nền tảng dữ liệu. Khi có dữ liệu mới, có thể phân tích ngay lập tức, hỗ trợ ra quyết định nhanh và insight kịp thời.
Nhược điểm của zero-ETL
Bên cạnh lợi ích, zero-ETL cũng có một số thách thức, bao gồm:
- Khó khắc phục sự cố: Việc xác định và xử lý sự cố có thể phức tạp hơn vì tất cả quy trình dữ liệu được thực hiện trong một bước tích hợp. Việc cô lập nguồn gốc vấn đề đòi hỏi hiểu sâu toàn bộ hệ thống.
- Đường cong học tập dốc hơn: Loại bỏ các pipeline ETL truyền thống có thể giảm nhu cầu cho các vai trò kỹ sư dữ liệu trung gian. Sự chuyển dịch này có thể khiến nhà khoa học dữ liệu và kỹ sư học máy phải đảm nhiệm các tác vụ trước đây do kỹ sư dữ liệu xử lý, dẫn tới đường cong học tập dốc hơn.
- Phụ thuộc đám mây: Các giải pháp zero-ETL thường được thiết kế dựa trên đám mây. Những tổ chức chưa sẵn sàng tích hợp công nghệ đám mây vào hệ thống có thể gặp khó khăn khi áp dụng zero-ETL. Sự phụ thuộc này có thể làm dấy lên lo ngại về bảo mật dữ liệu, tuân thủ và kiểm soát.
Các trường hợp sử dụng điển hình của Zero-ETL
Zero-ETL mang lại lợi thế đáng kể trong nhiều kịch bản xử lý và phân tích dữ liệu thời gian thực. Dưới đây là một số trường hợp tiêu biểu:
- Phân tích thời gian thực: Zero-ETL loại bỏ quy trình ETL theo lô truyền thống và cho phép truy cập thời gian thực vào dữ liệu mới phát sinh, bao gồm tương tác của khách hàng, hành vi người dùng và mẫu lưu lượng phương tiện. Tự động hóa này giúp nhóm ra quyết định dựa trên dữ liệu ngay lập tức, cải thiện khả năng phản hồi và hiệu quả vận hành.
- Truyền dữ liệu tức thời: Trong kiến trúc quản lý dữ liệu zero-ETL, việc loại bỏ pipeline ETL đồng nghĩa quá trình nhân bản dữ liệu sang kho khác, nơi nhà khoa học dữ liệu có thể truy cập, diễn ra nhanh hơn nhiều hoặc thậm chí theo thời gian thực.
- Học máy và AI: Zero-ETL đặc biệt hữu ích cho các ứng dụng học máy và trí tuệ nhân tạo, nơi dữ liệu kịp thời là yếu tố then chốt. Streaming dữ liệu thời gian thực và khả năng sẵn sàng ngay lập tức cho phép huấn luyện liên tục và cập nhật mô hình với dữ liệu mới nhất, cải thiện độ chính xác và mức độ phù hợp của dự đoán, insight AI.
So sánh Zero-ETL và ETL truyền thống
Bảng sau cung cấp so sánh chi tiết giữa Zero-ETL và các quy trình ETL truyền thống.
|
|
Zero-ETL
|
ETL truyền thống
|
|
Ảo hóa dữ liệu
|
Sử dụng công nghệ ảo hóa dữ liệu để đơn giản hóa việc nhân bản dữ liệu giữa các kho.
|
Ảo hóa dữ liệu có thể thừa hoặc khó triển khai vì dữ liệu được di chuyển từ giai đoạn biến đổi sang nạp trong ETL.
|
|
Giám sát chất lượng dữ liệu
|
Về bản chất là cách tiếp cận quản lý dữ liệu tự động; vì vậy có thể phát sinh vấn đề chất lượng dữ liệu.
|
Do pipeline di chuyển dữ liệu có các bước rời rạc trong ETL, chất lượng dữ liệu được giám sát và khắc phục tốt hơn.
|
|
Đa dạng kiểu dữ liệu
|
Hồ dữ liệu dựa trên đám mây cho phép nhiều kiểu và định dạng dữ liệu mà không bị ràng buộc bởi kiến trúc.
|
Kiến trúc trích xuất và biến đổi có thể hạn chế kiểu dữ liệu (cần thêm công sức kỹ thuật ở các giai đoạn trích xuất và biến đổi cho các loại dữ liệu khác nhau).
|
|
Triển khai thời gian thực
|
Phân tích dữ liệu có thể thực hiện ngay trên nền tảng với độ trễ tối thiểu từ lúc dữ liệu phát sinh đến biến đổi và phân tích.
|
Tính chất chạy theo lô theo lịch của pipeline ngăn cản phân tích dữ liệu thời gian thực.
|
|
Chi phí và bảo trì
|
Tiết kiệm chi phí và dễ bảo trì hơn vì cần ít thành phần tính toán và mã hóa hơn. Việc biến đổi và nạp dữ liệu có thể thực hiện khi cần.
|
Tốn kém hơn vì đòi hỏi nhiều tài nguyên tính toán và các chuyên gia dữ liệu giàu kinh nghiệm.
|
|
Quy mô
|
Mở rộng nhanh hơn và ít tốn kém hơn nhờ loại bỏ phần cứng trung gian phục vụ di chuyển dữ liệu.
|
Có thể chậm và tốn kém do cần phần cứng tốt hơn và tối ưu mã để đáp ứng nguồn dữ liệu lớn hơn.
|
|
Di chuyển dữ liệu
|
Không hoặc tối thiểu.
|
Cần di chuyển dữ liệu vì pipeline là rời rạc và dữ liệu phải được chuyển tới giai đoạn nạp.
|
Zero-ETL so với các kỹ thuật tích hợp dữ liệu khác
Dưới đây là so sánh giữa zero-ETL và các kỹ thuật tích hợp dữ liệu nổi bật khác, làm rõ điểm chung và khác biệt cốt lõi.
Zero-ETL so với ELT
- Điểm chung: Zero-ETL và ELT (Extract, Load, Transform) giúp giảm thời gian và độ phức tạp của phân tích dữ liệu bằng cách hoãn bước biến đổi tới sau khi dữ liệu được nạp vào hệ thống đích. ELT được xem là tiền thân của zero-ETL, vì đã đặt nền móng cho việc trì hoãn biến đổi sang giai đoạn sau trong pipeline xử lý dữ liệu.
- Khác biệt chính: Zero-ETL loại bỏ giai đoạn trung gian dàn dựng dữ liệu bắt buộc trong ELT, từ đó giảm độ trễ và cải thiện khả năng sẵn sàng dữ liệu theo thời gian thực. Zero-ETL tiếp tục đơn giản hóa pipeline dữ liệu bằng cách giảm số bước và yêu cầu hạ tầng.
Zero-ETL so với API
- Điểm chung: Zero-ETL và API cho phép truy vấn đến nhiều nguồn dữ liệu, tạo điều kiện tích hợp dữ liệu trên các hệ thống khác nhau.
- Khác biệt chính: Zero-ETL chủ yếu là công nghệ không cần viết mã, yêu cầu tối thiểu mã thủ công cho tích hợp và quản lý dữ liệu. Ngược lại, API cần mã tùy chỉnh để kết nối và tương tác với các nguồn dữ liệu khác nhau. Ngoài ra, API có thể dễ bị rủi ro bảo mật hơn do bản chất dựa trên mã của việc tích hợp, có thể tạo ra lỗ hổng nếu không được quản lý và bảo mật đúng cách.
Các công cụ Zero-ETL hàng đầu
Như đã thấy trong bài viết này, zero-ETL là một công cụ quản lý dữ liệu tiên tiến đã thu hút sự quan tâm trong ngành, phần lớn được phổ biến bởi AWS và được các nhà cung cấp đám mây khác áp dụng.
Dưới đây là tổng quan ngắn về các công cụ zero-ETL hàng đầu hiện nay:
Các công cụ zero-ETL của AWS
- Tích hợp trực tiếp Aurora và Redshift: AWS đã tích hợp Amazon Aurora và Amazon Redshift để cho phép phân tích thời gian thực mà không cần các quy trình ETL truyền thống.
- Redshift Spectrum: Cho phép người dùng chạy truy vấn SQL trên dữ liệu ở quy mô exabyte trong Amazon S3 mà không phải nạp hay biến đổi dữ liệu. Dịch vụ này hỗ trợ truy vấn liền mạch dữ liệu có cấu trúc và phi cấu trúc, rất phù hợp cho tập dữ liệu đa dạng.
- Amazon Athena: Giải pháp phân tích serverless xử lý khối lượng lớn dữ liệu cho phân tích tại chỗ, bao gồm học máy và AI, sử dụng SQL hoặc Python để kết nối dữ liệu streaming từ các dịch vụ đám mây.
- Amazon Redshift Streaming Ingestion: Dịch vụ cung cấp thu nhận dữ liệu thời gian thực từ Amazon Kinesis Data Streams hoặc Amazon MSK, hỗ trợ các tác vụ học máy thời gian thực chuyên sâu.
Các công cụ Zero-ETL từ nhà cung cấp đám mây khác
Ngoài AWS, các nhà cung cấp đám mây khác cũng cung cấp các nền tảng dữ liệu hợp nhất với khả năng zero-ETL:
- Snowflake: Hỗ trợ tạo kho và hồ dữ liệu có khả năng xử lý dữ liệu phi cấu trúc theo kiến trúc zero-ETL. Snowflake đơn giản hóa quy trình dữ liệu và hỗ trợ phân tích thời gian thực, học máy.
- Google BigQuery: Thực thi truy vấn SQL phức tạp trên các tập dữ liệu lớn theo thời gian thực, hỗ trợ tích hợp liền mạch với các dịch vụ Google Cloud khác cho phân tích thời gian thực. BigQuery được thiết kế để xử lý hiệu quả lượng dữ liệu khổng lồ.
- Microsoft Azure Synapse Analytics: Cung cấp thu nhận và phân tích dữ liệu thời gian thực với nền tảng phân tích hợp nhất, hỗ trợ phân tích nâng cao và ứng dụng BI. Synapse tích hợp với nhiều dịch vụ Azure.
Kết luận
Loại bỏ các giai đoạn ETL truyền thống trong pipeline phân tích dữ liệu và học máy tạo ra một sự chuyển dịch lớn trong tư duy kỹ thuật dữ liệu. Tích hợp kiến trúc zero-ETL mang lại lợi ích đáng kể, bao gồm tăng tốc độ, nâng cao bảo mật và khả năng mở rộng tốt hơn.
Tuy nhiên, sự chuyển dịch này cũng đem tới thách thức. Nhu cầu về các kỹ năng kỹ thuật dữ liệu truyền thống có thể giảm, đòi hỏi nhà phân tích dữ liệu, nhà khoa học học máy và nhà khoa học dữ liệu phải tiếp thu nhiều khái niệm và kỹ năng tích hợp dữ liệu nâng cao hơn.
Zero-ETL tập trung vào nhu cầu của nhà phân tích dữ liệu và kỹ sư học máy, gợi mở tương lai nơi các vai trò này trở nên trung tâm hơn, có thể định hình lại nhu cầu thị trường lao động và bộ kỹ năng.
Nếu bạn quan tâm tìm hiểu sâu hơn về kiến trúc dữ liệu, hãy xem khóa học ETL và ELT trong Python!


Trong các doanh nghiệp hiện đại, nhu cầu rút ngắn thời gian triển khai insight từ dữ liệu ngày càng tăng. Cần có một cách tiếp cận nhanh để đẩy nhanh quá trình chuyển đổi từ thu thập dữ liệu sang phân tích, trí tuệ nhân tạo và triển khai học máy.
Các kiến trúc ETL (trích xuất, biến đổi, nạp) truyền thống gặp nhiều thách thức trong việc đáp ứng các yêu cầu kỹ thuật của dữ liệu lớn và phân tích dữ liệu thời gian thực. Do đó, một kiến trúc quản lý dữ liệu mới có tên zero-ETL đã xuất hiện nhằm giảm thiểu hoặc loại bỏ nhu cầu thực hiện các quy trình ETL.
Zero-ETL là gì?
Zero-ETL là một hệ thống tích hợp được thiết kế để loại bỏ hoặc giảm nhu cầu tạo pipeline dữ liệu ETL. Bằng cách cho phép truy vấn trên các silo dữ liệu khác nhau mà không cần di chuyển dữ liệu vật lý, zero-ETL hướng tới việc hợp lý hóa xử lý dữ liệu và nâng cao hiệu quả.
Thuật ngữ “zero-ETL” được giới thiệu tại hội nghị AWS re:Invent năm 2022, khi công bố tích hợp giữa Amazon Aurora và Amazon Redshift. Kể từ đó, AWS đã phát triển khái niệm này, chủ yếu thông qua các dịch vụ hỗ trợ phân tích và biến đổi dữ liệu trực tiếp ngay trong nền tảng dữ liệu mà không cần các pipeline ETL riêng biệt.
Trong một pipeline xử lý dữ liệu ETL điển hình, một chuyên gia dữ liệu, như kỹ sư dữ liệu hoặc nhà khoa học dữ liệu, thu thập dữ liệu từ nguồn như cơ sở dữ liệu, API, tệp JSON hoặc XML.
Sau khi trích xuất dữ liệu, áp dụng các biến đổi khác nhau như kết hợp dữ liệu, thực hiện tính toán, hợp nhất bảng hoặc loại bỏ những thông tin không cần thiết như dấu thời gian hoặc ID người dùng.
Cuối cùng, dữ liệu đã biến đổi được nạp vào một nền tảng để phân tích sâu hơn, như học máy, phân tích thống kê hoặc trực quan hóa dữ liệu. Quy trình này đòi hỏi nhiều thời gian, chi phí và công sức do tính phức tạp của nó.
Kiến trúc ETL truyền thống
Hãy xem phép so sánh sau: Trong nhiếp ảnh truyền thống, ảnh được chụp bằng phim (trích xuất dữ liệu), xử lý trong buồng tối (biến đổi), rồi tráng và hiển thị (nạp). Giờ hãy hình dung máy ảnh kỹ thuật số nơi bức ảnh được chụp, xử lý và sẵn sàng hiển thị (hoặc truyền trực tiếp) ngay tại một nơi.
Tương tự, zero-ETL thay đổi cách xử lý dữ liệu bằng cách loại bỏ trích xuất, biến đổi và nạp. Kiến trúc này giảm thiểu việc di chuyển dữ liệu và cho phép chúng ta biến đổi, phân tích toàn bộ dữ liệu trong một nền tảng duy nhất.
Zero-ETL hứa hẹn khả năng phân tích dữ liệu theo thời gian thực hoặc độ trễ tối thiểu cho các nhà khoa học dữ liệu và các bên liên quan trong doanh nghiệp.
Zero-ETL hoạt động như thế nào?
Zero-ETL đơn giản hóa tích hợp dữ liệu bằng cách liên kết trực tiếp các nguồn dữ liệu với kho hoặc hồ dữ liệu, đảm bảo dữ liệu luôn sẵn sàng theo thời gian thực cho phân tích và báo cáo. Điều này khả thi nhờ nhiều công nghệ và dịch vụ dựa trên đám mây, chẳng hạn như:
Nhân bản cơ sở dữ liệu
Nhân bản cơ sở dữ liệu là quá trình sao chép và đồng bộ dữ liệu từ một cơ sở dữ liệu sang cơ sở dữ liệu khác.
Trong bối cảnh zero-ETL giữa cơ sở dữ liệu và kho dữ liệu, nhân bản đảm bảo dữ liệu trong kho dữ liệu được cập nhật tự động theo thời gian thực hoặc gần thời gian thực, loại bỏ nhu cầu về các quy trình ETL riêng. Đây là trường hợp tích hợp giữa Amazon Aurora và Amazon Redshift.
Truy vấn liên kết (federated querying)
Truy vấn liên kết đề cập đến khả năng chạy truy vấn trên nhiều nguồn dữ liệu, như cơ sở dữ liệu, kho dữ liệu hoặc hồ dữ liệu, mà không cần di chuyển hoặc nhân bản dữ liệu vào một vị trí duy nhất.
Đối với zero-ETL, truy vấn liên kết cho phép các chuyên gia dữ liệu truy cập và phân tích trực tiếp dữ liệu lưu trữ ở các nền tảng khác nhau, cung cấp cái nhìn hợp nhất về dữ liệu mà không phải gánh chi phí quy trình ETL truyền thống.
Streaming dữ liệu
Streaming dữ liệu là việc xử lý và truyền dữ liệu liên tục, theo thời gian thực ngay khi dữ liệu được tạo ra.
Trong zero-ETL, streaming dữ liệu bao gồm việc thu nhận dữ liệu từ nhiều nguồn (như cơ sở dữ liệu, thiết bị IoT hoặc ứng dụng) và ngay lập tức chuyển vào kho dữ liệu hoặc hồ dữ liệu. Điều này đảm bảo dữ liệu gần như lập tức sẵn sàng cho phân tích và truy vấn, không cần các quy trình ETL theo lô.
Phân tích dữ liệu tại chỗ (in-place)
Để đạt được phân tích dữ liệu tại chỗ, các biến đổi cần thiết được tích hợp ngay trong nền tảng dữ liệu đám mây, như hồ dữ liệu. Sự tích hợp này cho phép xử lý và phân tích dữ liệu theo thời gian thực ngay tại nơi dữ liệu lưu trữ, giảm độ trễ và cải thiện hiệu quả.
Ví dụ, dữ liệu phi cấu trúc thu thập ở định dạng JSON hoặc XML sẽ được biến đổi và phân tích bằng công nghệ “schema-on-read” ngay trong chính hồ dữ liệu, loại bỏ các bước trung gian di chuyển dữ liệu tới kho lưu trữ sẵn sàng cho báo cáo.
Ví dụ kiến trúc dữ liệu Zero-ETL
Các thành phần khác nhau của Zero-ETL
Mặc dù kiến trúc zero-ETL có thể nghe như không có thành phần hoặc tất cả thành phần được hợp nhất, vẫn có những yếu tố và dịch vụ khác nhau có thể sử dụng tùy theo nhu cầu phân tích mục tiêu và nguồn lực. Các dịch vụ này bao gồm:
Dịch vụ tích hợp dữ liệu trực tiếp
Các nhà cung cấp đám mây cung cấp những dịch vụ chuyên biệt tự động hóa tích hợp zero-ETL. Như đã đề cập, AWS cung cấp tích hợp giữa Amazon Aurora và Amazon Redshift, trong đó dữ liệu ghi vào Aurora được tự động nhân bản sang Redshift. Các dịch vụ này quản lý việc nhân bản và biến đổi dữ liệu ở bên trong, loại bỏ nhu cầu về quy trình ETL truyền thống.
Change Data Capture (CDC)
Công nghệ CDC là một thành phần cốt lõi của các kiến trúc zero-ETL. Nó liên tục giám sát và ghi nhận các thay đổi (thêm, cập nhật, xóa) trong cơ sở dữ liệu nguồn và nhân bản các thay đổi này theo thời gian thực sang hệ thống đích.
Pipeline dữ liệu streaming
Các pipeline streaming di chuyển dữ liệu theo thời gian thực từ những nguồn khác nhau tới hệ thống đích. Các nền tảng như Amazon Kinesis và Apache Kafka cho phép luồng dữ liệu liên tục, đảm bảo cập nhật với độ trễ thấp.
Điện toán không máy chủ (serverless)
Kiến trúc serverless hỗ trợ zero-ETL bằng cách tự động quản lý hạ tầng cần thiết và mở rộng tài nguyên theo nhu cầu. Các dịch vụ như AWS Lambda và Google Cloud Functions minh họa cách tiếp cận này bằng việc cho phép thực thi hàm để phản hồi các sự kiện dữ liệu.
Công nghệ schema-on-read
Bằng cách áp dụng schema khi đọc dữ liệu thay vì khi ghi, schema-on-read hỗ trợ linh hoạt trong xử lý dữ liệu phi cấu trúc và bán cấu trúc như JSON và XML. Cách tiếp cận này giảm nhu cầu schema định trước và cho phép phân tích dữ liệu động.
Liên kết và trừu tượng hóa dữ liệu
Zero-ETL tạo điều kiện tiếp nhận và nhân bản dữ liệu từ các nguồn khác nhau thông qua liên kết dữ liệu (data federation). Điều này bao gồm việc sử dụng hồ dữ liệu và ảo hóa dữ liệu đa nền tảng để tạo một lớp đối tượng trừu tượng, đơn giản hóa việc nhân bản dữ liệu mà không đòi hỏi biến đổi và di chuyển dữ liệu quá nhiều. Ảo hóa dữ liệu cho phép người dùng truy cập và truy vấn dữ liệu trên các hệ thống khác nhau như thể ở một vị trí duy nhất.
Hồ dữ liệu
Trong cách tiếp cận zero-ETL, các biến đổi và phân tích được thực hiện trong chính nền tảng dữ liệu. Điều này cho phép quản lý dữ liệu phi cấu trúc ở nhiều định dạng (video, hình ảnh, văn bản và số) trong một hệ lưu trữ đa định dạng như hồ dữ liệu, thường không cần các biến đổi trung gian.
Ưu điểm và nhược điểm của Zero-ETL
Zero-ETL nghe có vẻ là một cách tiếp cận hứa hẹn để tăng hiệu quả trong khoa học dữ liệu. Tuy nhiên, cần so sánh cả ưu và nhược điểm mà việc triển khai zero-ETL có thể mang lại.
Ưu điểm của zero-ETL
Zero-ETL mang lại nhiều lợi ích cho quản lý và phân tích dữ liệu, bao gồm:
Nhược điểm của zero-ETL
Bên cạnh lợi ích, zero-ETL cũng có một số thách thức, bao gồm:
Các trường hợp sử dụng điển hình của Zero-ETL
Zero-ETL mang lại lợi thế đáng kể trong nhiều kịch bản xử lý và phân tích dữ liệu thời gian thực. Dưới đây là một số trường hợp tiêu biểu:
So sánh Zero-ETL và ETL truyền thống
Bảng sau cung cấp so sánh chi tiết giữa Zero-ETL và các quy trình ETL truyền thống.
Zero-ETL
ETL truyền thống
Ảo hóa dữ liệu
Sử dụng công nghệ ảo hóa dữ liệu để đơn giản hóa việc nhân bản dữ liệu giữa các kho.
Ảo hóa dữ liệu có thể thừa hoặc khó triển khai vì dữ liệu được di chuyển từ giai đoạn biến đổi sang nạp trong ETL.
Giám sát chất lượng dữ liệu
Về bản chất là cách tiếp cận quản lý dữ liệu tự động; vì vậy có thể phát sinh vấn đề chất lượng dữ liệu.
Do pipeline di chuyển dữ liệu có các bước rời rạc trong ETL, chất lượng dữ liệu được giám sát và khắc phục tốt hơn.
Đa dạng kiểu dữ liệu
Hồ dữ liệu dựa trên đám mây cho phép nhiều kiểu và định dạng dữ liệu mà không bị ràng buộc bởi kiến trúc.
Kiến trúc trích xuất và biến đổi có thể hạn chế kiểu dữ liệu (cần thêm công sức kỹ thuật ở các giai đoạn trích xuất và biến đổi cho các loại dữ liệu khác nhau).
Triển khai thời gian thực
Phân tích dữ liệu có thể thực hiện ngay trên nền tảng với độ trễ tối thiểu từ lúc dữ liệu phát sinh đến biến đổi và phân tích.
Tính chất chạy theo lô theo lịch của pipeline ngăn cản phân tích dữ liệu thời gian thực.
Chi phí và bảo trì
Tiết kiệm chi phí và dễ bảo trì hơn vì cần ít thành phần tính toán và mã hóa hơn. Việc biến đổi và nạp dữ liệu có thể thực hiện khi cần.
Tốn kém hơn vì đòi hỏi nhiều tài nguyên tính toán và các chuyên gia dữ liệu giàu kinh nghiệm.
Quy mô
Mở rộng nhanh hơn và ít tốn kém hơn nhờ loại bỏ phần cứng trung gian phục vụ di chuyển dữ liệu.
Có thể chậm và tốn kém do cần phần cứng tốt hơn và tối ưu mã để đáp ứng nguồn dữ liệu lớn hơn.
Di chuyển dữ liệu
Không hoặc tối thiểu.
Cần di chuyển dữ liệu vì pipeline là rời rạc và dữ liệu phải được chuyển tới giai đoạn nạp.
Zero-ETL so với các kỹ thuật tích hợp dữ liệu khác
Dưới đây là so sánh giữa zero-ETL và các kỹ thuật tích hợp dữ liệu nổi bật khác, làm rõ điểm chung và khác biệt cốt lõi.
Zero-ETL so với ELT
Zero-ETL so với API
Các công cụ Zero-ETL hàng đầu
Như đã thấy trong bài viết này, zero-ETL là một công cụ quản lý dữ liệu tiên tiến đã thu hút sự quan tâm trong ngành, phần lớn được phổ biến bởi AWS và được các nhà cung cấp đám mây khác áp dụng.
Dưới đây là tổng quan ngắn về các công cụ zero-ETL hàng đầu hiện nay:
Các công cụ zero-ETL của AWS
Các công cụ Zero-ETL từ nhà cung cấp đám mây khác
Ngoài AWS, các nhà cung cấp đám mây khác cũng cung cấp các nền tảng dữ liệu hợp nhất với khả năng zero-ETL:
Kết luận
Loại bỏ các giai đoạn ETL truyền thống trong pipeline phân tích dữ liệu và học máy tạo ra một sự chuyển dịch lớn trong tư duy kỹ thuật dữ liệu. Tích hợp kiến trúc zero-ETL mang lại lợi ích đáng kể, bao gồm tăng tốc độ, nâng cao bảo mật và khả năng mở rộng tốt hơn.
Tuy nhiên, sự chuyển dịch này cũng đem tới thách thức. Nhu cầu về các kỹ năng kỹ thuật dữ liệu truyền thống có thể giảm, đòi hỏi nhà phân tích dữ liệu, nhà khoa học học máy và nhà khoa học dữ liệu phải tiếp thu nhiều khái niệm và kỹ năng tích hợp dữ liệu nâng cao hơn.
Zero-ETL tập trung vào nhu cầu của nhà phân tích dữ liệu và kỹ sư học máy, gợi mở tương lai nơi các vai trò này trở nên trung tâm hơn, có thể định hình lại nhu cầu thị trường lao động và bộ kỹ năng.
Nếu bạn quan tâm tìm hiểu sâu hơn về kiến trúc dữ liệu, hãy xem khóa học ETL và ELT trong Python!