
Kurs
ETL und ELT mit Python
4 Std.
39.5K
In modernen Unternehmen steigt der Druck, Dateninsights schneller bereitzustellen. Es braucht einen Ansatz, der den Weg von der Datenerfassung bis zu Analytics, Künstlicher Intelligenz und Machine-Learning-Einsatz deutlich verkürzt.
Klassische ETL-Architekturen (Extract, Transform, Load) stoßen bei den Anforderungen von Big Data und Echtzeitanalysen an Grenzen. Deshalb ist mit Zero-ETL eine neue Datenmanagement-Architektur entstanden, die ETL-Prozesse minimiert oder ganz überflüssig macht.
Zero-ETL ist ein Integrationsansatz, der die Erstellung von ETL-Datenpipelines reduziert oder ganz vermeidet. Durch Abfragen über verschiedene Datensilos hinweg, ohne die Daten physisch zu verschieben, verschlankt Zero-ETL die Datenverarbeitung und steigert die Effizienz.
Der Begriff „Zero-ETL“ wurde 2022 auf der AWS re:Invent geprägt, als die Integration von Amazon Aurora mit Amazon Redshift angekündigt wurde. Seither hat AWS das Konzept weiterentwickelt – vor allem mit Services, die direkte Datenanalyse und -transformation innerhalb der Datenplattform ermöglichen, ohne separate ETL-Pipelines zu benötigen.
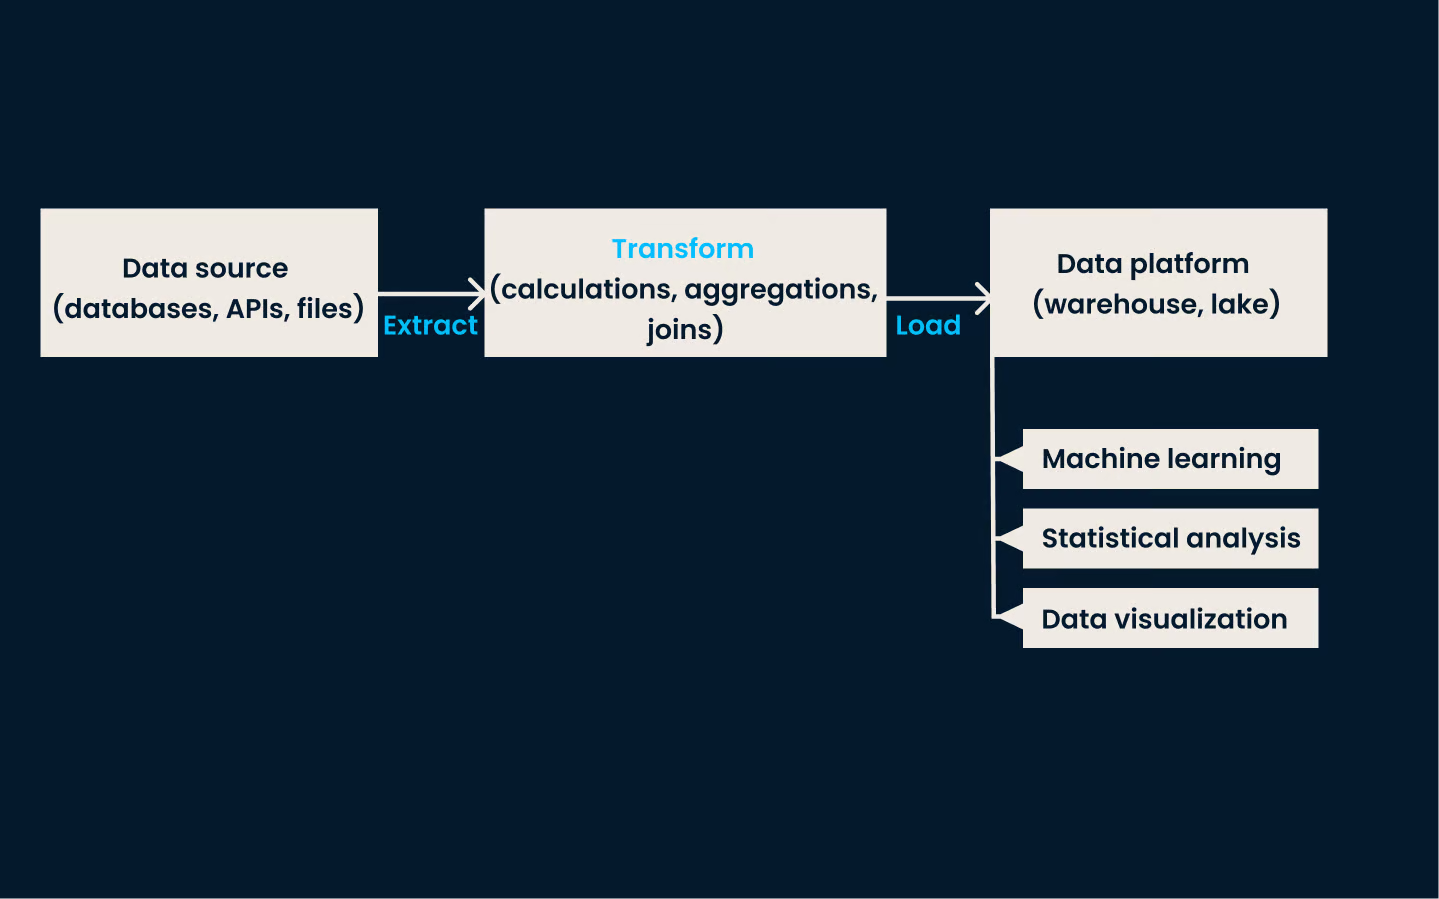
In einer typischen ETL-Pipeline sammelt eine Datenfachkraft, etwa ein Data Engineer oder Data Scientist, Daten aus Quellen wie Datenbanken, APIs, JSON- oder XML-Dateien.
Nach der Extraktion werden die Daten transformiert – etwa durch das Zusammenführen, Berechnen, Mergen von Tabellen oder das Entfernen unnötiger Informationen wie Zeitstempel oder User-IDs.
Anschließend werden die transformierten Daten in eine Plattform geladen, um sie weiter zu analysieren – zum Beispiel für Machine Learning, statistische Analysen oder Datenvisualisierung. Dieser Ablauf ist komplex und kostet viel Zeit, Geld und Aufwand.
Traditionelle ETL-Architektur
Stell dir folgendes Bild vor: In der analogen Fotografie wird ein Foto mit einem Negativ aufgenommen (Datenextraktion), im Dunkelraum entwickelt (Transformation) und anschließend ausbelichtet und gezeigt (Laden). Mit einer Digitalkamera hingegen entsteht das Bild an einem Ort, ist fertig entwickelt und sofort anzeigbar – oder wird live übertragen.
Ganz ähnlich verändert Zero-ETL die Datenverarbeitung, indem Extraktion, Transformation und Laden entfallen. Die Architektur minimiert Datenbewegungen und ermöglicht, alle Daten in einer einzigen Plattform zu transformieren und zu analysieren.
Zero-ETL verspricht Echtzeit-Analysen oder sehr geringe Latenzen – für Data Scientists ebenso wie für Business-Entscheider.
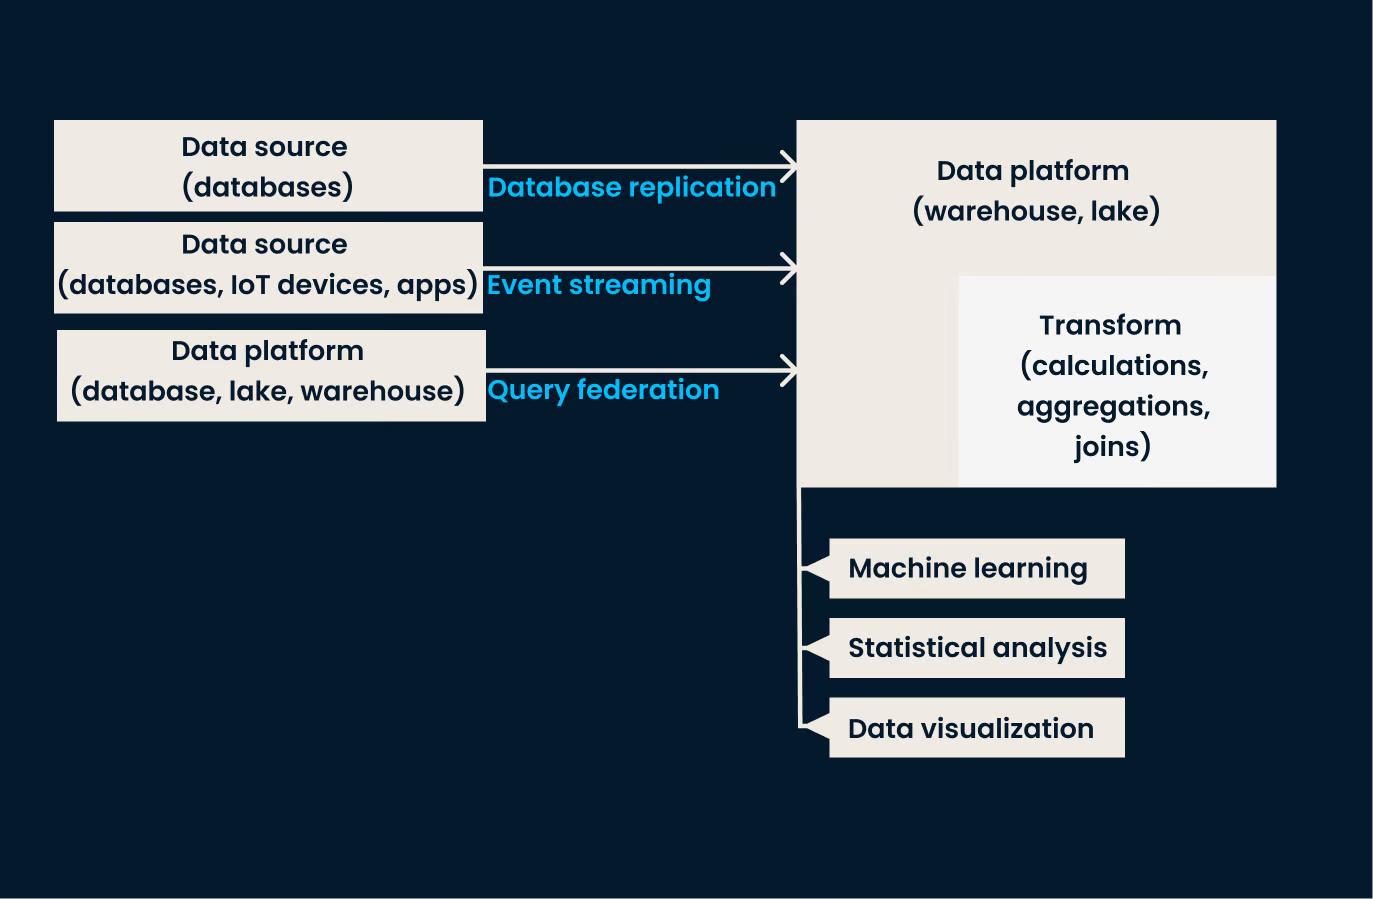
Zero-ETL vereinfacht die Datenintegration, indem Datenquellen direkt mit Data Warehouses oder Data Lakes verknüpft werden – so stehen Daten für Analysen und Reports in Echtzeit bereit. Möglich wird das durch verschiedene Cloud-Technologien und -Services, wie etwa:
Unter Datenbankreplikation versteht man das Kopieren und Synchronisieren von Daten von einer Datenbank in eine andere.
Im Zero-ETL-Kontext zwischen Datenbank und Data Warehouse sorgt Replikation dafür, dass das Warehouse automatisch in Echtzeit oder nahezu in Echtzeit aktualisiert wird – separate ETL-Prozesse entfallen. So funktioniert z. B. die Integration zwischen Amazon Aurora und Amazon Redshift.
Föderierte Abfragen ermöglichen es, Abfragen über mehrere Datenquellen – etwa Datenbanken, Warehouses oder Lakes – auszuführen, ohne die Daten in einen zentralen Speicher zu bewegen oder zu replizieren.
Im Zero-ETL-Ansatz greifen Datenfachleute direkt auf Daten in unterschiedlichen Plattformen zu und analysieren sie, erhalten so eine einheitliche Sicht – ohne den Overhead klassischer ETL-Prozesse.
Datenstreaming bezeichnet die kontinuierliche, echtzeitnahe Verarbeitung und Übertragung von Daten, sobald sie entstehen.
Bei Zero-ETL werden Daten aus verschiedenen Quellen (z. B. Datenbanken, IoT-Geräten oder Anwendungen) erfasst und sofort in ein Data Warehouse oder einen Data Lake geliefert. So sind sie praktisch ohne Verzögerung für Analysen und Abfragen verfügbar – ohne Batch-ETL.
Für In-place-Analysen werden die nötigen Transformationen direkt in der Cloud-Datenplattform, etwa im Data Lake, integriert. Dadurch finden Verarbeitung und Analyse dort statt, wo die Daten liegen – mit weniger Latenz und höherer Effizienz.
Beispielsweise lassen sich unstrukturierte Daten im JSON- oder XML-Format per „Schema-on-Read“ direkt im Data Lake transformieren und analysieren – ohne sie vorab in einen reportingfertigen Speicher zu verschieben.
Beispiel für eine Zero-ETL-Datenarchitektur
Auch wenn Zero-ETL so klingt, als gäbe es keine oder nur einen einzigen Baustein: Je nach Ziel und Ressourcen kommen unterschiedliche Elemente und Services zum Einsatz. Dazu zählen:
Cloud-Anbieter bieten spezialisierte Services, die Zero-ETL-Integrationen automatisieren. Wie erwähnt, repliziert bei AWS die Integration von Amazon Aurora und Amazon Redshift Daten, die in Aurora geschrieben werden, automatisch nach Redshift. Diese Services übernehmen Replikation und Transformation intern – klassische ETL-Prozesse entfallen.
CDC ist ein Kernelement von Zero-ETL. Es überwacht kontinuierlich Änderungen (Insert, Update, Delete) in Quellsystemen und repliziert sie in Echtzeit in Zielsysteme.
Streaming-Pipelines transportieren Daten in Echtzeit von unterschiedlichen Quellen ins Zielsystem. Plattformen wie Amazon Kinesis und Apache Kafka ermöglichen kontinuierlichen Datenfluss mit niedriger Latenz.
Serverless-Architekturen unterstützen Zero-ETL, indem sie Infrastruktur automatisch managen und je nach Bedarf skalieren. Services wie AWS Lambda oder Google Cloud Functions führen Funktionen ereignisgesteuert aus.
Beim Schema-on-Read wird das Schema erst beim Lesen angewandt – das erhöht die Flexibilität beim Umgang mit unstrukturierten und semi-strukturierten Formaten wie JSON und XML. Vordefinierte Schemata werden weniger benötigt, dynamische Analysen werden einfacher.
Zero-ETL erleichtert die Aufnahme und Duplizierung von Daten aus verschiedenen Quellen durch Datenföderation. Data Lakes und plattformübergreifende Datenvirtualisierung schaffen dabei eine abstrakte Objektschicht und vereinfachen die Duplizierung, ohne umfangreiche Transformationen und Datenbewegungen. Mit Datenvirtualisierung greifen Nutzende über Systeme hinweg zu, als lägen die Daten an einem Ort.
Im Zero-ETL-Ansatz finden Transformationen und Analysen direkt in der Datenplattform statt. So lassen sich unstrukturierte Daten in verschiedenen Formaten (Video, Bilder, Text, numerisch) in einem multiformalen Speicher wie einem Data Lake managen – oft ohne vorgelagerte Transformationen.
Zero-ETL klingt nach einem vielversprechenden Weg zu mehr Effizienz in der Data Science. Dennoch lohnt sich der Blick auf beide Seiten – Vorteile wie auch mögliche Nachteile einer Zero-ETL-Einführung.
Zero-ETL bringt mehrere Pluspunkte für Datenmanagement und Analytics, darunter:
Trotz der Vorteile gibt es Herausforderungen, zum Beispiel:
Zero-ETL zeigt seine Stärken in verschiedenen Echtzeit- und Analyse-Szenarien. Typische Use Cases sind:
Die folgende Tabelle vergleicht Zero-ETL mit traditionellen ETL-Prozessen im Detail.
Im Folgenden der Vergleich von Zero-ETL mit anderen gängigen Techniken – Gemeinsamkeiten und zentrale Unterschiede im Überblick.
Wie gezeigt, ist Zero-ETL ein moderner Datenmanagement-Ansatz, der vor allem durch AWS populär wurde und inzwischen von weiteren Cloud-Anbietern aufgegriffen ist.
Hier ein kurzer Überblick über die führenden Zero-ETL-Tools:
Neben AWS bieten weitere Clouds integrierte Datenplattformen mit Zero-ETL-Fähigkeiten:
Das Streichen klassischer ETL-Phasen in Analytics- und ML-Pipelines verändert das Data Engineering grundlegend. Zero-ETL bringt klare Vorteile: mehr Geschwindigkeit, höhere Sicherheit und bessere Skalierbarkeit.
Gleichzeitig entstehen neue Herausforderungen. Traditionelle Data-Engineering-Aufgaben werden weniger, während Data Analysts, Machine-Learning-Spezialistinnen und Data Scientists mehr Integrationskompetenzen aufbauen müssen.
Zero-ETL rückt die Bedürfnisse von Data Analysts und ML Engineers in den Mittelpunkt – und deutet auf eine Zukunft hin, in der diese Rollen noch zentraler werden und das Anforderungsprofil am Arbeitsmarkt sich entsprechend verschiebt.
Wenn du tiefer in Datenarchitekturen einsteigen willst, schau dir unseren Kurs ETL and ELT in Python an!
Vertiefe dein Wissen zu Datenarchitektur und -management mit diesen Kursen!
Kurs
Kurs
Kurs
Blog
Blog
Nisha Arya Ahmed
15 Min.
Blog
Hesam Sheikh Hassani
15 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Allan Ouko
11 Min.
Tutorial
Sejal Jaiswal
24 Min.




