课程
使用 Python 中的 statsmodels 进行回归入门
4 小时
63K
线性回归是数据分析和数据科学中的一项强大工具。它用于量化因变量与一个或多个自变量之间的关系。如果您熟悉线性回归,您可能也了解常见的拟合优度指标R平方,它表示因变量方差中由自变量解释的比例。不过,您可能对调整后的R平方不太熟悉,它常用于包含多个预测变量的更复杂模型。
本文将帮助您全面理解调整后的R平方、它在模型评估中的重要性、与R平方的关键差异,以及它在多元回归场景中的应用,从而更全面地掌握这些模型统计指标。开始之前,强烈推荐学习 DataCamp 的Python 中使用 statsmodels 的回归入门课程以及我们的R 语言中的回归入门课程,了解回归模型以及如何解读包括调整后的R平方在内的各类性能指标。
R平方衡量的是模型中的一个或多个自变量对因变量方差的解释比例。调整后的R平方同样用于解释方差,但它多考虑了一点:顾名思义,它会调整R平方的取值,对无关(这里特指高度共线)的变量进行惩罚。它通过同时考虑预测变量的数量和样本量来实现这一点。
要计算调整后的R平方,我们首先需要得到R平方。尽管求R平方有不同方法,下面的公式是最常见的一种:
这里,R平方等于1减去残差平方和与总离差平方和之比。
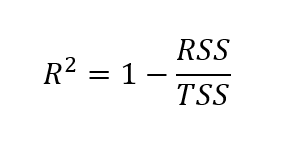
其中:
得到R平方后,我们即可计算调整后的R平方。方法是将R平方代入下面的公式。
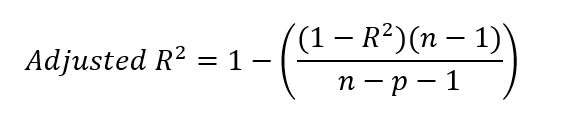
其中:
我们来做个练习。设想这样一个情景:我们有一个包含30个观测值的数据集,构建了一个包含5个预测变量的多元线性回归模型,得到R平方为0.8。下面展示如何据此求出调整后的R平方:
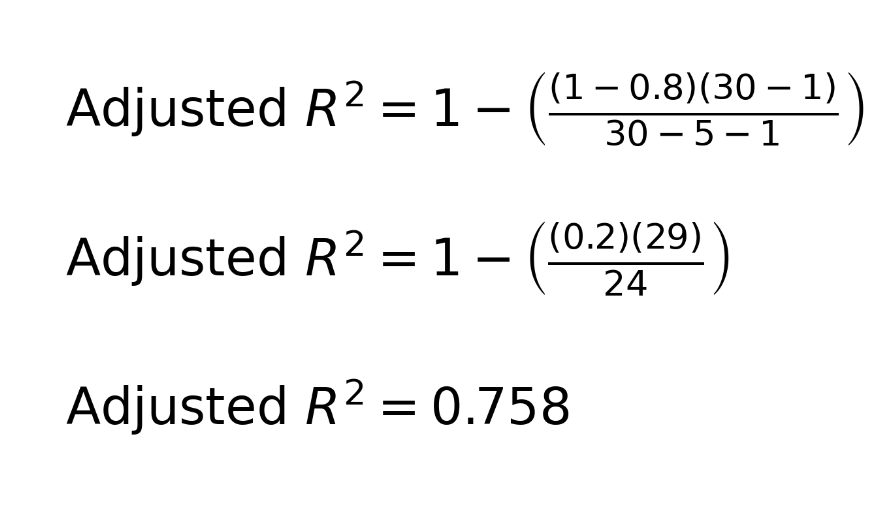
您可能会好奇,为什么等式的分子和分母里都有-1。解释如下:分子中的n−1体现自由度,用于修正用样本均值计算方差时的偏差。因为计算方差时通常用样本均值来估计总体均值,而样本均值并不等于真实总体均值,方差往往会被低估。为矫正这一偏差,我们将自由度减少1。
在分母中,n−p−1用于根据模型中的预测变量个数p进行调整,其中p表示自变量数量。分母中的额外−1是为了修正对模型截距的估计,这同样会消耗一个自由度。请牢记,在回归模型中,我们既要估计预测变量的斜率系数,也要估计截距,以反映模型的完整复杂度。
尽管R平方和调整后的R平方都用于评估回归模型性能,但两者存在关键区别。R平方在向模型添加更多预测变量时总是会增加或保持不变,即使这些变量并未显著提升模型的解释力。这会造成对模型有效性的误导性印象。
调整后的R平方会根据模型中的自变量数量对R平方进行校正。如果新引入的预测变量未能改善模型拟合,调整后的R平方可能会降低,因此它是更可靠的模型准确性度量。基于这一点,数据分析师可以借助调整后的R平方来帮助判断应纳入哪些预测变量。
在构建可靠模型时,了解何时应优先使用调整后的R平方十分重要。以下场景适合用调整后的R平方来评估模型:
总体来说,在多元回归模型中,由于调整后的R平方会考虑预测变量数量并惩罚加入无关变量,因此通常优于R平方。但在以下情形下,使用R平方依然可能合适:
考虑一个示例,帮助对比R平方与调整后的R平方的差异。假设我们有以下两个回归模型:
我们或许会说,模型1的R平方更高,似乎对数据的总体方差解释更多。但我们也必须考虑,模型2可能更好地解释了变量之间的真实关系,因为它考虑了无关预测变量的影响。模型2较高的调整后R平方表明,其通过惩罚不必要的复杂度而提供了更可靠的拟合,同时也更不易过拟合。就我个人而言,在缺乏其他信息时,我会选择模型2。
下面我们在 R 与 Python 中演示如何计算调整后的R平方。我们将使用 Kaggle 上的“Fish Market”数据集,用于根据鱼的品种和各项物理测量来估计其重量。为简化演示,我们将输出结果四舍五入到小数点后五位。
下载数据集并保存在您的工作目录中。使用以下代码,将鱼的重量作为因变量,拟合包含多个变量的线性模型,包括Length1、Height、Width和Length3,它们分别表示鱼的垂直长度、高度、对角宽度和交叉长度。
# Load the dataset
data <- read.csv("data/Fish.csv")

# Remove rows with missing values
data <- na.omit(data)

# Model 1: Using 4 predictors ('Length1', 'Height', 'Width', 'Length3')
model1 <- lm(Weight ~ Length1 + Height + Width + Length3, data = data)
现在,我们查看R平方和调整后的R平方,结果如下。调整后的R平方非常接近R平方,仅略低一些。
r_squared_model1 <- round(summary(model1)$r.squared, 4)
r_squared_model1 <- round(summary(model1)$adj.r.squared, 4)
0.88527
0.88229如果我们再添加一个预测变量呢?这次我们构建第二个模型,加入Length2(鱼的对角长度)。与之前相同,我们可以查看新模型的R平方和调整后的R平方。
# Model 2: Adding one more predictor ('Length2')
model2 <- lm(Weight ~ Length1 + Height + Width + Length3 + Length2, data = data)
r_squared_model2 <- round(summary(model1)$r.squared, 4)
r_squared_model2 <- round(summary(model1)$adj.r.squared, 4)0.88529
0.88154对于模型2,我们可以看到与模型1相比,R平方几乎没有增加。同时,调整后的R平方下降了,而且其下降幅度超过了R平方的上升幅度。这表明我们新增的预测变量并不好。
想一想,Length2(鱼的对角长度)很可能与模型中的其他变量或它们的线性组合高度相关。尤其是,我们预期鱼的对角长度与鱼的长度和交叉长度高度相关。因此,这个新变量并未带来新的、相关的信息。
为了更完整,我们也可以演示如何手工计算调整后的R平方。使用R平方值和模型参数,按照前文给出的公式计算即可。
# Save R-squared as a variable
r_squared_model2 <- summary(model2)$r.squared

# Get the number of observations (n) for both models
n <- nrow(data)  # Same for both models

# Get the number of predictors (excluding intercept) for each model
p_model1 <- length(coef(model1)) - 1
p_model2 <- length(coef(model2)) - 1

# Adjusted r-squared formula for Model 1
adjusted_r_squared_model1 <- 1 - ((1 - r_squared_model1) * (n - 1)) / (n - p_model1 - 1)

# Adjusted r-squared formula for Model 2
adjusted_r_squared_model2 <- 1 - ((1 - r_squared_model2) * (n - 1)) / (n - p_model2 - 1)

# Print R-squared values for both models
cat("R-Squared for Model 1:", r_squared_model1, "\n")
cat("R-Squared for Model 2:", r_squared_model2, "\n")

# Print the Adjusted R-Squared values for both models
cat("Adjusted R-Squared for Model 1:", adjusted_r_squared_model1, "\n")
cat("Adjusted R-Squared for Model 2:", adjusted_r_squared_model2, "\n")以下代码演示用 Python 进行相同示例的实现。
# Import requied libraries
import pandas as pd
import statsmodels.api as sm

# Load the dataset
data = pd.read_csv('data/Fish.csv')

# Drop rows with missing values if any exist
data = data.dropna()

# Define predictors for Model 1 (4 variables)
X1 = data[['Length1', 'Height', 'Width', 'Length3']]

# Add a constant (intercept)
X1 = sm.add_constant(X1)

# Define the target variable 'Weight'
y = data['Weight']

# Fit Model 1
model1 = sm.OLS(y, X1).fit()

# Define predictors for Model 2 (5 variables)
X2 = data[['Length1', 'Height', 'Width', 'Length3', 'Length2']]

# Add a constant (intercept)
X2 = sm.add_constant(X2)

# Fit Model 2
model2 = sm.OLS(y, X2).fit()

# Save r-squared as a variable
r_squared_model1 = model1.rsquared  # R-Squared for Model 1
r_squared_model2 = model2.rsquared  # R-Squared for Model 2

# Get the number of observations
n = X1.shape[0]  # Same for both models

# Get the number of predictors (excluding intercept) for each model
p_model1 = X1.shape[1] - 1  # Number of predictors for Model 1
p_model2 = X2.shape[1] - 1  # Number of predictors for Model 2

# Adjusted R-Squared formula for Model 1
adjusted_r_squared_model1 = 1 - ((1 - r_squared_model1) * (n - 1)) / (n - p_model1 - 1)

# Adjusted R-Squared formula for Model 2
adjusted_r_squared_model2 = 1 - ((1 - r_squared_model2) * (n - 1)) / (n - p_model2 - 1)

# Print R-squared for both models
print("R-Squared for Model 1:", r_squared_model1)
print("R-Squared for Model 2:", r_squared_model2)

# Print the Adjusted R-Squared values for both models
print("Adjusted R-Squared for Model 1:", adjusted_r_squared_model1)
print("Adjusted R-Squared for Model 2:", adjusted_r_squared_model2)
我们也可以直接使用 Python 的函数来获取回归模型的R平方与调整后的R平方:
# Model 1
print("Model 1 R-Squared:", model1.rsquared)
print("Model 1 Adjusted R-Squared:", model1.rsquared_adj)

# Model 2
print("Model 2 R-Squared:", model2.rsquared)
print("Model 2 Adjusted R-Squared:", model2.rsquared_adj)如果您在以上代码部分遇到任何问题,请参阅我们的教程:Python 线性回归基础和如何在 R 中进行线性回归,按步骤学习如何实现并解读回归模型的不同指标。如果您更偏好使用 Excel 进行分析,请查看我们的教程Excel 线性回归:新手完整指南,学习如何在 Excel 中实现并可视化线性回归模型。
讨论调整后的R平方时,也需要厘清相关术语。一些看起来相似的术语用途不同。下面有一张表,比较了几个名称相近但概念不同的指标:R平方、调整后的R平方与预测R平方。
| Metric | Measures | Use Case | Strengths | Limitations |
|---|---|---|---|---|
| R-squared | 模型解释的方差比例 | 了解模型对训练数据的拟合程度 | 易于解读,能快速给出模型拟合情况 | 在比较含不同预测变量的模型时可能误导,易受过拟合影响 |
| Adjusted R-squared | 考虑预测变量数量后,模型解释的方差比例 | 比较包含不同预测变量数量的模型 | 惩罚加入无关变量,有助于防止过拟合 | 不反映模型在新数据上的预测表现 |
| Predicted R-squared | 模型对新数据的预测能力 | 评估模型在未见数据上的表现 | 指示模型对新数据的泛化能力 | 需要交叉验证或留出集,计算成本较高 |
最后,我们来看一些常见错误,因为在回归中关于它的用法经常被误解。
调整后的R平方是评估回归模型性能的重要指标,尤其是在涉及多个自变量的情况下。与R平方相比,当包含多个预测变量时,它能更真实、更可靠地反映模型的准确性。
如果您想了解 R 与 Python 如何求解线性回归模型的系数,请查看以下教程:线性回归的正规方程教程与机器学习中的QR分解:详细指南。
与 DataCamp 一起学习
课程
课程
课程