कोर्स
Python में statsmodels के साथ Regression परिचय
4 घंटा
63K
डेटा विश्लेषण और डेटा साइंस में लीनियर रिग्रेशन एक शक्तिशाली उपकरण है। इसका उपयोग आश्रित चर और एक या अधिक स्वतंत्र चरों के बीच संबंध को मापने के लिए किया जाता है। यदि आप लीनियर रिग्रेशन से परिचित हैं, तो आप r-स्क्वायर्ड नामक सामान्य गुडनेस-ऑफ-फिट माप से भी परिचित हो सकते हैं, जो आश्रित चर में उस वेरिएंस के अनुपात को दर्शाता है जिसे स्वतंत्र चर/चरों द्वारा समझाया गया है। हालांकि, आप एडजस्टेड r-स्क्वायर्ड से कम परिचित हो सकते हैं, जिसका उपयोग अक्सर कई प्रेडिक्टर्स वाले अधिक जटिल मॉडलों में किया जाता है।
यह लेख आपको एडजस्टेड r-स्क्वायर्ड, मॉडल मूल्यांकन में इसकी महत्ता, r-स्क्वायर्ड से इसके प्रमुख अंतर, और मल्टिपल रिग्रेशन परिदृश्यों में इसके उपयोगों की व्यापक समझ देगा ताकि आप इन मॉडल सांख्यिकीय मापों में पूर्ण दक्षता हासिल कर सकें। जैसे ही हम शुरुआत करते हैं, मैं DataCamp के Introduction to Regression with statsmodels in Python कोर्स और हमारे Introduction to Regression in R कोर्स को लेने की अत्यधिक अनुशंसा करता/करती हूं ताकि आप रिग्रेशन मॉडलों और उनके विभिन्न परफॉर्मेंस मैट्रिक्स, जिनमें एडजस्टेड r-स्क्वायर्ड भी शामिल है, की व्याख्या करना सीख सकें।
R-स्क्वायर्ड उस वेरिएंस के अनुपात को मापता है जो मॉडल के स्वतंत्र चर/चरों द्वारा आश्रित चर में समझाया गया है। एडजस्टेड r-स्क्वायर्ड भी वेरिएंस को समझाता है, लेकिन इसमें एक अतिरिक्त विचार शामिल है: जैसा कि नाम सुझाता है, यह एडजस्ट करता है r-स्क्वायर्ड मान को अप्रासंगिक, यानी अत्यधिक सह-रैखिक (highly collinear) चरों को शामिल करने पर दंडित करके। यह प्रेडिक्टर्स की संख्या और सैंपल साइज़ दोनों को ध्यान में रखकर ऐसा करता है।
एडजस्टेड r-स्क्वायर्ड खोजने के लिए, हमें पहले r-स्क्वायर्ड खोजना होगा। यद्यपि r-स्क्वायर्ड मान निकालने के अलग-अलग तरीके हैं, नीचे दिया गया सूत्र सबसे सामान्य में से एक है:
यहां r-स्क्वायर्ड को एक घटा अवशेषों के सम-ऑफ-स्क्वेयर्स को कुल सम-ऑफ-स्क्वेयर्स से भाग देकर प्राप्त भागफल के रूप में गिना जाता है।
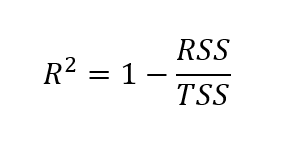
जहां:
r-स्क्वायर्ड मान मिलने के बाद, हम एडजस्टेड r-स्क्वायर्ड निकाल सकते हैं। हम नीचे दिए गए सूत्र में अपने r-स्क्वायर्ड मान को रखते हैं।
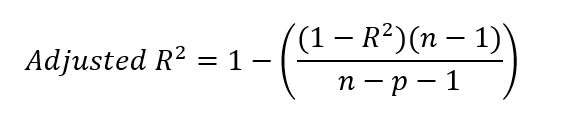
जहां:
अभ्यास के लिए, एक उदाहरण आज़माते हैं। यह स्थिति मान लें: हमारे पास 30 प्रेक्षणों वाला एक डेटासेट है। हम पाँच प्रेडिक्टर्स के साथ एक मल्टिपल लीनियर रिग्रेशन मॉडल बनाते हैं। हमें r-स्क्वायर्ड 0.8 मिलता है। एडजस्टेड r-स्क्वायर्ड निकालने के लिए इस जानकारी का उपयोग इस प्रकार कर सकते हैं:
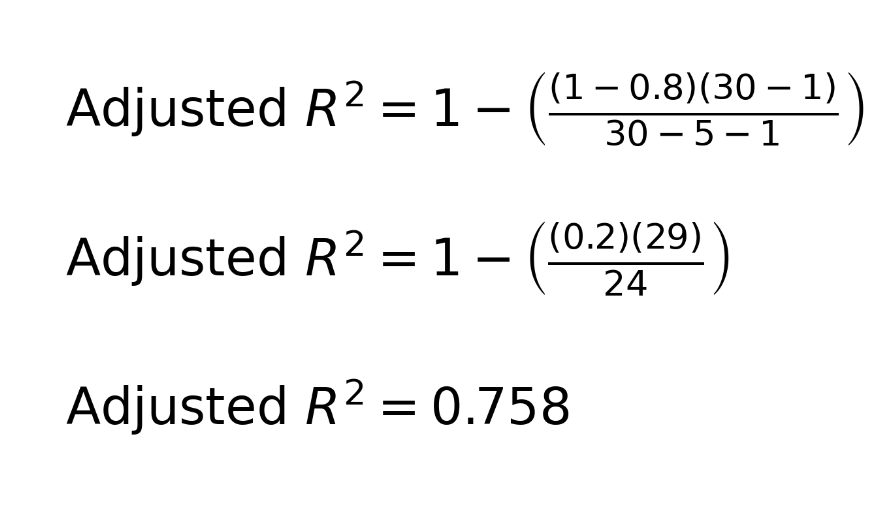
आप समीकरण में, अंश और हर दोनों में -1 के बारे में सोच रहे होंगे। स्पष्ट करने के लिए, अंश में n−1 डिग्रीज़ ऑफ फ्रीडम का हिसाब रखता है, जो वेरिएंस निकालते समय सैंपल मीन के उपयोग के लिए सुधार करता है। इसका कारण यह है कि वेरिएंस की गणना करते समय हम आमतौर पर पॉप्युलेशन मीन के अनुमान के रूप में सैंपल मीन का उपयोग करते हैं। क्योंकि सैंपल मीन वास्तविक पॉप्युलेशन मीन नहीं है, वेरिएंस कम आंकी जा सकती है। इस बायस को सुधारने के लिए, हम डिग्रीज़ ऑफ फ्रीडम को 1 घटा देते हैं।
हर में, n−p−1 मॉडल में प्रेडिक्टर्स की संख्या p के लिए समायोजित करता है, जहां p स्वतंत्र चरों की संख्या है। हर में अतिरिक्त −1 मॉडल के इंटरसेप्ट के अनुमान के लिए सुधार करता है, जो एक डिग्री ऑफ फ्रीडम और उपयोग करता है। हमें याद रखना चाहिए कि रिग्रेशन मॉडल में, हम प्रेडिक्टर्स के स्लोप गुणांकों के साथ-साथ इंटरसेप्ट का भी अनुमान लगाते हैं ताकि पूर्ण जटिलता का हिसाब हो सके।
यद्यपि r-स्क्वायर्ड और एडजस्टेड r-स्क्वायर्ड दोनों रिग्रेशन मॉडल के प्रदर्शन का मूल्यांकन करते हैं, इन दो मेट्रिक्स के बीच एक प्रमुख अंतर है। r-स्क्वायर्ड मान मॉडल में अधिक प्रेडिक्टर्स जोड़ने पर हमेशा बढ़ता है या समान रहता है, भले ही वे प्रेडिक्टर्स मॉडल की व्याख्यात्मक क्षमता में पर्याप्त सुधार न करें। यह समस्या मॉडल की प्रभावशीलता की भ्रामक धारणा बना सकती है।
एडजस्टेड r-स्क्वायर्ड, मॉडल में स्वतंत्र चरों की संख्या का हिसाब रखने के लिए r-स्क्वायर्ड मान को समायोजित करता है। यदि कोई नया प्रेडिक्टर मॉडल के फिट में सुधार नहीं करता है तो एडजस्टेड r-स्क्वायर्ड घट सकता है, जिससे यह मॉडल की सटीकता का अधिक विश्वसनीय माप बन जाता है। इसी कारण, एडजस्टेड r-स्क्वायर्ड डेटा विश्लेषकों के लिए एक उपकरण के रूप में उपयोगी है जो उन्हें यह तय करने में मदद करता है कि किन प्रेडिक्टर्स को शामिल किया जाए।
विश्वसनीय मॉडल बनाने में r-स्क्वायर्ड की तुलना में एडजस्टेड r-स्क्वायर्ड का उपयोग कब करना है, यह समझना महत्वपूर्ण है। निम्नलिखित वे स्थितियां हैं जहां मॉडलों का मूल्यांकन करने के लिए एडजस्टेड r-स्क्वायर्ड का उपयोग उपयुक्त है।
सामान्यतः, मल्टिपल रिग्रेशन मॉडलों में एडजस्टेड r-स्क्वायर्ड को r-स्क्वायर्ड पर प्राथमिकता दी जाती है क्योंकि यह प्रेडिक्टर्स की संख्या का हिसाब रखता है और अप्रासंगिक चरों को जोड़ने पर दंडित करता है, लेकिन कुछ स्थितियां ऐसी भी हैं जहां r-स्क्वायर्ड का उपयोग उपयुक्त हो सकता है:
एक उदाहरण पर विचार करें जहां r-स्क्वायर्ड और एडजस्टेड r-स्क्वायर्ड के बीच के सूक्ष्म अंतर प्रभाव डालेंगे। मान लें हमारे पास ये दो रिग्रेशन मॉडल हैं:
हम कह सकते हैं कि मॉडल 1 का r-स्क्वायर्ड अधिक होने से वह डेटा में समग्र वेरिएंस का अधिक भाग समझाता लगता है। लेकिन हमें यह भी सोचना होगा कि मॉडल 2 अप्रासंगिक प्रेडिक्टर्स का हिसाब रखने के कारण चरों के बीच वास्तविक अंतर्निहित संबंध को अधिक अच्छी तरह समझा सकता है। मॉडल 2 का अधिक एडजस्टेड r-स्क्वायर्ड दर्शाता है कि वह अनावश्यक जटिलता पर दंड लगाकर अधिक विश्वसनीय फिट प्रदान करता है, और संभवतः ओवरफिटिंग की प्रवृत्ति कम है। व्यक्तिगत रूप से, और अन्य जानकारी के अभाव में, मैं मॉडल 2 को चुनूंगा/चुनूंगी।
आइए R और Python में एडजस्टेड r-स्क्वायर्ड की गणना के व्यावहारिक उदाहरण देखें। हम Kaggle के “Fish Market” डेटासेट का उपयोग करेंगे, जो प्रजाति और भौतिक मापों के आधार पर मछली के वज़न का अनुमान लगाने में सहायक है। सरलता के लिए, हम आउटपुट को पाँच दशमलव स्थानों तक राउंड करेंगे।
डेटासेट डाउनलोड करें और उसे अपनी वर्किंग डायरेक्टरी में सहेजें। निम्न कोड का उपयोग करके एक लीनियर मॉडल फिट करें जो मछली के वज़न की भविष्यवाणी कुछ अलग-अलग चरों के फ़ंक्शन के रूप में करता है, जिनमें Length1, Height, Width, और Length3 शामिल हैं, जो क्रमशः मछली की वर्टिकल लंबाई, ऊंचाई, विकर्ण चौड़ाई और क्रॉस लंबाई को संदर्भित करते हैं।
# Load the dataset
data <- read.csv("data/Fish.csv")

# Remove rows with missing values
data <- na.omit(data)

# Model 1: Using 4 predictors ('Length1', 'Height', 'Width', 'Length3')
model1 <- lm(Weight ~ Length1 + Height + Width + Length3, data = data)
अब, हम r-स्क्वायर्ड और एडजस्टेड r-स्क्वायर्ड मान जांचते हैं, और हमें निम्न दिखाई देता है। एडजस्टेड r-स्क्वायर्ड, r-स्क्वायर्ड मान के बहुत करीब है, बस थोड़ा कम।
r_squared_model1 <- round(summary(model1)$r.squared, 4)
r_squared_model1 <- round(summary(model1)$adj.r.squared, 4)
0.88527
0.88229यदि हम अब एक और प्रेडिक्टर जोड़कर दूसरा मॉडल बनाएं तो क्या होगा? इस बार, हम दूसरा मॉडल बनाते हैं और Length2 जोड़ते हैं, जो मछली की विकर्ण लंबाई को संदर्भित करता है। पहले की तरह ही, हम अपने नए मॉडल के r-स्क्वायर्ड और एडजस्टेड r-स्क्वायर्ड मान देख सकते हैं।
# Model 2: Adding one more predictor ('Length2')
model2 <- lm(Weight ~ Length1 + Height + Width + Length3 + Length2, data = data)
r_squared_model2 <- round(summary(model1)$r.squared, 4)
r_squared_model2 <- round(summary(model1)$adj.r.squared, 4)0.88529
0.88154मॉडल 2 के लिए, हम देखते हैं कि मॉडल 1 की तुलना में r-स्क्वायर्ड मान लगभग बढ़ा ही नहीं। साथ ही, एडजस्टेड r-स्क्वायर्ड मान घट गया, और एडजस्टेड r-स्क्वायर्ड में कमी r-स्क्वायर्ड में वृद्धि से अधिक थी। यह हमें बताता है कि जो प्रेडिक्टर हमने जोड़ा वह अच्छा नहीं था।
सोचें तो, Length2 यानी मछली की विकर्ण लंबाई, संभवतः मॉडल के अन्य चरों के साथ या उनके किसी रैखिक संयोजन के साथ अत्यधिक सहसंबद्ध थी। विशेष रूप से, हम अपेक्षा करते हैं कि मछली की विकर्ण लंबाई, मछली की लंबाई और क्रॉस लंबाई के साथ उच्च सहसंबद्ध होगी। इसलिए हमारा नया चर कोई नई, प्रासंगिक जानकारी नहीं जोड़ पाया।
पूर्णता के हित में, हम हाथ से एडजस्टेड r-स्क्वायर्ड कैसे निकालें, यह भी दिखा सकते हैं। हम r-स्क्वायर्ड मान और मॉडल पैरामीटर्स लेते हैं और पहले दिखाए गए सूत्र का पालन करते हैं।
# Save R-squared as a variable
r_squared_model2 <- summary(model2)$r.squared

# Get the number of observations (n) for both models
n <- nrow(data)  # Same for both models

# Get the number of predictors (excluding intercept) for each model
p_model1 <- length(coef(model1)) - 1
p_model2 <- length(coef(model2)) - 1

# Adjusted r-squared formula for Model 1
adjusted_r_squared_model1 <- 1 - ((1 - r_squared_model1) * (n - 1)) / (n - p_model1 - 1)

# Adjusted r-squared formula for Model 2
adjusted_r_squared_model2 <- 1 - ((1 - r_squared_model2) * (n - 1)) / (n - p_model2 - 1)

# Print R-squared values for both models
cat("R-Squared for Model 1:", r_squared_model1, "\n")
cat("R-Squared for Model 2:", r_squared_model2, "\n")

# Print the Adjusted R-Squared values for both models
cat("Adjusted R-Squared for Model 1:", adjusted_r_squared_model1, "\n")
cat("Adjusted R-Squared for Model 2:", adjusted_r_squared_model2, "\n")निम्न कोड Python में उसी उदाहरण का कार्यान्वयन दिखाता है।
# Import requied libraries
import pandas as pd
import statsmodels.api as sm

# Load the dataset
data = pd.read_csv('data/Fish.csv')

# Drop rows with missing values if any exist
data = data.dropna()

# Define predictors for Model 1 (4 variables)
X1 = data[['Length1', 'Height', 'Width', 'Length3']]

# Add a constant (intercept)
X1 = sm.add_constant(X1)

# Define the target variable 'Weight'
y = data['Weight']

# Fit Model 1
model1 = sm.OLS(y, X1).fit()

# Define predictors for Model 2 (5 variables)
X2 = data[['Length1', 'Height', 'Width', 'Length3', 'Length2']]

# Add a constant (intercept)
X2 = sm.add_constant(X2)

# Fit Model 2
model2 = sm.OLS(y, X2).fit()

# Save r-squared as a variable
r_squared_model1 = model1.rsquared  # R-Squared for Model 1
r_squared_model2 = model2.rsquared  # R-Squared for Model 2

# Get the number of observations
n = X1.shape[0]  # Same for both models

# Get the number of predictors (excluding intercept) for each model
p_model1 = X1.shape[1] - 1  # Number of predictors for Model 1
p_model2 = X2.shape[1] - 1  # Number of predictors for Model 2

# Adjusted R-Squared formula for Model 1
adjusted_r_squared_model1 = 1 - ((1 - r_squared_model1) * (n - 1)) / (n - p_model1 - 1)

# Adjusted R-Squared formula for Model 2
adjusted_r_squared_model2 = 1 - ((1 - r_squared_model2) * (n - 1)) / (n - p_model2 - 1)

# Print R-squared for both models
print("R-Squared for Model 1:", r_squared_model1)
print("R-Squared for Model 2:", r_squared_model2)

# Print the Adjusted R-Squared values for both models
print("Adjusted R-Squared for Model 1:", adjusted_r_squared_model1)
print("Adjusted R-Squared for Model 2:", adjusted_r_squared_model2)
हम Python में फ़ंक्शंस का उपयोग करके रिग्रेशन मॉडलों के r-स्क्वायर्ड और एडजस्टेड r-स्क्वायर्ड मान भी निकाल सकते हैं:
# Model 1
print("Model 1 R-Squared:", model1.rsquared)
print("Model 1 Adjusted R-Squared:", model1.rsquared_adj)

# Model 2
print("Model 2 R-Squared:", model2.rsquared)
print("Model 2 Adjusted R-Squared:", model2.rsquared_adj)
यदि आपको ऊपर दिए गए कोड अनुभागों में कोई दिक्कत हुई हो, तो हमारे ट्यूटोरियल Essentials of Linear Regression in Python और How to Do Linear Regression in R देखें, जिनमें रिग्रेशन मॉडल को लागू करने और उसके विभिन्न मैट्रिक्स की व्याख्या करने की चरण-दर-चरण मार्गदर्शिका है। यदि Excel आपका पसंदीदा विश्लेषण उपकरण है, तो हमारा ट्यूटोरियल Linear Regression in Excel: A Comprehensive Guide For Beginners देखें, जिसमें Excel में लीनियर रिग्रेशन मॉडल लागू करने और विज़ुअलाइज़ करने का तरीका बताया गया है।
एडजस्टेड r-स्क्वायर्ड पर विचार करते समय, हमें शब्दावली को स्पष्ट रखना चाहिए। कुछ शब्द समान लगते हैं लेकिन उनके उद्देश्य अलग होते हैं। यहां, मैंने एक सारणी बनाई है जो समान लगने वाले लेकिन भिन्न विचारों की तुलना करती है: r-स्क्वायर्ड, एडजस्टेड r-स्क्वायर्ड, और प्रेडिक्टेड r-स्क्वायर्ड।
| मेट्रिक | क्या मापता है | उपयोग का मामला | मजबूतियां | सीमाएं |
|---|---|---|---|---|
| R-स्क्वायर्ड | मॉडल द्वारा समझाए गए वेरिएंस का अनुपात | यह समझना कि मॉडल ट्रेनिंग डेटा पर कितना अच्छा फिट होता है | आसान व्याख्या, जल्दी से मॉडल फिट बताता है | अलग-अलग प्रेडिक्टर्स वाले मॉडलों की तुलना में भ्रामक, ओवरफिटिंग के प्रति संवेदनशील |
| एडजस्टेड R-स्क्वायर्ड | समझाए गए वेरिएंस का अनुपात, प्रेडिक्टर्स की संख्या के लिए समायोजित | अलग-अलग संख्या वाले प्रेडिक्टर्स के मॉडलों की तुलना | अप्रासंगिक चरों को जोड़ने पर दंडित करता है, ओवरफिटिंग रोकता है | नए डेटा पर भविष्यवाणी प्रदर्शन को नहीं दर्शाता |
| प्रेडिक्टेड R-स्क्वायर्ड | मॉडल नए डेटा की कितनी अच्छी भविष्यवाणी करता है | अनदेखे डेटा पर मॉडल के प्रदर्शन का मूल्यांकन | दर्शाता है कि मॉडल नए डेटा पर कितना सामान्यीकृत करता है | क्रॉस-वैलिडेशन या होल्डआउट डेटासेट की आवश्यकता, संगणकीय रूप से महंगा |
अंत में, कुछ सामान्य गलतियों पर नज़र डालते हैं क्योंकि रिग्रेशन में इसके उपयोग के बारे में कुछ आम गलतफहमियां होती हैं।
एडजस्टेड r-स्क्वायर्ड रिग्रेशन मॉडलों के प्रदर्शन का मूल्यांकन करने के लिए एक महत्वपूर्ण मेट्रिक है, विशेषकर तब जब कई स्वतंत्र चर हों। r-स्क्वायर्ड मेट्रिक की तुलना में, जब कई प्रेडिक्टर्स शामिल होते हैं तो यह मॉडल की सटीकता का अधिक यथार्थवादी और विश्वसनीय माप प्रदान करता है।
यदि आप जानना चाहते हैं कि R और Python लीनियर रिग्रेशन मॉडलों के गुणांक कैसे निकालते हैं, तो निम्न ट्यूटोरियल देखें: Normal Equation for Linear Regression Tutorial और QR Decomposition in Machine Learning: A Detailed Guide।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स