

集成前提条件
在集成 AWS Lake Formation 和 AWS Glue 之前,请确保您具备以下条件:
- AWS 账户:可访问 AWS Lake Formation 和 AWS Glue。
- 基础 知识:熟悉数据湖、ETL 和 AWS 服务。
- S3 存储桶:预先配置的 S3 存储桶用于存放数据。
- IAM 角色: 需要具备访问两项服务所需的 IAM 角色和权限。
- CloudFormation:提供了用于部署基础设置的模板。You 可以在 此处找到模板。
集成分步指南
准备好前提条件后,请按以下步骤操作:
步骤 1:设置 AWS Lake Formation
第一步是在开始集成流程之前,部署构建安全数据湖所需的核心 AWS 资源。AWS CloudFormation 模板有助于组织并部署所需资源。
使用提供的 CloudFormation 模板在您的 AWS 账户中创建一个堆栈。此堆栈将预置本教程用例所需的关键资源。
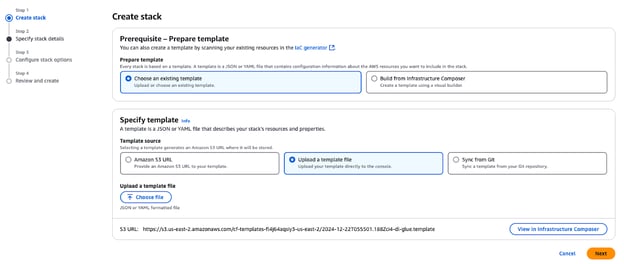
在 AWS CloudFormation 中创建堆栈
部署堆栈后,您的 AWS 账户中将创建以下关键资源:
- Amazon VPC 和子网:为承载资源而提供的 VPC 与公有子网,并包含适当的网络配置。
- Amazon S3 存储桶:
- 存放与博客相关的数据、脚本和结果。
- Hosts 用于构建数据湖的 TPC 数据。
- IAM 角色与策略:
GlueServiceRole:授予 AWS Glue 访问 S3 和 Lake Formation 服务的权限。DataEngineerGlueServiceRole:为工程师提供数据访问与处理的权限。DataAdminUser和DataEngineerUser:预创建的 IAM 用户,用于探索与管理 Lake Formation 的安全性。- AWS Glue Crawler:TPC Crawler,用于扫描并编目存储在 S3 存储桶中的 Parquet 数据。
- Amazon EC2 实例:辅助实例 (
EC2-DB-Loader),用于预加载并将示例数据传输到 S3。 - AWS Secrets Manager:用于安全存储预创建 IAM 用户凭据的密钥 (
lf-users-credentials)。
堆栈创建完成后,您将拥有:
- 一个保存于 Amazon S3 的示例 TPC 数据库。
- 用于探索安全模式与访问控制的预创建用户和角色。
- 用于编目和处理数据的 Glue 配置和爬网程序。
- 完成本文各步骤所需的所有基础组件。
步骤 2:配置数据权限
本节中,数据湖管理员将配置 AWS Lake Formation,使其可供数据消费者(包括数据工程师)使用。管理员将:
- 在 AWS Lake Formation 中创建新数据库以存储 TPC 数据。
- 在 AWS Glue 数据目录中注册 TPC 数据集的元数据表。
- 配置 Lake Formation 标签和策略,为不同用户建立访问权限。
这些配置可提供安全、细粒度的访问控制,并与其他 AWS 服务顺畅协作。
设置数据湖管理员
数据湖管理员是指可对任何数据目录实体授予任何主体(包括其自身)权限的身份与访问管理(IAM)用户或角色。数据湖管理员通常是首位被创建来管理数据目录的用户,通常拥有数据目录的管理权限。
在 AWS Lake Formation 服务中,您可以点击管理角色与任务 -> 添加管理员 在导航面板中打开对话框,然后在下拉列表中选择 lf-data-admin IAM 用户。
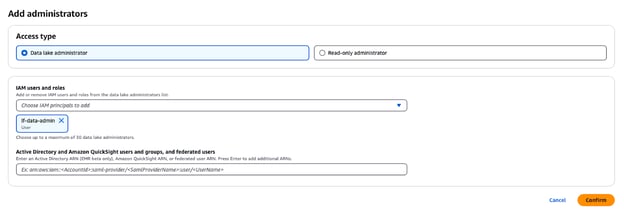
在 AWS Lake Formation 中添加数据湖管理员
更改目录设置
默认情况下,为与 AWS Glue 数据目录兼容,Lake Formation 会选中“仅使用 IAM 访问控制”。若要启用基于 Lake Formation 权限的细粒度访问控制,您需要调整以下设置:
- 在导航窗格的Administration 下,选择 Administrative roles and tasks。
- 如果在 Database creators 下看到
IAMAllowedPrincipals组,选择该组并点击 Revoke。 - 在 Revoke permissions 对话框中,确认该组具有 Create database 权限,然后点击 Revoke。
通过以上步骤,将禁用默认的 IAM 访问控制,并允许您实施 Lake Formation 权限以增强安全性。
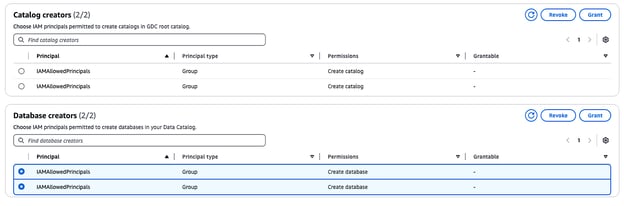
在 AWS Lake Formation 中管理目录和数据库创建者
步骤 3:使用 AWS Glue 数据目录
现在,是时候开始使用 Glue 数据目录了。
创建数据库
要为 TPC 数据创建数据库,请先退出当前 AWS 会话,然后以 lf-data-admin 用户重新登录。使用 CloudFormation 输出提供的登录链接以及从 AWS Secrets Manager 获取的密码。
- 进入 AWS Lake Formation 控制台,从左侧导航中选择 Databases。
- 点击 Create database 按钮。
- 将数据库命名为 “tpc”,该数据库将用于 TPC 数据湖。
- 在 Location 字段中,选择 CloudFormation 堆栈创建的 S3 数据湖路径。此路径可在 CloudFormation 的输出选项卡中找到,命名为
lf-data-lake-account-ID,其中account-ID为您 12 位的 AWS 账户号。 - 取消勾选 Use only IAM access control for new tables in this database 选项,以启用细粒度访问控制。
- 将其他选项保持默认,然后点击 Create database。
该数据库将作为在 Lake Formation 设置中存储与管理 TPC 数据元数据的基础。
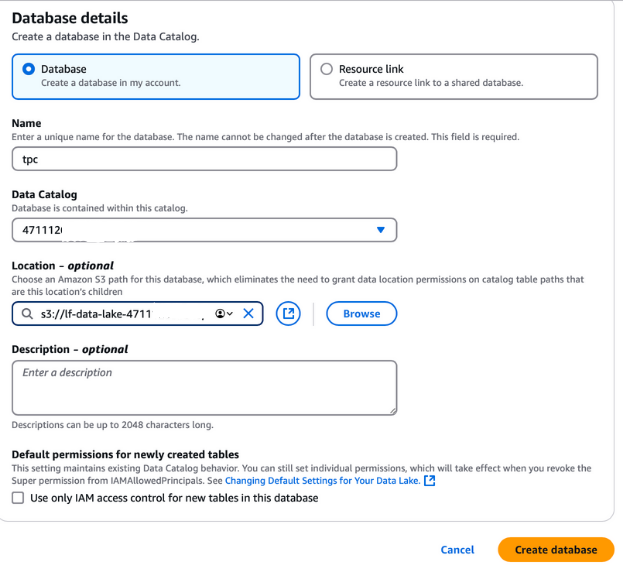
在 AWS Lake Formation 中创建数据库
为数据湖注入数据
我们使用 AWS Glue Crawler 在 AWS Glue 数据目录中创建表。Crawler 是在 AWS Glue 中创建表的最常见方式,它可以一次扫描多个数据存储,并在爬网结束后生成或更新数据目录中的表详情。
在运行 AWS Glue Crawler 之前,您需要为其 IAM 角色授予必要权限:
- 在 AWS Lake Formation 控制台,进入 Databases,选择
tpc数据库。 - 在 Actions 下拉菜单中选择 Grant。
- 在 Grant permissions 对话框中:
- 在 Principals 下,选择 IAM 角色
LF-GlueServiceRole。 - 在 LF-Tags or catalog resources 部分,确保选择 Named data catalog resources。
- 选择
tpc作为数据库。 - 在 Database permissions 部分,勾选 Create table 选项。
- 点击 Grant。
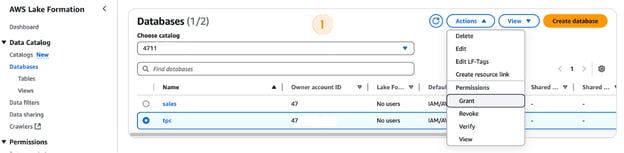
在 AWS Lake Formation 中授予权限
运行 AWS Glue Crawler
授予权限后,继续运行爬网程序:
- 在 AWS Lake Formation 控制台,导航至 Crawlers,点击打开 AWS Glue 控制台。
- 选择名为 TPC Crawler 的爬网程序并点击 Run crawler。
- 通过点击 Refresh 按钮来监控进度。
- 完成后,TPC 数据库将被填充表。查看 Table changes from the last run 列,查看新增的表数量(例如 8 张表)。
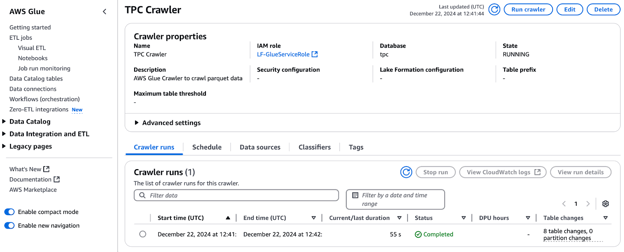
在 AWS Glue 中运行 TPC Crawler
您也可以在 AWS Lake Formation 控制台的 Data catalog 与 Tables 下验证这些表。
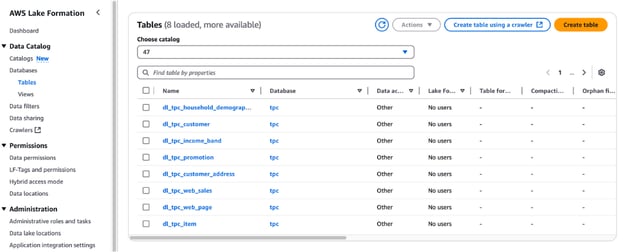
在 AWS Lake Formation 中查看表
注册数据湖位置
必须在 AWS Lake Formation 中注册用于数据湖存储的 S3 存储桶。完成注册后,您即可对 AWS Glue 数据目录对象与底层存储在存储桶中的数据实施细粒度访问控制。
注册数据湖位置的步骤:
- 在 AWS Lake Formation 控制台进入 Data Lake Locations 部分,点击 Register location。
- 输入通过 CloudFormation 模板创建的 S3 存储桶路径。该存储桶将存放在管道过程中引入的数据。
- 在 IAM Role 中,选择由 CloudFormation 模板创建的
LF-GlueServiceRole。 - 在Permission mode 下选择 Lake Formation,以启用高级访问控制功能。
- 点击 Register location 保存配置。
注册完成后,请验证您的数据湖位置以确保配置正确。此步骤对于在 Lake Formation 设置中实现无缝的数据管理与安全至关重要。
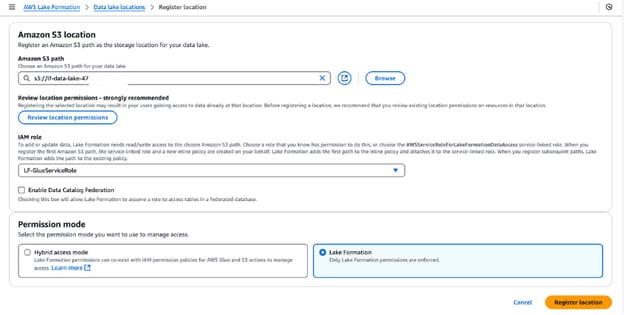
在 AWS Lake Formation 中注册 Amazon S3 位置
Lake Formation 标签(LF-Tags)
LF-Tag 可用于组织资源并一次性在多个资源上设置权限。通过使用分类法组织数据,可以拆解复杂策略并有效管理权限。这之所以可行,是因为使用 LF-Tag 可以将策略与资源解耦,从而在资源创建之前就能设置访问策略。
创建并分配 LF-Tag 的步骤
- 创建 LF-Tag:
- 进入 Lake Formation 控制台,访问 AWS Lake Formation。
- 在导航窗格中选择 LF-Tags and permissions,然后点击 Add LF-Tag。
- 键填写 “Classification”,并添加 “Sensitive” 和 “Non-Sensitive” 作为取值。点击 Add LF-Tag。
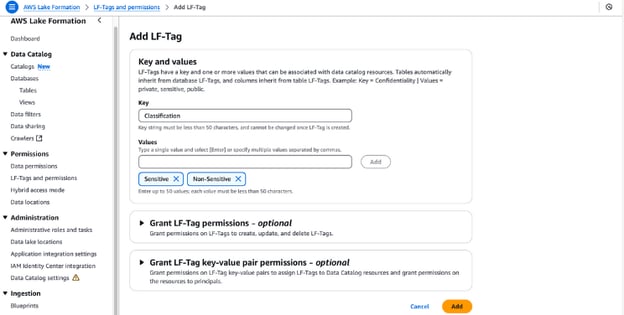
在 AWS Lake Formation 中创建 LF-Tag
- 授予 LF-Tag 权限:
- 确保
lf-data-admin用户具有 LF-Tag 权限。在 Lake Formation 控制台进入 Tables。 - 选择表
dl_tpc_customer,点击 actions 菜单并选择 Grant。 - 在 IAM users and roles 下选择
lf-data-admin。 - 对于 LF-Tags 或目录资源,选择 Named data catalog resources。
- 选择
tpc数据库与表dl_tpc_customer,授予Alter表权限。点击 Grant。
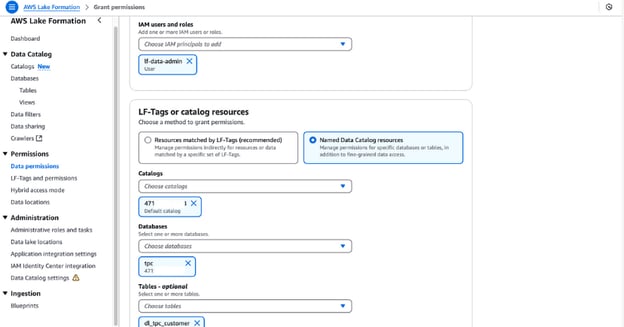
在 AWS Lake Formation 中授予权限
- 为数据目录对象分配 LF-Tag:
- 进入 Tables 并选择
dl_tpc_customer表。打开表详情并在操作菜单中选择 Edit LF-Tags。 - 点击 Assign new LF-Tag,键填写 “Classification”,值设为 “Non-Sensitive”。点击 Save。
- 在表的操作菜单中选择 Edit schema。选择
c_first_name、c_last_name和c_email_address等列,然后点击 Edit LF-Tags。 - 对于继承的键
Classification,将值更改为 “Sensitive”,然后点击 Save。将该配置保存为新版本。 - 将 LF-Tag 应用于其他表:
- 对于
dl_tpc_household_demographics表,进入 Actions 并选择 Edit LF-Tags。 - 在对话框中点击 Assign new LF-Tag。将键设为 Group,值设为 Analyst。点击 Save 完成。
通过以上步骤,您可以高效地为数据目录对象分配 LF-Tag,确保整个数据湖实现安全、细粒度的访问控制。
步骤 4:在 AWS Glue 中创建 ETL 任务
AWS Glue Studio 是一个拖放式用户界面,可帮助用户为 AWS Glue 开发、调试和监控 ETL 任务。数据工程师借助基于 Apache Spark 的 Glue ETL,对存储在 Amazon S3 的数据集进行转换,并将数据加载至数据湖与数据仓库进行分析。为在多团队协作同一数据集时实现有效的访问管理,需要依据角色授予与限制访问。
使用 AWS Lake Formation 授权
按照以下步骤,为 lf-data-engineer 用户及对应的 DE-GlueServiceRole 角色授予所需权限。该角色由数据工程师在 Glue Studio 任务中访问 Glue 数据目录表时使用。
- 以数据湖管理员身份登录:
- 使用
lf-data-admin用户登录 AWS 管理控制台。密码从 AWS Secrets Manager 获取,登录 URL 见 CloudFormation 输出。
- 使用
- 为某张表授予查询权限:
- 在 Lake Formation 控制台进入 Data lake permissions。
- 点击 Grant,并在对话框中填写以下信息:
- IAM users and roles:输入
lf-data-engineer和DE-GlueServiceRole。 - LF-Tags or catalog resources:选择 Named data catalog resources。
- Databases:选择
tpc。 - Tables:选择
dl_tpc_household_demographics。 - Table permissions:选择 Select 和 Describe。
- IAM users and roles:输入
- 点击 Grant 保存权限。
- 为数据库授予创建表权限:
- 再次进入 Data Lake Permissions。
- 点击 Grant,并在对话框中填写以下信息:
- IAM users and roles:输入
DE-GlueServiceRole。 - LF-Tags or catalog resources:选择 Named data catalog resources。
- Databases:选择
tpc(不选择表)。 - Database permissions:选择 Create table。
- IAM users and roles:输入
- 点击Grant 以完成权限配置。
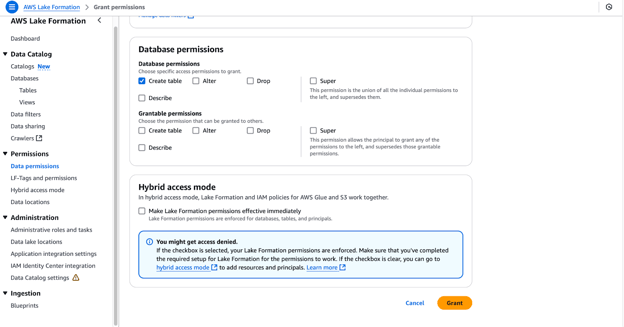
在 AWS Lake Formation 中配置数据库权限
完成上述步骤后,lf-data-engineer 用户与 DE-GlueServiceRole 角色将具备在 Glue Studio 作业中使用 Glue 数据目录表与管理资源所需的权限。该设置确保了对数据湖的安全、基于角色的访问。
创建 Glue Studio ETL 任务
本节我们将使用 SQL Transform 在 AWS Glue Studio 中创建一个 ETL 任务。
- 以
lf-data-engineer身份登录 AWS:- 使用
lf-data-engineer用户登录 AWS 管理控制台。密码从 AWS Secrets Manager 获取,登录 URL 见 CloudFormation 输出。
- 使用
- 打开 Glue Studio 并开始新建作业:
- 进入 Glue Studio 控制台并点击 Visual ETL。
- 将作业重命名为
LF_GlueStudio以便识别。
- 配置作业详情:
- 点击 Job Details 选项卡,设置以下配置:
- IAM role:选择
DE-GlueServiceRole。 - Glue version: 选择 Glue 5.0 - Support Spark 3.1, Scala 2, Python 3。
- Requested number of workers: 设置为 5。
- Job bookmark: 选择 Disable。
- Number of retries: 设置为 0。
- IAM role:选择
- 点击 Job Details 选项卡,设置以下配置:
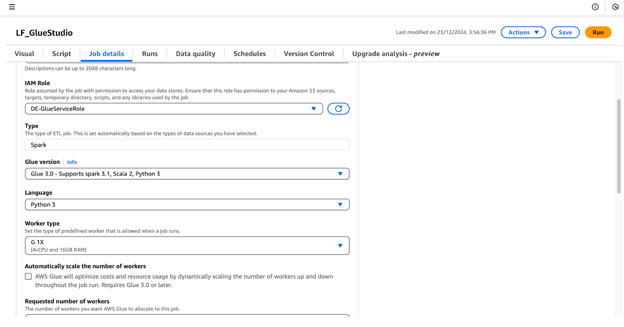
在 AWS Glue Studio 中配置作业详情
- 添加数据源节点:
- 在 Visual 选项卡下,点击+ 按钮并添加一个 AWS Glue Data Catalog 节点来配置数据源。将此节点重命名为 “Amazon S3”。
- 在可视化编辑器中选择 Amazon S3 节点,并在右侧面板配置其属性:
- 在 Data Source Properties - Data Catalog 下设置:
- Database:
tpc。 - Table:
dl_tpc_household_demographics。 (注意:lf-data-admin仅为lf-data-engineer在此表上授予了 Select 权限。其他表不会出现在下拉列表中。)
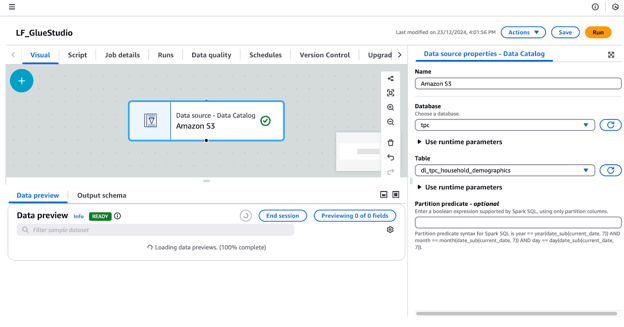
在 AWS Glue Studio 中配置数据源
- 添加并配置 SQL Query 节点:
- 选中 Amazon S3 节点后,点击 + 按钮,添加 SQL Query 节点作为转换。
- 选择 SQL Query 节点并进行配置:
- 在 Transform 下,将您的 SQL 查询输入到 SQL Query 字段。
- 添加以下查询:
/* Select all records where buy potential is between 0 and 500 */
SELECT *
FROM myDataSource
WHERE hd_buy_potential = '0-500';-
-
- 在 Output Schema 下,点击 Edit 并删除键
hd_dep_count和hd_vehicle_count。点击 Apply。
- 在 Output Schema 下,点击 Edit 并删除键
-
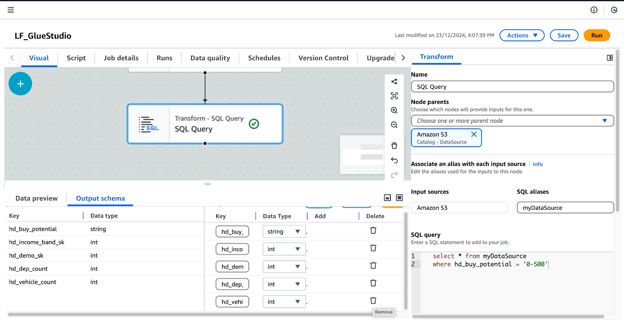
在 AWS Glue Studio 中配置 SQL Query 转换
- 添加数据目标节点:
- 选中 SQL Query 节点后,点击 + 按钮并添加数据目标节点。从搜索结果中选择 Amazon S3 Target。
- 在右侧面板配置 Data Target-S3 节点:
- Format: 选择 Parquet。
- Compression type: 选择 Snappy。
- S3 target location: 输入
s3://<your_LFDataLakeBucketName>/gluestudio/curated/。(将<your_LFDataLakeBucketName>替换为 CloudFormation Outputs 选项卡中的实际存储桶名称。) - Data Catalog update options:选择 Create a table in the Data Catalog and on subsequent runs, update the schema and add new partitions。
- Database:选择
tpc。 - Table name:为输出表命名。例如
dl_tpc_household_demographics_below500。 - 保存并检查作业:
- 点击右上角的 Save 保存作业。
- 可选:切换到 Script 选项卡查看自动生成的脚本。您可以根据需要下载或编辑该脚本。
通过上述步骤,您将创建一个完整可用的 Glue Studio ETL 作业,它会转换数据并将结果写入精选(curated)S3 文件夹,同时更新 Glue 数据目录。
步骤 5:测试与验证集成
要确认在 Lake Formation 中授予的权限,请以 lf-data-engineer 用户身份(如在 Create Glue Studio Jobs 部分所述)执行以下步骤:
- 运行
LF_GlueStudio作业: - 进入 LF_GlueStudio 作业并点击右上角的 Run 按钮执行作业。
- 在作业界面选择 Runs 选项卡来监控作业执行情况。
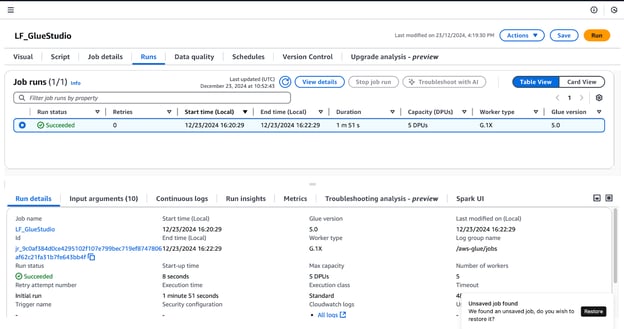
在 AWS Glue Studio 中监控作业运行
- 验证作业输出:
- 当作业运行状态显示为 Succeeded 后,前往 S3 存储桶中的
curated文件夹检查输出文件。这些文件应为 Parquet 格式,符合作业创建时的配置。
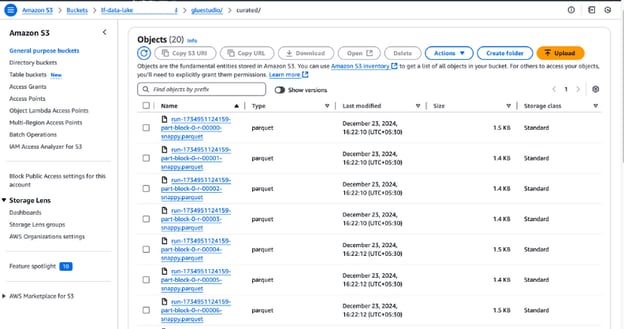
在 Amazon S3 中查看输出文件
- 验证新创建的表:
- 打开 Glue 数据目录并导航至您在作业设置中指定的数据库。
- 检查新表是否列在该数据库下,以确认输出数据已成功编目。
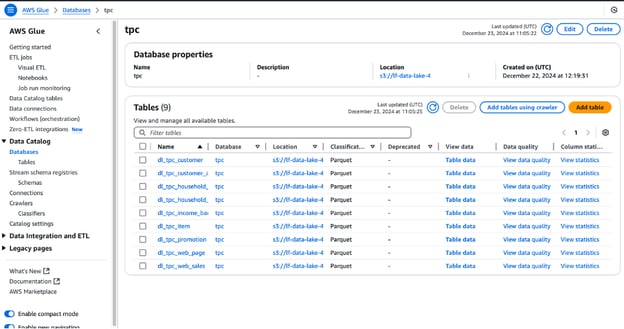
在 AWS Glue 中查看数据库表
集成 AWS Lake Formation 与 AWS Glue 的最佳实践
在集成 AWS Lake Formation 和 AWS Glue 时,遵循最佳实践可增强数据安全、简化运维并优化性能。以下是充分利用这些服务的方法:
优化数据权限
- 采用最小权限原则:仅授予用户和角色所需资源的访问权限。避免分配过宽权限,以免不必要地暴露敏感数据或关键资源。
- 定期审计访问策略:定期审查和更新策略,以符合不断变化的安全与合规要求。利用 AWS IAM Access Analyzer 等工具检测过度授权的策略。
- 利用 LF-Tag 进行策略管理:使用 Lake Formation 标签(LF-Tag)对相关资源分组,简化权限管理。通过应用 Sensitive 或 Non-Sensitive 等标签,您可以创建可扩展、可复用的策略,并自动应用于已打标签的资源。
- 将策略与资源解耦: 在资源创建之前,使用 LF-Tag 或模板定义权限。这样,当新增数据源或表时,可实现顺畅的集成流程。
监控与调试作业
- 为 Glue 作业启用 CloudWatch 日志:CloudWatch Logs 可捕获 AWS Glue 作业执行的详细日志,包括错误和执行细节。利用这些日志快速排障。
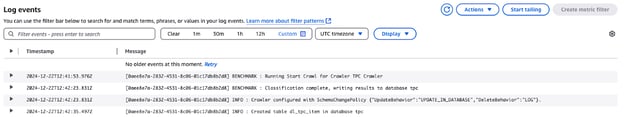
AWS CloudWatch 中 TPC Crawler 的日志事件
- 监控 Glue 指标:AWS Glue 提供有助于识别 ETL 工作流低效或问题的指标。设置 CloudWatch 警报以在出现异常模式时通知您。
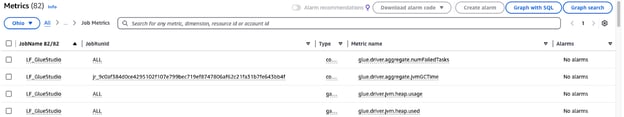
监控 AWS Glue Studio 作业指标
使用分区与压缩
- 优化数据分区:根据常用的查询维度划分数据集,如部门、日期或区域。在 Athena 或 Redshift 中,例如按月份和年份划分销售数据,可以显著加速查询并降低扫描成本。
- 选择合适的压缩格式:使用为分析型负载打造的列式存储格式,如 ORC 或 Parquet。结合使用Snappy 等高效压缩算法,以节省存储并加速查询。
- 在 Glue 作业中自动分区: AWS Glue 作业可在 ETL 过程中动态分区数据。在作业配置中指定分区键,确保新增数据按结构化方式存储。
- 定期监控并调整策略:随着数据量增长,评估压缩与分区策略的效果。分析查询趋势,并相应调整分区方案以适配变化的工作负载。
结论
实施 AWS Lake Formation 和 AWS Glue 有助于组织对数据进行整理、保护与处理。借助 Lake Formation 的完善安全措施与 Glue 的自动化能力,您可以优化 ETL 流程,满足所有数据治理相关策略,并为包括数据工程师和数据科学家在内的用户提供便捷的数据访问。
其收益包括:
- 增强的安全性:通过 LF-Tag 的细粒度访问控制,确保敏感数据仅对获授权用户可见。
- 自动化:AWS Glue 简化数据准备与转换,降低人工操作与错误。
- 可扩展性:动态权限与策略管理,可随数据增长而无缝扩展。
- 高效性:通过分区与压缩优化存储与查询性能,节省时间与成本。
在深入理解数据集成的同时,结合实操学习尤为关键。例如,掌握 Python 中的 ETL 与 ELT 能力,可显著提升您对数据的处理与转换效率。同样,夯实数据管理概念有助于更好地组织与处理数据集。而要确保结果可靠,理解数据质量导论课程中的原则也必不可少。
常见问题
集成 AWS Lake Formation 和 AWS Glue 的目的是什么?
通过实施 AWS Lake Formation 与 AWS Glue,可以构建安全、自动化且可扩展的数据管道。此集成提供全面的访问控制、流畅的 ETL 流程,以及统一的数据管理、分析与合规平台。
LF-Tag 在 AWS Lake Formation 中有何重要意义?
LF-Tag 使大规模权限管理成为可能,因为它通过按一定分类法(例如 “Sensitive” 或 “Non-Sensitive”)组织数据。它们有助于降低访问策略的复杂度,您可以基于标签来设置权限,甚至在资源实际创建之前就进行设置,从而带来灵活性与安全性。
AWS Glue Studio 在本次集成中扮演什么角色?
AWS Glue Studio 是一款带有拖放界面的数据转换工具。用户可通过该界面开发、监控和控制 ETL 作业。它提升了数据转换流程的效率,便于将数据转换为可供进一步分析的形式。
多个团队能否安全地访问同一数据集?
是的,AWS Lake Formation 提供细粒度访问控制能力,您可以将访问权限授予特定角色或基于 LF-Tag 的策略。这样,每个团队只能查看与其相关的数据,同时确保数据得到保护。
文中提到的 TPC 数据集是什么?
TPC 数据集是一种广泛用于培训、基准测试与教学用途的合成数据集。它包含有关各类产品、客户、人口统计数据、网络销售及其他交易相关数据的信息,因而更贴近真实场景。

Rahul Sharma 是一位 AWS 大使、DevOps 架构师与技术博主,专注于云计算、DevOps 实践与开源技术。凭借在 AWS、Kubernetes 与 Terraform 方面的专长,他通过生动易懂的文章与教程,为学习者与专业人士化繁为简。Rahul 热衷于解决 DevOps 难题,并分享洞见以赋能技术社区。
在当今的数据环境中,组织在保护、治理和迁移大数据集方面面临挑战。AWS Lake Formation 和 AWS Glue 是两个可帮助您应对这些挑战的服务。AWS Glue 负责数据清洗、重构和数据类型转换,而 AWS Lake Formation 用于构建数据湖并执行数据安全与管理。
在本文中,我们将演示如何使用 AWS Lake Formation 和 AWS Glue 构建一个安全、自动化的数据管道。我们将使用 AWS Glue 开发一个 ETL 任务,将当前存储在 S3 存储桶中的示例数据进行搬移和处理,并通过 AWS Lake Formation 实现细粒度访问控制。
什么是 AWS Lake Formation?
AWS Lake Formation 提供在 AWS 上创建、管理和保护数据湖所需的工具。借助 Lake Formation,在 Amazon S3 上创建数据湖、管理安全和权限变得更简单。
使用 AWS Lake Formation,您可以:
什么是 AWS Glue?
AWS Glue 是一项无服务器数据集成服务,提供用于数据准备的 抽取、转换和加载(ETL)功能。它是自动化的数据准备服务,可简化数据编目、转换和加载的管理。它可以将来自诸如 S3 等各种来源的数据整合到数据仓库或数据库中。
借助 AWS Glue,您将获得:
如果您是 Glue 新手,请查看我们的AWS Glue 入门教程。
为何要集成 AWS Lake Formation 和 AWS Glue?
集成 AWS Lake Formation 和 AWS Glue 可以兼得两者所长:安全的数据湖与自动化的 ETL 管道。其优势包括: