

Vereisten voor integratie
Voordat je AWS Lake Formation en AWS Glue integreert, zorg dat je het volgende hebt:
- AWS-account: Toegang tot AWS Lake Formation en AWS Glue.
- Basiskennis: Bekendheid met datalakes, ETL en AWS-services.
- S3-bucket: Een vooraf geconfigureerde S3-bucket om je data op te slaan.
- IAM-rollen: Benodigde IAM-rollen en -permissies om beide services te gebruiken.
- CloudFormation: Er is een template beschikbaar om de basisopzet te deployen. Je vindt de template hier.
Stapsgewijze gids voor integratie
Zodra je de vereisten op orde hebt, volg je deze stappen:
Stap 1: AWS Lake Formation instellen
De eerste stap is het deployen van de kern-AWS-resources die nodig zijn om een beveiligd datalake te bouwen, voordat je met de integratie begint. De AWS CloudFormation-template helpt om alle vereiste resources te organiseren en te deployen.
Gebruik de meegeleverde CloudFormation-template om een stack in je AWS-account te maken. Deze stack voorziet in essentiële resources die nodig zijn voor de use-cases in deze tutorial.
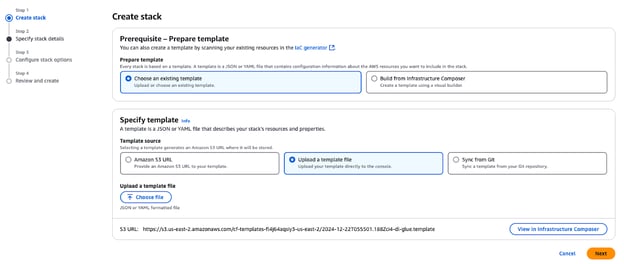
Een stack maken in AWS CloudFormation
Na het deployen van de stack worden de volgende kernresources in je AWS-account aangemaakt:
- Amazon VPC en subnet: Een VPC en een public subnet voor het hosten van resources met de juiste netwerkconfiguraties.
- Amazon S3-buckets:
- Slaat bloggerelateerde data, scripts en resultaten op.
- Host de TPC-data die wordt gebruikt voor het bouwen van het datalake.
- IAM-rollen en -policies:
GlueServiceRole: Verleent AWS Glue toegang tot S3 en Lake Formation-services.DataEngineerGlueServiceRole: Geeft engineers permissies voor data-toegang en -verwerking.DataAdminUserenDataEngineerUser: Vooraf geconfigureerde IAM-gebruikers om Lake Formation-beveiliging te verkennen en beheren.- AWS Glue Crawler: Een TPC Crawler om de Parquet-data in de S3-bucket te scannen en te catalogiseren.
- Amazon EC2-instance: Een helper-instance (
EC2-DB-Loader) voor het vooraf laden en overzetten van voorbeelddata naar S3. - AWS Secrets Manager: Een secret (
lf-users-credentials) om gebruikersreferenties voor de vooraf gemaakte IAM-gebruikers veilig op te slaan.
Nadat de stack is gemaakt, heb je het volgende:
- Een voorbeeld-TPC-database opgeslagen in Amazon S3.
- Vooraf aangemaakte gebruikers en rollen om beveiligingspatronen en toegangscontroles te verkennen.
- Glue-configuraties en crawlers om je data te catalogiseren en te verwerken.
- Alle fundamentele componenten die nodig zijn om de stappen in deze blog te volgen.
Stap 2: Datapermissies configureren
In deze sectie configureert de Data Lake Administrator AWS Lake Formation om het beschikbaar te maken voor dataconsumenten, waaronder data engineers. De beheerder zal:
- Een nieuwe database aanmaken in AWS Lake Formation om TPC-data op te slaan.
- Metadatatabellen voor de TPC-dataset registreren in de AWS Glue Data Catalog.
- Lake Formation-tags en -policies configureren om toegangspermissies voor verschillende gebruikers in te stellen.
Deze configuraties zorgen voor veilige, fijnmazige toegangscontrole en soepele afstemming met andere AWS-services.
Data Lake Administrator instellen
Een Data Lake Administrator is een Identity and Access Management (IAM)-gebruiker of -rol die elke principal (inclusief zichzelf) permissies kan geven op elk Data Catalog-object. De Data Lake Administrator is meestal de eerste gebruiker die wordt gemaakt om de Data Catalog te beheren en is doorgaans de gebruiker met administratieve rechten op de Data Catalog.
In de AWS Lake Formation-service kun je het dialoogvenster openen door te klikken op Administrative roles and tasks -> Add Administrators in het navigatiepaneel en vervolgens de IAM-gebruiker lf-data-admin uit de keuzelijst te selecteren.
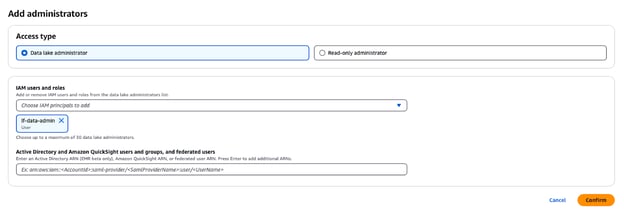
Een Data Lake Administrator toevoegen in AWS Lake Formation
Catalogusinstellingen wijzigen
Standaard heeft Lake Formation de optie “Use only IAM access control” geselecteerd om compatibel te zijn met de AWS Glue Data Catalog. Om fijnmazige toegangscontrole met Lake Formation-permissies in te schakelen, moet je deze instellingen aanpassen:
- Kies in het navigatiepaneel onder Administration de optie Administrative roles and tasks.
- Als de groep
IAMAllowedPrincipalsverschijnt onder Database creators, selecteer dan de groep en kies Revoke. - Controleer in het dialoogvenster Revoke permissions of de groep de permissie Create database heeft en klik dan op Revoke.
Deze stappen schakelen de standaard IAM-toegangscontrole uit en stellen je in staat Lake Formation-permissies te implementeren voor betere beveiliging.
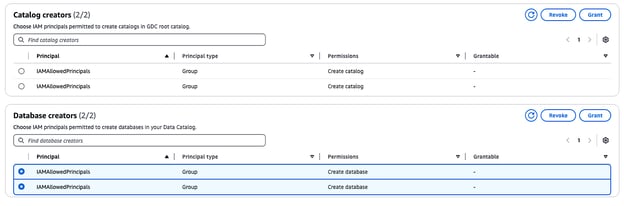
Catalogus- en databasecreators beheren in AWS Lake Formation
Stap 3: De AWS Glue Data Catalog gebruiken
Nu is het tijd om de Glue Data Catalog te gebruiken.
Een database maken
Log uit van je huidige AWS-sessie en log opnieuw in als de gebruiker lf-data-admin om een database voor de TPC-data te maken. Gebruik de aanmeldlink in de CloudFormation-output en het wachtwoord uit AWS Secrets Manager.
- Ga naar de AWS Lake Formation-console en selecteer Databases in het linkerpaneel.
- Klik op de knop Create database.
- Geef de database de naam “tpc”, aangezien deze wordt gebruikt voor het TPC-datalake.
- Selecteer in het veld Location het S3-datalakepad dat door de CloudFormation-stack is gemaakt. Dit pad vind je in het CloudFormation-outputtabblad en heet
lf-data-lake-account-ID, waarbijaccount-IDje 12-cijferige AWS-accountnummer is. - Schakel de optie Use only IAM access control for new tables in this database uit om fijnmazige toegangscontrole in te schakelen.
- Laat alle andere opties op de standaardwaarden staan en klik op Create database.
Deze database vormt de basis voor het opslaan en beheren van metadata voor de TPC-data in de Lake Formation-setup.
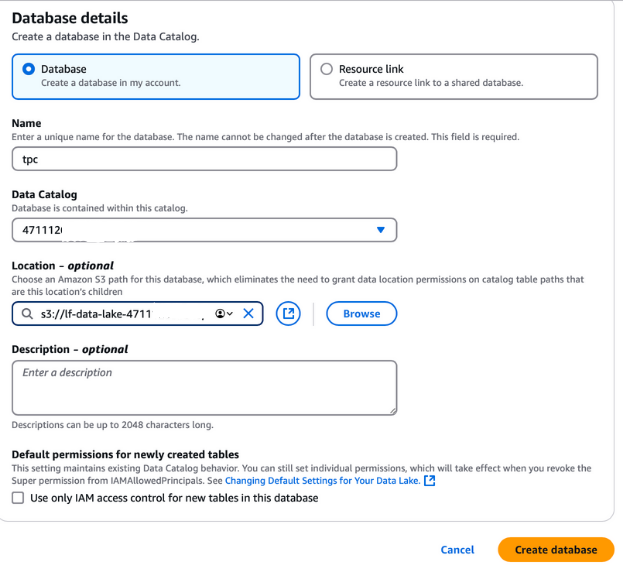
Een database maken in AWS Lake Formation
Het Data Lake hydrateren
We gebruiken een AWS Glue Crawler om tabellen in de AWS Glue Data Catalog te maken. Crawlers zijn de meest gebruikte manier om tabellen in AWS Glue te creëren, omdat ze meerdere datastores tegelijk kunnen scannen en na de crawl de details van de tabellen in de Data Catalog kunnen genereren of bijwerken.
Voordat je de AWS Glue Crawler uitvoert, moet je de vereiste permissies toekennen aan de IAM-rol ervan:
- Ga in de AWS Lake Formation-console naar Databases en selecteer de
tpc-database. - Kies in het dropdownmenu Actions de optie Grant.
- In het dialoogvenster Grant permissions:
- Selecteer onder Principals de IAM-rol
LF-GlueServiceRole. - Zorg dat in de sectie LF-Tags or catalog resources de optie Named data catalog resources is geselecteerd.
- Selecteer
tpcals database. - Vink in de sectie Database permissions de optie Create table aan.
- Klik op Grant.
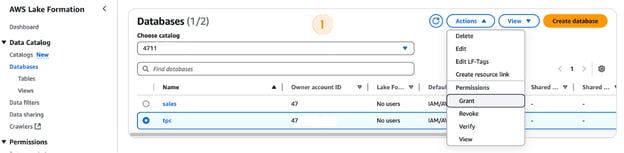
Permissies verlenen in AWS Lake Formation
De AWS Glue Crawler uitvoeren
Met de verleende permissies kun je de crawler uitvoeren:
- Ga in de AWS Lake Formation-console naar Crawlers en open de AWS Glue-console.
- Selecteer de crawler met de naam TPC Crawler en klik op Run crawler.
- Volg de voortgang door op de knop Refresh te klikken.
- Na voltooiing wordt de TPC-database gevuld met tabellen. Controleer de kolom Table changes from the last run om te zien hoeveel tabellen zijn toegevoegd (bijv. 8 tabellen).
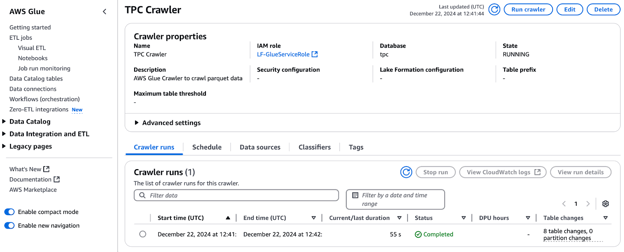
De TPC Crawler uitvoeren in AWS Glue
Je kunt deze tabellen ook verifiëren in de AWS Lake Formation-console onder Data catalog en Tables.
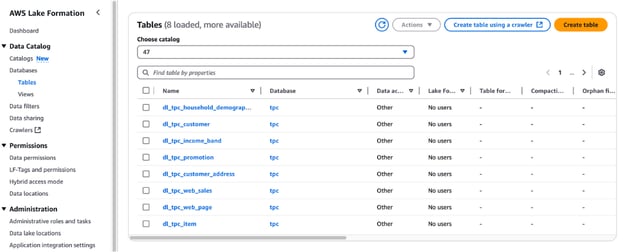
Tabellen bekijken in AWS Lake Formation
Data Lake-locaties registreren
Je moet de S3-bucket in AWS Lake Formation registreren voor je datalake-opslag. Dankzij deze registratie kun je fijnmazige toegangscontrole afdwingen op AWS Glue Data Catalog-objecten en de onderliggende data in de bucket.
Stappen om een Data Lake-locatie te registreren:
- Ga naar de sectie Data Lake Locations in de AWS Lake Formation-console en klik op Register location.
- Voer het pad in naar de S3-bucket die via de CloudFormation-template is aangemaakt. Deze bucket slaat de data op die tijdens het pipelineproces wordt ingeladen.
- Selecteer voor de IAM Role de
LF-GlueServiceRoledie door de CloudFormation-template is aangemaakt. - Kies onder Permission mode voor Lake Formation om geavanceerde toegangscontrolefuncties in te schakelen.
- Klik op Register location om je configuratie op te slaan.
Controleer na registratie je data lake-locatie om te zorgen dat deze correct is geconfigureerd. Deze stap is essentieel voor naadloos databeheer en beveiliging in je Lake Formation-setup.
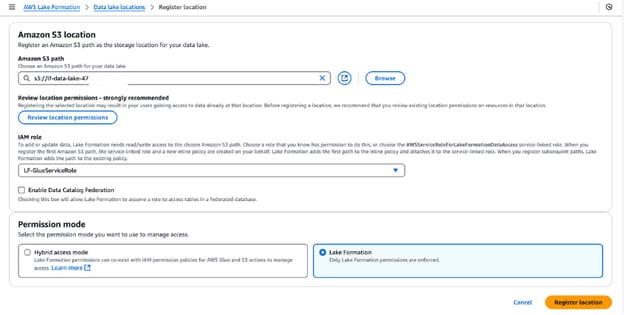
Een Amazon S3-locatie registreren in AWS Lake Formation
Lake Formation-tags (LF-Tags)
LF-Tags kunnen worden gebruikt om resources te organiseren en permissies in één keer op veel resources in te stellen. Je kunt data met taxonomieën organiseren en zo complexe policies opsplitsen en permissies effectief beheren. Dit is mogelijk omdat je met LF-Tags policy loskoppelt van resource, waardoor je toegangsbeleid kunt inrichten nog voordat resources zijn aangemaakt.
Stappen om LF-Tags te maken en toe te wijzen
- LF-Tags maken:
- Ga naar de Lake Formation-console op AWS Lake Formation.
- Kies in het navigatiepaneel LF-Tags and permissions en klik vervolgens op Add LF-Tag.
- Vul “Classification” in als key en voeg “Sensitive” en “Non-Sensitive” toe als values. Klik op Add LF-Tag.
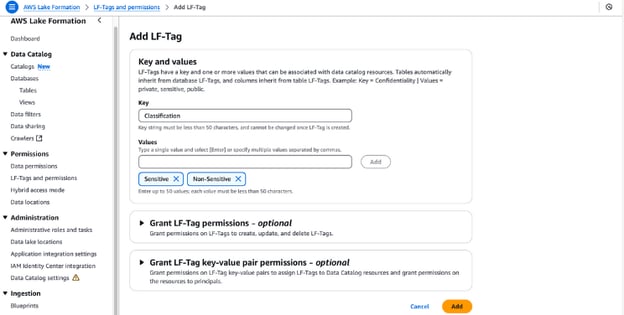
LF-Tags maken in AWS Lake Formation
- LF-tagpermissies verlenen:
- Zorg dat de gebruiker
lf-data-adminLF-Tag-permissies heeft. Ga naar Tables in de Lake Formation-console. - Selecteer de tabel
dl_tpc_customer, klik op het actions-menu en kies Grant. - Selecteer onder IAM users and roles
lf-data-admin. - Selecteer voor LF-Tags of catalogusresources Named data catalog resources.
- Kies de
tpc-database en de tabeldl_tpc_customer, en verleenAlter-tabelpermissies. Klik op Grant.
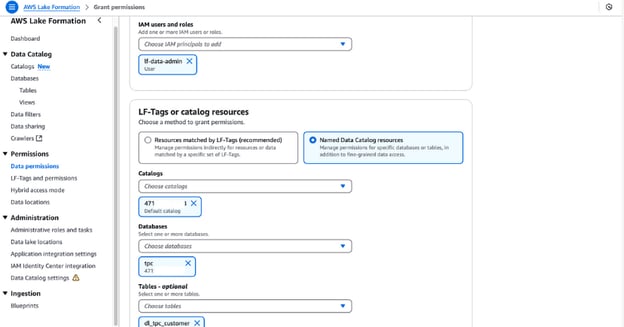
Permissies verlenen in AWS Lake Formation
- LF-tags toewijzen aan Data Catalog-objecten:
- Ga naar Tables en selecteer de tabel
dl_tpc_customer. Open de tabeldetails en kies Edit LF-Tags in het actiesmenu. - Klik op Assign new LF-Tag, vul “Classification” in als key en stel “Non-Sensitive” in als value. Klik op Save.
- Kies in het actiesmenu van de tabel Edit schema. Selecteer kolommen zoals
c_first_name,c_last_nameenc_email_address, en klik op Edit LF-Tags. - Wijzig voor de overgeërfde key
Classificationde value naar “Sensitive” en klik op Save. Sla deze configuratie op als een nieuwe versie. - LF-Tags toepassen op extra tabellen:
- Ga voor de tabel
dl_tpc_household_demographicsnaar Actions en kies Edit LF-Tags. - Klik in het dialoogvenster op Assign new LF-Tag. Stel Group in als key en Analyst als value. Klik op Save om af te ronden.
Door deze stappen te volgen, kun je efficiënt LF-Tags toewijzen aan je Data Catalog-objecten en zo beveiligde, fijnmazige toegangscontrole in je datalake borgen.
Stap 4: Een ETL-job maken in AWS Glue
AWS Glue Studio is een drag-and-drop-interface waarmee gebruikers ETL-jobs voor AWS Glue kunnen ontwikkelen, debuggen en monitoren. Data engineers gebruiken Glue ETL, gebaseerd op Apache Spark, om datasets in Amazon S3 te transformeren en data te laden in datalakes en -warehouses voor analyse. Om toegang effectief te beheren wanneer meerdere teams met dezelfde datasets werken, is het belangrijk om toegang te verlenen en te beperken op basis van rollen.
Permissies verlenen met AWS Lake Formation
Volg deze stappen om de vereiste permissies te verlenen aan de gebruiker lf-data-engineer en de bijbehorende rol DE-GlueServiceRole. Deze rol wordt door de data engineer gebruikt om toegang te krijgen tot Glue Data Catalog-tabellen in Glue Studio-jobs.
- Log in als de Data Lake Administrator:
- Gebruik de gebruiker
lf-data-adminom in te loggen op de AWS Management Console. Haal het wachtwoord op uit AWS Secrets Manager en de login-URL uit de CloudFormation-output.
- Gebruik de gebruiker
- Select-permissies verlenen voor een tabel:
- Ga naar Data lake permissions in de Lake Formation-console.
- Klik op Grant en vul in het dialoogvenster het volgende in:
- IAM users and roles: Voer
lf-data-engineerenDE-GlueServiceRolein. - LF-Tags or catalog resources: Selecteer Named data catalog resources.
- Databases: Kies
tpc. - Tables: Kies
dl_tpc_household_demographics. - Table permissions: Selecteer Select en Describe.
- IAM users and roles: Voer
- Klik op Grant om de permissies op te slaan.
- Create table-permissies voor een database verlenen:
- Ga opnieuw naar Data Lake Permissions.
- Klik op Grant en vul in het dialoogvenster het volgende in:
- IAM users and roles: Voer
DE-GlueServiceRolein. - LF-Tags or catalog resources: Selecteer Named data catalog resources.
- Databases: Kies
tpc(laat tabellen niet geselecteerd). - Database permissions: Selecteer Create table.
- IAM users and roles: Voer
- Klik op Grant om de permissies te voltooien.
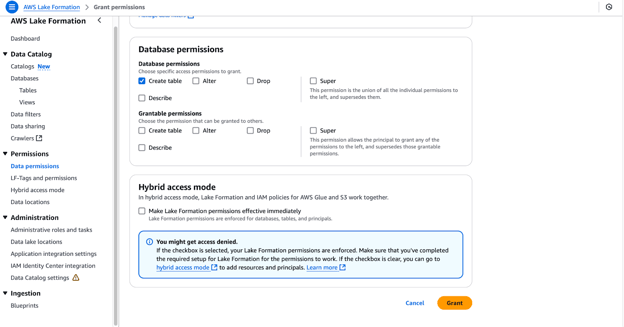
Databasepermissies configureren in AWS Lake Formation
Door deze stappen te voltooien, krijgen de gebruiker lf-data-engineer en de rol DE-GlueServiceRole de benodigde permissies om met Glue Data Catalog-tabellen te werken en resources in Glue Studio-jobs te beheren. Deze setup zorgt voor veilige, rolgebaseerde toegang tot je datalake.
Glue Studio ETL-jobs maken
In deze sectie maken we een ETL-job in AWS Glue Studio met SQL Transform.
- Log in op AWS als
lf-data-engineer:- Gebruik de gebruiker
lf-data-engineerom in te loggen op de AWS Management Console. Haal het wachtwoord op uit AWS Secrets Manager en de login-URL uit de CloudFormation-output.
- Gebruik de gebruiker
- Open Glue Studio en start een nieuwe job:
- Ga naar de Glue Studio-console en klik op Visual ETL.
- Hernoem de job naar
LF_GlueStudiozodat deze gemakkelijk te herkennen is.
- Jobdetails configureren:
- Klik op het tabblad Job Details om de volgende instellingen te configureren:
- IAM role: Selecteer
DE-GlueServiceRole. - Glue version: Selecteer Glue 5.0 - Support Spark 3.1, Scala 2, Python 3.
- Requested number of workers: Stel in op 5.
- Job bookmark: Selecteer Disable.
- Number of retries: Stel in op 0.
- IAM role: Selecteer
- Klik op het tabblad Job Details om de volgende instellingen te configureren:
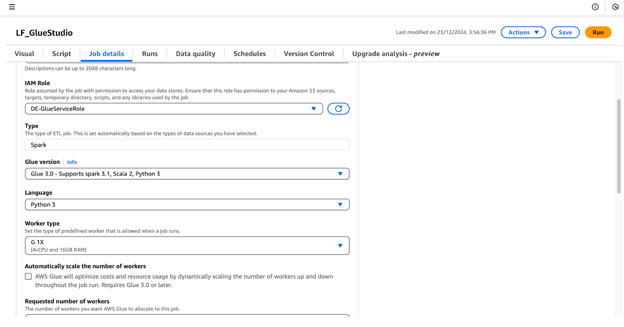
Jobdetails configureren in AWS Glue Studio
- Voeg een datasourcenode toe:
- Klik onder het tabblad Visual op de knop + en voeg een AWS Glue Data Catalog-node toe om de datasource te configureren. Hernoem deze node naar “Amazon S3”.
- Selecteer de Amazon S3-node in de visuele editor en configureer de eigenschappen in het rechtermenu:
- Stel onder Data Source Properties - Data Catalog het volgende in:
- Database:
tpc. - Table:
dl_tpc_household_demographics. (Let op: de gebruikerlf-data-adminheeftlf-data-engineeralleen Select-permissie verleend op deze tabel. Andere tabellen verschijnen niet in de keuzelijst.)
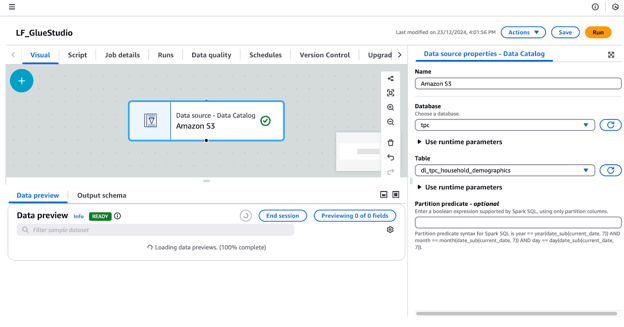
Een datasource configureren in AWS Glue Studio
- SQL Query-node toevoegen en configureren:
- Met de Amazon S3-node geselecteerd, klik je op de +-knop en voeg je een SQL Query-node toe als transform.
- Selecteer de SQL Query-node en configureer deze:
- Voer onder Transform je SQL-query in het veld SQL Query in.
- Voeg deze query toe:
/* Select all records where buy potential is between 0 and 500 */
SELECT *
FROM myDataSource
WHERE hd_buy_potential = '0-500';-
-
- Klik onder Output Schema op Edit en verwijder de keys
hd_dep_countenhd_vehicle_count. Klik op Apply.
- Klik onder Output Schema op Edit en verwijder de keys
-
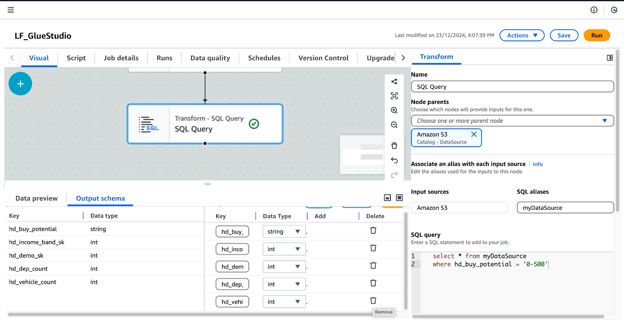
SQL Query Transform configureren in AWS Glue Studio
- Voeg een datadoelnode toe:
- Met de SQL Query-node geselecteerd, klik je op de +-knop en voeg je een Data Target-node toe. Selecteer Amazon S3 Target in de zoekresultaten.
- Configureer de Data Target-S3-node in het rechterpaneel:
- Format: Selecteer Parquet.
- Compression type: Selecteer Snappy.
- S3 target location: Voer
s3://<your_LFDataLakeBucketName>/gluestudio/curated/in. (Vervang<your_LFDataLakeBucketName>door de daadwerkelijke bucketnaam uit het CloudFormation Outputs-tabblad.) - Data Catalog update options: Selecteer Create a table in the Data Catalog and on subsequent runs, update the schema and add new partitions.
- Database: Selecteer
tpc. - Table name: Geef een naam op voor de outputtabel. Bijvoorbeeld
dl_tpc_household_demographics_below500. - Sla de job op en controleer:
- Klik rechtsboven op Save om de job op te slaan.
- Schakel desgewenst over naar het tabblad Script om het automatisch gegenereerde script te bekijken. Je kunt dit script downloaden of bewerken indien nodig.
Met deze stappen maak je een volledig functionele Glue Studio ETL-job die data transformeert en de resultaten naar een curated S3-map schrijft, terwijl de Glue Data Catalog wordt bijgewerkt.
Stap 5: De integratie testen en valideren
Om de in Lake Formation verleende permissies te bevestigen, volg je deze stappen terwijl je bent ingelogd als de gebruiker lf-data-engineer (zoals beschreven in de sectie Create Glue Studio Jobs):
- Voer de job
LF_GlueStudiouit: - Ga naar de LF_GlueStudio-job en klik op de knop Run rechtsboven om de job uit te voeren.
- Monitor de jobuitvoering door het tabblad Runs in de jobinterface te selecteren.
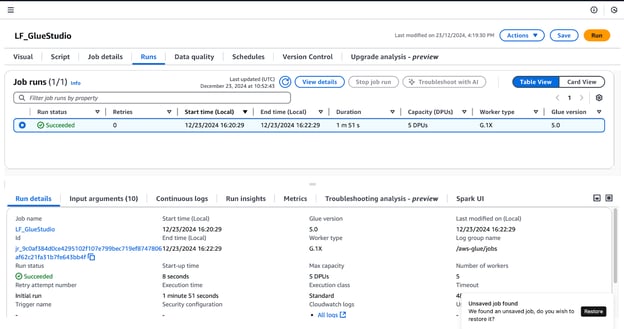
Jobruns monitoren in AWS Glue Studio
- Controleer de joboutput:
- Zodra de jobstatus Succeeded aangeeft, ga je naar de map
curatedin je S3-bucket om de outputbestanden te controleren. Deze bestanden zouden in Parquet-formaat moeten staan, zoals tijdens het maken van de job is ingesteld.
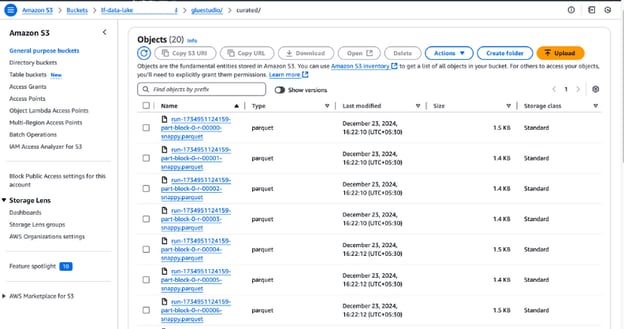
Outputbestanden bekijken in Amazon S3
- Controleer de nieuw aangemaakte tabel:
- Open de Glue Data Catalog en ga naar de database die je tijdens de jobconfiguratie hebt opgegeven.
- Controleer of de nieuwe tabel onder de database staat, wat bevestigt dat de outputdata succesvol is gecatalogiseerd.
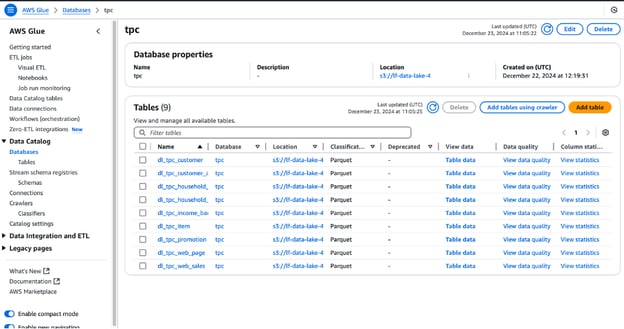
Databasetabellen bekijken in AWS Glue
Best practices voor het integreren van AWS Lake Formation en AWS Glue
Door best practices te volgen bij het integreren van AWS Lake Formation en AWS Glue, kun je de databeveiliging verbeteren, operaties stroomlijnen en prestaties optimaliseren. Zo haal je het meeste uit deze services:
Optimaliseer datatoegangsrechten
- Hanteer het least privilege-principe: Geef gebruikers en rollen alleen toegang tot de resources die ze nodig hebben. Vermijd brede permissies die gevoelige data of kritieke resources onnodig kunnen blootstellen.
- Controleer toegangsbeleid regelmatig: Beoordeel en update policies periodiek om te voldoen aan veranderende beveiligings- en compliance-eisen. Gebruik tools zoals AWS IAM Access Analyzer om te brede policies te detecteren.
- Gebruik LF-Tags voor policybeheer: Gebruik Lake Formation Tags (LF-Tags) om gerelateerde resources te groeperen en het beheer van permissies te vereenvoudigen. Door tags zoals Sensitive of Non-Sensitive toe te passen, maak je schaalbare, herbruikbare policies die automatisch gelden voor getagde resources.
- Koppel policies los van resources: Definieer permissies met LF-Tags of templates voordat resources zijn aangemaakt. Dit zorgt voor een naadloos integratieproces wanneer nieuwe databronnen of tabellen worden toegevoegd.
Jobs monitoren en debuggen
- Schakel CloudWatch-logs in voor Glue-jobs: CloudWatch Logs kan gedetailleerde logs vastleggen van AWS Glue-jobuitvoeringen, inclusief fouten en uitvoeringsdetails. Gebruik deze logs om snel problemen op te lossen.
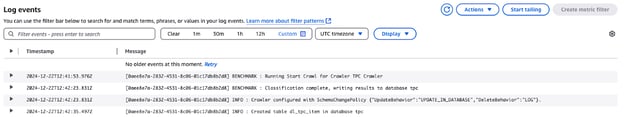
Logevents voor TPC Crawler in AWS CloudWatch
- Glue-metrics monitoren: AWS Glue biedt metrics die helpen om inefficiënties of problemen in je ETL-workflows te identificeren. Stel CloudWatch-alarms in om je te informeren over ongebruikelijke patronen.
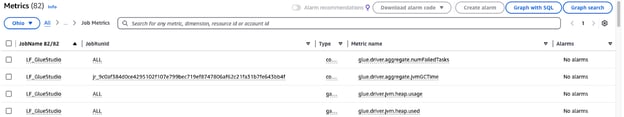
AWS Glue Studio-jobmetrics monitoren
Gebruik partitionering en compressie
- Optimaliseer datapartitionering: Verdeel datasets op basis van vaak gevraagde kenmerken, zoals afdeling, datum of regio. In Athena of Redshift, kan het bijvoorbeeld de queries aanzienlijk versnellen en scankosten verlagen als je salesdata verdeelt op maand en jaar.
- Kies het juiste compressieformaat: Gebruik kolomgebaseerde opslagformaten die voor analytische werklasten zijn gemaakt, zoals ORC of Parquet. Combineer deze met efficiënte compressie-algoritmen zoals Snappy om opslag te besparen en queries te versnellen.
- Partitionering automatiseren in Glue-jobs: AWS Glue-jobs kunnen data dynamisch partitioneren tijdens het ETL-proces. Specificeer partition keys in je jobconfiguratie om te garanderen dat binnenkomende data in een gestructureerd formaat wordt opgeslagen.
- Monitor en pas strategieën regelmatig aan: Evalueer de effectiviteit van je compressie en partitionering naarmate je datavolume groeit. Analyseer querytrends en pas vervolgens het partitioneringsschema aan op veranderende workloads.
Conclusie
Door AWS Lake Formation en AWS Glue te implementeren, kan de organisatie data organiseren, beveiligen en verwerken. Met de uitgebreide beveiligingsmaatregelen van Lake Formation en de automatisering van Glue kun je je ETL-processen optimaliseren, voldoen aan alle beleidsregels rond datagovernance en gebruikers, waaronder data engineers en data scientists, eenvoudige toegang tot data bieden.
Voordelen zijn onder andere:
- Verbeterde beveiliging: Fijnmazige toegangscontrole met LF-Tags zorgt ervoor dat gevoelige data alleen toegankelijk is voor geautoriseerde gebruikers.
- Automatisering: AWS Glue vereenvoudigt datapreparatie en -transformatie, waardoor handmatig werk en fouten verminderen.
- Schaalbaarheid: Dynamische permissies en policybeheer maken naadloze schaalvergroting mogelijk naarmate data groeit.
- Efficiëntie: Geoptimaliseerde opslag en queryprestaties via partitionering en compressie besparen tijd en kosten.
Als je je begrip van data-integratie wilt verdiepen, is het essentieel om je leerproces aan te vullen met praktische, hands-on kennis. Zo kan het beheersen van datapijplijnen met ETL en ELT in Python je vermogen om data efficiënt te verwerken en te transformeren vergroten. Evenzo zal een stevige basis in Databeheerconcepten verbeteren hoe je datasets structureert en beheert. En om te zorgen dat je resultaten betrouwbaar zijn, is inzicht in de principes uit de cursus Inleiding tot Datakwaliteit een must.
FAQs
Wat is het doel van het integreren van AWS Lake Formation en AWS Glue?
Door AWS Lake Formation en AWS Glue te implementeren, kun je veilige, geautomatiseerde en schaalbare datapijplijnen ontwikkelen. Deze integratie biedt uitgebreide toegangscontrole, gestroomlijnde ETL-processen en een uniform platform voor databeheer, analytics en compliance.
Wat is het belang van LF-Tags in AWS Lake Formation?
Met LF-Tags kun je permissies op schaal beheren doordat data via taxonomieën wordt georganiseerd, bijvoorbeeld “Sensitive” of “Non-Sensitive”. Ze helpen de complexiteit van toegangsbeleid te verminderen omdat je permissies op basis van tags kunt instellen, en zelfs voordat resources daadwerkelijk zijn gemaakt; dit biedt flexibiliteit én veiligheid.
Welke rol speelt AWS Glue Studio in deze integratie?
AWS Glue Studio is een hulpmiddel voor dataconversie met een drag-and-drop-interface. Gebruikers kunnen via deze interface ETL-jobs ontwikkelen, monitoren en beheren. Het maakt datatransformatieprocessen efficiënter en helpt zo data te transformeren voor verdere analyse.
Kunnen meerdere teams veilig toegang krijgen tot dezelfde dataset?
Ja, AWS Lake Formation biedt de mogelijkheid voor fijnmazige toegangscontrole, waarbij je gebruikers toegang kunt geven op basis van specifieke rollen of zelfs LF-Tags. Zo kan elk team alleen de data bekijken die voor hen relevant is, terwijl de data zelf beschermd blijft.
Wat is de TPC-dataset die in het artikel wordt genoemd?
De TPC-dataset is een synthetische dataset die veel wordt gebruikt voor training, benchmarking en educatieve doeleinden. Het bevat informatie over diverse producten, klanten, demografische gegevens, webverkopen en andere transactiegerelateerde data, waardoor het realistischer is.

Rahul Sharma is een AWS Ambassador, DevOps-architect en technisch blogger, gespecialiseerd in cloudcomputing, DevOps-praktijken en open-sourcetechnologieën. Met expertise in AWS, Kubernetes en Terraform maakt hij complexe concepten eenvoudiger voor zowel studenten als professionals via boeiende artikelen en tutorials. Rahul is gepassioneerd over het oplossen van DevOps-uitdagingen en het delen van inzichten om de techcommunity te versterken.


Organisaties hebben moeite om big datasets te beveiligen, te beheren en te verplaatsen in de huidige dataomgeving. AWS Lake Formation en AWS Glue zijn twee services die je helpen deze uitdagingen te overwinnen. AWS Glue voert datacleaning, herstructurering en conversie van datatypes uit, terwijl AWS Lake Formation datalakes opzet en zorgt voor databeveiliging en -beheer.
In deze blog laten we zien hoe je een beveiligde, geautomatiseerde datapijplijn ontwikkelt met AWS Lake Formation en AWS Glue. We maken een ETL-job met AWS Glue om voorbeelddata, die momenteel in een S3-bucket staat, te verplaatsen en te verwerken, en fijnmazige toegangscontrole wordt ingericht via AWS Lake Formation.
Wat is AWS Lake Formation?
AWS Lake Formation biedt de tools om datalakes op AWS te maken, te beheren en te beveiligen. Met Lake Formation wordt het eenvoudiger om datalakes op Amazon S3 te creëren en beveiliging en permissies te beheren.
Met AWS Lake Formation kun je:
Wat is AWS Glue?
AWS Glue is een serverless data-integratieservice die Extract, Transform en Load (ETL) functionaliteit biedt voor datapreparatie. Het is een geautomatiseerde datapreparatieservice die het eenvoudiger maakt om datacatalogusbeheer, transformatie en laden te regelen. Dit is handig om data uit verschillende bronnen, zoals S3, te consolideren in datawarehouses of databases.
Met AWS Glue krijg je:
Ben je nieuw met Glue? Bekijk dan onze Getting Started with AWS Glue-tutorial.
Waarom AWS Lake Formation en AWS Glue integreren?
Door AWS Lake Formation en AWS Glue te integreren, combineer je het beste van twee werelden: veilige datalakes en geautomatiseerde ETL-pijplijnen. Enkele voordelen van deze integratie zijn: