

Prasyarat untuk Integrasi
Sebelum mengintegrasikan AWS Lake Formation dan AWS Glue, pastikan Anda memiliki hal berikut:
- Akun AWS: Akses ke AWS Lake Formation dan AWS Glue.
- Pengetahuan dasar: Keakraban dengan data lake, ETL, dan layanan AWS.
- Bucket S3: Bucket S3 yang sudah dikonfigurasi untuk menyimpan data Anda.
- Peran IAM: Peran dan izin IAM yang diperlukan untuk mengakses kedua layanan.
- CloudFormation: Template disediakan untuk menerapkan setup dasar. Anda dapat menemukan templatenya di sini.
Panduan Langkah demi Langkah untuk Integrasi
Setelah Anda menyiapkan prasyarat, ikuti langkah-langkah berikut:
Langkah 1: Menyiapkan AWS Lake Formation
Langkah pertama adalah menerapkan sumber daya inti AWS yang diperlukan untuk membangun data lake yang aman sebelum memulai proses integrasi. Template AWS CloudFormation membantu mengatur dan menerapkan semua sumber daya yang dibutuhkan.
Gunakan template CloudFormation yang disediakan untuk membuat stack di akun AWS Anda. Stack ini menyediakan sumber daya esensial yang diperlukan untuk skenario penggunaan yang dijelaskan dalam tutorial ini.
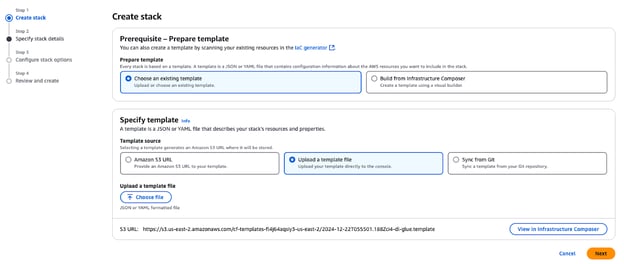
Membuat stack di AWS CloudFormation
Setelah stack diterapkan, sumber daya kunci berikut akan dibuat di akun AWS Anda:
- Amazon VPC dan subnet: VPC dan subnet publik untuk menampung sumber daya dengan konfigurasi jaringan yang sesuai.
- Bucket Amazon S3:
- Menyimpan data, skrip, dan hasil terkait blog.
- Menampung data TPC yang digunakan untuk membangun data lake.
- Peran dan kebijakan IAM:
GlueServiceRole: Memberikan akses AWS Glue ke layanan S3 dan Lake Formation.DataEngineerGlueServiceRole: Memberikan insinyur izin untuk akses dan pemrosesan data.DataAdminUserdanDataEngineerUser: Pengguna IAM prakonfigurasi untuk mengeksplorasi dan mengelola keamanan Lake Formation.- AWS Glue Crawler: TPC Crawler untuk memindai dan mengatalogkan data parquet yang disimpan di bucket S3.
- Instance Amazon EC2: Instance pembantu (
EC2-DB-Loader) untuk pra-memuat dan mentransfer data contoh ke S3. - AWS Secrets Manager: Secret (
lf-users-credentials) untuk menyimpan kredensial pengguna secara aman bagi pengguna IAM yang telah dibuat sebelumnya.
Setelah stack dibuat, Anda akan memiliki hal-hal berikut:
- Sebuah contoh database TPC yang disimpan di Amazon S3.
- Pengguna dan peran yang telah dibuat sebelumnya untuk mengeksplorasi pola keamanan dan kontrol akses.
- Konfigurasi Glue dan crawler untuk mengatalogkan dan memproses data Anda.
- Semua komponen dasar yang diperlukan untuk mengikuti langkah-langkah dalam blog ini.
Langkah 2: Mengonfigurasi izin data
Pada bagian ini, Administrator Data Lake akan mengonfigurasi AWS Lake Formation agar tersedia untuk persona konsumen data, termasuk data engineer. Administrator akan:
- Membuat database baru di AWS Lake Formation untuk menyimpan data TPC.
- Mendaftarkan tabel metadata untuk dataset TPC di AWS Glue Data Catalog.
- Mengonfigurasi tag dan kebijakan Lake Formation untuk menetapkan izin akses bagi pengguna yang berbeda.
Konfigurasi ini memberikan kontrol akses granular yang aman dan koordinasi yang mulus dengan layanan AWS lainnya.
Menetapkan Administrator Data Lake
Administrator Data Lake adalah pengguna atau peran Identity and Access Management (IAM) yang dapat memberikan izin kepada prinsip mana pun (termasuk dirinya sendiri) pada entitas Data Catalog mana pun. Administrator Data Lake biasanya merupakan pengguna pertama yang dibuat untuk mengelola Data Catalog dan umumnya adalah pengguna yang diberikan hak administratif untuk Data Catalog.
Di layanan AWS Lake Formation, Anda dapat membuka prompt dengan mengeklik tombol Administrative roles and tasks -> Add Administrators di panel navigasi lalu memilih pengguna IAM lf-data-admin dari daftar dropdown.
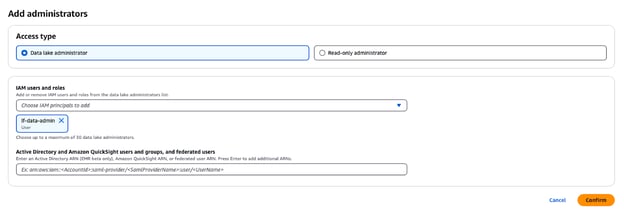
Menambahkan Administrator Data Lake di AWS Lake Formation
Mengubah pengaturan katalog
Secara default, Lake Formation memiliki opsi “Use only IAM access control” yang dipilih agar kompatibel dengan AWS Glue Data Catalog. Untuk mengaktifkan kontrol akses granular dengan izin Lake Formation, Anda perlu menyesuaikan pengaturan berikut:
- Di panel navigasi, di bawah Administration, pilih Administrative roles and tasks.
- Jika grup
IAMAllowedPrincipalsmuncul di bawah Database creators, pilih grup tersebut lalu klik Revoke. - Di kotak dialog Revoke permissions, konfirmasikan bahwa grup memiliki izin Create database lalu klik Revoke.
Langkah-langkah ini akan menonaktifkan kontrol akses IAM default dan memungkinkan Anda menerapkan izin Lake Formation untuk keamanan yang ditingkatkan.
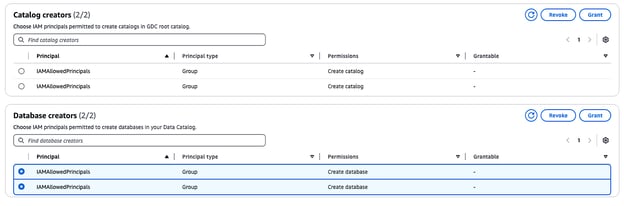
Mengelola catalog dan database creators di AWS Lake Formation
Langkah 3: Menggunakan AWS Glue Data Catalog
Sekarang, saatnya memanfaatkan Glue Data Catalog.
Membuat database
Untuk membuat database bagi data TPC, keluar dari sesi AWS Anda saat ini dan masuk kembali sebagai pengguna lf-data-admin. Gunakan tautan masuk yang diberikan pada output CloudFormation dan kata sandi yang diambil dari AWS Secrets Manager.
- Buka konsol AWS Lake Formation dan pilih Databases dari panel navigasi kiri.
- Klik tombol Create database.
- Beri nama database “tpc”, karena akan digunakan untuk data lake TPC.
- Pada kolom Location, pilih path data lake S3 yang dibuat oleh stack CloudFormation. Path ini dapat ditemukan di tab output CloudFormation dan akan diberi nama
lf-data-lake-account-ID, di manaaccount-IDadalah 12 digit nomor akun AWS Anda. - Hapus centang pada opsi Use only IAM access control for new tables in this database untuk mengaktifkan kontrol akses granular.
- Biarkan opsi lainnya pada nilai default dan klik Create database.
Database ini akan menjadi dasar untuk menyimpan dan mengelola metadata untuk data TPC dalam setup Lake Formation.
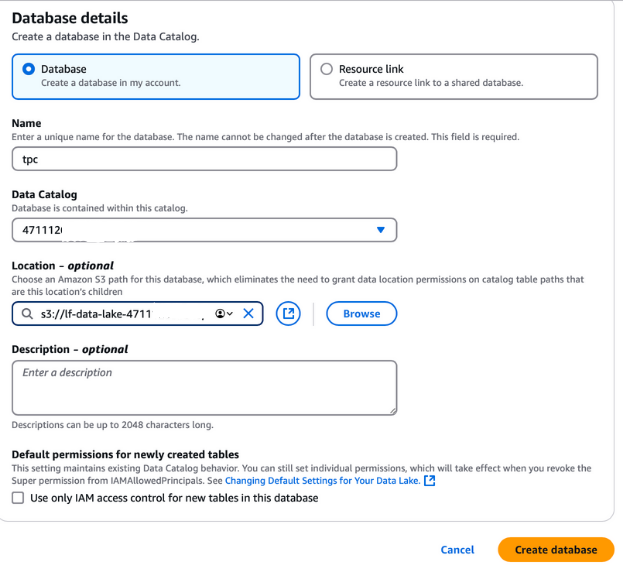
Membuat database di AWS Lake Formation
Mengisi Data Lake
Kami menggunakan AWS Glue Crawler untuk membuat tabel di AWS Glue Data Catalog. Crawler adalah cara paling umum untuk membuat tabel di AWS Glue, karena dapat memindai banyak data store sekaligus dan menghasilkan atau memperbarui detail tabel di Data Catalog setelah proses crawl selesai.
Sebelum menjalankan AWS Glue Crawler, Anda perlu memberikan izin yang diperlukan kepada peran IAM-nya:
- Di konsol AWS Lake Formation, buka Databases dan pilih database
tpc. - Dari menu dropdown Actions, pilih Grant.
- Di kotak dialog Grant permissions:
- Di bawah Principals, pilih peran IAM
LF-GlueServiceRole. - Di bagian LF-Tags or catalog resources, pastikan Named data catalog resources dipilih.
- Pilih
tpcsebagai database. - Di bagian Database permissions, centang opsi Create table.
- Klik Grant.
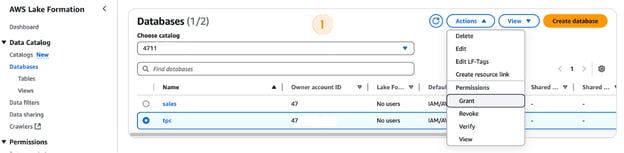
Memberikan izin di AWS Lake Formation
Menjalankan AWS Glue Crawler
Setelah izin diberikan, lanjutkan untuk menjalankan crawler:
- Di konsol AWS Lake Formation, buka Crawlers dan klik untuk membuka konsol AWS Glue.
- Pilih crawler bernama TPC Crawler dan klik Run crawler.
- Pantau progres dengan mengeklik tombol Refresh.
- Setelah selesai, database TPC akan terisi tabel. Periksa kolom Table changes from the last run untuk melihat jumlah tabel yang ditambahkan (misalnya, 8 tabel).
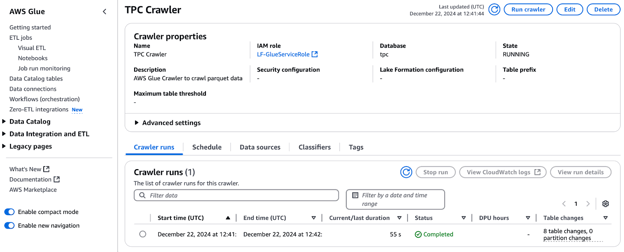
Menjalankan TPC Crawler di AWS Glue
Anda juga dapat memverifikasi tabel-tabel ini di konsol AWS Lake Formation di bawah Data catalog dan Tables.
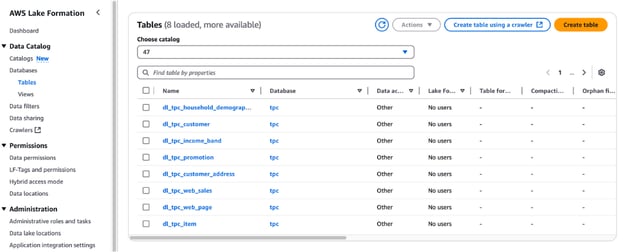
Melihat tabel di AWS Lake Formation
Mendaftarkan lokasi Data Lake
Anda harus mendaftarkan bucket S3 di AWS Lake Formation untuk penyimpanan data lake Anda. Pendaftaran ini memungkinkan Anda menerapkan kontrol akses granular pada objek AWS Glue Data Catalog dan data yang mendasarinya yang disimpan di bucket.
Langkah-langkah mendaftarkan lokasi Data Lake:
- Masuk ke bagian Data Lake Locations di konsol AWS Lake Formation dan klik Register location.
- Masukkan path ke bucket S3 yang dibuat melalui template CloudFormation. Bucket ini akan menyimpan data yang diingest selama proses pipeline.
- Untuk IAM Role, pilih
LF-GlueServiceRoleyang dibuat oleh template CloudFormation. - Di bawah Permission mode, pilih Lake Formation untuk mengaktifkan fitur kontrol akses tingkat lanjut.
- Klik Register location untuk menyimpan konfigurasi Anda.
Setelah didaftarkan, verifikasi lokasi data lake Anda untuk memastikan konfigurasinya sudah benar. Langkah ini penting untuk manajemen data dan keamanan yang mulus dalam setup Lake Formation Anda.
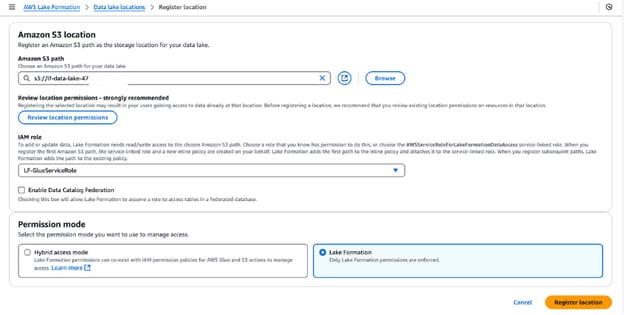
Mendaftarkan lokasi Amazon S3 di AWS Lake Formation
Lake Formation tags (LF-Tag)
LF-Tag dapat digunakan untuk mengatur sumber daya dan menetapkan izin pada banyak sumber daya sekaligus. Ini memungkinkan Anda mengatur data menggunakan taksonomi, sehingga memecah kebijakan kompleks dan mengelola izin secara efektif. Hal ini dimungkinkan karena dengan LF-Tag, Anda dapat memisahkan kebijakan dari sumber daya, sehingga Anda dapat menyiapkan kebijakan akses bahkan sebelum sumber daya dibuat.
Langkah-langkah membuat dan menetapkan LF-Tag
- Buat LF-Tag:
- Buka konsol Lake Formation di AWS Lake Formation.
- Di panel navigasi, pilih LF-Tags and permissions, lalu klik Add LF-Tag.
- Masukkan “Classification” sebagai key dan tambahkan “Sensitive” dan “Non-Sensitive” sebagai value. Klik Add LF-Tag.
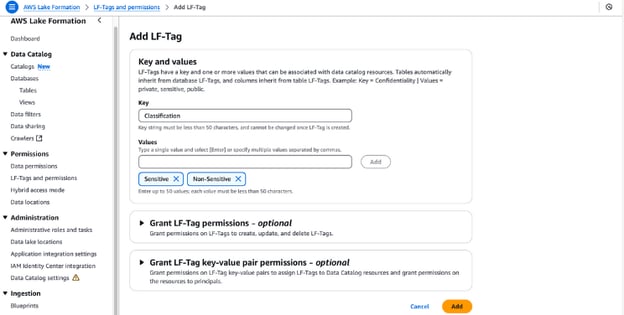
Membuat LF-Tag di AWS Lake Formation
- Berikan izin LF-Tag:
- Pastikan pengguna
lf-data-adminmemiliki izin LF-Tag. Buka Tables di konsol Lake Formation. - Pilih tabel
dl_tpc_customer, klik menu actions, dan pilih Grant. - Di bawah IAM users and roles, pilih
lf-data-admin. - Untuk LF-Tags atau catalog resources, pilih Named data catalog resources.
- Pilih database
tpcdan tabeldl_tpc_customer, lalu berikan izin tabelAlter. Klik Grant.
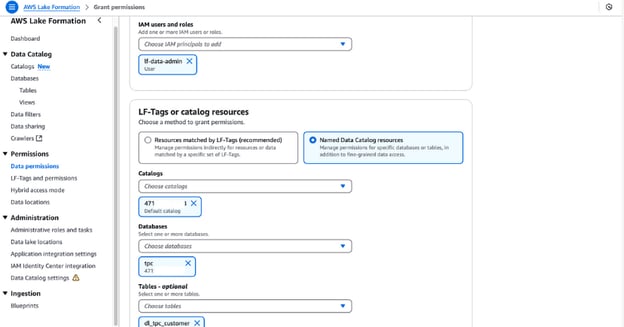
Memberikan izin di AWS Lake Formation
- Tetapkan LF-Tag ke objek Data Catalog:
- Buka Tables dan pilih tabel
dl_tpc_customer. Buka detail tabel dan pilih Edit LF-Tags dari menu actions. - Klik Assign new LF-Tag, masukkan “Classification” sebagai key, dan setel “Non-Sensitive” sebagai value. Klik Save.
- Dari menu actions tabel, pilih Edit schema. Pilih kolom seperti
c_first_name,c_last_name, danc_email_address, lalu klik Edit LF-Tags. - Untuk key turunan
Classification, ubah value menjadi “Sensitive” lalu klik Save. Simpan konfigurasi ini sebagai versi baru. - Terapkan LF-Tag ke tabel tambahan:
- Untuk tabel
dl_tpc_household_demographics, buka Actions dan pilih Edit LF-Tags. - Di kotak dialog, klik Assign new LF-Tag. Setel Group sebagai key dan Analyst sebagai value. Klik Save untuk menyelesaikan.
Dengan mengikuti langkah-langkah ini, Anda dapat menetapkan LF-Tag secara efisien pada objek Data Catalog, memastikan kontrol akses granular yang aman di seluruh data lake Anda.
Langkah 4: Membuat job ETL di AWS Glue
AWS Glue Studio adalah antarmuka pengguna drag-and-drop yang membantu pengguna mengembangkan, men-debug, dan memantau job ETL untuk AWS Glue. Data engineer memanfaatkan Glue ETL, berbasis Apache Spark, untuk mentransformasi set data yang tersimpan di Amazon S3 dan memuat data ke data lake dan gudang data untuk analisis. Untuk mengelola akses secara efektif ketika beberapa tim berkolaborasi pada set data yang sama, penting untuk memberikan akses dan membatasinya sesuai peran.
Memberikan izin dengan AWS Lake Formation
Ikuti langkah-langkah berikut untuk memberikan izin yang diperlukan kepada pengguna lf-data-engineer dan peran terkait DE-GlueServiceRole. Peran ini digunakan oleh data engineer untuk mengakses tabel Glue Data Catalog dalam job Glue Studio.
- Masuk sebagai Administrator Data Lake:
- Gunakan pengguna
lf-data-adminuntuk masuk ke AWS Management Console. Ambil kata sandi dari AWS Secrets Manager dan URL masuk dari output CloudFormation.
- Gunakan pengguna
- Berikan izin select untuk sebuah tabel:
- Masuk ke Data lake permissions di konsol Lake Formation.
- Klik Grant, lalu pada kotak dialog, berikan informasi berikut:
- IAM users and roles: Masukkan
lf-data-engineerdanDE-GlueServiceRole. - LF-Tags or catalog resources: Pilih Named data catalog resources.
- Databases: Pilih
tpc. - Tables: Pilih
dl_tpc_household_demographics. - Table permissions: Pilih Select dan Describe.
- IAM users and roles: Masukkan
- Klik Grant untuk menyimpan izin.
- Berikan izin membuat tabel untuk sebuah database:
- Kembali ke Data Lake Permissions.
- Klik Grant, lalu pada kotak dialog, berikan informasi berikut:
- IAM users and roles: Masukkan
DE-GlueServiceRole. - LF-Tags or catalog resources: Pilih Named data catalog resources.
- Databases: Pilih
tpc(biarkan tabel tidak dipilih). - Database permissions: Pilih Create table.
- IAM users and roles: Masukkan
- Klik Grant untuk menyelesaikan pemberian izin.
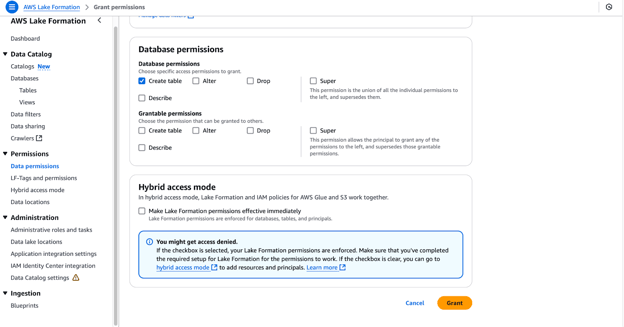
Mengonfigurasi izin database di AWS Lake Formation
Menyelesaikan langkah-langkah ini akan memberikan pengguna lf-data-engineer dan peran DE-GlueServiceRole izin yang diperlukan untuk bekerja dengan tabel Glue Data Catalog dan mengelola sumber daya dalam job Glue Studio. Setup ini memastikan akses berbasis peran yang aman ke data lake Anda.
Membuat job ETL Glue Studio
Pada bagian ini, kita akan membuat job ETL di AWS Glue Studio menggunakan SQL Transform.
- Masuk ke AWS sebagai
lf-data-engineer:- Gunakan pengguna
lf-data-engineeruntuk masuk ke AWS Management Console. Ambil kata sandi dari AWS Secrets Manager dan URL masuk yang disediakan oleh output CloudFormation.
- Gunakan pengguna
- Buka Glue Studio dan mulai job baru:
- Buka konsol Glue Studio dan klik Visual ETL.
- Ubah nama job menjadi
LF_GlueStudioagar mudah diidentifikasi.
- Konfigurasikan detail job:
- Klik tab Job Details untuk menyiapkan konfigurasi berikut:
- Peran IAM: Pilih
DE-GlueServiceRole. - Versi Glue: Pilih Glue 5.0 - Support Spark 3.1, Scala 2, Python 3.
- Requested number of workers: Setel ke 5.
- Job bookmark: Pilih Disable.
- Number of retries: Setel ke 0.
- Peran IAM: Pilih
- Klik tab Job Details untuk menyiapkan konfigurasi berikut:
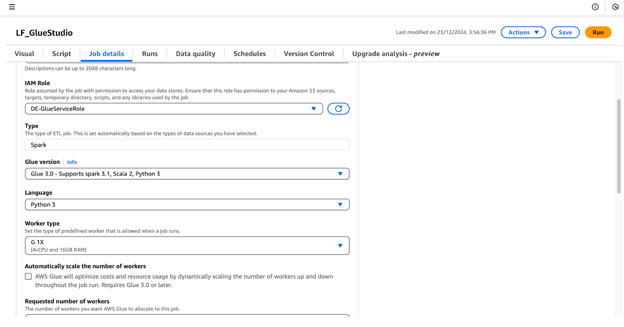
Mengonfigurasi detail job di AWS Glue Studio
- Tambahkan node sumber data:
- Di bawah tab Visual, klik tombol + dan tambahkan node AWS Glue Data Catalog untuk mengonfigurasi sumber data. Ganti nama node ini menjadi “Amazon S3”.
- Pilih node Amazon S3 pada editor visual dan konfigurasikan propertinya di panel kanan:
- Di bawah Data Source Properties - Data Catalog, atur:
- Database:
tpc. - Table:
dl_tpc_household_demographics. (Catatan: Penggunalf-data-adminhanya memberikan penggunalf-data-engineerizin Select pada tabel ini. Tabel lain tidak akan muncul di dropdown.)
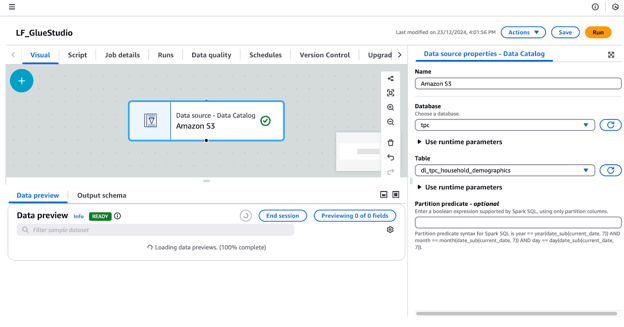
Mengonfigurasi sumber data di AWS Glue Studio
- Tambahkan dan konfigurasikan node SQL Query:
- Dengan node Amazon S3 dipilih, klik tombol + dan tambahkan node SQL Query sebagai transform.
- Pilih node SQL Query dan konfigurasikan:
- Di bawah Transform, masukkan kueri SQL Anda pada kolom SQL Query.
- Tambahkan kueri berikut:
/* Select all records where buy potential is between 0 and 500 */
SELECT *
FROM myDataSource
WHERE hd_buy_potential = '0-500';-
-
- Di bawah Output Schema, klik Edit dan hapus key
hd_dep_countdanhd_vehicle_count. Klik Apply.
- Di bawah Output Schema, klik Edit dan hapus key
-
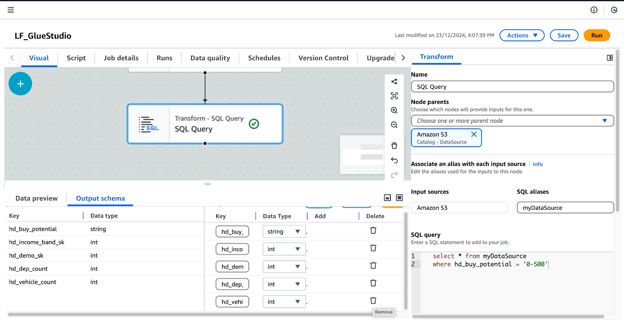
Mengonfigurasi SQL Query Transform di AWS Glue Studio
- Tambahkan node target data:
- Dengan node SQL Query dipilih, klik tombol + dan tambahkan node Data Target. Pilih Amazon S3 Target dari hasil pencarian.
- Konfigurasikan node Data Target-S3 di panel kanan:
- Format: Pilih Parquet.
- Compression type: Pilih Snappy.
- S3 target location: Masukkan
s3://<your_LFDataLakeBucketName>/gluestudio/curated/. (Ganti<your_LFDataLakeBucketName>dengan nama bucket sebenarnya dari tab CloudFormation Outputs.) - Data Catalog update options: Pilih Create a table in the Data Catalog and on subsequent runs, update the schema and add new partitions.
- Database: Pilih
tpc. - Table name: Berikan nama untuk tabel output. Contohnya,
dl_tpc_household_demographics_below500. - Simpan dan tinjau job:
- Klik Save di pojok kanan atas untuk menyimpan job.
- Opsional, beralih ke tab Script untuk melihat skrip yang dibuat otomatis. Anda dapat mengunduh atau mengedit skrip ini jika diperlukan.
Dengan mengikuti langkah-langkah ini, Anda akan membuat job ETL Glue Studio yang sepenuhnya fungsional untuk mentransformasi data dan menulis hasilnya ke folder S3 curated sambil memperbarui Glue Data Catalog.
Langkah 5: Menguji dan memvalidasi integrasi
Untuk mengonfirmasi izin yang diberikan di Lake Formation, ikuti langkah-langkah berikut saat Anda masuk sebagai pengguna lf-data-engineer (sebagaimana dijelaskan pada bagian Create Glue Studio Jobs):
- Jalankan job
LF_GlueStudio: - Buka job LF_GlueStudio dan klik tombol Run di pojok kanan atas untuk mengeksekusi job.
- Pantau eksekusi job dengan memilih tab Runs di dalam antarmuka job.
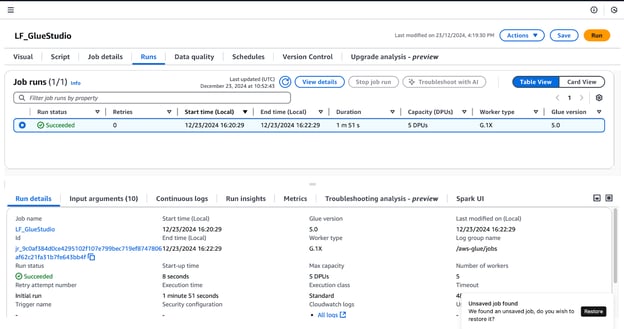
Memantau job run di AWS Glue Studio
- Verifikasi output job:
- Setelah status run job menampilkan Succeeded, buka folder
curateddi bucket S3 Anda untuk memeriksa file output. File ini seharusnya berformat Parquet, sesuai konfigurasi saat pembuatan job.
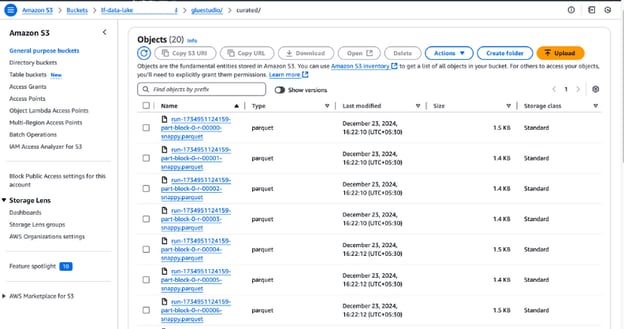
Melihat file output di Amazon S3
- Verifikasi tabel yang baru dibuat:
- Buka Glue Data Catalog dan masuk ke database yang Anda tentukan saat penyiapan job.
- Pastikan tabel baru tercantum di bawah database, mengonfirmasi bahwa data output telah dikatalogkan dengan sukses.
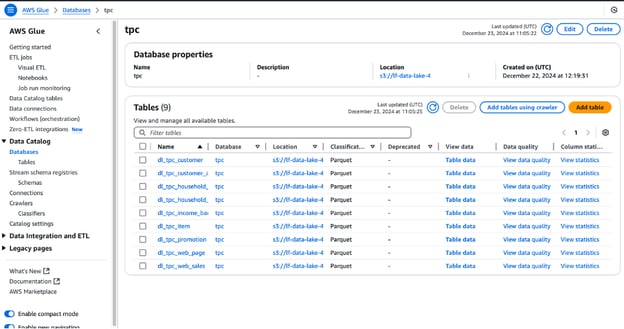
Melihat tabel database di AWS Glue
Praktik Terbaik untuk Mengintegrasikan AWS Lake Formation dan AWS Glue
Saat mengintegrasikan AWS Lake Formation dan AWS Glue, mengikuti praktik terbaik dapat meningkatkan keamanan data, merampingkan operasi, dan mengoptimalkan kinerja. Berikut cara memaksimalkan kedua layanan ini:
Optimalkan izin data
- Terapkan prinsip least privilege: Berikan pengguna dan peran akses hanya ke sumber daya yang mereka butuhkan. Hindari memberikan izin luas yang dapat mengekspos data sensitif atau sumber daya kritis secara tidak perlu.
- Audit kebijakan akses secara berkala: Tinjau dan perbarui kebijakan secara berkala agar selaras dengan persyaratan keamanan dan kepatuhan yang berubah. Manfaatkan alat seperti AWS IAM Access Analyzer untuk mendeteksi kebijakan yang terlalu permisif.
- Manfaatkan LF-Tag untuk manajemen kebijakan: Gunakan Lake Formation Tags (LF-Tag) untuk mengelompokkan sumber daya terkait dan menyederhanakan manajemen izin. Dengan menerapkan tag seperti Sensitive atau Non-Sensitive, Anda dapat membuat kebijakan yang skalabel dan dapat digunakan kembali yang otomatis diterapkan pada sumber daya bertag.
- Pisahkan kebijakan dari sumber daya: Tentukan izin menggunakan LF-Tag atau template sebelum sumber daya dibuat. Ini memastikan proses integrasi berjalan mulus saat sumber data atau tabel baru ditambahkan.
Pantau dan debug job
- Aktifkan CloudWatch logs untuk job Glue: CloudWatch Logs dapat menangkap log terperinci dari eksekusi job AWS Glue, termasuk error dan detail eksekusi. Gunakan log ini untuk menelusuri masalah dengan cepat.
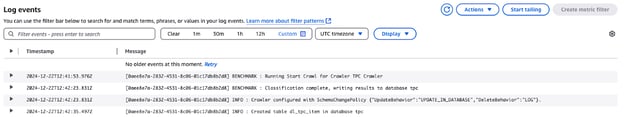
Log event untuk TPC Crawler di AWS CloudWatch
- Pantau metrik Glue: AWS Glue menyediakan metrik untuk membantu mengidentifikasi ketidakefisienan atau masalah dalam alur kerja ETL Anda. Siapkan CloudWatch alarm untuk memberi tahu Anda tentang pola yang tidak biasa.
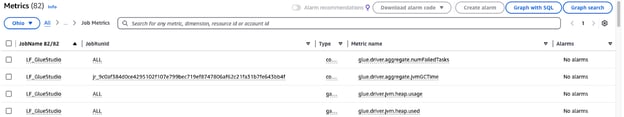
Memantau metrik job AWS Glue Studio
Gunakan partisi dan kompresi
- Optimalkan partisi data: Bagi dataset menurut karakteristik yang sering diminta, seperti departemen, tanggal, atau wilayah. Di Athena atau Redshift, misalnya, membagi data penjualan berdasarkan bulan dan tahun dapat secara signifikan mempercepat kueri dan menurunkan biaya pemindaian.
- Pilih format kompresi yang tepat: Gunakan format penyimpanan kolumnar yang dibuat untuk beban kerja analitik, seperti ORC atau Parquet. Padukan dengan algoritma kompresi yang efektif seperti Snappy untuk menghemat penyimpanan dan mempercepat kueri.
- Otomatiskan partisi dalam job Glue: Job AWS Glue dapat mempartisi data secara dinamis selama proses ETL. Tentukan key partisi dalam konfigurasi job agar data yang masuk disimpan dalam format terstruktur.
- Pantau dan sesuaikan strategi secara berkala: Nilai seberapa baik kompresi dan partisi Anda bekerja seiring bertambahnya volume data. Tinjau pola kueri, lalu modifikasi skema partisi untuk mengakomodasi beban kerja yang berubah.
Kesimpulan
Menerapkan AWS Lake Formation dan AWS Glue membantu organisasi dalam mengatur, melindungi, dan memproses data. Dengan memanfaatkan fitur keamanan komprehensif Lake Formation dan otomatisasi Glue, Anda dapat mengoptimalkan proses ETL, memenuhi semua kebijakan terkait tata kelola data, dan menyediakan akses data yang mudah bagi pengguna, termasuk data engineer dan data scientist.
Manfaatnya meliputi:
- Keamanan yang ditingkatkan: Kontrol akses granular dengan LF-Tag memastikan data sensitif hanya dapat diakses oleh pengguna yang berwenang.
- Otomatisasi: AWS Glue menyederhanakan persiapan dan transformasi data, mengurangi upaya manual dan kesalahan.
- Skalabilitas: Izin dan manajemen kebijakan yang dinamis memungkinkan skalasi tanpa hambatan seiring pertumbuhan data.
- Efisiensi: Kinerja penyimpanan dan kueri yang dioptimalkan melalui partisi dan kompresi menghemat waktu dan biaya.
Saat Anda memperdalam pemahaman tentang integrasi data, penting untuk melengkapinya dengan pengetahuan praktis langsung. Misalnya, menguasai pipeline data dengan ETL dan ELT di Python dapat meningkatkan kemampuan Anda memproses dan mentransformasi data secara efisien. Demikian pula, pemahaman yang kuat tentang Konsep Manajemen Data akan meningkatkan cara Anda menyusun dan menangani dataset. Dan untuk memastikan hasil Anda andal, memahami prinsip-prinsip yang diajarkan dalam kursus Introduction to Data Quality adalah suatu keharusan.
FAQ
Apa tujuan mengintegrasikan AWS Lake Formation dan AWS Glue?
Dengan menerapkan AWS Lake Formation dan AWS Glue, dimungkinkan untuk membangun pipeline data yang aman, otomatis, dan skalabel. Integrasi ini menyediakan kontrol akses yang komprehensif, proses ETL yang efisien, serta platform terpadu untuk manajemen data, analitik, dan kepatuhan.
Apa pentingnya LF-Tag dalam AWS Lake Formation?
LF-Tag memungkinkan pengelolaan izin dalam skala besar karena data diorganisasi berdasarkan taksonomi tertentu, misalnya “Sensitive” atau “Non-Sensitive.” LF-Tag membantu mengurangi kompleksitas kebijakan akses karena Anda dapat menetapkan izin berdasarkan tag, dan bahkan sebelum sumber daya benar-benar dibuat, Anda sudah dapat melakukannya; ini memberikan tingkat fleksibilitas sekaligus keamanan.
Apa peran AWS Glue Studio dalam integrasi ini?
AWS Glue Studio adalah alat konversi data dengan antarmuka drag-and-drop. Pengguna dapat mengembangkan, memantau, dan mengontrol job ETL melalui antarmuka ini. Alat ini membuat proses transformasi data lebih efisien dan membantu menyiapkan data untuk analisis lebih lanjut.
Bisakah beberapa tim mengakses dataset yang sama dengan aman?
Ya, AWS Lake Formation menawarkan kemampuan kontrol akses granular di mana Anda dapat memberikan akses kepada pengguna berdasarkan peran tertentu atau bahkan LF-Tag. Dengan cara ini, setiap tim hanya dapat melihat data yang relevan bagi mereka, dan data tetap terlindungi.
Apa itu dataset TPC yang disebutkan dalam artikel?
Dataset TPC adalah dataset sintetis yang tersedia luas untuk pelatihan, benchmarking, dan tujuan edukasi. Dataset ini berisi informasi tentang berbagai produk, pelanggan, data demografis, penjualan web, dan data terkait transaksi lainnya, sehingga terasa lebih realistis.

Rahul Sharma adalah AWS Ambassador, Arsitek DevOps, dan blogger teknis yang mengkhususkan diri pada komputasi awan, praktik DevOps, serta teknologi open-source. Dengan keahlian di AWS, Kubernetes, dan Terraform, ia menyederhanakan konsep yang kompleks bagi pelajar dan profesional melalui artikel dan tutorial yang menarik. Rahul bersemangat memecahkan tantangan DevOps dan berbagi wawasan untuk memberdayakan komunitas teknologi.




Dalam lanskap data saat ini, banyak organisasi kesulitan mengamankan, mengatur tata kelola, dan memindahkan set data besar. AWS Lake Formation dan AWS Glue adalah dua layanan yang dapat membantu Anda mengatasi tantangan ini. AWS Glue melakukan pembersihan data, restrukturisasi, dan konversi tipe data, sementara AWS Lake Formation membangun data lake serta menangani keamanan dan manajemen data.
Dalam blog ini, kami akan mendemonstrasikan cara membangun pipeline data yang aman dan otomatis menggunakan AWS Lake Formation dan AWS Glue. Kami akan membuat job ETL dengan AWS Glue untuk memindahkan dan memproses data contoh yang saat ini tersimpan di bucket S3, dan kontrol akses granular akan diterapkan melalui AWS Lake Formation.
Apa itu AWS Lake Formation?
AWS Lake Formation menyediakan alat yang diperlukan untuk membuat, mengelola, dan mengamankan data lake di AWS. Dengan Lake Formation, membuat data lake di Amazon S3 serta mengelola keamanan dan izin menjadi lebih mudah.
Dengan AWS Lake Formation, Anda dapat:
Apa itu AWS Glue?
AWS Glue adalah layanan integrasi data tanpa server yang menyediakan fungsi Extract, Transform, and Load (ETL) untuk persiapan data. Ini adalah layanan persiapan data otomatis yang memudahkan pengelolaan pengkatalogan, transformasi, dan pemuatan data. Layanan ini berguna untuk mengonsolidasikan data dari berbagai sumber, seperti S3, ke gudang data atau basis data.
Dengan AWS Glue, Anda mendapatkan:
Jika Anda baru di Glue, lihat tutorial Memulai dengan AWS Glue kami.
Mengapa Mengintegrasikan AWS Lake Formation dan AWS Glue?
Mengintegrasikan AWS Lake Formation dan AWS Glue menghadirkan yang terbaik dari keduanya: data lake yang aman dan pipeline ETL yang otomatis. Beberapa manfaat integrasi ini meliputi: