

इंटीग्रेशन के लिए पूर्वापेक्षाएँ
AWS Lake Formation और AWS Glue को एकीकृत करने से पहले, सुनिश्चित करें कि आपके पास निम्नलिखित हैं:
- AWS खाता: AWS Lake Formation और AWS Glue तक पहुँच।
- आवश्यक ज्ञान: डेटा लेक, ETL और AWS सेवाओं से परिचित होना।
- S3 बकेट: अपना डेटा स्टोर करने के लिए पूर्व-संरूपित S3 बकेट।
- IAM roles: दोनों सेवाओं तक पहुँच के लिए आवश्यक IAM roles और अनुमतियाँ।
- CloudFormation: बेस सेटअप डिप्लॉय करने के लिए एक टेम्पलेट उपलब्ध है। You टेम्पलेट यहाँ पा सकते हैं।
इंटीग्रेशन की चरण-दर-चरण गाइड
एक बार पूर्वापेक्षाएँ पूरी हो जाएँ, तो ये कदम अपनाएँ:
कदम 1: AWS Lake Formation सेटअप करना
पहला कदम एक सुरक्षित डेटा लेक बनाने के लिए आवश्यक कोर AWS संसाधनों को डिप्लॉय करना है, इंटीग्रेशन प्रोसेस शुरू करने से पहले। AWS CloudFormation टेम्पलेट सभी आवश्यक संसाधनों को व्यवस्थित और डिप्लॉय करने में मदद करता है।
अपने AWS खाते में स्टैक बनाने के लिए प्रदान किया गया CloudFormation टेम्पलेट उपयोग करें। यह स्टैक इस ट्यूटोरियल में वर्णित उपयोग मामलों के लिए आवश्यक संसाधन प्रोविजन करता है।
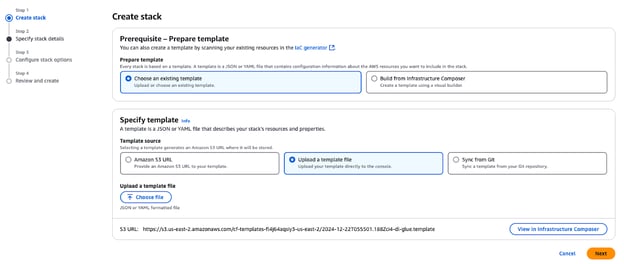
AWS CloudFormation में स्टैक बनाना
स्टैक डिप्लॉय होने पर, आपके AWS खाते में निम्न प्रमुख संसाधन बनेंगे:
- Amazon VPC और सबनेट: उपयुक्त नेटवर्किंग कॉन्फ़िगरेशन के साथ संसाधनों की होस्टिंग के लिए एक VPC और एक पब्लिक सबनेट।
- Amazon S3 बकेट्स:
- ब्लॉग-संबंधित डेटा, स्क्रिप्ट और परिणामों को स्टोर करता है।
- H TPC डेटा होस्ट करता है जिसका उपयोग डेटा लेक बनाने के लिए होता है।
- IAM roles और नीतियाँ:
GlueServiceRole: AWS Glue को S3 और Lake Formation सेवाओं तक पहुँच प्रदान करता है।DataEngineerGlueServiceRole: इंजीनियरों को डेटा एक्सेस और प्रोसेसिंग के लिए अनुमतियाँ देता है।DataAdminUserऔरDataEngineerUser: Lake Formation सुरक्षा को एक्सप्लोर और मैनेज करने के लिए पूर्व-निर्मित IAM यूज़र।- AWS Glue Crawler: S3 बकेट में स्टोर किए गए पारकेट डेटा को स्कैन और कैटलॉग करने के लिए एक TPC Crawler।
- Amazon EC2 इंस्टेंस: एक हेल्पर इंस्टेंस (
EC2-DB-Loader) जो सैंपल डेटा को S3 में प्री-लोड और ट्रांसफर करता है। - AWS Secrets Manager: एक सीक्रेट (
lf-users-credentials) जो पूर्व-निर्मित IAM यूज़र के क्रेडेंशियल्स को सुरक्षित रूप से स्टोर करता है।
स्टैक बनने के बाद, आपके पास निम्नलिखित होंगे:
- A sample TPC डेटाबेस Amazon S3 में स्टोर होगा।
- सुरक्षा पैटर्न और एक्सेस कंट्रोल एक्सप्लोर करने के लिए पूर्व-निर्मित यूज़र और roles।
- अपने डेटा को कैटलॉग और प्रोसेस करने के लिए Glue कॉन्फ़िगरेशन और क्रॉलर।
- इस ब्लॉग के चरणों का पालन करने के लिए आवश्यक सभी बुनियादी घटक।
कदम 2: डेटा अनुमतियाँ कॉन्फ़िगर करना
इस अनुभाग में, Data Lake Administrator AWS Lake Formation को डेटा उपभोक्ता पर्सोना, जिनमें डेटा इंजीनियर भी शामिल हैं, के लिए उपलब्ध कराएगा। प्रशासक निम्न करेगा:
- AWS Lake Formation में एक नया डेटाबेस बनाएँ ताकि TPC डेटा स्टोर किया जा सके।
- TPC डेटासेट के मेटाडेटा टेबल्स को AWS Glue Data Catalog में रजिस्टर करें।
- विभिन्न यूज़र्स के लिए एक्सेस अनुमतियाँ स्थापित करने हेतु Lake Formation टैग्स और नीतियाँ कॉन्फ़िगर करें।
ये कॉन्फ़िगरेशन सुरक्षित, सूक्ष्म स्तर के एक्सेस कंट्रोल और अन्य AWS सेवाओं के साथ सुचारु समन्वय प्रदान करते हैं।
Data Lake Administrator सेटअप करना
Data Lake Administrator एक Identity and Access Management (IAM) यूज़र या role होता है जो किसी भी प्रिंसिपल (खुद सहित) को किसी भी Data Catalog एंटिटी पर अनुमति दे सकता है। Data Catalog को मैनेज करने के लिए प्रायः सबसे पहले यही यूज़र बनाया जाता है और आमतौर पर इसी यूज़र को Data Catalog के लिए प्रशासनिक विशेषाधिकार दिए जाते हैं।
AWS Lake Formation सेवा में, आप नेविगेशन पैनल में Administrative roles and tasks -> Add Administrators पर क्लिक करके प्रॉम्प्ट खोल सकते हैं और फिर ड्रॉपडाउन सूची से lf-data-admin IAM यूज़र का चयन कर सकते हैं।
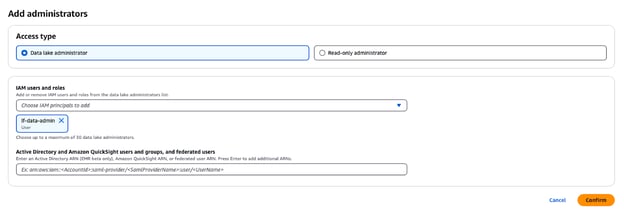
AWS Lake Formation में Data Lake Administrator जोड़ना
कैटलॉग सेटिंग्स बदलना
डिफ़ॉल्ट रूप से, Lake Formation में “Use only IAM access control” विकल्प चुना होता है ताकि AWS Glue Data Catalog के साथ संगतता बनी रहे। Lake Formation अनुमतियों के साथ सूक्ष्म स्तर का एक्सेस कंट्रोल सक्षम करने के लिए, आपको इन सेटिंग्स को समायोजित करना होगा:
- नेविगेशन पेन में, Administration के अंतर्गत Administrative roles and tasks चुनें।
- यदि
IAMAllowedPrincipalsसमूह Database creators के अंतर्गत दिखाई देता है, तो समूह का चयन करें और Revoke चुनें। - Revoke permissions डायलॉग बॉक्स में, सुनिश्चित करें कि समूह के पास Create database अनुमति है और फिर Revoke पर क्लिक करें।
ये कदम डिफ़ॉल्ट IAM एक्सेस कंट्रोल को अक्षम कर देंगे और आपको बेहतर सुरक्षा के लिए Lake Formation अनुमतियाँ लागू करने की अनुमति देंगे।
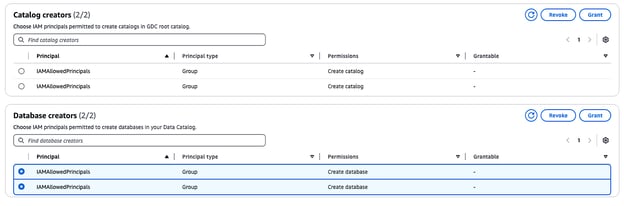
AWS Lake Formation में कैटलॉग और डेटाबेस क्रिएटर्स का प्रबंधन
कदम 3: AWS Glue Data Catalog का उपयोग
अब, Glue Data Catalog को काम में लेने का समय है।
डेटाबेस बनाना
TPC डेटा के लिए डेटाबेस बनाने हेतु, अपने वर्तमान AWS सत्र से लॉग आउट करें और lf-data-admin यूज़र के रूप में पुनः लॉग इन करें। CloudFormation आउटपुट में दिए गए साइन-इन लिंक और AWS Secrets Manager से प्राप्त पासवर्ड का उपयोग करें।
- AWS Lake Formation कंसोल पर जाएँ और बाएँ नेविगेशन पेन से Databases चुनें।
- Create database बटन पर क्लिक करें।
- डेटाबेस का नाम “tpc” रखें, क्योंकि इसका उपयोग TPC डेटा लेक के लिए होगा।
- Location फ़ील्ड में, CloudFormation स्टैक द्वारा बनाया गया S3 डेटा लेक पथ चुनें। यह पथ CloudFormation आउटपुट टैब में मिलेगा और
lf-data-lake-account-IDनाम से होगा, जहाँaccount-IDआपका 12-अंकों का AWS खाता नंबर है। - विकल्प Use only IAM access control for new tables in this database को अनचेक करें ताकि सूक्ष्म स्तर का एक्सेस कंट्रोल सक्षम हो सके।
- अन्य सभी विकल्पों को डिफ़ॉल्ट पर छोड़ें और Create database पर क्लिक करें।
यह डेटाबेस Lake Formation सेटअप में TPC डेटा के मेटाडेटा को स्टोर और प्रबंधित करने की आधारशिला होगा।
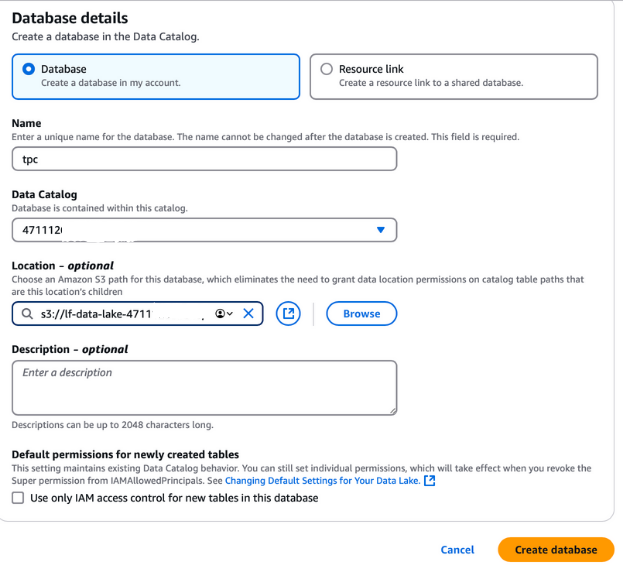
AWS Lake Formation में डेटाबेस बनाना
डेटा लेक को हाइड्रेट करना
AWS Glue Crawler का उपयोग हम AWS Glue Data Catalog में टेबल्स बनाने के लिए करते हैं। क्रॉलर AWS Glue में टेबल्स बनाने का सबसे आम तरीका हैं, क्योंकि वे एक साथ कई डेटा स्टोर को स्कैन कर सकते हैं और क्रॉल पूरा होने के बाद Data Catalog में टेबल्स के विवरण जनरेट या अपडेट कर सकते हैं।
AWS Glue Crawler चलाने से पहले, आपको उसके IAM role को आवश्यक अनुमतियाँ देनी होंगी:
- AWS Lake Formation कंसोल में, Databases पर जाएँ और
tpcडेटाबेस चुनें। - Actions ड्रॉपडाउन मेनू से Grant चुनें।
- Grant permissions डायलॉग बॉक्स में:
- Principals के अंतर्गत IAM role
LF-GlueServiceRoleचुनें। - LF-Tags or catalog resources सेक्शन में सुनिश्चित करें कि Named data catalog resources चुना हुआ है।
- डेटाबेस के रूप में
tpcचुनें। - Database permissions सेक्शन में Create table विकल्प पर टिक करें।
- Grant पर क्लिक करें।
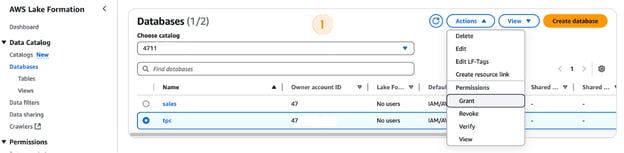
AWS Lake Formation में अनुमतियाँ प्रदान करना
AWS Glue Crawler चलाना
अनुमतियाँ मिलने के बाद, क्रॉलर चलाएँ:
- AWS Lake Formation कंसोल में Crawlers पर जाएँ और AWS Glue कंसोल खोलें।
- TPC Crawler नामक क्रॉलर चुनें और Run crawler पर क्लिक करें।
- Refresh बटन पर क्लिक करके प्रगति मॉनिटर करें।
- समाप्त होने पर, TPC डेटाबेस टेबल्स से भर जाएगा। Table changes from the last run कॉलम में जोड़ी गई टेबल्स की संख्या देखें (उदा., 8 टेबल्स)।
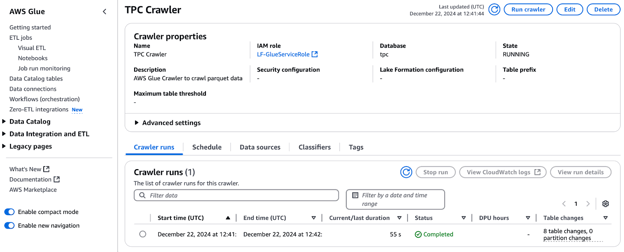
AWS Glue में TPC Crawler चलाना
आप इन टेबल्स को AWS Lake Formation कंसोल में Data catalog और Tables के अंतर्गत भी सत्यापित कर सकते हैं।
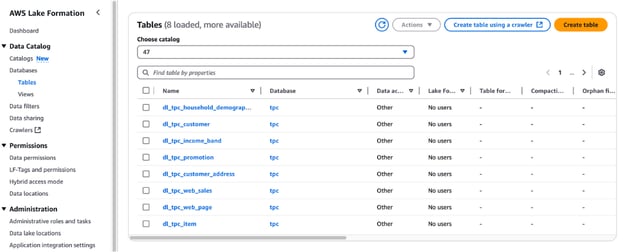
AWS Lake Formation में टेबल्स देखना
Data Lake लोकेशंस रजिस्टर करना
आपको अपने डेटा लेक स्टोरेज के लिए S3 बकेट को AWS Lake Formation में रजिस्टर करना होगा। यह रजिस्ट्रेशन आपको AWS Glue Data Catalog ऑब्जेक्ट्स और बकेट में स्टोर अंतर्निहित डेटा पर सूक्ष्म स्तर का एक्सेस कंट्रोल लागू करने देता है।
Data Lake लोकेशन रजिस्टर करने के चरण:
- AWS Lake Formation कंसोल में Data Lake Locations सेक्शन में जाएँ और Register location पर क्लिक करें।
- CloudFormation टेम्पलेट के माध्यम से बनाए गए S3 बकेट का पाथ दर्ज करें। यह बकेट पाइपलाइन प्रक्रिया के दौरान ग्रहण किए गए डेटा को स्टोर करेगा।
- IAM Role के लिए, CloudFormation टेम्पलेट द्वारा बनाया गया
LF-GlueServiceRoleचुनें। - Permission mode के अंतर्गत, उन्नत एक्सेस कंट्रोल फीचर्स सक्षम करने के लिए Lake Formation चुनें।
- कॉन्फ़िगरेशन सहेजने के लिए Register location पर क्लिक करें।
रजिस्टर होने के बाद, अपने डेटा लेक लोकेशन को सत्यापित करें ताकि यह सुनिश्चित हो सके कि यह सही तरीके से कॉन्फ़िगर है। यह चरण आपके Lake Formation सेटअप में निर्बाध डेटा प्रबंधन और सुरक्षा के लिए आवश्यक है।
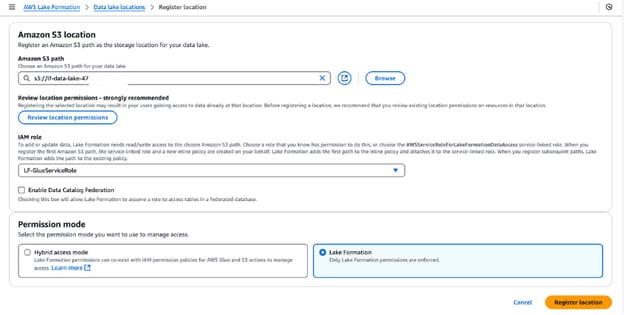
AWS Lake Formation में Amazon S3 लोकेशन रजिस्टर करना
Lake Formation टैग्स (LF-Tags)
LF-Tags का उपयोग संसाधनों को व्यवस्थित करने और एक साथ कई संसाधनों पर अनुमतियाँ सेट करने के लिए किया जा सकता है। यह आपको टैक्सोनॉमीज़ के माध्यम से डेटा को व्यवस्थित करने में सक्षम बनाता है और इस प्रकार जटिल नीतियों को विभाजित करके अनुमतियों का प्रभावी ढंग से प्रबंधन करता है। यह इसलिए संभव है क्योंकि LF-Tags के साथ आप नीति को संसाधन से अलग कर सकते हैं, और इस प्रकार संसाधन बनाए जाने से पहले भी आप एक्सेस नीतियाँ सेट कर सकते हैं।
LF-Tags बनाने और असाइन करने के चरण
- LF-Tags बनाएँ:
- Lake Formation कंसोल पर जाएँ at AWS Lake Formation।
- नेविगेशन पेन में LF-Tags and permissions चुनें, फिर Add LF-Tag पर क्लिक करें।
- “Classification” को key के रूप में दें और “Sensitive” तथा “Non-Sensitive” को values के रूप में जोड़ें। Add LF-Tag पर क्लिक करें।
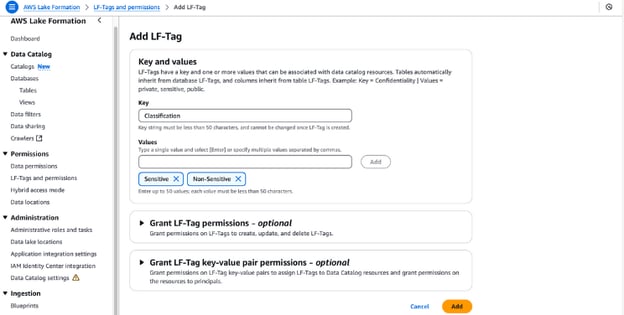
AWS Lake Formation में LF-Tags बनाना
- LF-tag अनुमतियाँ प्रदान करें:
- सुनिश्चित करें कि
lf-data-adminयूज़र के पास LF-Tag अनुमतियाँ हैं। Lake Formation कंसोल में Tables पर जाएँ। - टेबल
dl_tpc_customerचुनें, actions मेनू पर क्लिक करें और Grant चुनें। - IAM users and roles के अंतर्गत
lf-data-adminचुनें। - LF-Tags या कैटलॉग संसाधनों के लिए Named data catalog resources चुनें।
-
tpcडेटाबेस औरdl_tpc_customerटेबल चुनें, औरAlterटेबल अनुमतियाँ दें। Grant पर क्लिक करें।
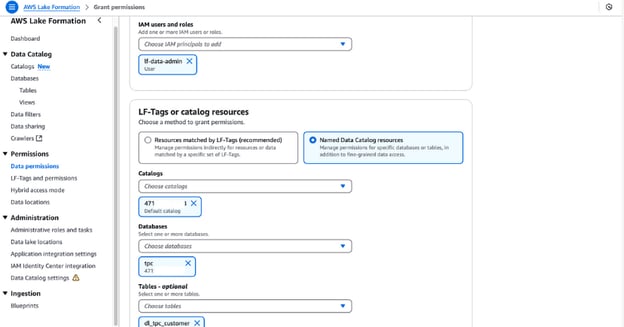
AWS Lake Formation में अनुमतियाँ प्रदान करना
- Data Catalog ऑब्जेक्ट्स को LF-tags असाइन करें:
- Tables पर जाएँ और
dl_tpc_customerटेबल चुनें। टेबल विवरण खोलें और actions मेनू से Edit LF-Tags चुनें। - Assign new LF-Tag पर क्लिक करें, key के रूप में “Classification” दें, और value “Non-Sensitive” सेट करें। Save पर क्लिक करें।
- टेबल के actions मेनू से Edit schema चुनें।
c_first_name,c_last_name, औरc_email_addressजैसे कॉलम चुनें और Edit LF-Tags पर क्लिक करें। - विरासत में मिले key
Classificationके लिए, value को “Sensitive” में बदलें और Save पर क्लिक करें। इस कॉन्फ़िगरेशन को नए संस्करण के रूप में सेव करें। - अतिरिक्त टेबल्स पर LF-Tags लागू करें:
- टेबल
dl_tpc_household_demographicsके लिए, Actions पर जाएँ और Edit LF-Tags चुनें। - डायलॉग बॉक्स में Assign new LF-Tag पर क्लिक करें। key के रूप में Group और value के रूप में Analyst सेट करें। अंतिम रूप देने के लिए Save पर क्लिक करें।
इन चरणों का पालन करके, आप अपने Data Catalog ऑब्जेक्ट्स को कुशलतापूर्वक LF-Tags असाइन कर सकते हैं, जिससे आपके डेटा लेक में सुरक्षित, सूक्ष्म स्तर का एक्सेस कंट्रोल सुनिश्चित होता है।
कदम 4: AWS Glue में ETL जॉब बनाना
AWS Glue Studio एक ड्रैग-एंड-ड्रॉप यूज़र इंटरफ़ेस है जो उपयोगकर्ताओं को AWS Glue के लिए ETL जॉब्स विकसित, डीबग और मॉनिटर करने में मदद करता है। डेटा इंजीनियर Apache Spark आधारित Glue ETL का उपयोग Amazon S3 में स्टोर डेटा सेट्स को ट्रांसफॉर्म करने और विश्लेषण हेतु डेटा लेक और वेयरहाउस में लोड करने के लिए करते हैं। जब कई टीमें एक ही डेटा सेट्स पर सहयोग करती हैं, तो भूमिका-आधारित एक्सेस देना और उसे प्रतिबंधित करना प्रभावी प्रशासन के लिए महत्वपूर्ण है।
AWS Lake Formation के साथ अनुमतियाँ प्रदान करना
आवश्यक अनुमतियाँ lf-data-engineer यूज़र और संबंधित DE-GlueServiceRole role को देने के लिए ये कदम अपनाएँ। यह role डेटा इंजीनियर द्वारा Glue Studio जॉब्स में Glue Data Catalog टेबल्स तक पहुँच के लिए उपयोग किया जाता है।
- Data Lake Administrator के रूप में लॉग इन करें:
- AWS Management Console में लॉग इन करने के लिए
lf-data-adminयूज़र का उपयोग करें। पासवर्ड AWS Secrets Manager से और लॉगिन URL CloudFormation आउटपुट से प्राप्त करें।
- AWS Management Console में लॉग इन करने के लिए
- किसी टेबल के लिए Select अनुमतियाँ दें:
- Lake Formation कंसोल में Data lake permissions पर जाएँ।
- Grant पर क्लिक करें, और डायलॉग बॉक्स में निम्न जानकारी दें:
- IAM users and roles:
lf-data-engineerऔरDE-GlueServiceRoleदर्ज करें। - LF-Tags or catalog resources: Named data catalog resources चुनें।
- Databases:
tpcचुनें। - Tables:
dl_tpc_household_demographicsचुनें। - Table permissions: Select और Describe चुनें।
- IAM users and roles:
- अनुमतियाँ सहेजने के लिए Grant पर क्लिक करें।
- किसी डेटाबेस के लिए Create table अनुमतियाँ दें:
- फिर से Data Lake Permissions पर जाएँ।
- Grant पर क्लिक करें, और डायलॉग बॉक्स में निम्न जानकारी दें:
- IAM users and roles:
DE-GlueServiceRoleदर्ज करें। - LF-Tags or catalog resources: Named data catalog resources चुनें।
- Databases:
tpcचुनें (टेबल्स अनचुनी छोड़ें)। - Database permissions: Create table चुनें।
- IAM users and roles:
- अनुमतियाँ अंतिम रूप देने के लिए Grant पर क्लिक करें।
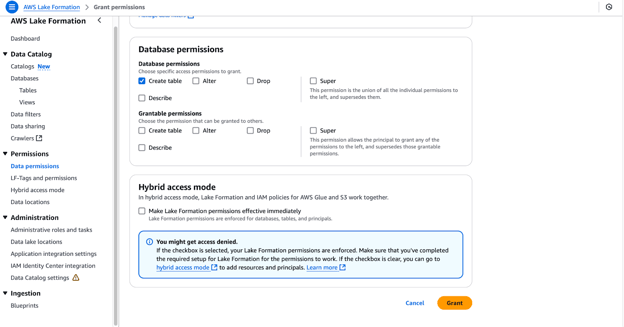
AWS Lake Formation में डेटाबेस अनुमतियाँ कॉन्फ़िगर करना
इन चरणों को पूरा करने से lf-data-engineer यूज़र और DE-GlueServiceRole role को Glue Data Catalog टेबल्स के साथ काम करने और Glue Studio जॉब्स में संसाधनों का प्रबंधन करने के लिए आवश्यक अनुमतियाँ मिलेंगी। यह सेटअप आपके डेटा लेक के लिए सुरक्षित, भूमिका-आधारित एक्सेस सुनिश्चित करता है।
Glue Studio ETL जॉब्स बनाना
इस अनुभाग में, हम SQL Transform का उपयोग करके AWS Glue Studio में एक ETL जॉब बनाएँगे।
-
lf-data-engineerके रूप में AWS में लॉग इन करें:- AWS Management Console में लॉग इन करने के लिए
lf-data-engineerयूज़र का उपयोग करें। पासवर्ड AWS Secrets Manager से और लॉगिन URL CloudFormation आउटपुट से प्राप्त करें।
- AWS Management Console में लॉग इन करने के लिए
- Glue Studio खोलें और नया जॉब शुरू करें:
- Glue Studio कंसोल पर जाएँ और Visual ETL पर क्लिक करें।
- जॉब का नाम
LF_GlueStudioरखें ताकि इसे आसानी से पहचाना जा सके।
- जॉब विवरण कॉन्फ़िगर करें:
- Job Details टैब पर क्लिक करके निम्न कॉन्फ़िगरेशन सेट करें:
- IAM role:
DE-GlueServiceRoleचुनें। - Glue version: Glue 5.0 - Support Spark 3.1, Scala 2, Python 3 चुनें।
- Requested number of workers: 5 सेट करें।
- Job bookmark: Disable चुनें।
- Number of retries: 0 सेट करें।
- IAM role:
- Job Details टैब पर क्लिक करके निम्न कॉन्फ़िगरेशन सेट करें:
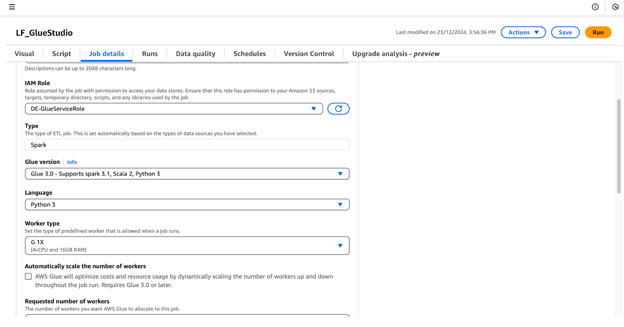
AWS Glue Studio में जॉब विवरण कॉन्फ़िगर करना
- डेटा स्रोत नोड जोड़ें:
- Visual टैब के अंतर्गत, + बटन पर क्लिक करें और डेटा स्रोत कॉन्फ़िगर करने के लिए AWS Glue Data Catalog नोड जोड़ें। इस नोड का नाम “Amazon S3” रखें।
- विजुअल एडिटर पर Amazon S3 नोड चुनें और दाएँ पैनल में इसकी प्रॉपर्टीज़ कॉन्फ़िगर करें:
- Data Source Properties - Data Catalog के अंतर्गत सेट करें:
- Database:
tpc। - Table:
dl_tpc_household_demographics। (नोट:lf-data-adminयूज़र ने केवलlf-data-engineerको इस टेबल पर Select अनुमति दी है। अन्य टेबल्स ड्रॉपडाउन में दिखाई नहीं देंगी।)
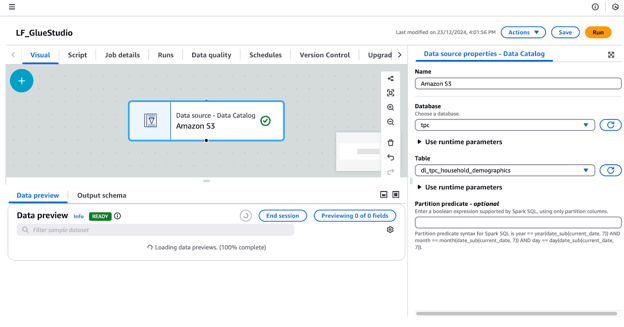
AWS Glue Studio में डेटा स्रोत कॉन्फ़िगर करना
- SQL Query नोड जोड़ें और कॉन्फ़िगर करें:
- Amazon S3 नोड चुने रहने पर, + बटन पर क्लिक करें और ट्रांसफॉर्म के रूप में एक SQL Query नोड जोड़ें।
- SQL Query नोड चुनें और इसे कॉन्फ़िगर करें:
- Transform के अंतर्गत, SQL Query फ़ील्ड में अपनी SQL क्वेरी इनपुट करें।
- यह क्वेरी जोड़ें:
/* Select all records where buy potential is between 0 and 500 */
SELECT *
FROM myDataSource
WHERE hd_buy_potential = '0-500';-
-
- Output Schema के अंतर्गत, Edit पर क्लिक करें और keys
hd_dep_countतथाhd_vehicle_countहटा दें। Apply पर क्लिक करें।
- Output Schema के अंतर्गत, Edit पर क्लिक करें और keys
-
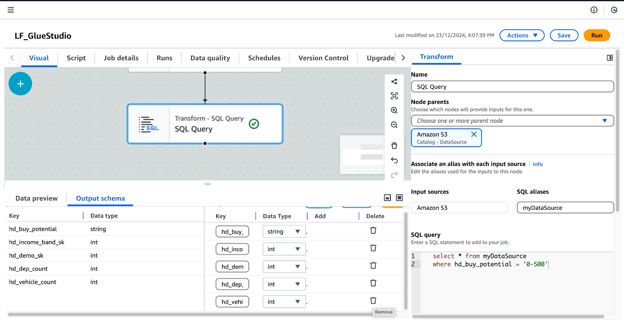
AWS Glue Studio में SQL Query Transform कॉन्फ़िगर करना
- डेटा टारगेट नोड जोड़ें:
- SQL Query नोड चुने रहने पर, + बटन पर क्लिक करें और एक Data Target नोड जोड़ें। सर्च परिणामों से Amazon S3 Target चुनें।
- दाएँ पैनल में Data Target-S3 नोड कॉन्फ़िगर करें:
- Format: Parquet चुनें।
- Compression type: Snappy चुनें।
- S3 target location:
s3://<your_LFDataLakeBucketName>/gluestudio/curated/दर्ज करें। (CloudFormation Outputs टैब से वास्तविक बकेट नाम से<your_LFDataLakeBucketName>को बदलें।) - Data Catalog update options: चुनें Create a table in the Data Catalog and on subsequent runs, update the schema and add new partitions.
- Database:
tpcचुनें। - Table name: आउटपुट टेबल के लिए एक नाम दें। उदाहरण के लिए,
dl_tpc_household_demographics_below500। - जॉब सहेजें और समीक्षा करें:
- ऊपरी-दाएँ कोने में Save पर क्लिक करके जॉब सहेजें।
- वैकल्पिक रूप से, Script टैब पर स्विच करके ऑटो-जनरेटेड स्क्रिप्ट देखें। आवश्यकता हो तो आप स्क्रिप्ट डाउनलोड या संपादित कर सकते हैं।
इन चरणों का पालन करके, आप एक पूर्ण रूप से कार्यात्मक Glue Studio ETL जॉब बनाएँगे जो डेटा को ट्रांसफॉर्म करता है और परिणामों को एक क्यूरेटेड S3 फ़ोल्डर में लिखता है, साथ ही Glue Data Catalog को अपडेट करता है।
कदम 5: इंटीग्रेशन का परीक्षण और सत्यापन
Lake Formation में दी गई अनुमतियों की पुष्टि करने के लिए, Create Glue Studio Jobs अनुभाग में वर्णित अनुसार lf-data-engineer यूज़र के रूप में लॉग इन रहते हुए ये कदम अपनाएँ:
-
LF_GlueStudioजॉब चलाएँ: - LF_GlueStudio जॉब पर जाएँ और जॉब निष्पादित करने के लिए ऊपरी-दाएँ कोने में Run बटन पर क्लिक करें।
- जॉब निष्पादन की निगरानी के लिए जॉब इंटरफ़ेस के भीतर Runs टैब चुनें।
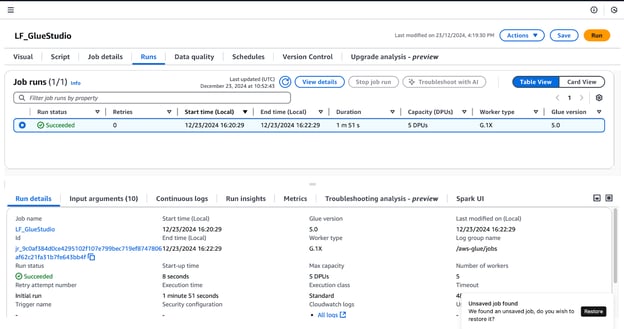
AWS Glue Studio में जॉब रन मॉनिटर करना
- जॉब आउटपुट सत्यापित करें:
- जॉब रन स्टेटस Succeeded दिखने पर, अपने S3 बकेट के
curatedफ़ोल्डर में आउटपुट फ़ाइलें जाँचें। जॉब निर्माण के दौरान कॉन्फ़िगर अनुसार ये फ़ाइलें Parquet फ़ॉर्मेट में होनी चाहिए।
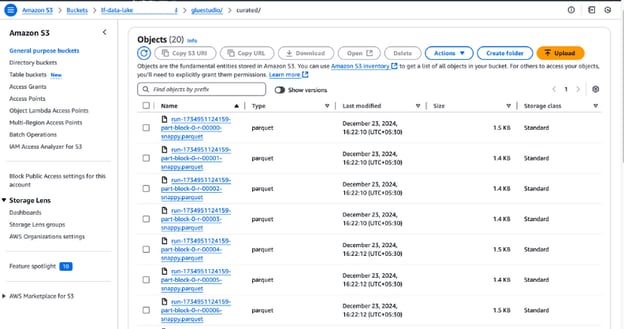
Amazon S3 में आउटपुट फ़ाइलें देखना
- नई बनाई गई टेबल सत्यापित करें:
- Glue Data Catalog खोलें और जॉब सेटअप के दौरान निर्दिष्ट डेटाबेस पर जाएँ।
- जाँचें कि नई टेबल डेटाबेस के अंतर्गत सूचीबद्ध है, जिससे पुष्टि हो कि आउटपुट डेटा सफलतापूर्वक कैटलॉग हो गया है।
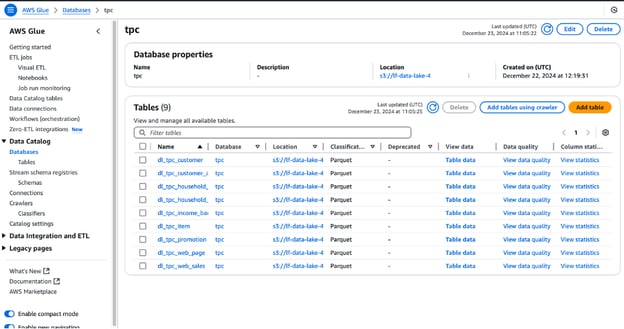
AWS Glue में डेटाबेस टेबल्स देखना
AWS Lake Formation और AWS Glue के एकीकरण के लिए सर्वोत्तम प्रथाएँ
AWS Lake Formation और AWS Glue को एकीकृत करते समय, सर्वोत्तम प्रथाओं का पालन करने से डेटा सुरक्षा में वृद्धि, संचालन को सुव्यवस्थित, और प्रदर्शन का अनुकूलन हो सकता है। इन सेवाओं का अधिकतम लाभ ऐसे उठाएँ:
डेटा अनुमतियाँ अनुकूलित करें
- Least privilege सिद्धांत अपनाएँ: यूज़र्स और roles को केवल वही संसाधन एक्सेस दें जिनकी उन्हें आवश्यकता है। व्यापक अनुमतियाँ देने से बचें जो अनावश्यक रूप से संवेदनशील डेटा या महत्वपूर्ण संसाधन उजागर कर सकती हैं।
- एक्सेस नीतियों का नियमित ऑडिट करें: सुरक्षा और अनुपालन आवश्यकताओं में बदलाव के अनुरूप नीतियों की समय-समय पर समीक्षा और अपडेट करें। अत्यधिक उदार नीतियों का पता लगाने के लिए AWS IAM Access Analyzer जैसे टूल्स का लाभ उठाएँ।
- नीति प्रबंधन के लिए LF-Tags का लाभ उठाएँ: Lake Formation Tags (LF-Tags) का उपयोग संबंधित संसाधनों को समूहबद्ध करने और अनुमतियों के प्रबंधन को सरल बनाने के लिए करें। Sensitive या Non-Sensitive जैसे टैग्स लागू करके आप स्केलेबल, पुन: उपयोग योग्य नीतियाँ बना सकते हैं जो स्वचालित रूप से टैग किए गए संसाधनों पर लागू हो जाती हैं।
- नीतियों को संसाधनों से अलग रखें: संसाधन बनाए जाने से पहले LF-Tags या टेम्पलेट्स का उपयोग कर अनुमतियाँ परिभाषित करें। इससे नए डेटा स्रोतों या टेबल्स के जुड़ने पर निर्बाध इंटीग्रेशन सुनिश्चित होता है।
जॉब्स मॉनिटर और डीबग करें
- Glue जॉब्स के लिए CloudWatch लॉग्स सक्षम करें: CloudWatch Logs AWS Glue जॉब निष्पादन के विस्तृत लॉग्स कैप्चर कर सकता है, जिनमें त्रुटियाँ और निष्पादन विवरण शामिल हैं। मुद्दों का त्वरित समाधान करने के लिए इन लॉग्स का उपयोग करें।
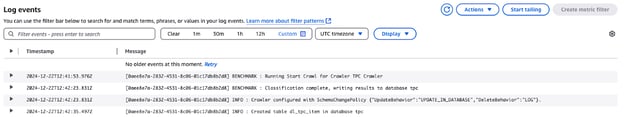
AWS CloudWatch में TPC Crawler के लॉग इवेंट्स
- Glue मेट्रिक्स मॉनिटर करें: AWS Glue मेट्रिक्स प्रदान करता है जो आपके ETL वर्कफ़्लो में अक्षमताओं या मुद्दों की पहचान करने में मदद करता है। असामान्य पैटर्न के बारे में सूचित करने के लिए CloudWatch अलार्म सेट करें।
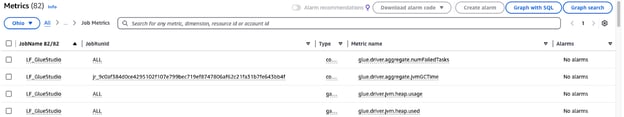
AWS Glue Studio जॉब मेट्रिक्स मॉनिटर करना
पार्टिशनिंग और कंप्रेशन का उपयोग करें
- डेटा पार्टिशनिंग को अनुकूलित करें: डेटा सेट्स को अक्सर पूछी जाने वाली विशेषताओं के अनुसार विभाजित करें, जैसे विभाग, तारीख, या क्षेत्र। Athena या Redshift में, उदाहरण के लिए, बिक्री डेटा को माह और वर्ष के अनुसार विभाजित करने से क्वेरीज़ काफी तेज़ हो सकती हैं और स्कैन लागत कम हो सकती है।
- उचित कंप्रेशन फ़ॉर्मेट चुनें: विश्लेषणात्मक वर्कलोड के लिए बने कॉलमनर स्टोरेज फ़ॉर्मेट जैसे ORC या Parquet का उपयोग करें। इन्हें Snappy जैसे प्रभावी कंप्रेशन एल्गोरिद्म के साथ जोड़ें ताकि स्टोरेज बचे और क्वेरी तेज़ हों।
- Glue जॉब्स में पार्टिशनिंग ऑटोमेट करें: AWS Glue जॉब्स ETL प्रक्रिया के दौरान डेटा को डायनेमिक रूप से पार्टिशन कर सकते हैं। इनकमिंग डेटा को संरचित रूप में स्टोर करने की गारंटी के लिए जॉब कॉन्फ़िगरेशन में पार्टिशन keys निर्दिष्ट करें।
- रणनीतियों की नियमित निगरानी और समायोजन करें: जैसे-जैसे आपका डेटा वॉल्यूम बढ़ता है, अपने कंप्रेशन और पार्टिशनिंग की प्रभावशीलता का आकलन करें। क्वेरी ट्रेंड्स की जाँच करें, फिर बदलते वर्कलोड के अनुरूप पार्टिशनिंग स्कीमा संशोधित करें।
निष्कर्ष
AWS Lake Formation और AWS Glue को लागू करने से संगठन डेटा को व्यवस्थित, सुरक्षित और प्रोसेस कर सकते हैं। Lake Formation के व्यापक सुरक्षा उपायों और Glue के ऑटोमेशन का उपयोग करके, आप अपने ETL प्रोसेस को अनुकूलित कर सकते हैं, डेटा गवर्नेंस से संबंधित सभी नीतियों को पूरा कर सकते हैं, और डेटा इंजीनियर्स तथा डेटा साइंटिस्ट्स सहित उपयोगकर्ताओं के लिए डेटा तक आसान पहुँच प्रदान कर सकते हैं।
लाभों में शामिल हैं:
- बेहतर सुरक्षा: LF-Tags के साथ सूक्ष्म स्तर का एक्सेस कंट्रोल सुनिश्चित करता है कि संवेदनशील डेटा केवल अधिकृत यूज़र्स के लिए सुलभ हो।
- स्वचालन: AWS Glue डेटा प्रिपरेशन और ट्रांसफॉर्मेशन को सरल बनाता है, जिससे मैनुअल प्रयास और त्रुटियाँ कम होती हैं।
- स्केलेबिलिटी: डायनेमिक अनुमतियाँ और नीति प्रबंधन डेटा बढ़ने के साथ निर्बाध स्केलिंग सक्षम करते हैं।
- कुशलता: पार्टिशनिंग और कंप्रेशन के माध्यम से स्टोरेज और क्वेरी प्रदर्शन का अनुकूलन समय और लागत बचाता है।
जैसे-जैसे आप डेटा इंटीग्रेशन की समझ को गहरा करते हैं, अपने सीखने को व्यावहारिक, हाथ-से-हाथ ज्ञान से पूरक करना आवश्यक है। उदाहरण के लिए, ETL और ELT in Python के साथ डेटा पाइपलाइंस में महारत हासिल करना आपके डेटा प्रोसेसिंग और ट्रांसफॉर्मेशन कौशल को उन्नत कर सकता है। इसी तरह, Data Management Concepts की ठोस समझ आपको डेटा सेट्स को संरचित करने और संभालने में बेहतर बनाएगी। और अपने परिणामों की विश्वसनीयता सुनिश्चित करने के लिए, Introduction to Data Quality कोर्स में सिखाए गए सिद्धांतों को समझना आवश्यक है।
FAQs
AWS Lake Formation और AWS Glue को एकीकृत करने का उद्देश्य क्या है?
AWS Lake Formation और AWS Glue को लागू करके, सुरक्षित, स्वचालित और स्केलेबल डेटा पाइपलाइन विकसित करना संभव है। यह इंटीग्रेशन व्यापक एक्सेस कंट्रोल, सुव्यवस्थित ETL प्रोसेस और एकीकृत डेटा प्रबंधन, एनालिटिक्स और अनुपालन प्लेटफ़ॉर्म प्रदान करता है।
AWS Lake Formation में LF-Tags का महत्व क्या है?
LF-Tags बड़े पैमाने पर अनुमतियों का प्रबंधन करने देते हैं क्योंकि इनके माध्यम से डेटा को “Sensitive” या “Non-Sensitive” जैसी टैक्सोनॉमीज़ के अनुसार व्यवस्थित किया जाता है। वे एक्सेस नीतियों की जटिलता को कम करने में मदद करते हैं क्योंकि आप टैग्स के आधार पर अनुमतियाँ सेट कर सकते हैं, और संसाधन वास्तव में बनने से पहले भी ऐसा कर सकते हैं; इससे लचीलापन और सुरक्षा दोनों मिलते हैं।
इस इंटीग्रेशन में AWS Glue Studio की क्या भूमिका है?
AWS Glue Studio एक ड्रैग-एंड-ड्रॉप इंटरफ़ेस वाला डेटा रूपांतरण टूल है। उपयोगकर्ता इस इंटरफ़ेस के माध्यम से ETL जॉब्स विकसित, मॉनिटर और नियंत्रित कर सकते हैं। यह डेटा ट्रांसफॉर्मेशन प्रक्रियाओं को अधिक कुशल बनाता है और इस प्रकार आगे के विश्लेषण के लिए डेटा तैयार करने में मदद करता है।
क्या कई टीमें एक ही डेटासेट को सुरक्षित रूप से एक्सेस कर सकती हैं?
हाँ, AWS Lake Formation सूक्ष्म स्तर के एक्सेस कंट्रोल की क्षमता प्रदान करता है जहाँ आप यूज़र्स को विशिष्ट roles या यहाँ तक कि LF-Tags के आधार पर एक्सेस दे सकते हैं। इस प्रकार, प्रत्येक टीम केवल वही डेटा देख पाएगी जो उनसे संबंधित है, और डेटा सुरक्षित रहेगा।
लेख में उल्लिखित TPC डेटासेट क्या है?
TPC डेटासेट एक सिंथेटिक डेटासेट है जो प्रशिक्षण, बेंचमार्किंग और शैक्षणिक उद्देश्यों के लिए व्यापक रूप से उपलब्ध है। इसमें विभिन्न उत्पादों, ग्राहकों, जनसांख्यिकीय डेटा, वेब सेल्स और अन्य लेनदेन-संबंधित डेटा की जानकारी शामिल होती है, जिससे यह अधिक यथार्थपरक बनता है।

राहुल शर्मा AWS एंबेसडर, DevOps आर्किटेक्ट, और तकनीकी ब्लॉगर हैं, जो क्लाउड कंप्यूटिंग, DevOps प्रथाओं और ओपन‑सोर्स तकनीकों में विशेषज्ञता रखते हैं। AWS, Kubernetes, और Terraform में उनकी विशेषज्ञता के साथ, वे रोचक लेखों और ट्यूटोरियल्स के माध्यम से जटिल अवधारणाओं को सीखने वालों और पेशेवरों के लिए सरल बनाते हैं। राहुल DevOps से जुड़ी चुनौतियों को सुलझाने और तकनीकी समुदाय को सशक्त बनाने के लिए अपनी अंतर्दृष्टियाँ साझा करने के प्रति उत्साही हैं।
आज के डेटा परिदृश्य में संगठन बड़े डेटा सेट को सुरक्षित करने, गवर्न करने और स्थानांतरित करने में संघर्ष करते हैं। AWS Lake Formation और AWS Glue दो सेवाएँ हैं जो इन चुनौतियों को दूर करने में आपकी मदद कर सकती हैं। AWS Glue डेटा की सफाई, पुनर्संरचना और डेटा प्रकार रूपांतरण करता है, जबकि AWS Lake Formation डेटा लेक बनाता है और डेटा सुरक्षा तथा प्रबंधन करता है।
इस ब्लॉग में, हम AWS Lake Formation और AWS Glue का उपयोग करके एक सुरक्षित, स्वचालित डेटा पाइपलाइन विकसित करने का प्रदर्शन करेंगे। हम AWS Glue का उपयोग करके एक ETL जॉब विकसित करेंगे ताकि S3 बकेट में संग्रहीत सैंपल डेटा को स्थानांतरित और प्रोसेस किया जा सके, और सूक्ष्म स्तर का एक्सेस नियंत्रण AWS Lake Formation के माध्यम से किया जाएगा।
AWS Lake Formation क्या है?
AWS Lake Formation AWS पर डेटा लेक बनाने, प्रबंधित करने और सुरक्षित करने के लिए आवश्यक टूल प्रदान करता है। Lake Formation के साथ, Amazon S3 पर डेटा लेक बनाना और सुरक्षा व अनुमतियों का प्रबंधन करना आसान हो जाता है।
AWS Lake Formation का उपयोग करके, आप:
AWS Glue क्या है?
AWS Glue एक सर्वरलेस डेटा इंटीग्रेशन सेवा है जो डेटा प्रिपरेशन के लिए Extract, Transform, and Load (ETL) कार्यक्षमता प्रदान करती है। यह एक स्वचालित डेटा प्रिपरेशन सेवा है जो डेटा कैटलॉगिंग, ट्रांसफॉर्मेशन और लोडिंग का प्रबंधन आसान बनाती है। यह S3 जैसे विभिन्न स्रोतों से डेटा को समेकित करके डेटा वेयरहाउस या डेटाबेस में लाने में सहायक है।
AWS Glue के साथ, आपको मिलता है:
यदि आप Glue में नए हैं, तो हमारा Getting Started with AWS Glue ट्यूटोरियल देखें।
AWS Lake Formation और AWS Glue को एकीकृत क्यों करें?
AWS Lake Formation और AWS Glue का एकीकरण दोनों दुनियाओं का सर्वश्रेष्ठ लाता है: सुरक्षित डेटा लेक और स्वचालित ETL पाइपलाइंस। इस एकीकरण के कुछ लाभ हैं: