कोर्स
Scalable AI Models with PyTorch Lightning
3 घंटा
1.3K
Vaswani आदि के पेपर Attention is All You Need में पहली बार प्रस्तुत किए गए Transformers अपनी अनोखी डिज़ाइन और प्रभावशीलता के कारण तब से कई NLP कार्यों के आधारस्तंभ बन गए हैं।
Transformers के केंद्र में attention मैकेनिज़्म है, विशेष रूप से 'self-attention' की अवधारणा, जो मॉडल को इनपुट डेटा के विभिन्न हिस्सों को महत्व देने और प्राथमिकता देने में सक्षम बनाती है। यह मैकेनिज़्म डेटा में लंबी दूरी की निर्भरताओं को संभालने देता है। मूल रूप से, यह एक वेटिंग स्कीम है जो आउटपुट बनाते समय मॉडल को इनपुट के विभिन्न भागों पर ध्यान केंद्रित करने की अनुमति देती है।
Self-attention मैकेनिज़्म मॉडल को इनपुट सीक्वेंस के विभिन्न शब्दों या फीचर्स पर विचार करने देता है, और प्रत्येक को एक 'वजन' देता है जो किसी दिए गए आउटपुट के लिए उसकी महत्ता को दर्शाता है। उदाहरण के लिए, वाक्य अनुवाद कार्य में, किसी विशेष शब्द का अनुवाद करते समय, मॉडल उन शब्दों को उच्चतर attention वेट दे सकता है जो लक्षित शब्द से व्याकरणिक या अर्थगत रूप से संबंधित हैं। यह प्रक्रिया Transformer को शब्दों या फीचर्स के बीच निर्भरताओं को कैप्चर करने देती है, चाहे वे सीक्वेंस में एक-दूसरे से कितनी भी दूरी पर हों।
NLP के क्षेत्र में Transformers का प्रभाव अतिशयोक्ति से परे है। उन्होंने कई कार्यों में पारंपरिक मॉडलों को पीछे छोड़ दिया है, और मानवीय भाषा को अधिक सूक्ष्मता से समझने और उत्पन्न करने की श्रेष्ठ क्षमता दिखाई है।
NLP की गहन समझ के लिए, DataCamp का Natural Language Processing in Python ट्रैक एक अनुशंसित संसाधन है।
Transformer बनाने से पहले, कार्य वातावरण का सही सेटअप आवश्यक है। सबसे पहले, PyTorch इंस्टॉल होना चाहिए। PyTorch को pip या conda पैकेज मैनेजर के माध्यम से इंस्टॉल किया जा सकता है।
pip के लिए, यह कमांड उपयोग करें:
pip3 install torch torchvision torchaudioconda के लिए, यह कमांड उपयोग करें:
conda install pytorch torchvision -c pytorchPyTorch को इंस्टॉल और चलाने के अन्य विकल्पों के लिए, आधिकारिक वेबसाइट देखें।
इसके अतिरिक्त, डीप लर्निंग अवधारणाओं की बुनियादी जानकारी होना उपयोगी है, क्योंकि Transformer के संचालन को समझने में ये बुनियादी होंगी। हमारा Deep Learning in Python कोर्स शुरुआत करने के लिए बढ़िया है।
Transformer मॉडल बनाने के लिए निम्नलिखित चरण आवश्यक हैं:
हम PyTorch लाइब्रेरी (कोर फ़ंक्शनैलिटी के लिए), न्यूरल नेटवर्क मॉड्यूल (न्यूरल नेटवर्क बनाने के लिए), ऑप्टिमाइज़ेशन मॉड्यूल (नेटवर्क्स को ट्रेन करने के लिए), और डेटा यूटिलिटी फ़ंक्शंस (डेटा को संभालने के लिए) से शुरुआत करेंगे। इसके अतिरिक्त, हम मानक Python के math मॉड्यूल (गणितीय संचालन के लिए) और copy मॉड्यूल (जटिल ऑब्जेक्ट्स की कॉपी बनाने के लिए) आयात करेंगे।
ये टूल्स मॉडल की आर्किटेक्चर परिभाषित करने, डेटा प्रबंधन करने, और प्रशिक्षण प्रक्रिया स्थापित करने की नींव रखते हैं।
import torch
import torch.nn as nn
import torch.optim as optim
import torch.utils.data as data
import math
import copyअपने कॉम्पोनेंट्स बनाना शुरू करने से पहले, निम्न तालिका पर नज़र डालें, जो Transformer के विभिन्न कॉम्पोनेंट्स और उनके उद्देश्य का वर्णन करती है:
| Component | Description | Purpose |
|---|---|---|
| Multi-Head Attention | इनपुट के विभिन्न भागों पर ध्यान केंद्रित करने का तंत्र | सीक्वेंस में विभिन्न स्थितियों के बीच निर्भरताएँ कैप्चर करता है |
| Feed-Forward Networks | पोज़िशन-वाइज़ पूर्ण-सम्पर्कित लेयर्स | attention आउटपुट्स को ट्रांसफ़ॉर्म करता है और जटिलता जोड़ता है |
| Positional Encoding | एंबेडिंग्स में स्थितिगत जानकारी जोड़ता है | मॉडल को सीक्वेंस क्रम का संदर्भ प्रदान करता है |
| Layer Normalization | हर सब-लेयर के इनपुट्स को सामान्यीकृत करता है | प्रशिक्षण को स्थिर करता है, कन्वर्जेन्स सुधारता है |
| Residual Connections | लेयर्स के बीच शॉर्टकट्स | ग्रेडिएंट समस्याओं को कम करके गहरे नेटवर्क्स के प्रशिक्षण में मदद करता है |
| Dropout | कुछ नेटवर्क कनेक्शंस को यादृच्छिक रूप से शून्य करता है | मॉडल को नियमिताइज़ करके ओवरफिटिंग रोकता है |
मल्टी-हेड attention मैकेनिज़्म एक सीक्वेंस में हर जोड़ी की स्थितियों के बीच attention की गणना करता है। यह कई “attention हेड्स” से बना होता है जो इनपुट सीक्वेंस के विभिन्न पहलुओं को कैप्चर करते हैं।
मल्टी-हेड attention के बारे में और जानने के लिए, Large Language Models (LLMs) Concepts कोर्स के attention mechanisms सेक्शन को देखें।
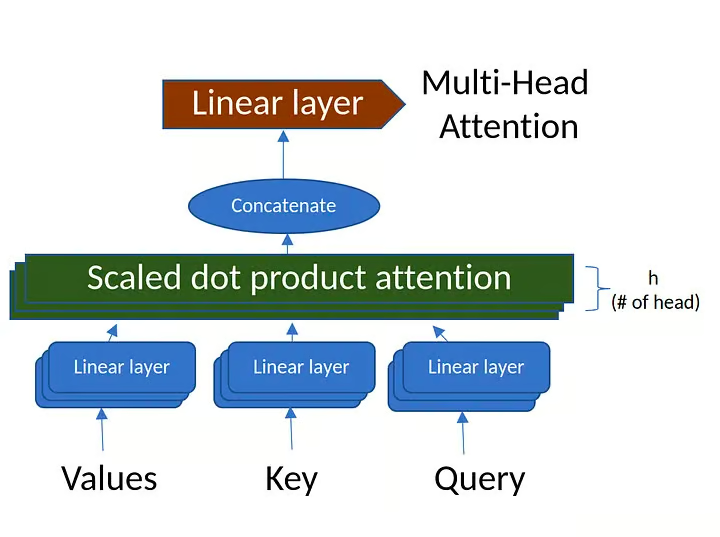
चित्र 1. मल्टी-हेड Attention (स्रोत: लेखक द्वारा बनाई गई छवि)
class MultiHeadAttention(nn.Module):
    def __init__(self, d_model, num_heads):
        super(MultiHeadAttention, self).__init__()
        # Ensure that the model dimension (d_model) is divisible by the number of heads
        assert d_model % num_heads == 0, "d_model must be divisible by num_heads"

        # Initialize dimensions
        self.d_model = d_model # Model's dimension
        self.num_heads = num_heads # Number of attention heads
        self.d_k = d_model // num_heads # Dimension of each head's key, query, and value

        # Linear layers for transforming inputs
        self.W_q = nn.Linear(d_model, d_model) # Query transformation
        self.W_k = nn.Linear(d_model, d_model) # Key transformation
        self.W_v = nn.Linear(d_model, d_model) # Value transformation
        self.W_o = nn.Linear(d_model, d_model) # Output transformation

    def scaled_dot_product_attention(self, Q, K, V, mask=None):
        # Calculate attention scores
        attn_scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(self.d_k)

        # Apply mask if provided (useful for preventing attention to certain parts like padding)
        if mask is not None:
            attn_scores = attn_scores.masked_fill(mask == 0, -1e9)

        # Softmax is applied to obtain attention probabilities
        attn_probs = torch.softmax(attn_scores, dim=-1)

        # Multiply by values to obtain the final output
        output = torch.matmul(attn_probs, V)
        return output

    def split_heads(self, x):
        # Reshape the input to have num_heads for multi-head attention
        batch_size, seq_length, d_model = x.size()
        return x.view(batch_size, seq_length, self.num_heads, self.d_k).transpose(1, 2)

    def combine_heads(self, x):
        # Combine the multiple heads back to original shape
        batch_size, _, seq_length, d_k = x.size()
        return x.transpose(1, 2).contiguous().view(batch_size, seq_length, self.d_model)

    def forward(self, Q, K, V, mask=None):
        # Apply linear transformations and split heads
        Q = self.split_heads(self.W_q(Q))
        K = self.split_heads(self.W_k(K))
        V = self.split_heads(self.W_v(V))

        # Perform scaled dot-product attention
        attn_output = self.scaled_dot_product_attention(Q, K, V, mask)

        # Combine heads and apply output transformation
        output = self.W_o(self.combine_heads(attn_output))
        return output
क्लास परिभाषा और इनिशियलाइज़ेशन:
class MultiHeadAttention(nn.Module):
    def __init__(self, d_model, num_heads):
यह क्लास PyTorch के nn.Module की सबक्लास के रूप में परिभाषित है।
d_model: इनपुट का आयाम।num_heads: attention हेड्स की संख्या जिसमें इनपुट को विभाजित किया जाएगा।इनिशियलाइज़ेशन में जाँचा जाता है कि d_model, num_heads से विभाज्य है, और फिर query, key, value, और output के लिए ट्रांसफ़ॉर्मेशन वेट्स परिभाषित किए जाते हैं।
स्केल्ड डॉट-प्रोडक्ट attention:
def scaled_dot_product_attention(self, Q, K, V, mask=None):attn_scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(self.d_k). यहाँ, queries (Q) और keys (K) का डॉट प्रोडक्ट लेकर और उसे key आयाम (d_k) के वर्गमूल से स्केल करके attention स्कोर्स निकाले जाते हैं।V) से गुणा करके अंतिम आउटपुट प्राप्त किया जाता है।हेड्स को विभाजित करना:
def split_heads(self, x):यह मेथड इनपुट x को आकार (batch_size, num_heads, seq_length, d_k) में रीशेप करता है। यह मॉडल को एक साथ कई attention हेड्स प्रोसेस करने देता है, जिससे समानांतर गणना संभव होती है।
हेड्स को मिलाना:
def combine_heads(self, x):प्रत्येक हेड पर अलग से attention लागू करने के बाद, यह मेथड परिणामों को फिर से एक टेन्सर में मिलाता है जिसका आकार (batch_size, seq_length, d_model) होता है। यह आगे की प्रोसेसिंग के लिए परिणाम तैयार करता है।
फ़ॉरवर्ड मेथड:
def forward(self, Q, K, V, mask=None):वास्तविक गणना फ़ॉरवर्ड मेथड में होती है:
Q), keys (K), और values (V) को पहले इनिशियलाइज़ेशन में परिभाषित वेट्स का उपयोग करके लिनियर ट्रांसफ़ॉर्मेशन से गुजारा जाता है।Q, K, V को split_heads मेथड की मदद से कई हेड्स में विभाजित किया जाता है।scaled_dot_product_attention मेथड कॉल किया जाता है।combine_heads मेथड का उपयोग करके एक टेन्सर में मिलाया जाता है।सारांश में, MultiHeadAttention क्लास Transformer मॉडलों में प्रयुक्त मल्टी-हेड attention मैकेनिज़्म को समाहित करता है। यह इनपुट को कई attention हेड्स में बाँटने, प्रत्येक पर attention लागू करने, और फिर परिणामों को मिलाने का कार्य करता है। ऐसा करके, मॉडल इनपुट डेटा में विभिन्न स्केल्स पर संबंधों को कैप्चर कर पाता है, जिससे उसकी अभिव्यक्तिक क्षमता बढ़ती है।
class PositionWiseFeedForward(nn.Module):
    def __init__(self, d_model, d_ff):
        super(PositionWiseFeedForward, self).__init__()
        self.fc1 = nn.Linear(d_model, d_ff)
        self.fc2 = nn.Linear(d_ff, d_model)
        self.relu = nn.ReLU()

    def forward(self, x):
        return self.fc2(self.relu(self.fc1(x)))
क्लास परिभाषा:
class PositionWiseFeedForward(nn.Module):यह क्लास PyTorch के nn.Module की सबक्लास है, जिसका अर्थ है कि यह न्यूरल नेटवर्क लेयर्स के साथ काम करने के लिए आवश्यक सभी फ़ंक्शनैलिटी उत्तराधिकार में प्राप्त करती है।
इनिशियलाइज़ेशन:
def __init__(self, d_model, d_ff):
    super(PositionWiseFeedForward, self).__init__()
    self.fc1 = nn.Linear(d_model, d_ff)
    self.fc2 = nn.Linear(d_ff, d_model)
self.relu = nn.ReLU()d_model: मॉडल के इनपुट और आउटपुट का आयाम।d_ff: फ़ीड-फ़ॉरवर्ड नेटवर्क की आंतरिक लेयर का आयाम।self.fc1 और self.fc2: दो फुली-कनेक्टेड (लिनियर) लेयर्स, जिनके इनपुट और आउटपुट आयाम d_model और d_ff द्वारा परिभाषित हैं।self.relu: ReLU (Rectified Linear Unit) एक्टिवेशन फ़ंक्शन, जो दोनों लिनियर लेयर्स के बीच नॉन-लिनियरिटी जोड़ता है।फ़ॉरवर्ड मेथड:
def forward(self, x):
return self.fc2(self.relu(self.fc1(x)))x: फ़ीड-फ़ॉरवर्ड नेटवर्क का इनपुट।self.fc1(x): इनपुट पहले पहली लिनियर लेयर (fc1) से गुजरता है।self.relu(...): fc1 के आउटपुट पर ReLU एक्टिवेशन लागू होता है। ReLU सभी ऋणात्मक मानों को शून्य से बदल देता है, जिससे मॉडल में नॉन-लिनियरिटी आती है।self.fc2(...): एक्टिवेटेड आउटपुट फिर दूसरी लिनियर लेयर (fc2) से होकर अंतिम आउटपुट देता है।सारांश में, PositionWiseFeedForward क्लास एक पोज़िशन-वाइज़ फ़ीड-फ़ॉरवर्ड न्यूरल नेटवर्क परिभाषित करता है, जो दो लिनियर लेयर्स और उनके बीच ReLU एक्टिवेशन से बना है। Transformer मॉडलों के संदर्भ में, यह नेटवर्क प्रत्येक पोज़िशन पर अलग-अलग लेकिन समान रूप से लागू होता है। यह attention मैकेनिज़्म्स द्वारा सीखी गई विशेषताओं को ट्रांसफ़ॉर्म करने में मदद करता है और attention आउटपुट्स के लिए एक अतिरिक्त प्रोसेसिंग चरण के रूप में कार्य करता है।
Positional Encoding का उपयोग इनपुट सीक्वेंस में प्रत्येक टोकन की स्थिति संबंधी जानकारी जोड़ने के लिए किया जाता है। यह विभिन्न आवृत्तियों वाले sine और cosine फ़ंक्शंस का उपयोग करके पोज़िशनल एनकोडिंग उत्पन्न करता है।
class PositionalEncoding(nn.Module):
    def __init__(self, d_model, max_seq_length):
        super(PositionalEncoding, self).__init__()

        pe = torch.zeros(max_seq_length, d_model)
        position = torch.arange(0, max_seq_length, dtype=torch.float).unsqueeze(1)
        div_term = torch.exp(torch.arange(0, d_model, 2).float() * -(math.log(10000.0) / d_model))

        pe[:, 0::2] = torch.sin(position * div_term)
        pe[:, 1::2] = torch.cos(position * div_term)

        self.register_buffer('pe', pe.unsqueeze(0))

    def forward(self, x):
        return x + self.pe[:, :x.size(1)]
क्लास परिभाषा:
class PositionalEncoding(nn.Module):यह क्लास PyTorch के nn.Module की सबक्लास के रूप में परिभाषित है, जिससे इसे मानक PyTorch लेयर की तरह उपयोग किया जा सकता है।
इनिशियलाइज़ेशन:
def __init__(self, d_model, max_seq_length):
    super(PositionalEncoding, self).__init__()

    pe = torch.zeros(max_seq_length, d_model)
    position = torch.arange(0, max_seq_length, dtype=torch.float).unsqueeze(1)
    div_term = torch.exp(torch.arange(0, d_model, 2).float() * -(math.log(10000.0) / d_model))

    pe[:, 0::2] = torch.sin(position * div_term)
    pe[:, 1::2] = torch.cos(position * div_term)

self.register_buffer('pe', pe.unsqueeze(0))d_model: मॉडल के इनपुट का आयाम।max_seq_length: उस अधिकतम सीक्वेंस लंबाई तक जिसके लिए पोज़िशनल एनकोडिंग्स पहले से गणना की जाती हैं।pe: शून्यों से भरा टेन्सर, जिसे पोज़िशनल एनकोडिंग्स से भरा जाएगा।position: सीक्वेंस में प्रत्येक स्थिति के लिए स्थिति-सूचकांक वाला टेन्सर।div_term: स्थिति-सूचकांकों को विशिष्ट तरीके से स्केल करने के लिए प्रयुक्त पद।pe के सम अनुक्रमांकों पर और cosine फ़ंक्शन विषम अनुक्रमांकों पर लागू होता है।pe को एक बफ़र के रूप में पंजीकृत किया जाता है, यानी यह मॉड्यूल की स्टेट का हिस्सा होगा लेकिन ट्रेन होने योग्य पैरामीटर नहीं होगा।फ़ॉरवर्ड मेथड:
def forward(self, x):
    return x + self.pe[:, :x.size(1)]
फ़ॉरवर्ड मेथड बस पोज़िशनल एनकोडिंग्स को इनपुट x में जोड़ देता है।
यह x की वास्तविक सीक्वेंस लंबाई के अनुरूप बनाने के लिए pe के पहले x.size(1) तत्वों का उपयोग करता है।
सारांश
PositionalEncoding क्लास सीक्वेंस में टोकन्स की स्थिति संबंधी जानकारी जोड़ता है। चूँकि Transformer मॉडल (अपने self-attention मैकेनिज़्म के कारण) टोकन्स के क्रम का अंतर्निहित ज्ञान नहीं रखता, यह क्लास मॉडल को सीक्वेंस में टोकन्स की स्थिति पर विचार करने में मदद करता है। प्रयुक्त साइनसॉइडल फ़ंक्शंस मॉडल को सापेक्ष स्थितियों पर ध्यान देना आसानी से सिखाते हैं, क्योंकि वे सीक्वेंस की प्रत्येक स्थिति के लिए अद्वितीय और स्मूद एनकोडिंग बनाते हैं।
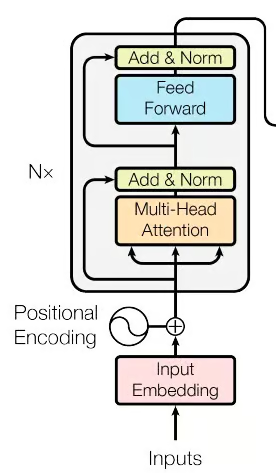
चित्र 2. Transformer नेटवर्क का एन्कोडर भाग (स्रोत: मूल पेपर से छवि)
class EncoderLayer(nn.Module):
    def __init__(self, d_model, num_heads, d_ff, dropout):
        super(EncoderLayer, self).__init__()
        self.self_attn = MultiHeadAttention(d_model, num_heads)
        self.feed_forward = PositionWiseFeedForward(d_model, d_ff)
        self.norm1 = nn.LayerNorm(d_model)
        self.norm2 = nn.LayerNorm(d_model)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x, mask):
        attn_output = self.self_attn(x, x, x, mask)
        x = self.norm1(x + self.dropout(attn_output))
        ff_output = self.feed_forward(x)
        x = self.norm2(x + self.dropout(ff_output))
        return x
क्लास परिभाषा:
class EncoderLayer(nn.Module):यह क्लास PyTorch के nn.Module की सबक्लास के रूप में परिभाषित है, जिसका अर्थ है कि इसे PyTorch में न्यूरल नेटवर्क के निर्माण खंड के रूप में उपयोग किया जा सकता है।
इनिशियलाइज़ेशन:
def __init__(self, d_model, num_heads, d_ff, dropout):
    super(EncoderLayer, self).__init__()
    self.self_attn = MultiHeadAttention(d_model, num_heads)
    self.feed_forward = PositionWiseFeedForward(d_model, d_ff)
    self.norm1 = nn.LayerNorm(d_model)
    self.norm2 = nn.LayerNorm(d_model)
    self.dropout = nn.Dropout(dropout)
पैरामीटर्स:
d_model: इनपुट का आयाम।num_heads: मल्टी-हेड attention में हेड्स की संख्या।d_ff: पोज़िशन-वाइज़ फ़ीड-फ़ॉरवर्ड नेटवर्क की आंतरिक लेयर का आयाम।dropout: रेगुलराइज़ेशन के लिए ड्रॉपआउट दर।कॉम्पोनेंट्स:
self.self_attn: मल्टी-हेड self-attention मैकेनिज़्म।self.feed_forward: पोज़िशन-वाइज़ फ़ीड-फ़ॉरवर्ड न्यूरल नेटवर्क।self.norm1 और self.norm2: लेयर नॉर्मलाइज़ेशन, जो लेयर के इनपुट को स्मूद करता है।self.dropout: ड्रॉपआउट लेयर, जो प्रशिक्षण के दौरान कुछ एक्टिवेशंस को यादृच्छिक रूप से शून्य करके ओवरफिटिंग को रोकने में मदद करता है।फ़ॉरवर्ड मेथड:
def forward(self, x, mask):
    attn_output = self.self_attn(x, x, x, mask)
    x = self.norm1(x + self.dropout(attn_output))
    ff_output = self.feed_forward(x)
    x = self.norm2(x + self.dropout(ff_output))
    return x
इनपुट:
x: एन्कोडर लेयर का इनपुट।mask: इनपुट के कुछ हिस्सों को नज़रअंदाज़ करने के लिए वैकल्पिक मास्क।प्रसंस्करण चरण:
x को मल्टी-हेड self-attention मैकेनिज़्म से गुज़ारा जाता है।norm1 के साथ नॉर्मलाइज़ेशन होता है।norm2 के साथ नॉर्मलाइज़ेशन होता है।सारांश:
EncoderLayer क्लास Transformer के एन्कोडर की एक एकल लेयर को परिभाषित करती है। इसमें मल्टी-हेड self-attention मैकेनिज़्म के बाद पोज़िशन-वाइज़ फ़ीड-फ़ॉरवर्ड नेटवर्क शामिल है, और उपयुक्त स्थानों पर रेजिडुअल कनेक्शंस, लेयर नॉर्मलाइज़ेशन, और ड्रॉपआउट लागू होते हैं। मिलकर, ये कॉम्पोनेंट्स एन्कोडर को इनपुट डेटा में जटिल संबंधों को कैप्चर करने और उन्हें डाउनस्ट्रीम कार्यों के लिए उपयोगी प्रतिनिधित्व में बदलने में सक्षम बनाते हैं। आमतौर पर, ऐसे कई एन्कोडर लेयर्स को स्टैक करके Transformer मॉडल का पूरा एन्कोडर भाग बनाया जाता है।
class DecoderLayer(nn.Module):
    def __init__(self, d_model, num_heads, d_ff, dropout):
        super(DecoderLayer, self).__init__()
        self.self_attn = MultiHeadAttention(d_model, num_heads)
        self.cross_attn = MultiHeadAttention(d_model, num_heads)
        self.feed_forward = PositionWiseFeedForward(d_model, d_ff)
        self.norm1 = nn.LayerNorm(d_model)
        self.norm2 = nn.LayerNorm(d_model)
        self.norm3 = nn.LayerNorm(d_model)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x, enc_output, src_mask, tgt_mask):
        attn_output = self.self_attn(x, x, x, tgt_mask)
        x = self.norm1(x + self.dropout(attn_output))
        attn_output = self.cross_attn(x, enc_output, enc_output, src_mask)
        x = self.norm2(x + self.dropout(attn_output))
        ff_output = self.feed_forward(x)
        x = self.norm3(x + self.dropout(ff_output))
        return x
क्लास परिभाषा:
class DecoderLayer(nn.Module):इनिशियलाइज़ेशन:
def __init__(self, d_model, num_heads, d_ff, dropout):
    super(DecoderLayer, self).__init__()
    self.self_attn = MultiHeadAttention(d_model, num_heads)
    self.cross_attn = MultiHeadAttention(d_model, num_heads)
    self.feed_forward = PositionWiseFeedForward(d_model, d_ff)
    self.norm1 = nn.LayerNorm(d_model)
    self.norm2 = nn.LayerNorm(d_model)
    self.norm3 = nn.LayerNorm(d_model)
self.dropout = nn.Dropout(dropout)पैरामीटर्स:
d_model: इनपुट का आयाम।num_heads: मल्टी-हेड attention में हेड्स की संख्या।d_ff: फ़ीड-फ़ॉरवर्ड नेटवर्क की आंतरिक लेयर का आयाम।dropout: रेगुलराइज़ेशन के लिए ड्रॉपआउट दर।कॉम्पोनेंट्स:
self.self_attn: लक्ष्य सीक्वेंस के लिए मल्टी-हेड self-attention मैकेनिज़्म।self.cross_attn: एन्कोडर के आउटपुट पर attention करने वाला मल्टी-हेड क्रॉस-अटेंशन मैकेनिज़्म।self.feed_forward: पोज़िशन-वाइज़ फ़ीड-फ़ॉरवर्ड न्यूरल नेटवर्क।self.norm1, self.norm2, self.norm3: लेयर नॉर्मलाइज़ेशन कॉम्पोनेंट्स।self.dropout: रेगुलराइज़ेशन के लिए ड्रॉपआउट लेयर।फ़ॉरवर्ड मेथड:
ef forward(self, x, enc_output, src_mask, tgt_mask):
    attn_output = self.self_attn(x, x, x, tgt_mask)
    x = self.norm1(x + self.dropout(attn_output))
    attn_output = self.cross_attn(x, enc_output, enc_output, src_mask)
    x = self.norm2(x + self.dropout(attn_output))
    ff_output = self.feed_forward(x)
    x = self.norm3(x + self.dropout(ff_output))
return xइनपुट:
x: डिकोडर लेयर का इनपुट।enc_output: संबंधित एन्कोडर से आउटपुट (क्रॉस-अटेंशन चरण में उपयोग होता है)।src_mask: एन्कोडर के आउटपुट के कुछ हिस्सों को नज़रअंदाज़ करने के लिए स्रोत मास्क।tgt_mask: डिकोडर के इनपुट के कुछ हिस्सों को नज़रअंदाज़ करने के लिए लक्ष्य मास्क।प्रसंस्करण चरण:
norm1 के साथ नॉर्मलाइज़ किया जाता है।enc_output पर ध्यान करने वाले क्रॉस-अटेंशन मैकेनिज़्म से प्रोसेस किया जाता है।norm2 के साथ नॉर्मलाइज़ किया जाता है।norm3 के साथ नॉर्मलाइज़ किया जाता है।सारांश:
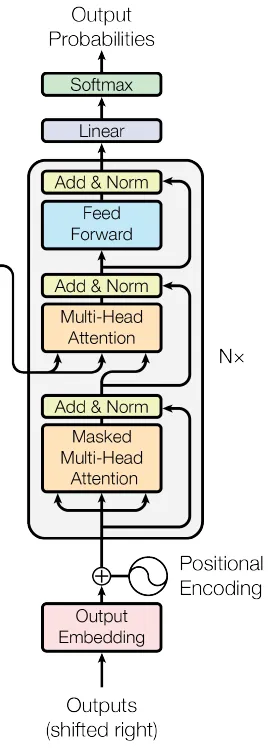
DecoderLayer क्लास Transformer के डिकोडर की एक एकल लेयर को परिभाषित करती है। इसमें मल्टी-हेड self-attention, मल्टी-हेड क्रॉस-अटेंशन (जो एन्कोडर के आउटपुट पर ध्यान करता है), पोज़िशन-वाइज़ फ़ीड-फ़ॉरवर्ड नेटवर्क, और संबंधित रेजिडुअल कनेक्शंस, लेयर नॉर्मलाइज़ेशन, और ड्रॉपआउट लेयर्स शामिल हैं। यह संयोजन डिकोडर को एन्कोडर के प्रतिनिधित्वों के आधार पर, लक्ष्य और स्रोत दोनों सीक्वेंस को ध्यान में रखते हुए सार्थक आउटपुट जनरेट करने में सक्षम बनाता है। एन्कोडर की तरह, डिकोडर का पूर्ण भाग बनाने के लिए आमतौर पर कई डिकोडर लेयर्स स्टैक की जाती हैं।
अगले चरण में, व्यापक Transformer मॉडल का निर्माण करने के लिए एन्कोडर और डिकोडर ब्लॉक्स को संयोजित किया जाएगा।
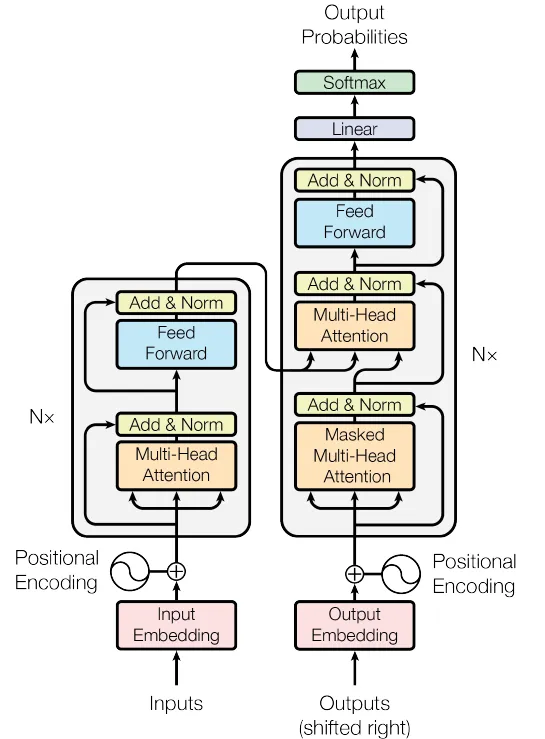
चित्र 4. Transformer नेटवर्क (स्रोत: मूल पेपर से छवि)
class Transformer(nn.Module):
    def __init__(self, src_vocab_size, tgt_vocab_size, d_model, num_heads, num_layers, d_ff, max_seq_length, dropout):
        super(Transformer, self).__init__()
        self.encoder_embedding = nn.Embedding(src_vocab_size, d_model)
        self.decoder_embedding = nn.Embedding(tgt_vocab_size, d_model)
        self.positional_encoding = PositionalEncoding(d_model, max_seq_length)

        self.encoder_layers = nn.ModuleList([EncoderLayer(d_model, num_heads, d_ff, dropout) for _ in range(num_layers)])
        self.decoder_layers = nn.ModuleList([DecoderLayer(d_model, num_heads, d_ff, dropout) for _ in range(num_layers)])

        self.fc = nn.Linear(d_model, tgt_vocab_size)
        self.dropout = nn.Dropout(dropout)

    def generate_mask(self, src, tgt):
        src_mask = (src != 0).unsqueeze(1).unsqueeze(2)
        tgt_mask = (tgt != 0).unsqueeze(1).unsqueeze(3)
        seq_length = tgt.size(1)
        nopeak_mask = (1 - torch.triu(torch.ones(1, seq_length, seq_length), diagonal=1)).bool()
        tgt_mask = tgt_mask & nopeak_mask
        return src_mask, tgt_mask

    def forward(self, src, tgt):
        src_mask, tgt_mask = self.generate_mask(src, tgt)
        src_embedded = self.dropout(self.positional_encoding(self.encoder_embedding(src)))
        tgt_embedded = self.dropout(self.positional_encoding(self.decoder_embedding(tgt)))

        enc_output = src_embedded
        for enc_layer in self.encoder_layers:
            enc_output = enc_layer(enc_output, src_mask)

        dec_output = tgt_embedded
        for dec_layer in self.decoder_layers:
            dec_output = dec_layer(dec_output, enc_output, src_mask, tgt_mask)

        output = self.fc(dec_output)
        return output
क्लास परिभाषा:
class Transformer(nn.Module):इनिशियलाइज़ेशन:
def __init__(self, src_vocab_size, tgt_vocab_size, d_model, num_heads, num_layers, d_ff, max_seq_length, dropout):कन्स्ट्रक्टर निम्न पैरामीटर्स लेता है:
src_vocab_size: स्रोत शब्दावली आकार।tgt_vocab_size: लक्ष्य शब्दावली आकार।d_model: मॉडल की एंबेडिंग्स का आयाम।num_heads: मल्टी-हेड attention में हेड्स की संख्या।num_layers: एन्कोडर और डिकोडर, दोनों के लिए लेयर्स की संख्या।d_ff: फ़ीड-फ़ॉरवर्ड नेटवर्क की आंतरिक लेयर का आयाम।max_seq_length: पोज़िशनल एनकोडिंग के लिए अधिकतम सीक्वेंस लंबाई।dropout: रेगुलराइज़ेशन के लिए ड्रॉपआउट दर।और यह निम्नलिखित कॉम्पोनेंट्स परिभाषित करता है:
self.encoder_embedding: स्रोत सीक्वेंस के लिए एंबेडिंग लेयर।self.decoder_embedding: लक्ष्य सीक्वेंस के लिए एंबेडिंग लेयर।self.positional_encoding: पोज़िशनल एनकोडिंग कॉम्पोनेंट।self.encoder_layers: एन्कोडर लेयर्स की सूची।self.decoder_layers: डिकोडर लेयर्स की सूची।self.fc: लक्ष्य शब्दावली आकार पर मैप करने वाली अंतिम फुली-कनेक्टेड (लिनियर) लेयर।self.dropout: ड्रॉपआउट लेयर।मास्क जनरेट करने का मेथड:
def generate_mask(self, src, tgt):यह मेथड स्रोत और लक्ष्य सीक्वेंस के लिए मास्क बनाता है, जिससे पैडिंग टोकन्स को नज़रअंदाज़ किया जा सके और लक्ष्य सीक्वेंस के लिए प्रशिक्षण के दौरान भविष्य के टोकन्स देखे न जा सकें।
फ़ॉरवर्ड मेथड:
def forward(self, src, tgt):यह मेथड Transformer का फ़ॉरवर्ड पास परिभाषित करता है, जो स्रोत और लक्ष्य सीक्वेंस लेकर आउटपुट प्रेडिक्शंस उत्पन्न करता है।
आउटपुट:
अंतिम आउटपुट एक टेन्सर है जो लक्ष्य सीक्वेंस के लिए मॉडल की भविष्यवाणियों का प्रतिनिधित्व करता है।
सारांश:
Transformer क्लास Transformer मॉडल के विभिन्न कॉम्पोनेंट्स — एंबेडिंग्स, पोज़िशनल एनकोडिंग, एन्कोडर लेयर्स, और डिकोडर लेयर्स — को एक साथ लाती है। यह मल्टी-हेड attention, फ़ीड-फ़ॉरवर्ड नेटवर्क्स, और लेयर नॉर्मलाइज़ेशन की जटिलताओं को समाहित करते हुए प्रशिक्षण और इन्फ़रेंस के लिए एक सुविधाजनक इंटरफ़ेस प्रदान करती है।
यह इम्प्लीमेंटेशन मानक Transformer आर्किटेक्चर का अनुसरण करती है, जिससे यह मशीन अनुवाद, टेक्स्ट समरीकरण आदि जैसे सीक्वेंस-टू-सीक्वेंस कार्यों के लिए उपयुक्त है। मास्किंग का समावेश सुनिश्चित करता है कि मॉडल सीक्वेंस के कारणात्मक निर्भरताओं का पालन करे, पैडिंग टोकन्स को नज़रअंदाज़ करे, और भविष्य के टोकन्स से सूचना लीक न होने दे।
ये क्रमिक चरण Transformer मॉडल को इनपुट सीक्वेंस को कुशलतापूर्वक प्रोसेस करने और उनके अनुरूप आउटपुट सीक्वेंस उत्पन्न करने में सक्षम बनाते हैं।
दृष्टांत उद्देश्यों के लिए, इस उदाहरण में एक डमी डेटासेट बनाया जाएगा। हालाँकि, व्यावहारिक परिदृश्य में, एक अधिक विस्तृत डेटासेट का उपयोग किया जाएगा, और प्रक्रिया में पाठ पूर्वप्रसंस्करण के साथ-साथ स्रोत और लक्ष्य दोनों भाषाओं के लिए शब्दावली मैपिंग्स का निर्माण शामिल होगा।
src_vocab_size = 5000
tgt_vocab_size = 5000
d_model = 512
num_heads = 8
num_layers = 6
d_ff = 2048
max_seq_length = 100
dropout = 0.1

transformer = Transformer(src_vocab_size, tgt_vocab_size, d_model, num_heads, num_layers, d_ff, max_seq_length, dropout)

# Generate random sample data
src_data = torch.randint(1, src_vocab_size, (64, max_seq_length))  # (batch_size, seq_length)
tgt_data = torch.randint(1, tgt_vocab_size, (64, max_seq_length))  # (batch_size, seq_length)
हाइपरपैरामीटर्स:
ये मान Transformer मॉडल की आर्किटेक्चर और व्यवहार को परिभाषित करते हैं:
src_vocab_size, tgt_vocab_size: स्रोत और लक्ष्य सीक्वेंस की शब्दावली का आकार, दोनों 5000।d_model: मॉडल की एंबेडिंग्स का आयाम, 512।num_heads: मल्टी-हेड attention में हेड्स की संख्या, 8।num_layers: एन्कोडर और डिकोडर दोनों के लिए लेयर्स की संख्या, 6।d_ff: फ़ीड-फ़ॉरवर्ड नेटवर्क की आंतरिक लेयर का आयाम, 2048।max_seq_length: पोज़िशनल एनकोडिंग के लिए अधिकतम सीक्वेंस लंबाई, 100।dropout: रेगुलराइज़ेशन के लिए ड्रॉपआउट दर, 0.1।संदर्भ हेतु, निम्न तालिका Transformer मॉडलों के सबसे सामान्य हाइपरपैरामीटर्स और उनके मानों का वर्णन करती है:
| Hyperparameter | Typical values | Impact on performance |
|---|---|---|
| d_model | 256, 512, 1024 | उच्च मान मॉडल की क्षमता बढ़ाते हैं लेकिन अधिक गणना की माँग करते हैं |
| num_heads | 8, 12, 16 | अधिक हेड्स डेटा के विविध पहलुओं को कैप्चर कर सकते हैं, लेकिन कंप्यूटेशनल लागत बढ़ती है |
| num_layers | 6, 12, 24 | अधिक लेयर्स प्रतिनिधित्व शक्ति बढ़ाती हैं, पर ओवरफिटिंग का जोखिम भी |
| d_ff | 2048, 4096 | बड़े फ़ीड-फ़ॉरवर्ड नेटवर्क मॉडल की मज़बूती बढ़ाते हैं |
| dropout | 0.1, 0.3 | ओवरफिटिंग रोकने के लिए मॉडल को रेगुलराइज़ करता है |
| learning rate | 0.0001 - 0.001 | कन्वर्जेन्स की गति और स्थिरता को प्रभावित करता है |
| batch size | 32, 64, 128 | बड़े बैच साइज सीखने की स्थिरता बढ़ाते हैं पर अधिक मेमोरी चाहिए |
Transformer इंस्टेंस बनाना:
transformer = Transformer(src_vocab_size, tgt_vocab_size, d_model, num_heads, num_layers, d_ff, max_seq_length, dropout)यह लाइन दिए गए हाइपरपैरामीटर्स के साथ Transformer क्लास का एक इंस्टेंस बनाती है। यह इंस्टेंस इन्हीं हाइपरपैरामीटर्स द्वारा परिभाषित आर्किटेक्चर और व्यवहार रखेगा।
यादृच्छिक नमूना डेटा बनाना:
निम्न लाइनों में यादृच्छिक स्रोत और लक्ष्य सीक्वेंस बनाए जाते हैं:
src_data: 1 और src_vocab_size के बीच के यादृच्छिक पूर्णांक, जो (64, max_seq_length) आकार वाले स्रोत सीक्वेंस के बैच का प्रतिनिधित्व करते हैं।tgt_data: 1 और tgt_vocab_size के बीच के यादृच्छिक पूर्णांक, जो (64, max_seq_length) आकार वाले लक्ष्य सीक्वेंस के बैच का प्रतिनिधित्व करते हैं।सारांश:
यह कोड स्निपेट दर्शाता है कि Transformer मॉडल को कैसे इनिशियलाइज़ किया जाए और यादृच्छिक स्रोत व लक्ष्य सीक्वेंस कैसे जनरेट किए जाएँ जिन्हें इसमें फ़ीड किया जा सके। चुने गए हाइपरपैरामीटर्स Transformer की विशिष्ट संरचना और गुण निर्धारित करते हैं। यह सेटअप एक बड़े स्क्रिप्ट का हिस्सा हो सकता है जहाँ मॉडल को वास्तविक सीक्वेंस-टू-सीक्वेंस कार्यों जैसे मशीन अनुवाद या टेक्स्ट समरीकरण पर प्रशिक्षित और मूल्यांकित किया जाता है।
अब, ऊपर वर्णित नमूना डेटा का उपयोग करके मॉडल को प्रशिक्षित किया जाएगा। हालाँकि, वास्तविक दुनिया के परिदृश्य में, काफी बड़ा डेटासेट उपयोग किया जाएगा, जिसे सामान्यतः प्रशिक्षण और वैलिडेशन के अलग-अलग सेट्स में विभाजित किया जाता है।
criterion = nn.CrossEntropyLoss(ignore_index=0)
optimizer = optim.Adam(transformer.parameters(), lr=0.0001, betas=(0.9, 0.98), eps=1e-9)

transformer.train()

for epoch in range(100):
    optimizer.zero_grad()
    output = transformer(src_data, tgt_data[:, :-1])
    loss = criterion(output.contiguous().view(-1, tgt_vocab_size), tgt_data[:, 1:].contiguous().view(-1))
    loss.backward()
    optimizer.step()
    print(f"Epoch: {epoch+1}, Loss: {loss.item()}")
लॉस फ़ंक्शन और ऑप्टिमाइज़र:
criterion = nn.CrossEntropyLoss(ignore_index=0): लॉस फ़ंक्शन को क्रॉस-एंट्रॉपी लॉस के रूप में परिभाषित करता है। ignore_index को 0 पर सेट किया गया है, यानी इंडेक्स 0 (आमतौर पर पैडिंग टोकन्स) वाले टार्गेट्स को लॉस में शामिल नहीं किया जाएगा।optimizer = optim.Adam(...): ऑप्टिमाइज़र को Adam के रूप में परिभाषित करता है, 0.0001 लर्निंग रेट और विशिष्ट बीटा मानों के साथ।मॉडल प्रशिक्षण मोड:
transformer.train(): Transformer मॉडल को प्रशिक्षण मोड में सेट करता है, जिससे ड्रॉपआउट जैसी केवल प्रशिक्षण के दौरान लागू होने वाली प्रवृत्तियाँ सक्षम हो जाती हैं।प्रशिक्षण लूप:
यह कोड स्निपेट 100 epochs के लिए एक सामान्य प्रशिक्षण लूप का उपयोग करके मॉडल को ट्रेन करता है:
for epoch in range(100): 100 प्रशिक्षण epochs पर इटरेट करता है।optimizer.zero_grad(): पिछले इटरेशन के ग्रेडिएंट्स को साफ़ करता है।output = transformer(src_data, tgt_data[:, :-1]): स्रोत डेटा और लक्ष्य डेटा (हर सीक्वेंस के अंतिम टोकन को छोड़कर) को Transformer से पास करता है। यह सीक्वेंस-टू-सीक्वेंस कार्यों में सामान्य है, जहाँ लक्ष्य को एक टोकन से शिफ्ट किया जाता है।loss = criterion(...): मॉडल की भविष्यवाणियों और लक्ष्य डेटा (हर सीक्वेंस के पहले टोकन को छोड़कर) के बीच लॉस की गणना करता है। डेटा को एक-आयामी टेन्सर्स में रीशेप करके क्रॉस-एंट्रॉपी लॉस फ़ंक्शन का उपयोग किया जाता है।loss.backward(): लॉस के सापेक्ष मॉडल के पैरामीटर्स के ग्रेडिएंट्स की गणना करता है।optimizer.step(): गणना किए गए ग्रेडिएंट्स का उपयोग करके मॉडल के पैरामीटर्स को अपडेट करता है।print(f"Epoch: {epoch+1}, Loss: {loss.item()}"): वर्तमान epoch संख्या और उस epoch का लॉस मान प्रिंट करता है।सारांश:
यह कोड स्निपेट 100 epochs के लिए यादृच्छिक रूप से जनरेट किए गए स्रोत और लक्ष्य सीक्वेंस पर Transformer मॉडल को ट्रेन करता है। यह Adam ऑप्टिमाइज़र और क्रॉस-एंट्रॉपी लॉस फ़ंक्शन का उपयोग करता है। हर epoch के लिए लॉस प्रिंट किया जाता है, जिससे आप प्रशिक्षण प्रगति की निगरानी कर सकते हैं। वास्तविक-world परिदृश्य में, आप यादृच्छिक स्रोत और लक्ष्य सीक्वेंस को अपनी टास्क (जैसे मशीन अनुवाद) के वास्तविक डेटा से बदलेंगे।
मॉडल को प्रशिक्षित करने के बाद, उसके प्रदर्शन का मूल्यांकन वैलिडेशन या टेस्ट डेटासेट पर किया जा सकता है। नीचे इसका एक उदाहरण दिया गया है:
transformer.eval()

# Generate random sample validation data
val_src_data = torch.randint(1, src_vocab_size, (64, max_seq_length))  # (batch_size, seq_length)
val_tgt_data = torch.randint(1, tgt_vocab_size, (64, max_seq_length))  # (batch_size, seq_length)

with torch.no_grad():

    val_output = transformer(val_src_data, val_tgt_data[:, :-1])
    val_loss = criterion(val_output.contiguous().view(-1, tgt_vocab_size), val_tgt_data[:, 1:].contiguous().view(-1))
    print(f"Validation Loss: {val_loss.item()}")
मूल्यांकन मोड:
transformer.eval(): Transformer मॉडल को इवैल्यूएशन मोड में डालता है। यह महत्वपूर्ण है क्योंकि यह ड्रॉपआउट जैसी केवल प्रशिक्षण के दौरान प्रयुक्त प्रवृत्तियों को बंद कर देता है।यादृच्छिक वैलिडेशन डेटा जनरेट करना:
val_src_data: 1 और src_vocab_size के बीच के यादृच्छिक पूर्णांक, जो (64, max_seq_length) आकार वाले वैलिडेशन स्रोत सीक्वेंस के बैच का प्रतिनिधित्व करते हैं।val_tgt_data: 1 और tgt_vocab_size के बीच के यादृच्छिक पूर्णांक, जो (64, max_seq_length) आकार वाले वैलिडेशन लक्ष्य सीक्वेंस के बैच का प्रतिनिधित्व करते हैं।वैलिडेशन लूप:
with torch.no_grad(): ग्रेडिएंट गणना को निष्क्रिय करता है, क्योंकि वैलिडेशन के दौरान वेट अपडेट की आवश्यकता नहीं होती। इससे मेमोरी की खपत कम होती है और गणना तेज़ होती है।val_output = transformer(val_src_data, val_tgt_data[:, :-1]): वैलिडेशन स्रोत डेटा और वैलिडेशन लक्ष्य डेटा (हर सीक्वेंस के अंतिम टोकन को छोड़कर) को Transformer से पास करता है।val_loss = criterion(...): मॉडल की भविष्यवाणियों और वैलिडेशन लक्ष्य डेटा (हर सीक्वेंस के पहले टोकन को छोड़कर) के बीच लॉस की गणना करता है। लॉस को एक-आयामी टेन्सर्स में रीशेप करके, पहले से परिभाषित क्रॉस-एंट्रॉपी लॉस फ़ंक्शन का उपयोग किया जाता है।print(f"Validation Loss: {val_loss.item()}"): वैलिडेशन लॉस मान प्रिंट करता है।सारांश:
यह कोड स्निपेट यादृच्छिक रूप से जनरेट किए गए वैलिडेशन डेटासेट पर Transformer मॉडल का मूल्यांकन करता है, वैलिडेशन लॉस की गणना करता है, और उसे प्रिंट करता है। वास्तविक-world परिदृश्य में, यादृच्छिक वैलिडेशन डेटा को उस टास्क के वास्तविक वैलिडेशन डेटा से बदलना चाहिए जिस पर आप काम कर रहे हैं। वैलिडेशन लॉस यह संकेत देता है कि आपका मॉडल अनदेखे डेटा पर कितना अच्छा प्रदर्शन कर रहा है, जो मॉडल की जेनेरलाईज़ेशन क्षमता का एक महत्वपूर्ण माप है।
Transformers और Hugging Face के बारे में अधिक जानकारी के लिए, हमारा ट्यूटोरियल An Introduction to Using Transformers and Hugging Face उपयोगी है।
अंत में, इस ट्यूटोरियल ने दिखाया कि PyTorch — जो डीप लर्निंग के लिए सबसे बहुमुखी टूल्स में से एक है — का उपयोग करके Transformer मॉडल कैसे बनाया जाए। समानांतरता की क्षमता और डेटा में दीर्घकालिक निर्भरताओं को कैप्चर करने की योग्यता के साथ, Transformers के पास विभिन्न क्षेत्रों में, विशेष रूप से अनुवाद, सारांशण, और सेंटिमेंट विश्लेषण जैसे NLP कार्यों में अपार संभावनाएँ हैं।
जो लोग उन्नत डीप लर्निंग अवधारणाओं और तकनीकों की अपनी समझ को और गहरा करना चाहते हैं, वे DataCamp पर Advanced Deep Learning with Keras कोर्स को देख सकते हैं। आप एक अलग ट्यूटोरियल में PyTorch के साथ एक सरल न्यूरल नेटवर्क बनाना भी पढ़ सकते हैं।
इन कोर्सेज़ के साथ PyTorch के बारे में और जानें!
कोर्स
कोर्स
कोर्स