Curso
Conceptos de la IA generativa
2 h
117.2K
Databricks ha sido pionera en el desarrollo de tecnologías y plataformas que permiten llevar soluciones de IA a escala, impulsando además proyectos de código abierto como Apache Spark y MLflow.
Durante el Data + AI Summit 2023 de Databricks, se anunció Lakehouse AI como la primera plataforma de IA del mundo integrada en la capa de datos — y se presentaron muchas más novedades. Con el lanzamiento de ChatGPT y los enormes avances de la IA generativa a nivel global, Lakehouse AI es la respuesta de Databricks para crear aplicaciones de IA generativa con un enfoque centrado en los datos.
En este tutorial, vamos a presentar la plataforma Databricks Lakehouse AI, reflexionar sobre su importancia, entender las nuevas funciones lanzadas y cómo podemos aprovecharlas en nuestro ciclo de desarrollo de machine learning.
¿Lakehouse? Sabemos que pueden ser términos nuevos para ti.
Desgranemos paso a paso la evolución de Databricks Lakehouse AI. Para entender Lakehouse AI, primero tenemos que comprender bien la arquitectura Lakehouse.
Un "lakehouse" es una arquitectura moderna de gestión de datos que combina la flexibilidad y el bajo coste de un data lake con las capacidades de gestión de datos de un data warehouse.
Tenemos un tutorial completo sobre las diferencias entre data lake y data warehouse, pero, en resumen, significa lo siguiente:
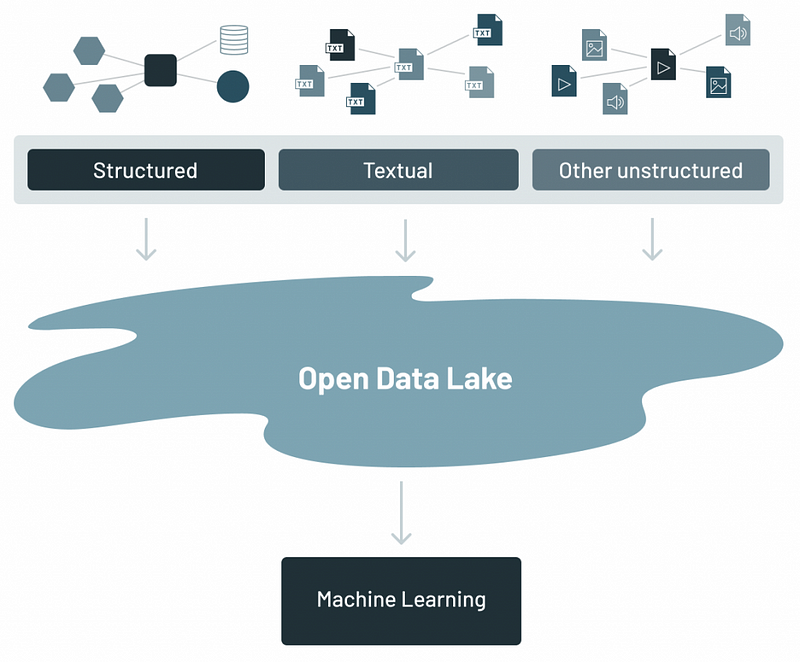
La arquitectura de un data lake (Fuente)
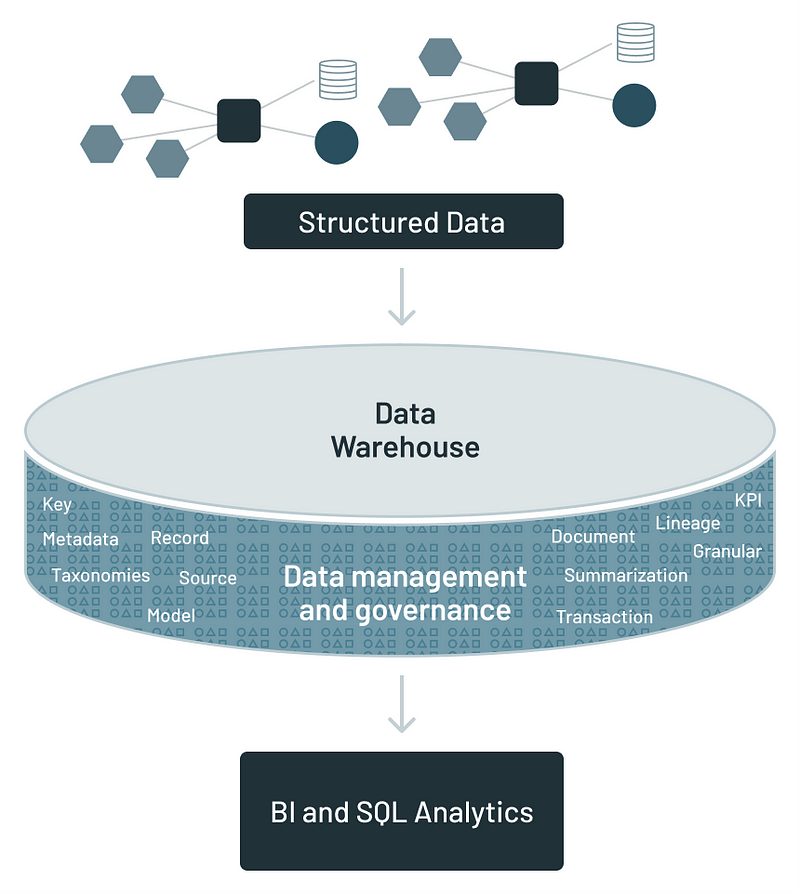
La arquitectura de un data warehouse (Fuente)
Los data lakes suelen tener dificultades de gestión y gobernanza por la propia naturaleza de almacenar grandes cantidades de datos en bruto y no estructurados, lo que puede derivar en "pantanos de datos" en los que es difícil encontrar, acceder o confiar en la información. La falta de estructura también puede lastrar el rendimiento de consultas analíticas complejas, y los data lakes tradicionales no suelen soportar bien operaciones transaccionales, al carecer de transacciones ACID, fundamentales para garantizar la integridad de los datos.
Los data warehouses, por su parte, están optimizados para datos estructurados y analítica, pero pueden resultar muy costosos de escalar a medida que crecen los volúmenes. La exigencia de estructurar y procesar los datos en un esquema predefinido introduce rigidez y limita la capacidad de ingerir y analizar rápidamente nuevos tipos de datos.
Estas limitaciones han impulsado la evolución de la arquitectura lakehouse, que busca aunar lo mejor de ambos mundos:
Así es como se ve la arquitectura lakehouse:
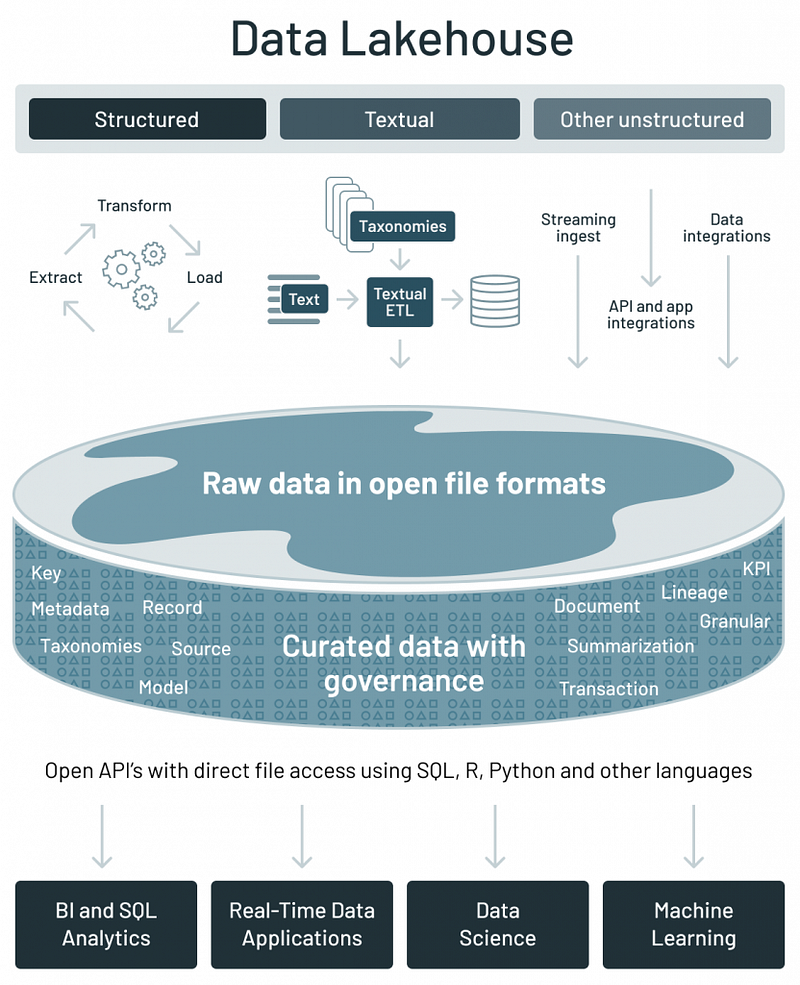
La arquitectura data lakehouse (Fuente)
Ahora que entendemos la evolución de Databricks Lakehouse, llegamos a la pregunta clave.
Lakehouse AI es la integración de capacidades de inteligencia artificial y machine learning directamente en la arquitectura lakehouse. Esto significa que podemos desarrollar, entrenar y desplegar modelos de IA usando los enormes volúmenes de datos almacenados en el data lake sin necesidad de mover o copiar los datos a otro entorno para su procesamiento.
La relevancia de esta plataforma es:
Estas características explican por qué Databricks presentó esta plataforma como la primera plataforma de IA del mundo integrada en la capa de datos.
La transición hacia Lakehouse AI ha sido fundamental para que las empresas adopten operaciones más basadas en datos e integradas con IA.
En el corazón de esta transformación hay varios componentes esenciales que facilitan el desarrollo, el despliegue y la gestión de modelos de IA y machine learning. Entender por qué y cuándo se necesitan puede ayudar a las organizaciones a aprovechar sus datos con mayor eficacia para aplicaciones de IA.
Vector Search en Databricks Lakehouse AI supone un gran avance (también presentado en el Data + AI Summit 2023) para manejar y buscar en conjuntos de datos masivos información semánticamente similar, en lugar de basarse en coincidencias de palabras clave tradicionales.
Vector Search funciona convirtiendo datos y consultas en vectores en un espacio multidimensional llamado embeddings, derivados de un modelo de IA generativa. Este método coloca más cerca en el espacio n-dimensional las palabras o conceptos semánticamente similares, permitiendo resultados de búsqueda más relevantes y con contexto.
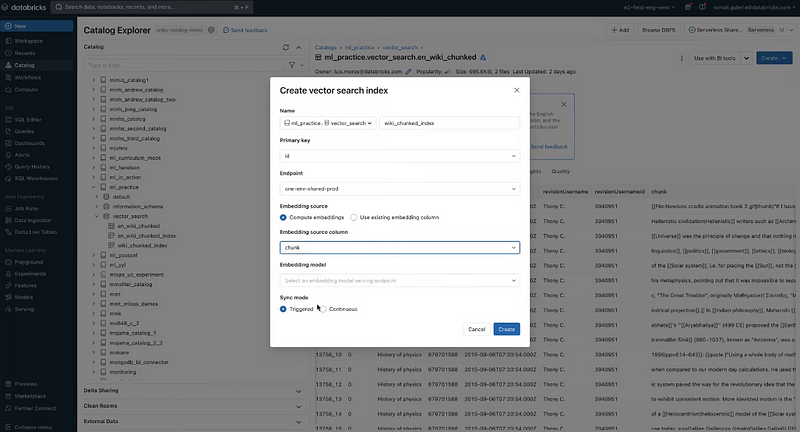
Búsqueda vectorial (captura del autor)
El proceso de uso de Vector Search (vídeo demo de Databricks) es el siguiente:
Empresas como Lippert ya utilizan Vector Search para que sus agentes encuentren rápidamente respuestas a las consultas de clientes, ingiriendo contenido de diversas fuentes.
Estos modelos, disponibles en el Marketplace de Databricks, están optimizados para alto rendimiento y se integran fácilmente en el entorno Lakehouse para múltiples casos de uso, desde análisis y generación de texto hasta procesamiento de imágenes.
Algunos modelos de IA generativa seleccionados son:
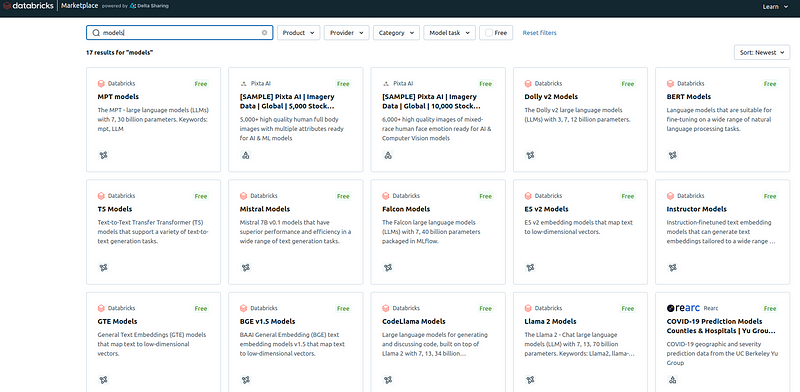
Modelos disponibles en Databricks Marketplace (captura del autor)
Estos modelos están diseñados para funcionar sin fricciones con el resto de funciones de Databricks Lakehouse AI, incluyendo gestión de datos, analítica y herramientas de MLOps. Enseguida veremos cómo usarlos en el desarrollo de machine learning.
Las funciones de AutoML (aprendizaje automático automatizado) dentro de Databricks Lakehouse AI están pensadas para agilizar y automatizar el proceso de desarrollo de modelos, acercando la ciencia de datos avanzada a más perfiles, incluso con poca experiencia en machine learning.
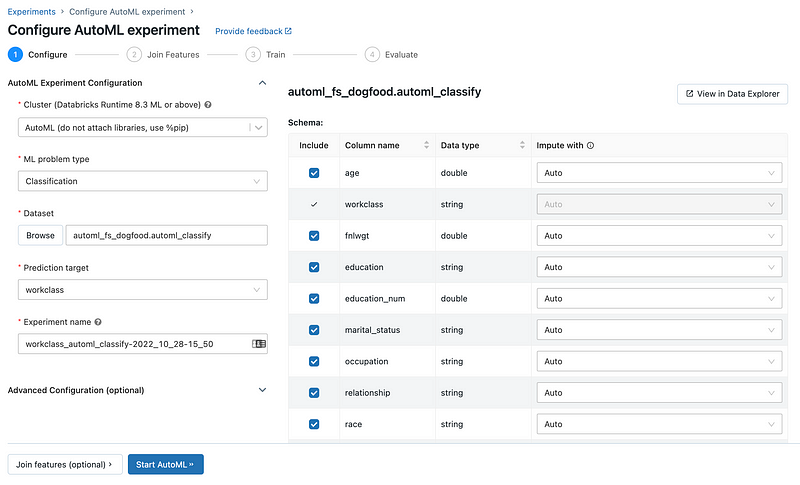
Databricks AutoML (Fuente)
Cuando proporcionamos el conjunto de datos y el objetivo de predicción, AutoML se encarga de preparar los datos para entrenar un modelo. Después crea, ajusta y evalúa múltiples modelos a través de una serie de ensayos.
Una vez completada la evaluación, AutoML presenta los resultados y ofrece un notebook de Python con el código fuente de cada ensayo. Esto nos permite revisar, reproducir y modificar el código según sea necesario. AutoML también calcula estadísticas resumidas sobre el dataset y guarda esta información en un notebook para futuras consultas.
Con el último lanzamiento, AutoML ahora permite afinar modelos de IA generativa para clasificación de texto y modelos de embeddings con datos propios del cliente. Esto significa que usuarios de negocio no técnicos pueden crear aplicaciones de IA generativa con unos pocos clics.
Databricks Lakehouse Monitoring nos permite supervisar las propiedades estadísticas y la calidad de nuestras tablas de datos y hacer seguimiento del rendimiento de los modelos de machine learning y sus predicciones. Analizando el flujo de datos dentro de los pipelines de Databricks, esta función ayuda a garantizar la monitorización continua de la calidad de los datos y la eficacia de los modelos.
Así fluye la información a través del monitoreo de Lakehouse para habilitar la supervisión continua:
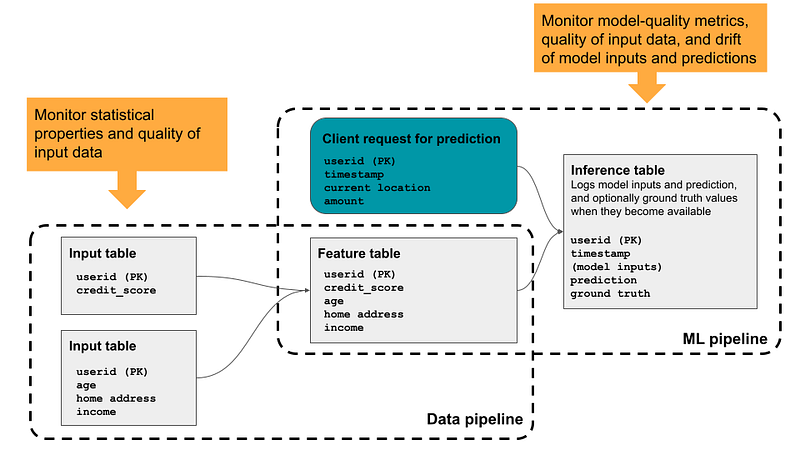
Flujo de Lakehouse Monitoring (Fuente)
Además de monitorizar, esta función aporta insights accionables sobre integridad de datos, distribuciones, drift y rendimiento del modelo a lo largo del tiempo.
Veamos ahora cómo todas estas funciones se integran bajo una gobernanza unificada en Lakehouse AI.
La idea de gobernanza unificada es poder acceder, controlar, colaborar, monitorizar y actuar sobre los datos, los modelos de machine learning y otros activos de IA en un único lugar. A medida que una organización crece y madura en su recorrido de transformación con IA, gestionar todo desde una misma plataforma es clave.
Databricks Unity Catalog hace precisamente eso, y unificar el enfoque de gobernanza de los activos de IA acelera la adopción de IA garantizando al mismo tiempo el cumplimiento normativo.
Aunque hay funciones útiles como el explorador de datos y la posibilidad de añadir sistemas externos, la característica estrella es poder tener una vista panorámica de la gobernanza de todos estos activos mediante un sencillo portal de Unity Catalog, como se muestra a continuación:
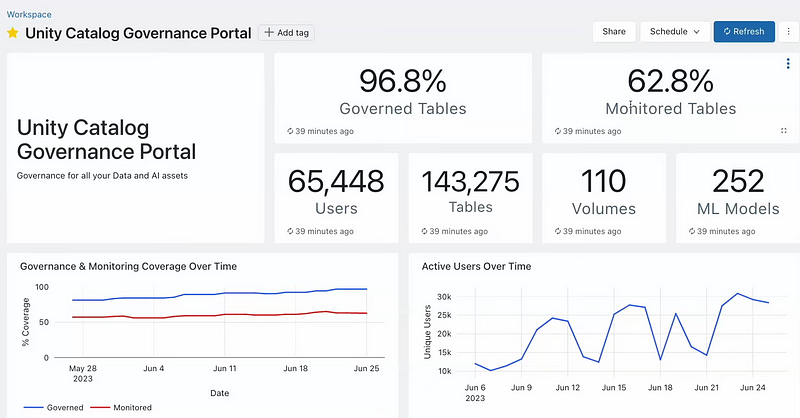
Portal de gobernanza de Unity Catalog (captura del autor)
Este portal muestra métricas clave como el porcentaje de tablas gobernadas y monitorizadas, el número de usuarios activos y el recuento de tablas, volúmenes y modelos de ML. Esta vista de alto nivel ayuda a evaluar rápidamente el estado de la gobernanza y el uso activo de los activos de datos.
El panel también muestra la actividad de los usuarios en el tiempo, lo que ayuda a entender cómo se utilizan los activos de datos dentro de la organización e identificar cuellos de botella o necesidades de formación.
Además, el portal lista posibles riesgos de gobernanza identificando problemas como tablas sin monitorizar o columnas derivadas de PII (información personal identificable), proporcionando un enfoque proactivo para gestionar los datos de forma segura, como se ve a continuación.
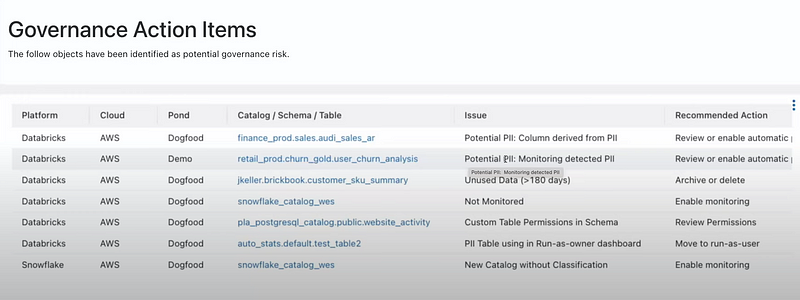
Vista de acciones de gobernanza en el panel de Unity Catalog (captura del autor)
Cada problema detectado incluye una acción recomendada que guía a los usuarios para resolver posibles incidencias de gobernanza. Esta función simplifica y unifica el proceso, a menudo complejo, de gobernar los activos de IA y datos en toda la plataforma.
Ahora que entendemos las funciones de la plataforma y cómo encajan entre sí, pasemos a su aplicación en un desarrollo de machine learning de extremo a extremo.
Para repasar el ciclo de vida del desarrollo de machine learning, te recomendamos nuestro tutorial detallado. En esta sección, veremos cómo encajan las funciones de Databricks Lakehouse AI dentro de ese ciclo.
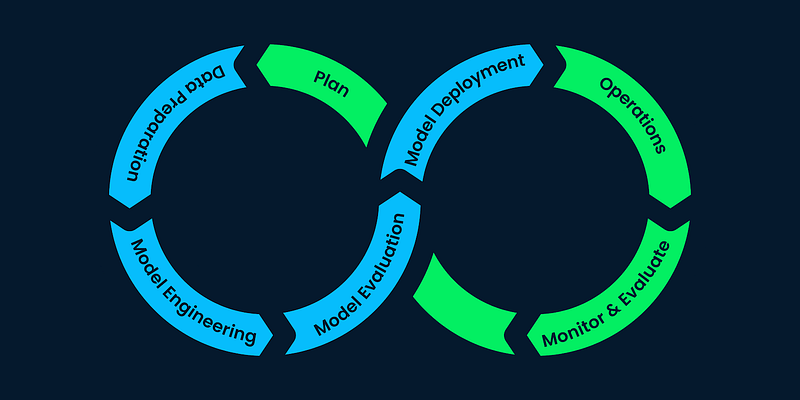
Desarrollo de machine learning de extremo a extremo (Fuente)
La base del machine learning en Databricks Lakehouse AI es la capacidad de entrenar y construir modelos de forma eficiente.
Podemos usar el runtime de Databricks ML, que incluye paquetes como pandas y PySpark, para preparar y limpiar datos. Databricks Feature Store es un repositorio centralizado dentro de la plataforma Databricks Lakehouse AI, diseñado para almacenar, compartir y gestionar características de machine learning.
Este feature store garantiza que las características usadas para entrenar los modelos sean coherentes con las utilizadas durante la inferencia en producción. Además, evitamos malgastar cómputo recalculando una y otra vez las mismas características para distintos casos de uso.
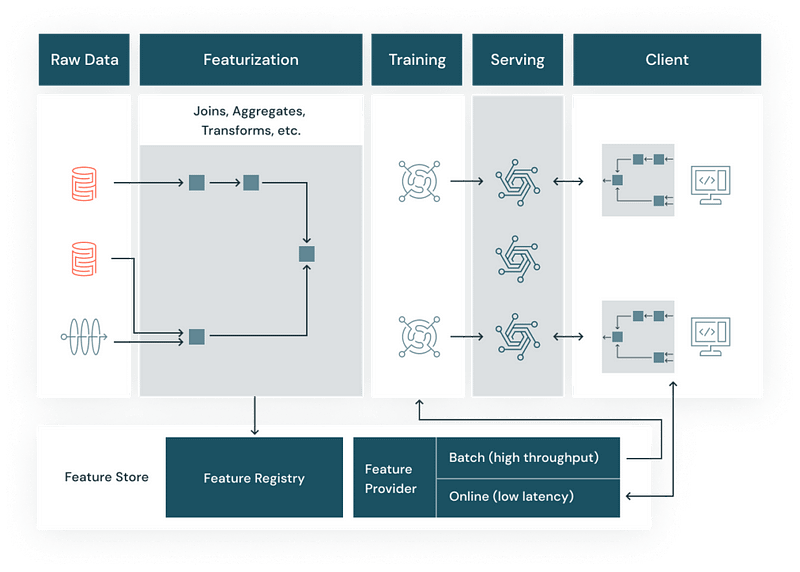
Función de un feature store (Fuente)
Al centralizar la definición y el almacenamiento de características, elimina el problema habitual del "training-serving skew", cuando los datos usados para entrenar difieren de los que el modelo ve en producción.
Para el desarrollo de modelos, tenemos la flexibilidad de elegir entre modelos predefinidos y seleccionados disponibles en el entorno de Databricks o entrenar un modelo a medida adaptado a datos y necesidades de negocio específicas.
Databricks también ofrece clústeres optimizados con GPU, lo que acelera el entrenamiento (y la inferencia) y permite escalar, un factor a menudo crucial para generar insights, predicciones y recomendaciones en tiempo real y a gran escala.
Databricks ha desarrollado una herramienta de código abierto llamada MLflow, disponible de forma nativa en la plataforma, que simplifica el complejo proceso de seguimiento de experimentos, empaquetado de código en ejecuciones reproducibles y compartición de hallazgos.
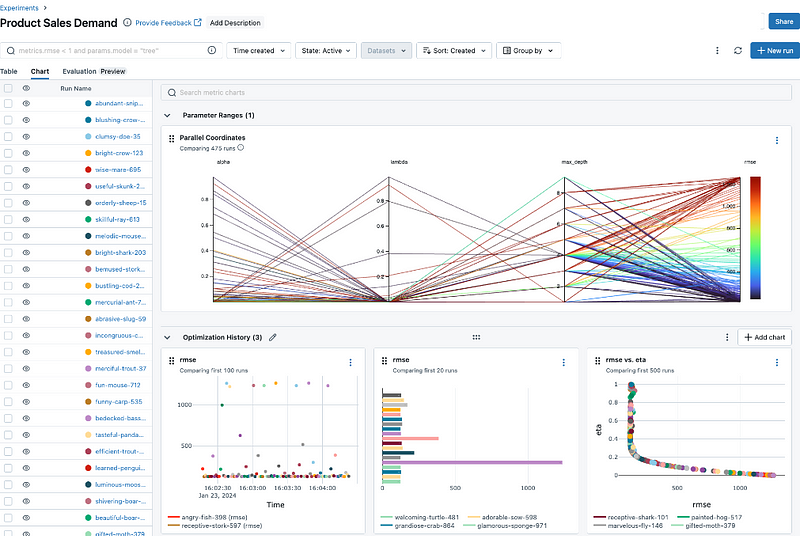
Ejemplo de experimento en MLflow (captura del autor)
Los pasos para crear un marco de experimentación son los siguientes:
Una vez establecido el marco, podemos iterar rápidamente para llegar antes al mejor modelo.
Model Serving, otra función de Databricks Lakehouse AI, agiliza el paso de los modelos desde desarrollo a producción.
Esta funcionalidad permite desplegar modelos como endpoints REST, que se integran fácilmente en aplicaciones y servicios para predicciones en tiempo real o inferencia por lotes.
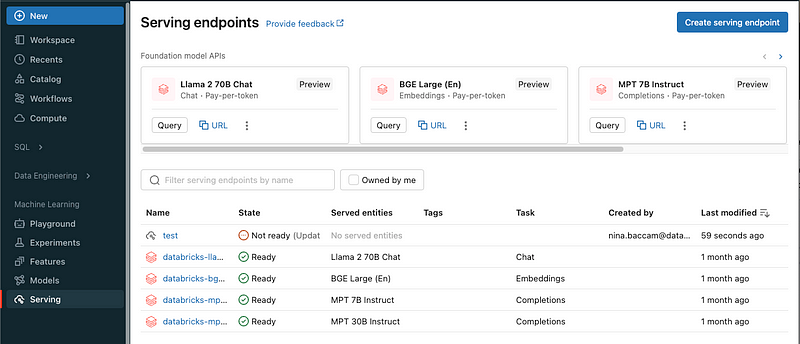
Endpoints de Model Serving (Fuente)
Una vez entrenado un modelo, los data scientists pueden desplegarlo con unos pocos clics, sin necesidad de una gran configuración ni de experiencia en DevOps. Así es como se hace:
Te animamos a seguir estos ejemplos de tutorial detallados de Databricks para ejecutar estos pasos con facilidad. Esta facilidad de despliegue es crucial en los flujos de datos modernos, donde la capacidad de iterar y poner modelos en producción con rapidez puede generar un gran valor de negocio.
Una vez que nuestros modelos están en producción, la última fase clave del ciclo de vida de la IA es la monitorización y evaluación. Consiste en seguir de forma continua el rendimiento del modelo para asegurar que se mantiene eficaz y preciso con el tiempo.
Databricks Lakehouse AI facilita esto mediante Lakehouse Monitoring y las Inference Tables, herramientas esenciales para mantener la salud y eficacia de nuestros sistemas de IA. Como ya vimos las funciones de Lakehouse Monitoring, aquí nos centraremos en las inference tables.
En pocas palabras, la Inference Table es una función adicional, que puedes activar con una casilla, que nos permite capturar los datos de entrada y las predicciones correspondientes de los endpoints de Model Serving y registrarlos en una tabla delta que formará parte de Unity Catalog.
Este mecanismo de logging aporta varios beneficios:
El proceso de desarrollo de machine learning es cíclico: tomamos el feedback de la primera versión en producción y refinamos, reentrenamos y construimos modelos más precisos y eficientes, volviendo así al primer paso.
Este tutorial ha presentado la evolución de Databricks Lakehouse AI y sus funciones clave. También hemos visto cómo estas capacidades se integran mediante una gobernanza unificada. Por último, hemos analizado cómo recorrer el ciclo de vida de machine learning de extremo a extremo usando la plataforma Databricks Lakehouse AI.
Para aprender más sobre Databricks Lakehouse y su aplicación en ingeniería de datos, desarrollo de machine learning y creación de aplicaciones a gran escala de forma práctica, te recomendamos nuestro curso Introduction to Databricks como siguiente paso.
¡Empieza hoy tu camino en IA!
Curso
Curso
Curso
blog
Abid Ali Awan
7 min
blog
Abid Ali Awan
15 min
blog
Adel Nehme
15 min
Tutorial
Zoumana Keita
14 min
Tutorial
Arunn Thevapalan
13 min
Tutorial
Kurtis Pykes
7 min