
Cursus
Generatieve AI-concepten
2 uur
121.1K
Databricks is een van de pioniers in het bouwen van technologieën en platforms die helpen AI‑oplossingen op schaal te leveren, onder meer door het aanjagen van open‑sourceprojecten zoals Apache Spark en MLflow.
Tijdens de Databrick Data + AI Summit 2023 werd Lakehouse AI aangekondigd als ’s werelds eerste AI‑platform dat is ingebouwd in de datalaag — en werden nog veel meer nieuwe features gepresenteerd. Met de lancering van ChatGPT en enorme sprongen in generatieve AI‑technologieën wereldwijd is Lakehouse AI het antwoord van Databricks op het bouwen van generatieve AI‑applicaties via een datacentrische aanpak.
In deze tutorial introduceren we het Databricks Lakehouse AI‑platform, staan we stil bij de betekenis ervan, bespreken we de nieuwe features en hoe je die kunt inzetten in je machine‑learningontwikkelcyclus.
Wacht, Lakehouse? We snappen dat dit misschien allemaal nieuwe termen voor je zijn.
Laten we de evolutie van Databricks Lakehouse AI stap voor stap uit elkaar halen. Om Lakehouse AI te begrijpen — moeten we eerst de Lakehouse‑architectuur goed begrijpen.
Een "Lakehouse" is een moderne data‑architectuur die de flexibiliteit en kostenefficiëntie van een data lake combineert met de data‑managementfeatures van een datawarehouse.
We hebben een complete tutorial over de verschillen tussen het data lake en het datawarehouse, maar kort samengevat betekent het dit:
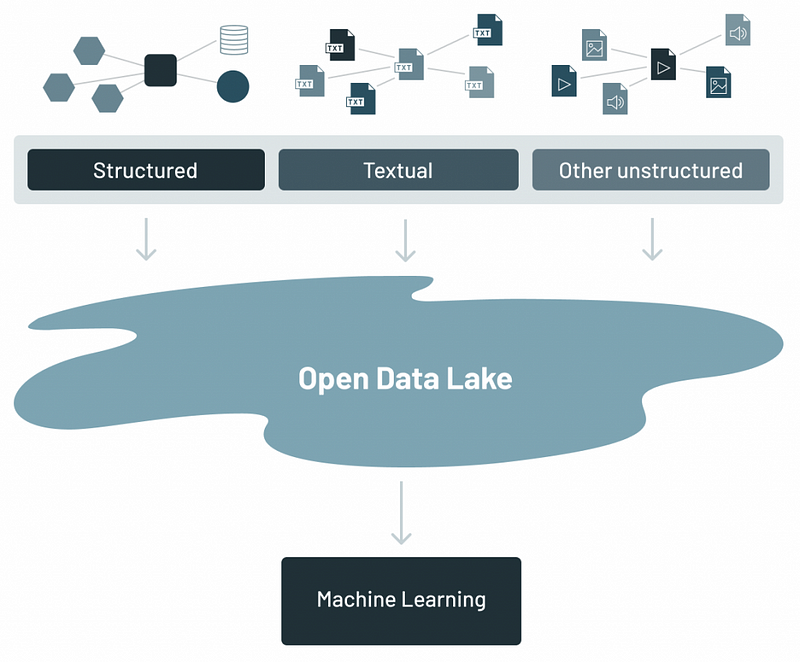
De data‑lake‑architectuur (Bron)
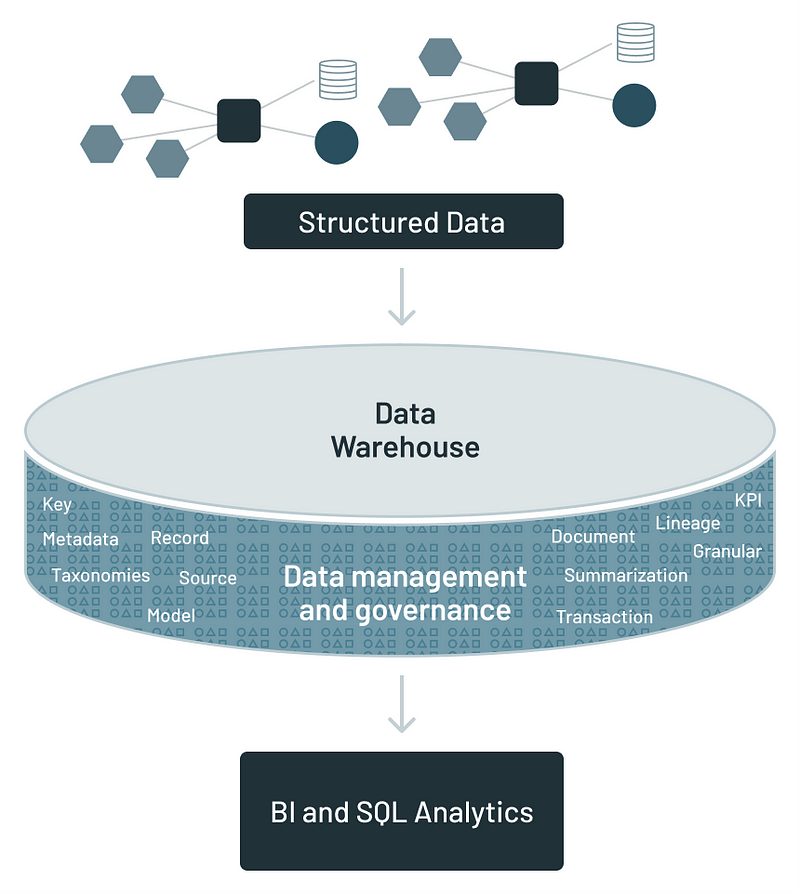
De datawarehouse‑architectuur (Bron)
Data lakes worstelen vaak met datamanagement en governance doordat ze enorme hoeveelheden ruwe, ongestructureerde data opslaan. Dat kan leiden tot "data swamps", waarin data lastig te vinden, te benaderen of te vertrouwen is. Het gebrek aan structuur kan ook de performance van complexe analytische queries belemmeren. Traditionele data lakes ondersteunen transactie‑operaties bovendien slecht en missen ACID‑transactiecapaciteiten, die cruciaal zijn voor dataintegriteit.
Datawarehouses daarentegen zijn geoptimaliseerd voor gestructureerde data en analytics, maar kunnen duur worden om op te schalen naarmate de datavolumes groeien. De eis om data te structureren en in een vooraf gedefinieerd schema te gieten, kan starheid introduceren en maakt het lastiger om snel nieuwe datatypen in te laden en te analyseren.
Deze beperkingen hebben geleid tot de evolutie van de Lakehouse‑architectuur, die het beste van beide werelden wil samenbrengen:
Zo ziet de lakehouse‑architectuur eruit:
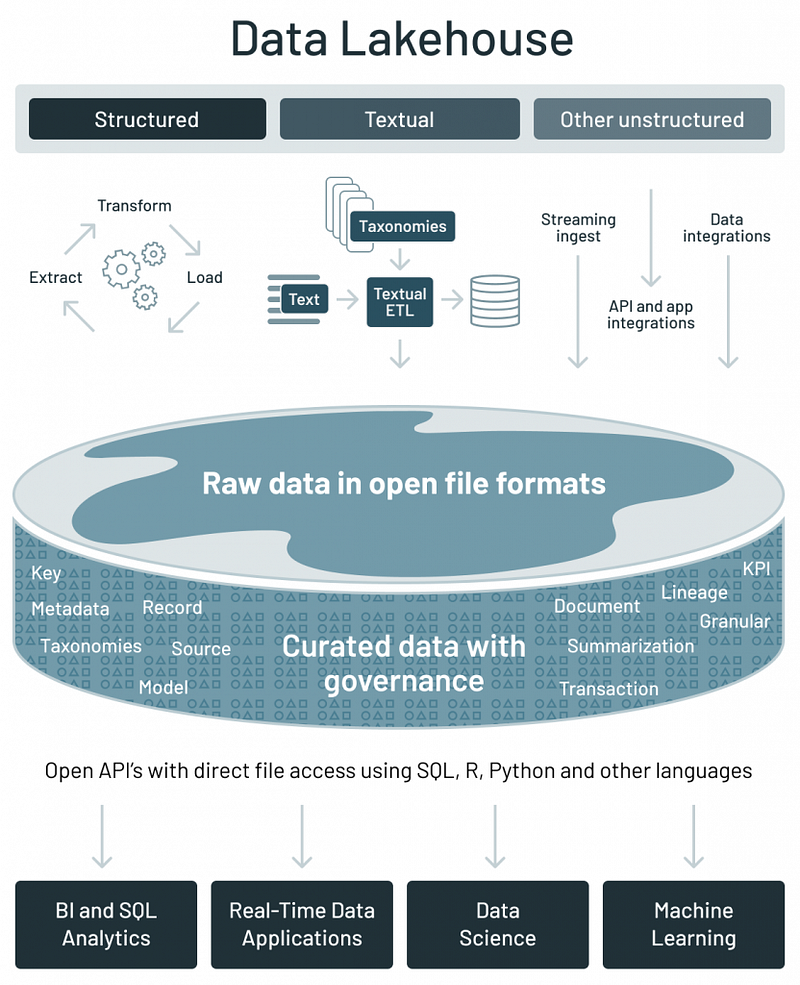
De data‑lakehouse‑architectuur (Bron)
Nu we de evolutie van Databricks Lakehouse begrijpen, komen we bij de hamvraag.
Lakehouse AI is de integratie van kunstmatige intelligentie en machine‑learningcapaciteiten direct in de Lakehouse‑architectuur. Dit betekent dat we AI‑modellen kunnen ontwikkelen, trainen en deployen met gebruik van de grote hoeveelheden data in ons data lake, zonder die data te hoeven verplaatsen of kopiëren naar een aparte verwerkingsomgeving.
De betekenis van dit platform is:
Deze features verklaren waarom Databricks dit platform aankondigde als ’s werelds eerste AI‑platform dat is ingebouwd in de datalaag.
De overstap naar Lakehouse AI is cruciaal geweest om bedrijven meer data‑gedreven en AI‑geïntegreerd te laten werken.
Centraal in deze transformatie staan verschillende kerncomponenten die de ontwikkeling, uitrol en het beheer van AI‑ en machine‑learningmodellen mogelijk maken. Begrijpen waarom en wanneer je deze componenten nodig hebt, helpt organisaties hun data effectiever in te zetten voor AI‑toepassingen.
Vector Search in Databricks Lakehouse AI is een grote stap vooruit (ook gelanceerd op de Data+AI Summit 2023) in het doorzoeken van enorme datasets om semantisch vergelijkbare informatie te vinden, in plaats van te vertrouwen op traditionele zoekwoorden.
Vector Search werkt door data en queries om te zetten in vectoren in een multidimensionale ruimte, embeddings genaamd, afgeleid van een generatief AI‑model. Hierdoor liggen semantisch vergelijkbare woorden of concepten dichter bij elkaar in de n‑dimensionale ruimte, wat relevantere en contextbewuste zoekresultaten oplevert.
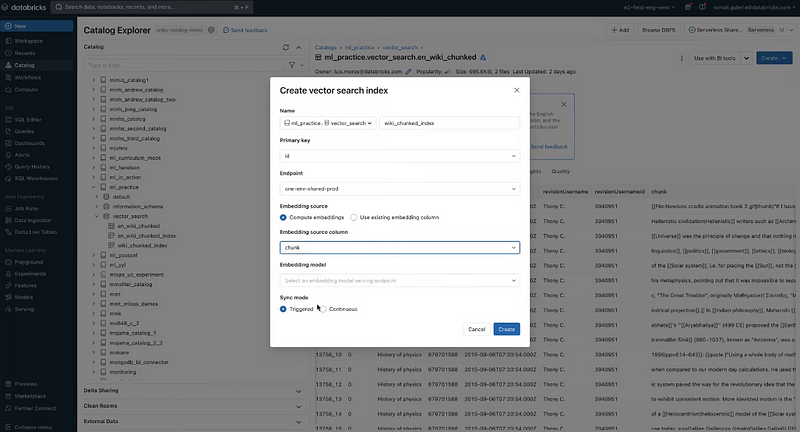
Vector search (schermafbeelding door auteur)
Het proces voor het gebruik van Vector Search (demovideo van Databricks) is als volgt:
Bedrijven zoals Lippert gebruiken Vector Search al om agents te helpen snel antwoorden te vinden op klantvragen door content uit verschillende bronnen in Vector Search te laden.
Deze modellen, beschikbaar in de Databricks Marketplace, zijn geoptimaliseerd voor hoge performance en ontworpen om eenvoudig te integreren in de Lakehouse‑omgeving voor uiteenlopende toepassingen, van tekstanalyse en ‑generatie tot beeldverwerking.
Enkele van de gecureerde generatieve AI‑modellen zijn:
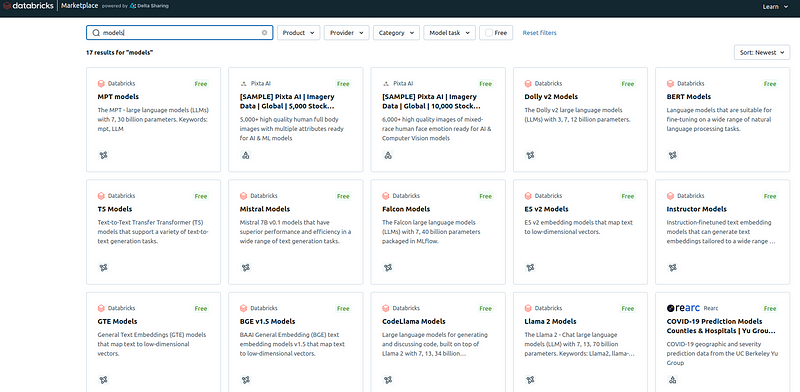
Modellen in Databricks Marketplace (schermafbeelding door auteur)
Deze modellen werken naadloos samen met de bredere set features van Databricks Lakehouse AI, waaronder datamanagement, analytics en MLOps‑tools. Straks zien we hoe je deze modellen kunt gebruiken in machine‑learningontwikkeling.
AutoML (Automated Machine Learning) binnen Databricks Lakehouse AI is ontworpen om het ontwikkelen van machine‑learningmodellen te stroomlijnen en te automatiseren, zodat geavanceerde datascience toegankelijker wordt voor een bredere groep gebruikers, inclusief mensen met beperkte ML‑expertise.
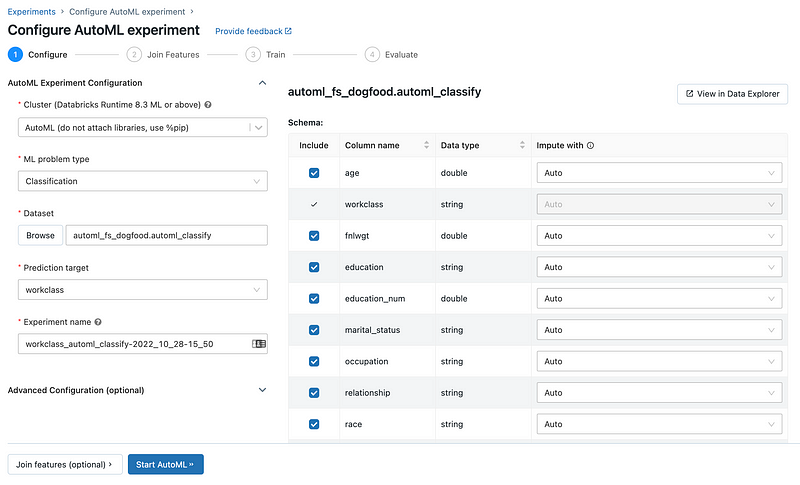
Databrick AutoML (Bron)
Als we de dataset aanleveren en het voorspelde doel specificeren, zorgt AutoML ervoor dat de dataset klaar wordt gemaakt om een model op te trainen. Vervolgens maakt, stemt en evalueert het meerdere modellen via een reeks trials.
Na de evaluatie presenteert AutoML de resultaten en biedt een Python‑notebook met de broncode voor elke trial. Zo kunnen we de code bekijken, reproduceren en naar wens aanpassen. AutoML berekent ook samenvattende statistieken over onze dataset en slaat die informatie op in een notebook voor later gebruik.
Met de nieuwste release biedt AutoML nu het fijn‑afstemmen van generatieve AI‑modellen voor tekstclassificatie en embeddingmodellen met de eigen data van de klant. Dit betekent dat niet‑technische businessgebruikers nu met een paar klikken generatieve AI‑applicaties kunnen bouwen met AutoML.
Databricks Lakehouse Monitoring stelt ons in staat de statistische eigenschappen en kwaliteit van onze datatabellen te monitoren en de performance van machine‑learningmodellen en hun voorspellingen te volgen. Door de dataflow binnen de Databricks‑pipelines te bekijken, helpt deze monitoringfeature om de datakwaliteit en modeleffectiviteit continu te bewaken.
Zo stroomt de data door Lakehouse Monitoring om continue monitoring mogelijk te maken:
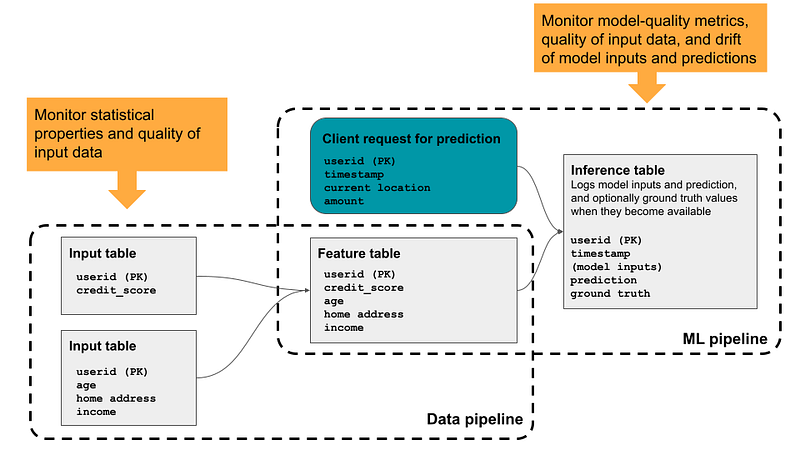
Lakehouse Monitoring‑flow (Bron)
Deze feature gaat verder dan alleen monitoren en biedt ook actiegerichte inzichten in aspecten zoals dataintegriteit, distributie, drift en modelperformance in de tijd.
Laten we nu bekijken hoe al deze features samenkomen als unified governance in Lakehouse AI.
Het idee van unified governance is dat je op één plek toegang hebt tot, controle over, samenwerking aan, monitoring van en actie op data, machine‑learningmodellen en andere AI‑assets. Naarmate een organisatie groeit en volwassen wordt in de AI‑transformatie, is het cruciaal om alles centraal te kunnen beheren.
Databricks Unity Catalog doet precies dat, en door de aanpak voor governance van AI‑assets te verenigen, versnelt het de adoptie van AI terwijl naleving van regelgeving gewaarborgd blijft.
Naast handige features zoals Data Explorer en de mogelijkheid om externe systemen toe te voegen, is de uitblinker het vogelvluchtperspectief op de volledige governance van deze assets via een eenvoudige Unity Catalog Governance Portal, zoals hieronder:
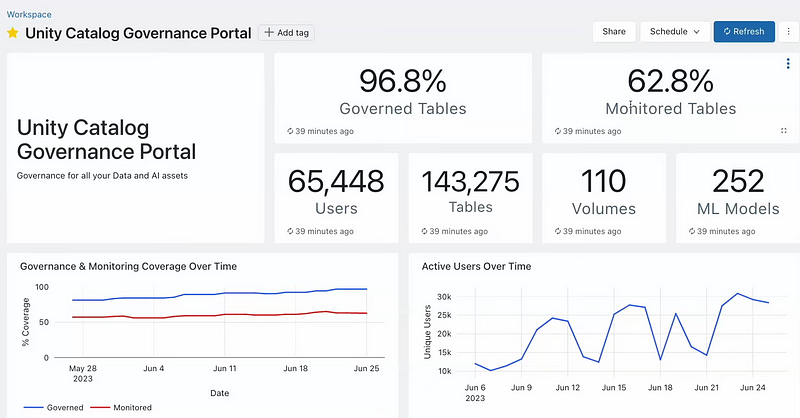
Unity Catalog‑governanceportal (schermafbeelding door auteur)
Deze portal toont kernstatistieken zoals het percentage bestuurde en gemonitorde tabellen, het aantal actieve gebruikers en het aantal tabellen, volumes en ML‑modellen. Dit helikopterview helpt om snel de governancestatus en de actieve betrokkenheid bij data‑assets te beoordelen.
Het dashboard toont ook de activiteiten van gebruikers in de tijd, wat kan helpen te begrijpen hoe data‑assets in de organisatie worden gebruikt en waar eventuele knelpunten of trainingsbehoeften liggen.
Verder geeft de portal potentiële governancerisico’s weer door issues te signaleren, zoals ongemonitorde tabellen of kolommen afgeleid van PII (persoonlijk identificeerbare informatie). Dat biedt een proactieve aanpak voor veilig databeheer, zoals hieronder te zien is.
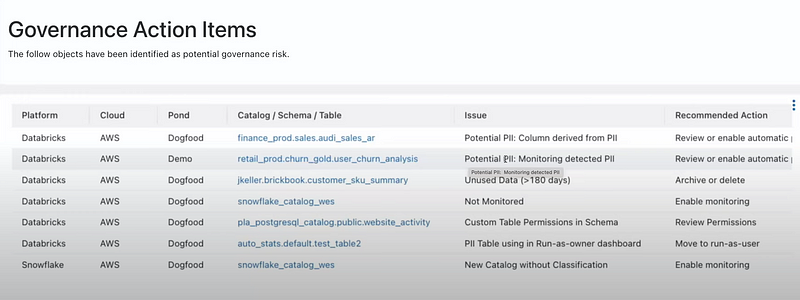
Overzicht van governance‑acties in het Unity Catalog‑dashboard (schermafbeelding door auteur)
Bij elk gesignaleerd issue hoort een aanbevolen actie, die gebruikers helpt mogelijke governanceproblemen op te lossen. Deze feature vereenvoudigt en verenigt het vaak complexe governancetraject van AI‑ en data‑assets op het platform.
Nu we de features van het platform en hun samenhang begrijpen, duiken we in de toepassing voor end‑to‑end machine‑learningontwikkeling.
Voor een opfrisser van de end‑to‑end machine‑learningontwikkelcyclus raden we onze uitgebreide tutorial daarover aan. In deze sectie laten we zien hoe de features van Databricks Lakehouse AI in de cyclus passen.
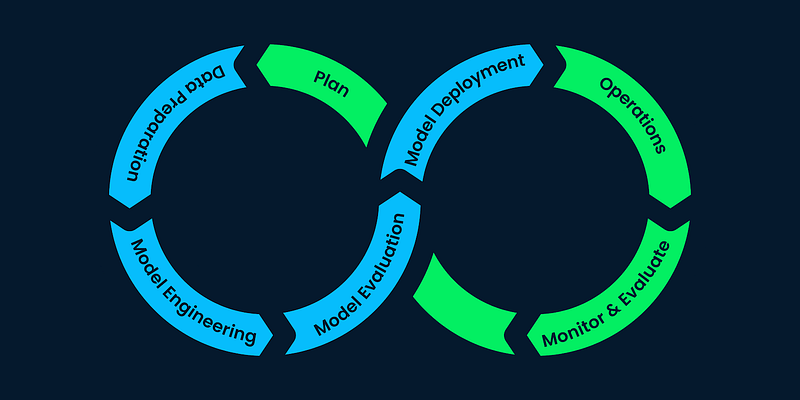
End‑to‑end machine‑learningontwikkeling (Bron)
De basis van machine learning binnen Databricks Lakehouse AI is de mogelijkheid om efficiënt modellen te trainen en te bouwen.
We kunnen de Databricks ML‑runtime gebruiken, die met gangbare pakketten zoals pandas en PySpark komt, voor datavoorbereiding en opschoning. Databricks Feature Store is een centraal repository binnen het Databricks Lakehouse AI‑platform — ontworpen om machine‑learningfeatures op te slaan, te delen en te beheren.
Deze feature store zorgt ervoor dat features die gebruikt worden om modellen te trainen consistent zijn met die tijdens inference in productie. We hoeven ook geen rekenkracht te verspillen door features telkens opnieuw te berekenen voor verschillende use‑cases.
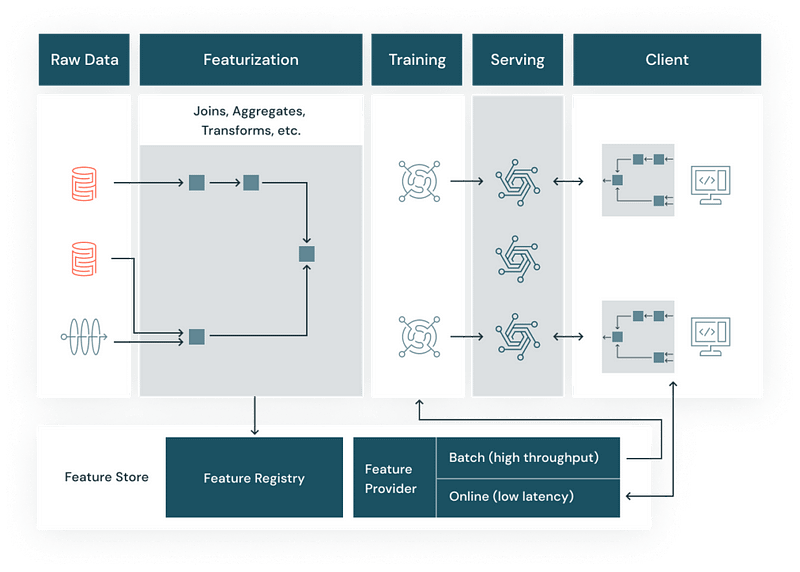
De functie van een feature store (Bron)
Door featuredefinities en opslag te centraliseren, wordt het veelvoorkomende probleem van "training‑serving skew" weggenomen, waarbij de data voor training verschilt van wat het model live tegenkomt.
Voor modelontwikkeling hebben we de flexibiliteit om te kiezen uit vooraf gebouwde gecureerde modellen binnen de Databricks‑omgeving of om een aangepast model te trainen dat is afgestemd op de specifieke data en bedrijfsbehoeften.
Databricks heeft ook GPU‑geoptimaliseerde clusters, wat betekent dat trainen (en inference) sneller en op schaal kan gebeuren. Dat is vaak cruciaal voor realtime inzichten, voorspellingen en aanbevelingen op schaal.
Databricks heeft een open‑sourcetool ontwikkeld genaamd MLflow, die native beschikbaar is op het Databricks‑platform en het complexe proces stroomlijnt van het volgen van experimenten, het verpakken van code in reproduceerbare runs en het delen van bevindingen.
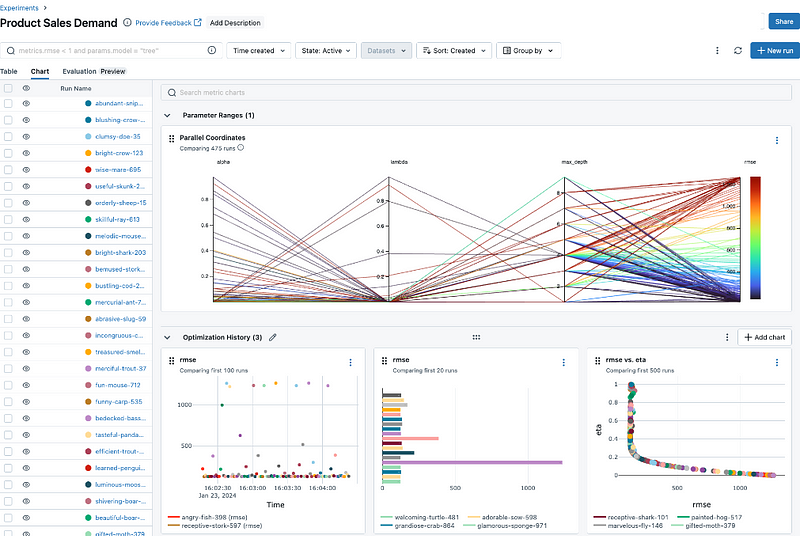
Een voorbeeld van een MLflow‑experiment (schermafbeelding door auteur)
De stappen om een experimentatiekader op te zetten zijn als volgt:
Zodra het kader staat, kunnen we snel itereren om al vroeg bij het beste model uit te komen.
Model Serving, een andere feature binnen Databricks Lakehouse AI, stroomlijnt de overgang van machine‑learningmodellen van ontwikkeling naar een productieklare staat.
Hiermee kunnen modellen worden uitgerold als RESTful endpoints, die eenvoudig zijn te integreren in verschillende applicaties en services voor realtime voorspellingen of batch‑inference.
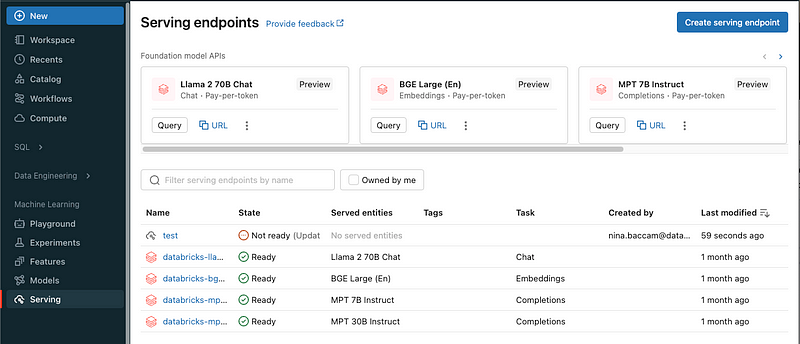
Model Serving‑endpoints (Bron)
Zodra een model is getraind, kunnen data scientists het met een paar klikken deployen, zonder uitgebreide setup of DevOps‑kennis. Zo pak je dit aan:
We raden je aan deze gedetailleerde tutorialvoorbeelden van Databricks door te nemen om deze stappen vlot uit te voeren. Deze eenvoud in deployment is cruciaal in moderne dataworkflows, waar snel itereren en modellen uitrollen veel bedrijfswaarde kan opleveren.
Als onze machine‑learningmodellen in productie staan, is de laatste cruciale fase in de AI‑levenscyclus monitoring en evaluatie. In deze fase volg je continu de performance van het model om te zorgen dat het effectief en accuraat blijft.
Databricks Lakehouse AI faciliteert dit met Lakehouse Monitoring en Inference Tables, essentiële tools om de gezondheid en effectiviteit van onze AI‑systemen te bewaken. Omdat we de features van Lakehouse Monitoring al zagen, focussen we hier op de inference‑tabellen.
Kort gezegd is de Inference Table een extra feature, die je aanzet met een vinkje, waarmee we de inputdata en de bijbehorende voorspellingen van de Model Serving‑endpoints vastleggen in een deltatable, die deel uitmaakt van de Unity Catalog.
Dit logmechanisme heeft meerdere voordelen:
Het machine‑learningontwikkelproces is cyclisch van aard: we nemen de feedback uit de eerste versie in productie en verfijnen, hertrainen en bouwen modellen die nauwkeuriger en efficiënter zijn, waarna we weer bij stap één uitkomen.
Deze tutorial introduceerde de evolutie van Databricks Lakehouse AI en de kernfeatures. We zagen ook hoe deze features samenkomen via unified governance. Vervolgens hebben we geanalyseerd hoe je door de end‑to‑end machine‑learninglevenscyclus navigeert met het Databricks Lakehouse AI‑platform.
Wil je meer leren over Databricks Lakehouse en de toepassing in data‑engineering, machine‑learningontwikkeling en het bouwen van grootschalige applicaties met hands‑on oefeningen? Bekijk dan als volgende stap onze cursus Introduction to Databricks.
Begin vandaag aan je AI-reis!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

