Databricks fait partie des pionniers qui conçoivent des technologies et des plateformes permettant de déployer des solutions d'IA à grande échelle, en soutenant notamment des projets open source tels qu'Apache Spark et MLflow.
Lors du Databricks Data + AI Summit 2023, Lakehouse AI a été présenté comme la première plateforme d'IA au monde, intégrée à la couche de données — et de nombreuses nouvelles fonctionnalités ont été annoncées. Avec le lancement de ChatGPT et les avancées majeures en IA générative partout dans le monde, Lakehouse AI est la réponse de Databricks pour créer des applications d'IA générative via une approche centrée sur les données.
Dans ce tutoriel, nous allons présenter la plateforme Databricks Lakehouse AI, expliquer son importance, découvrir les nouvelles fonctionnalités lancées et voir comment les utiliser tout au long du cycle de développement du machine learning.
Qu'est-ce que Databricks Lakehouse AI ?
Lakehouse ? Ces termes peuvent vous sembler nouveaux.
Décomposons pas à pas l'évolution de Databricks Lakehouse AI. Pour comprendre Lakehouse AI, il faut d'abord bien maîtriser l'architecture Lakehouse.
Qu'est-ce qu'un Lakehouse ?
Un « Lakehouse » est une architecture moderne de gestion des données qui combine la flexibilité et l'efficacité économique d'un data lake avec les fonctionnalités de gestion de données d'un data warehouse.
Nous avons un tutoriel complet sur les différences entre data lakes et data warehouses. En bref :
- Data lake : un référentiel de stockage capable de conserver une très grande quantité de données brutes dans leur format natif jusqu'au moment où l'on en a besoin. C'est comme un grand conteneur où l'on déverse toutes ses données, structurées (comme des tables de base de données) ou non structurées (texte, images, etc.), sans se soucier d'une organisation préalable.
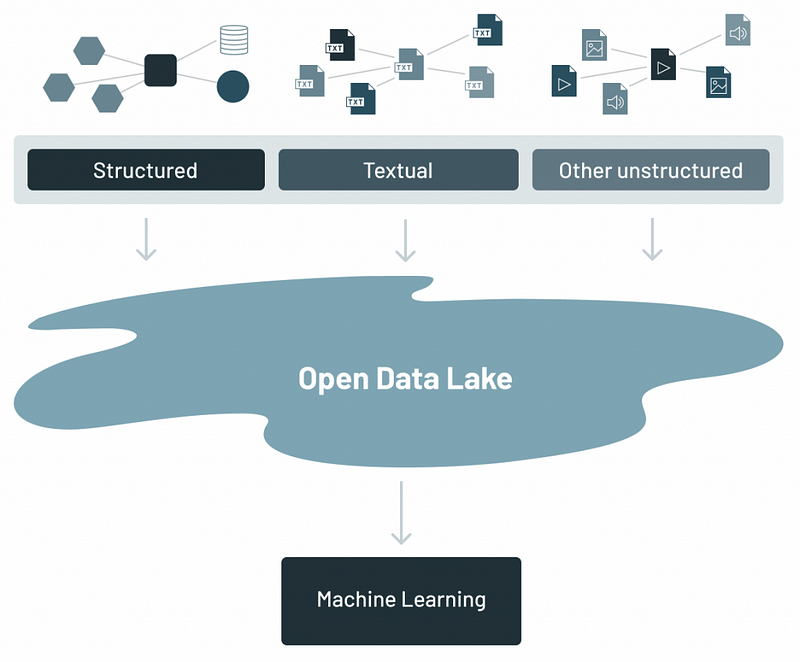
L'architecture du data lake (Source)
- Data warehouse : un système conçu pour le reporting et l'analyse, où les données sont structurées, traitées et stockées de façon à être facilement interrogées et analysées. C'est comme une bibliothèque où les ouvrages sont soigneusement classés et catalogués pour un accès rapide.
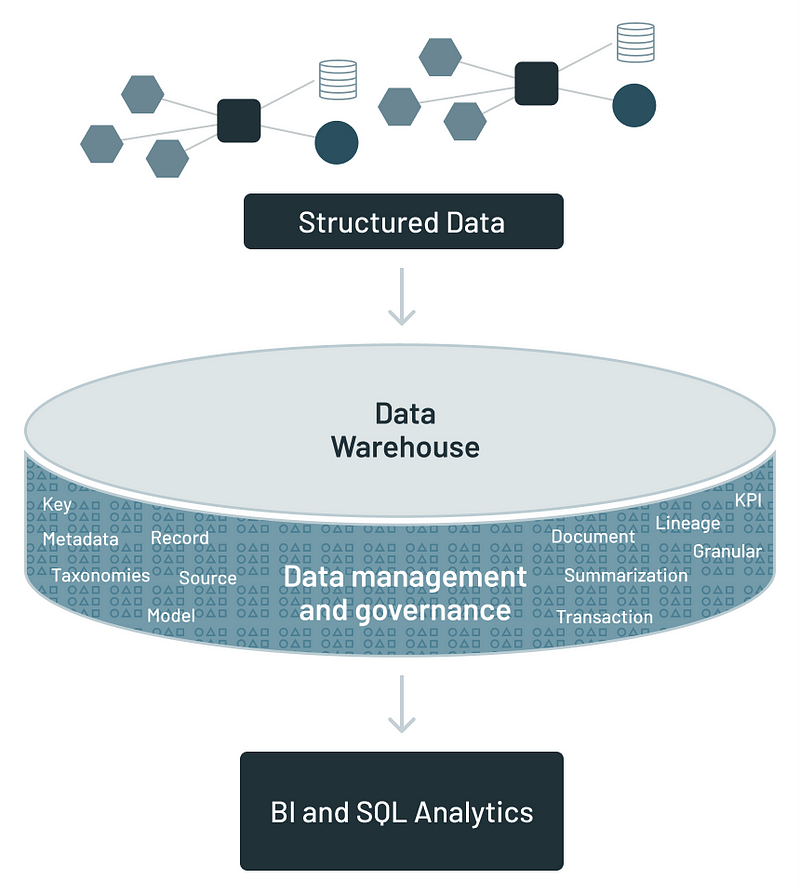
L'architecture du data warehouse (Source)
Les data lakes rencontrent souvent des difficultés de gestion et de gouvernance, car ils stockent d'énormes volumes de données brutes et non structurées. Ils peuvent alors se transformer en « marécages de données », où il devient difficile de trouver, d'accéder ou de faire confiance aux données. L'absence de structure peut aussi pénaliser les requêtes analytiques complexes, et les data lakes traditionnels gèrent mal les opérations transactionnelles, faute de capacités ACID, pourtant essentielles pour garantir l'intégrité des données.
Les data warehouses, à l'inverse, sont optimisés pour les données structurées et l'analytique, mais leur mise à l'échelle peut devenir très coûteuse à mesure que les volumes augmentent. Le besoin de structurer les données selon un schéma prédéfini introduit de la rigidité, ce qui limite l'ingestion et l'analyse rapides de nouveaux types de données.
Ces limites ont conduit à l'émergence de l'architecture Lakehouse, qui vise à réunir le meilleur des deux mondes :
- Permettre de stocker à faible coût d'immenses quantités de données brutes (comme un data lake).
- Offrir des analyses complexes efficaces et une gestion robuste avec gouvernance et fiabilité (comme un data warehouse).
Voici à quoi ressemble l'architecture lakehouse :
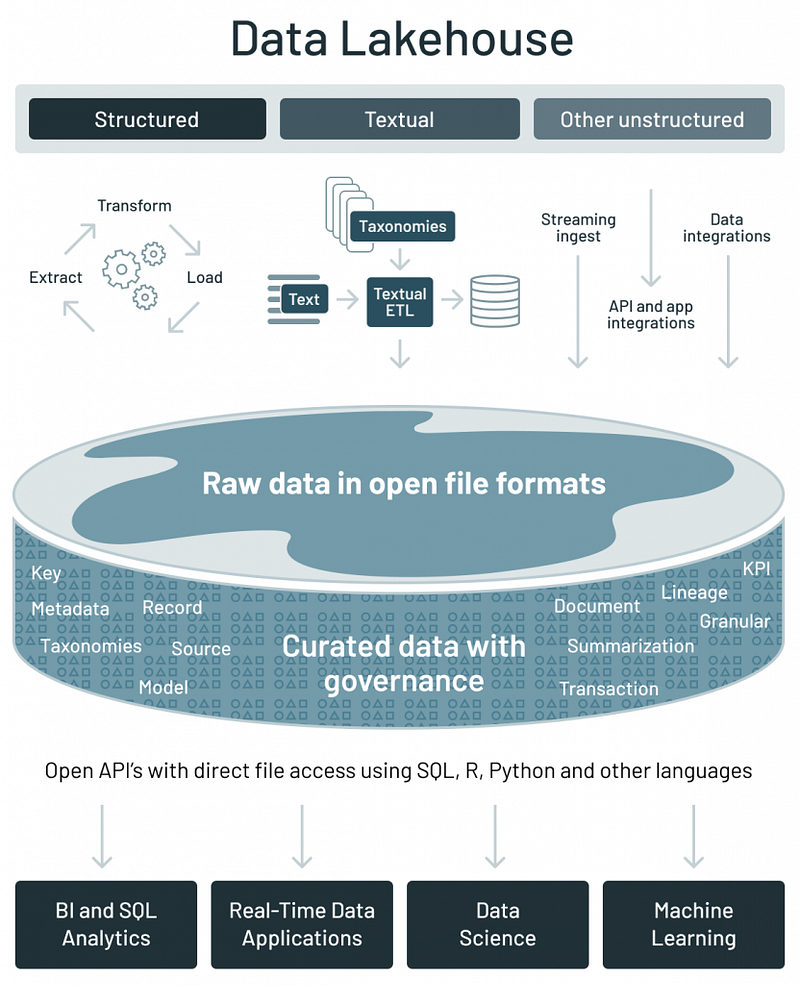
L'architecture du data lakehouse (Source)
Maintenant que nous comprenons l'évolution de Databricks Lakehouse, passons à la question clé.
Qu'est-ce que Lakehouse AI ?
Lakehouse AI désigne l'intégration de capacités d'intelligence artificielle et de machine learning directement au sein de l'architecture Lakehouse. Concrètement, nous pouvons développer, entraîner et déployer des modèles d'IA en s'appuyant sur les vastes volumes de données stockées dans le data lake, sans devoir déplacer ou copier ces données vers un autre environnement de traitement.
L'importance de cette plateforme tient à :
- Un accès direct aux données : les modèles d'IA peuvent être entraînés sur des jeux de données plus complets, pour des résultats potentiellement plus précis et plus pertinents.
- Une architecture simplifiée : en réduisant le besoin de systèmes distincts pour le stockage et le traitement IA, on diminue la complexité et les coûts de gestion de l'infrastructure data.
- Des insights en temps réel : le traitement temps réel des données pour les applications d'IA permet aux entreprises de prendre des décisions plus rapides, fondées sur les données.
Ces atouts expliquent pourquoi Databricks a présenté cette plateforme comme la première plateforme d'IA intégrée à la couche de données.
Composants clés de Lakehouse AI
La transition vers Lakehouse AI a joué un rôle déterminant pour orienter les entreprises vers des opérations plus « data-driven » et intégrant l'IA.
Au cœur de cette transformation, plusieurs composants facilitent le développement, le déploiement et la gestion des modèles d'IA et de machine learning. Comprendre pourquoi et quand les utiliser aide les organisations à mieux exploiter leurs données pour des cas d'usage IA.
Vector Search
Vector Search dans Databricks Lakehouse AI représente une avancée majeure (également annoncée lors du Data + AI Summit 2023) pour explorer d'immenses jeux de données et y rechercher des informations proches sémantiquement, plutôt que de se limiter à des correspondances par mots-clés.
Vector Search fonctionne en convertissant les données et les requêtes en vecteurs dans un espace multidimensionnel appelé « embeddings », dérivés d'un modèle d'IA générative. Les mots ou concepts sémantiquement similaires se trouvent plus proches dans cet espace n-dimensionnel, ce qui fournit des résultats de recherche plus pertinents et contextuels.
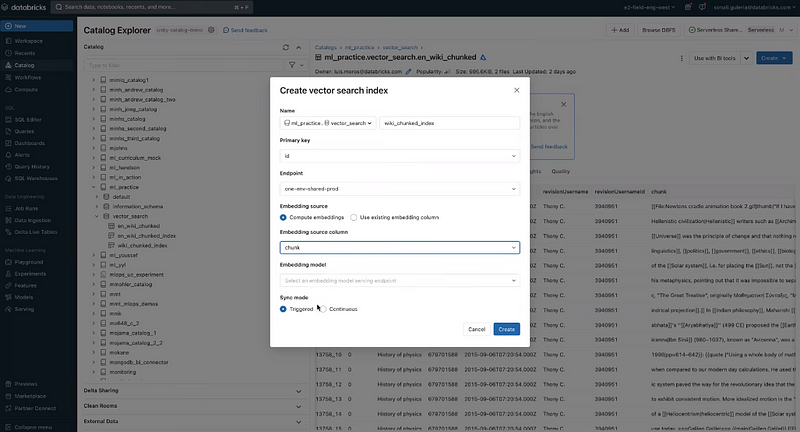
Vector search (Capture d'écran par l'auteur)
Le processus d'utilisation de Vector Search (vidéo de démonstration par Databricks) est le suivant :
- Créer un endpoint et un index de recherche vectorielle.
- Ingestion de segments de données en entrée, puis projection dans un espace N-dimensionnel représenté par un vecteur d'embedding.
- Stockage de ces vecteurs dans une base de données vectorielle afin d'appliquer des algorithmes de recherche de plus proches voisins, rapides et extensibles, pour trouver des vecteurs similaires.
Des entreprises comme Lippert utilisent déjà Vector Search pour aider les agents à répondre rapidement aux demandes clients, en important des contenus issus de multiples sources.
Curated Models
Ces modèles, disponibles dans le Databricks Marketplace, sont optimisés pour de hautes performances et conçus pour s'intégrer facilement à l'environnement Lakehouse, pour des cas d'usage allant de l'analyse et la génération de texte au traitement d'images.
Parmi les modèles d'IA générative « curated » figurent :
- MPT-7B et Falcon-7B : des modèles respectivement spécialisés dans le suivi d'instructions et la synthèse, adaptés aux tâches nécessitant la compréhension et la génération de texte naturel à partir d'instructions, ou le résumé de longs documents en synthèses concises et informatives.
- Stable Diffusion : un modèle de génération d'images reconnu pour sa capacité à créer des visuels de haute qualité à partir de descriptions textuelles, ouvrant un large éventail d'applications créatives et analytiques dans le cadre de Lakehouse AI. Consultez notre tutoriel Stable Diffusion pour en savoir plus.
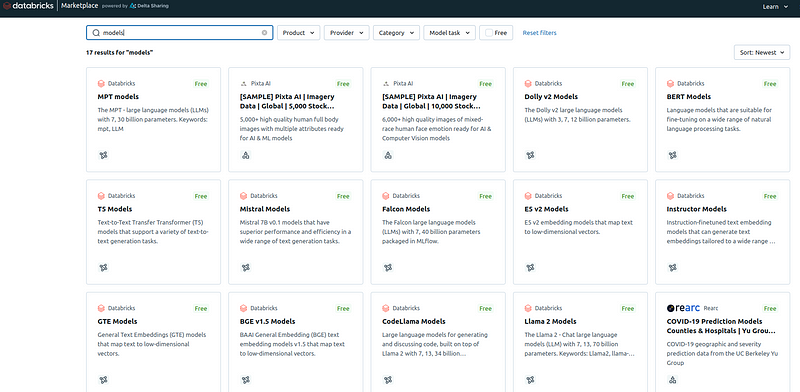
Modèles disponibles dans le Databricks Marketplace (Capture d'écran par l'auteur)
Ces modèles s'articulent parfaitement avec l'ensemble des fonctionnalités de Databricks Lakehouse AI, y compris la gestion des données, l'analytique et les outils MLOps. Nous verrons dans un instant comment les utiliser dans le développement de modèles.
AutoML
Les fonctionnalités AutoML (Automated Machine Learning) de Databricks Lakehouse AI simplifient et automatisent la création de modèles, rendant la data science avancée accessible à un public plus large, y compris aux utilisateurs ayant peu d'expérience en machine learning.
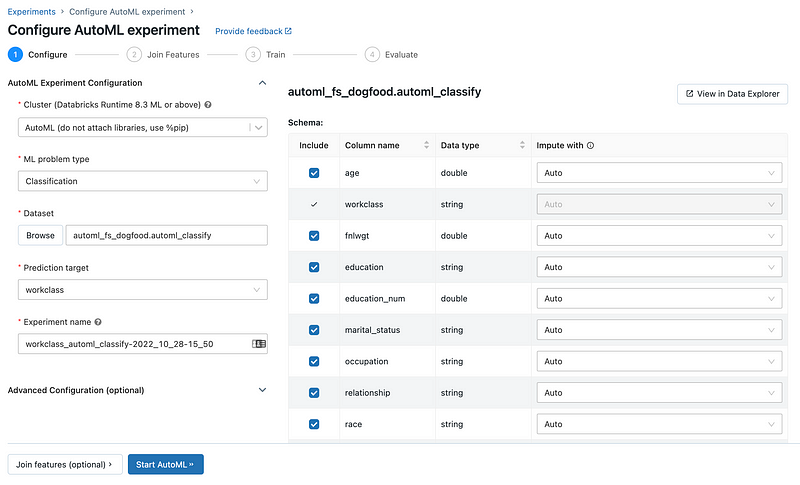
Databricks AutoML (Source)
En fournissant le jeu de données et l'objectif de prédiction, AutoML se charge de préparer les données pour l'entraînement. Il crée ensuite, ajuste et évalue plusieurs modèles au fil d'essais successifs.
Une fois l'évaluation terminée, AutoML présente les résultats et met à disposition un notebook Python contenant le code source de chaque essai. Nous pouvons ainsi revoir, reproduire et modifier le code si besoin. AutoML calcule également des statistiques descriptives sur le jeu de données et les enregistre dans un notebook pour référence ultérieure.
Avec la dernière version, AutoML permet désormais d'affiner des modèles d'IA générative pour la classification de texte et des modèles d'embedding avec les données propres aux clients. Autrement dit, des utilisateurs métier non techniques peuvent construire des applications d'IA générative en quelques clics.
Lakehouse Monitoring
Databricks Lakehouse Monitoring nous permet de surveiller les propriétés statistiques et la qualité de nos tables de données, ainsi que de suivre les performances des modèles de machine learning et de leurs prédictions. En observant les flux de données dans les pipelines Databricks, ce module aide à garantir un suivi continu de la qualité des données et de l'efficacité des modèles.
Voici comment les données circulent dans Lakehouse Monitoring pour permettre cette surveillance continue :
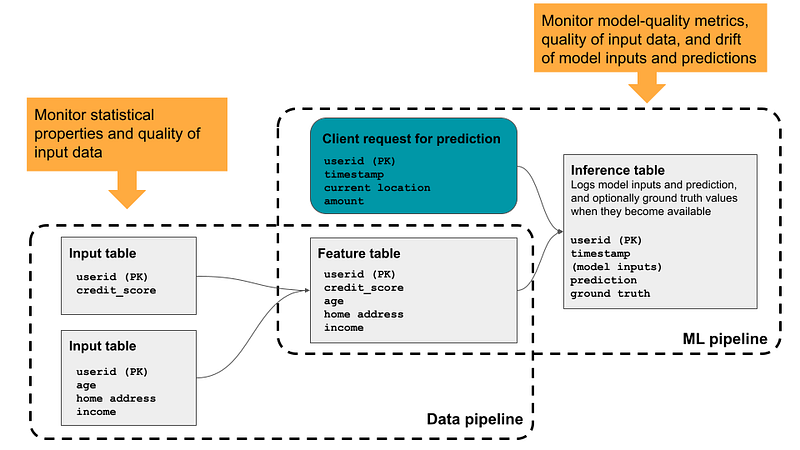
Flux de Lakehouse Monitoring (Source)
Au-delà du simple monitoring, cette fonctionnalité fournit des insights actionnables sur l'intégrité des données, les distributions, les dérives et les performances des modèles dans le temps.
Voyons maintenant comment toutes ces fonctionnalités se rejoignent dans une gouvernance unifiée au sein de Lakehouse AI.
Le rôle de la gouvernance unifiée dans Lakehouse AI
La gouvernance unifiée consiste à pouvoir accéder, contrôler, collaborer, superviser et agir sur les données, les modèles de machine learning et les autres actifs d'IA depuis un même endroit. À mesure qu'une organisation progresse dans sa transformation IA, la centralisation de la gestion devient essentielle.
Databricks Unity Catalog répond à cet enjeu : en unifiant l'approche de gouvernance des actifs d'IA, il accélère l'adoption de l'IA tout en garantissant la conformité réglementaire.
Au-delà d'outils utiles comme l'explorateur de données et la connexion à des systèmes externes, la fonctionnalité phare est la vue d'ensemble de la gouvernance via un portail Unity Catalog simple, illustré ci-dessous :
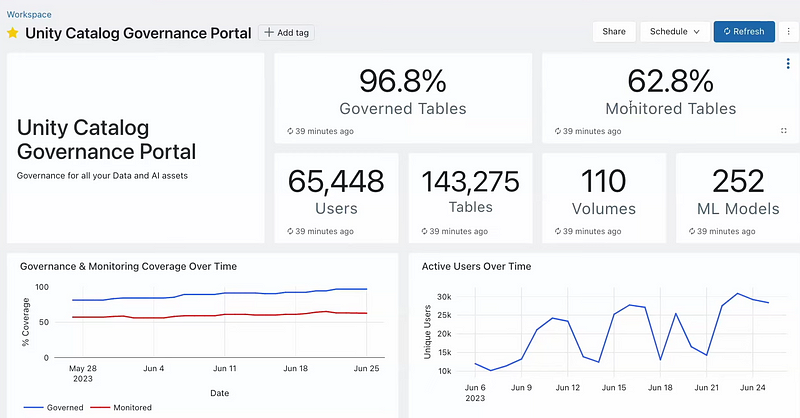
Portail de gouvernance Unity Catalog (Capture d'écran par l'auteur)
Ce portail affiche des indicateurs clés comme le pourcentage de tables gouvernées et monitorées, le nombre d'utilisateurs actifs, ainsi que le volume de tables, de volumes et de modèles ML. Cette vue d'ensemble permet d'évaluer rapidement l'état de la gouvernance et l'engagement autour des actifs data.
Le tableau de bord montre aussi l'activité des utilisateurs dans le temps, utile pour comprendre l'usage des actifs data et identifier des goulets d'étranglement ou des besoins de formation.
En outre, le portail recense les risques potentiels de gouvernance, en signalant par exemple des tables non surveillées ou des colonnes dérivées de données personnelles (PII), ce qui favorise une gestion proactive et sécurisée des données, comme ci-dessous.
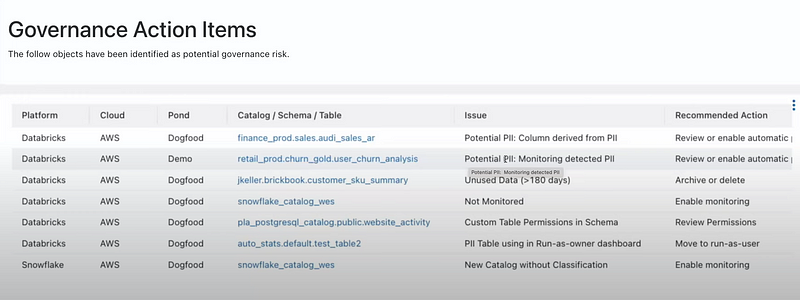
Vue des actions de gouvernance dans le tableau de bord Unity Catalog (Capture d'écran par l'auteur)
Chaque problème identifié s'accompagne d'une recommandation d'action, guidant les utilisateurs vers la résolution. Cette fonctionnalité simplifie et unifie un processus de gouvernance souvent complexe des actifs IA et data sur l'ensemble de la plateforme.
Maintenant que nous avons vu les fonctionnalités et leur articulation, passons à l'application au développement de bout en bout en machine learning.
Développement machine learning de bout en bout sur Databricks Lakehouse AI
Pour un rappel sur le cycle de développement du machine learning, consultez notre tutoriel détaillé. Dans cette section, nous verrons comment les fonctionnalités de Databricks Lakehouse AI s'intègrent dans ce cycle.
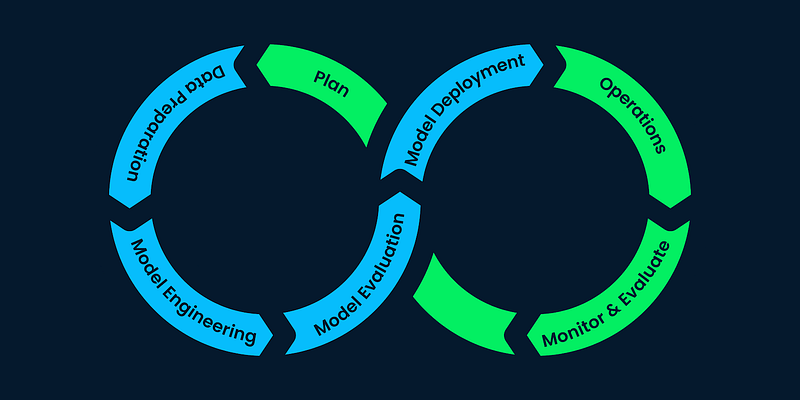
Développement machine learning de bout en bout (Source)
1. Préparation des données et feature engineering
La base du machine learning dans Databricks Lakehouse AI, c'est la capacité à entraîner et construire des modèles efficacement.
Nous pouvons utiliser le runtime Databricks ML, qui inclut des bibliothèques courantes telles que pandas et PySpark, pour préparer et nettoyer les données. Databricks Feature Store est un référentiel centralisé au sein de la plateforme Databricks Lakehouse AI, conçu pour stocker, partager et gérer les features de machine learning.
Le Feature Store garantit la cohérence entre les features utilisées à l'entraînement et celles utilisées en production lors de l'inférence. Il évite aussi de gaspiller des ressources en recalculant sans cesse les même features pour différents cas d'usage.
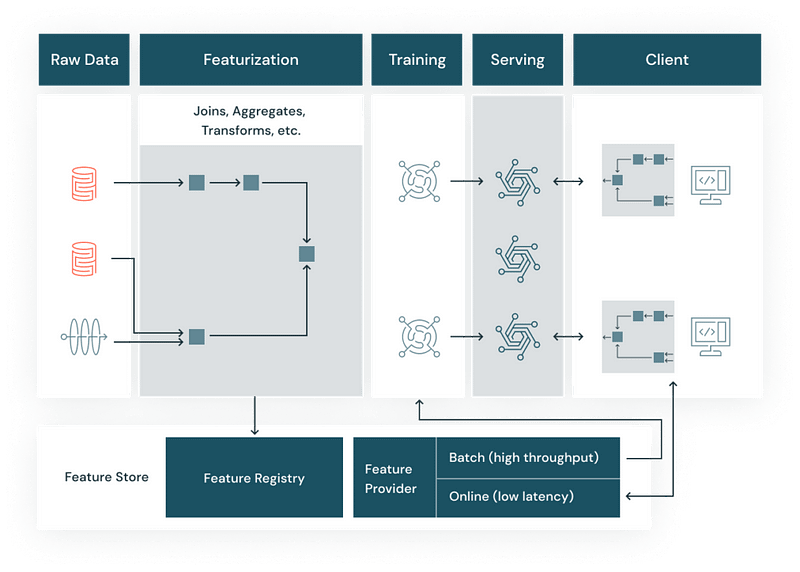
Rôle d'un feature store (Source)
En centralisant la définition et le stockage des features, il élimine le problème classique du « training-serving skew », lorsque les données d'entraînement diffèrent de celles rencontrées en production.
2. Conception des modèles
Pour développer les modèles, nous pouvons soit utiliser des modèles préconfigurés disponibles dans l'environnement Databricks, soit entraîner un modèle sur mesure adapté à nos données et besoins métier.
- Exploiter des modèles existants : comme vu plus haut, nous pouvons choisir des modèles préentraînés sur de vastes jeux de données via le Databricks Marketplace. Des notebooks d'exemple accompagnent ces modèles, ce qui facilite leur prise en main.
- Entraîner de nouveaux modèles : pour des solutions spécifiques, nous pouvons utiliser le runtime ML, qui inclut des frameworks et langages de machine learning tels que TensorFlow, PyTorch et Scikit-learn. L'entraînement est facilité par les notebooks collaboratifs de Databricks, un environnement interactif où, en tant que data scientists, nous écrivons du code, analysons des données et partageons nos analyses.
Databricks propose aussi des clusters optimisés GPU, ce qui accélère l'entraînement (et l'inférence) et facilite le passage à l'échelle — un atout crucial pour fournir en temps voulu des insights, des prédictions et des recommandations.
3. Évaluation et expérimentation
Databricks a développé un outil open source appelé MLflow, nativement disponible sur la plateforme, qui simplifie le suivi des expériences, l'empaquetage du code en exécutions reproductibles et le partage des résultats.
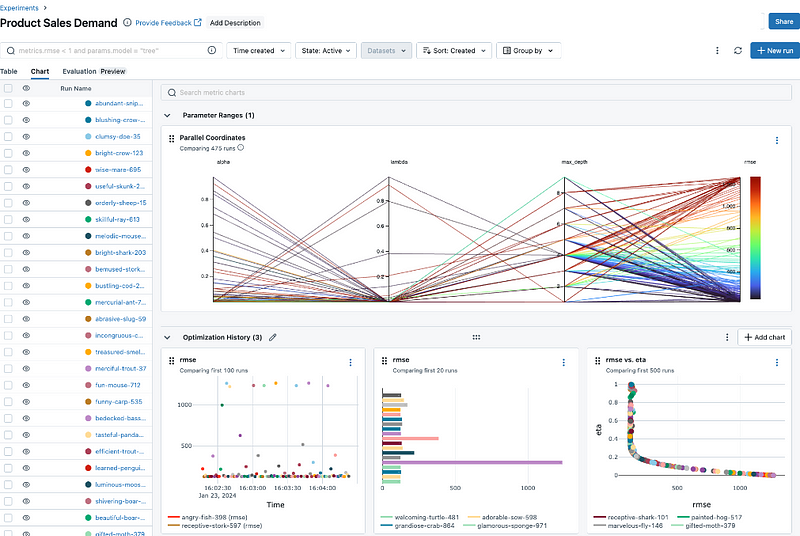
Exemple d'expérience MLflow (Capture d'écran par l'auteur)
La mise en place d'un cadre d'expérimentation comprend les étapes suivantes :
- Installer MLflow et définir l'URI de tracking
- Créer une expérience
- Démarrer un run MLflow et journaliser paramètres, métriques et artefacts
- Créer plusieurs runs sous la même expérience pour le réglage d'hyperparamètres et autres améliorations
- Examiner les résultats des runs de l'expérience
- Sélectionner le meilleur modèle et le faire passer en production
Une fois le cadre en place, nous pouvons itérer rapidement pour converger plus tôt vers le meilleur modèle.
4. Déploiement des modèles et MLOps
Model Serving, une autre fonctionnalité de Databricks Lakehouse AI, fluidifie le passage des modèles du développement à la production.
Les modèles peuvent être exposés en endpoints REST, facilement intégrables dans diverses applications et services pour des prédictions en temps réel ou par lots.
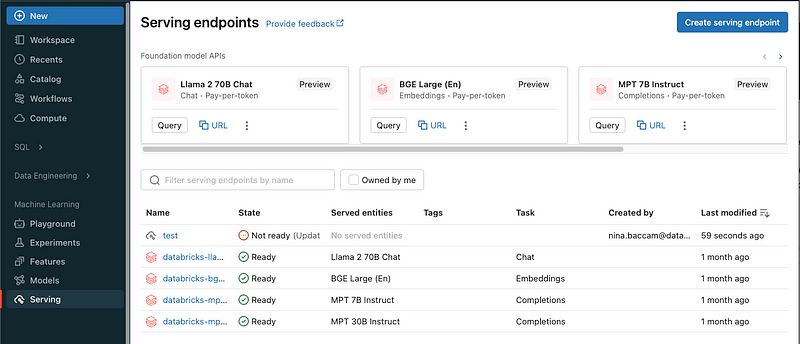
Endpoints Model Serving (Source)
Une fois le modèle entraîné, les data scientists peuvent le déployer en quelques clics, sans configuration lourde ni expertise DevOps. Pour ce faire :
- Journaliser les modèles dans le registre de modèles (une fonctionnalité de MLflow)
- Utiliser l'interface Serving pour créer un endpoint pour le modèle sélectionné
- Interroger l'endpoint créé
Nous vous recommandons de suivre ces exemples de tutoriels détaillés de Databricks pour exécuter ces étapes sereinement. Cette facilité de déploiement est cruciale dans les workflows data modernes, où la capacité à itérer et déployer rapidement crée une véritable valeur métier.
5. Supervision et évaluation
Une fois les modèles déployés en production, la dernière phase essentielle du cycle de vie de l'IA consiste à les superviser et les évaluer en continu, afin de garantir leur efficacité et leur précision dans le temps.
Databricks Lakehouse AI s'appuie pour cela sur Lakehouse Monitoring et les Inference Tables, deux outils essentiels pour maintenir la santé et l'efficacité des systèmes d'IA. Comme nous avons déjà présenté Lakehouse Monitoring, concentrons-nous ici sur les Inference Tables.
En bref, l'Inference Table est une option supplémentaire, activable par une case à cocher, qui permet de capturer les données d'entrée et les prédictions correspondantes issues des endpoints Model Serving, puis de les journaliser dans une table Delta intégrée à Unity Catalog.
Ce mécanisme de journalisation présente plusieurs avantages :
- Détection de la dérive des modèles : avec le temps, les données rencontrées en production peuvent s'éloigner de celles ayant servi à l'entraînement. Les Inference Tables aident à détecter cette dérive en surveillant en continu les caractéristiques des données entrantes et en les comparant au jeu d'entraînement. Elles fonctionnent de concert avec le tableau de bord Lakehouse Monitoring.
- Débogage et analyse des causes racines : si les prédictions d'un modèle déçoivent, les Inference Tables fournissent les données granulaires nécessaires pour comprendre l'origine du problème. En examinant les entrées ayant conduit à un résultat insatisfaisant, les data scientists peuvent déboguer et affiner leurs modèles plus efficacement.
- Conformité réglementaire et audit : dans les secteurs très réglementés (finance, santé, etc.), les Inference Tables offrent une traçabilité transparente du processus décisionnel du modèle, utile pour expliquer les décisions aux parties prenantes ou aux autorités.
Le développement en machine learning est cyclique : on recueille les retours de la première version en production, puis l'on affine, réentraîne et construit des modèles plus précis et plus efficients, ce qui nous ramène au premier stade.
Conclusion
Ce tutoriel a présenté l'évolution de Databricks Lakehouse AI et ses fonctionnalités clés. Nous avons également vu comment elles s'articulent via une gouvernance unifiée. Enfin, nous avons analysé la manière de parcourir le cycle de développement de bout en bout en s'appuyant sur la plateforme Databricks Lakehouse AI.
Pour approfondir Databricks Lakehouse et ses applications en data engineering, en développement de machine learning et en création d'applications à grande échelle, nous vous recommandons de suivre notre Introduction to Databricks comme prochaine étape.


 Kurtis Pykes · 15 min







Databricks fait partie des pionniers qui conçoivent des technologies et des plateformes permettant de déployer des solutions d'IA à grande échelle, en soutenant notamment des projets open source tels qu'Apache Spark et MLflow.
Lors du Databricks Data + AI Summit 2023, Lakehouse AI a été présenté comme la première plateforme d'IA au monde, intégrée à la couche de données — et de nombreuses nouvelles fonctionnalités ont été annoncées. Avec le lancement de ChatGPT et les avancées majeures en IA générative partout dans le monde, Lakehouse AI est la réponse de Databricks pour créer des applications d'IA générative via une approche centrée sur les données.
Dans ce tutoriel, nous allons présenter la plateforme Databricks Lakehouse AI, expliquer son importance, découvrir les nouvelles fonctionnalités lancées et voir comment les utiliser tout au long du cycle de développement du machine learning.
Qu'est-ce que Databricks Lakehouse AI ?
Lakehouse ? Ces termes peuvent vous sembler nouveaux.
Décomposons pas à pas l'évolution de Databricks Lakehouse AI. Pour comprendre Lakehouse AI, il faut d'abord bien maîtriser l'architecture Lakehouse.
Qu'est-ce qu'un Lakehouse ?
Un « Lakehouse » est une architecture moderne de gestion des données qui combine la flexibilité et l'efficacité économique d'un data lake avec les fonctionnalités de gestion de données d'un data warehouse.
Nous avons un tutoriel complet sur les différences entre data lakes et data warehouses. En bref :
L'architecture du data lake (Source)
L'architecture du data warehouse (Source)
Les data lakes rencontrent souvent des difficultés de gestion et de gouvernance, car ils stockent d'énormes volumes de données brutes et non structurées. Ils peuvent alors se transformer en « marécages de données », où il devient difficile de trouver, d'accéder ou de faire confiance aux données. L'absence de structure peut aussi pénaliser les requêtes analytiques complexes, et les data lakes traditionnels gèrent mal les opérations transactionnelles, faute de capacités ACID, pourtant essentielles pour garantir l'intégrité des données.
Les data warehouses, à l'inverse, sont optimisés pour les données structurées et l'analytique, mais leur mise à l'échelle peut devenir très coûteuse à mesure que les volumes augmentent. Le besoin de structurer les données selon un schéma prédéfini introduit de la rigidité, ce qui limite l'ingestion et l'analyse rapides de nouveaux types de données.
Ces limites ont conduit à l'émergence de l'architecture Lakehouse, qui vise à réunir le meilleur des deux mondes :
Voici à quoi ressemble l'architecture lakehouse :
L'architecture du data lakehouse (Source)
Maintenant que nous comprenons l'évolution de Databricks Lakehouse, passons à la question clé.
Qu'est-ce que Lakehouse AI ?
Lakehouse AI désigne l'intégration de capacités d'intelligence artificielle et de machine learning directement au sein de l'architecture Lakehouse. Concrètement, nous pouvons développer, entraîner et déployer des modèles d'IA en s'appuyant sur les vastes volumes de données stockées dans le data lake, sans devoir déplacer ou copier ces données vers un autre environnement de traitement.
L'importance de cette plateforme tient à :
Ces atouts expliquent pourquoi Databricks a présenté cette plateforme comme la première plateforme d'IA intégrée à la couche de données.
Composants clés de Lakehouse AI
La transition vers Lakehouse AI a joué un rôle déterminant pour orienter les entreprises vers des opérations plus « data-driven » et intégrant l'IA.
Au cœur de cette transformation, plusieurs composants facilitent le développement, le déploiement et la gestion des modèles d'IA et de machine learning. Comprendre pourquoi et quand les utiliser aide les organisations à mieux exploiter leurs données pour des cas d'usage IA.
Vector Search
Vector Search dans Databricks Lakehouse AI représente une avancée majeure (également annoncée lors du Data + AI Summit 2023) pour explorer d'immenses jeux de données et y rechercher des informations proches sémantiquement, plutôt que de se limiter à des correspondances par mots-clés.
Vector Search fonctionne en convertissant les données et les requêtes en vecteurs dans un espace multidimensionnel appelé « embeddings », dérivés d'un modèle d'IA générative. Les mots ou concepts sémantiquement similaires se trouvent plus proches dans cet espace n-dimensionnel, ce qui fournit des résultats de recherche plus pertinents et contextuels.
Vector search (Capture d'écran par l'auteur)
Le processus d'utilisation de Vector Search (vidéo de démonstration par Databricks) est le suivant :
Des entreprises comme Lippert utilisent déjà Vector Search pour aider les agents à répondre rapidement aux demandes clients, en important des contenus issus de multiples sources.
Curated Models
Ces modèles, disponibles dans le Databricks Marketplace, sont optimisés pour de hautes performances et conçus pour s'intégrer facilement à l'environnement Lakehouse, pour des cas d'usage allant de l'analyse et la génération de texte au traitement d'images.
Parmi les modèles d'IA générative « curated » figurent :
Modèles disponibles dans le Databricks Marketplace (Capture d'écran par l'auteur)
Ces modèles s'articulent parfaitement avec l'ensemble des fonctionnalités de Databricks Lakehouse AI, y compris la gestion des données, l'analytique et les outils MLOps. Nous verrons dans un instant comment les utiliser dans le développement de modèles.
AutoML
Les fonctionnalités AutoML (Automated Machine Learning) de Databricks Lakehouse AI simplifient et automatisent la création de modèles, rendant la data science avancée accessible à un public plus large, y compris aux utilisateurs ayant peu d'expérience en machine learning.
Databricks AutoML (Source)
En fournissant le jeu de données et l'objectif de prédiction, AutoML se charge de préparer les données pour l'entraînement. Il crée ensuite, ajuste et évalue plusieurs modèles au fil d'essais successifs.
Une fois l'évaluation terminée, AutoML présente les résultats et met à disposition un notebook Python contenant le code source de chaque essai. Nous pouvons ainsi revoir, reproduire et modifier le code si besoin. AutoML calcule également des statistiques descriptives sur le jeu de données et les enregistre dans un notebook pour référence ultérieure.
Avec la dernière version, AutoML permet désormais d'affiner des modèles d'IA générative pour la classification de texte et des modèles d'embedding avec les données propres aux clients. Autrement dit, des utilisateurs métier non techniques peuvent construire des applications d'IA générative en quelques clics.
Lakehouse Monitoring
Databricks Lakehouse Monitoring nous permet de surveiller les propriétés statistiques et la qualité de nos tables de données, ainsi que de suivre les performances des modèles de machine learning et de leurs prédictions. En observant les flux de données dans les pipelines Databricks, ce module aide à garantir un suivi continu de la qualité des données et de l'efficacité des modèles.
Voici comment les données circulent dans Lakehouse Monitoring pour permettre cette surveillance continue :
Flux de Lakehouse Monitoring (Source)
Au-delà du simple monitoring, cette fonctionnalité fournit des insights actionnables sur l'intégrité des données, les distributions, les dérives et les performances des modèles dans le temps.
Voyons maintenant comment toutes ces fonctionnalités se rejoignent dans une gouvernance unifiée au sein de Lakehouse AI.
Le rôle de la gouvernance unifiée dans Lakehouse AI
La gouvernance unifiée consiste à pouvoir accéder, contrôler, collaborer, superviser et agir sur les données, les modèles de machine learning et les autres actifs d'IA depuis un même endroit. À mesure qu'une organisation progresse dans sa transformation IA, la centralisation de la gestion devient essentielle.
Databricks Unity Catalog répond à cet enjeu : en unifiant l'approche de gouvernance des actifs d'IA, il accélère l'adoption de l'IA tout en garantissant la conformité réglementaire.
Au-delà d'outils utiles comme l'explorateur de données et la connexion à des systèmes externes, la fonctionnalité phare est la vue d'ensemble de la gouvernance via un portail Unity Catalog simple, illustré ci-dessous :
Portail de gouvernance Unity Catalog (Capture d'écran par l'auteur)
Ce portail affiche des indicateurs clés comme le pourcentage de tables gouvernées et monitorées, le nombre d'utilisateurs actifs, ainsi que le volume de tables, de volumes et de modèles ML. Cette vue d'ensemble permet d'évaluer rapidement l'état de la gouvernance et l'engagement autour des actifs data.
Le tableau de bord montre aussi l'activité des utilisateurs dans le temps, utile pour comprendre l'usage des actifs data et identifier des goulets d'étranglement ou des besoins de formation.
En outre, le portail recense les risques potentiels de gouvernance, en signalant par exemple des tables non surveillées ou des colonnes dérivées de données personnelles (PII), ce qui favorise une gestion proactive et sécurisée des données, comme ci-dessous.
Vue des actions de gouvernance dans le tableau de bord Unity Catalog (Capture d'écran par l'auteur)
Chaque problème identifié s'accompagne d'une recommandation d'action, guidant les utilisateurs vers la résolution. Cette fonctionnalité simplifie et unifie un processus de gouvernance souvent complexe des actifs IA et data sur l'ensemble de la plateforme.
Maintenant que nous avons vu les fonctionnalités et leur articulation, passons à l'application au développement de bout en bout en machine learning.
Développement machine learning de bout en bout sur Databricks Lakehouse AI
Pour un rappel sur le cycle de développement du machine learning, consultez notre tutoriel détaillé. Dans cette section, nous verrons comment les fonctionnalités de Databricks Lakehouse AI s'intègrent dans ce cycle.
Développement machine learning de bout en bout (Source)
1. Préparation des données et feature engineering
La base du machine learning dans Databricks Lakehouse AI, c'est la capacité à entraîner et construire des modèles efficacement.
Nous pouvons utiliser le runtime Databricks ML, qui inclut des bibliothèques courantes telles que pandas et PySpark, pour préparer et nettoyer les données. Databricks Feature Store est un référentiel centralisé au sein de la plateforme Databricks Lakehouse AI, conçu pour stocker, partager et gérer les features de machine learning.
Le Feature Store garantit la cohérence entre les features utilisées à l'entraînement et celles utilisées en production lors de l'inférence. Il évite aussi de gaspiller des ressources en recalculant sans cesse les même features pour différents cas d'usage.
Rôle d'un feature store (Source)
En centralisant la définition et le stockage des features, il élimine le problème classique du « training-serving skew », lorsque les données d'entraînement diffèrent de celles rencontrées en production.
2. Conception des modèles
Pour développer les modèles, nous pouvons soit utiliser des modèles préconfigurés disponibles dans l'environnement Databricks, soit entraîner un modèle sur mesure adapté à nos données et besoins métier.
Databricks propose aussi des clusters optimisés GPU, ce qui accélère l'entraînement (et l'inférence) et facilite le passage à l'échelle — un atout crucial pour fournir en temps voulu des insights, des prédictions et des recommandations.
3. Évaluation et expérimentation
Databricks a développé un outil open source appelé MLflow, nativement disponible sur la plateforme, qui simplifie le suivi des expériences, l'empaquetage du code en exécutions reproductibles et le partage des résultats.
Exemple d'expérience MLflow (Capture d'écran par l'auteur)
La mise en place d'un cadre d'expérimentation comprend les étapes suivantes :
Une fois le cadre en place, nous pouvons itérer rapidement pour converger plus tôt vers le meilleur modèle.
4. Déploiement des modèles et MLOps
Model Serving, une autre fonctionnalité de Databricks Lakehouse AI, fluidifie le passage des modèles du développement à la production.
Les modèles peuvent être exposés en endpoints REST, facilement intégrables dans diverses applications et services pour des prédictions en temps réel ou par lots.
Endpoints Model Serving (Source)
Une fois le modèle entraîné, les data scientists peuvent le déployer en quelques clics, sans configuration lourde ni expertise DevOps. Pour ce faire :
Nous vous recommandons de suivre ces exemples de tutoriels détaillés de Databricks pour exécuter ces étapes sereinement. Cette facilité de déploiement est cruciale dans les workflows data modernes, où la capacité à itérer et déployer rapidement crée une véritable valeur métier.
5. Supervision et évaluation
Une fois les modèles déployés en production, la dernière phase essentielle du cycle de vie de l'IA consiste à les superviser et les évaluer en continu, afin de garantir leur efficacité et leur précision dans le temps.
Databricks Lakehouse AI s'appuie pour cela sur Lakehouse Monitoring et les Inference Tables, deux outils essentiels pour maintenir la santé et l'efficacité des systèmes d'IA. Comme nous avons déjà présenté Lakehouse Monitoring, concentrons-nous ici sur les Inference Tables.
En bref, l'Inference Table est une option supplémentaire, activable par une case à cocher, qui permet de capturer les données d'entrée et les prédictions correspondantes issues des endpoints Model Serving, puis de les journaliser dans une table Delta intégrée à Unity Catalog.
Ce mécanisme de journalisation présente plusieurs avantages :
Le développement en machine learning est cyclique : on recueille les retours de la première version en production, puis l'on affine, réentraîne et construit des modèles plus précis et plus efficients, ce qui nous ramène au premier stade.
Conclusion
Ce tutoriel a présenté l'évolution de Databricks Lakehouse AI et ses fonctionnalités clés. Nous avons également vu comment elles s'articulent via une gouvernance unifiée. Enfin, nous avons analysé la manière de parcourir le cycle de développement de bout en bout en s'appuyant sur la plateforme Databricks Lakehouse AI.
Pour approfondir Databricks Lakehouse et ses applications en data engineering, en développement de machine learning et en création d'applications à grande échelle, nous vous recommandons de suivre notre Introduction to Databricks comme prochaine étape.