
Corso
Concetti di IA generativa
2 ore
121.2K
Databricks è stata tra i pionieri nello sviluppo di tecnologie e piattaforme che aiutano a fornire soluzioni di AI su larga scala, guidando anche progetti open source come Apache Spark e MLflow.
Durante il Databrick Data + AI Summit 2023, è stata annunciata Lakehouse AI come la prima piattaforma di AI al mondo, integrata direttamente nel livello dati — e sono state presentate molte altre nuove funzionalità. Con il lancio di ChatGPT e i grandi passi avanti nelle tecnologie di AI generativa in tutto il mondo, Lakehouse AI è la risposta di Databrick alla costruzione di applicazioni di AI generativa attraverso un approccio data‑centric.
In questo tutorial presenteremo la piattaforma Databricks Lakehouse AI, ne valuteremo l’importanza, capiremo le nuove funzionalità lanciate e come potremmo utilizzarle nel nostro ciclo di sviluppo di machine learning.
Aspetta, Lakehouse? Capita che questi termini siano nuovi per te.
Analizziamo passo dopo passo l’evoluzione di Databricks Lakehouse AI. Per capire Lakehouse AI — dobbiamo prima comprendere a fondo l’architettura Lakehouse.
Un “Lakehouse” è un’architettura moderna di gestione dei dati che combina la flessibilità e la convenienza economica di un data lake con le funzionalità di gestione dati di un data warehouse.
Abbiamo un intero tutorial sulle differenze tra data lake e data warehouse nel dettaglio, ma in breve, ecco cosa significa:
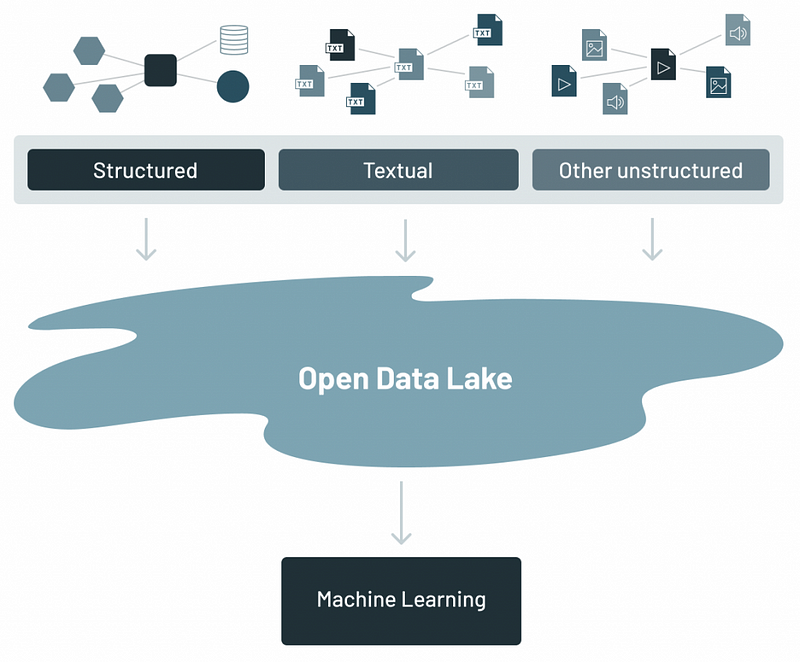
L’architettura del data lake (Fonte)
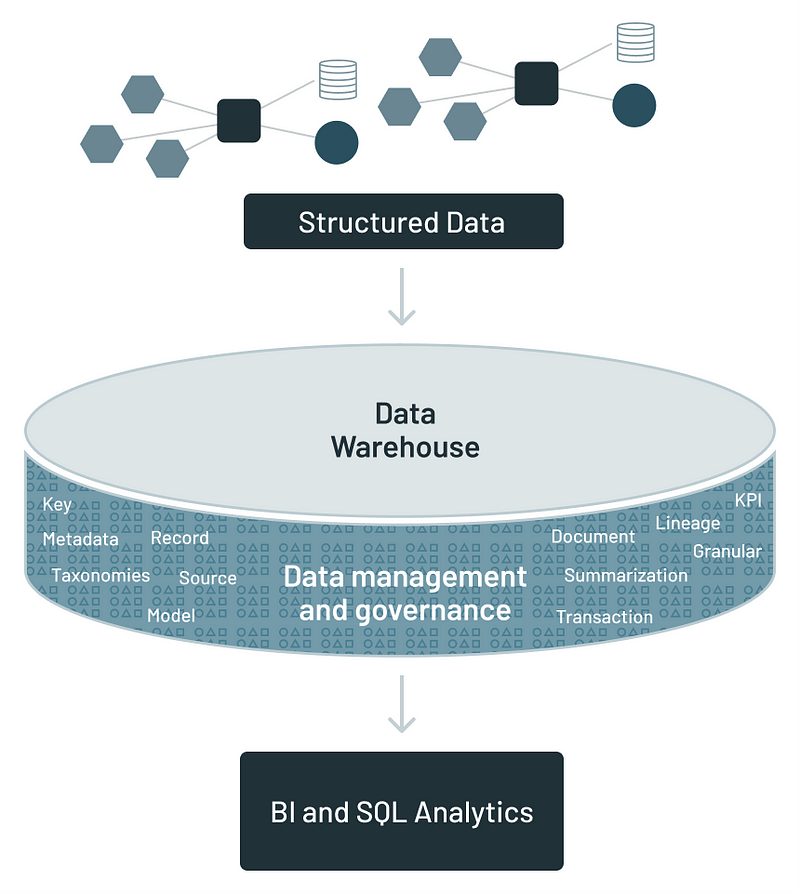
L’architettura del data warehouse (Fonte)
I data lake spesso faticano nella gestione e nella governance dei dati a causa della loro natura di archiviare enormi quantità di dati grezzi e non strutturati, il che può portare a “data swamp”, dove i dati sono difficili da trovare, accedere o di cui fidarsi. La mancanza di struttura può anche ostacolare le prestazioni di query analitiche complesse, e i data lake tradizionali di solito non supportano bene le operazioni transazionali, mancando delle capacità di transazione ACID, cruciali per garantire l’integrità dei dati.
I data warehouse, invece, sono ottimizzati per dati strutturati e analisi, ma possono diventare costosi da scalare man mano che i volumi aumentano. La necessità che i dati siano strutturati e trasformati in uno schema predefinito può introdurre rigidità, limitando la capacità di acquisire e analizzare rapidamente nuovi tipi di dati.
Questi limiti hanno guidato l’evoluzione dell’architettura Lakehouse, che mira a unire il meglio di entrambi i mondi:
Ecco come si presenta l’architettura lakehouse:
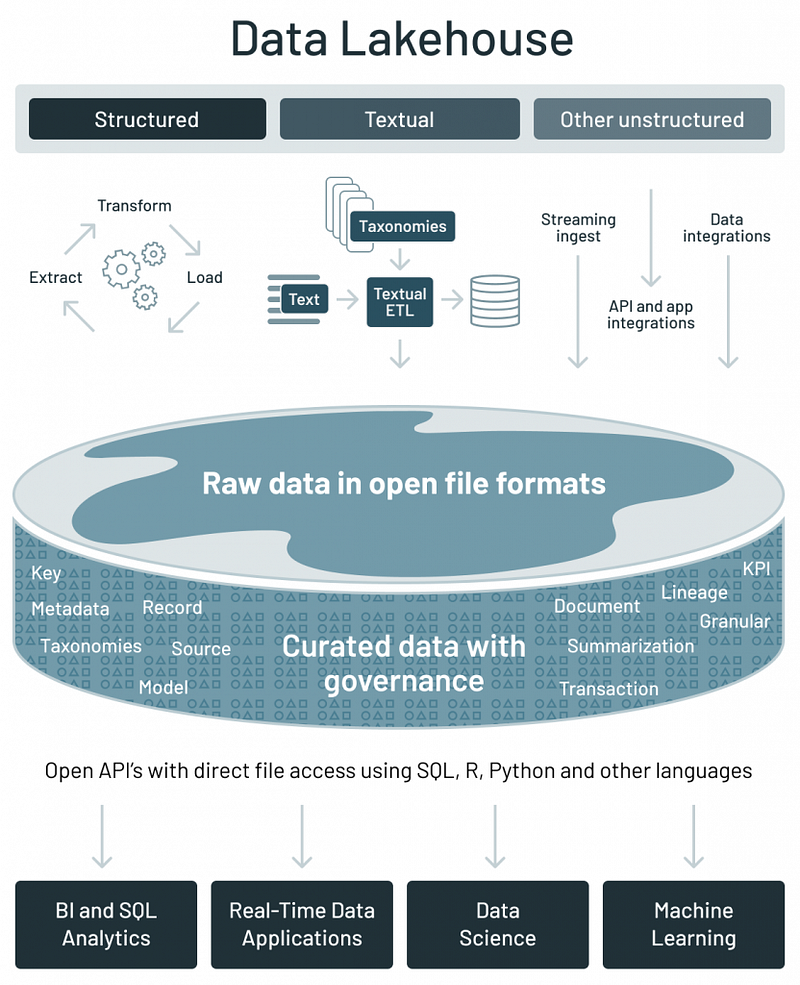
L’architettura del data lakehouse (Fonte)
Ora che abbiamo capito l’evoluzione di Databricks Lakehouse, arriviamo alla domanda finale.
Lakehouse AI è l’integrazione di funzionalità di intelligenza artificiale e machine learning direttamente nell’architettura Lakehouse. Significa che possiamo sviluppare, addestrare e distribuire modelli di AI utilizzando le enormi quantità di dati archiviati nel nostro data lake senza dover spostare o copiare i dati in un ambiente separato per l’elaborazione.
L’importanza di questa piattaforma è:
Queste caratteristiche spiegano perché Databricks ha annunciato questa piattaforma come la prima piattaforma di AI al mondo integrata nel livello dati.
Il passaggio a Lakehouse AI è stato determinante per spingere le aziende verso operazioni più data‑driven e integrate con l’AI.
Al centro di questa trasformazione ci sono diversi componenti chiave che facilitano lo sviluppo, la distribuzione e la gestione di modelli di AI e machine learning. Capire perché e quando servono questi componenti può aiutare le organizzazioni a sfruttare in modo più efficace i propri dati per applicazioni di AI.
La Vector Search in Databricks Lakehouse AI rappresenta un notevole avanzamento (presentato anche al Data+AI Summit 2023) nella gestione e ricerca all’interno di dataset enormi per trovare informazioni semanticamente simili, invece che basarsi sulle tradizionali corrispondenze per parola chiave.
La Vector Search funziona convertendo dati e query in vettori in uno spazio multidimensionale chiamato embedding, derivati da un modello di AI generativa. Questo metodo fa sì che parole o concetti semanticamente simili siano più vicini nello spazio n‑dimensionale, consentendo risultati di ricerca più pertinenti e attenti al contesto.
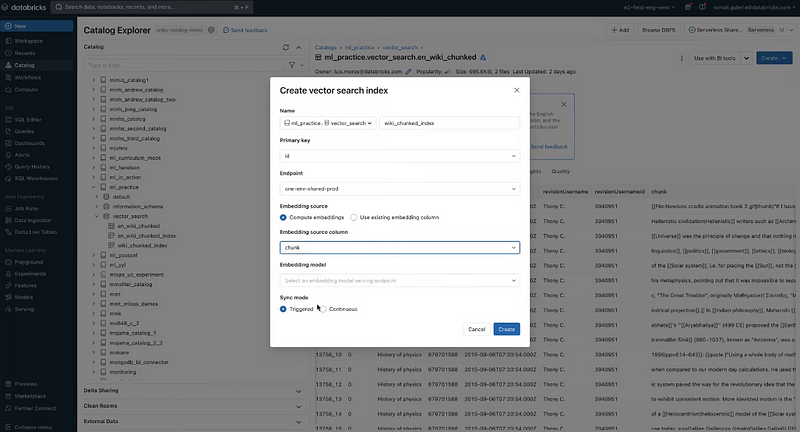
Vector search (Screenshot dell’autore)
Il processo di utilizzo della Vector Search (video demo di Databricks) è il seguente:
Aziende come Lippert hanno già utilizzato la Vector Search per consentire agli operatori di trovare rapidamente risposte alle richieste dei clienti, alimentando la Vector Search con contenuti provenienti da varie fonti.
Questi modelli, disponibili all’interno del Databricks Marketplace, sono ottimizzati per alte prestazioni e progettati per essere facilmente integrati nell’ambiente Lakehouse per un’ampia gamma di applicazioni, dall’analisi e generazione di testo all’elaborazione di immagini.
Alcuni dei modelli di AI generativa curati includono:
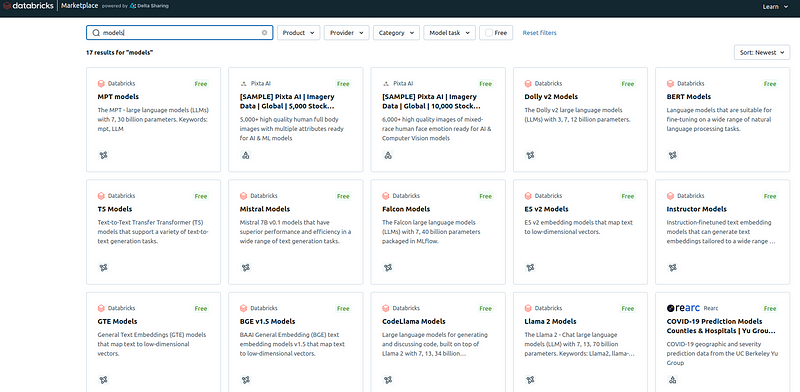
Modelli disponibili nel Databricks Marketplace (Screenshot dell’autore)
Questi modelli sono progettati per funzionare senza soluzione di continuità con l’insieme più ampio di funzionalità di Databricks Lakehouse AI, inclusi strumenti di gestione dei dati, analytics e MLOps. Tra poco vedremo come questi modelli possono essere utilizzati nello sviluppo di machine learning.
Le funzionalità AutoML (Automated Machine Learning) all’interno di Databricks Lakehouse AI sono progettate per semplificare e automatizzare il processo di sviluppo dei modelli di machine learning, rendendo la data science avanzata accessibile a un numero più ampio di utenti, inclusi coloro con competenze limitate in machine learning.
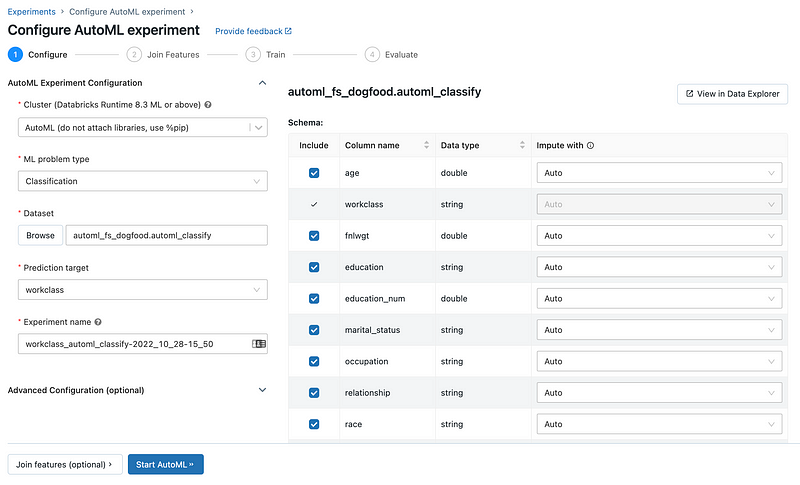
Databrick AutoML (Fonte)
Quando forniamo il dataset e specifichiamo l’obiettivo di previsione, AutoML si occupa di preparare il dataset per l’addestramento di un modello. Prosegue poi creando, tarando e valutando più modelli attraverso una serie di prove.
Una volta completata la valutazione, AutoML presenta i risultati e offre un notebook Python contenente il codice sorgente di ogni prova. Questo ci consente di rivedere, riprodurre e modificare il codice secondo necessità. AutoML calcola anche statistiche riassuntive sul nostro dataset e salva queste informazioni in un notebook per riferimento futuro.
Con l’ultimo lancio, AutoML offre ora il fine‑tuning di modelli di AI generativa per la classificazione del testo e di modelli di embedding con i dati propri del cliente. Ciò significa che utenti business non tecnici possono ora utilizzare AutoML per creare applicazioni di AI generativa con pochi clic.
Databricks Lakehouse Monitoring ci consente di monitorare le proprietà statistiche e la qualità delle nostre tabelle di dati e di tracciare le prestazioni dei modelli di machine learning e delle loro previsioni. Esaminando il flusso di dati nelle pipeline di Databricks, questa funzionalità aiuta a garantire il monitoraggio continuo della qualità dei dati e dell’efficacia dei modelli.
Ecco come i dati fluiscono attraverso il monitoraggio del Lakehouse per abilitare il controllo continuo:
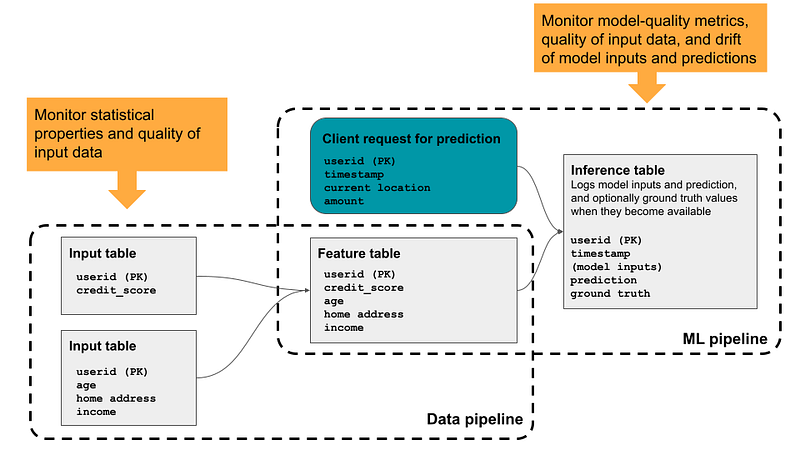
Flusso del Lakehouse Monitoring (Fonte)
Invece di fermarsi al monitoraggio, questa funzionalità fornisce anche insight azionabili su vari aspetti come integrità dei dati, distribuzione, drift e prestazioni del modello nel tempo.
Vediamo ora come tutte queste funzionalità si integrano nella governance unificata in Lakehouse AI.
L’idea della governance unificata è poter accedere, controllare, collaborare, monitorare e agire sui dati, sui modelli di machine learning e su altri asset di AI in un unico posto. Man mano che un’organizzazione cresce e matura nel percorso di trasformazione AI, poter gestire tutto in un unico luogo è cruciale.
Databricks Unity Catalog fa proprio questo, e unificare l’approccio alla governance degli asset di AI accelera l’adozione dell’AI garantendo al contempo la conformità normativa.
Sebbene siano utili funzionalità come l’esploratore dei dati e la possibilità di aggiungere sistemi esterni, la funzione di spicco è poter avere una vista d’insieme dell’intera governance di questi asset tramite un semplice Unity Catalog Governance Portal, come mostrato di seguito:
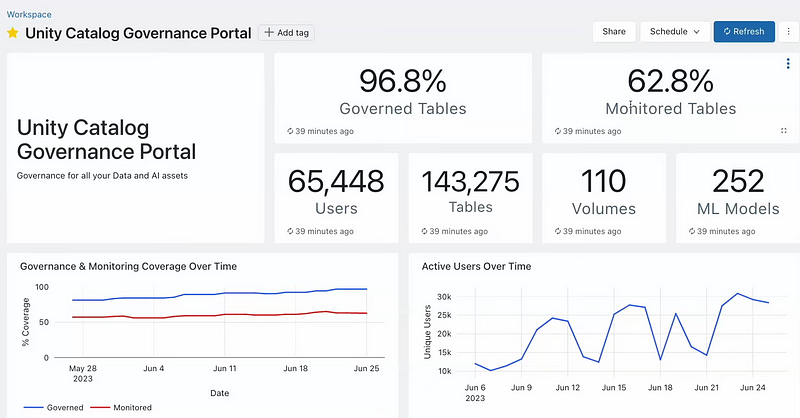
Portale di governance di Unity Catalog (Screenshot dell’autore)
Questo portale mostra metriche chiave come la percentuale di tabelle governate e monitorate, il numero di utenti attivi e il conteggio di tabelle, volumi e modelli di ML. Questa vista di alto livello aiuta a valutare rapidamente lo stato della governance e il livello di coinvolgimento sugli asset di dati.
La dashboard mostra anche i livelli di attività degli utenti nel tempo, utile per comprendere come gli asset di dati sono utilizzati all’interno dell’organizzazione e per identificare eventuali colli di bottiglia o esigenze di formazione.
Inoltre, il portale elenca potenziali rischi di governance identificando problemi come tabelle non monitorate o colonne derivate da PII (Personally Identifiable Information), offrendo un approccio proattivo alla gestione sicura dei dati, come mostrato sotto.
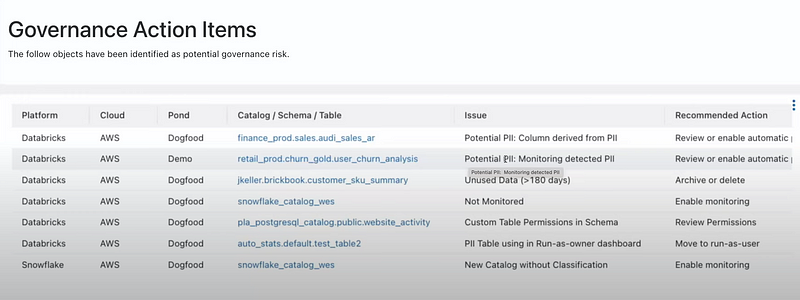
Vista degli elementi d’azione di governance nella dashboard di Unity Catalog (Screenshot dell’autore)
Ogni problema identificato è accompagnato da un’azione consigliata, guidando gli utenti nella risoluzione delle potenziali criticità di governance. Questa funzionalità semplifica e unifica il spesso complesso processo di governance degli asset di AI e dati sulla piattaforma.
Ora che abbiamo capito le funzionalità della piattaforma e come si integrano, passiamo alla loro applicazione per lo sviluppo end‑to‑end di machine learning.
Per un ripasso del ciclo di sviluppo del machine learning end‑to‑end, ti consigliamo di consultare il nostro tutorial approfondito. In questa sezione, capiremo come le funzionalità di Databricks Lakehouse AI si inseriscono nel ciclo.
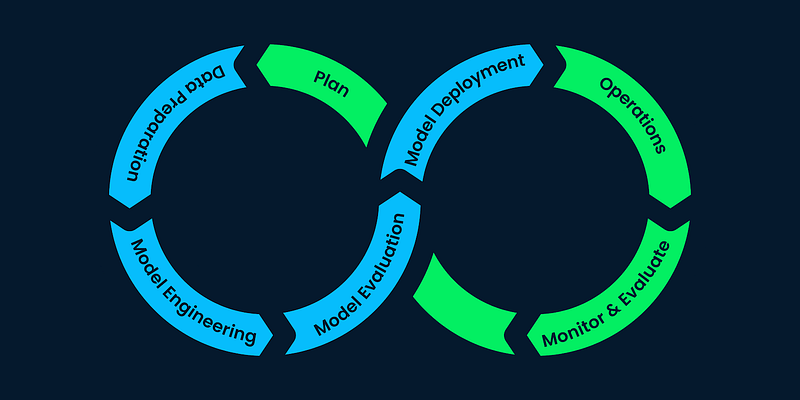
Sviluppo end‑to‑end di Machine Learning (Fonte)
La pietra angolare del machine learning all’interno di Databricks Lakehouse AI è la capacità di addestrare e costruire modelli in modo efficiente.
Possiamo usare il runtime ML di Databricks, che include pacchetti comuni come pandas e PySpark, per preparazione e pulizia dei dati. Databricks Feature Store è un repository centralizzato all’interno della piattaforma Databricks Lakehouse AI — progettato per archiviare, condividere e gestire le feature di machine learning.
Questo feature store garantisce che le feature utilizzate per l’addestramento dei modelli di machine learning siano coerenti con quelle impiegate in fase di inferenza negli ambienti di produzione. Inoltre, non dobbiamo sprecare risorse di calcolo ricalcolando le feature più e più volte per casi d’uso diversi.
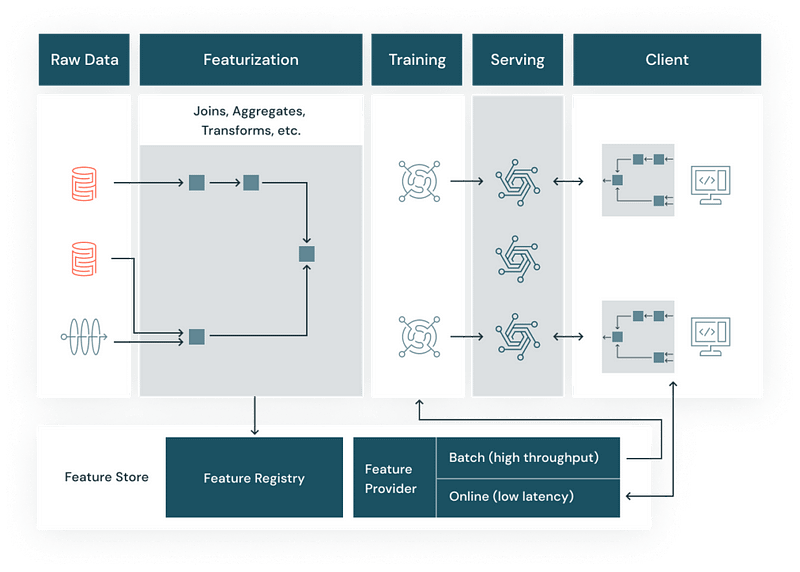
La funzione di un feature store (Fonte)
Centralizzando le definizioni e l’archiviazione delle feature, elimina il problema comune del “training‑serving skew”, in cui i dati usati per l’addestramento del modello differiscono da quelli che il modello incontra in produzione.
Per lo sviluppo dei modelli, abbiamo la flessibilità di scegliere tra modelli predefiniti curati disponibili nell’ambiente Databricks o optare per l’addestramento di un modello personalizzato su misura per i propri dati ed esigenze di business.
Databricks dispone anche di cluster ottimizzati per GPU, il che significa che l’addestramento (e l’inferenza) può avvenire più rapidamente e su scala, elemento spesso cruciale quando si tratta di insight, previsioni e raccomandazioni in tempo reale su larga scala.
Databricks ha sviluppato uno strumento open source chiamato MLflow, disponibile nativamente sulla piattaforma Databricks, che semplifica il complesso processo di tracciamento degli esperimenti, impacchettamento del codice in run riproducibili e condivisione dei risultati.
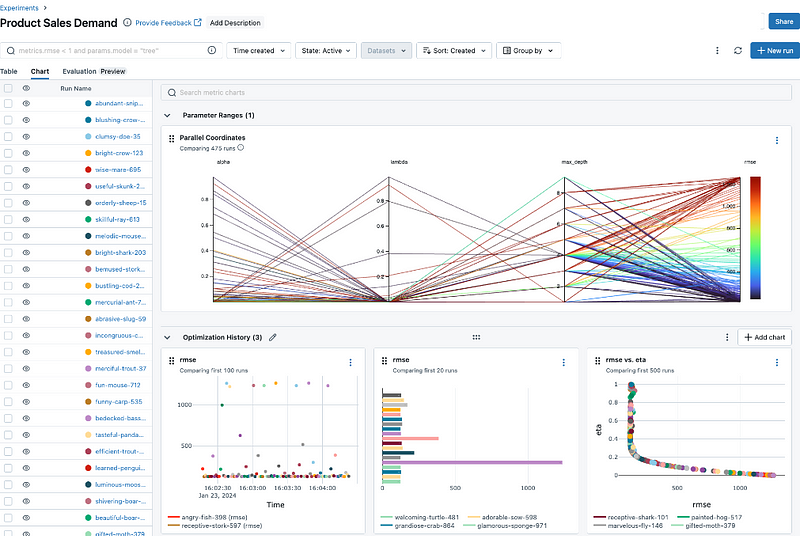
Esempio di esperimento MLflow (Screenshot dell’autore)
I passaggi per creare un framework di sperimentazione sono i seguenti:
Una volta stabilito il framework, possiamo iterare rapidamente per arrivare presto al modello migliore.
Model Serving, un’altra funzionalità all’interno di Databricks Lakehouse AI, semplifica il passaggio dei modelli di machine learning dalla fase di sviluppo a uno stato pronto per la produzione.
Questa funzionalità consente di distribuire i modelli come endpoint RESTful, facilmente integrabili in varie applicazioni e servizi per previsioni in tempo reale o inferenza batch.
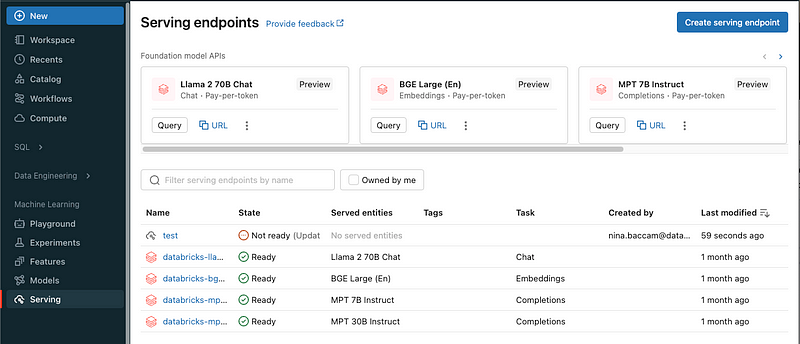
Endpoint di Model Serving (Fonte)
Una volta addestrato un modello, i data scientist possono distribuirlo con pochi clic senza bisogno di configurazioni estese o competenze DevOps. Ecco come fare:
Ti invitiamo a consultare questi tutorial dettagliati di Databricks per eseguire facilmente questi passaggi. Questa semplicità di deployment è cruciale nei flussi di lavoro dati moderni, dove la capacità di iterare e distribuire modelli rapidamente può generare significativo valore di business.
Una volta che i nostri modelli di machine learning sono in produzione, l’ultima fase cruciale del ciclo di vita dell’AI è il monitoraggio e la valutazione. Questa fase prevede il tracciamento continuo delle prestazioni del modello per garantirne l’efficacia e l’accuratezza nel tempo.
Databricks Lakehouse AI facilita ciò tramite Lakehouse Monitoring e Inference Tables, strumenti essenziali per mantenere la salute e l’efficacia dei nostri sistemi di AI. Poiché abbiamo già visto le funzionalità di Lakehouse Monitoring, in questa sezione ci concentreremo sulle inference table.
In poche parole, l’Inference Table è una funzionalità aggiuntiva, da abilitare con una semplice spunta, che ci consente di catturare i dati di input e le corrispondenti previsioni dagli endpoint di Model Serving e registrarli in una tabella delta, che farà parte dell’Unity Catalog.
Questo meccanismo di logging ha molteplici benefici:
Il processo di sviluppo del machine learning è ciclico per natura, il che significa che raccogliamo il feedback dalla prima versione in produzione e perfezioniamo, riaddestriamo e costruiamo modelli più accurati ed efficienti, tornando così di nuovo al primo passo.
Questo tutorial ha presentato l’evoluzione di Databricks Lakehouse AI e le sue funzionalità principali. Abbiamo anche visto come queste funzionalità si integrano tramite una governance unificata. Inoltre, abbiamo analizzato e compreso come navigare nell’intero ciclo di vita del machine learning utilizzando la piattaforma Databricks Lakehouse AI.
Per saperne di più su Databricks Lakehouse e sulla sua applicazione nell’ingegneria dei dati, nello sviluppo di machine learning e nella costruzione di applicazioni su larga scala con un approccio pratico, ti consigliamo come passo successivo il nostro corso Introduction to Databricks.
Inizia oggi il tuo percorso nell’AI!
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min



