
Kurs
Konzeptuelle Einführung in generative KI
2 Std.
117.2K
Databricks gehört zu den Vorreitern bei Technologien und Plattformen, die KI-Lösungen in großem Maßstab möglich machen – unter anderem durch die Förderung von Open-Source-Projekten wie Apache Spark und MLflow.
Während des Databricks Data + AI Summit 2023 wurde Lakehouse AI als weltweit erste KI-Plattform angekündigt, die direkt in die Datenschicht integriert ist — zusammen mit vielen weiteren neuen Funktionen. Mit dem Start von ChatGPT und großen Sprüngen in generativer KI weltweit ist Lakehouse AI Databricks’ Antwort, generative KI-Anwendungen datengetrieben zu entwickeln.
In diesem Tutorial stellen wir die Databricks Lakehouse AI Plattform vor, ordnen ihre Bedeutung ein, erklären die neuen Funktionen und zeigen, wie wir sie im Machine-Learning-Lebenszyklus nutzen können.
Moment, Lakehouse? Uns ist klar, dass das für dich neu sein kann.
Lass uns die Entwicklung von Databricks Lakehouse AI Schritt für Schritt aufdröseln. Um Lakehouse AI zu verstehen, müssen wir zuerst die Lakehouse-Architektur begreifen.
Ein „Lakehouse“ ist eine moderne Datenarchitektur, die die Flexibilität und Kostenvorteile eines Data Lakes mit den Datamanagement-Fähigkeiten eines Data Warehouses kombiniert.
Wir haben ein ausführliches Tutorial zu den Unterschieden zwischen Data Lake und Data Warehouse. Kurz gesagt, bedeutet das:
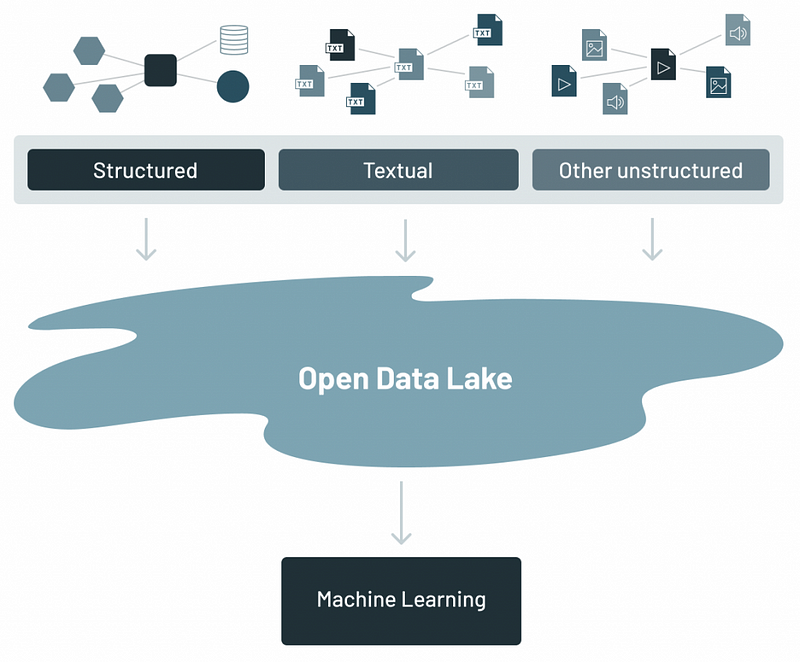
Die Data-Lake-Architektur (Quelle)
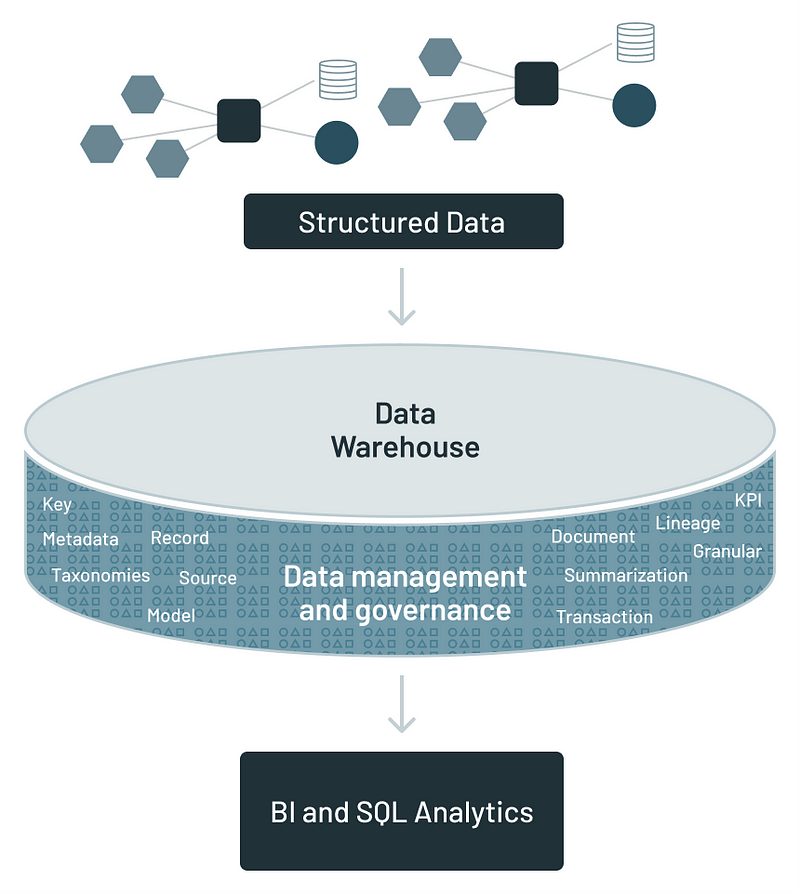
Die Data-Warehouse-Architektur (Quelle)
Data Lakes kämpfen häufig mit Datenmanagement und Governance, weil riesige Mengen unstrukturierter Rohdaten gespeichert werden. So entstehen „Data Swamps“, in denen Daten schwer auffindbar, zugänglich oder vertrauenswürdig sind. Der Mangel an Struktur kann außerdem komplexe Analysen ausbremsen, und klassische Data Lakes unterstützen Transaktionen meist schlecht, da ihnen ACID-Fähigkeiten fehlen – entscheidend für Datenintegrität.
Data Warehouses sind hingegen für strukturierte Daten und Analytik optimiert, können aber mit wachsendem Datenvolumen sehr teuer werden. Die Notwendigkeit, Daten in ein vordefiniertes Schema zu pressen, führt zu Starrheit und erschwert die schnelle Aufnahme und Analyse neuer Datentypen.
Diese Limitierungen haben zur Lakehouse-Architektur geführt, die das Beste aus beiden Welten vereint:
So sieht die Lakehouse-Architektur aus:
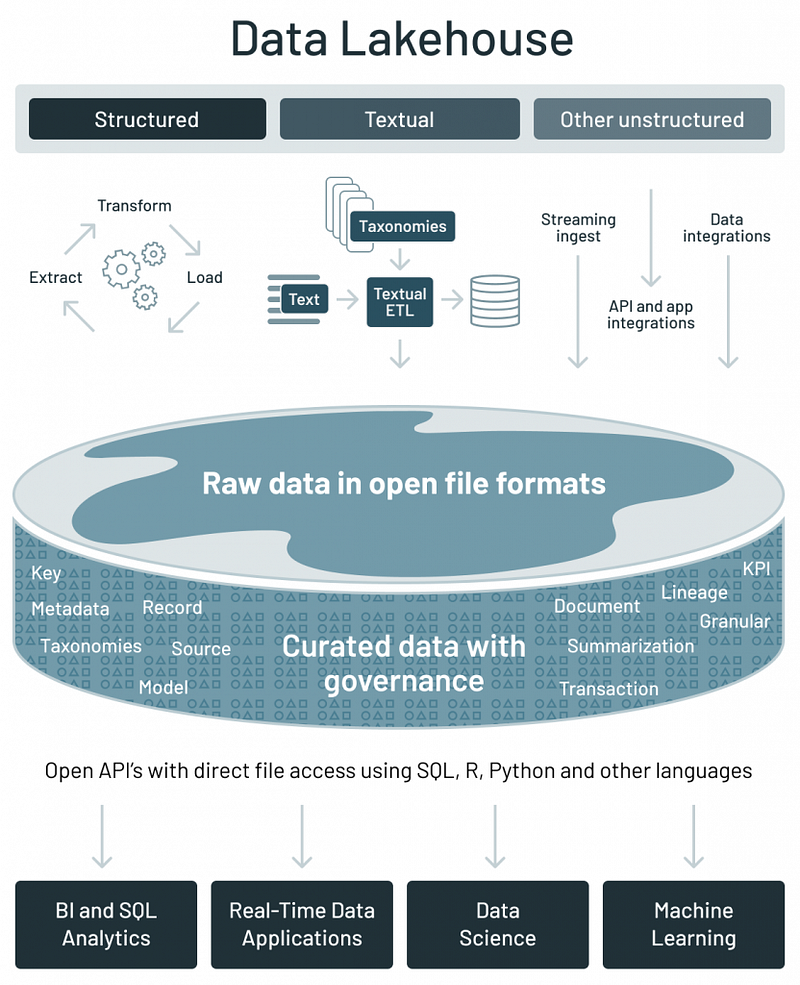
Die Data-Lakehouse-Architektur (Quelle)
Jetzt, da wir die Entwicklung des Databricks Lakehouse verstehen, kommen wir zur entscheidenden Frage.
Lakehouse AI integriert KI- und Machine-Learning-Funktionen direkt in die Lakehouse-Architektur. Das bedeutet: Wir können KI-Modelle mit den riesigen Datenmengen im Data Lake entwickeln, trainieren und bereitstellen, ohne die Daten für die Verarbeitung in eine separate Umgebung verschieben zu müssen.
Die Bedeutung dieser Plattform:
Das erklärt, warum Databricks diese Plattform als weltweit erste KI-Plattform direkt in der Datenschicht angekündigt hat.
Der Schritt zu Lakehouse AI treibt Unternehmen zu datenbasierten, KI-integrierten Arbeitsweisen.
Im Zentrum stehen mehrere Kernkomponenten für Entwicklung, Bereitstellung und Management von KI- und ML-Modellen. Zu wissen, wann und warum sie gebraucht werden, hilft, Daten für KI-Anwendungen effektiver zu nutzen.
Vector Search in Databricks Lakehouse AI ist ein großer Fortschritt (ebenfalls auf dem Data+AI Summit 2023 angekündigt), um in riesigen Datensätzen semantisch ähnliche Informationen zu finden – statt nur über Schlüsselwörter.
Vector Search wandelt Daten und Suchanfragen in Vektoren in einem mehrdimensionalen Raum um („Embeddings“), die aus einem generativen KI-Modell stammen. Semantisch ähnliche Wörter oder Konzepte liegen in diesem n-dimensionalen Raum näher beieinander – für relevantere, kontextbezogene Suchergebnisse.
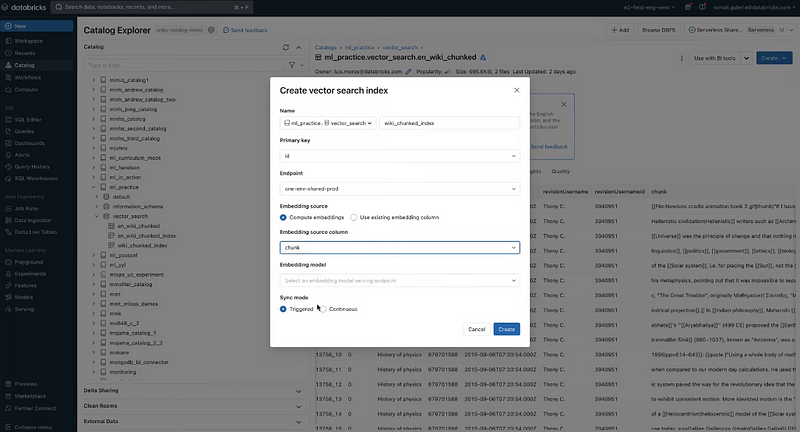
Vektorsuche (Screenshot des Autors)
So läuft Vector Search ab (Demo-Video von Databricks):
Unternehmen wie Lippert nutzen Vector Search bereits, um Agents schnell Antworten auf Kundenanfragen zu liefern, indem Inhalte aus verschiedenen Quellen in Vector Search eingespeist werden.
Diese im Databricks Marketplace verfügbaren Modelle sind auf hohe Performance optimiert und lassen sich einfach ins Lakehouse integrieren – von Textanalyse und -generierung bis Bildverarbeitung.
Zu den kuratierten generativen KI-Modellen gehören:
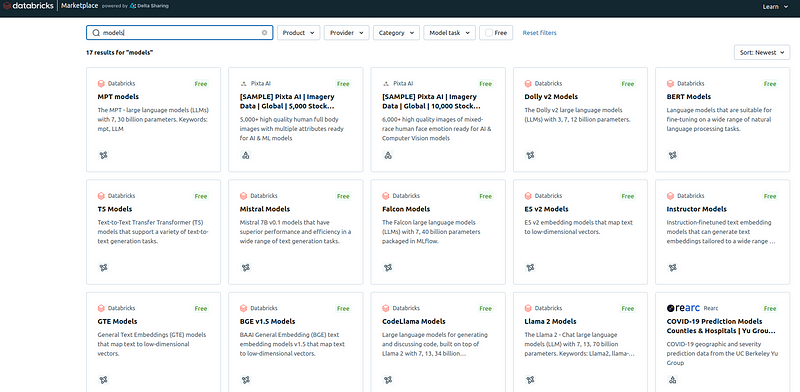
Modelle im Databricks Marketplace (Screenshot des Autors)
Diese Modelle funktionieren nahtlos mit den übrigen Lakehouse-AI-Funktionen wie Datenmanagement, Analytics und MLOps. Gleich sehen wir, wie sie in der ML-Entwicklung eingesetzt werden.
AutoML (Automated Machine Learning) in Databricks Lakehouse AI strafft und automatisiert die ML-Modellentwicklung. So wird fortgeschrittene Data Science für mehr Nutzer zugänglich – auch für jene mit wenig ML-Erfahrung.
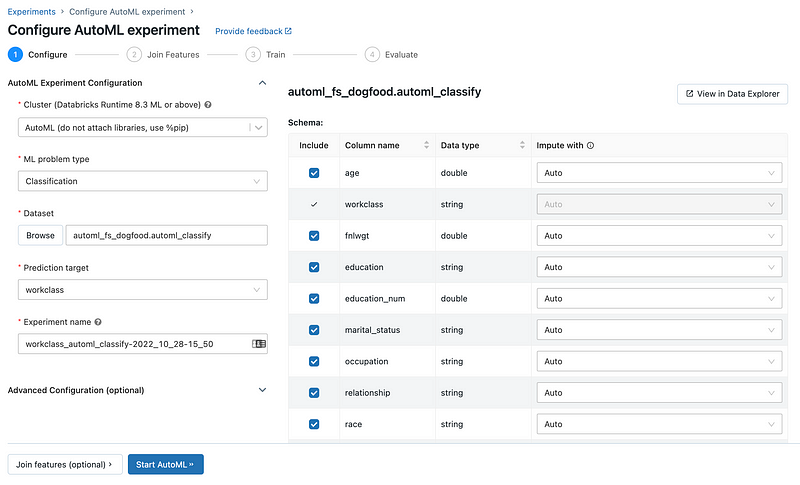
Databricks AutoML (Quelle)
Gibst du den Datensatz und das Vorhersageziel vor, übernimmt AutoML die Aufbereitung für das Training. Anschließend werden in mehreren Trials verschiedene Modelle erzeugt, getunt und bewertet.
Nach der Auswertung präsentiert AutoML die Ergebnisse und stellt für jeden Trial ein Python-Notebook mit dem Quellcode bereit. So kannst du den Code prüfen, reproduzieren und anpassen. AutoML berechnet außerdem zusammenfassende Statistiken über deinen Datensatz und speichert sie in einem Notebook.
Mit dem neuesten Release können nun generative KI-Modelle für Textklassifikation und Embeddings mit eigenen Daten feinjustiert werden. Damit können auch fachliche Nutzer ohne tiefes Technik-Know-how per Klicks generative KI-Anwendungen bauen.
Databricks Lakehouse Monitoring ermöglicht es, die statistischen Eigenschaften und Qualität deiner Tabellen zu überwachen sowie die Performance von ML-Modellen und ihren Prognosen zu tracken. Durch Einblick in die Datenflüsse der Databricks-Pipelines stellt das Feature eine kontinuierliche Überwachung von Datenqualität und Modelleffektivität sicher.
So fließen die Daten durchs Lakehouse Monitoring, um die kontinuierliche Überwachung zu ermöglichen:
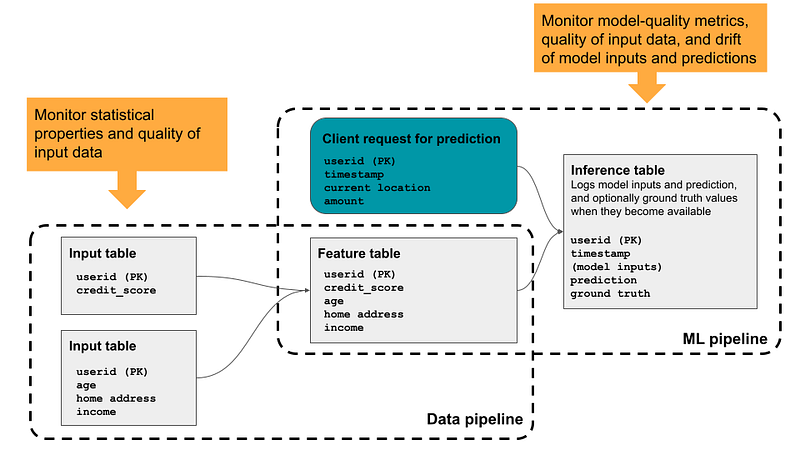
Lakehouse-Monitoring-Flow (Quelle)
Statt bei der Beobachtung stehenzubleiben, liefert dieses Feature umsetzbare Insights über Datenintegrität, Verteilungen, Drift und die Modellperformance im Zeitverlauf.
Schauen wir uns nun an, wie all diese Funktionen als einheitliche Governance in Lakehouse AI zusammenspielen.
Einheitliche Governance bedeutet, Daten, ML-Modelle und andere KI-Assets zentral zu finden, zu steuern, gemeinsam zu nutzen, zu überwachen und darauf zu reagieren. Je weiter eine Organisation in ihrer KI-Transformation ist, desto wichtiger ist dieses zentrale Management.
Der Databricks Unity Catalog liefert genau das. Die einheitliche Steuerung der KI-Assets beschleunigt die KI-Adoption und stellt gleichzeitig Compliance sicher.
Neben Features wie Data Explorer und der Einbindung externer Systeme sticht besonders der Überblick über die gesamte Governance im Unity Catalog Governance Portal hervor, wie unten zu sehen:
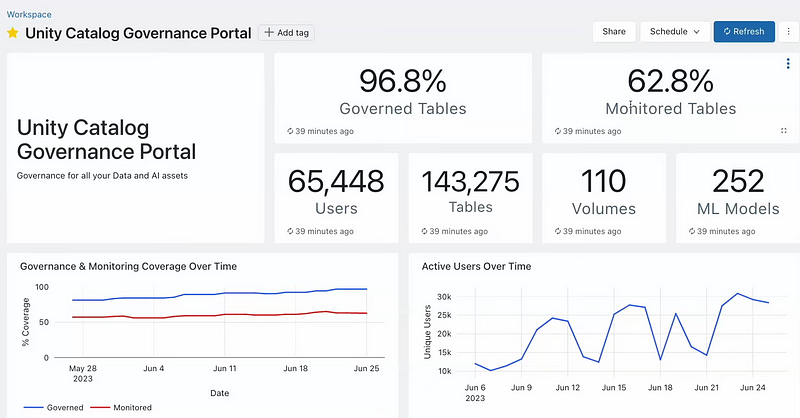
Unity-Catalog-Governance-Portal (Screenshot des Autors)
Das Portal zeigt Kennzahlen wie den Anteil überwachter Tabellen, aktive Nutzende sowie die Anzahl von Tabellen, Volumes und ML-Modellen. Dieser High-Level-Blick hilft, Governance-Status und Nutzung schnell einzuschätzen.
Das Dashboard zeigt auch die Aktivitäten der Nutzenden im Zeitverlauf, um die Nutzung der Datenassets zu verstehen und Engpässe oder Schulungsbedarfe zu erkennen.
Zudem listet das Portal potenzielle Governance-Risiken, etwa unüberwachte Tabellen oder aus PII (personenbezogenen Daten) abgeleitete Spalten, und ermöglicht so proaktives, sicheres Datenmanagement, wie unten zu sehen.
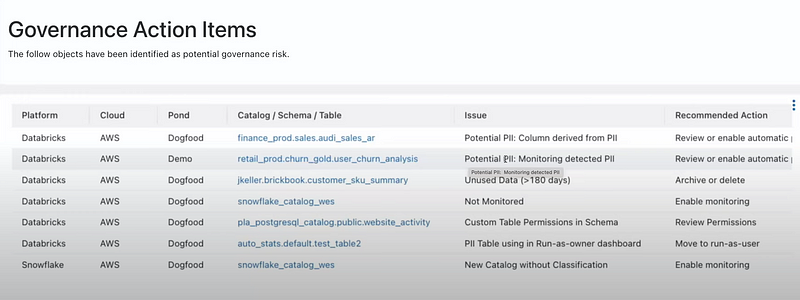
Governance-Action-Items im Unity-Catalog-Dashboard (Screenshot des Autors)
Zu jedem Fund gibt es eine empfohlene Maßnahme, die bei der Behebung unterstützt. So wird die oft komplexe Governance von KI- und Datenassets plattformweit vereinfacht und vereinheitlicht.
Da wir nun die Funktionen und ihr Zusammenspiel kennen, tauchen wir in die End-to-End-ML-Entwicklung ein.
Zur Auffrischung des End-to-End-Machine-Learning-Lebenszyklus empfehlen wir unser ausführliches Tutorial. Hier zeigen wir, wie die Funktionen von Databricks Lakehouse AI in den Lebenszyklus passen.
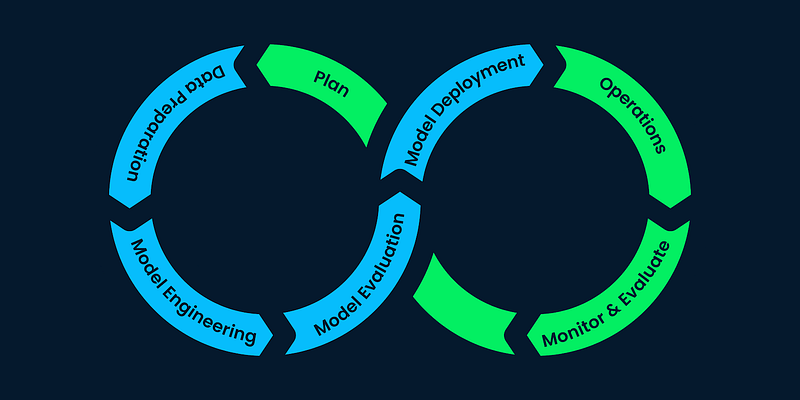
End-to-End Machine-Learning-Entwicklung (Quelle)
Die Basis für ML im Databricks Lakehouse AI ist die Fähigkeit, Modelle effizient zu bauen und zu trainieren.
Mit dem Databricks-ML-Runtime inklusive gängiger Pakete wie pandas und PySpark bereiten wir Daten auf und reinigen sie. Der Databricks Feature Store ist ein zentraler Speicher im Lakehouse AI – für das Speichern, Teilen und Verwalten von ML-Features.
So sind die Features für Training und spätere Inferenz konsistent. Und wir verschwenden keine Rechenressourcen, indem wir Features immer wieder neu berechnen.
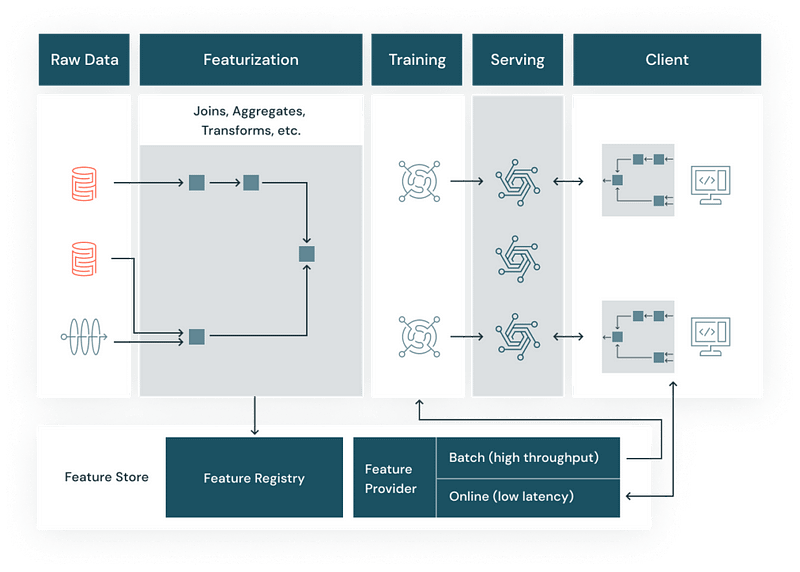
Die Aufgabe eines Feature Stores (Quelle)
Durch die zentrale Definition und Ablage von Features wird das „Training-Serving Skew“ vermieden – wenn Trainingsdaten von Live-Daten abweichen.
Für die Modellentwicklung können wir kuratierte, vorgefertigte Modelle im Databricks-Umfeld nutzen oder eigene, auf Daten und Business-Anforderungen zugeschnittene Modelle trainieren.
Databricks stellt zudem GPU-optimierte Cluster bereit. Training und Inferenz laufen dadurch schneller und skaliert – entscheidend für Echtzeit-Insights, Prognosen und Empfehlungen im großen Stil.
Databricks hat mit MLflow ein Open-Source-Tool entwickelt, das nativ in Databricks verfügbar ist und das Tracken von Experimenten, das Verpacken von Code in reproduzierbare Runs und das Teilen der Ergebnisse vereinfacht.
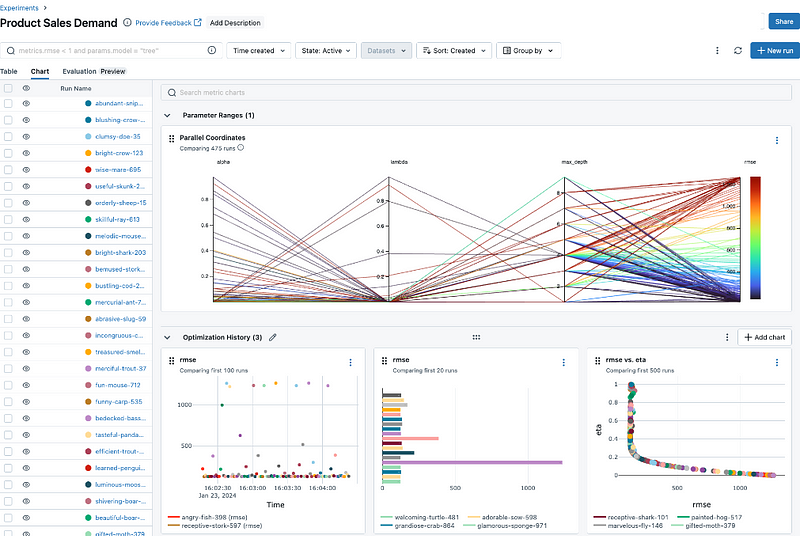
Ein Beispiel-Experiment in MLflow (Screenshot des Autors)
So baust du einen Experimentierrahmen auf:
Steht der Rahmen, können wir schnell iterieren und früh das beste Modell finden.
Model Serving, eine weitere Lakehouse-AI-Funktion, macht den Übergang vom Entwicklungs- zum produktionsreifen Modell nahtlos.
Modelle lassen sich als RESTful Endpoints bereitstellen und damit einfach in Anwendungen und Services für Echtzeitvorhersagen oder Batch-Inferenz integrieren.
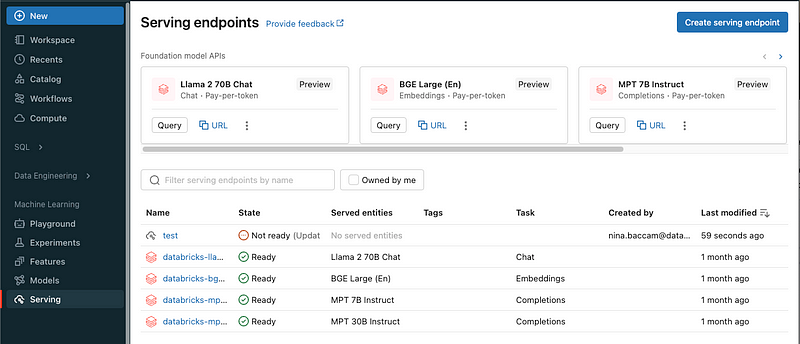
Model-Serving-Endpunkte (Quelle)
Nach dem Training können Data Scientists das Modell mit wenigen Klicks deployen – ohne großen Setup- oder DevOps-Aufwand. So geht’s:
Wir empfehlen die ausführlichen Tutorial-Beispiele von Databricks für eine reibungslose Umsetzung. Schnelles Deployment ist entscheidend, wenn zügige Iterationen messbaren Business-Mehrwert liefern sollen.
Sind Modelle in Produktion, folgt die letzte, entscheidende Phase im KI-Lebenszyklus: Monitoring und Bewertung. Dabei wird die Modellleistung kontinuierlich überwacht, damit sie dauerhaft wirksam und präzise bleibt.
Databricks Lakehouse AI unterstützt das mit Lakehouse Monitoring und Inference Tables – essenziell für stabile, wirksame KI-Systeme. Da wir Lakehouse Monitoring bereits betrachtet haben, fokussieren wir hier die Inference Tables.
Kurz gesagt: Der Inference Table ist ein zuschaltbares Feature, das Eingabedaten und zugehörige Vorhersagen der Model-Serving-Endpunkte erfasst und in einer Delta-Tabelle protokolliert, die Teil des Unity Catalog ist.
Das bringt mehrere Vorteile:
Der ML-Entwicklungsprozess ist zyklisch: Feedback aus der ersten Version fließt in Verfeinerung, Retraining und bessere Modelle – und es geht von vorne los.
Dieses Tutorial hat die Entwicklung von Databricks Lakehouse AI und seine Kernfunktionen vorgestellt. Wir haben gesehen, wie sie über einheitliche Governance zusammenspielen, und wie sich der gesamte Machine-Learning-Lebenszyklus mit der Databricks Lakehouse AI Plattform umsetzen lässt.
Um Databricks Lakehouse und den Einsatz in Data Engineering, ML-Entwicklung und beim Bau großskaliger Anwendungen praxisnah kennenzulernen, empfehlen wir als nächsten Schritt unseren Kurs Introduction to Databricks.
Starte heute deine KI-Reise!
Kurs
Kurs
Kurs