
Khóa học
Các khái niệm về Generative AI
2 giờ
121.2K
Databricks là một trong những đơn vị tiên phong xây dựng công nghệ và nền tảng giúp triển khai các giải pháp AI ở quy mô lớn, bao gồm dẫn dắt các dự án nguồn mở như Apache Spark và MLflow.
Tại Data + AI Summit 2023 của Databricks, Lakehouse AI đã được công bố là nền tảng AI đầu tiên trên thế giới, được tích hợp ngay trong lớp dữ liệu — đồng thời nhiều tính năng mới khác cũng được giới thiệu. Với sự ra mắt của ChatGPT và những bước nhảy vọt của công nghệ AI tạo sinh trên toàn thế giới, Lakehouse AI là câu trả lời của Databricks cho việc xây dựng ứng dụng AI tạo sinh theo hướng lấy dữ liệu làm trung tâm.
Trong hướng dẫn này, chúng ta sẽ giới thiệu nền tảng Databricks Lakehouse AI, bàn về ý nghĩa của nó, tìm hiểu các tính năng mới được ra mắt và cách tận dụng chúng trong vòng đời phát triển machine learning.
Khoan đã, Lakehouse là gì? Chúng tôi hiểu đây có thể là những thuật ngữ còn mới với bạn.
Hãy cùng phân tích quá trình hình thành của Databricks Lakehouse AI theo từng bước. Để hiểu Lakehouse AI — trước hết chúng ta cần nắm rõ kiến trúc Lakehouse.
“Lakehouse” là một kiến trúc quản trị dữ liệu hiện đại, kết hợp tính linh hoạt và hiệu quả chi phí của data lake với các tính năng quản lý dữ liệu của data warehouse.
Chúng tôi có một hướng dẫn đầy đủ về sự khác nhau giữa data lake và data warehouse. Tóm lược như sau:
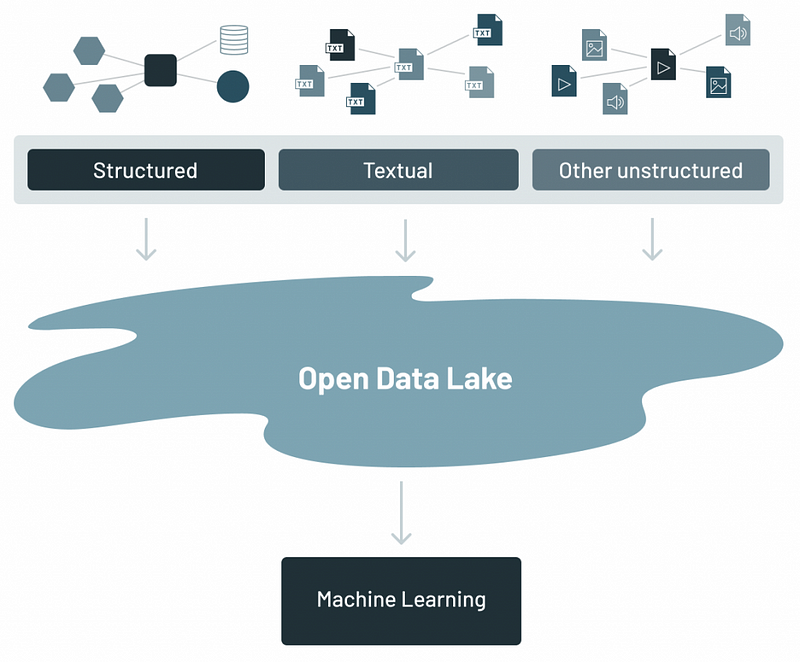
Kiến trúc data lake (Nguồn)
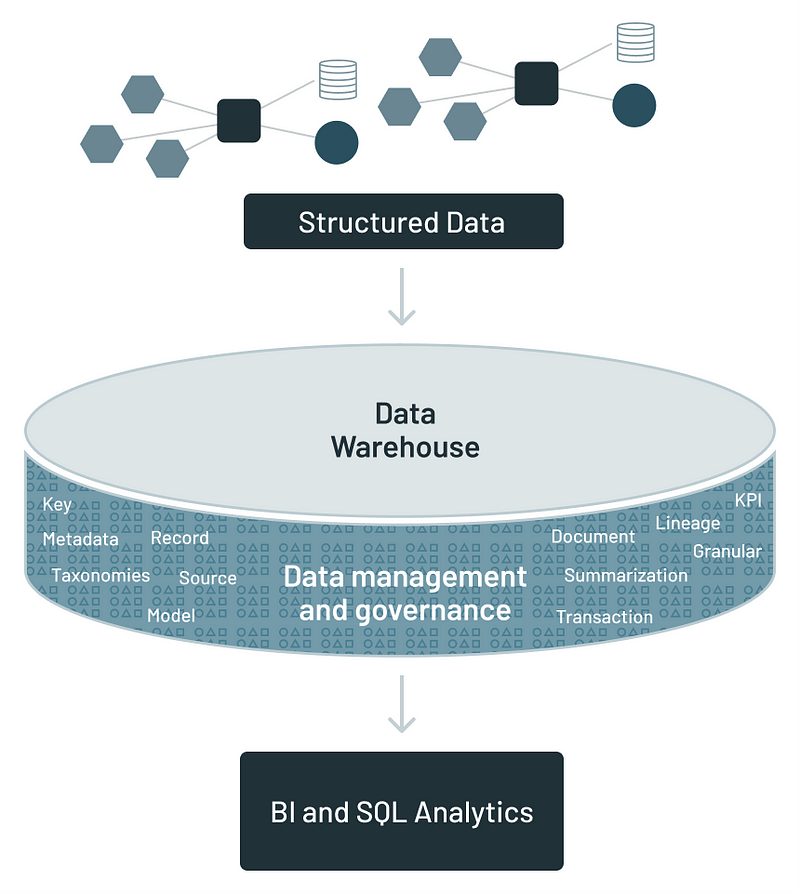
Kiến trúc data warehouse (Nguồn)
Data lake thường gặp khó khăn trong quản trị và quản lý dữ liệu do đặc thù lưu trữ lượng lớn dữ liệu thô, không có cấu trúc, dễ biến thành “đầm lầy dữ liệu” nơi dữ liệu khó tìm, khó truy cập hoặc khó tin cậy. Thiếu cấu trúc cũng có thể cản trở hiệu năng của các truy vấn phân tích phức tạp, và các data lake truyền thống thường không hỗ trợ tốt các thao tác dữ liệu giao dịch, thiếu khả năng giao dịch ACID vốn rất quan trọng để đảm bảo tính toàn vẹn dữ liệu.
Ngược lại, data warehouse được tối ưu cho dữ liệu có cấu trúc và phân tích, nhưng chi phí có thể tăng cao khi dữ liệu phình to. Yêu cầu cấu trúc và xử lý dữ liệu theo lược đồ định sẵn có thể tạo ra sự cứng nhắc, hạn chế khả năng nhanh chóng nạp và phân tích các loại dữ liệu mới.
Những hạn chế này đã thúc đẩy sự ra đời của kiến trúc Lakehouse, nhằm dung hòa ưu điểm của cả hai:
Kiến trúc lakehouse trông như sau:
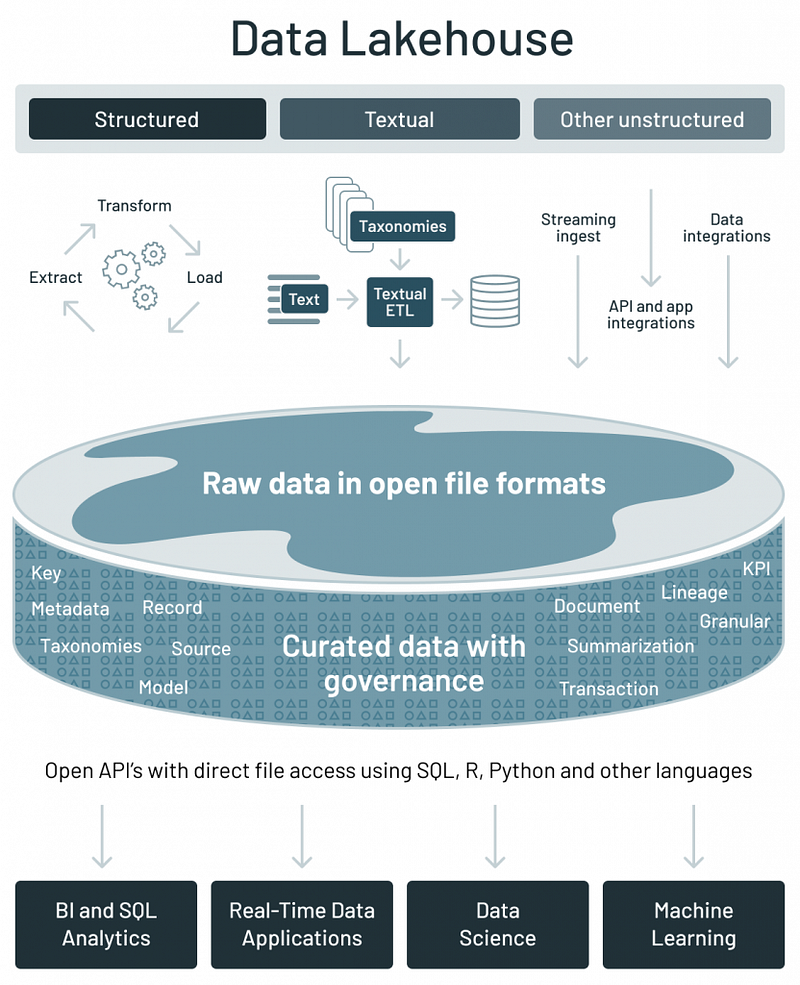
Kiến trúc data lakehouse (Nguồn)
Giờ đây khi đã hiểu quá trình phát triển của Databricks Lakehouse, chúng ta đến với câu hỏi cuối cùng.
Lakehouse AI là việc tích hợp trực tiếp các khả năng trí tuệ nhân tạo và machine learning vào kiến trúc Lakehouse. Nghĩa là chúng ta có thể phát triển, huấn luyện và triển khai mô hình AI ngay trên khối dữ liệu khổng lồ lưu trong data lake mà không cần di chuyển hay sao chép dữ liệu sang môi trường xử lý riêng.
Ý nghĩa của nền tảng này là:
Những điểm này lý giải vì sao Databricks giới thiệu đây là nền tảng AI đầu tiên trên thế giới được tích hợp vào lớp dữ liệu.
Việc chuyển sang Lakehouse AI đã đóng vai trò quan trọng trong việc thúc đẩy doanh nghiệp vận hành dựa trên dữ liệu và tích hợp AI nhiều hơn.
Trung tâm của chuyển đổi này là một số thành phần cốt lõi hỗ trợ phát triển, triển khai và quản trị các mô hình AI và machine learning. Hiểu được vì sao và khi nào cần các thành phần này sẽ giúp tổ chức khai thác dữ liệu hiệu quả hơn cho ứng dụng AI.
Vector Search trong Databricks Lakehouse AI là một bước tiến lớn (cũng được ra mắt tại Data+AI Summit 2023) trong việc xử lý và tìm kiếm qua các tập dữ liệu khổng lồ để phát hiện thông tin tương đồng về ngữ nghĩa, thay vì chỉ dựa vào đối sánh từ khóa truyền thống.
Vector Search hoạt động bằng cách chuyển đổi dữ liệu và truy vấn thành các vector trong không gian nhiều chiều gọi là embeddings, được suy ra từ một mô hình AI tạo sinh. Cách này giúp các từ hoặc khái niệm tương đồng về ngữ nghĩa nằm gần nhau trong không gian n-chiều, cho phép trả về kết quả tìm kiếm liên quan và có ngữ cảnh hơn.
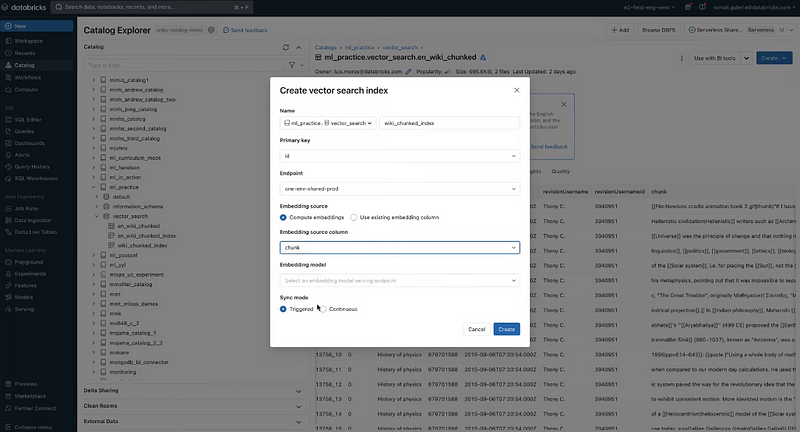
Vector search (Ảnh chụp màn hình bởi tác giả)
Quy trình sử dụng Vector Search (video demo của Databricks) như sau:
Các công ty như Lippert đã sử dụng Vector Search để giúp nhân viên nhanh chóng tìm câu trả lời cho thắc mắc của khách hàng bằng cách nạp nội dung từ nhiều nguồn khác nhau vào Vector Search.
Các mô hình này, có sẵn trong Databricks Marketplace, được tối ưu cho hiệu năng cao và được thiết kế để tích hợp dễ dàng vào môi trường Lakehouse cho nhiều ứng dụng, từ phân tích và tạo văn bản đến xử lý hình ảnh.
Một số mô hình AI tạo sinh được tuyển chọn gồm:
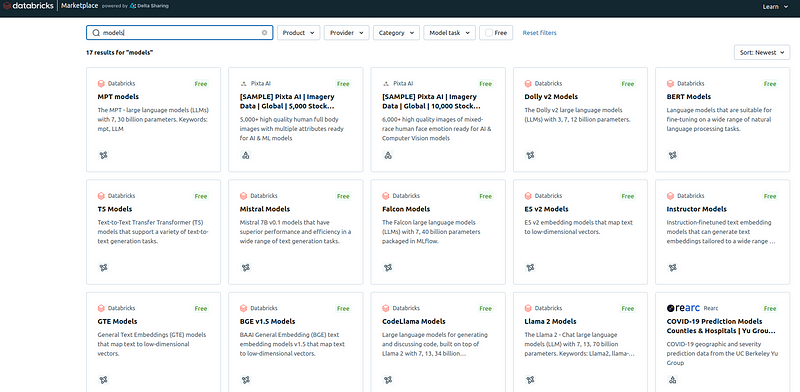
Các mô hình có sẵn trong Databricks Marketplace (Ảnh chụp màn hình bởi tác giả)
Các mô hình này được thiết kế để hoạt động liền mạch với bộ tính năng rộng hơn của Databricks Lakehouse AI, bao gồm quản lý dữ liệu, phân tích và công cụ MLOps. Chúng ta sẽ sớm xem cách dùng chúng trong phát triển machine learning.
Tính năng AutoML (Automated Machine Learning) trong Databricks Lakehouse AI được thiết kế để hợp lý hóa và tự động hóa quá trình phát triển mô hình machine learning, giúp khoa học dữ liệu nâng cao trở nên dễ tiếp cận hơn với đông đảo người dùng, kể cả những người ít kinh nghiệm về machine learning.
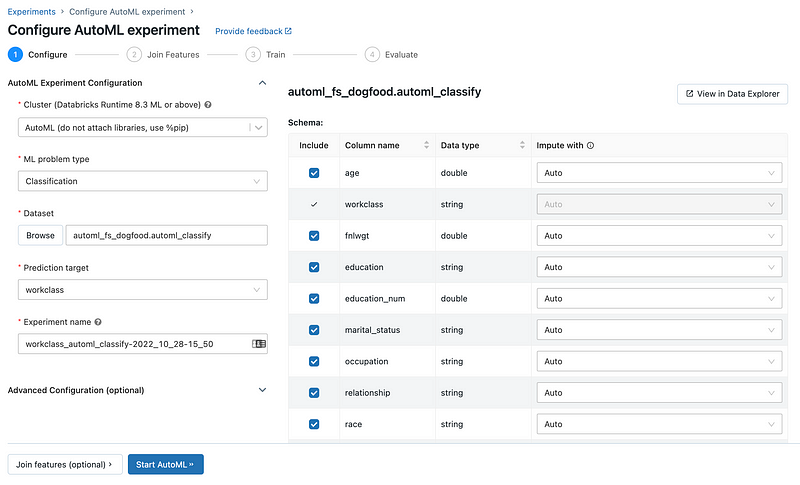
Databrick AutoML (Nguồn)
Khi chúng ta cung cấp bộ dữ liệu và xác định mục tiêu dự đoán, AutoML sẽ lo việc chuẩn bị dữ liệu sẵn sàng để huấn luyện mô hình. Sau đó, AutoML tạo, tinh chỉnh và đánh giá nhiều mô hình qua một loạt thử nghiệm.
Khi đánh giá hoàn tất, AutoML trình bày kết quả và cung cấp một notebook Python chứa mã nguồn cho từng thử nghiệm. Điều này cho phép chúng ta xem, tái lập và chỉnh sửa mã khi cần. AutoML cũng tính toán thống kê tóm tắt về bộ dữ liệu và lưu thông tin này trong một notebook để tham khảo sau.
Với bản ra mắt mới nhất, AutoML hiện hỗ trợ tinh chỉnh các mô hình AI tạo sinh cho phân loại văn bản và các mô hình embedding với dữ liệu riêng của khách hàng. Điều này có nghĩa là người dùng doanh nghiệp không chuyên kỹ thuật cũng có thể dùng AutoML để xây dựng ứng dụng AI tạo sinh chỉ với vài cú nhấp chuột.
Databricks Lakehouse Monitoring cho phép chúng ta theo dõi các đặc tính thống kê và chất lượng của các bảng dữ liệu, cũng như theo dõi hiệu năng của mô hình machine learning và dự đoán của chúng. Bằng cách quan sát luồng dữ liệu trong pipeline của Databricks, tính năng này giúp đảm bảo việc giám sát liên tục về chất lượng dữ liệu và hiệu quả của mô hình.
Dưới đây là cách dữ liệu luân chuyển qua Lakehouse Monitoring để kích hoạt giám sát liên tục:
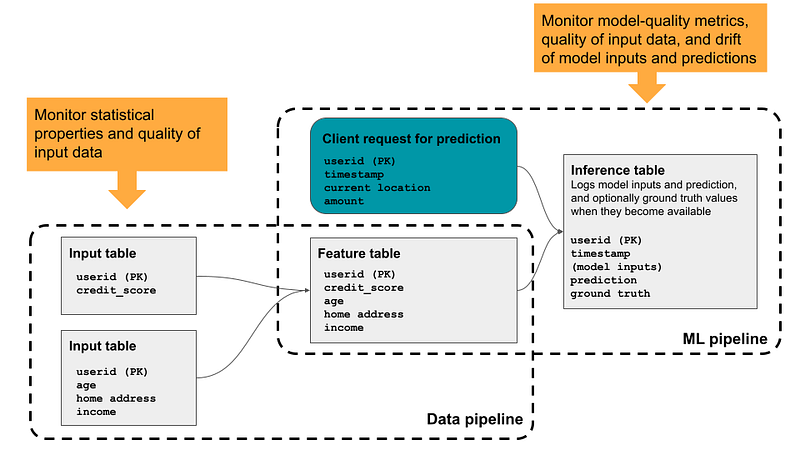
Luồng Lakehouse Monitoring (Nguồn)
Không chỉ dừng lại ở giám sát, tính năng này còn cung cấp những thông tin có thể hành động về các khía cạnh như tính toàn vẹn dữ liệu, phân phối dữ liệu, độ trôi và hiệu năng mô hình theo thời gian.
Giờ hãy xem cách tất cả những tính năng này kết hợp lại thành mô hình quản trị hợp nhất trong Lakehouse AI.
Ý tưởng về quản trị hợp nhất là có thể truy cập, kiểm soát, cộng tác, giám sát và hành động trên dữ liệu, mô hình machine learning và các tài sản AI khác ở một nơi. Khi tổ chức phát triển và trưởng thành trong hành trình chuyển đổi AI, khả năng quản lý mọi thứ tập trung là tối quan trọng.
Databricks Unity Catalog làm đúng điều đó, và việc hợp nhất phương pháp quản trị tài sản AI về cơ bản giúp tăng tốc độ ứng dụng AI đồng thời vẫn đảm bảo tuân thủ quy định.
Bên cạnh các tính năng hữu ích như trình khám phá dữ liệu và khả năng thêm hệ thống bên ngoài, điểm nổi bật là có thể quan sát toàn cảnh việc quản trị các tài sản này thông qua một Cổng quản trị Unity Catalog đơn giản như dưới đây:
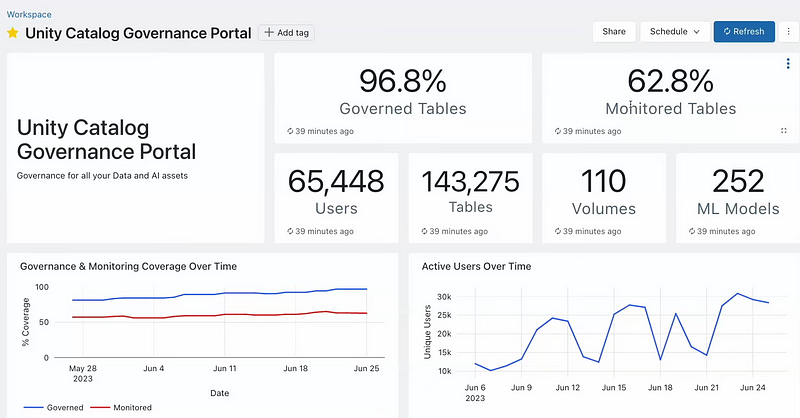
Cổng quản trị Unity Catalog (Ảnh chụp màn hình bởi tác giả)
Cổng này hiển thị các chỉ số chính như tỷ lệ bảng được quản trị và giám sát, số người dùng hoạt động, số lượng bảng, volume và mô hình ML. Cái nhìn tổng quan này giúp nhanh chóng đánh giá trạng thái quản trị và mức độ tương tác với tài sản dữ liệu.
Bảng điều khiển cũng cho thấy mức độ hoạt động của người dùng theo thời gian, hỗ trợ hiểu cách tài sản dữ liệu được sử dụng trong tổ chức và xác định nút thắt cổ chai hoặc nhu cầu đào tạo.
Ngoài ra, cổng còn liệt kê các rủi ro quản trị tiềm ẩn bằng cách xác định các vấn đề như bảng chưa được giám sát hoặc cột bắt nguồn từ PII (Thông tin nhận dạng cá nhân), cung cấp cách tiếp cận chủ động để quản lý dữ liệu an toàn, như minh họa dưới đây.
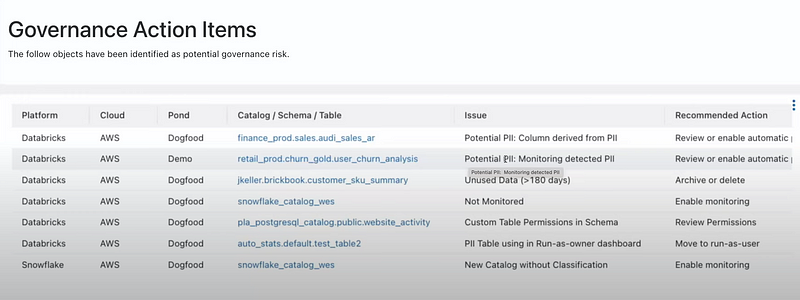
Giao diện hạng mục hành động quản trị trên bảng điều khiển Unity Catalog (Ảnh chụp màn hình bởi tác giả)
Mỗi vấn đề được xác định đều đi kèm hành động khuyến nghị, hướng dẫn người dùng giải quyết các mối quan ngại về quản trị. Tính năng này đơn giản hóa và hợp nhất quá trình vốn phức tạp khi quản trị tài sản AI và dữ liệu trên toàn nền tảng.
Khi đã hiểu các tính năng và cách chúng kết hợp, hãy đi sâu vào ứng dụng của nền tảng cho phát triển machine learning đầu cuối.
Để ôn lại vòng đời phát triển machine learning, chúng tôi khuyến nghị bạn xem hướng dẫn chuyên sâu. Trong phần này, chúng ta sẽ hiểu cách các tính năng của Databricks Lakehouse AI khớp vào vòng đời đó.
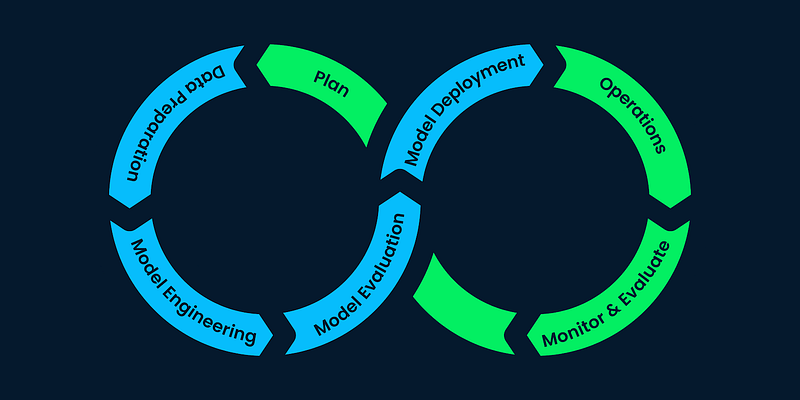
Phát triển Machine Learning đầu cuối (Nguồn)
Nền tảng của machine learning trong Databricks Lakehouse AI là khả năng huấn luyện và xây dựng mô hình hiệu quả.
Chúng ta có thể sử dụng ML runtime của Databricks đi kèm các gói phổ biến như pandas và PySpark để chuẩn bị và làm sạch dữ liệu. Databricks Feature Store là một kho tập trung trong Nền tảng Databricks Lakehouse AI — được thiết kế để lưu trữ, chia sẻ và quản lý các đặc trưng (feature) machine learning.
Feature Store đảm bảo các đặc trưng dùng để huấn luyện mô hình nhất quán với đặc trưng dùng khi suy luận trong môi trường sản xuất. Chúng ta cũng không phải lãng phí tài nguyên tính toán bằng cách tính lại đặc trưng lặp đi lặp lại cho các trường hợp sử dụng khác nhau.
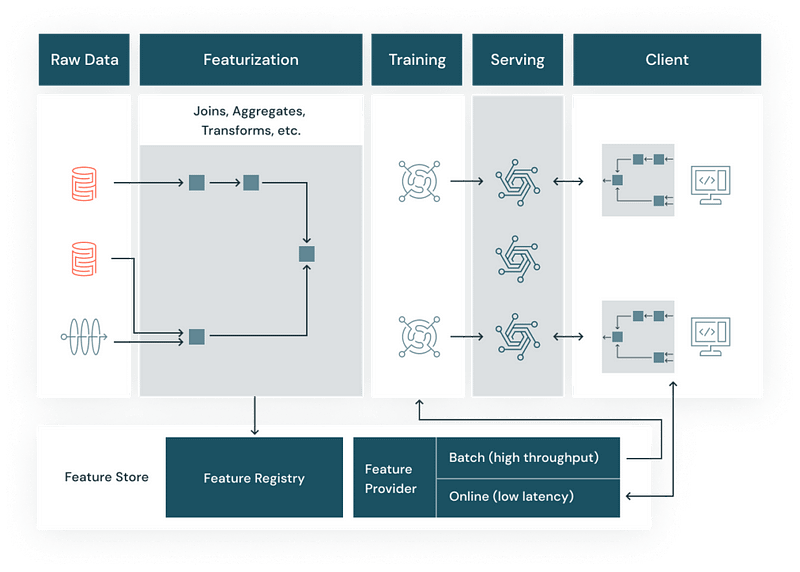
Chức năng của feature store (Nguồn)
Bằng cách tập trung hóa định nghĩa và lưu trữ đặc trưng, nó loại bỏ vấn đề phổ biến “lệch giữa huấn luyện và phục vụ”, khi dữ liệu dùng để huấn luyện khác với dữ liệu mô hình gặp trong môi trường thực tế.
Đối với phát triển mô hình, chúng ta có thể linh hoạt chọn từ các mô hình được tuyển chọn sẵn trong môi trường Databricks hoặc tự huấn luyện mô hình tùy chỉnh phù hợp với dữ liệu và yêu cầu kinh doanh cụ thể.
Databricks cũng có các cụm GPU tối ưu, giúp việc huấn luyện (và suy luận) diễn ra nhanh hơn và ở quy mô lớn, điều này thường then chốt khi cần thông tin theo thời gian thực, dự đoán và gợi ý ở quy mô.
Databricks đã phát triển công cụ nguồn mở MLflow, được tích hợp sẵn trong nền tảng Databricks, giúp đơn giản hóa quá trình theo dõi thí nghiệm, đóng gói mã thành các lần chạy có thể tái lập và chia sẻ phát hiện.
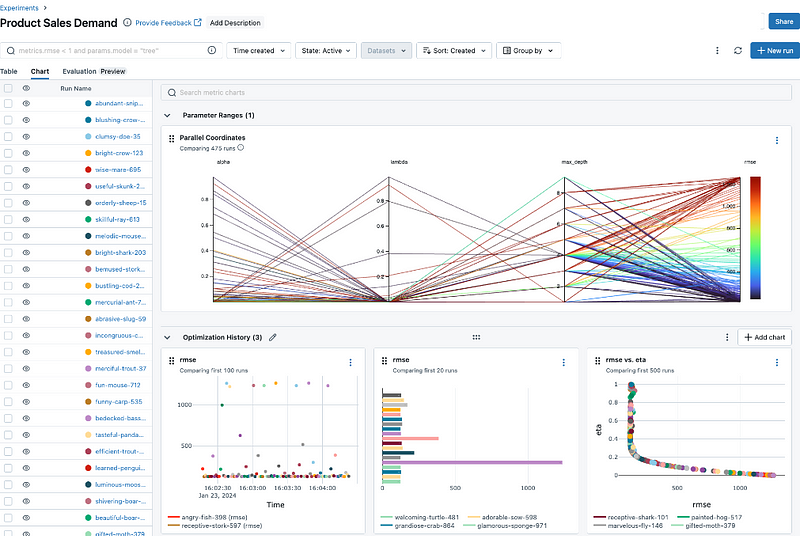
Ví dụ một thí nghiệm MLflow (Ảnh chụp màn hình bởi tác giả)
Các bước xây dựng khung thực nghiệm như sau:
Sau khi khung được thiết lập, chúng ta có thể lặp nhanh để sớm tìm ra mô hình tốt nhất.
Model Serving, một tính năng khác trong Databricks Lakehouse AI, giúp đơn giản hóa việc chuyển mô hình machine learning từ giai đoạn phát triển sang trạng thái sẵn sàng sản xuất.
Tính năng này cho phép triển khai mô hình dưới dạng endpoint RESTful, có thể dễ dàng tích hợp vào nhiều ứng dụng và dịch vụ để dự đoán thời gian thực hoặc suy luận theo lô.
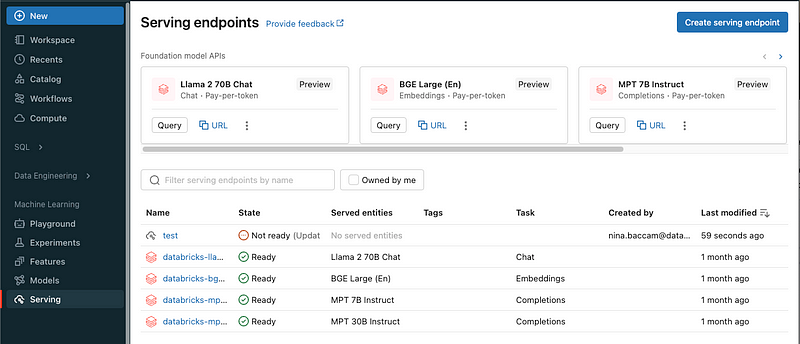
Model Serving endpoints (Nguồn)
Khi mô hình đã được huấn luyện, nhà khoa học dữ liệu có thể triển khai chỉ với vài cú nhấp chuột mà không cần nhiều thiết lập hay chuyên môn DevOps. Cách thực hiện như sau:
Chúng tôi khuyến nghị bạn xem các ví dụ hướng dẫn chi tiết từ Databricks để thực hiện các bước này dễ dàng. Sự tiện lợi khi triển khai là tối quan trọng trong các quy trình dữ liệu hiện đại, nơi khả năng lặp nhanh và triển khai mô hình có thể mang lại giá trị kinh doanh đáng kể.
Khi mô hình machine learning được triển khai vào sản xuất, giai đoạn cuối cùng nhưng quan trọng trong vòng đời AI là giám sát và đánh giá. Giai đoạn này bao gồm theo dõi liên tục hiệu năng của mô hình để đảm bảo nó luôn hiệu quả và chính xác theo thời gian.
Databricks Lakehouse AI hỗ trợ điều này thông qua Lakehouse Monitoring và Inference Tables, những công cụ thiết yếu để duy trì sức khỏe và hiệu lực của hệ thống AI. Vì chúng ta đã xem các tính năng của Lakehouse Monitoring trước đó, phần này sẽ tập trung vào inference table.
Nói đơn giản, Inference Table là một tính năng bổ sung, bạn cần bật bằng một ô chọn, cho phép ghi lại dữ liệu đầu vào và dự đoán tương ứng từ các Model Serving endpoint vào một bảng delta, vốn là một phần của Unity Catalog.
Cơ chế ghi log này mang lại nhiều lợi ích:
Quy trình phát triển machine learning mang tính chu kỳ, nghĩa là chúng ta lấy phản hồi từ phiên bản triển khai đầu tiên để tinh chỉnh, huấn luyện lại và xây dựng các mô hình chính xác, hiệu quả hơn, quay trở lại bước đầu tiên.
Hướng dẫn này đã giới thiệu quá trình phát triển của Databricks Lakehouse AI và các tính năng cốt lõi. Chúng ta cũng đã xem cách các tính năng này kết hợp trong một mô hình quản trị hợp nhất. Tiếp đó, chúng ta phân tích và hiểu cách dẫn dắt qua vòng đời machine learning đầu cuối bằng nền tảng Databricks Lakehouse AI.
Để tìm hiểu thêm về Databricks Lakehouse và ứng dụng của nó trong kỹ thuật dữ liệu, phát triển machine learning, và xây dựng ứng dụng quy mô lớn theo cách thực hành, chúng tôi khuyến nghị bạn xem khóa học Giới thiệu về Databricks như bước tiếp theo.
Khởi đầu hành trình AI của bạn ngay hôm nay!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
