
Kursus
Konsep Generative AI
2 jam
121.1K
Databricks adalah salah satu pelopor dalam membangun teknologi dan platform yang membantu menghadirkan solusi AI dalam skala besar, termasuk mendorong proyek open-source seperti Apache Spark dan MLflow.
Pada saat Data + AI Summit 2023 dari Databrick, Lakehouse AI diumumkan sebagai platform AI pertama di dunia yang dibangun langsung pada lapisan data — dan banyak fitur baru lainnya juga diumumkan. Dengan hadirnya ChatGPT dan lompatan besar teknologi AI generatif di seluruh dunia, Lakehouse AI adalah jawaban Databrick untuk membangun aplikasi AI generatif melalui pendekatan yang berpusat pada data.
Dalam tutorial ini, kami akan memperkenalkan platform Databricks Lakehouse AI, mempertimbangkan signifikansinya, memahami fitur-fitur baru yang diluncurkan, dan bagaimana kita dapat memanfaatkannya dalam siklus pengembangan machine learning.
Tunggu, Lakehouse? Kami paham ini mungkin istilah baru bagi Anda.
Mari uraikan evolusi Databricks Lakehouse AI selangkah demi selangkah. Untuk memahami Lakehouse AI — kita perlu benar-benar memahami arsitektur Lakehouse terlebih dahulu.
“Lakehouse” adalah arsitektur manajemen data modern yang menggabungkan fleksibilitas dan efisiensi biaya dari data lake dengan fitur manajemen data dari data warehouse.
Kami memiliki tutorial lengkap tentang perbedaan antara data lake dan data warehouse secara rinci, namun singkatnya, berikut maknanya:
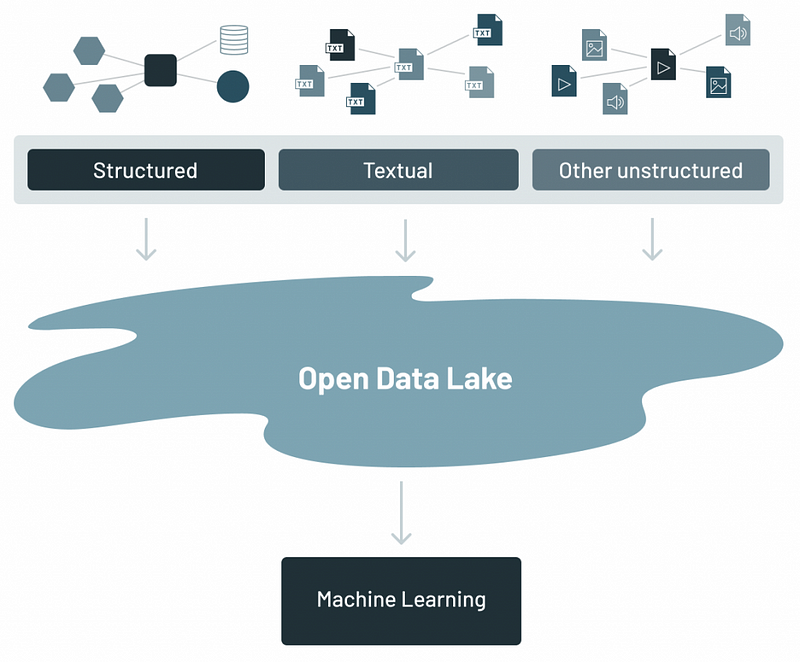
Arsitektur data lake (Sumber)
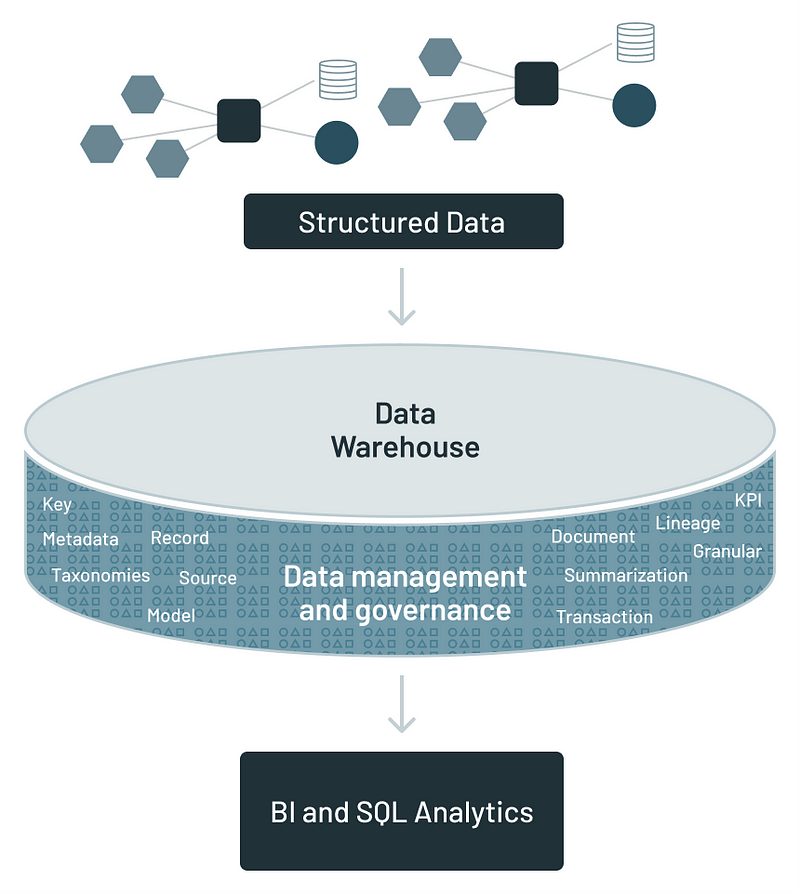
Arsitektur data warehouse (Sumber)
Data lake sering kesulitan dalam manajemen dan tata kelola data karena sifatnya yang menyimpan data mentah tidak terstruktur dalam jumlah besar, yang dapat menyebabkan “rawa data” (data swamp) di mana data sulit ditemukan, diakses, atau dipercaya. Kurangnya struktur juga dapat menghambat kinerja kueri analitis yang kompleks, dan data lake tradisional biasanya tidak mendukung operasi data transaksional dengan baik, karena tidak memiliki kemampuan transaksi ACID yang krusial untuk memastikan integritas data.
Sebaliknya, data warehouse dioptimalkan untuk data terstruktur dan analitik namun dapat menjadi mahal saat skalanya diperbesar seiring meningkatnya volume data. Persyaratan agar data harus disusun dan diproses ke dalam skema yang telah ditentukan dapat menimbulkan kekakuan, membatasi kemampuan untuk dengan cepat mengambil dan menganalisis jenis data baru.
Keterbatasan-keterbatasan ini mendorong evolusi arsitektur Lakehouse, yang bertujuan menghadirkan keunggulan dari keduanya:
Berikut tampilan arsitektur lakehouse:
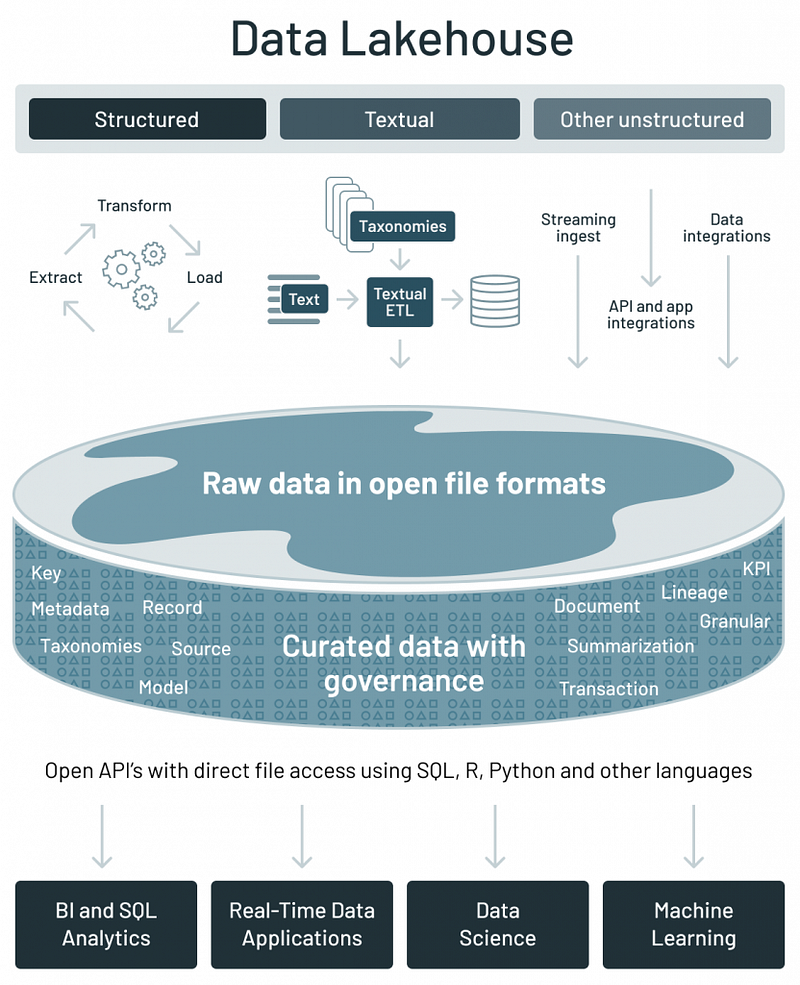
Arsitektur data lakehouse (Sumber)
Kini setelah kita memahami evolusi Databricks Lakehouse, tibalah pada pertanyaan terakhir.
Lakehouse AI adalah integrasi kemampuan kecerdasan buatan dan machine learning langsung ke dalam arsitektur Lakehouse. Artinya kita dapat mengembangkan, melatih, dan menerapkan model AI menggunakan data dalam jumlah besar yang tersimpan di data lake tanpa perlu memindahkan atau menyalin data ke lingkungan terpisah untuk diproses.
Signifikansi platform ini adalah:
Fitur-fitur ini menjelaskan mengapa Databricks mengumumkan platform ini sebagai platform AI pertama di dunia yang dibangun ke dalam lapisan data.
Transisi ke Lakehouse AI berperan penting dalam mendorong bisnis menuju operasi yang lebih berbasis data dan terintegrasi AI.
Di jantung transformasi ini terdapat beberapa komponen inti yang memfasilitasi pengembangan, penyebaran, dan pengelolaan model AI dan machine learning. Memahami mengapa dan kapan komponen ini dibutuhkan dapat membantu organisasi memanfaatkan data mereka secara lebih efektif untuk aplikasi AI.
Vector Search di Databricks Lakehouse AI merupakan kemajuan signifikan (juga diluncurkan di Data+AI Summit 2023) dalam menangani dan menelusuri himpunan data masif untuk menemukan informasi yang mirip secara semantik, bukan sekadar mengandalkan kecocokan kata kunci tradisional.
Vector Search bekerja dengan mengonversi data dan kueri menjadi vektor dalam ruang multi-dimensi yang disebut embedding, yang diturunkan dari model AI Generatif. Metode ini membuat kata atau konsep yang secara semantik mirip menjadi lebih dekat dalam ruang n-dimensi, sehingga menghasilkan hasil pencarian yang lebih relevan dan kontekstual.
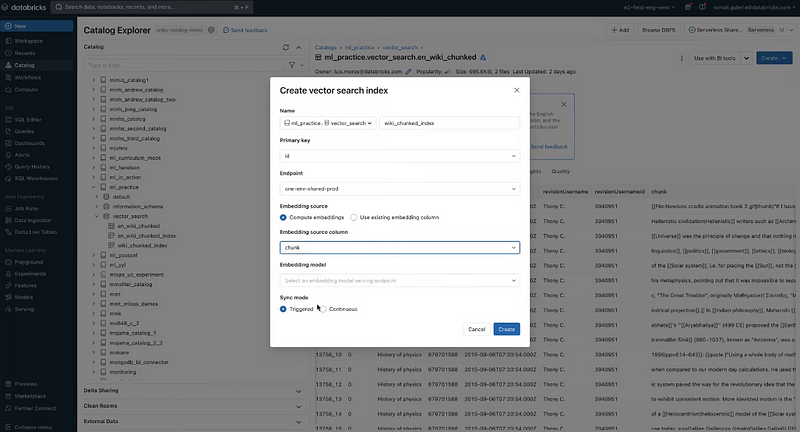
Pencarian vektor (Tangkapan layar oleh penulis)
Proses menggunakan Vector Search (video demo oleh Databricks) adalah sebagai berikut:
Perusahaan seperti Lippert telah menggunakan Vector Search untuk membantu agen menemukan jawaban atas pertanyaan pelanggan dengan cepat, dengan memasukkan konten dari berbagai sumber ke dalam Vector Search.
Model-model ini, tersedia di Databricks Marketplace, dioptimalkan untuk kinerja tinggi dan dirancang agar mudah diintegrasikan ke dalam lingkungan Lakehouse untuk beragam aplikasi, mulai dari analisis dan pembuatan teks hingga pemrosesan gambar.
Beberapa model AI Generatif terkurasi meliputi:
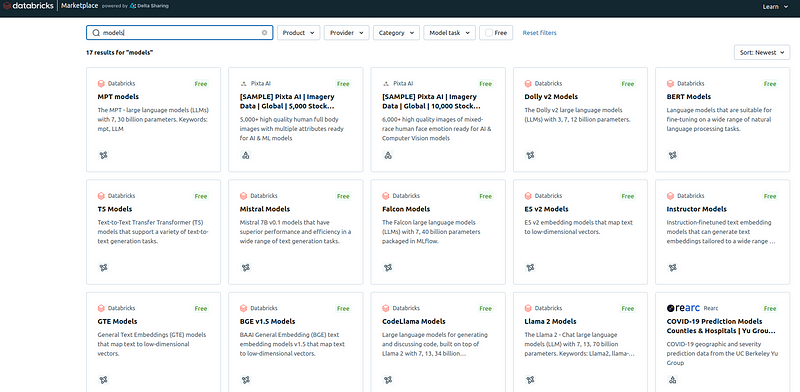
Model yang tersedia di Databricks Marketplace (Tangkapan layar oleh penulis)
Model-model ini dirancang untuk bekerja mulus dengan rangkaian fitur Databricks Lakehouse AI yang lebih luas, termasuk manajemen data, analitik, dan alat MLOps. Kita akan melihat bagaimana model-model ini dapat digunakan dalam pengembangan machine learning sebentar lagi.
Fitur AutoML (Automated Machine Learning) dalam Databricks Lakehouse AI dirancang untuk merampingkan dan mengotomatiskan proses pengembangan model machine learning, sehingga ilmu data tingkat lanjut dapat diakses oleh lebih banyak pengguna, termasuk mereka yang memiliki keahlian machine learning terbatas.
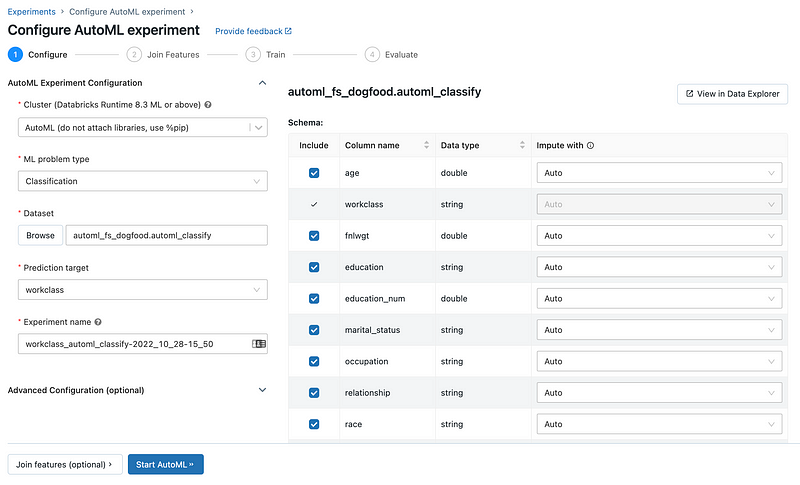
Databrick AutoML (Sumber)
Saat kita menyediakan dataset dan menentukan tujuan prediksi, AutoML menangani penyiapan dataset agar siap untuk melatih model. Selanjutnya AutoML membuat, menyesuaikan, dan mengevaluasi beberapa model melalui serangkaian uji coba.
Setelah evaluasi selesai, AutoML menyajikan hasilnya dan menawarkan notebook Python yang berisi kode sumber untuk setiap uji coba. Ini memungkinkan kita meninjau, mereproduksi, dan memodifikasi kode sesuai kebutuhan. AutoML juga menghitung statistik ringkasan tentang dataset kita dan menyimpan informasi ini dalam sebuah notebook untuk referensi di masa mendatang.
Dengan peluncuran terbaru, AutoML kini menawarkan fine-tuning model AI generatif untuk klasifikasi teks dan model embedding dengan data milik pelanggan sendiri. Artinya pengguna bisnis non-teknis kini dapat menggunakan AutoML untuk membangun aplikasi AI generatif hanya dengan beberapa klik.
Databricks Lakehouse Monitoring memungkinkan kita memantau sifat statistik dan kualitas tabel data serta melacak kinerja model machine learning dan prediksinya. Dengan menelaah alur data dalam pipeline Databricks, fitur pemantauan ini membantu memastikan pemantauan kualitas data dan efektivitas model secara berkelanjutan.
Berikut bagaimana data mengalir melalui pemantauan Lakehouse untuk memungkinkan pemantauan berkelanjutan:
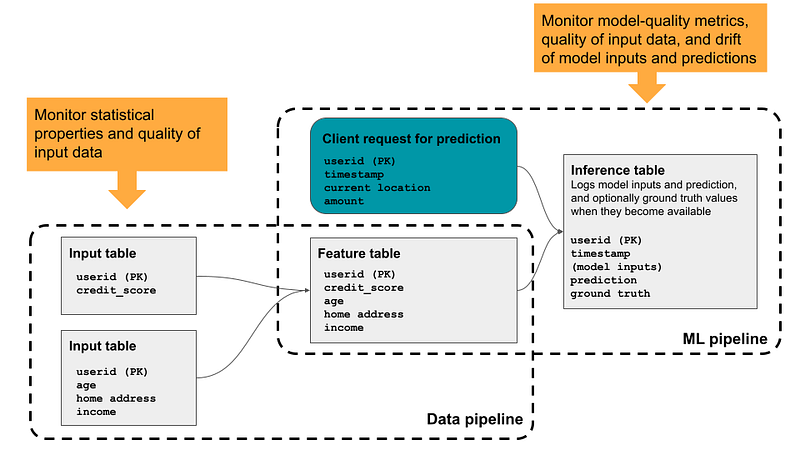
Alur Lakehouse Monitoring (Sumber)
Alih-alih berhenti pada pemantauan, fitur ini juga memberikan wawasan praktis tentang berbagai aspek seperti integritas data, distribusi, drift, dan kinerja model dari waktu ke waktu.
Sekarang mari kita lihat bagaimana semua fitur ini bersatu sebagai tata kelola terpadu di Lakehouse AI.
Gagasan tata kelola terpadu adalah kemampuan untuk mengakses, mengontrol, berkolaborasi, memantau, dan bertindak atas data, model machine learning, dan aset AI lainnya di satu tempat. Seiring bertumbuh dan matangnya organisasi dalam perjalanan transformasi AI, kemampuan mengelola semuanya di satu tempat menjadi krusial.
Databricks Unity Catalog mewujudkan hal tersebut, dan menyatukan pendekatan untuk mengelola aset AI pada dasarnya mempercepat adopsi AI sekaligus tetap memastikan kepatuhan regulasi.
Meskipun ada fitur-fitur berguna seperti penjelajah data dan kemampuan menambahkan sistem eksternal, fitur yang paling menonjol adalah kemampuan melihat gambaran helikopter atas keseluruhan tata kelola aset-aset ini melalui Unity Catalog Governance Portal sederhana seperti ditunjukkan di bawah:
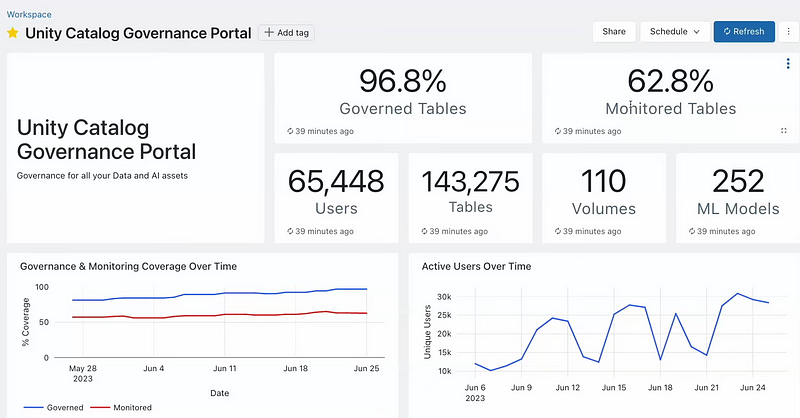
Portal tata kelola Unity catalog (Tangkapan layar oleh penulis)
Portal ini menampilkan metrik utama seperti persentase tabel yang diatur dan dipantau, jumlah pengguna aktif, serta jumlah tabel, volume, dan model ML. Tampilan tingkat tinggi ini membantu menilai dengan cepat status tata kelola dan tingkat keterlibatan aktif terhadap aset data.
Dasbor ini juga menunjukkan tingkat aktivitas pengguna dari waktu ke waktu, yang dapat membantu memahami bagaimana aset data dimanfaatkan dalam organisasi dan mengidentifikasi potensi hambatan atau kebutuhan pelatihan.
Selain itu, portal mencantumkan potensi risiko tata kelola dengan mengidentifikasi isu seperti tabel yang tidak dipantau atau kolom yang diturunkan dari PII (Personally Identifiable Information), sehingga memberikan pendekatan proaktif untuk mengelola data secara aman, seperti terlihat di bawah ini.
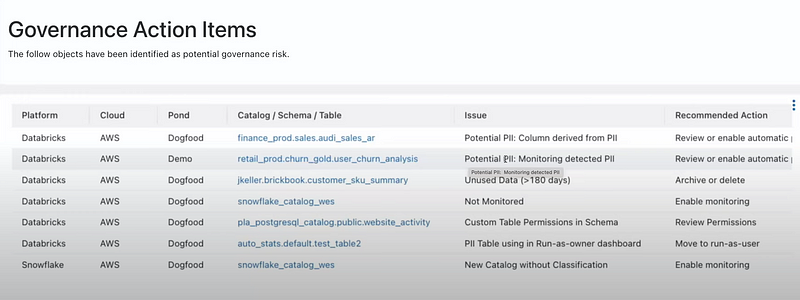
Tampilan item tindakan tata kelola pada dasbor unity catalog (Tangkapan layar oleh penulis)
Setiap isu yang teridentifikasi disertai rekomendasi tindakan, membimbing pengguna untuk menyelesaikan potensi kekhawatiran tata kelola. Fitur ini menyederhanakan dan menyatukan proses tata kelola aset AI dan data yang sering kali kompleks di seluruh platform.
Setelah memahami fitur-fitur platform dan bagaimana semuanya terhubung, kini mari kita telusuri penerapannya untuk pengembangan machine learning end-to-end.
Sebagai penyegar tentang siklus pengembangan machine learning end-to-end, kami menganjurkan Anda merujuk pada tutorial mendalam kami. Pada bagian ini, kita akan memahami bagaimana fitur-fitur Databricks Lakehouse AI cocok dengan siklus tersebut.
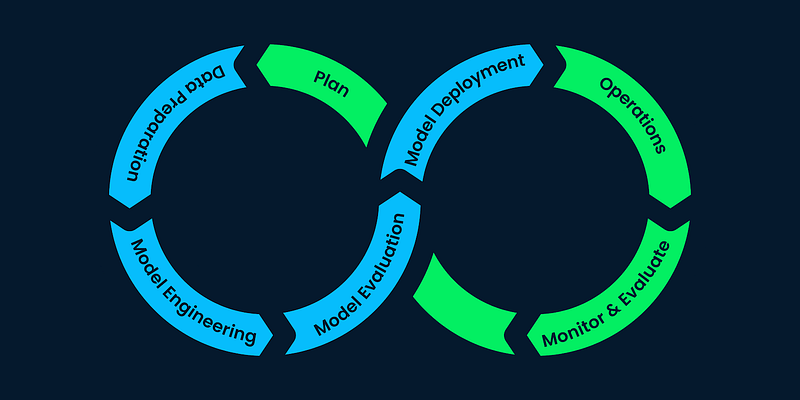
Pengembangan Machine Learning End-to-end (Sumber)
Batu fondasi machine learning dalam Databricks Lakehouse AI adalah kemampuan untuk melatih dan membangun model secara efisien.
Kita dapat menggunakan runtime Databricks ML yang dilengkapi paket umum seperti pandas dan PySpark untuk persiapan dan pembersihan data. Databricks Feature Store adalah repositori terpusat dalam Platform Databricks Lakehouse AI — yang dirancang untuk menyimpan, berbagi, dan mengelola fitur-fitur machine learning.
Feature store ini memastikan fitur yang digunakan untuk melatih model machine learning konsisten dengan yang digunakan saat inferensi di lingkungan produksi. Kita juga tidak perlu membuang sumber daya komputasi dengan menghitung ulang fitur berulang kali untuk berbagai use case.
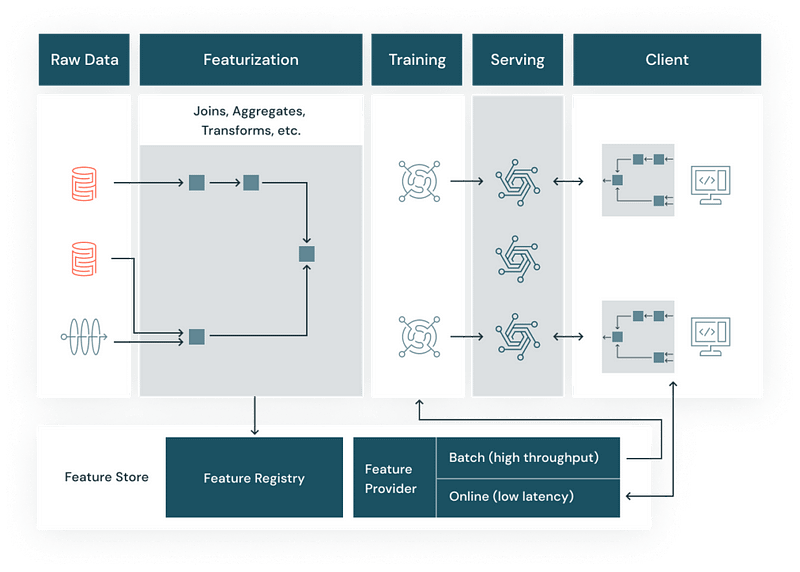
Fungsi feature store (Sumber)
Dengan memusatkan definisi dan penyimpanan fitur, ini menghilangkan masalah umum “training-serving skew,” ketika data yang digunakan untuk melatih model berbeda dari yang ditemui model di lingkungan produksi.
Untuk pengembangan model, kita memiliki fleksibilitas untuk memilih model terkurasi yang sudah tersedia dalam lingkungan Databricks atau memilih melatih model kustom yang disesuaikan dengan data dan kebutuhan bisnis spesifik.
Databricks juga memiliki klaster yang dioptimalkan GPU, artinya pelatihan (dan inferensi) dapat berlangsung lebih cepat dan dalam skala, yang sering kali menjadi elemen krusial saat menginginkan wawasan, prediksi, dan rekomendasi real-time dalam skala besar.
Databricks mengembangkan alat open-source bernama MLflow, yang tersedia secara native di platform Databricks, untuk menyederhanakan proses kompleks pelacakan eksperimen, mengemas kode menjadi run yang dapat direproduksi, dan berbagi temuan.
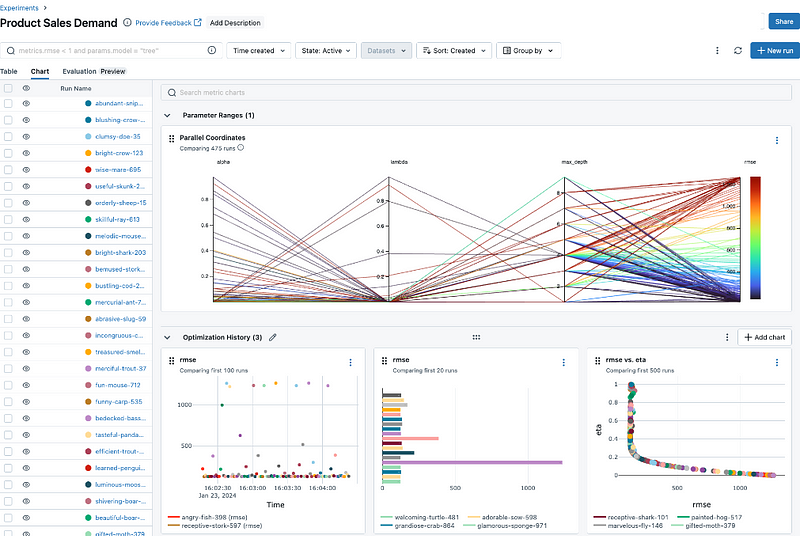
Contoh eksperimen MLflow (Tangkapan layar oleh penulis)
Langkah-langkah membuat kerangka eksperimen adalah sebagai berikut:
Setelah kerangka kerja terbentuk, kita dapat beriterasi dengan cepat untuk mendapatkan model terbaik sejak awal.
Model Serving, fitur lain dalam Databricks Lakehouse AI, merampingkan transisi model machine learning dari tahap pengembangan ke kondisi siap produksi.
Fitur ini memungkinkan model diterapkan sebagai endpoint RESTful, yang dapat dengan mudah diintegrasikan ke berbagai aplikasi dan layanan untuk prediksi real-time atau inferensi batch.
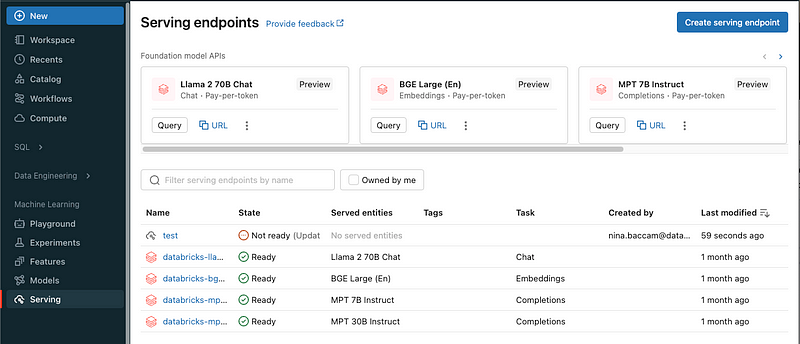
Endpoint Model Serving (Sumber)
Setelah model dilatih, data scientist dapat menerapkannya hanya dengan beberapa klik tanpa perlu penyiapan ekstensif atau keahlian DevOps. Berikut caranya:
Kami menganjurkan Anda menelusuri contoh tutorial terperinci dari Databricks untuk mengeksekusi langkah-langkah ini dengan mudah. Kemudahan deployment ini krusial dalam alur kerja data modern, di mana kemampuan untuk beriterasi dan menerapkan model dengan cepat dapat secara signifikan mendorong nilai bisnis.
Setelah model machine learning kita diterapkan ke produksi, fase krusial terakhir dalam siklus AI adalah pemantauan dan evaluasi. Fase ini melibatkan pelacakan kinerja model secara berkelanjutan untuk memastikan model tetap efektif dan akurat dari waktu ke waktu.
Databricks Lakehouse AI memfasilitasi hal ini melalui Lakehouse Monitoring dan Inference Tables, yang merupakan alat esensial untuk menjaga kesehatan dan efektivitas sistem AI kita. Karena kita sudah melihat fitur Lakehouse Monitoring sebelumnya, pada bagian ini kita akan berfokus pada inference tables.
Secara sederhana, Inference Table adalah fitur tambahan, yang perlu Anda aktifkan dengan mencentang kotak, yang memungkinkan kita menangkap data input dan prediksi terkait dari endpoint Model Serving dan mencatatnya ke dalam delta table, yang akan menjadi bagian dari Unity Catalog.
Mekanisme pencatatan ini memiliki beberapa manfaat:
Proses pengembangan machine learning bersifat siklik, yang berarti kita mengambil umpan balik dari versi pertama deployment dan menyempurnakan, melatih ulang, serta membangun model yang lebih akurat dan efisien, sehingga membawa kita kembali ke langkah pertama.
Tutorial ini memperkenalkan evolusi Databricks Lakehouse AI dan fitur-fiturnya yang inti. Kita juga melihat bagaimana fitur-fitur ini menyatu melalui tata kelola terpadu. Selanjutnya, kita menganalisis dan memahami bagaimana menavigasi siklus hidup pengembangan machine learning end-to-end menggunakan platform Databricks Lakehouse AI.
Untuk mempelajari lebih lanjut tentang Databricks Lakehouse dan penerapannya dalam rekayasa data, pengembangan machine learning, dan membangun aplikasi skala besar secara praktis, kami merekomendasikan melihat kursus Introduction to Databricks kami sebagai langkah berikutnya.
Mulai Perjalanan AI Anda Hari Ini!
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



