
Kurs
Üretken Yapay Zeka Kavramları
2 sa
121.1K
Databricks, Apache Spark ve MLflow gibi açık kaynak projeleri yönlendirmek de dahil olmak üzere, ölçekli AI çözümleri sunmaya yardımcı olan teknolojiler ve platformlar geliştirmede öncülerden biri olmuştur.
Databrick Data + AI Summit 2023 sırasında, Lakehouse AI veri katmanına yerleşik olarak inşa edilen dünyadaki ilk AI platformu olarak duyuruldu — ve bununla birlikte birçok yeni özellik tanıtıldı. Dünyada ChatGPT’nin lansmanı ve üretken AI teknolojilerindeki büyük sıçramaların ardından, Lakehouse AI, veriye odaklı bir yaklaşımla üretken AI uygulamaları geliştirmeye Databricks’in yanıtıdır.
Bu eğitimde, Databricks Lakehouse AI platformunu tanıtacak, önemini değerlendirecek, sunulan yeni özellikleri anlayacak ve bunları makine öğrenimi geliştirme yaşam döngümüzde nasıl kullanabileceğimizi göreceğiz.
Bir dakika, Lakehouse? Hepsi sizin için yeni terimler olabilir, anlıyoruz.
Databricks Lakehouse AI’nin evrimini adım adım inceleyelim. Lakehouse AI’yi anlamak için önce Lakehouse mimarisini tam olarak kavramamız gerekir.
“Lakehouse”, bir veri gölünün esnekliği ve maliyet etkinliğini, bir veri ambarının veri yönetimi özellikleriyle birleştiren modern bir veri yönetimi mimarisidir.
Veri gölü ve veri ambarı arasındaki farklara ilişkin baştan sona bir eğitimimiz var; ancak kısaca, bunun anlamı şudur:
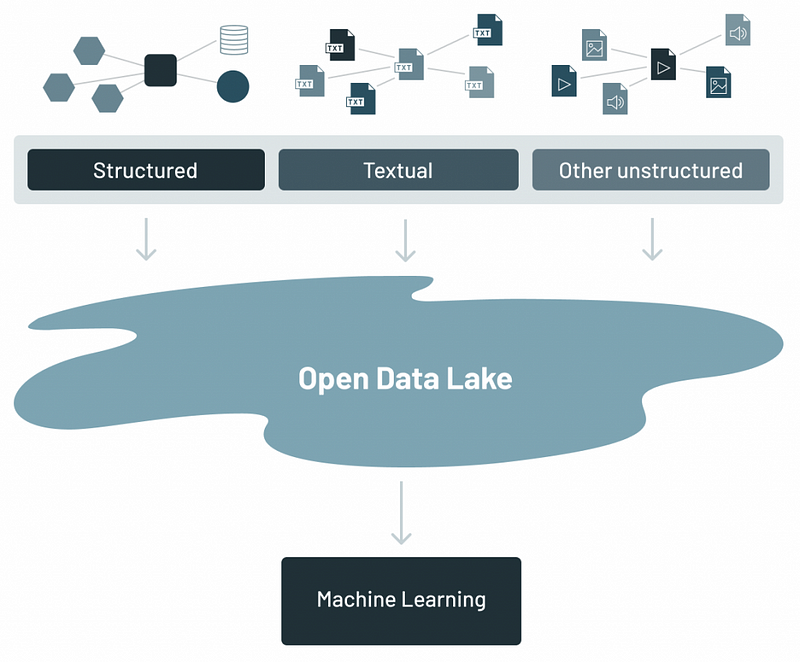
Veri gölü mimarisi (Kaynak)
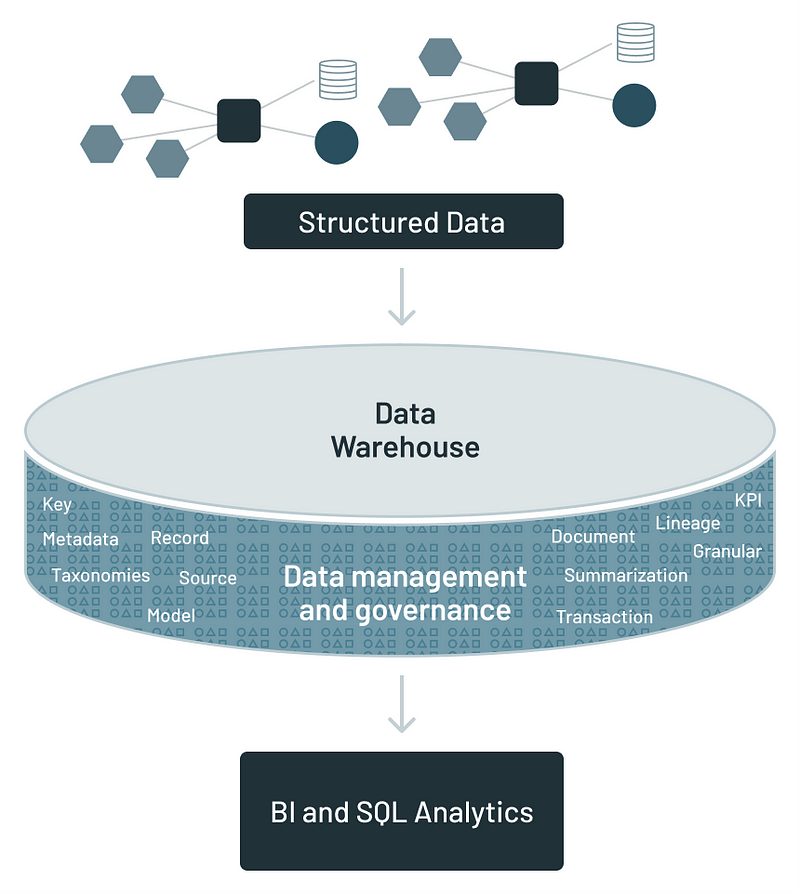
Veri ambarı mimarisi (Kaynak)
Veri gölleri, doğaları gereği büyük miktarda ham, yapılandırılmamış veri depoladıkları için veri yönetimi ve yönetişiminde sıklıkla zorlanır; bu da verinin bulunmasının, erişilmesinin veya güvenilmesinin zor olduğu “veri bataklıklarına” yol açabilir. Yapı eksikliği, karmaşık analitik sorguların performansını da engelleyebilir ve geleneksel veri gölleri genellikle işlem verisi operasyonlarını iyi desteklemez; veri bütünlüğünü sağlamak için kritik olan ACID işlem yeteneklerinden yoksundur.
Öte yandan veri ambarları, yapılandırılmış veri ve analitik için optimize edilmiştir; ancak veri hacimleri arttıkça ölçeklendirmek maliyet açısından zorlayıcı olabilir. Verinin önceden tanımlı bir şemaya yapılandırılıp işlenmesi gerekliliği de katılık getirebilir ve yeni veri türlerini hızla içe aktarma ve analiz etme yeteneğini kısıtlayabilir.
Bu sınırlamalar, her iki dünyanın en iyisini bir araya getirmeyi amaçlayan Lakehouse mimarisinin evrimini tetiklemiştir:
Lakehouse mimarisi şu şekilde görünür:
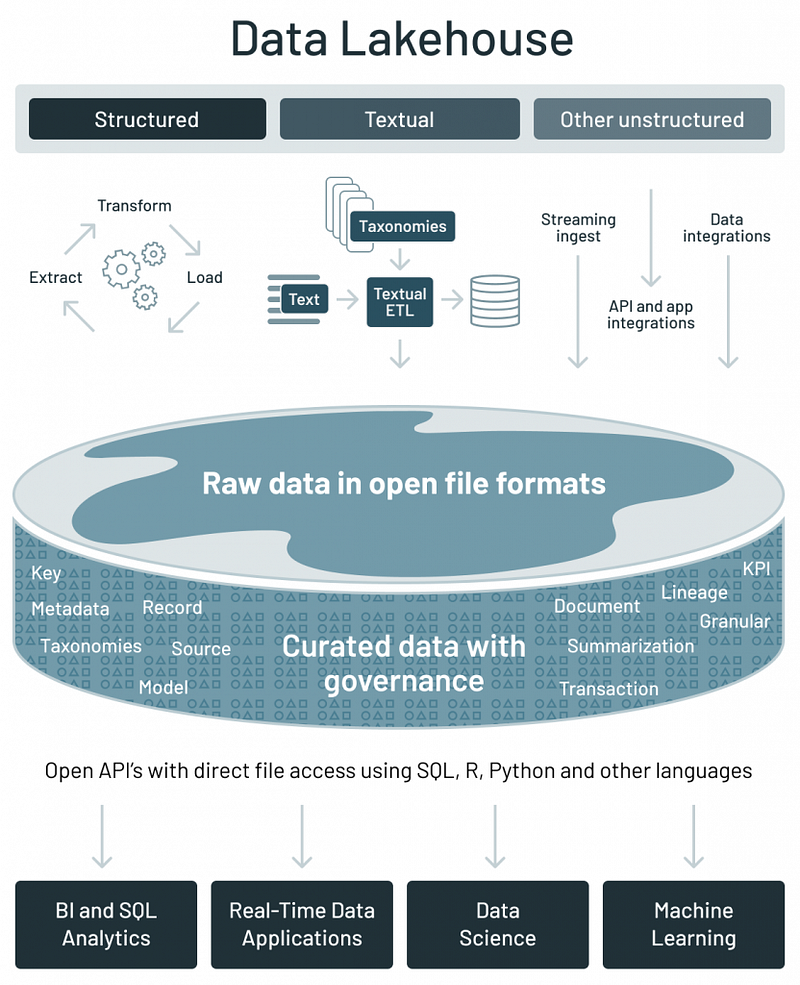
Veri lakehouse mimarisi (Kaynak)
Artık Databricks Lakehouse’un evrimini anladığımıza göre, son soruya geldik.
Lakehouse AI, yapay zeka ve makine öğrenimi yeteneklerinin doğrudan Lakehouse mimarisine entegre edilmesidir. Bu, veriyi işlemek için ayrı bir ortama taşıma veya kopyalama gereği olmadan, veri gölümüzde depolanan büyük veri kümelerini kullanarak AI modelleri geliştirebileceğimiz, eğitebileceğimiz ve dağıtabileceğimiz anlamına gelir.
Bu platformun önemi şunlardır:
Bu özellikler, Databricks’in bu platformu veri katmanına yerleşik dünyadaki ilk AI platformu olarak duyurmasının nedenini açıklar.
Lakehouse AI’ye geçiş, işletmeleri daha veriye dayalı ve AI ile bütünleşik operasyonlara yönlendirmede önemli rol oynadı.
Bu dönüşümün merkezinde, AI ve makine öğrenimi modellerinin geliştirilmesini, dağıtılmasını ve yönetilmesini kolaylaştıran birkaç temel bileşen bulunur. Bu bileşenlerin neden ve ne zaman gerekli olduğunu anlamak, kuruluşların verilerini AI uygulamaları için daha etkin biçimde kullanmasına yardımcı olabilir.
Databricks Lakehouse AI’deki Vektör Arama, geleneksel anahtar kelime eşleşmelerine güvenmek yerine, anlamsal olarak benzer bilgileri bulmak için devasa veri kümelerini işleme ve içinde arama yapmada önemli bir ilerlemeyi temsil eder (Data+AI Summit 2023’te de tanıtılmıştır).
Vektör Arama, verileri ve sorguları, bir Üretken AI modelinden türetilen ve gömlemeler olarak adlandırılan çok boyutlu bir uzaydaki vektörlere dönüştürerek çalışır. Bu yöntem, anlamsal olarak benzer kelime veya kavramların n-boyutlu uzayda birbirine daha yakın olmasını sağlar; böylece daha ilgili ve bağlamı dikkate alan arama sonuçları elde edilir.
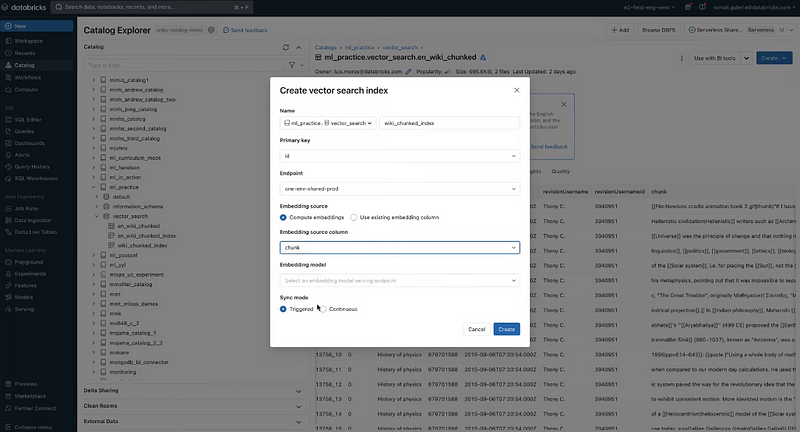
Vektör arama (Yazarın ekran görüntüsü)
Vektör Aramayı kullanma süreci (Databricks’in demo videosu) şu şekildedir:
Lippert gibi şirketler, çeşitli kaynaklardaki içeriği Vektör Arama’ya alarak, temsilcilerin müşteri sorularına hızla yanıt bulmasını sağlamak için Vektör Aramayı çoktan kullandı.
Databricks Marketplace’te sunulan bu modeller, yüksek performans için optimize edilmiştir ve metin analizi ile üretiminden görsel işlemeye kadar geniş bir uygulama yelpazesi için Lakehouse ortamına kolayca entegre edilecek şekilde tasarlanmıştır.
Seçilmiş bazı Üretken AI modelleri şunlardır:
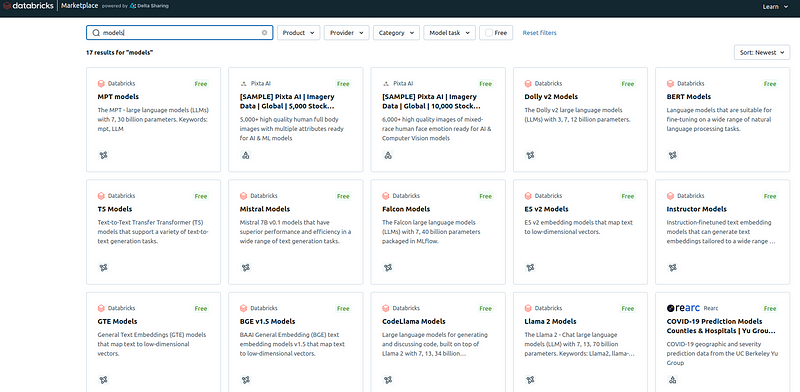
Databricks Marketplace’te mevcut modeller (Yazarın ekran görüntüsü)
Bu modeller, veri yönetimi, analitik ve MLOps araçları dahil olmak üzere Databricks Lakehouse AI özelliklerinin daha geniş setiyle sorunsuz çalışacak şekilde tasarlanmıştır. Bu modellerin makine öğrenimi geliştirmesinde nasıl kullanılabileceğini birazdan göreceğiz.
Databricks Lakehouse AI içindeki AutoML (Otomatik Makine Öğrenimi) özellikleri, makine öğrenimi modeli geliştirme sürecini kolaylaştırıp otomatikleştirmek üzere tasarlanmıştır; böylece ileri düzey veri bilimi, sınırlı makine öğrenimi bilgisine sahip kullanıcılar da dahil olmak üzere daha geniş bir kullanıcı kitlesine erişilebilir hale gelir.
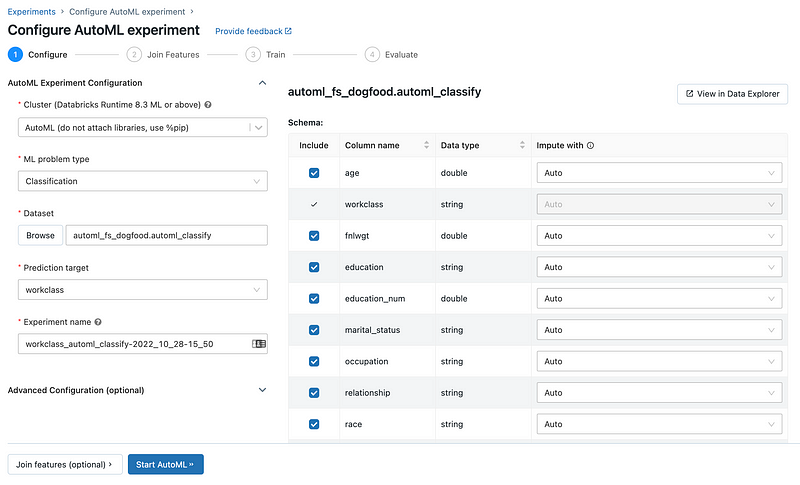
Databrick AutoML (Kaynak)
Veri kümesini sağladığımızda ve tahmin amacını belirttiğimizde, AutoML veri kümesini bir model eğitimi için hazır hale getirmeyi üstlenir. Ardından bir dizi deneme üzerinden birden çok model oluşturur, ayarlar ve değerlendirir.
Değerlendirme tamamlandığında AutoML sonuçları sunar ve her denemenin kaynak kodunu içeren bir Python not defteri sağlar. Bu, kodu gözden geçirmemize, yeniden üretmemize ve gerektiğinde değiştirmemize olanak tanır. AutoML ayrıca veri kümemiz hakkında özet istatistikler hesaplar ve bu bilgileri ileride başvurmak üzere bir not defterine kaydeder.
Son lansmanla birlikte AutoML artık müşterinin kendi verileriyle metin sınıflandırma ve gömme modelleri için üretken AI modellerini ince ayar yapmayı sunuyor. Bu, teknik olmayan iş kullanıcılarının bile birkaç tıklamayla üretken AI uygulamaları oluşturmak için AutoML’yi kullanabileceği anlamına gelir.
Databricks Lakehouse Monitoring, veri tablolarımızın istatistiksel özelliklerini ve kalitesini izlememizi, makine öğrenimi modellerinin ve tahminlerinin performansını takip etmemizi sağlar. Databricks’in veri hatlarındaki veri akışını inceleyerek, bu izleme özelliği veri kalitesinin ve model etkinliğinin kesintisiz olarak takip edilmesine yardımcı olur.
Sürekli izlemeyi mümkün kılmak için verinin Lakehouse izleme üzerinden nasıl aktığı şöyledir:
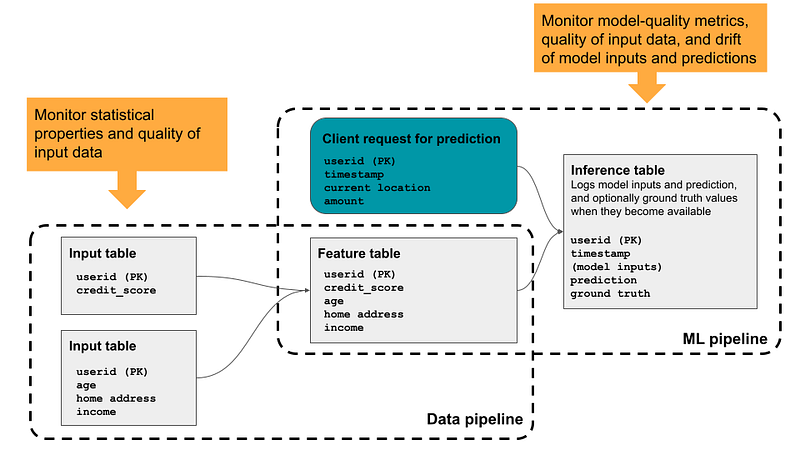
Lakehouse İzleme akışı (Kaynak)
Sadece izleme ile yetinmek yerine, bu özellik veri bütünlüğü, dağılım, sapma ve zaman içindeki model performansı gibi çeşitli konularda eyleme dönüştürülebilir içgörüler de sağlar.
Şimdi bu özelliklerin Lakehouse AI’de nasıl birleşik bir yönetişim olarak bir araya geldiğine bakalım.
Birleşik yönetişim fikri; veriye, makine öğrenimi modellerine ve diğer AI varlıklarına tek bir yerden erişebilmek, kontrol etmek, iş birliği yapmak, izlemek ve harekete geçebilmektir. Herhangi bir kuruluş AI dönüşüm yolculuğunda büyüyüp olgunlaştıkça, her şeyi tek bir yerde yönetebilmek kritik hale gelir.
Databricks Unity Catalog tam da bunu yapar ve AI varlıklarını yönetecek yaklaşımı birleştirmek, düzenleyici uyumu korurken AI benimsenmesini hızlandırır.
Veri gezgini ve harici sistemleri ekleyebilme gibi faydalı özellikler olsa da, öne çıkan özellik aşağıda gösterildiği gibi, bu varlıkların tamamının yönetişimini basit bir Unity Catalog Yönetişim Portalı üzerinden kuşbakışı görebilmektir:
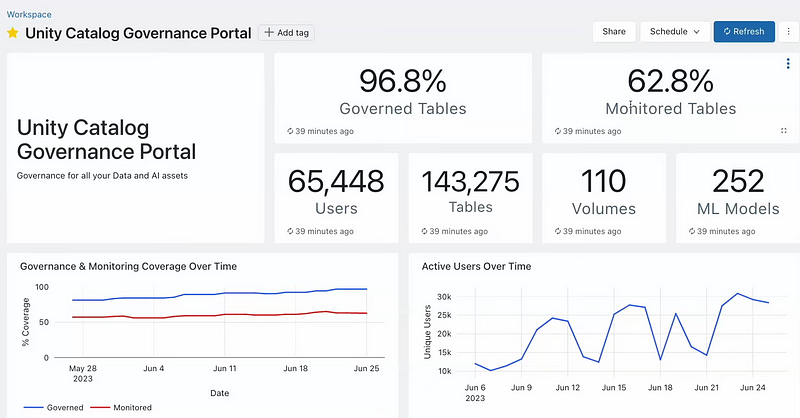
Unity catalog yönetişim portalı (Yazarın ekran görüntüsü)
Bu portal; yönetilen ve izlenen tabloların yüzdesi, aktif kullanıcı sayısı ve tablo, hacim ile ML modeli sayısı gibi temel metrikleri görüntüler. Bu üst düzey görünüm, yönetişim durumunu ve veri varlıklarıyla etkin etkileşimi hızlıca değerlendirmeye yardımcı olur.
Pano ayrıca kullanıcıların zaman içindeki etkinlik düzeylerini gösterir; bu da veri varlıklarının kuruluş içinde nasıl kullanıldığını anlamaya ve darboğazları veya eğitim ihtiyaçlarını belirlemeye yardımcı olabilir.
Ayrıca portal, izlenmeyen tablolar veya Kişisel Olarak Tanımlanabilir Bilgilerden (PII) türetilen sütunlar gibi sorunları belirleyerek potansiyel yönetişim risklerini listeler ve veriyi güvenli şekilde yönetmek için proaktif bir yaklaşım sunar; aşağıda görüldüğü gibi.
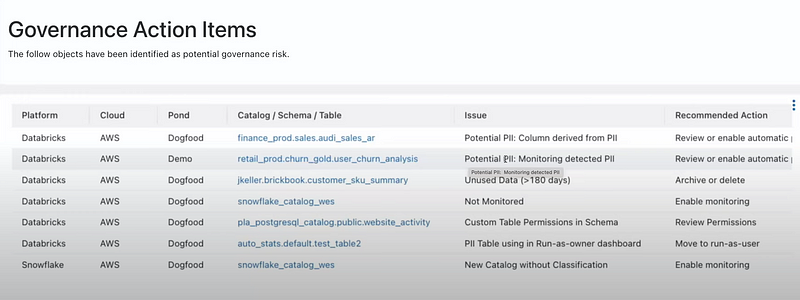
Unity catalog panosunun yönetişim eylem öğeleri görünümü (Yazarın ekran görüntüsü)
Belirlenen her sorun, kullanıcıları potansiyel yönetişim endişelerini çözmeye yönlendiren önerilen bir eylemle birlikte gelir. Bu özellik, platform genelinde AI ve veri varlıklarının sıklıkla karmaşık olan yönetişim sürecini basitleştirir ve birleştirir.
Artık platformun özelliklerini ve nasıl bir araya geldiklerini anladığımıza göre, uçtan uca makine öğrenimi geliştirme uygulamasına dalalım.
Uçtan uca makine öğrenimi geliştirme yaşam döngüsüne kısa bir hatırlatma için aynı konudaki ayrıntılı eğitimimize bakmanızı öneririz. Bu bölümde, Databricks Lakehouse AI’nin özelliklerinin yaşam döngüsüne nasıl uyduğunu anlayacağız.
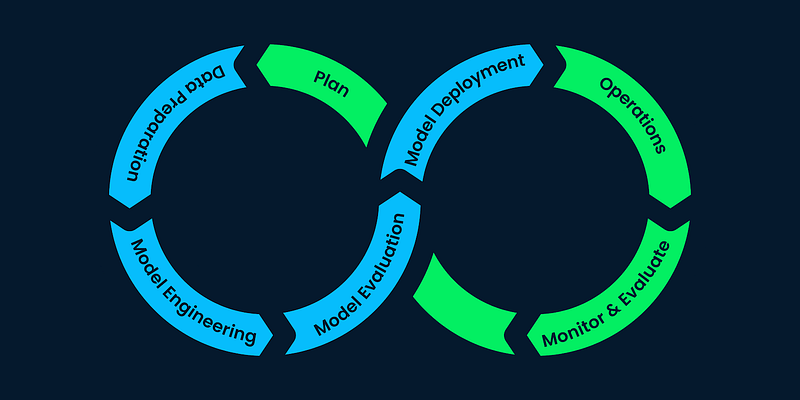
Uçtan uca Makine Öğrenimi Geliştirme (Kaynak)
Databricks Lakehouse AI içinde makine öğreniminin temel taşı, modelleri verimli bir şekilde eğitip inşa etme yeteneğidir.
Veri hazırlama ve temizleme için pandas ve PySpark gibi yaygın paketlerle birlikte gelen Databricks ML çalışma zamanını kullanabiliriz. Databricks Feature Store, Databricks Lakehouse AI Platformu içinde yer alan merkezi bir havuzdur — makine öğrenimi özelliklerini depolamak, paylaşmak ve yönetmek için tasarlanmıştır.
Bu özellik deposu, makine öğrenimi modellerini eğitmekte kullanılan özelliklerin, üretim ortamlarında çıkarım sırasında kullanılanlarla tutarlı olmasını sağlar. Ayrıca farklı kullanım durumları için özellikleri tekrar tekrar yeniden hesaplayarak hesaplama kaynaklarını israf etmemize gerek kalmaz.
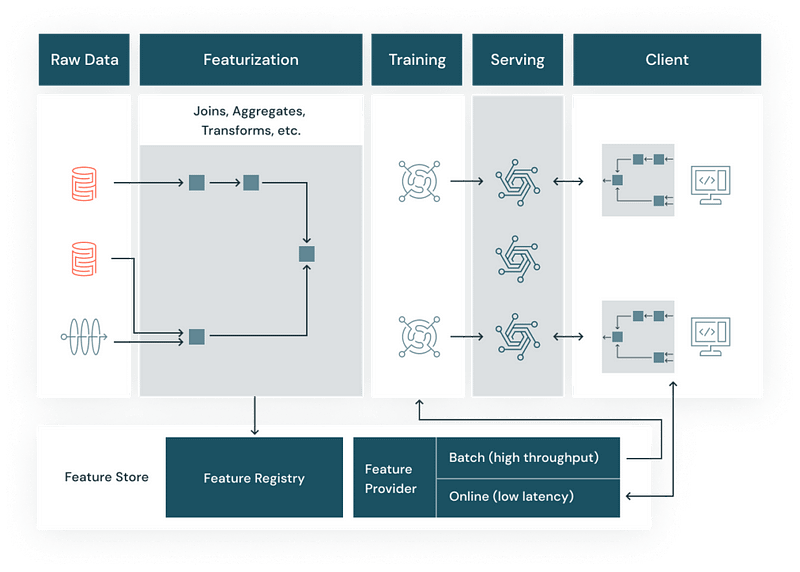
Bir özellik deposunun işlevi (Kaynak)
Özellik tanımlarını ve depolamayı merkezileştirerek, model eğitimi için kullanılan verinin, modelin canlı ortamda karşılaştığı veriden farklı olması anlamına gelen yaygın “eğitim-çıkarım uyumsuzluğu” sorununu ortadan kaldırır.
Model geliştirme için, Databricks ortamında mevcut olan önceden oluşturulmuş seçilmiş modellerden birini kullanma ya da belirli veri ve iş gereksinimlerinize göre uyarlanmış özel bir model eğitme esnekliğine sahibiz.
Databricks ayrıca GPU için optimize edilmiş kümelere sahiptir; bu da eğitimin (ve çıkarımın) daha hızlı ve ölçekli şekilde gerçekleşebileceği anlamına gelir; bu, gerçek zamanlı içgörüler, tahminler ve öneriler söz konusu olduğunda sıklıkla kritik bir unsurdur.
Databricks, deneyleri izleme, kodu yeniden üretilebilir çalıştırmalara paketleme ve bulguları paylaşma gibi karmaşık süreci kolaylaştıran, platformda yerel olarak bulunan MLflow adlı bir açık kaynak aracı geliştirdi.
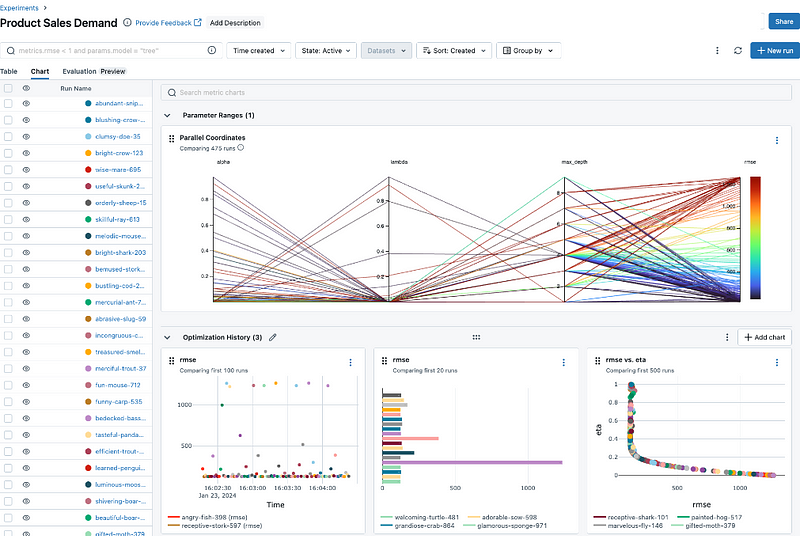
Örnek bir MLflow deneyi (Yazarın ekran görüntüsü)
Bir deney çerçevesi oluşturmanın adımları şöyledir:
Çerçeve kurulduktan sonra, en iyi modele erken aşamada ulaşmak için hızlıca yineleme yapabiliriz.
Databricks Lakehouse AI içindeki bir diğer özellik olan Model Sunumu, makine öğrenimi modellerinin geliştirme aşamasından üretime hazır duruma geçişini kolaylaştırır.
Bu işlev, modellerin RESTful uç noktalar olarak dağıtılmasına olanak tanır; böylece gerçek zamanlı tahminler veya toplu çıkarım için çeşitli uygulama ve hizmetlere kolayca entegre edilebilir.
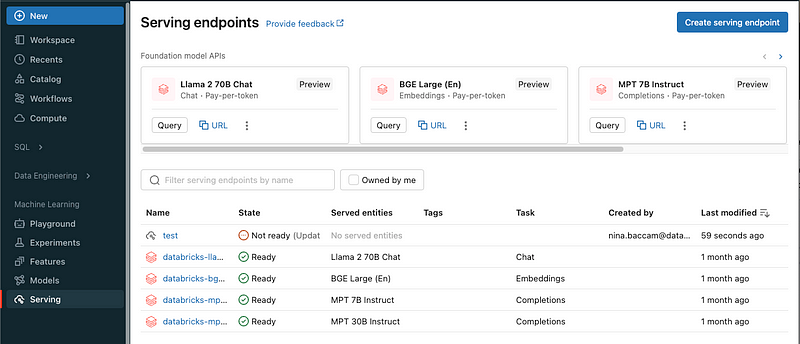
Model Sunumu uç noktaları (Kaynak)
Bir model eğitildikten sonra, veri bilimciler geniş kapsamlı kurulum veya DevOps uzmanlığına gerek duymadan yalnızca birkaç tıklamayla onu dağıtabilir. Bunu şu şekilde yapabilirsiniz:
Bu adımları kolaylıkla uygulamak için Databricks’in ayrıntılı eğitim örneklerini incelemenizi öneririz. Bu dağıtım kolaylığı, modern veri iş akışlarında, modelleri hızla yineleyip dağıtabilme yeteneğinin iş değerini önemli ölçüde artırabildiği durumlarda kritik önemdedir.
Makine öğrenimi modellerimiz üretime alındığında, AI yaşam döngüsündeki son kritik aşama izleme ve değerlendirmedir. Bu aşama, modelin zaman içinde etkili ve doğru kalmasını sağlamak için performansının sürekli takip edilmesini içerir.
Databricks Lakehouse AI, AI sistemlerimizin sağlığını ve etkinliğini korumak için temel araçlar olan Lakehouse Monitoring ve Çıkarım Tabloları ile bunu kolaylaştırır. Lakehouse Monitoring’in özelliklerine zaten baktığımız için, bu bölümde çıkarım tablolarına odaklanacağız.
Basitçe ifade etmek gerekirse, Çıkarım Tablosu, bir onay kutusuyla etkinleştirmeniz gereken ek bir özelliktir; Model Sunumu uç noktalarından gelen girdi verilerini ve karşılık gelen tahminleri yakalayarak bunları, Unity Catalog’un parçası olacak bir delta tablosuna kaydetmemizi sağlar.
Bu günlüğe kaydetme mekanizmasının birden çok faydası vardır:
Makine öğrenimi geliştirme süreci döngüseldir; yani, ilk dağıtım sürümümüzden geri bildirim alır, daha doğru ve verimli modeller oluşturmak için iyileştirir, yeniden eğitir ve böylece yeniden ilk adıma döneriz.
Bu eğitim, Databricks Lakehouse AI’nin evrimini ve temel özelliklerini tanıttı. Ayrıca bu özelliklerin birleşik bir yönetişim aracılığıyla nasıl bir araya geldiğine baktık. Dahası, Databricks Lakehouse AI platformunu kullanarak uçtan uca makine öğrenimi yaşam döngüsünde nasıl yol alabileceğimizi analiz edip anladık.
Daha fazla bilgi edinmek ve veri mühendisliği, makine öğrenimi geliştirme ve büyük ölçekli uygulama kurulumlarında Databricks Lakehouse’un uygulamasını pratik olarak görmek için bir sonraki adım olarak Databricks’e Giriş kursumuza bakmanızı öneririz.
Yapay Zeka Yolculuğunuza Bugün Başlayın!
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




