Curso
Conceitos de IA Generativa
2 h
117.2K
A Databricks tem sido uma das pioneiras na criação de tecnologias e plataformas que viabilizam soluções de IA em escala, impulsionando inclusive projetos open source como Apache Spark e MLflow.
Durante o Databricks Data + AI Summit 2023, o Lakehouse AI foi anunciado como a primeira plataforma de IA do mundo integrada à camada de dados — além de muitos outros recursos novos. Com o lançamento do ChatGPT e os saltos gigantes em tecnologias de IA generativa pelo mundo, o Lakehouse AI é a resposta da Databricks para construir aplicações de IA generativa com uma abordagem centrada em dados.
Neste tutorial, vamos apresentar a plataforma Databricks Lakehouse AI, refletir sobre sua importância, entender os novos recursos lançados e como podemos utilizá-los no nosso ciclo de desenvolvimento de machine learning.
Como assim, Lakehouse? A gente sabe que pode ser um termo novo para você.
Vamos destrinchar a evolução do Databricks Lakehouse AI passo a passo. Para entender o Lakehouse AI — primeiro precisamos entender bem a arquitetura Lakehouse.
Um “Lakehouse” é uma arquitetura moderna de gerenciamento de dados que combina a flexibilidade e o baixo custo de um data lake com os recursos de gestão de dados de um data warehouse.
Temos um tutorial completo sobre as diferenças entre data lake e data warehouse, mas, em resumo, significa o seguinte:
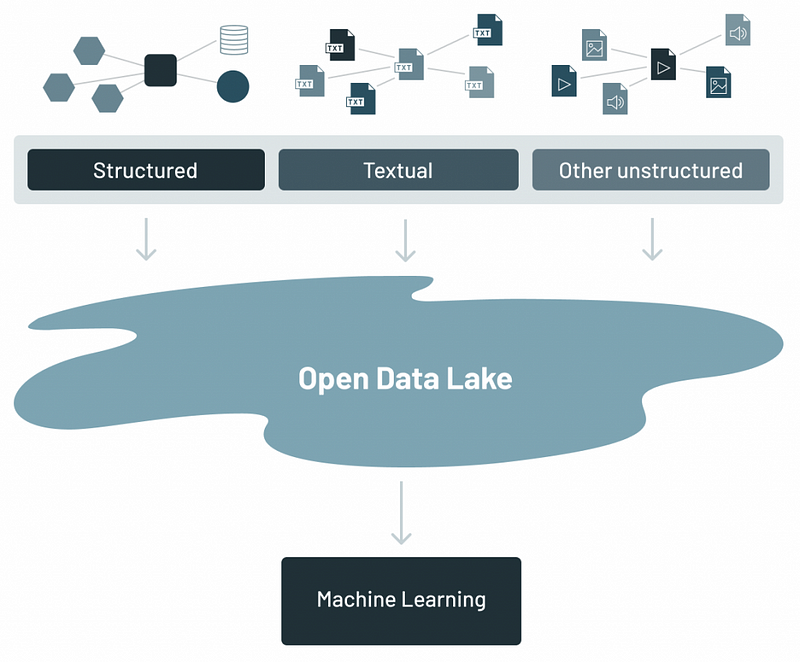
A arquitetura de data lake (Fonte)
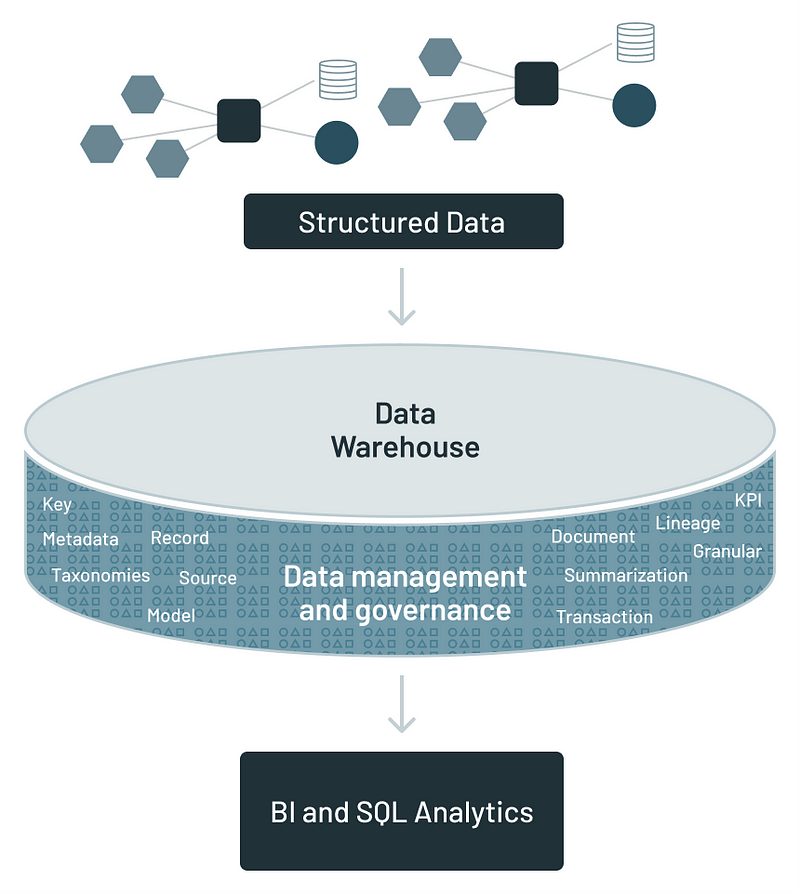
A arquitetura de data warehouse (Fonte)
Data lakes costumam ter dificuldades de gestão e governança por armazenarem enormes volumes de dados brutos e não estruturados, o que pode levar a “pântanos de dados”, onde é difícil encontrar, acessar ou confiar nos dados. A falta de estrutura também pode prejudicar o desempenho de consultas analíticas complexas, e data lakes tradicionais geralmente não dão suporte adequado a operações transacionais, faltando recursos de transações ACID, cruciais para garantir a integridade dos dados.
Já os data warehouses são otimizados para dados estruturados e análises, mas podem ficar caros demais à medida que o volume de dados cresce. A exigência de estruturar os dados em um schema predefinido traz rigidez, limitando a capacidade de ingerir e analisar rapidamente novos tipos de dados.
Essas limitações impulsionaram a evolução da arquitetura Lakehouse, que busca unir o melhor dos dois mundos:
Veja como é a arquitetura lakehouse:
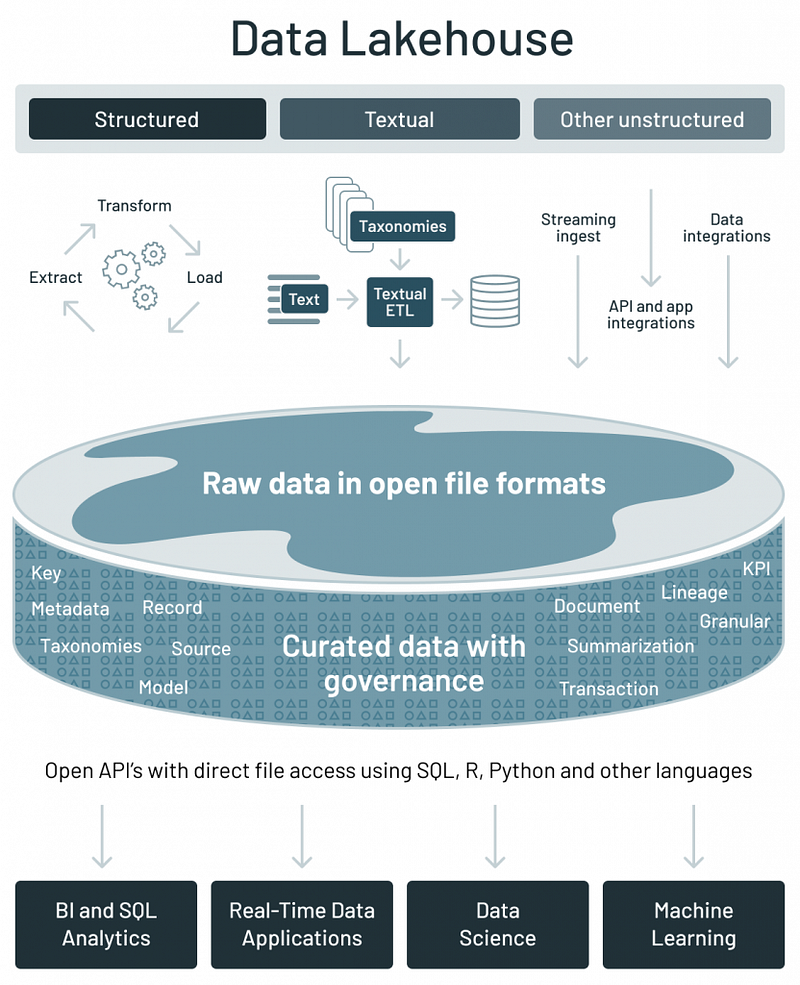
A arquitetura de data lakehouse (Fonte)
Agora que entendemos a evolução do Databricks Lakehouse, chegamos à pergunta final.
Lakehouse AI é a integração de recursos de inteligência artificial e machine learning diretamente na arquitetura Lakehouse. Isso significa que podemos desenvolver, treinar e implantar modelos de IA usando os enormes volumes de dados armazenados no data lake sem precisar mover ou copiar os dados para outro ambiente de processamento.
A importância dessa plataforma está em:
Esses recursos explicam por que a Databricks anunciou esta como a primeira plataforma de IA do mundo integrada à camada de dados.
A transição para o Lakehouse AI tem sido fundamental para levar os negócios a operações mais orientadas por dados e integradas à IA.
No centro dessa transformação estão vários componentes essenciais que facilitam o desenvolvimento, a implantação e o gerenciamento de modelos de IA e machine learning. Entender por que e quando esses componentes são necessários ajuda as organizações a aproveitar melhor seus dados em aplicações de IA.
O Vector Search no Databricks Lakehouse AI representa um avanço significativo (também lançado no Data + AI Summit 2023) no tratamento e na pesquisa em grandes volumes de dados para encontrar informações semanticamente semelhantes, indo além da correspondência tradicional por palavras-chave.
O Vector Search funciona convertendo dados e consultas em vetores em um espaço multidimensional chamado embeddings, derivados de um modelo de IA generativa. Esse método faz com que palavras ou conceitos semanticamente semelhantes fiquem mais próximos nesse espaço n-dimensional, permitindo resultados de busca mais relevantes e contextuais.
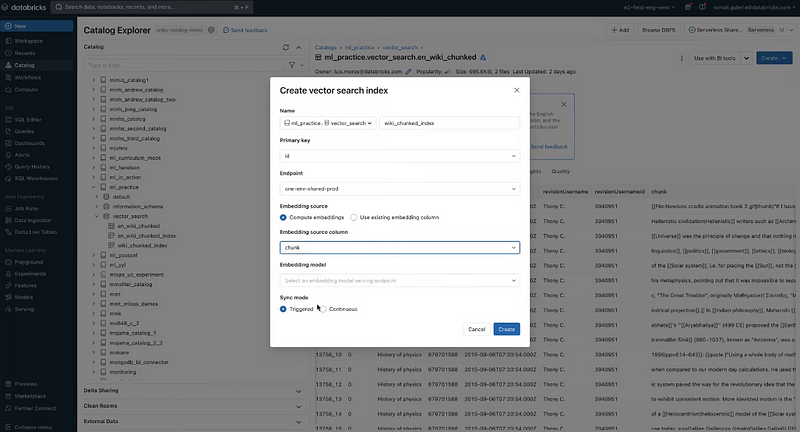
Busca vetorial (captura de tela do autor)
O processo de uso do Vector Search (vídeo de demonstração da Databricks) é o seguinte:
Empresas como a Lippert já usam o Vector Search para ajudar agentes a encontrar rapidamente respostas a dúvidas de clientes, ingerindo conteúdo de diversas fontes.
Esses modelos, disponíveis no Databricks Marketplace, são otimizados para alto desempenho e foram projetados para fácil integração ao ambiente Lakehouse em várias aplicações, de análise e geração de texto a processamento de imagens.
Alguns modelos de IA generativa curados incluem:
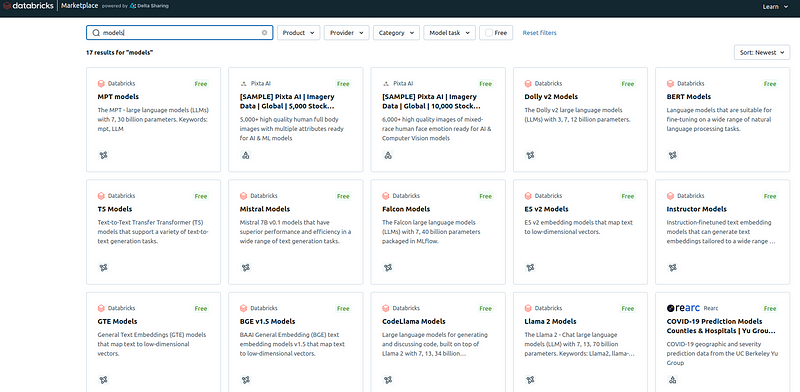
Modelos disponíveis no Databricks Marketplace (captura de tela do autor)
Esses modelos foram projetados para funcionar perfeitamente com o conjunto mais amplo de recursos do Databricks Lakehouse AI, incluindo ferramentas de gestão de dados, analytics e MLOps. Daqui a pouco veremos como usá-los no desenvolvimento de machine learning.
Os recursos de AutoML (Automated Machine Learning) no Databricks Lakehouse AI foram criados para simplificar e automatizar o processo de desenvolvimento de modelos de machine learning, tornando ciência de dados avançada acessível a um público mais amplo, incluindo quem tem pouca experiência em ML.
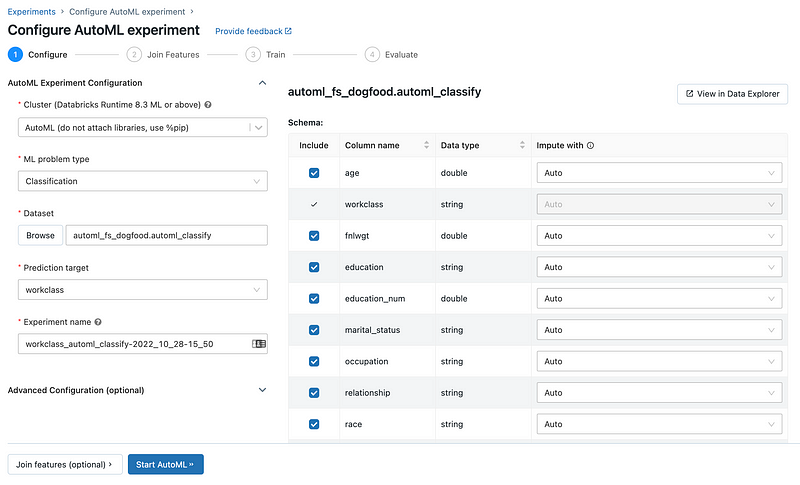
Databricks AutoML (Fonte)
Quando fornecemos o conjunto de dados e definimos o objetivo de predição, o AutoML cuida de preparar o dataset para treinar um modelo. Em seguida, ele cria, ajusta e avalia vários modelos por meio de uma série de experimentos.
Ao final da avaliação, o AutoML apresenta os resultados e oferece um notebook em Python com o código-fonte de cada experimento. Isso nos permite revisar, reproduzir e ajustar o código conforme necessário. O AutoML também calcula estatísticas resumidas sobre o dataset e salva essas informações em um notebook para referência futura.
Com o lançamento mais recente, o AutoML agora permite ajustar modelos de IA generativa para classificação de texto e modelos de embedding com os próprios dados do cliente. Ou seja, usuários de negócio não técnicos podem criar aplicações de IA generativa em poucos cliques.
O Databricks Lakehouse Monitoring permite monitorar as propriedades estatísticas e a qualidade das nossas tabelas de dados e acompanhar o desempenho de modelos de machine learning e suas predições. Ao examinar o fluxo de dados nos pipelines da Databricks, esse recurso ajuda a garantir o monitoramento contínuo da qualidade de dados e da efetividade dos modelos.
Veja como os dados fluem pelo Lakehouse Monitoring para viabilizar o acompanhamento contínuo:
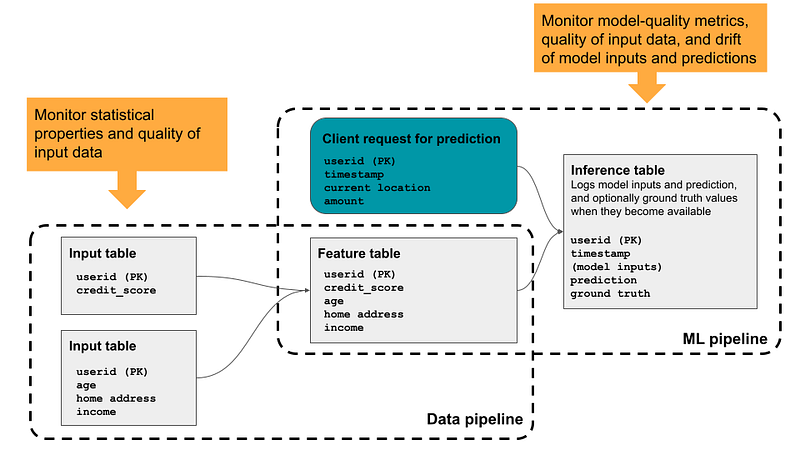
Fluxo do Lakehouse Monitoring (Fonte)
Além de monitorar, esse recurso também fornece insights acionáveis sobre integridade dos dados, distribuição, drift e desempenho do modelo ao longo do tempo.
Agora vamos ver como todos esses recursos se unem em uma governança unificada no Lakehouse AI.
A ideia de governança unificada é poder acessar, controlar, colaborar, monitorar e agir sobre dados, modelos de machine learning e outros ativos de IA em um só lugar. À medida que uma organização cresce e amadurece em sua jornada de transformação em IA, conseguir gerenciar tudo centralmente é crucial.
O Databricks Unity Catalog faz exatamente isso, e unificar a forma de governar ativos de IA acelera a adoção de IA sem abrir mão da conformidade regulatória.
Embora existam recursos úteis como o explorador de dados e a possibilidade de adicionar sistemas externos, o grande destaque é ter uma visão panorâmica de toda a governança desses ativos por meio de um Portal de Governança do Unity Catalog, como mostrado abaixo:
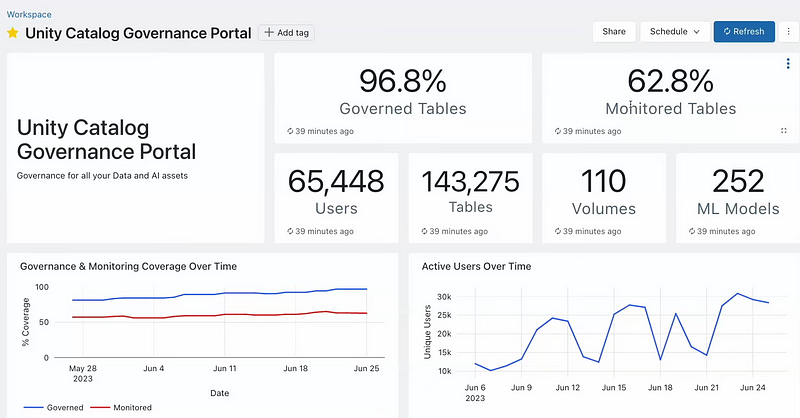
Portal de governança do Unity Catalog (captura de tela do autor)
Esse portal exibe métricas-chave como a porcentagem de tabelas governadas e monitoradas, o número de usuários ativos e a contagem de tabelas, volumes e modelos de ML. Essa visão de alto nível ajuda a avaliar rapidamente o status de governança e o engajamento com os ativos de dados.
O dashboard também mostra a atividade dos usuários ao longo do tempo, o que ajuda a entender como os ativos de dados são utilizados na organização e a identificar gargalos ou necessidades de capacitação.
Além disso, o portal lista riscos potenciais de governança identificando questões como tabelas não monitoradas ou colunas derivadas de PII (informações de identificação pessoal), oferecendo uma abordagem proativa para gerenciar dados com segurança, como visto abaixo.
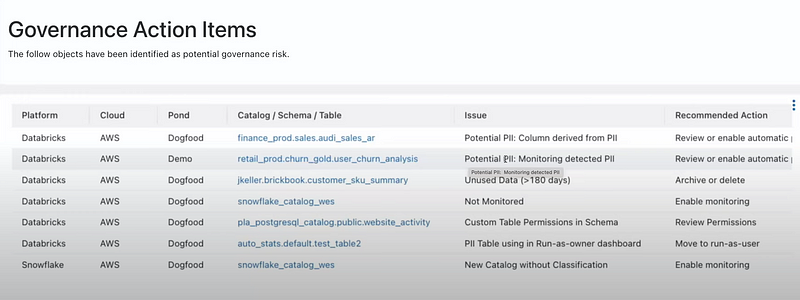
Itens de ação de governança no dashboard do Unity Catalog (captura de tela do autor)
Cada questão identificada vem com uma ação recomendada, guiando os usuários na resolução de possíveis problemas de governança. Esse recurso simplifica e unifica um processo que costuma ser complexo na gestão de ativos de IA e dados em toda a plataforma.
Agora que entendemos os recursos da plataforma e como eles se integram, vamos mergulhar no uso prático para desenvolvimento de machine learning de ponta a ponta.
Para relembrar o ciclo de desenvolvimento de machine learning, recomendamos nosso tutorial aprofundado. Nesta seção, vamos entender como os recursos do Databricks Lakehouse AI se encaixam nesse ciclo.
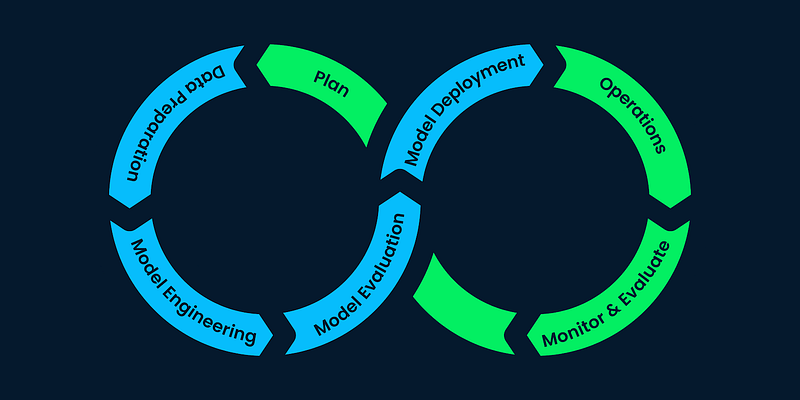
Desenvolvimento de machine learning de ponta a ponta (Fonte)
A base do machine learning no Databricks Lakehouse AI é a capacidade de treinar e construir modelos com eficiência.
Podemos usar o runtime de ML do Databricks, que já vem com pacotes como pandas e PySpark para preparação e limpeza de dados. O Databricks Feature Store é um repositório centralizado dentro da plataforma Databricks Lakehouse AI — projetado para armazenar, compartilhar e gerenciar features de machine learning.
Esse feature store garante que os atributos usados no treinamento sejam consistentes com os usados na inferência em produção. Também evita gastar computação recalculando features repetidamente para casos de uso diferentes.
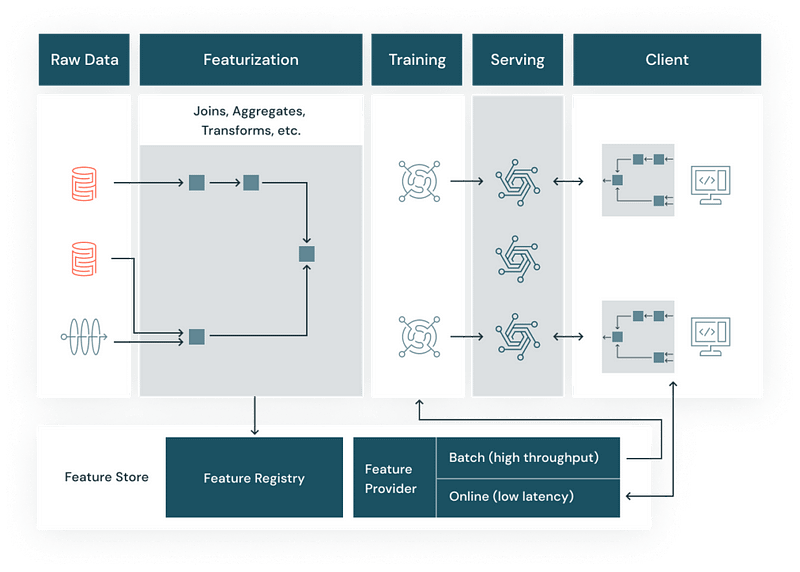
A função de um feature store (Fonte)
Ao centralizar definições e armazenamento de features, elimina-se o problema comum de “training-serving skew”, quando os dados do treinamento diferem dos encontrados pelo modelo em produção.
Para o desenvolvimento, temos a flexibilidade de escolher modelos curados pré-prontos no ambiente Databricks ou treinar um modelo customizado para os dados e necessidades do negócio.
A Databricks também oferece clusters otimizados com GPU, o que acelera treinamento (e inferência) em escala, algo crucial quando buscamos insights, previsões e recomendações em tempo real e em grande volume.
A Databricks desenvolveu uma ferramenta open source chamada MLflow, disponível nativamente na plataforma, que simplifica o processo de acompanhar experimentos, empacotar código em execuções reprodutíveis e compartilhar resultados.
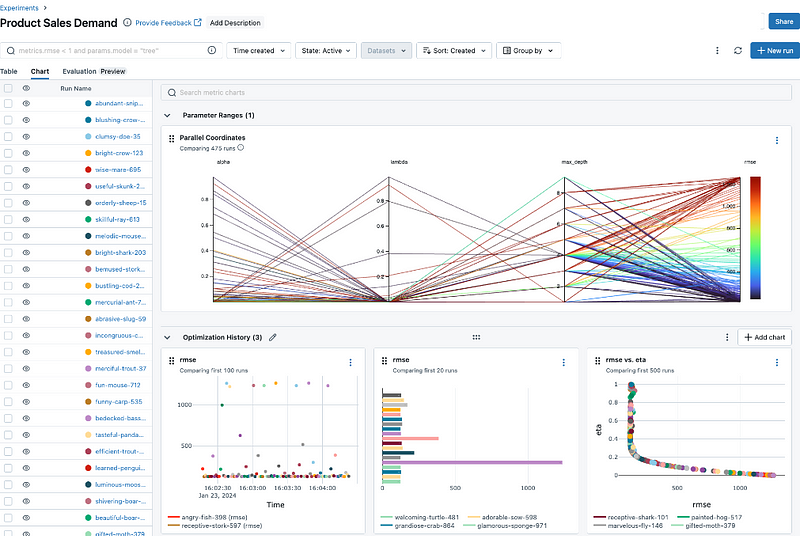
Exemplo de experimento no MLflow (captura de tela do autor)
Os passos para criar uma estrutura de experimentação são:
Uma vez estabelecida a estrutura, conseguimos iterar rapidamente para chegar ao melhor modelo mais cedo.
O Model Serving, outro recurso do Databricks Lakehouse AI, simplifica a transição de modelos do estágio de desenvolvimento para produção.
Essa funcionalidade permite implantar modelos como endpoints REST, que podem ser facilmente integrados a várias aplicações e serviços para predições em tempo real ou inferência em batch.
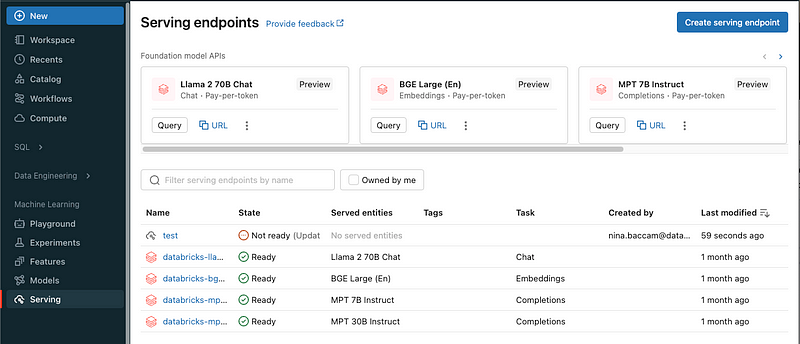
Endpoints de Model Serving (Fonte)
Depois que um modelo é treinado, cientistas de dados podem implantá-lo com poucos cliques, sem necessidade de grande configuração ou conhecimento aprofundado de DevOps. Veja como fazer:
Recomendamos seguir estes exemplos detalhados de tutorial da Databricks para executar essas etapas com facilidade. Essa agilidade na implantação é essencial nos fluxos de dados modernos, em que iterar e colocar modelos em produção rapidamente pode gerar muito valor de negócio.
Depois que nossos modelos entram em produção, a última etapa crucial do ciclo de IA é o monitoramento e a avaliação contínua. Isso envolve acompanhar o desempenho do modelo para garantir que continue eficaz e preciso ao longo do tempo.
O Databricks Lakehouse AI facilita isso por meio do Lakehouse Monitoring e das Inference Tables, ferramentas essenciais para manter a saúde e a eficácia dos sistemas de IA. Como já vimos os recursos do Lakehouse Monitoring, aqui vamos focar nas inference tables.
Em termos simples, a Inference Table é um recurso adicional, habilitado por uma checkbox, que permite capturar os dados de entrada e as respectivas predições dos endpoints de Model Serving e registrá-los em uma delta table, que fará parte do Unity Catalog.
Esse mecanismo de registro traz vários benefícios:
O processo de desenvolvimento de machine learning é cíclico, ou seja, usamos o feedback da primeira versão em produção para refinar, retreinar e construir modelos mais precisos e eficientes, voltando ao primeiro passo novamente.
Este tutorial apresentou a evolução do Databricks Lakehouse AI e seus recursos centrais. Também vimos como esses recursos se conectam por meio de uma governança unificada. Por fim, analisamos como percorrer o ciclo de desenvolvimento de machine learning de ponta a ponta usando a plataforma Databricks Lakehouse AI.
Para saber mais sobre o Databricks Lakehouse e sua aplicação em engenharia de dados, desenvolvimento de machine learning e construção de aplicações em grande escala, recomendamos como próximo passo nosso curso Introduction to Databricks.
Comece sua jornada em IA hoje mesmo!
Curso
Curso
Curso
blog
Adel Nehme
15 min
blog
Yuliya Melnik
15 min
blog
Austin Chia
9 min
blog
Javier Canales Luna
9 min
Tutorial
Zoumana Keita
14 min
Tutorial