

课程
MLOps 概念
2 小时
46.1K
实践并学习路径你的进步。
使用 Google 继续随着大语言模型(LLMs)对高端且显存充足的 GPU 机器的要求不断提高,部署难度也在不断加大。工程师还必须掌握MLOps 工具,以完成模型的服务化、部署、测试与监控。此外,他们还需要实施访问限制并维护安全,以抵御网络威胁与提示注入攻击。作为一名LLMOps 工程师并不轻松——但别担心,我们已经为您准备好了!
在本教程中,我们将探索一种更简单、更高效的云端部署方案,用于上线如 Llama 3.3 70B 等 LLM。只需几行 Python 代码和一些终端命令,您的模型就能启动运行。BentoCloud 会简化并托管全部流程,使部署过程直观且安全。
如果您是初学者,建议先学习 Introduction to LLMs in Python 课程,了解大语言模型的基础知识。
全新的 Meta Llama 3.3 是一款仅文本(70B)指令微调的多语种大语言模型(LLM),相较 Llama 3.1(70B)和 Llama 3.2(90B)有更佳表现。在某些场景下,它甚至超越了更大的 Llama 3.1(405B)。该模型专注于文本,针对多语对话用例进行了优化。
Llama 3.3 是基于优化的 Transformer 架构构建的自回归语言模型。它通过有监督微调(SFT)和基于人类反馈的强化学习(RLHF)进行训练,以更好地与人类在有用性与安全性方面的偏好对齐。
想进一步了解 Llama 3.3,请阅读博文What Is Meta's Llama 3.3 70B? How It Works, Use Cases & More。
本项目将使用 BentoML 构建 AI 服务,使用 vLLM 实现高吞吐量的模型服务,并通过 BentoCloud 提供稳健的基础设施与部署。此外,我们将部署模型的 AWQ 版本以优化性能。
简而言之,vLLM 与 AWQ 的组合堪称“神兵利器”,可构建超快且能同时处理多请求的 LLM 应用。
AWQ(Activation-aware Weight Quantization,激活感知权重量化)是一种创新的量化技术,旨在提升大型语言模型的部署效率。它能在尽可能保持高精度的同时,大幅降低内存占用并提升推理速度。
阅读研究论文,了解 AWQ 技术如何在保证精度的前提下优化模型推理。
vLLM(Virtual Large Language Model)是专为优化大语言模型推理与服务而设计的开源库。它通过引入 PagedAttention 等先进技术,解决吞吐量与内存效率等关键挑战,确保注意力 KV 内存管理高效。
通过教程vLLM: Setting Up vLLM Locally and on Google Cloud for CPU进一步了解 vLLM 的 Python 包。
BentoML 是一个开源的机器学习模型服务框架,是 LLM 部署流水线的中坚力量。它简化了在生产环境中对包括 LLM 在内的机器学习模型的打包、部署与管理。
参阅教程How to Deploy LLMs with BentoML,了解 BentoML 生态与如何部署较小的 LLM 模型。
BentoCloud 是构建在 BentoML 之上的无服务器平台,旨在简化机器学习模型的部署与管理。它为 AI 推理优化了稳健的基础设施,尤其适合服务 LLM。
借助 BentoCloud,用户无需操心基础设施管理,即可在云环境中部署可扩展且高效的 AI 解决方案。
接下来进入项目实操。我们将创建以下组件:
app.py 文件,使用 vLLM 与 FastAPI 定义模型服务 API。requirements.txt 文件,指定云环境需安装的 Python 包。bentofile.yaml 文件,用于配置基础设施、构建 Docker 镜像并设置部署环境。首先使用 pip 命令安装 BentoML Python 包:
pip install bentoml在 Python 应用文件中,我们将按以下步骤设置模型端点:
bentoml、fastapi 与 vllm 等 Python 库。将以下代码添加到您的 app.py:
# Standard library imports
import uuid
from argparse import Namespace
from typing import AsyncGenerator, Optional

# Third-party imports
import bentoml
import fastapi
from annotated_types import Ge, Le
from typing_extensions import Annotated

# Initialize FastAPI application
openai_api_app = fastapi.FastAPI()

# Constants
MAX_MODEL_LEN = 8192
MAX_TOKENS = 1024

SYSTEM_PROMPT = """You are a helpful and respectful assistant. Provide safe, unbiased, and accurate answers.
                If a question is unclear or you don't know the answer, explain why instead of guessing."""

MODEL_ID = "casperhansen/llama-3.3-70b-instruct-awq"

# Define OpenAI-compatible API endpoints
OPENAI_ENDPOINTS = [
    ["/chat/completions", "create_chat_completion", ["POST"]],
    ["/completions", "create_completion", ["POST"]],
    ["/models", "show_available_models", ["GET"]],
]


@bentoml.mount_asgi_app(openai_api_app, path="/v1")
@bentoml.service(
    name="llama3.3-70b-instruct-awq",
    traffic={
        "timeout": 1200,
        "concurrency": 256,
    },
    resources={
        "gpu": 1,
        "gpu_type": "nvidia-a100-80gb",
    },
)


class BentoVLLM:
    def __init__(self) -> None:
        """Initialize the BentoVLLM service with VLLM engine and tokenizer."""
        import vllm.entrypoints.openai.api_server as vllm_api_server
        from transformers import AutoTokenizer
        from vllm import AsyncEngineArgs, AsyncLLMEngine

        # Configure VLLM engine arguments
        ENGINE_ARGS = AsyncEngineArgs(
            model=MODEL_ID,
            max_model_len=MAX_MODEL_LEN,
            enable_prefix_caching=True,
        )

        # Initialize engine and tokenizer
        self.engine = AsyncLLMEngine.from_engine_args(ENGINE_ARGS)
        self.tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)

        # Register API endpoints
        for route, endpoint_name, methods in OPENAI_ENDPOINTS:
            endpoint_func = getattr(vllm_api_server, endpoint_name)
            openai_api_app.add_api_route(
                path=route,
                endpoint=endpoint_func,
                methods=methods,
            )

        # Configure model arguments
        model_config = self.engine.engine.get_model_config()
        args = Namespace(
            model=MODEL_ID,
            disable_log_requests=True,
            max_log_len=1000,
            response_role="assistant",
            served_model_name=None,
            chat_template=None,
            lora_modules=None,
            prompt_adapters=None,
            request_logger=None,
            disable_log_stats=True,
            return_tokens_as_token_ids=False,
            enable_tool_call_parser=True,
            enable_auto_tool_choice=True,
            tool_call_parser="llama3_json",
            enable_prompt_tokens_details=False,
        )

        # Initialize application state
        vllm_api_server.init_app_state(
            self.engine, model_config, openai_api_app.state, args
        )

    @bentoml.api
    async def generate(
        self,
        prompt: str = "Describe the process of photosynthesis in simple terms",
        system_prompt: Optional[str] = SYSTEM_PROMPT,
        max_tokens: Annotated[int, Ge(128), Le(MAX_TOKENS)] = MAX_TOKENS,
    ) -> AsyncGenerator[str, None]:
        """
        Generate text based on the input prompt using the VLLM engine.

        Args:
            prompt: The user's input prompt
            system_prompt: Optional system prompt to guide the model's behavior
            max_tokens: Maximum number of tokens to generate

        Returns:
            AsyncGenerator yielding generated text chunks
        """
        from vllm import SamplingParams

        # Configure sampling parameters
        SAMPLING_PARAM = SamplingParams(
            max_tokens=max_tokens,
            skip_special_tokens=True,
        )

        # Use default system prompt if none provided
        if system_prompt is None:
            system_prompt = SYSTEM_PROMPT

        # Prepare messages for chat
        messages = [
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": prompt},
        ]

        # Apply chat template
        prompt = self.tokenizer.apply_chat_template(
            messages,
            tokenize=False,
            add_generation_prompt=True,
        )

        # Generate response stream
        stream = await self.engine.add_request(uuid.uuid4().hex, prompt, SAMPLING_PARAM)

        # Stream the generated text
        cursor = 0
        async for request_output in stream:
            text = request_output.outputs[0].text
            yield text[cursor:]
            cursor = len(text)
创建 requirements.txt 文件,包含构建 AI 应用所需的全部 Python 包。请固定每个包的确切版本,以保障项目的稳定性与可复现性。
requirements.txt 内容应如下:
accelerate==1.2.0
autoawq==0.2.7.post3
bentoml>=1.3.15
fastapi==0.115.6
openai==1.57.0
vllm==0.6.4.post1; sys_platform == "linux"
bentofile.yaml 是用于定义与构建 BentoML 服务的配置文件,包含以下组件:
app.py)与服务类名(BentoVLLM)。requirements.txt 安装所需的 Python 包。将以下内容加入您的 bentofile.yaml 文件:
service: 'app:BentoVLLM'
labels:
  owner: Abid
  team: DataCamp
  stage: dev
include:
  - '*.py'
python:
  requirements_txt: './requirements.txt'
  lock_packages: false
docker:
python_version: "3.11"神奇的部分来了:BentoCloud 会替我们处理一切,我们只需执行一条命令。但在此之前,需要先在终端中输入以下命令登录 BentoCloud。
bentoml cloud login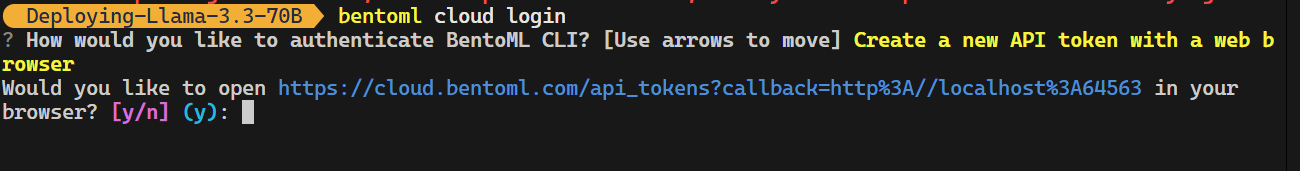
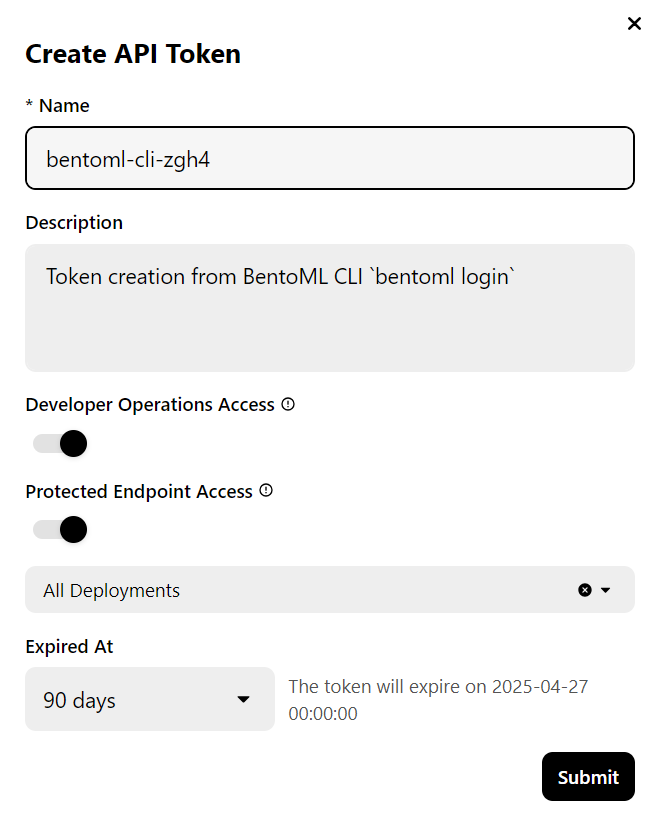
CLI 工具会询问您几个问题,然后将您重定向到 BentoCloud 网站以创建账户并生成 API 密钥。
完成后,它会自动将 API 密钥应用到您的 CLI 工具中。
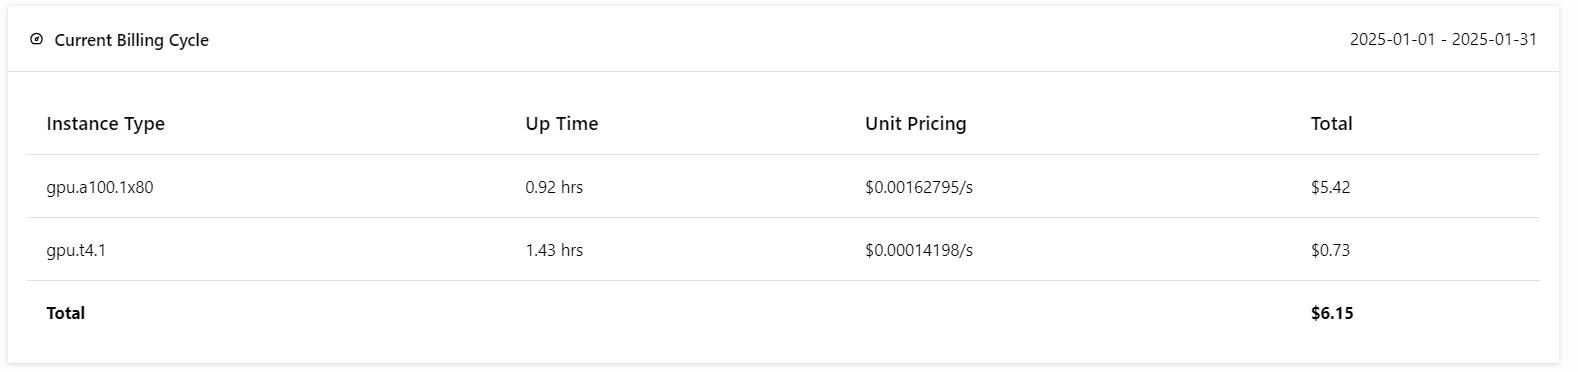
注意: 部署 70B 全量版本需要 80GB 的 GPU 显存。尽管 BentoCloud 提供 10 美元的免费额度,但您需要订阅专业版以使用拥有 80GB 显存的 A100 GPU。
要订阅,请点击右上角的个人头像进入 “Billing” 选项卡,并添加信用卡信息。
别担心;只要谨慎控制部署,费用不会超过 6 美元。但请务必在完成试验后终止部署!
接下来是最精彩的一步:我们将使用以下命令把 BentoML 应用部署到云端,并启用访问授权。这意味着只有持有 BentoML API 密钥的用户才能访问该 API 服务器。
bentoml deploy . --access-authorization true文件、配置与其他必要组件发送只需几秒,之后 BentoCloud 将接管剩余流程。
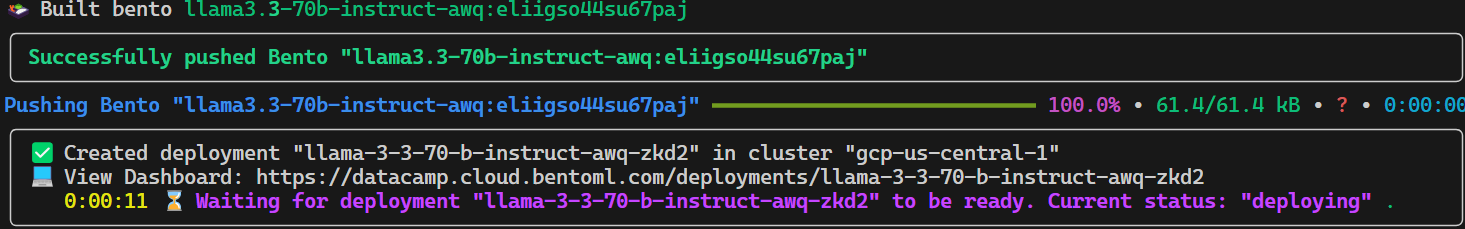
要查看当前正在运行的部署,请前往 BentoCloud 控制台并点击 “Deployments” 选项卡。如下图所示,应用处于 “Image Building” 流程:
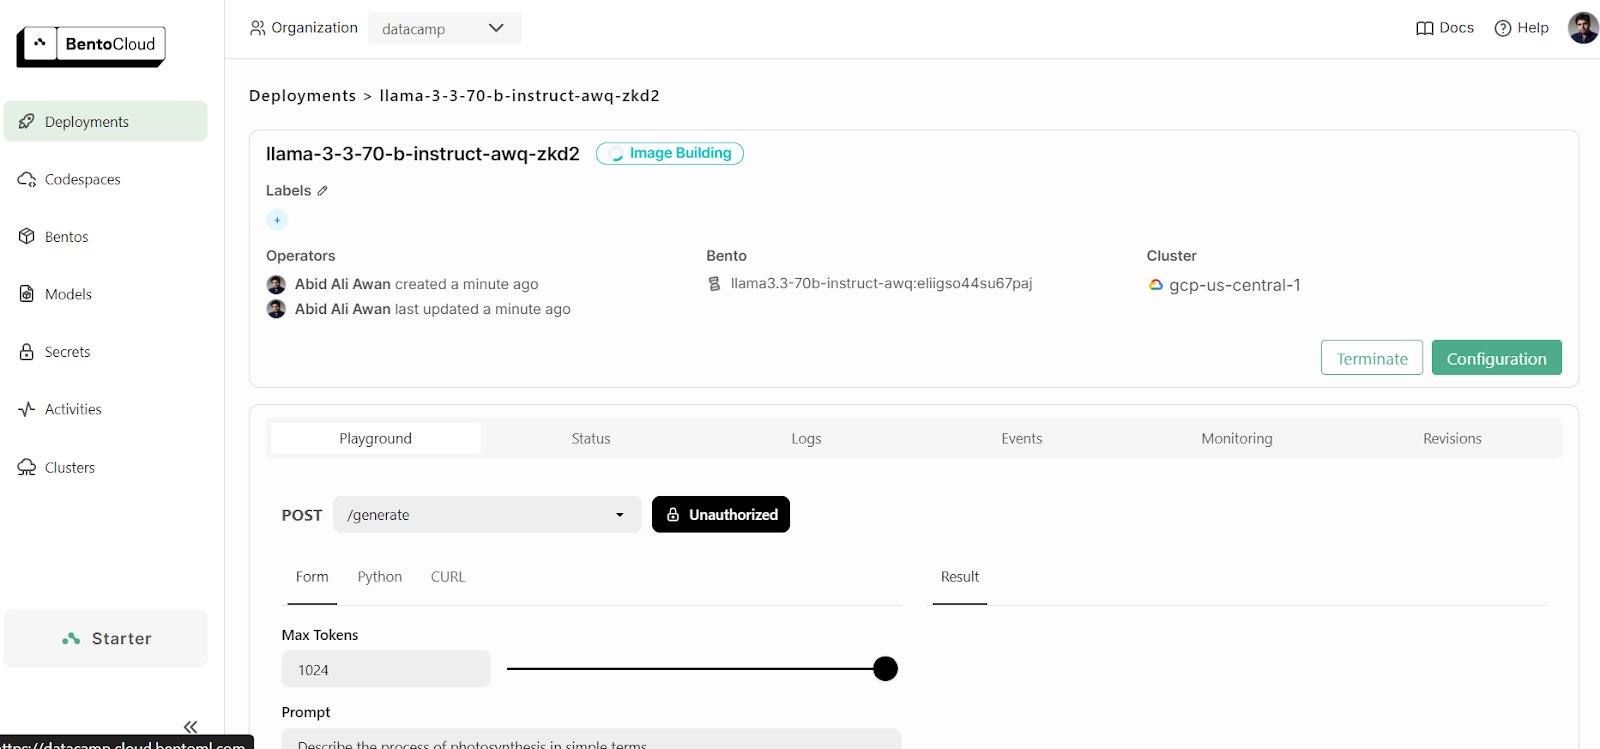
经过几分钟的镜像构建、基础设施准备与模型部署后,我们的应用即可投入使用!
BentoCloud 在控制台提供了类似 OpenAI 平台的 Playground UI,便于测试模型。由于我们的服务受限访问,在 Playground 中需要提供 API 密钥,如下所示:
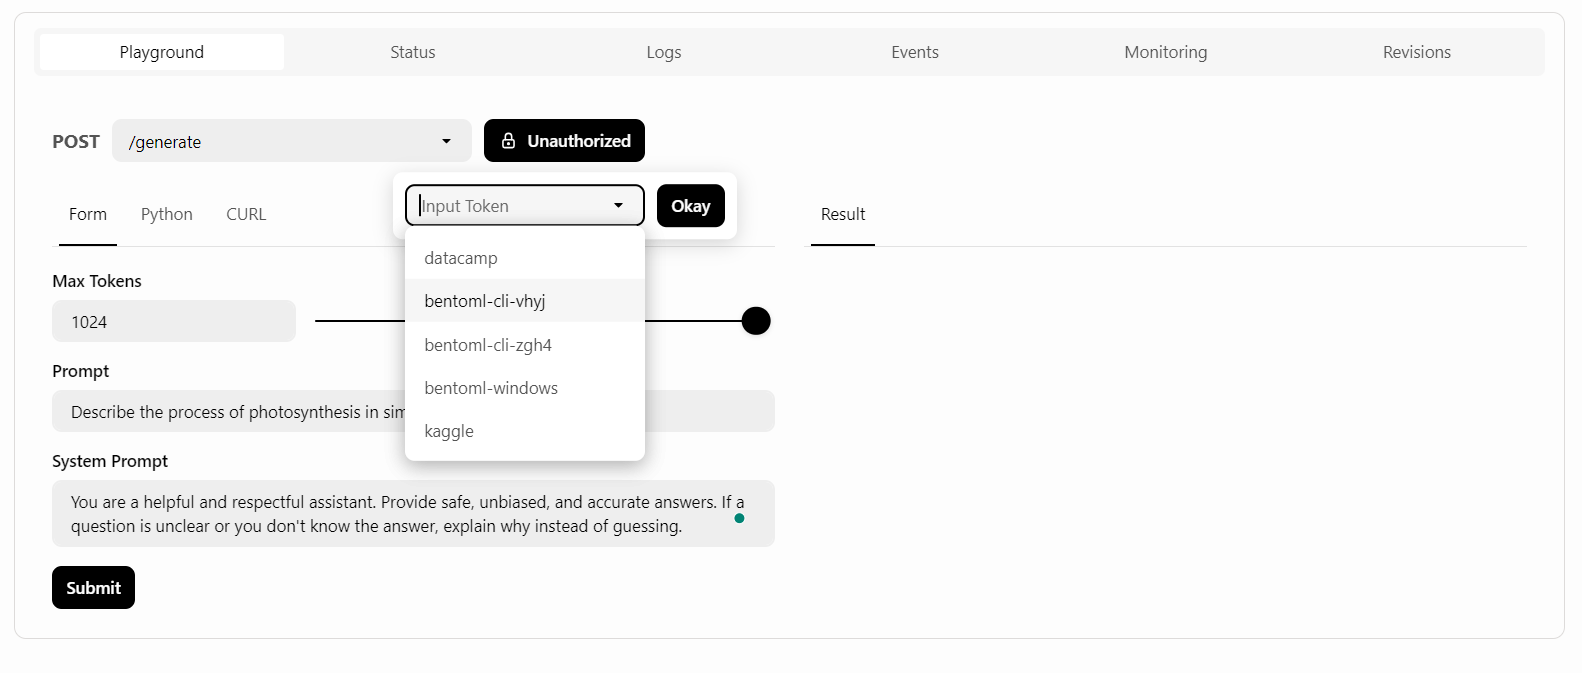
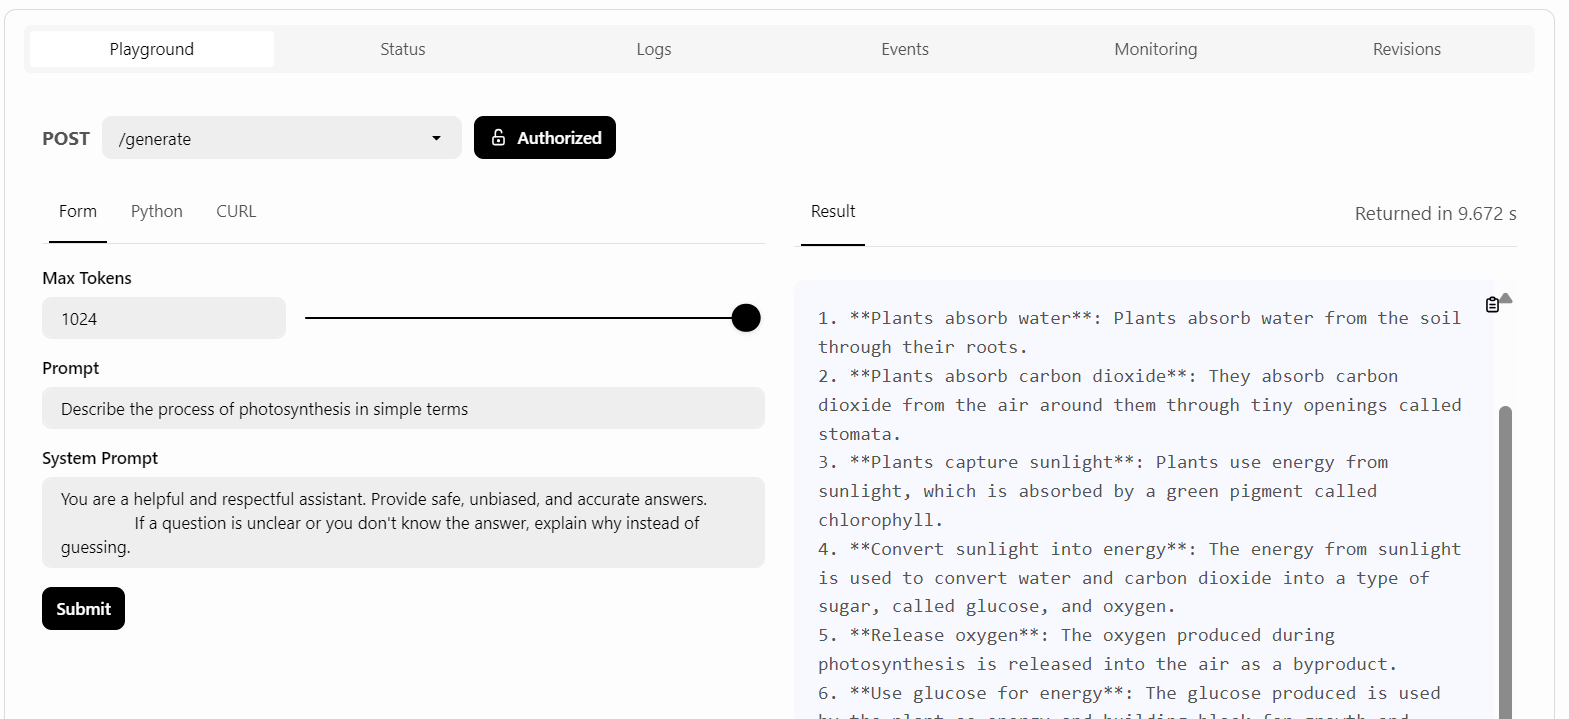
随后输入提示词并点击 “Submit”。
响应生成迅速且准确:
我们将在本地终端使用 CURL 命令访问 LLM 服务。但在此之前,需要生成一个新的 API 密钥,以便在任意系统上使用该服务:
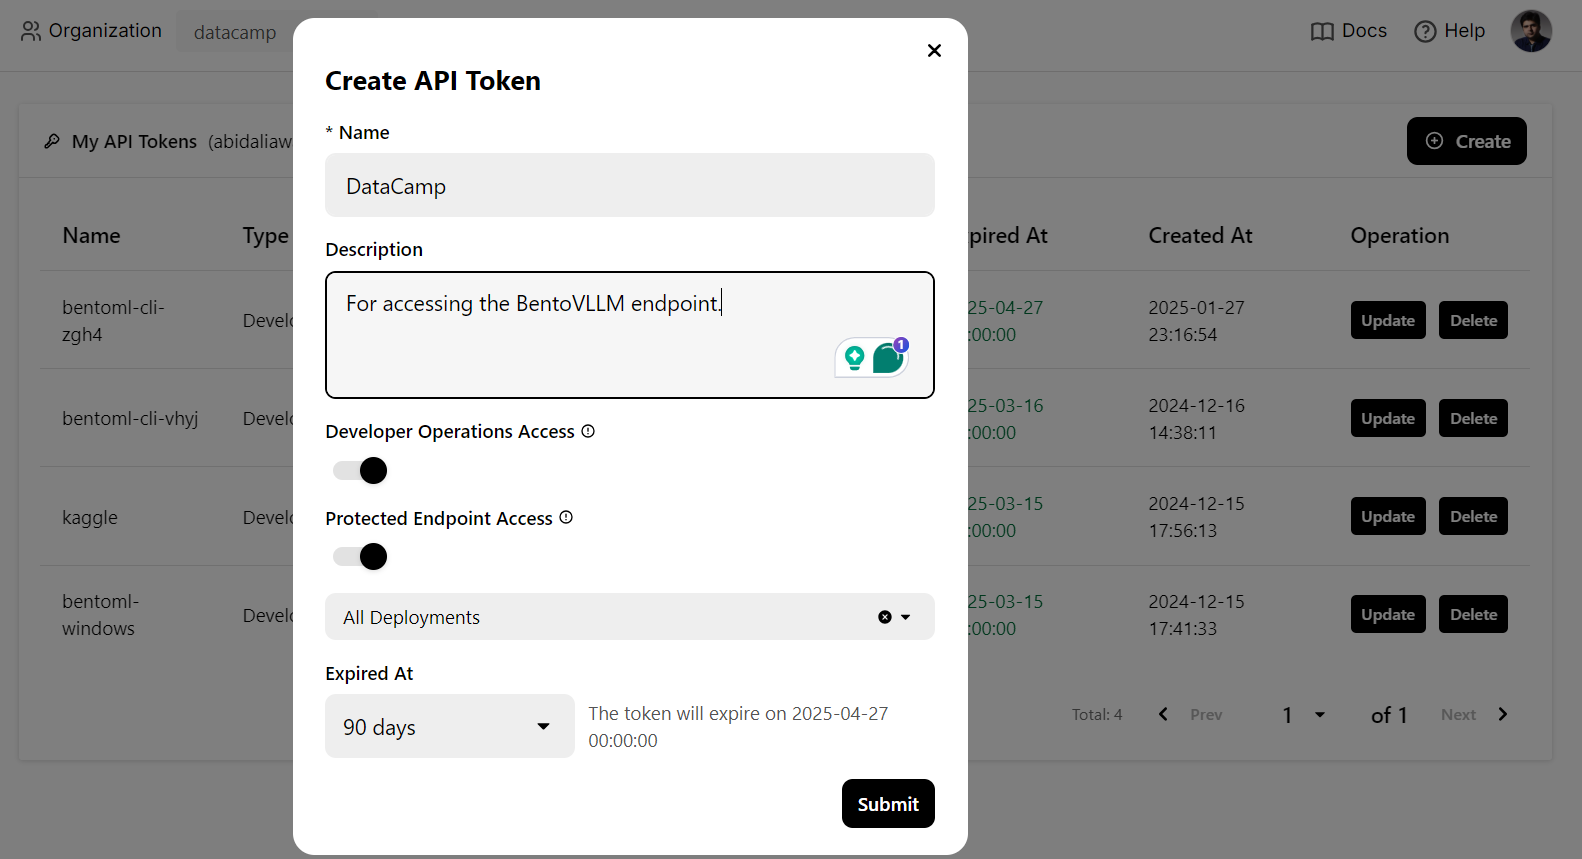
此外,还需要端点 URL,可在 “Deployments” 选项卡中复制:
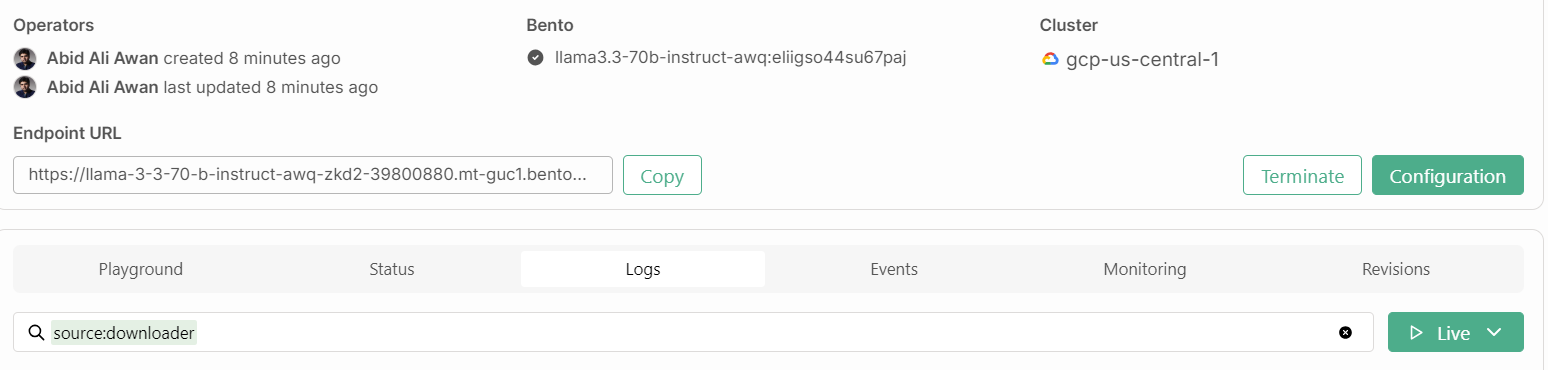
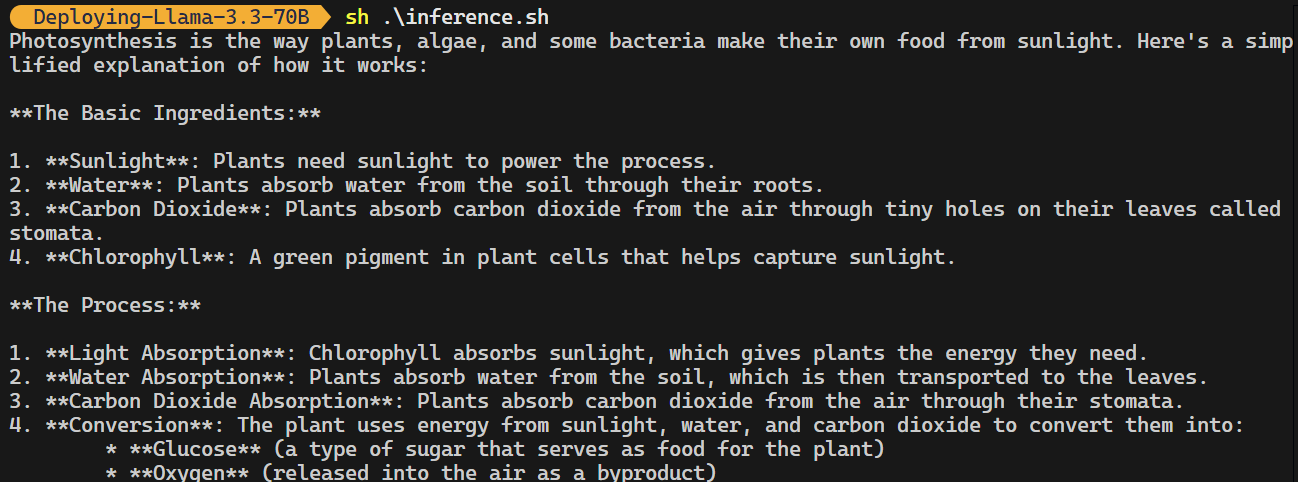
拿到 API 密钥与端点 URL 后,使用以下 CURL 命令即可生成响应。
该命令包含端点 URL、API 密钥、max_tokens 参数与 prompt:
curl -s -X POST \
    'https://llama-3-3-70-b-instruct-awq-zkd2-39800880.mt-guc1.bentoml.ai/generate' \
    -H "Authorization: Bearer $(echo $BENTO_CLOUD_API_KEY)" \
    -H 'Content-Type: application/json' \
    -d '{
        "max_tokens": 1024,
        "prompt": "Describe the process of photosynthesis in simple terms"
    }'
响应结果准确,且仅用几次发送就完成了生成。
BentoML 端点与 OpenAI Python 客户端兼容。您几乎无需修改代码即可将该开源模型集成到应用中。
您只需更改 base URL、提供 API 密钥并指定模型名称:
import os

from openai import OpenAI

BENTOML_API_KEY = os.getenv("BENTO_CLOUD_API_KEY")  #
if BENTOML_API_KEY is None:
    raise ValueError("BENTOML_API_KEY environment variable is not set.")


client = OpenAI(
    base_url="https://llama-3-3-70-b-instruct-awq-zkd2-39800880.mt-guc1.bentoml.ai/v1",
    api_key=BENTOML_API_KEY,
)

chat_completion = client.chat.completions.create(
    model="casperhansen/llama-3.3-70b-instruct-awq",
    messages=[
        {"role": "user", "content": "What is a black hole and how does it work?"}
    ],
    stream=True,
    stop=["<|eot_id|>", "<|end_of_text|>"],
)
for chunk in chat_completion:
    print(chunk.choices[0].delta.content or "", end="")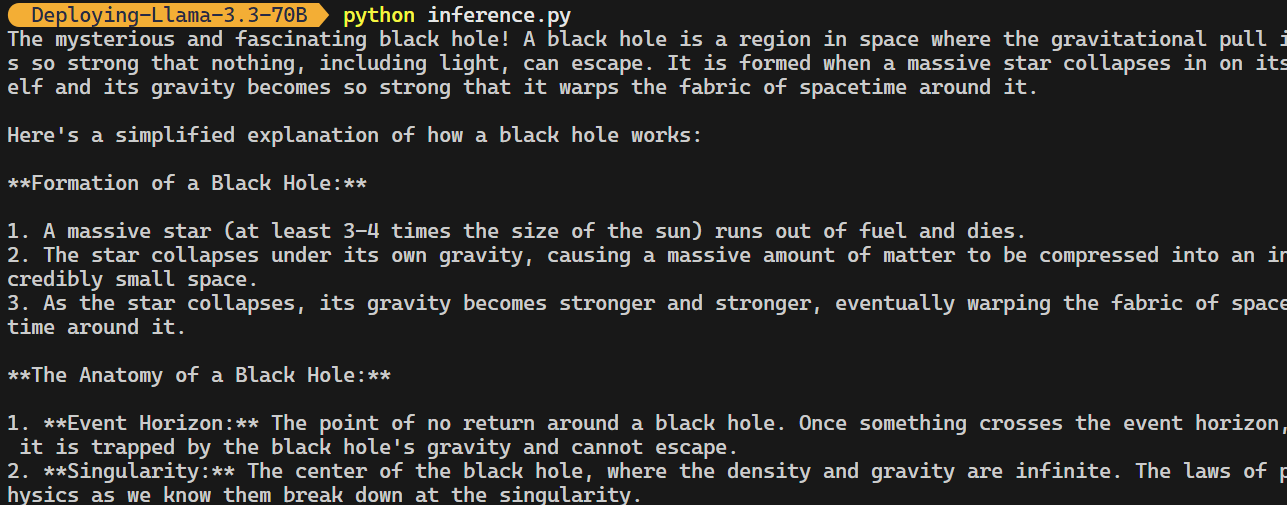
欢迎查阅 GitHub 仓库 kingabzpro/Deploying-Llama-3.3-70B,其中包含应用文件、配置与推理代码。
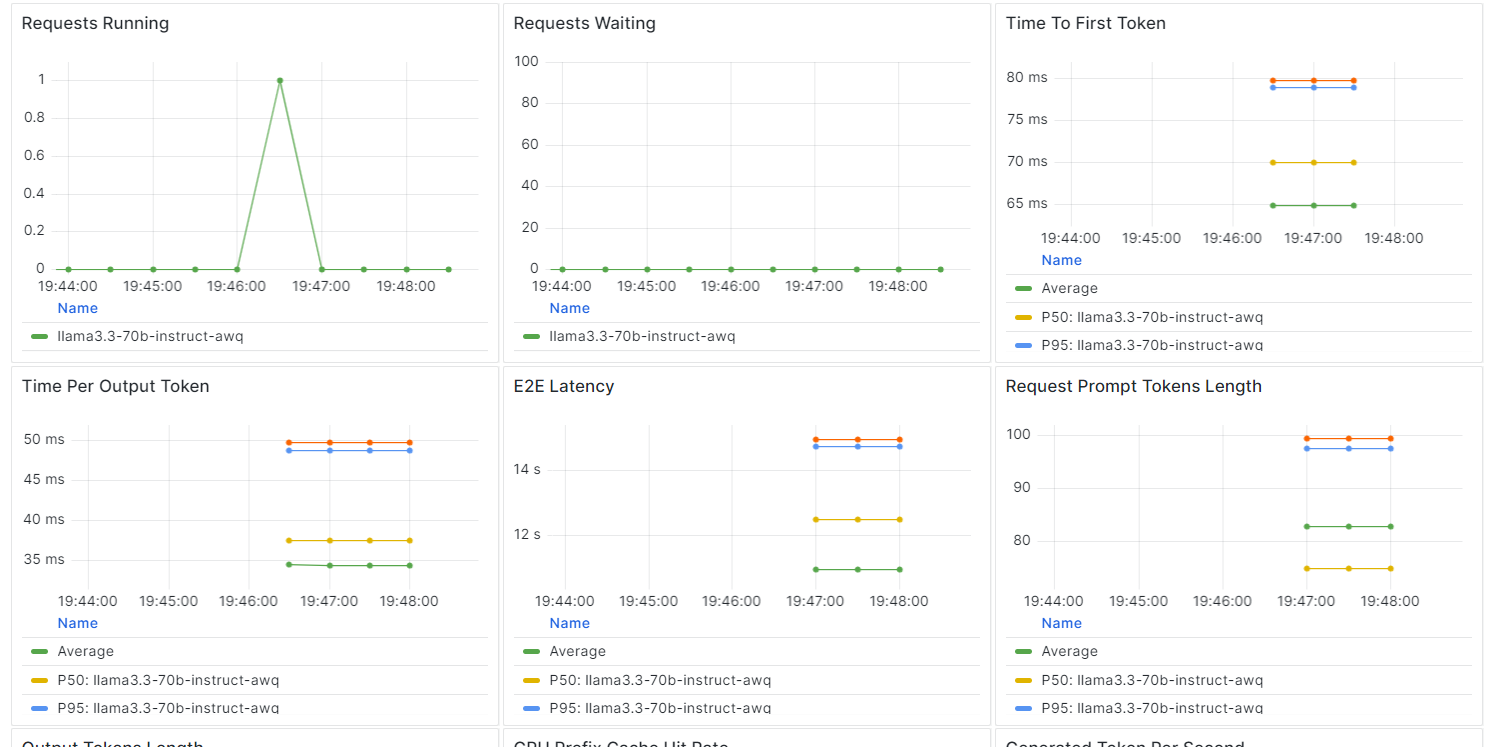
在 BentCloud 上,您无需额外搭建日志或监控工具,即可监控模型性能、延迟、硬件使用率、模型吞吐量及其他关键指标。
进入您的部署页面并点击 “Monitoring” 选项卡。
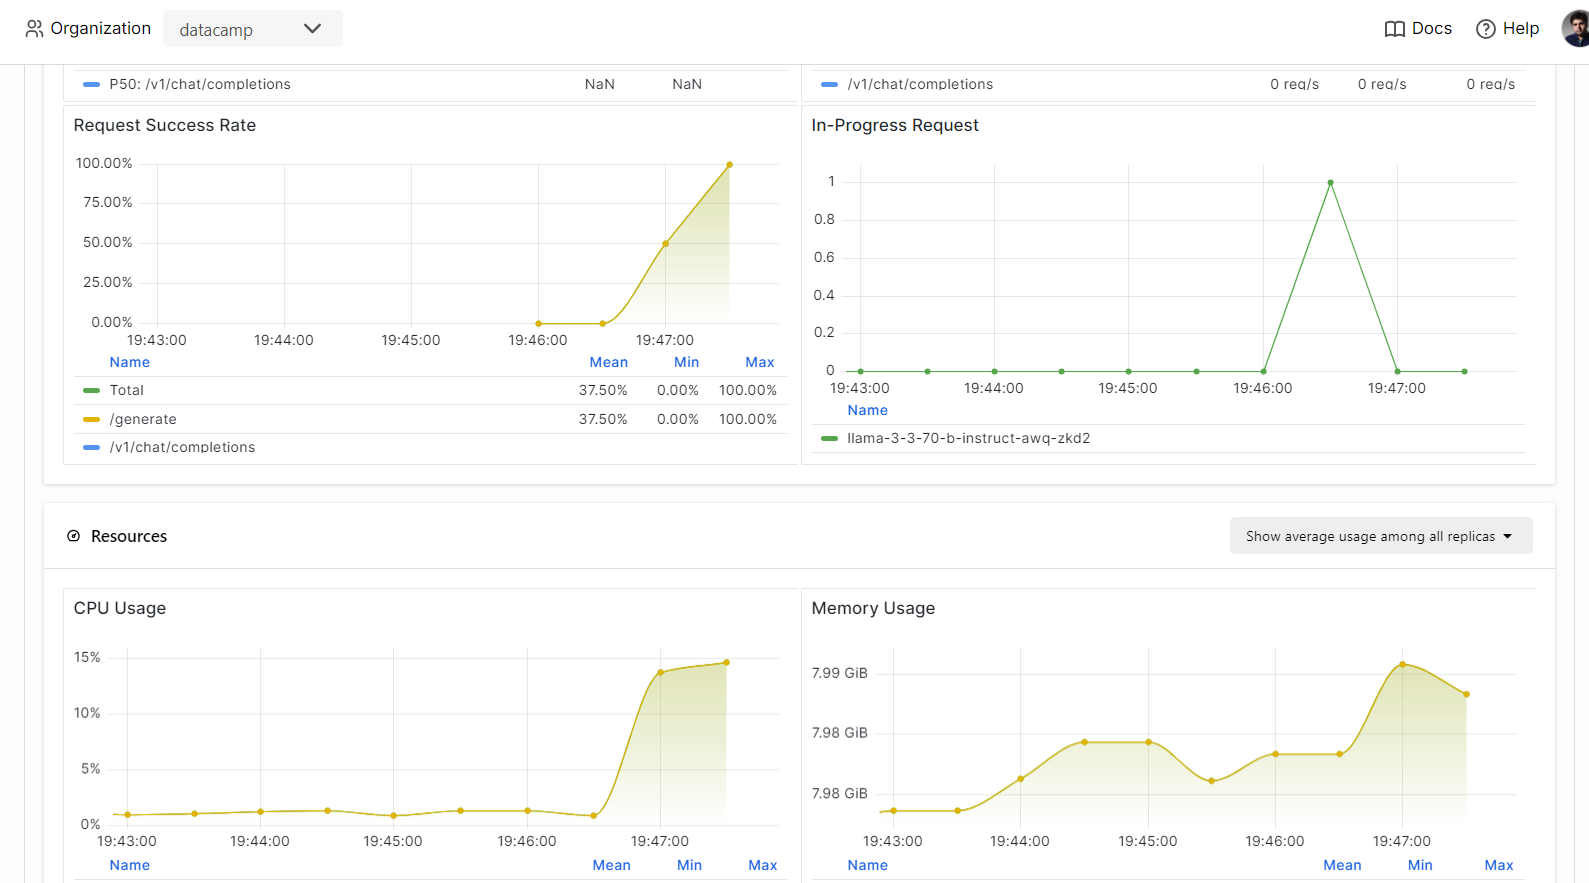
向下滚动可查看与服务、资源及 LLM 相关的指标,这些图表直观明了。
借助 BentoML 生态,构建与部署 LLM 端点已变得异常简单。
只需编写少量代码创建 API、配置 “bentofile” 并部署模型,您就能在数分钟内让模型上线。部署完成后,可通过 CURL 命令、Python 的 requests 库、BentoML 客户端或 OpenAI 客户端访问该端点。
最终,您将获得一个高效、低延迟、高吞吐的系统,能够同时处理多路请求。BentoCloud 还可基于您的配置实现自动伸缩,按需扩容或缩容以应对高并发流量。
如需更深入的 BentoML 部署 LLM 指南,建议参考How to Deploy LLMs with BentoML: A Step-by-Step Guide。
通过以下课程进一步学习 AI 与 LLM!
课程
课程
实践并学习路径你的进步。
使用 Google 继续