

Tìm hiểu các công cụ và dịch vụ chính cho dự án
Trong dự án này, chúng ta sẽ dùng BentoML để xây dựng dịch vụ AI, vLLM cho phục vụ mô hình thông lượng cao và BentoCloud cho hạ tầng, triển khai ổn định. Ngoài ra, chúng ta sẽ triển khai phiên bản AWQ của mô hình để tối ưu hiệu năng.
Tóm lại, vLLM kết hợp AWQ tạo nên một bộ đôi “sát thủ” để xây dựng ứng dụng LLM siêu nhanh và có thể xử lý đồng thời nhiều yêu cầu.
AWQ
AWQ (Activation-aware Weight Quantization) là kỹ thuật lượng tử hóa sáng tạo được thiết kế để nâng cao khả năng triển khai các mô hình ngôn ngữ lớn. Nó giảm đáng kể mức sử dụng bộ nhớ và cải thiện tốc độ suy luận, đồng thời vẫn duy trì độ chính xác cao.
Đọc bài báo nghiên cứu để tìm hiểu về công nghệ AWQ và cách nó tối ưu suy luận mô hình mà vẫn đảm bảo độ chính xác.
vLLM
vLLM (Virtual Large Language Model) là thư viện mã nguồn mở được thiết kế để tối ưu suy luận và phục vụ các mô hình ngôn ngữ lớn. Nó giải quyết các thách thức quan trọng như thông lượng và hiệu quả bộ nhớ bằng cách giới thiệu các kỹ thuật tiên tiến như PagedAttention, giúp quản lý bộ nhớ key-value của attention hiệu quả.
Tìm hiểu thêm về gói vLLM Python qua hướng dẫn vLLM: Thiết lập vLLM cục bộ và trên Google Cloud cho CPU.
BentoML
BentoML là khung phục vụ mô hình học máy mã nguồn mở, đóng vai trò xương sống của pipeline triển khai LLM. Nó đơn giản hóa việc đóng gói, triển khai và quản lý mô hình học máy, bao gồm cả LLM, trong môi trường sản xuất.
Theo dõi hướng dẫn Cách triển khai LLMs với BentoML để tìm hiểu hệ sinh thái BentoML và cách triển khai các mô hình LLM nhỏ hơn.
BentoCloud
BentoCloud là nền tảng serverless xây dựng trên BentoML, được thiết kế để tối ưu quy trình triển khai và quản lý mô hình học máy. Nó cung cấp hạ tầng mạnh mẽ tối ưu cho suy luận AI, đặc biệt phù hợp để phục vụ LLM.
Với BentoCloud, người dùng có thể triển khai các giải pháp AI có khả năng mở rộng và hiệu quả trên môi trường đám mây mà không phải bận tâm về quản trị hạ tầng.
Phát triển ứng dụng Llama 3.3 70B
Giờ hãy bắt đầu dự án. Chúng ta sẽ tạo các thành phần sau:
- Tệp
app.pyđể định nghĩa API phục vụ mô hình với vLLM và FastAPI. - Tệp
requirements.txtđể chỉ định các gói Python cần thiết cho môi trường đám mây. - Tệp
bentofile.yamlđể cấu hình hạ tầng, dựng ảnh Docker và thiết lập môi trường triển khai.
Chúng ta sẽ bắt đầu bằng cách cài gói BentoML Python với lệnh pip:
pip install bentomlTrong tệp ứng dụng Python, chúng ta sẽ thiết lập endpoint của mô hình bằng cách:
- Import các thư viện Python như
bentoml,fastapivàvllm. - Tạo ứng dụng FastAPI để phục vụ các endpoint tương thích OpenAI.
- Định nghĩa tham số mô hình, system prompt và ID mô hình.
- Chỉ định route cho chat completions, completions và danh sách mô hình.
- Cấu hình dịch vụ BentoML với tài nguyên GPU (NVIDIA A100) và mount ứng dụng FastAPI.
- Thiết lập engine VLLM và tokenizer cho suy luận mô hình.
- Triển khai phương thức bất đồng bộ và streaming để truyền tải phản hồi theo luồng.
Thêm đoạn mã dưới đây vào app.py của bạn:
# Standard library imports
import uuid
from argparse import Namespace
from typing import AsyncGenerator, Optional
# Third-party imports
import bentoml
import fastapi
from annotated_types import Ge, Le
from typing_extensions import Annotated
# Initialize FastAPI application
openai_api_app = fastapi.FastAPI()
# Constants
MAX_MODEL_LEN = 8192
MAX_TOKENS = 1024
SYSTEM_PROMPT = """You are a helpful and respectful assistant. Provide safe, unbiased, and accurate answers.
If a question is unclear or you don't know the answer, explain why instead of guessing."""
MODEL_ID = "casperhansen/llama-3.3-70b-instruct-awq"
# Define OpenAI-compatible API endpoints
OPENAI_ENDPOINTS = [
["/chat/completions", "create_chat_completion", ["POST"]],
["/completions", "create_completion", ["POST"]],
["/models", "show_available_models", ["GET"]],
]
@bentoml.mount_asgi_app(openai_api_app, path="/v1")
@bentoml.service(
name="llama3.3-70b-instruct-awq",
traffic={
"timeout": 1200,
"concurrency": 256,
},
resources={
"gpu": 1,
"gpu_type": "nvidia-a100-80gb",
},
)
class BentoVLLM:
def __init__(self) -> None:
"""Initialize the BentoVLLM service with VLLM engine and tokenizer."""
import vllm.entrypoints.openai.api_server as vllm_api_server
from transformers import AutoTokenizer
from vllm import AsyncEngineArgs, AsyncLLMEngine
# Configure VLLM engine arguments
ENGINE_ARGS = AsyncEngineArgs(
model=MODEL_ID,
max_model_len=MAX_MODEL_LEN,
enable_prefix_caching=True,
)
# Initialize engine and tokenizer
self.engine = AsyncLLMEngine.from_engine_args(ENGINE_ARGS)
self.tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
# Register API endpoints
for route, endpoint_name, methods in OPENAI_ENDPOINTS:
endpoint_func = getattr(vllm_api_server, endpoint_name)
openai_api_app.add_api_route(
path=route,
endpoint=endpoint_func,
methods=methods,
)
# Configure model arguments
model_config = self.engine.engine.get_model_config()
args = Namespace(
model=MODEL_ID,
disable_log_requests=True,
max_log_len=1000,
response_role="assistant",
served_model_name=None,
chat_template=None,
lora_modules=None,
prompt_adapters=None,
request_logger=None,
disable_log_stats=True,
return_tokens_as_token_ids=False,
enable_tool_call_parser=True,
enable_auto_tool_choice=True,
tool_call_parser="llama3_json",
enable_prompt_tokens_details=False,
)
# Initialize application state
vllm_api_server.init_app_state(
self.engine, model_config, openai_api_app.state, args
)
@bentoml.api
async def generate(
self,
prompt: str = "Describe the process of photosynthesis in simple terms",
system_prompt: Optional[str] = SYSTEM_PROMPT,
max_tokens: Annotated[int, Ge(128), Le(MAX_TOKENS)] = MAX_TOKENS,
) -> AsyncGenerator[str, None]:
"""
Generate text based on the input prompt using the VLLM engine.
Args:
prompt: The user's input prompt
system_prompt: Optional system prompt to guide the model's behavior
max_tokens: Maximum number of tokens to generate
Returns:
AsyncGenerator yielding generated text chunks
"""
from vllm import SamplingParams
# Configure sampling parameters
SAMPLING_PARAM = SamplingParams(
max_tokens=max_tokens,
skip_special_tokens=True,
)
# Use default system prompt if none provided
if system_prompt is None:
system_prompt = SYSTEM_PROMPT
# Prepare messages for chat
messages = [
{"role": "system", "content": system_prompt},
{"role": "user", "content": prompt},
]
# Apply chat template
prompt = self.tokenizer.apply_chat_template(
messages,
tokenize=False,
add_generation_prompt=True,
)
# Generate response stream
stream = await self.engine.add_request(uuid.uuid4().hex, prompt, SAMPLING_PARAM)
# Stream the generated text
cursor = 0
async for request_output in stream:
text = request_output.outputs[0].text
yield text[cursor:]
cursor = len(text)Tạo tệp requirements.txt và thêm tất cả gói Python cần thiết để xây dựng ứng dụng AI. Chỉ định chính xác phiên bản từng gói để đảm bảo tính ổn định và khả năng tái lập của dự án.
Dưới đây là cách tệp requirements.txt nên trông như thế này:
accelerate==1.2.0
autoawq==0.2.7.post3
bentoml>=1.3.15
fastapi==0.115.6
openai==1.57.0
vllm==0.6.4.post1; sys_platform == "linux"Tệp bentofile.yaml là tệp cấu hình dùng để định nghĩa và dựng dịch vụ BentoML. Nó gồm các thành phần sau:
- Định nghĩa dịch vụ: Chỉ định tên dịch vụ, liên kết tệp ứng dụng Python (
app.py) và tên lớp dịch vụ (BentoVLLM). - Nhãn: Thêm metadata như owner, team và stage để hỗ trợ tổ chức và quản lý dịch vụ.
- Tệp: Đảm bảo các tệp Python cần thiết được đưa vào quá trình build.
- Phụ thuộc: Cài đặt các gói Python bắt buộc bằng tệp
requirements.txt. - Phiên bản Python: Cấu hình container Docker sử dụng Python 3.11 để đảm bảo tương thích và ổn định.
Thêm nội dung sau vào tệp bentofile.yaml của bạn:
service: 'app:BentoVLLM'
labels:
owner: Abid
team: DataCamp
stage: dev
include:
- '*.py'
python:
requirements_txt: './requirements.txt'
lock_packages: false
docker:
python_version: "3.11"Triển khai ứng dụng Llama 3.3 70B
Giờ đến phần “ma thuật”: BentoCloud sẽ làm mọi thứ cho chúng ta, và bạn chỉ cần gõ một lệnh. Nhưng trước đó, hãy đăng nhập vào BentoCloud bằng cách gõ lệnh sau trong terminal.
bentoml cloud login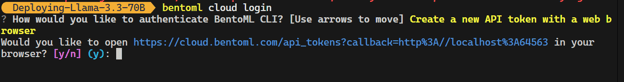
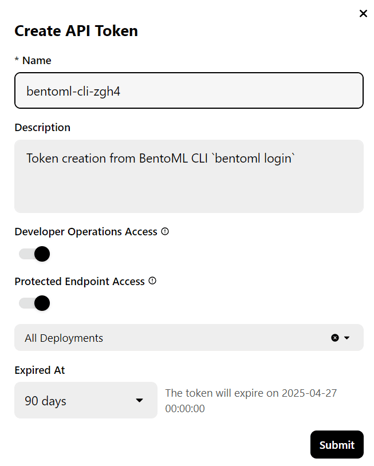
Công cụ CLI sẽ hỏi bạn vài câu và sau đó chuyển hướng đến trang BentoCloud để tạo tài khoản và sinh khóa API.
Sau khi hoàn tất, nó sẽ tự động áp dụng khóa API vào các công cụ CLI của bạn.
Lưu ý: Triển khai phiên bản đầy đủ của mô hình 70B cần 80GB bộ nhớ GPU. Mặc dù BentoCloud cung cấp 10 USD tín dụng miễn phí, bạn sẽ cần đăng ký gói pro để truy cập GPU A100 với 80GB VRAM.
Để đăng ký, vào tab “Billing” bằng cách nhấp ảnh hồ sơ ở góc phải trên và thêm thông tin thẻ tín dụng của bạn.
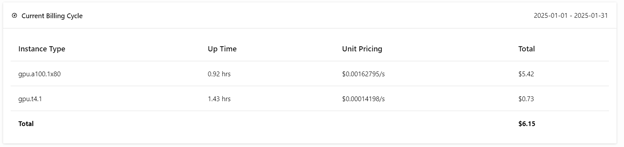
Đừng lo; nếu bạn triển khai cẩn thận, chi phí sẽ không vượt quá 6 USD. Nhưng hãy đảm bảo dừng triển khai khi bạn hoàn tất thử nghiệm!
Giờ đến phần hấp dẫn nhất: chúng ta sẽ triển khai ứng dụng BentoML lên đám mây bằng lệnh sau và bật ủy quyền truy cập. Điều này có nghĩa chỉ người dùng có khóa API BentoML mới có thể truy cập máy chủ API này.
bentoml deploy . --access-authorization trueSẽ mất vài giây để gửi tất cả tệp, cấu hình và các thành phần cần thiết, sau đó BentoCloud sẽ lo phần còn lại.
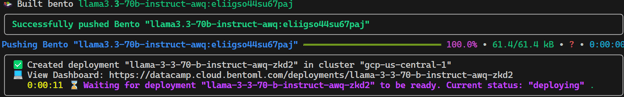
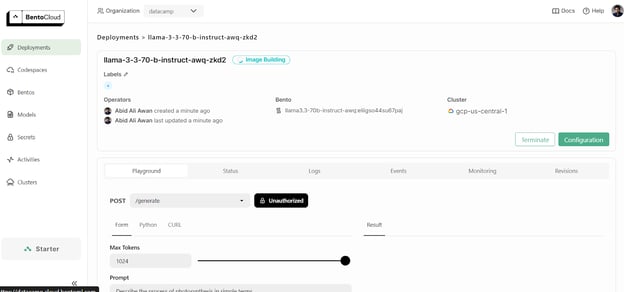
Để xem các triển khai đang chạy, vào bảng điều khiển BentoCloud và nhấp tab “Deployments”. Ví dụ, hình dưới cho thấy ứng dụng đang ở quá trình “Image Building”:
Truy cập mô hình đã triển khai
Sau vài phút dựng ảnh, thiết lập hạ tầng và triển khai mô hình, ứng dụng của chúng ta đã sẵn sàng sử dụng!
1. Playground
BentoCloud cung cấp giao diện Playground để thử mô hình trên bảng điều khiển, tương tự nền tảng OpenAI. Vì dịch vụ của chúng ta bị giới hạn, chúng ta cần cung cấp khóa API để truy cập mô hình trong Playground, như dưới đây:
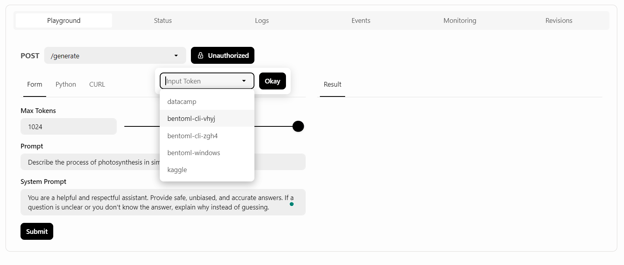
Sau đó, nhập prompt và nhấp nút “Submit”.
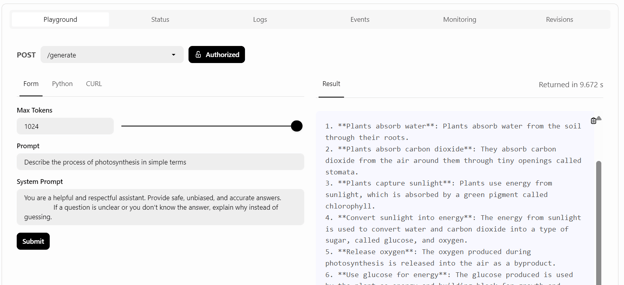
Phản hồi được tạo nhanh và chính xác:
2. Lệnh CURL
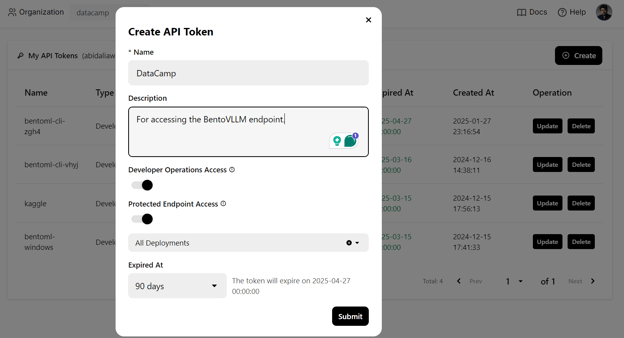
Chúng ta sẽ dùng lệnh CURL trong terminal để truy cập dịch vụ LLM tại chỗ. Nhưng trước tiên, cần tạo một khóa API mới để dùng dịch vụ này trên bất kỳ hệ thống nào:
Chúng ta cũng cần URL endpoint mà có thể sao chép từ tab “Deployments”:
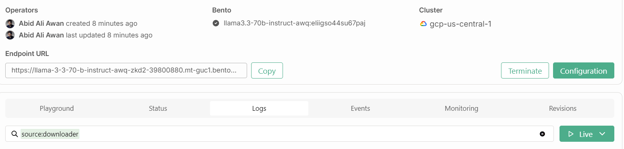
Khi đã có khóa API và endpoint URL, bạn có thể tạo phản hồi bằng lệnh CURL sau.
Lệnh bao gồm endpoint URL, khóa API, đối số max_tokens và prompt:
curl -s -X POST \
'https://llama-3-3-70-b-instruct-awq-zkd2-39800880.mt-guc1.bentoml.ai/generate' \
-H "Authorization: Bearer $(echo $BENTO_CLOUD_API_KEY)" \
-H 'Content-Type: application/json' \
-d '{
"max_tokens": 1024,
"prompt": "Describe the process of photosynthesis in simple terms"
}'Phản hồi chính xác, và mất vài lượt gửi để tạo ra nó.
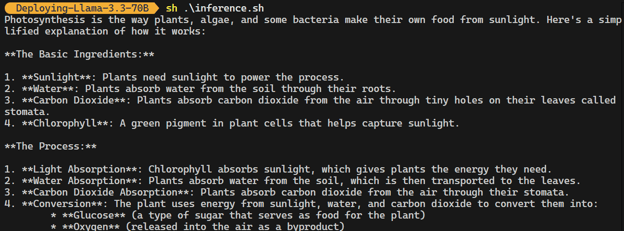
3. OpenAI Python client
Endpoint của BentoML tương thích với OpenAI Python client. Bạn không phải sửa đổi nhiều mã để tích hợp mô hình mã nguồn mở này vào ứng dụng của mình.
Bạn chỉ cần đổi base URL, cung cấp khóa API và chỉ định tên mô hình:
import os
from openai import OpenAI
BENTOML_API_KEY = os.getenv("BENTO_CLOUD_API_KEY") #
if BENTOML_API_KEY is None:
raise ValueError("BENTOML_API_KEY environment variable is not set.")
client = OpenAI(
base_url="https://llama-3-3-70-b-instruct-awq-zkd2-39800880.mt-guc1.bentoml.ai/v1",
api_key=BENTOML_API_KEY,
)
chat_completion = client.chat.completions.create(
model="casperhansen/llama-3.3-70b-instruct-awq",
messages=[
{"role": "user", "content": "What is a black hole and how does it work?"}
],
stream=True,
stop=["<|eot_id|>", "<|end_of_text|>"],
)
for chunk in chat_completion:
print(chunk.choices[0].delta.content or "", end="")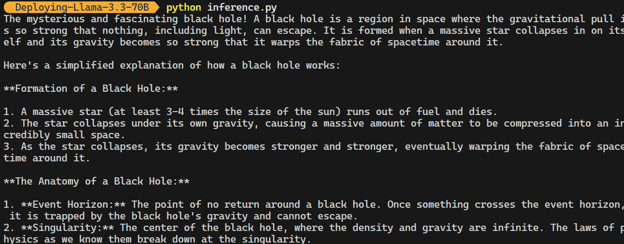
Vui lòng xem kho GitHub kingabzpro/Deploying-Llama-3.3-70B, nơi chứa tệp ứng dụng, cấu hình và mã suy luận.
Giám sát dịch vụ Llama 3.3
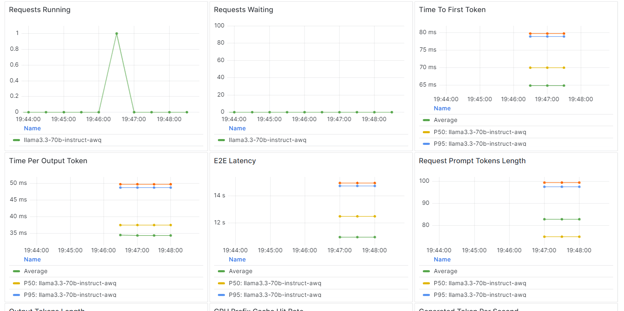
Trên BentCloud, bạn có thể theo dõi hiệu năng mô hình, độ trễ, mức sử dụng phần cứng, thông lượng mô hình và các chỉ số quan trọng khác mà không cần thiết lập công cụ logging hay giám sát.
Vào phần deployments và nhấp tab “Monitoring”.
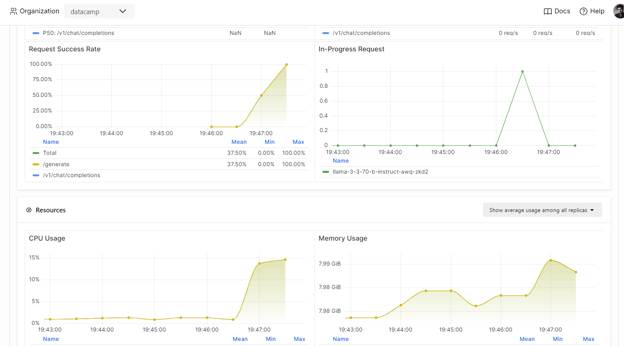
Cuộn xuống để xem các chỉ số về dịch vụ, tài nguyên và LLM trong các biểu đồ trực quan, dễ hiểu.
Kết luận
Việc xây dựng và triển khai một endpoint LLM đã trở nên vô cùng đơn giản với hệ sinh thái BentoML.
Chỉ với vài dòng mã để tạo API, thiết lập “bentofile” và triển khai mô hình, bạn có thể đưa mô hình vào hoạt động trong vài phút. Sau khi triển khai, endpoint có thể được truy cập qua lệnh CURL, thư viện Python requests, client của BentoML hoặc client của OpenAI.
Kết quả là một hệ thống hiệu quả cao, độ trễ thấp, thông lượng lớn, có khả năng xử lý đồng thời nhiều yêu cầu. BentoCloud cũng cung cấp auto-scaling dựa trên cấu hình của bạn, đảm bảo hệ thống có thể xử lý lưu lượng lớn bằng cách tự động tăng hoặc giảm quy mô khi cần.
Để có hướng dẫn chi tiết hơn về triển khai LLM với BentoML, tôi khuyến nghị theo dõi Cách triển khai LLMs với BentoML: Hướng dẫn từng bước.

Là một nhà khoa học dữ liệu được chứng nhận, tôi đam mê tận dụng công nghệ tiên tiến để tạo ra các ứng dụng học máy đổi mới. Với nền tảng vững chắc về nhận dạng giọng nói, phân tích và báo cáo dữ liệu, MLOps, AI hội thoại và NLP, tôi đã rèn giũa kỹ năng phát triển các hệ thống thông minh có thể tạo ra tác động thực sự. Bên cạnh chuyên môn kỹ thuật, tôi cũng là một người truyền đạt tốt, có khả năng chắt lọc các khái niệm phức tạp thành ngôn ngữ rõ ràng, súc tích. Nhờ đó, tôi trở thành một blogger được nhiều người quan tâm trong lĩnh vực khoa học dữ liệu, chia sẻ góc nhìn và kinh nghiệm với cộng đồng các chuyên gia dữ liệu ngày càng lớn. Hiện tại, tôi tập trung vào sáng tạo và biên tập nội dung, làm việc với các mô hình ngôn ngữ lớn để phát triển nội dung mạnh mẽ và hấp dẫn, giúp doanh nghiệp và cá nhân tận dụng tối đa dữ liệu của mình.


Việc triển khai mô hình ngôn ngữ lớn (LLM) ngày càng thách thức khi các mô hình này đòi hỏi máy GPU cao cấp với VRAM lớn. Kỹ sư cũng cần thành thạo các công cụ MLOps để phục vụ, triển khai, kiểm thử và giám sát mô hình. Bên cạnh đó, họ phải áp dụng kiểm soát truy cập và duy trì bảo mật để chống lại các mối đe dọa mạng và tấn công prompt injection. Cuộc sống của một kỹ sư LLMOps có thể rất khó khăn — nhưng đừng lo, chúng tôi sẽ hỗ trợ bạn!
Trong hướng dẫn này, chúng ta sẽ khám phá một giải pháp đơn giản và hiệu quả hơn để triển khai các LLM, chẳng hạn Llama 3.3 70B, trên đám mây. Chỉ với vài dòng mã Python và một số lệnh terminal, mô hình của bạn sẽ hoạt động. BentoCloud đơn giản hóa và quản lý mọi thứ, giúp quá trình triển khai trở nên trực quan và an toàn.
Nếu bạn là người mới bắt đầu, tôi khuyên bạn học khóa Introduction to LLMs in Python để nắm các kiến thức cơ bản về mô hình ngôn ngữ lớn.
Giới thiệu Llama 3.3
Meta Llama 3.3 mới là mô hình ngôn ngữ lớn (LLM) đa ngôn ngữ, chỉ văn bản (70B), được tinh chỉnh theo hướng dẫn, mang lại hiệu năng cải thiện so với Llama 3.1 (70B) và Llama 3.2 (90B). Trong một số trường hợp, nó thậm chí vượt trội hơn Llama 3.1 (405B) lớn hơn. Mô hình này chỉ văn bản và được tối ưu cho các trường hợp sử dụng hội thoại đa ngôn ngữ.
Llama 3.3 là mô hình ngôn ngữ tự hồi quy xây dựng trên kiến trúc transformer được tối ưu hóa. Nó được tinh chỉnh bằng Supervised Fine-Tuning (SFT) và học tăng cường với phản hồi của con người (RLHF) để phù hợp hơn với sở thích của con người về tính hữu ích và an toàn.
Tìm hiểu thêm về Llama 3.3 qua bài viết Meta's Llama 3.3 70B là gì? Cách hoạt động, Trường hợp sử dụng & hơn thế nữa.