
Cursus
MLOps-concepten
2 uur
45.8K
Het deployen van large language models (LLM’s) wordt steeds uitdagender, omdat deze modellen high-end GPU-machines met veel VRAM vereisen. Engineers moeten daarnaast MLOps-tools beheersen om taken als serven, deployen, testen en monitoren aan te kunnen. Daarbovenop moeten ze toegangsbeperkingen implementeren en de beveiliging op orde houden om te beschermen tegen cyberdreigingen en prompt-injectionaanvallen. Het leven van een LLMOps-engineer kan pittig zijn—maar geen zorgen, we helpen je op weg!
In deze tutorial verkennen we een eenvoudigere en efficiëntere oplossing om LLM’s, zoals Llama 3.3 70B, in de cloud te deployen. Met slechts een paar regels Python-code en wat terminalcommando’s heb je je model draaiend. BentoCloud stroomlijnt en beheert alles, waardoor het deployproces rechttoe rechtaan en veilig is.
Als je beginner bent, raad ik je aan om de cursus Introduction to LLMs in Python te volgen om de basis van large language models te begrijpen.
De nieuwe Meta Llama 3.3 is een tekst-only (70B) instruction-tuned, meertalig large language model (LLM) met betere prestaties dan Llama 3.1 (70B) en Llama 3.2 (90B). In sommige gevallen presteert het zelfs beter dan de grotere Llama 3.1 (405B). Dit model is tekst-only en geoptimaliseerd voor meertalige dialoogtoepassingen.
Llama 3.3 is een autoregressief taalmodel, gebouwd op een geoptimaliseerde transformerarchitectuur. Het is getuned met supervised fine-tuning (SFT) en reinforcement learning met menselijke feedback (RLHF) om beter aan te sluiten bij menselijke voorkeuren voor behulpzaamheid en veiligheid.
Lees meer over Llama 3.3 in de blogpost What Is Meta's Llama 3.3 70B? How It Works, Use Cases & More.
In dit project gebruiken we BentoML om de AI-service te bouwen, vLLM voor high-throughput model serving en BentoCloud voor robuuste infrastructuur en deployment. Daarnaast deployen we de AWQ-versie van het model om de prestaties te optimaliseren.
Kortom: vLLM gecombineerd met AWQ is een ijzersterke combinatie om LLM-applicaties te bouwen die supersnel zijn en meerdere verzoeken tegelijk aankunnen.
AWQ (Activation-aware Weight Quantization) is een innovatieve quantizationtechniek die bedoeld is om de deployment van large language models te verbeteren. Het vermindert het geheugengebruik en verhoogt de inference-snelheid aanzienlijk, terwijl de hoge nauwkeurigheid behouden blijft.
Lees het onderzoeksartikel om meer te leren over AWQ-technologie en hoe het modelinference optimaliseert met behoud van nauwkeurigheid.
vLLM (Virtual Large Language Model) is een open-sourcelibrary die specifiek is ontworpen om de inference en het serven van large language models te optimaliseren. Het pakt cruciale uitdagingen aan, zoals throughput en geheugenefficiëntie, met geavanceerde technieken als PagedAttention, dat zorgt voor efficiënt beheer van attention key-value-geheugen.
Leer meer over het vLLM Python-pakket in de tutorial vLLM: Setting Up vLLM Locally and on Google Cloud for CPU.
BentoML is een open-source framework voor het serven van machinelearningmodellen en vormt de ruggengraat van de LLM-deploymentpipeline. Het vereenvoudigt het verpakken, deployen en beheren van ML-modellen, inclusief LLM’s, in productie.
Volg de tutorial How to Deploy LLMs with BentoML om het BentoML-ecosysteem te leren kennen en kleinere LLM-modellen te deployen.
BentoCloud is een serverless platform bovenop BentoML, ontworpen om de deployment en het beheer van ML-modellen te stroomlijnen. Het biedt een robuuste infrastructuur die is geoptimaliseerd voor AI-inference, en is daarmee zeer geschikt voor het serven van LLM’s.
Met BentoCloud kun je schaalbare en efficiënte AI-oplossingen in cloudomgevingen deployen zonder je zorgen te maken over infrastructuurbeheer.
Laten we doorgaan met het project. We maken de volgende componenten:
app.py-bestand om de model serving-API te definiëren met vLLM en FastAPI.requirements.txt-bestand met de vereiste Python-pakketten voor installatie in de cloudomgeving.bentofile.yaml-bestand om de infrastructuur te configureren, Docker-images te bouwen en de deploymentomgeving in te richten.We beginnen met het installeren van het BentoML Python-pakket met het pip-commando:
pip install bentomlIn het Python-applicatiebestand richten we het modelendpoint als volgt in:
bentoml, fastapi en vllm.Voeg de onderstaande code toe aan je app.py:
# Standard library imports
import uuid
from argparse import Namespace
from typing import AsyncGenerator, Optional

# Third-party imports
import bentoml
import fastapi
from annotated_types import Ge, Le
from typing_extensions import Annotated

# Initialize FastAPI application
openai_api_app = fastapi.FastAPI()

# Constants
MAX_MODEL_LEN = 8192
MAX_TOKENS = 1024

SYSTEM_PROMPT = """You are a helpful and respectful assistant. Provide safe, unbiased, and accurate answers.
                If a question is unclear or you don't know the answer, explain why instead of guessing."""

MODEL_ID = "casperhansen/llama-3.3-70b-instruct-awq"

# Define OpenAI-compatible API endpoints
OPENAI_ENDPOINTS = [
    ["/chat/completions", "create_chat_completion", ["POST"]],
    ["/completions", "create_completion", ["POST"]],
    ["/models", "show_available_models", ["GET"]],
]


@bentoml.mount_asgi_app(openai_api_app, path="/v1")
@bentoml.service(
    name="llama3.3-70b-instruct-awq",
    traffic={
        "timeout": 1200,
        "concurrency": 256,
    },
    resources={
        "gpu": 1,
        "gpu_type": "nvidia-a100-80gb",
    },
)


class BentoVLLM:
    def __init__(self) -> None:
        """Initialize the BentoVLLM service with VLLM engine and tokenizer."""
        import vllm.entrypoints.openai.api_server as vllm_api_server
        from transformers import AutoTokenizer
        from vllm import AsyncEngineArgs, AsyncLLMEngine

        # Configure VLLM engine arguments
        ENGINE_ARGS = AsyncEngineArgs(
            model=MODEL_ID,
            max_model_len=MAX_MODEL_LEN,
            enable_prefix_caching=True,
        )

        # Initialize engine and tokenizer
        self.engine = AsyncLLMEngine.from_engine_args(ENGINE_ARGS)
        self.tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)

        # Register API endpoints
        for route, endpoint_name, methods in OPENAI_ENDPOINTS:
            endpoint_func = getattr(vllm_api_server, endpoint_name)
            openai_api_app.add_api_route(
                path=route,
                endpoint=endpoint_func,
                methods=methods,
            )

        # Configure model arguments
        model_config = self.engine.engine.get_model_config()
        args = Namespace(
            model=MODEL_ID,
            disable_log_requests=True,
            max_log_len=1000,
            response_role="assistant",
            served_model_name=None,
            chat_template=None,
            lora_modules=None,
            prompt_adapters=None,
            request_logger=None,
            disable_log_stats=True,
            return_tokens_as_token_ids=False,
            enable_tool_call_parser=True,
            enable_auto_tool_choice=True,
            tool_call_parser="llama3_json",
            enable_prompt_tokens_details=False,
        )

        # Initialize application state
        vllm_api_server.init_app_state(
            self.engine, model_config, openai_api_app.state, args
        )

    @bentoml.api
    async def generate(
        self,
        prompt: str = "Describe the process of photosynthesis in simple terms",
        system_prompt: Optional[str] = SYSTEM_PROMPT,
        max_tokens: Annotated[int, Ge(128), Le(MAX_TOKENS)] = MAX_TOKENS,
    ) -> AsyncGenerator[str, None]:
        """
        Generate text based on the input prompt using the VLLM engine.

        Args:
            prompt: The user's input prompt
            system_prompt: Optional system prompt to guide the model's behavior
            max_tokens: Maximum number of tokens to generate

        Returns:
            AsyncGenerator yielding generated text chunks
        """
        from vllm import SamplingParams

        # Configure sampling parameters
        SAMPLING_PARAM = SamplingParams(
            max_tokens=max_tokens,
            skip_special_tokens=True,
        )

        # Use default system prompt if none provided
        if system_prompt is None:
            system_prompt = SYSTEM_PROMPT

        # Prepare messages for chat
        messages = [
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": prompt},
        ]

        # Apply chat template
        prompt = self.tokenizer.apply_chat_template(
            messages,
            tokenize=False,
            add_generation_prompt=True,
        )

        # Generate response stream
        stream = await self.engine.add_request(uuid.uuid4().hex, prompt, SAMPLING_PARAM)

        # Stream the generated text
        cursor = 0
        async for request_output in stream:
            text = request_output.outputs[0].text
            yield text[cursor:]
            cursor = len(text)
Maak een requirements.txt-bestand en neem alle benodigde Python-pakketten op om de AI-applicatie te bouwen. Specificeer de exacte versies van elk pakket om de stabiliteit en reproduceerbaarheid van het project te waarborgen.
Zo zou de requirements.txt eruit moeten zien:
accelerate==1.2.0
autoawq==0.2.7.post3
bentoml>=1.3.15
fastapi==0.115.6
openai==1.57.0
vllm==0.6.4.post1; sys_platform == "linux"
Het bentofile.yaml-bestand is het configuratiebestand waarmee je de BentoML-service definieert en bouwt. Het bevat de volgende onderdelen:
app.py) en de serviceclassnaam (BentoVLLM).requirements.txt-bestand.Voeg de volgende inhoud toe aan je bentofile.yaml-bestand:
service: 'app:BentoVLLM'
labels:
  owner: Abid
  team: DataCamp
  stage: dev
include:
  - '*.py'
python:
  requirements_txt: './requirements.txt'
  lock_packages: false
docker:
python_version: "3.11"Nu komt het magische deel: BentoCloud regelt alles voor ons, en wij hoeven slechts één commando te typen. Maar eerst moeten we inloggen op BentoCloud met het volgende terminalcommando.
bentoml cloud login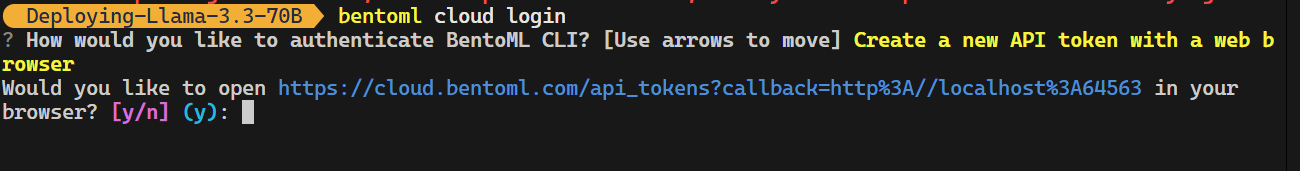
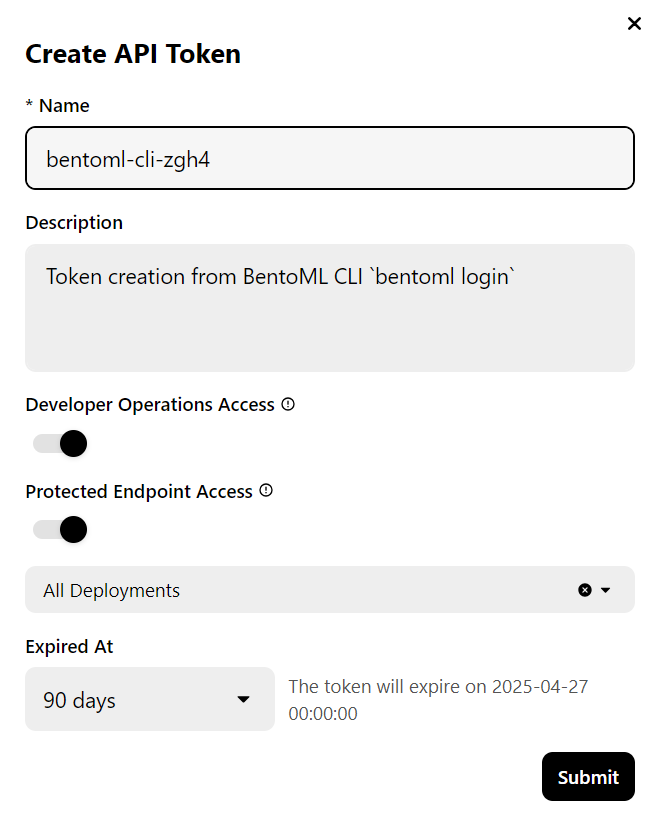
De CLI-tool stelt je een paar vragen en leidt je dan door naar de BentoCloud-website om een account aan te maken en een API-sleutel te genereren.
Zodra dat klaar is, wordt de API-sleutel automatisch toegepast in je CLI-tools.
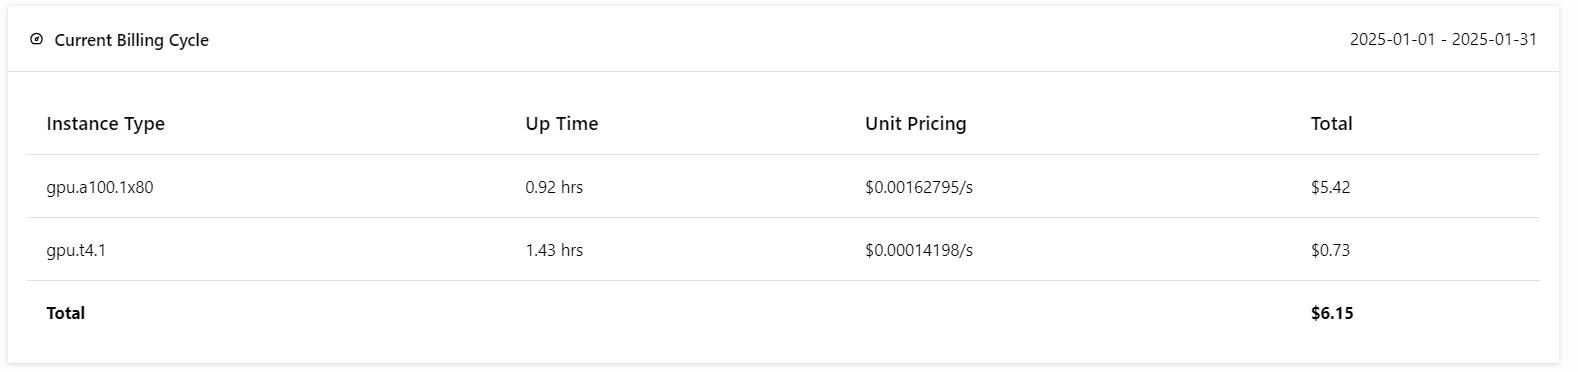
Let op: het deployen van de volledige 70B-versie vereist 80GB GPU-geheugen. Hoewel BentoCloud 10 USD aan gratis credits biedt, moet je je abonneren op het pro-plan om toegang te krijgen tot A100 GPU’s met 80GB VRAM.
Om je te abonneren ga je naar het tabblad “Billing” via je profielfoto rechtsboven en voeg je je creditcardgegevens toe.
Geen zorgen: als je zorgvuldig met deployments omgaat, kost het je niet meer dan $6 USD. Zorg er wel voor dat je de deployment beëindigt wanneer je klaar bent met experimenteren!
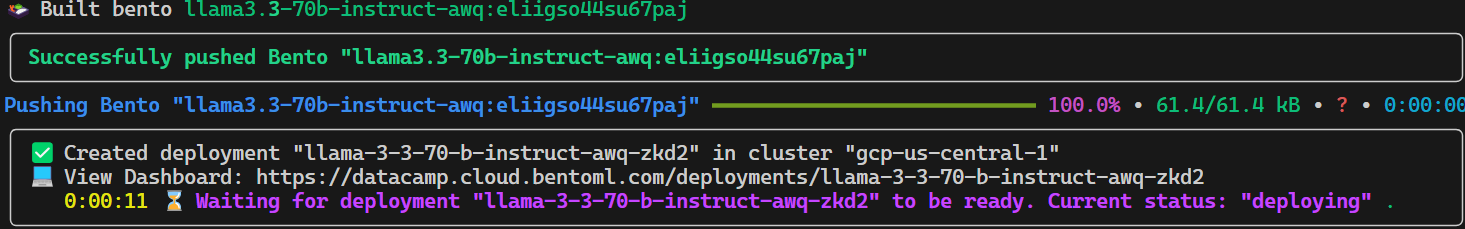
Dan het mooiste deel: we deployen de BentoML-applicatie naar de cloud met het volgende commando en schakelen toegangsautorisatie in. Dit betekent dat alleen gebruikers met de BentoML API-sleutel toegang hebben tot deze API-server.
bentoml deploy . --access-authorization trueHet duurt enkele seconden om alle bestanden, configuraties en andere vereiste componenten te versturen, waarna BentoCloud de rest beheert.
Om je huidige draaiende deployments te bekijken, ga je naar je BentoCloud-dashboard en klik je op het tabblad “Deployments”. In de onderstaande afbeelding zie je bijvoorbeeld de applicatie in het proces “Image Building”:
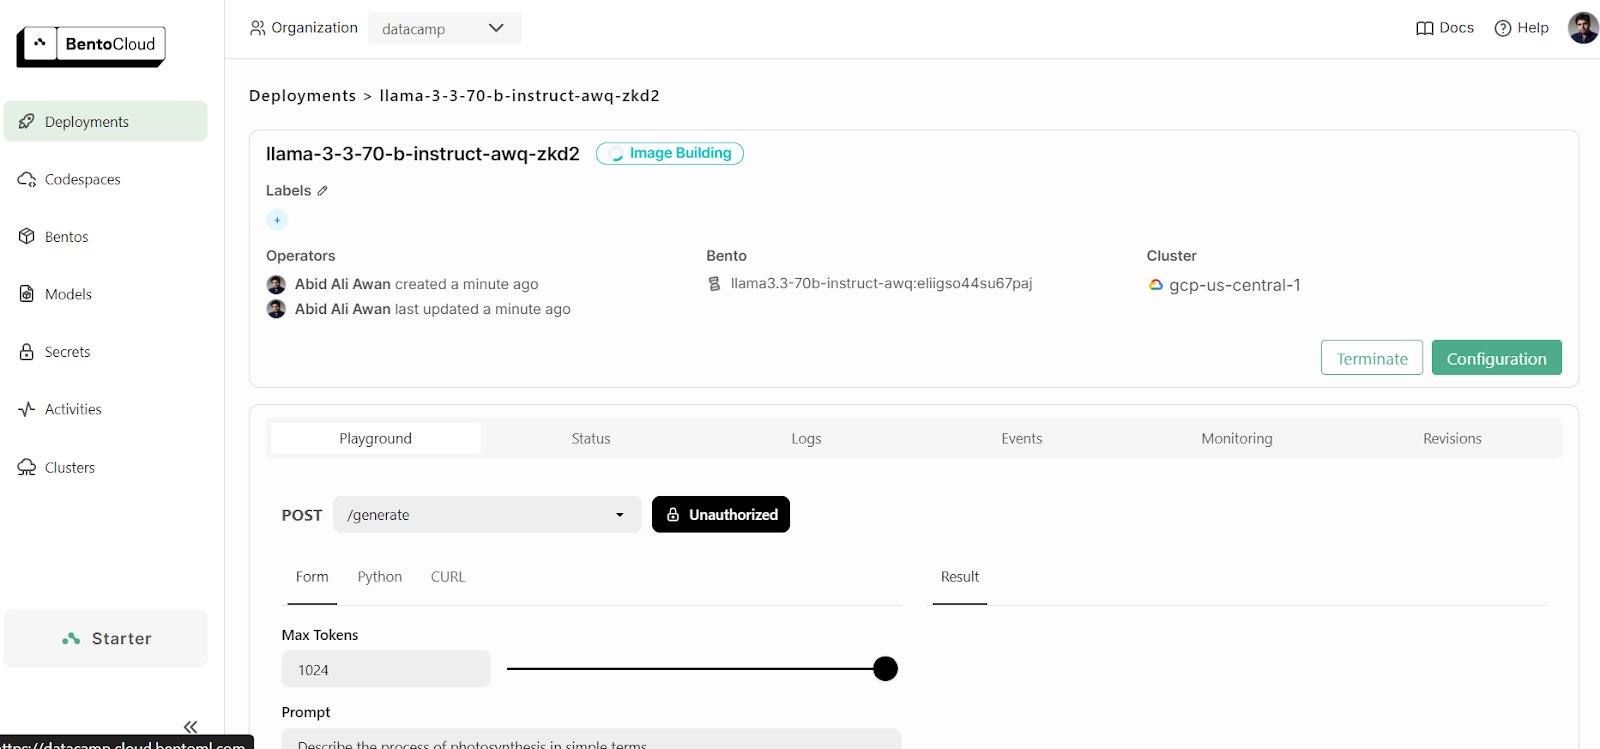
Na nog een paar minuten om de image te bouwen, de infrastructuur in te richten en het model te deployen, is onze applicatie klaar voor gebruik!
BentoCloud biedt een Playground-UI om je model te testen op het dashboard, vergelijkbaar met het OpenAI-platform. Omdat onze service is afgeschermd, moeten we een API-sleutel opgeven om in de Playground toegang te krijgen tot het model, zoals hieronder weergegeven:
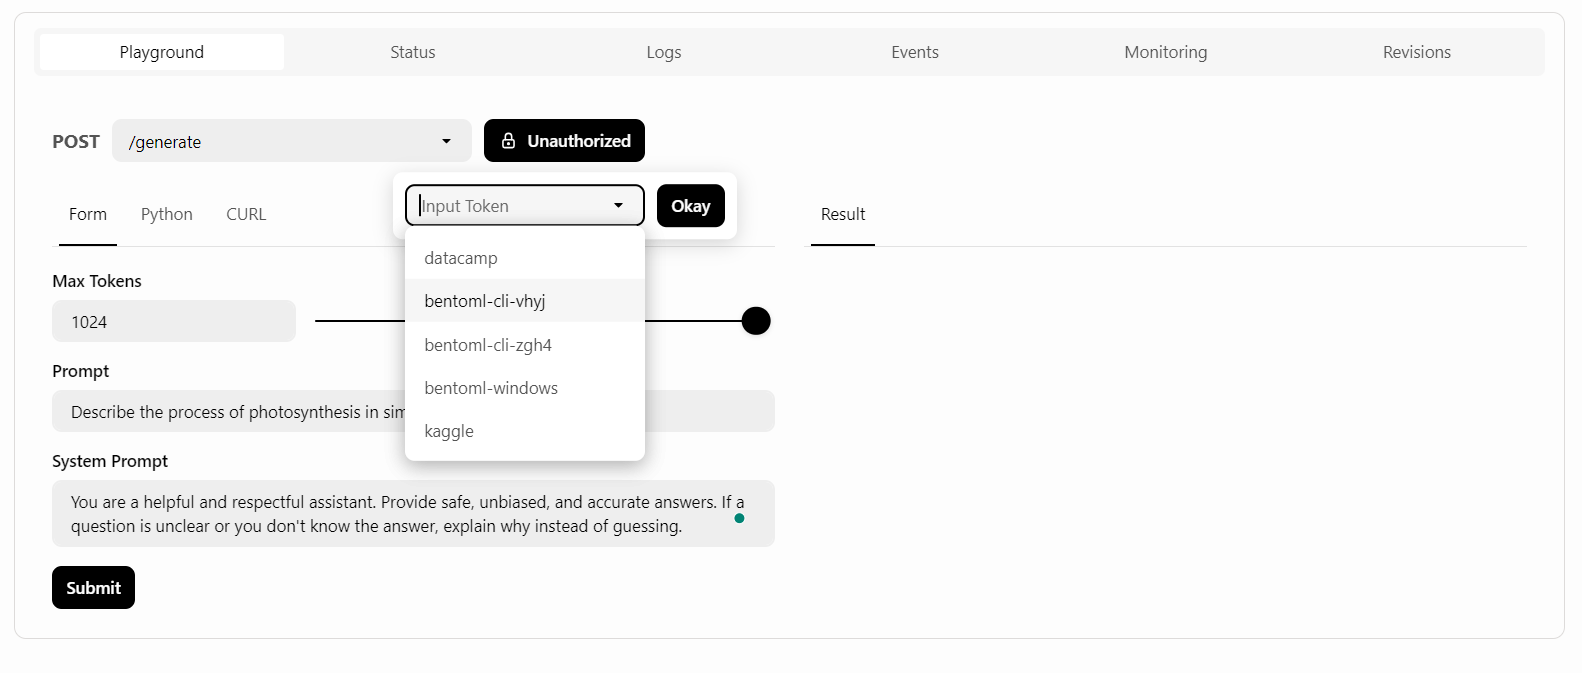
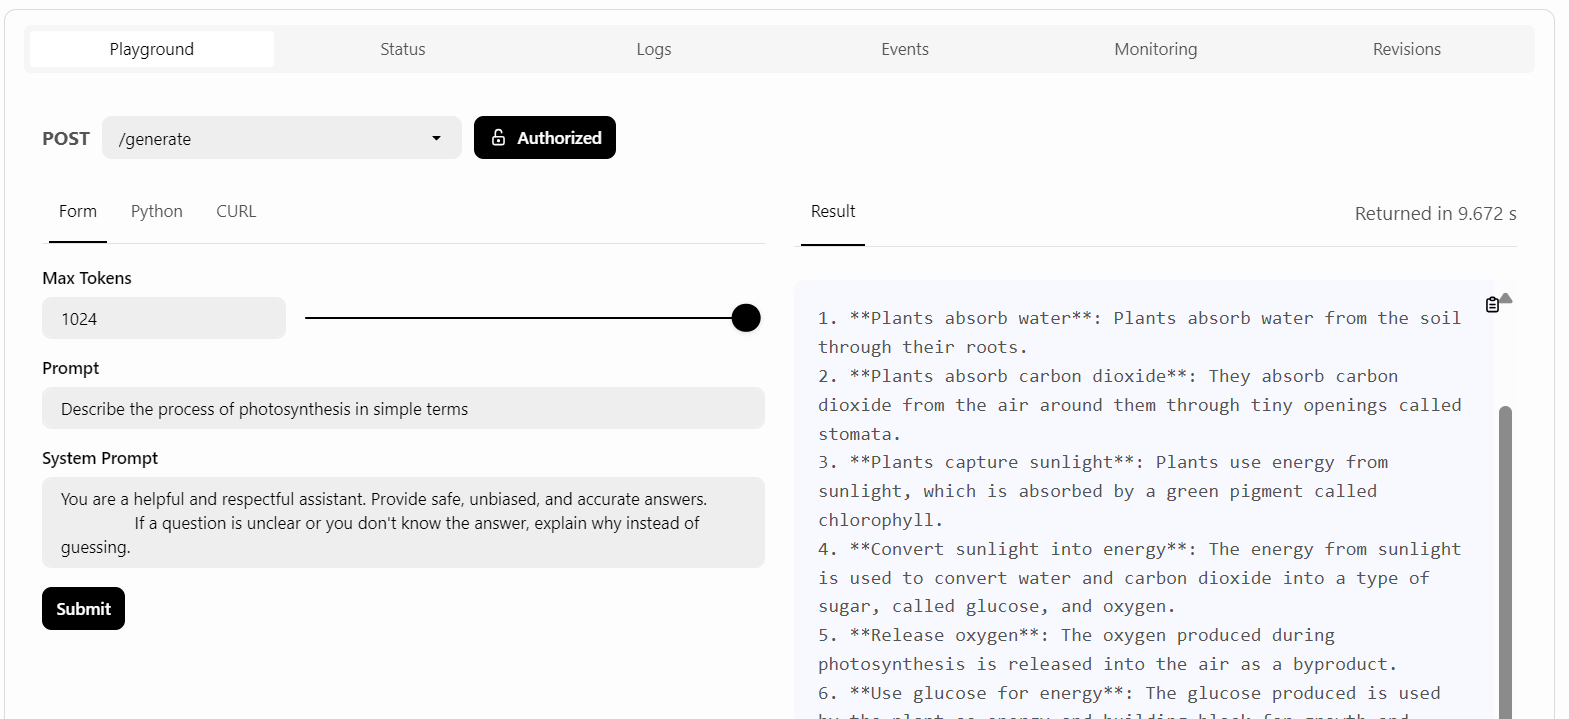
Daarna schrijven we de prompt en klikken we op de knop “Submit”.
De respons werd snel en nauwkeurig gegenereerd:
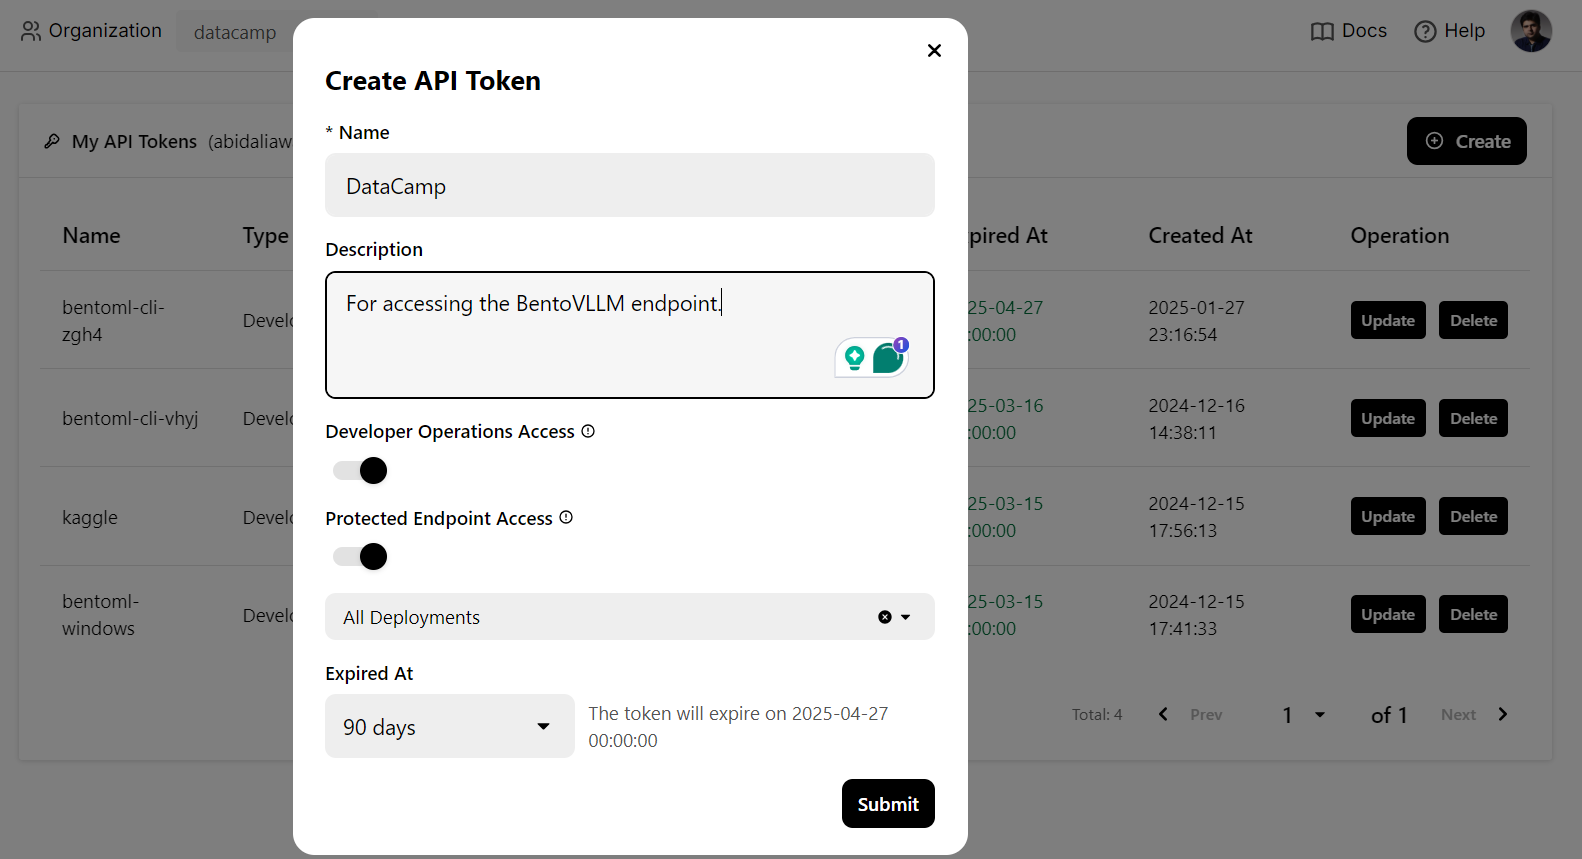
We gebruiken een CURL-commando in de terminal om lokaal toegang te krijgen tot de LLM-service. Maar eerst moeten we een nieuwe API-sleutel genereren om deze service op elk systeem te gebruiken:
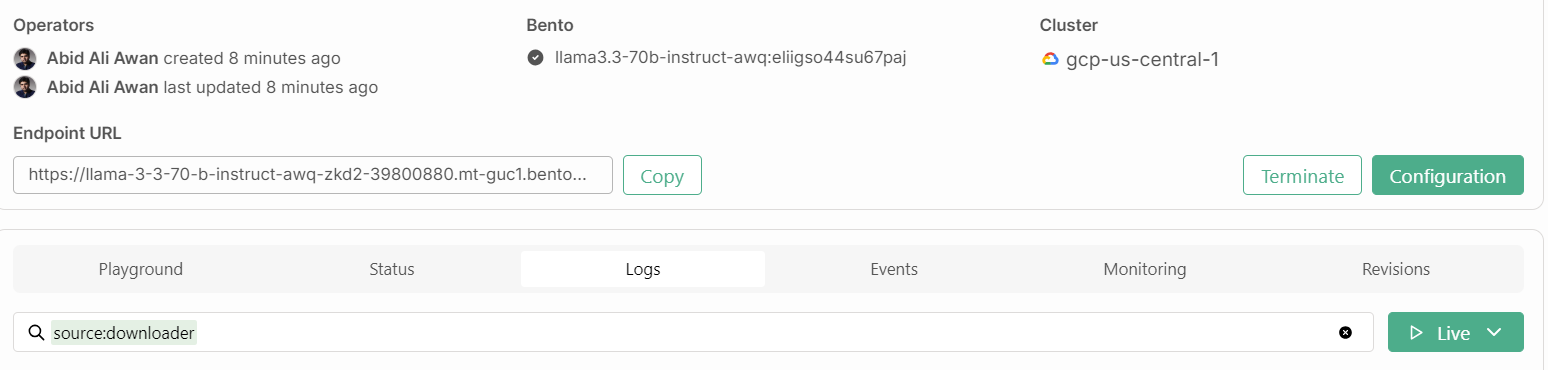
Daarnaast hebben we de endpoint-URL nodig, die we kunnen kopiëren van het tabblad “Deployments”:
Zodra je de API-sleutel en endpoint-URL hebt, kun je met het volgende CURL-commando een respons genereren.
Het commando bevat de endpoint-URL, API-sleutel, het argument max_tokens en de prompt:
curl -s -X POST \
    'https://llama-3-3-70-b-instruct-awq-zkd2-39800880.mt-guc1.bentoml.ai/generate' \
    -H "Authorization: Bearer $(echo $BENTO_CLOUD_API_KEY)" \
    -H 'Content-Type: application/json' \
    -d '{
        "max_tokens": 1024,
        "prompt": "Describe the process of photosynthesis in simple terms"
    }'
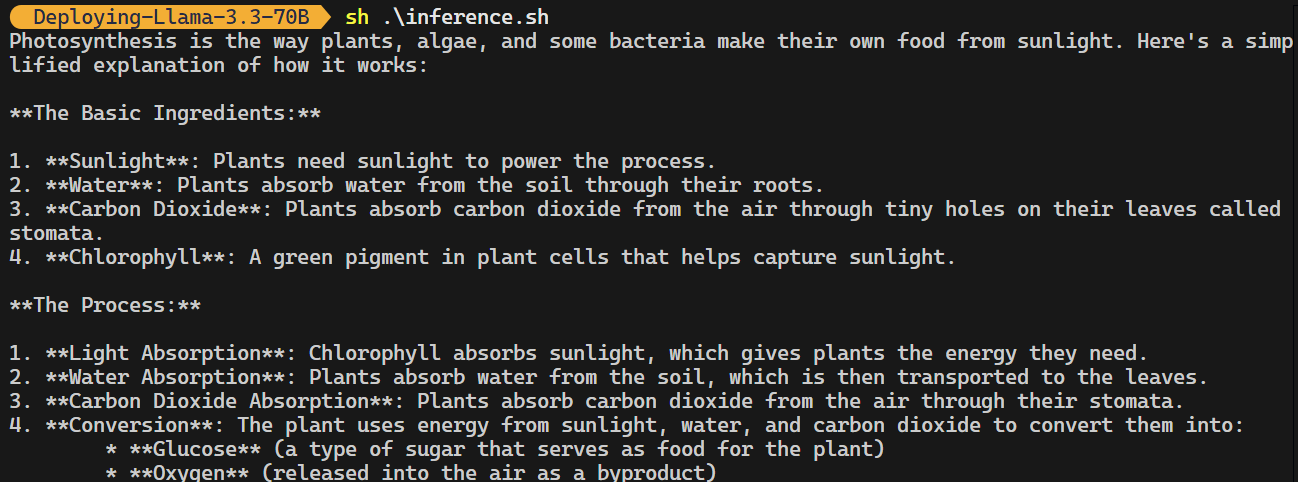
De respons is accuraat, en het kostte een paar seconden om die te genereren.
De BentoML-endpoint is compatibel met de OpenAI Python-client. Je hoeft je code nauwelijks aan te passen om dit open-sourcemodel in je applicatie te integreren.
Je hoeft alleen de base-URL te wijzigen, de API-sleutel op te geven en de modelnaam te specificeren:
import os

from openai import OpenAI

BENTOML_API_KEY = os.getenv("BENTO_CLOUD_API_KEY")  #
if BENTOML_API_KEY is None:
    raise ValueError("BENTOML_API_KEY environment variable is not set.")


client = OpenAI(
    base_url="https://llama-3-3-70-b-instruct-awq-zkd2-39800880.mt-guc1.bentoml.ai/v1",
    api_key=BENTOML_API_KEY,
)

chat_completion = client.chat.completions.create(
    model="casperhansen/llama-3.3-70b-instruct-awq",
    messages=[
        {"role": "user", "content": "What is a black hole and how does it work?"}
    ],
    stream=True,
    stop=["<|eot_id|>", "<|end_of_text|>"],
)
for chunk in chat_completion:
    print(chunk.choices[0].delta.content or "", end="")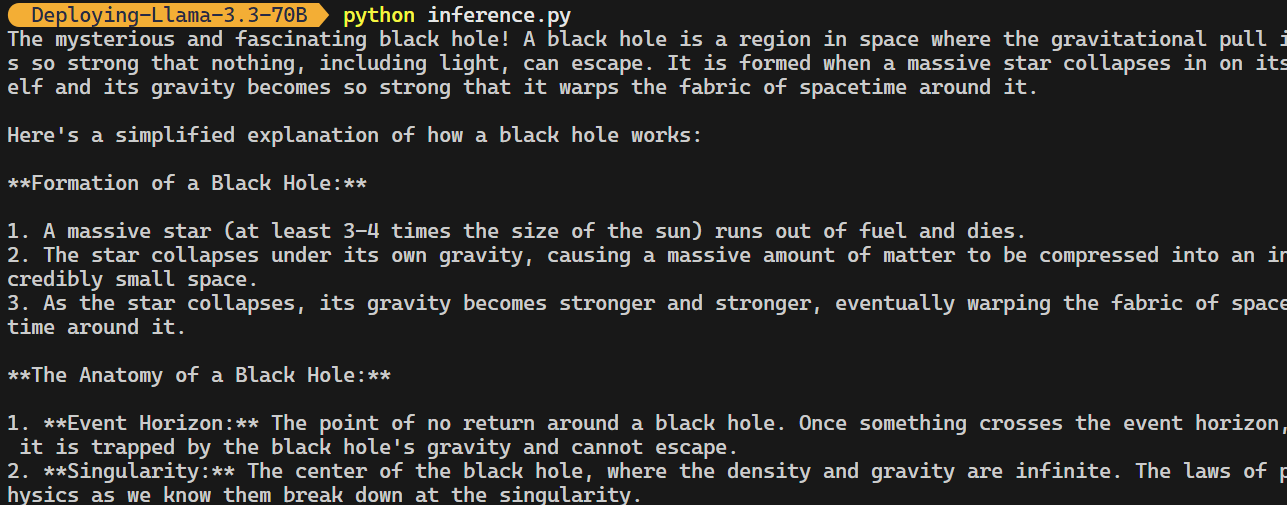
Bekijk zeker de GitHub-repository kingabzpro/Deploying-Llama-3.3-70B, met het applicatiebestand, configuraties en inference-code.
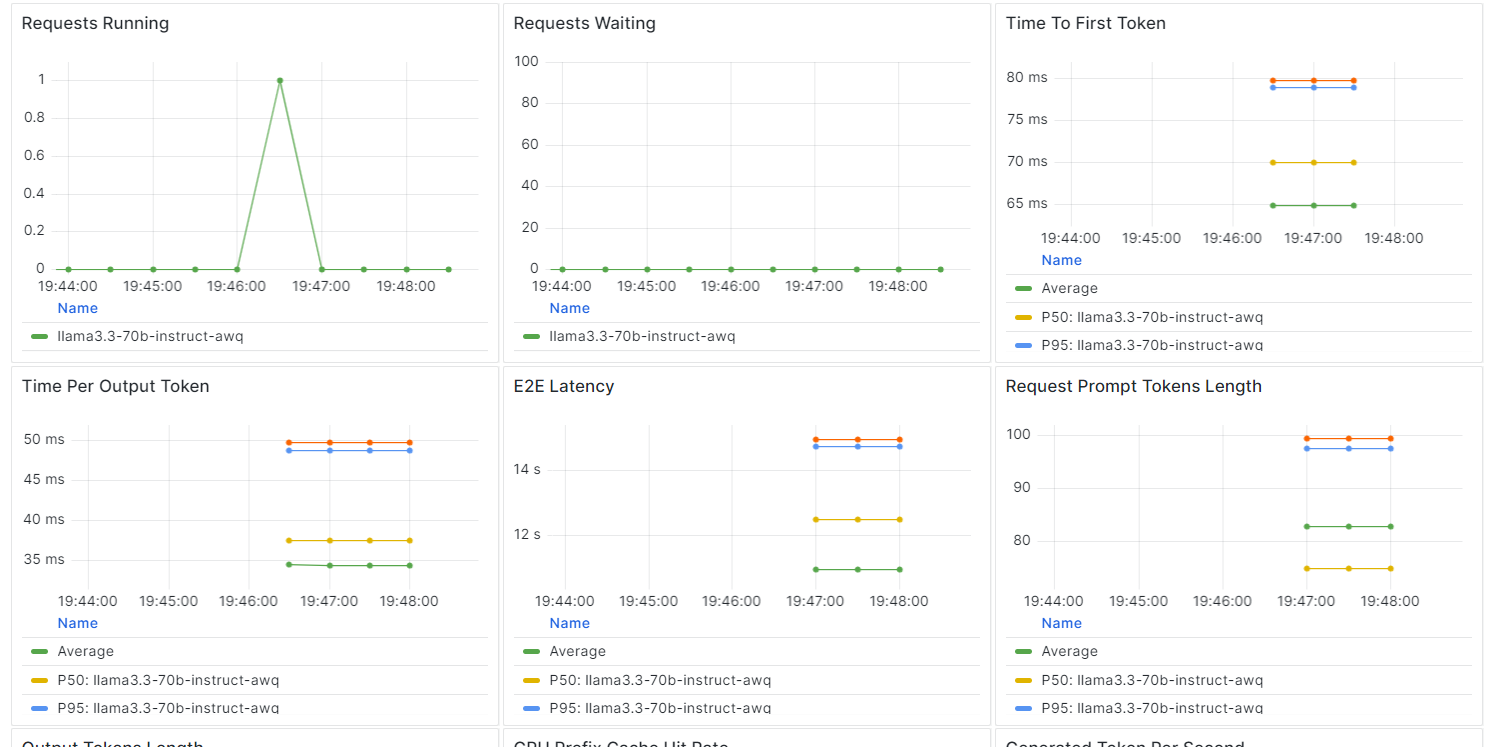
Op BentCloud kun je de modelprestaties, latentie, hardwaregebruik, model-throughput en andere kritieke metrics monitoren zonder logging- of monitoringtools in te richten.
Ga naar je deployments en klik op het tabblad “Monitoring”.
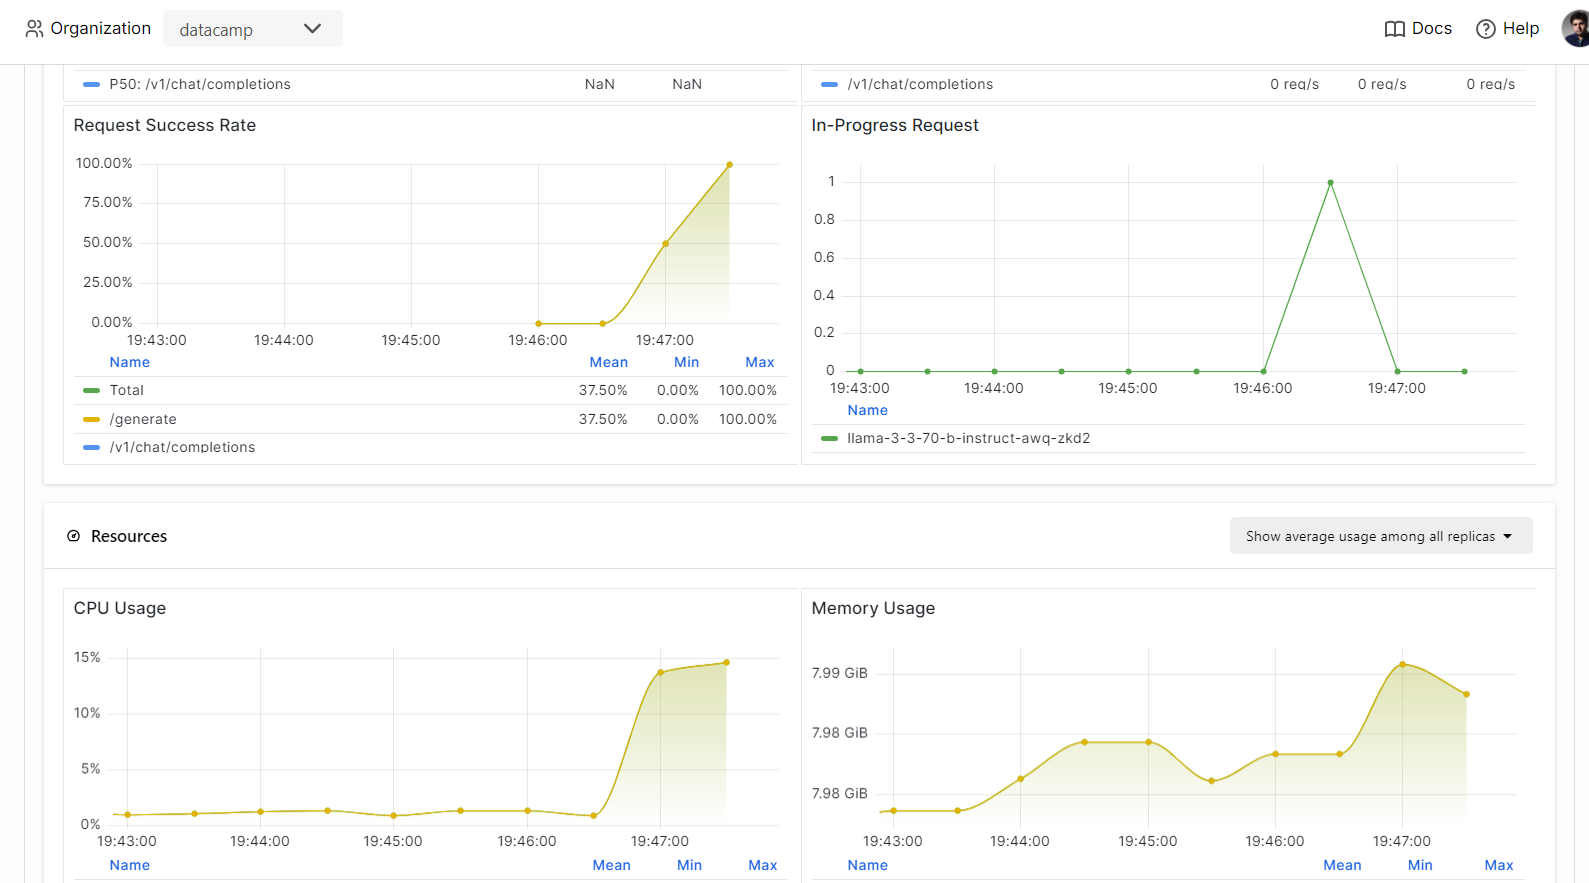
Scroll naar beneden om service-, resource- en LLM-gerelateerde metrics te zien in overzichtelijke, intuïtieve grafieken.
Het bouwen en deployen van een LLM-endpoint is opmerkelijk eenvoudig geworden met het BentoML-ecosysteem.
Met slechts een paar regels code om je API te maken, een “bentofile” in te richten en het model te deployen, heb je je model binnen enkele minuten draaiend. Eenmaal gedeployed, is het endpoint toegankelijk via CURL-commando’s, de Python-requests-bibliotheek, de BentoML-client of de OpenAI-client.
Het resultaat is een zeer efficiënt systeem met lage latentie en hoge throughput, dat meerdere verzoeken tegelijkertijd aankan. BentoCloud biedt bovendien autoscaling op basis van jouw configuratie, zodat het systeem hoge verkeersvolumes aankan door op of af te schalen waar nodig.
Voor een meer diepgaande gids over het deployen van LLM’s met BentoML raad ik de tutorial How to Deploy LLMs with BentoML: A Step-by-Step Guide aan.
Leer meer over AI en LLM’s met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

