
Kursus
Konsep MLOps
2 jam
45.8K
Mendeploy large language models (LLM) menjadi semakin menantang karena model-model ini memerlukan mesin GPU kelas atas dengan VRAM besar. Engineer juga harus menguasai alat MLOps untuk menangani tugas seperti serving, deployment, pengujian, dan pemantauan model. Selain itu, mereka perlu menerapkan pembatasan akses dan menjaga keamanan untuk melindungi dari ancaman siber dan serangan prompt injection. Hidup sebagai engineer LLMOps bisa berat—namun tenang saja; kami siap membantu!
Dalam tutorial ini, kita akan membahas solusi yang lebih sederhana dan efisien untuk mendeploy LLM seperti Llama 3.3 70B di cloud. Hanya dengan beberapa baris kode Python dan beberapa perintah terminal, model Anda akan berjalan. BentoCloud menyederhanakan dan mengelola semuanya, sehingga proses deployment menjadi mudah dan aman.
Jika Anda pemula, saya sarankan mengikuti kursus Introduction to LLMs in Python untuk memahami dasar-dasar large language model.
Meta Llama 3.3 yang baru adalah large language model (LLM) multibahasa berjenis text-only (70B) yang diinstruksi dan menawarkan kinerja lebih baik dibanding Llama 3.1 (70B) dan Llama 3.2 (90B). Dalam beberapa kasus, model ini bahkan melampaui Llama 3.1 (405B) yang lebih besar. Model ini hanya memproses teks dan dioptimalkan untuk skenario dialog multibahasa.
Llama 3.3 adalah model bahasa autoregresif yang dibangun di atas arsitektur transformer yang dioptimalkan. Model ini disetel menggunakan supervised fine-tuning (SFT) dan reinforcement learning dari umpan balik manusia (RLHF) untuk lebih selaras dengan preferensi manusia terkait kebermanfaatan dan keamanan.
Pelajari lebih lanjut tentang Llama 3.3 dengan membaca artikel blog Apa Itu Llama 3.3 70B dari Meta? Cara Kerja, Use Case, dan Lainnya.
Dalam proyek ini, kita akan menggunakan BentoML untuk membangun layanan AI, vLLM untuk serving model ber-throughput tinggi, dan BentoCloud untuk infrastruktur yang andal dan deployment. Selain itu, kita akan mendeploy versi AWQ dari model untuk mengoptimalkan performa.
Singkatnya, vLLM yang dipadukan dengan AWQ menjadi kombinasi ampuh untuk membangun aplikasi LLM yang sangat cepat dan mampu menangani banyak permintaan sekaligus.
AWQ (Activation-aware Weight Quantization) adalah teknik kuantisasi inovatif yang dirancang untuk meningkatkan deployment large language model. Teknik ini secara signifikan mengurangi penggunaan memori dan meningkatkan kecepatan inferensi, sekaligus mempertahankan akurasi tinggi.
Baca paper risetnya untuk mempelajari teknologi AWQ dan bagaimana ia mengoptimalkan inferensi model sambil menjaga akurasi.
vLLM (Virtual Large Language Model) adalah pustaka open-source yang dirancang khusus untuk mengoptimalkan inferensi dan serving large language model. vLLM mengatasi tantangan krusial seperti throughput dan efisiensi memori dengan memperkenalkan teknik canggih seperti PagedAttention, yang memastikan manajemen memori key-value attention yang efisien.
Pelajari lebih lanjut paket Python vLLM melalui tutorial vLLM: Menyiapkan vLLM Secara Lokal dan di Google Cloud untuk CPU.
BentoML adalah kerangka kerja open-source untuk serving model machine learning yang menjadi tulang punggung pipeline deployment LLM. BentoML menyederhanakan proses pengemasan, deployment, dan pengelolaan model machine learning, termasuk LLM, di lingkungan produksi.
Ikuti tutorial Cara Mendeploy LLM dengan BentoML untuk mempelajari ekosistem BentoML dan cara mendeploy model LLM yang lebih kecil.
BentoCloud adalah platform serverless yang dibangun di atas BentoML dan dirancang untuk menyederhanakan deployment dan pengelolaan model machine learning. Platform ini menawarkan infrastruktur tangguh yang dioptimalkan untuk inferensi AI, sehingga sangat cocok untuk serving LLM.
Dengan BentoCloud, pengguna dapat mendeploy solusi AI yang skalabel dan efisien di lingkungan cloud tanpa perlu khawatir mengelola infrastruktur.
Sekarang mari lanjutkan proyeknya. Kita akan membuat komponen berikut:
app.py untuk mendefinisikan API serving model dengan vLLM dan FastAPI.requirements.txt untuk menentukan paket Python yang diperlukan untuk diinstal di lingkungan cloud.bentofile.yaml untuk mengonfigurasi infrastruktur, membangun image Docker, dan menyiapkan lingkungan deployment.Kita akan mulai dengan memasang paket Python BentoML menggunakan perintah pip:
pip install bentomlDi file aplikasi Python, kita akan menyiapkan endpoint model dengan melakukan hal berikut:
bentoml, fastapi, dan vllm.Tambahkan kode di bawah ini ke app.py Anda:
# Standard library imports
import uuid
from argparse import Namespace
from typing import AsyncGenerator, Optional

# Third-party imports
import bentoml
import fastapi
from annotated_types import Ge, Le
from typing_extensions import Annotated

# Initialize FastAPI application
openai_api_app = fastapi.FastAPI()

# Constants
MAX_MODEL_LEN = 8192
MAX_TOKENS = 1024

SYSTEM_PROMPT = """You are a helpful and respectful assistant. Provide safe, unbiased, and accurate answers.
                If a question is unclear or you don't know the answer, explain why instead of guessing."""

MODEL_ID = "casperhansen/llama-3.3-70b-instruct-awq"

# Define OpenAI-compatible API endpoints
OPENAI_ENDPOINTS = [
    ["/chat/completions", "create_chat_completion", ["POST"]],
    ["/completions", "create_completion", ["POST"]],
    ["/models", "show_available_models", ["GET"]],
]


@bentoml.mount_asgi_app(openai_api_app, path="/v1")
@bentoml.service(
    name="llama3.3-70b-instruct-awq",
    traffic={
        "timeout": 1200,
        "concurrency": 256,
    },
    resources={
        "gpu": 1,
        "gpu_type": "nvidia-a100-80gb",
    },
)


class BentoVLLM:
    def __init__(self) -> None:
        """Initialize the BentoVLLM service with VLLM engine and tokenizer."""
        import vllm.entrypoints.openai.api_server as vllm_api_server
        from transformers import AutoTokenizer
        from vllm import AsyncEngineArgs, AsyncLLMEngine

        # Configure VLLM engine arguments
        ENGINE_ARGS = AsyncEngineArgs(
            model=MODEL_ID,
            max_model_len=MAX_MODEL_LEN,
            enable_prefix_caching=True,
        )

        # Initialize engine and tokenizer
        self.engine = AsyncLLMEngine.from_engine_args(ENGINE_ARGS)
        self.tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)

        # Register API endpoints
        for route, endpoint_name, methods in OPENAI_ENDPOINTS:
            endpoint_func = getattr(vllm_api_server, endpoint_name)
            openai_api_app.add_api_route(
                path=route,
                endpoint=endpoint_func,
                methods=methods,
            )

        # Configure model arguments
        model_config = self.engine.engine.get_model_config()
        args = Namespace(
            model=MODEL_ID,
            disable_log_requests=True,
            max_log_len=1000,
            response_role="assistant",
            served_model_name=None,
            chat_template=None,
            lora_modules=None,
            prompt_adapters=None,
            request_logger=None,
            disable_log_stats=True,
            return_tokens_as_token_ids=False,
            enable_tool_call_parser=True,
            enable_auto_tool_choice=True,
            tool_call_parser="llama3_json",
            enable_prompt_tokens_details=False,
        )

        # Initialize application state
        vllm_api_server.init_app_state(
            self.engine, model_config, openai_api_app.state, args
        )

    @bentoml.api
    async def generate(
        self,
        prompt: str = "Describe the process of photosynthesis in simple terms",
        system_prompt: Optional[str] = SYSTEM_PROMPT,
        max_tokens: Annotated[int, Ge(128), Le(MAX_TOKENS)] = MAX_TOKENS,
    ) -> AsyncGenerator[str, None]:
        """
        Generate text based on the input prompt using the VLLM engine.

        Args:
            prompt: The user's input prompt
            system_prompt: Optional system prompt to guide the model's behavior
            max_tokens: Maximum number of tokens to generate

        Returns:
            AsyncGenerator yielding generated text chunks
        """
        from vllm import SamplingParams

        # Configure sampling parameters
        SAMPLING_PARAM = SamplingParams(
            max_tokens=max_tokens,
            skip_special_tokens=True,
        )

        # Use default system prompt if none provided
        if system_prompt is None:
            system_prompt = SYSTEM_PROMPT

        # Prepare messages for chat
        messages = [
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": prompt},
        ]

        # Apply chat template
        prompt = self.tokenizer.apply_chat_template(
            messages,
            tokenize=False,
            add_generation_prompt=True,
        )

        # Generate response stream
        stream = await self.engine.add_request(uuid.uuid4().hex, prompt, SAMPLING_PARAM)

        # Stream the generated text
        cursor = 0
        async for request_output in stream:
            text = request_output.outputs[0].text
            yield text[cursor:]
            cursor = len(text)
Buat file requirements.txt dan cantumkan semua paket Python yang diperlukan untuk membangun aplikasi AI. Tentukan versi pasti setiap paket untuk menjaga stabilitas dan reprodusibilitas proyek.
Berikut tampilan requirements.txt yang diharapkan:
accelerate==1.2.0
autoawq==0.2.7.post3
bentoml>=1.3.15
fastapi==0.115.6
openai==1.57.0
vllm==0.6.4.post1; sys_platform == "linux"
File bentofile.yaml adalah file konfigurasi yang digunakan untuk mendefinisikan dan membangun layanan BentoML. File ini mencakup komponen berikut:
app.py) dan nama kelas layanan (BentoVLLM).requirements.txt.Tambahkan konten berikut ke file bentofile.yaml Anda:
service: 'app:BentoVLLM'
labels:
  owner: Abid
  team: DataCamp
  stage: dev
include:
  - '*.py'
python:
  requirements_txt: './requirements.txt'
  lock_packages: false
docker:
python_version: "3.11"Sekarang masuk ke bagian yang menyenangkan: BentoCloud akan mengurus semuanya untuk kita, dan kita hanya perlu mengetik satu perintah. Tetapi sebelum itu, kita harus masuk ke BentoCloud dengan mengetik perintah berikut di terminal.
bentoml cloud login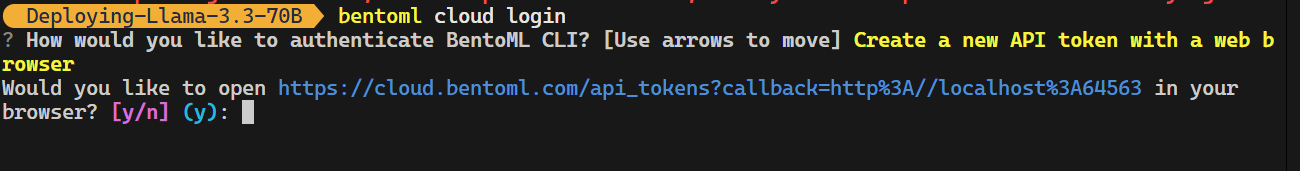
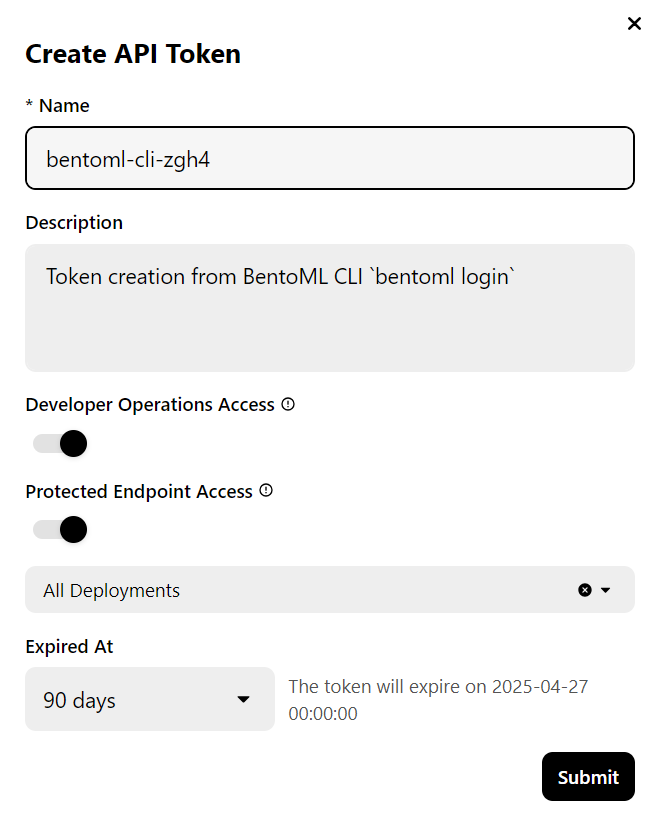
Alat CLI akan menanyakan beberapa pertanyaan lalu mengarahkan Anda ke situs BentoCloud untuk membuat akun dan menghasilkan kunci API.
Setelah selesai, kunci API akan otomatis diterapkan ke alat CLI Anda.
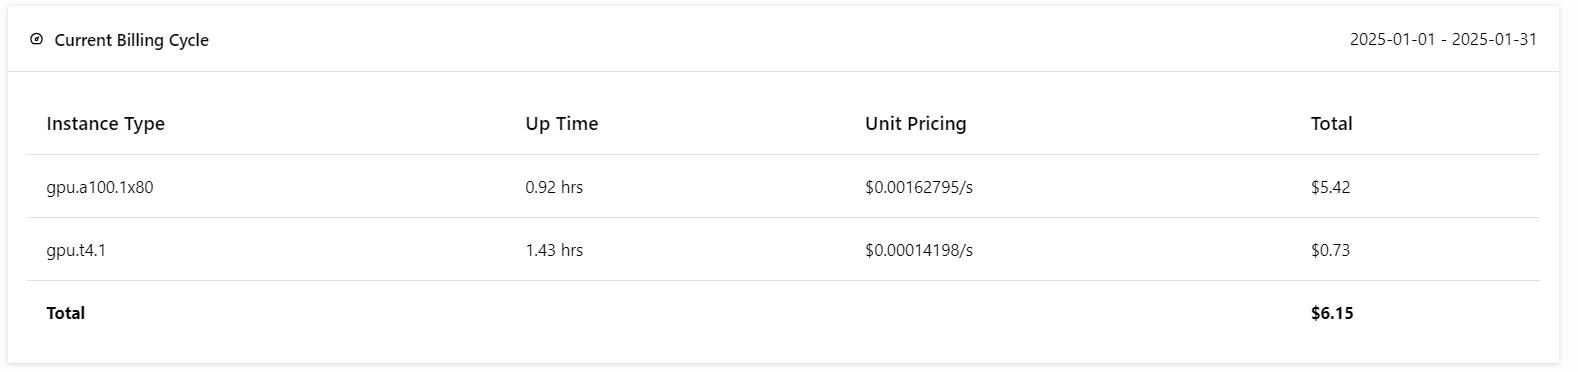
Catatan: Mendeploy versi penuh model 70B memerlukan memori GPU 80GB. Meskipun BentoCloud menyediakan kredit gratis sebesar 10 USD, Anda perlu berlangganan paket pro untuk mengakses GPU A100 dengan VRAM 80GB.
Untuk berlangganan, buka tab “Billing” dengan mengeklik foto profil Anda di pojok kanan atas dan tambahkan detail kartu kredit Anda.
Jangan khawatir; jika Anda berhati-hati saat deployment, biayanya tidak akan lebih dari $6 USD. Namun pastikan untuk menghentikan deployment setelah selesai bereksperimen!
Sekarang bagian terbaiknya: kita akan mendeploy aplikasi BentoML ke cloud menggunakan perintah berikut dan mengaktifkan otorisasi akses. Artinya, hanya pengguna dengan kunci API BentoML yang dapat mengakses server API ini.
bentoml deploy . --access-authorization truePerlu beberapa detik untuk mengirim semua file, konfigurasi, dan komponen lain yang diperlukan, setelah itu BentoCloud akan menangani sisanya.
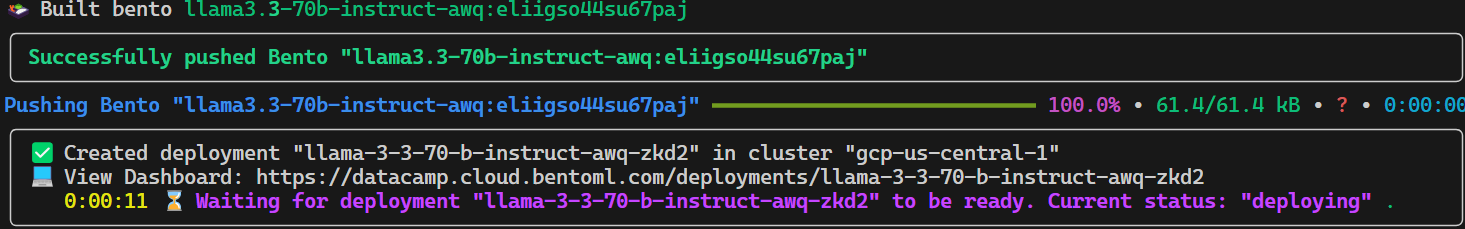
Untuk melihat deployment yang sedang berjalan, buka dasbor BentoCloud Anda dan klik tab “Deployments”. Misalnya, gambar di bawah menunjukkan aplikasi dalam proses “Image Building”:
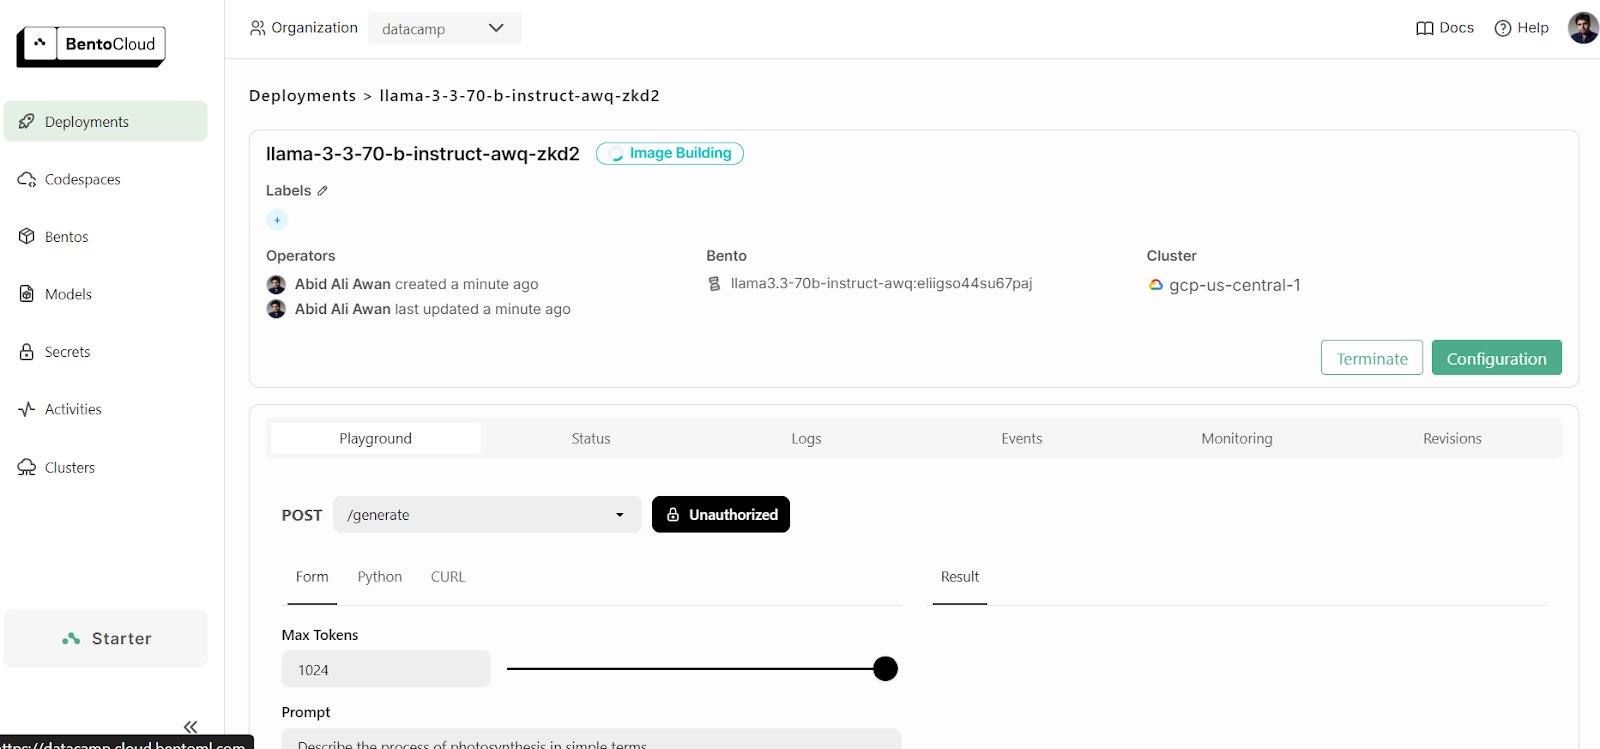
Setelah beberapa menit lagi untuk membangun image, menyiapkan infrastruktur, dan mendeploy model, aplikasi kita siap digunakan!
BentoCloud menyediakan UI Playground untuk menguji model Anda di dasbor, mirip dengan platform OpenAI. Karena layanan kita dibatasi, kita perlu memberikan kunci API untuk mengakses model di Playground, seperti berikut:
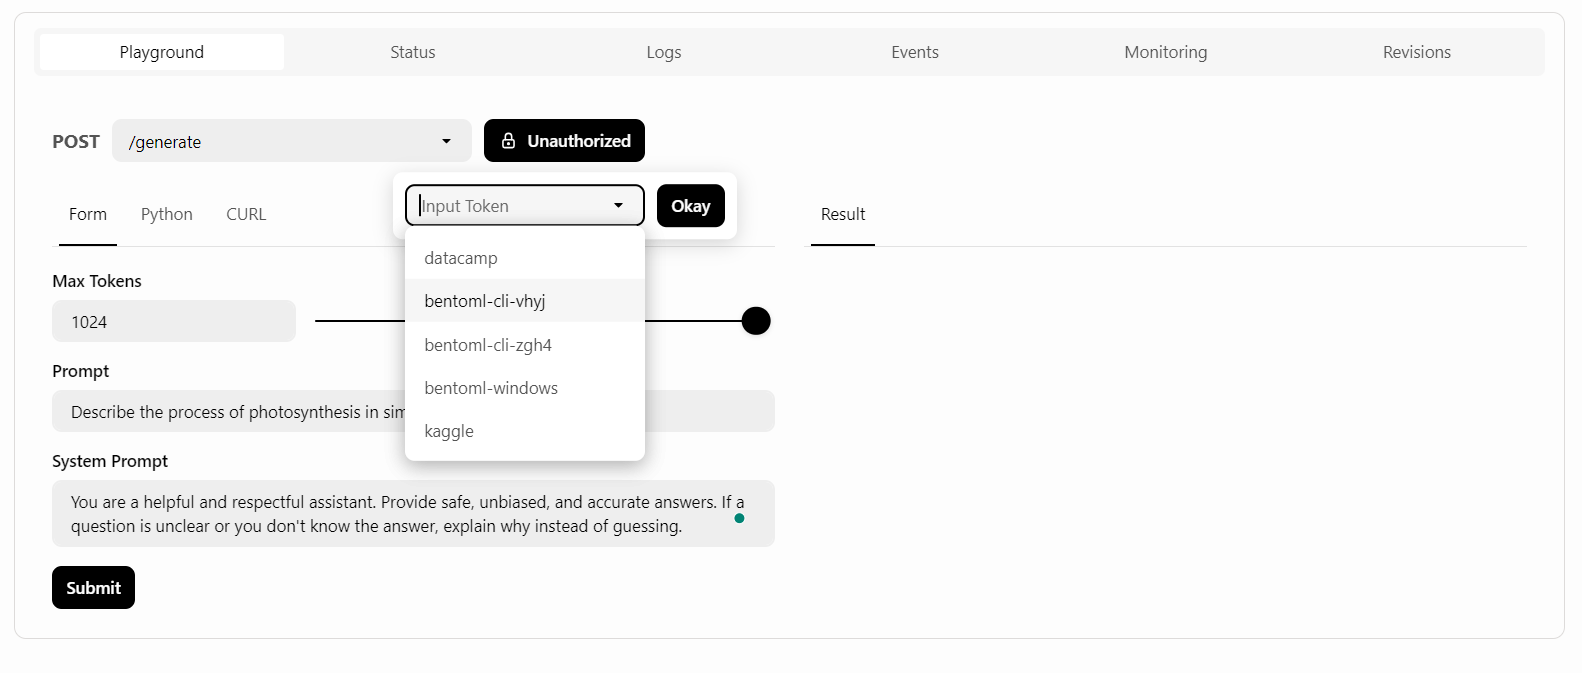
Setelah itu, kita menulis prompt dan klik tombol “Submit”.
Proses generasi respons cepat dan akurat:
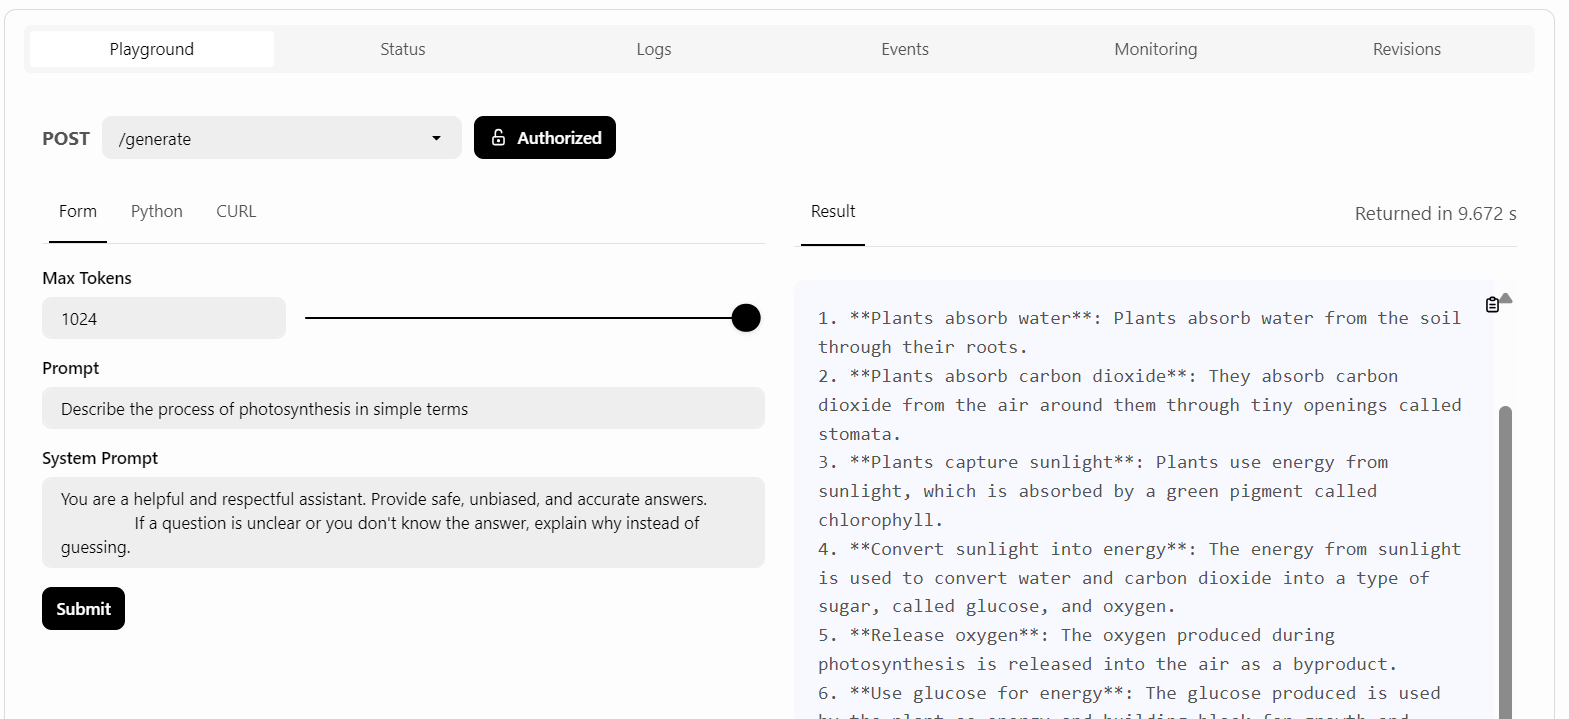
Kita akan menggunakan perintah CURL di terminal untuk mengakses layanan LLM secara lokal. Namun sebelum itu, kita perlu menghasilkan kunci API baru untuk menggunakan layanan ini di sistem mana pun:
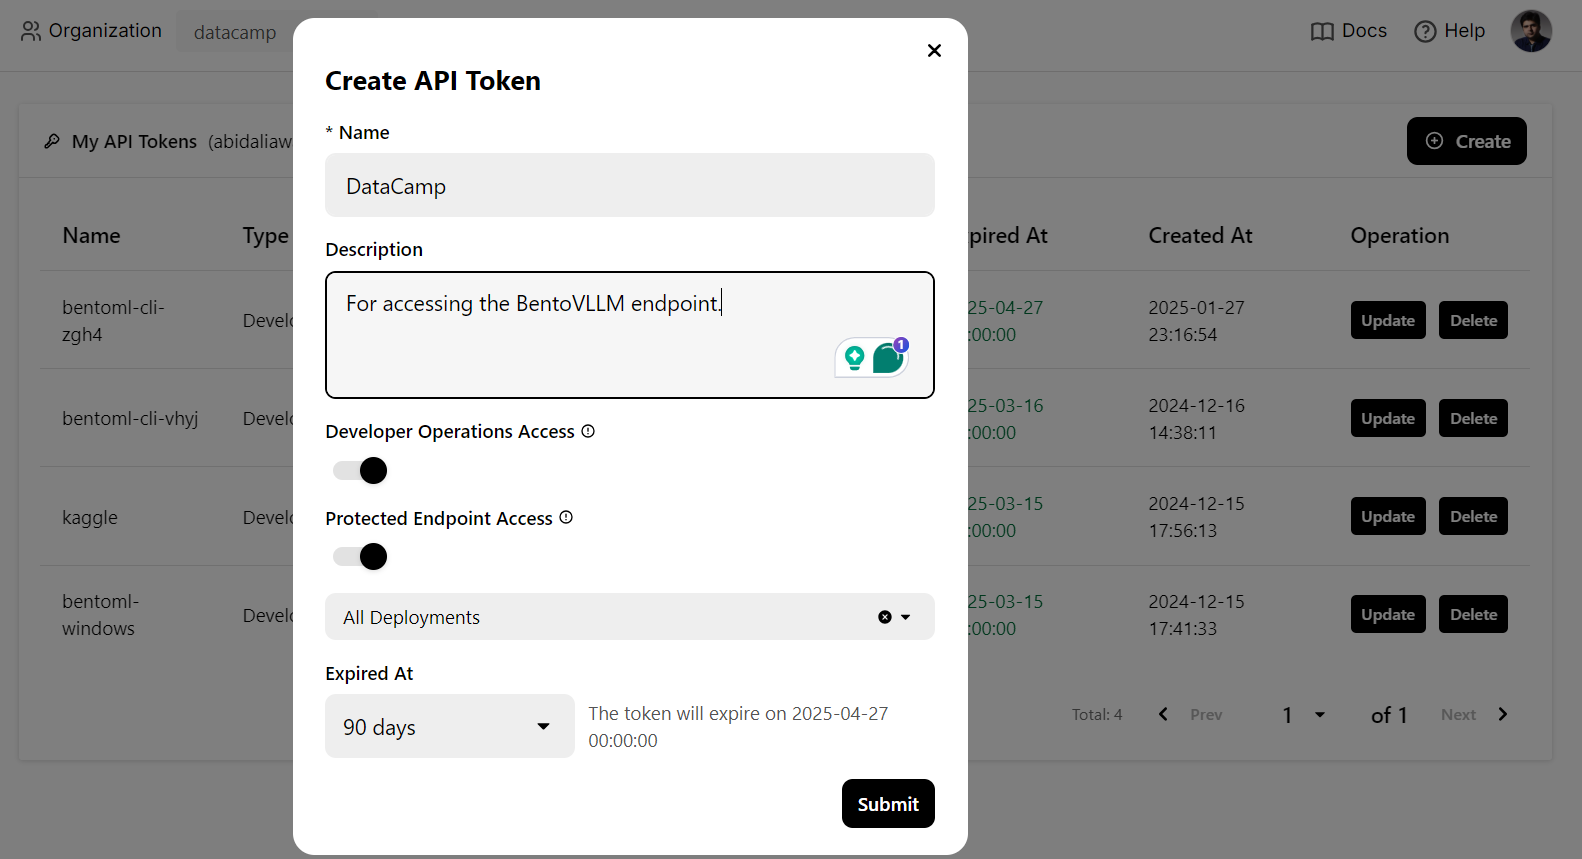
Kita juga memerlukan URL endpoint yang bisa disalin dari tab “Deployments”:
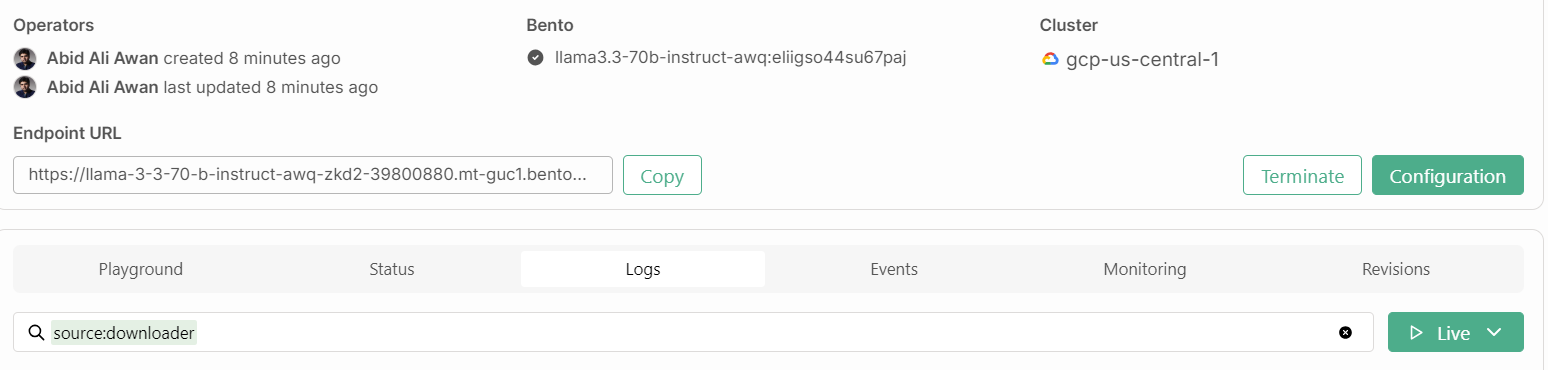
Setelah Anda memiliki kunci API dan URL endpoint, Anda dapat menghasilkan respons menggunakan perintah CURL berikut.
Perintah ini mencakup URL endpoint, kunci API, argumen max_tokens, dan prompt:
curl -s -X POST \
    'https://llama-3-3-70-b-instruct-awq-zkd2-39800880.mt-guc1.bentoml.ai/generate' \
    -H "Authorization: Bearer $(echo $BENTO_CLOUD_API_KEY)" \
    -H 'Content-Type: application/json' \
    -d '{
        "max_tokens": 1024,
        "prompt": "Describe the process of photosynthesis in simple terms"
    }'
Responsnya akurat, dan butuh beberapa pengiriman untuk menghasilkannya.
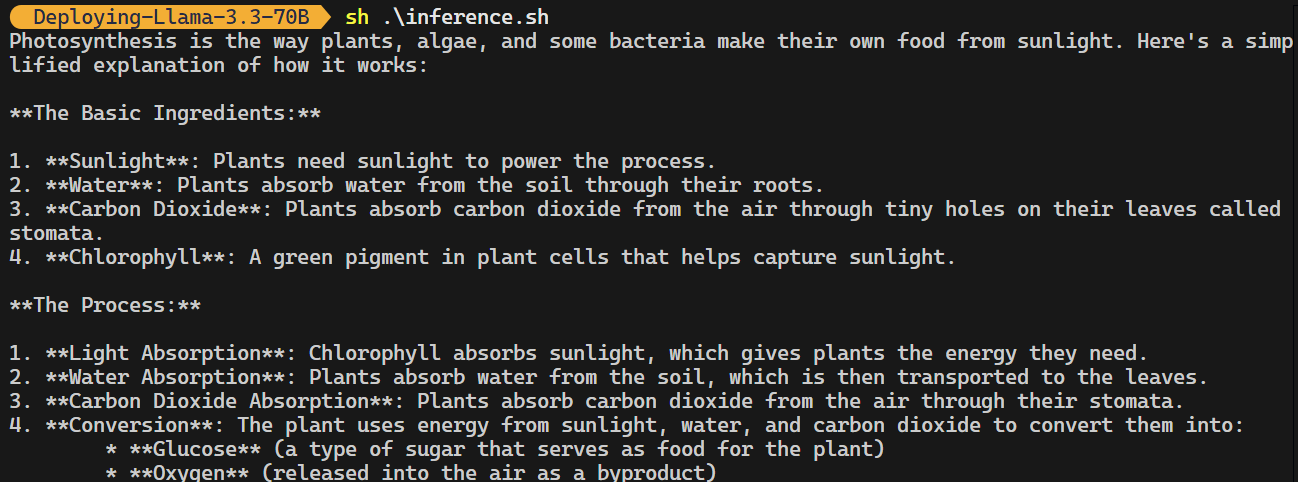
Endpoint BentoML kompatibel dengan klien Python OpenAI. Anda tidak perlu banyak memodifikasi kode untuk mengintegrasikan model open-source ini ke aplikasi Anda.
Yang perlu Anda lakukan hanyalah mengubah base URL, menyediakan kunci API, dan menentukan nama model:
import os

from openai import OpenAI

BENTOML_API_KEY = os.getenv("BENTO_CLOUD_API_KEY")  #
if BENTOML_API_KEY is None:
    raise ValueError("BENTOML_API_KEY environment variable is not set.")


client = OpenAI(
    base_url="https://llama-3-3-70-b-instruct-awq-zkd2-39800880.mt-guc1.bentoml.ai/v1",
    api_key=BENTOML_API_KEY,
)

chat_completion = client.chat.completions.create(
    model="casperhansen/llama-3.3-70b-instruct-awq",
    messages=[
        {"role": "user", "content": "What is a black hole and how does it work?"}
    ],
    stream=True,
    stop=["<|eot_id|>", "<|end_of_text|>"],
)
for chunk in chat_completion:
    print(chunk.choices[0].delta.content or "", end="")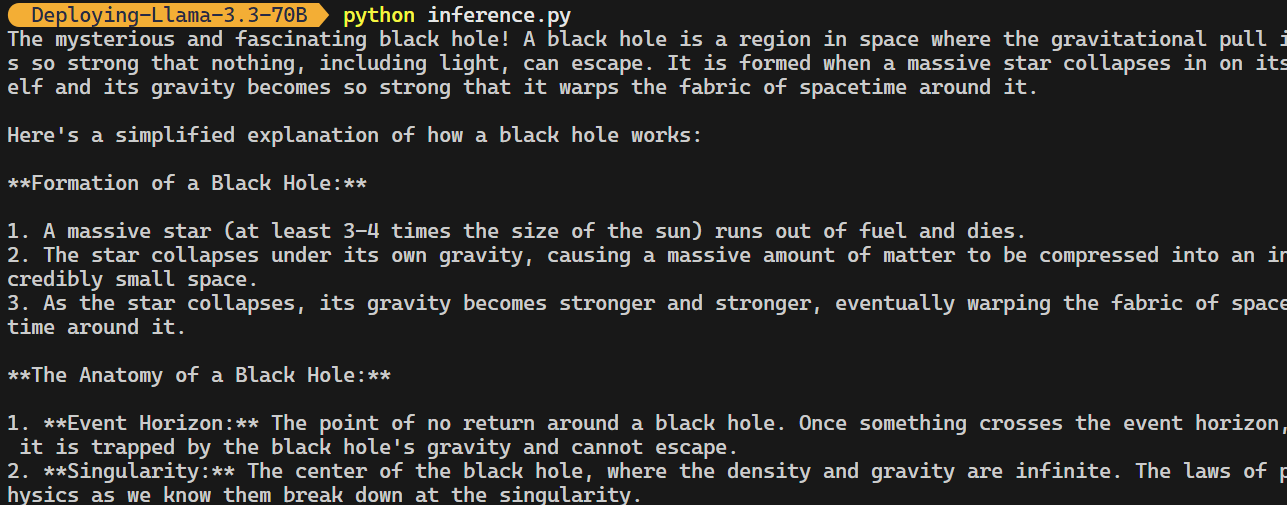
Silakan lihat repositori GitHub kingabzpro/Deploying-Llama-3.3-70B, yang berisi file aplikasi, konfigurasi, dan kode inferensi.
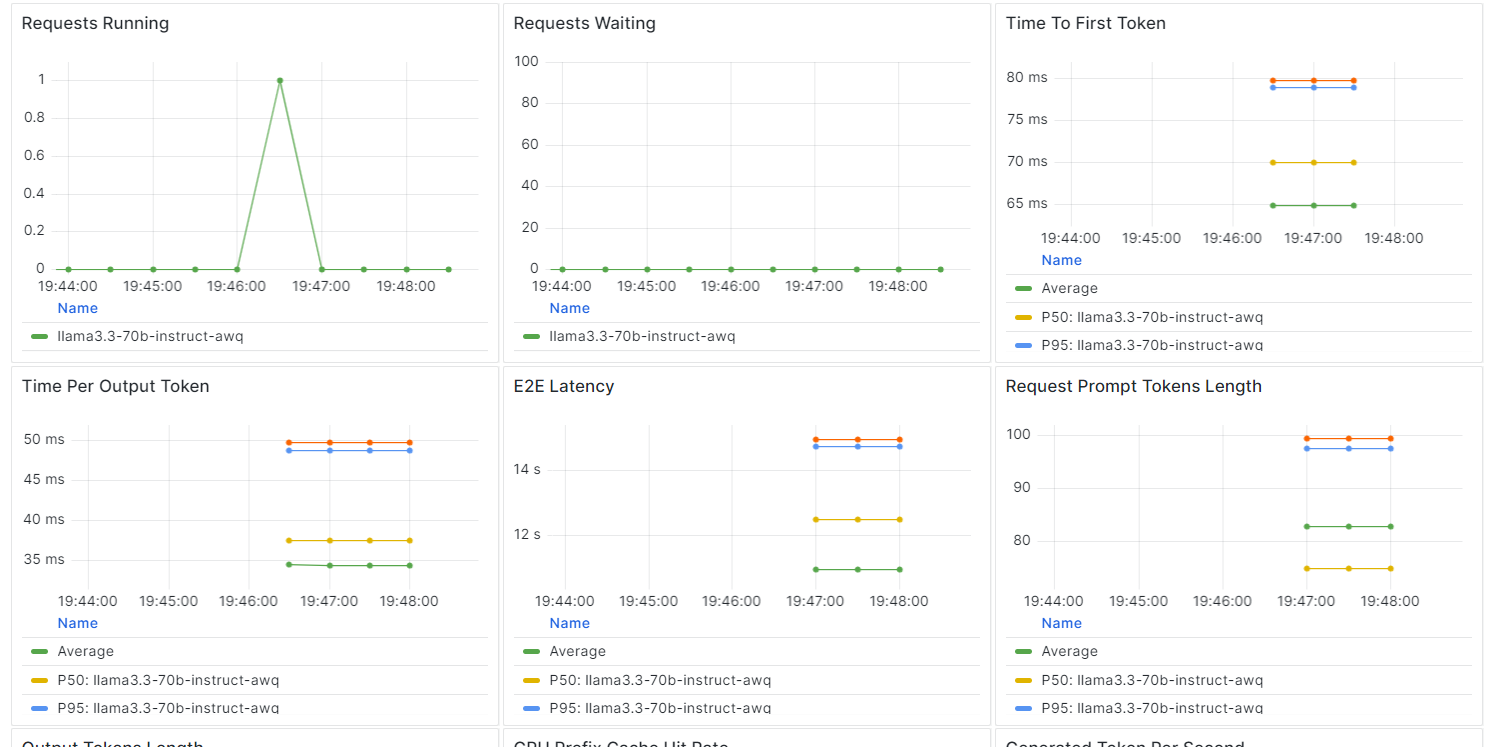
Di BentCloud, Anda dapat memantau kinerja model, latensi, penggunaan perangkat keras, throughput model, dan metrik penting lainnya tanpa menyiapkan alat logging atau monitoring.
Buka deployment Anda dan klik tab “Monitoring”.
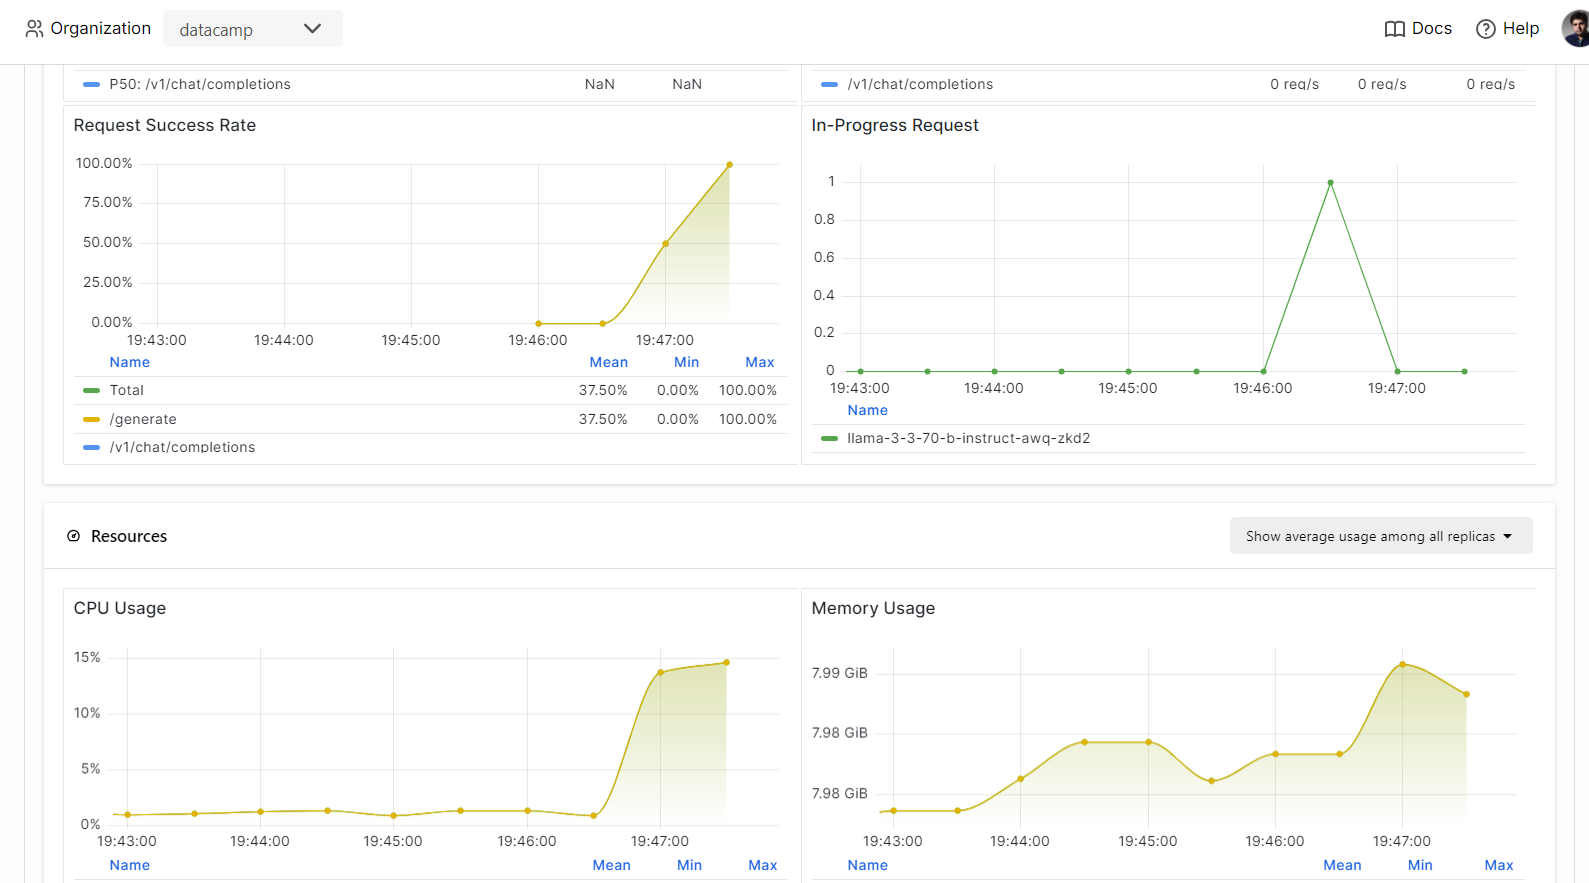
Gulir ke bawah untuk melihat metrik layanan, sumber daya, dan LLM dalam grafik yang intuitif dan mudah dipahami.
Membangun dan mendeploy endpoint LLM kini menjadi sangat mudah dengan ekosistem BentoML.
Hanya dengan menulis beberapa baris kode untuk membuat API, menyiapkan “bentofile”, dan mendeploy model, Anda dapat menjalankan model dalam hitungan menit. Setelah dideploy, endpoint dapat diakses melalui perintah CURL, pustaka Python requests, klien BentoML, atau klien OpenAI.
Hasilnya adalah sistem yang sangat efisien, berlatensi rendah, dengan throughput tinggi yang mampu menangani beberapa permintaan secara bersamaan. BentoCloud juga menawarkan auto-scaling berdasarkan konfigurasi Anda, memastikan sistem dapat menangani volume trafik tinggi dengan melakukan scale up atau down sesuai kebutuhan.
Untuk panduan yang lebih mendalam tentang deployment LLM dengan BentoML, saya sarankan mengikuti Cara Mendeploy LLM dengan BentoML: Panduan Langkah demi Langkah.
Pelajari lebih lanjut tentang AI dan LLM melalui kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt




