
Our biggest-ever sale. 60% off AI & data skills
Buy Now
Bu projede, yapay zeka servisini oluşturmak için BentoML, yüksek işlem hacimli model sunumu için vLLM ve sağlam altyapı ile dağıtım için BentoCloud kullanacağız. Ek olarak, performansı optimize etmek için modelin AWQ sürümünü dağıtacağız.
Kısacası, vLLM ile AWQ’nun birleşimi, son derece hızlı ve aynı anda birden çok isteği işleyebilen LLM uygulamaları geliştirmek için müthiş bir ikili oluşturur.
AWQ (Aktivasyon Farkındalıklı Ağırlık Niceleme), büyük dil modellerinin dağıtımını iyileştirmek için tasarlanmış yenilikçi bir niceleme tekniğidir. Bunu, bellek kullanımını önemli ölçüde azaltıp kestirim hızını artırırken yüksek doğruluğu koruyarak başarır.
Araştırma makalesini okuyarak AWQ teknolojisini ve doğruluğu korurken model kestirimini nasıl optimize ettiğini öğrenin.
vLLM (Virtual Large Language Model), büyük dil modellerinin kestirimi ve sunumunu optimize etmek için özel olarak tasarlanmış açık kaynaklı bir kütüphanedir. PagedAttention gibi gelişmiş teknikler sunarak, dikkat anahtar-değer belleğinin verimli yönetimini sağlayıp işlem hacmi ve bellek verimliliği gibi kritik sorunları ele alır.
vLLM Python paketini daha iyi anlamak için vLLM: vLLM’i Yerelde ve Google Cloud’da CPU İçin Kurma öğreticisini takip edin.
BentoML, LLM dağıtım hattının omurgası olarak hizmet veren, açık kaynaklı bir makine öğrenimi model sunum çerçevesidir. Üretimde LLM’ler de dâhil olmak üzere makine öğrenimi modellerinin paketlenmesini, dağıtılmasını ve yönetilmesini kolaylaştırır.
BentoML ile LLM’ler Nasıl Dağıtılır öğreticisini takip ederek BentoML ekosistemi ve daha küçük LLM modellerinin nasıl dağıtılacağı hakkında bilgi edinin.
BentoCloud, BentoML üzerine inşa edilmiş, makine öğrenimi modellerinin dağıtımını ve yönetimini kolaylaştırmak üzere tasarlanmış sunucusuz bir platformdur. Yapay zeka kestirimi için optimize edilmiş sağlam bir altyapı sunar ve LLM’leri sunmak için özellikle uygundur.
BentoCloud ile kullanıcılar, altyapı yönetimiyle uğraşmadan bulut ortamlarında ölçeklenebilir ve verimli yapay zeka çözümleri dağıtabilir.
Şimdi projeye devam edelim. Aşağıdaki bileşenleri oluşturacağız:
app.py dosyası.requirements.txt dosyası.bentofile.yaml dosyası.pip komutunu kullanarak BentoML Python paketini yükleyerek başlayacağız:
pip install bentomlPython uygulama dosyasında model uç noktasını şu şekilde ayarlayacağız:
bentoml, fastapi ve vllm gibi Python kütüphanelerini içe aktarın.Aşağıdaki kodu app.py dosyanıza ekleyin:
# Standard library imports
import uuid
from argparse import Namespace
from typing import AsyncGenerator, Optional
# Third-party imports
import bentoml
import fastapi
from annotated_types import Ge, Le
from typing_extensions import Annotated
# Initialize FastAPI application
openai_api_app = fastapi.FastAPI()
# Constants
MAX_MODEL_LEN = 8192
MAX_TOKENS = 1024
SYSTEM_PROMPT = """You are a helpful and respectful assistant. Provide safe, unbiased, and accurate answers.
If a question is unclear or you don't know the answer, explain why instead of guessing."""
MODEL_ID = "casperhansen/llama-3.3-70b-instruct-awq"
# Define OpenAI-compatible API endpoints
OPENAI_ENDPOINTS = [
["/chat/completions", "create_chat_completion", ["POST"]],
["/completions", "create_completion", ["POST"]],
["/models", "show_available_models", ["GET"]],
]
@bentoml.mount_asgi_app(openai_api_app, path="/v1")
@bentoml.service(
name="llama3.3-70b-instruct-awq",
traffic={
"timeout": 1200,
"concurrency": 256,
},
resources={
"gpu": 1,
"gpu_type": "nvidia-a100-80gb",
},
)
class BentoVLLM:
def __init__(self) -> None:
"""Initialize the BentoVLLM service with VLLM engine and tokenizer."""
import vllm.entrypoints.openai.api_server as vllm_api_server
from transformers import AutoTokenizer
from vllm import AsyncEngineArgs, AsyncLLMEngine
# Configure VLLM engine arguments
ENGINE_ARGS = AsyncEngineArgs(
model=MODEL_ID,
max_model_len=MAX_MODEL_LEN,
enable_prefix_caching=True,
)
# Initialize engine and tokenizer
self.engine = AsyncLLMEngine.from_engine_args(ENGINE_ARGS)
self.tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
# Register API endpoints
for route, endpoint_name, methods in OPENAI_ENDPOINTS:
endpoint_func = getattr(vllm_api_server, endpoint_name)
openai_api_app.add_api_route(
path=route,
endpoint=endpoint_func,
methods=methods,
)
# Configure model arguments
model_config = self.engine.engine.get_model_config()
args = Namespace(
model=MODEL_ID,
disable_log_requests=True,
max_log_len=1000,
response_role="assistant",
served_model_name=None,
chat_template=None,
lora_modules=None,
prompt_adapters=None,
request_logger=None,
disable_log_stats=True,
return_tokens_as_token_ids=False,
enable_tool_call_parser=True,
enable_auto_tool_choice=True,
tool_call_parser="llama3_json",
enable_prompt_tokens_details=False,
)
# Initialize application state
vllm_api_server.init_app_state(
self.engine, model_config, openai_api_app.state, args
)
@bentoml.api
async def generate(
self,
prompt: str = "Describe the process of photosynthesis in simple terms",
system_prompt: Optional[str] = SYSTEM_PROMPT,
max_tokens: Annotated[int, Ge(128), Le(MAX_TOKENS)] = MAX_TOKENS,
) -> AsyncGenerator[str, None]:
"""
Generate text based on the input prompt using the VLLM engine.
Args:
prompt: The user's input prompt
system_prompt: Optional system prompt to guide the model's behavior
max_tokens: Maximum number of tokens to generate
Returns:
AsyncGenerator yielding generated text chunks
"""
from vllm import SamplingParams
# Configure sampling parameters
SAMPLING_PARAM = SamplingParams(
max_tokens=max_tokens,
skip_special_tokens=True,
)
# Use default system prompt if none provided
if system_prompt is None:
system_prompt = SYSTEM_PROMPT
# Prepare messages for chat
messages = [
{"role": "system", "content": system_prompt},
{"role": "user", "content": prompt},
]
# Apply chat template
prompt = self.tokenizer.apply_chat_template(
messages,
tokenize=False,
add_generation_prompt=True,
)
# Generate response stream
stream = await self.engine.add_request(uuid.uuid4().hex, prompt, SAMPLING_PARAM)
# Stream the generated text
cursor = 0
async for request_output in stream:
text = request_output.outputs[0].text
yield text[cursor:]
cursor = len(text)Bir requirements.txt dosyası oluşturun ve yapay zeka uygulamasını derlemek için gerekli tüm Python paketlerini ekleyin. Projenin kararlılığını ve tekrarlanabilirliğini korumak için her paketin tam sürümlerini belirtin.
requirements.txt dosyasının şöyle görünmesi gerekir:
accelerate==1.2.0
autoawq==0.2.7.post3
bentoml>=1.3.15
fastapi==0.115.6
openai==1.57.0
vllm==0.6.4.post1; sys_platform == "linux"bentofile.yaml dosyası, BentoML servisinin tanımlanması ve oluşturulması için kullanılan yapılandırma dosyasıdır. Şu bileşenleri içerir:
app.py) ve servis sınıfı adına (BentoVLLM) bağlanır.requirements.txt dosyasını kullanarak gerekli Python paketlerini kurar.Aşağıdaki içeriği bentofile.yaml dosyanıza ekleyin:
service: 'app:BentoVLLM'
labels:
owner: Abid
team: DataCamp
stage: dev
include:
- '*.py'
python:
requirements_txt: './requirements.txt'
lock_packages: false
docker:
python_version: "3.11"Şimdi sihirli kısım geliyor: BentoCloud bizim için her şeyi yapacak ve bizim yalnızca bir komut yazmamız gerekecek. Ancak bundan önce, terminale aşağıdaki komutu yazarak BentoCloud’a giriş yapmamız gerekiyor.
bentoml cloud login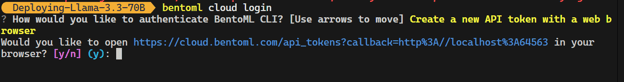
CLI aracı size birkaç soru soracak ve ardından bir hesap oluşturmak ve API anahtarını üretmek için BentoCloud web sitesine yönlendirecektir.
Bunu yaptıktan sonra, API anahtarını CLI araçlarınıza otomatik olarak uygular.
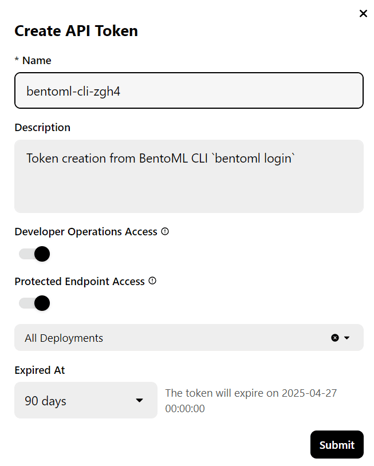
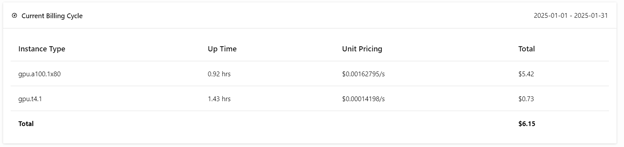
Not: 70B modelinin tam sürümünü dağıtmak 80 GB GPU belleği gerektirir. BentoCloud 10 ABD doları tutarında ücretsiz kredi sağlasa da, 80 GB VRAM’li A100 GPU’lara erişmek için pro planına abone olmanız gerekir.
Abone olmak için sağ üst köşedeki profil resminize tıklayarak “Billing” sekmesine gidin ve kredi kartı bilgilerinizi ekleyin.
Merak etmeyin; dağıtımlarda dikkatli olursanız 6 ABD dolarından fazlaya mal olmaz. Ancak denemeleriniz bittiğinde dağıtımı sonlandırdığınızdan emin olun!
Şimdi en iyi kısma geldik: Aşağıdaki komutla BentoML uygulamasını buluta dağıtacağız ve erişim yetkilendirmesini etkinleştireceğiz. Bu, yalnızca BentoML API anahtarına sahip kullanıcıların bu API sunucusuna erişebileceği anlamına gelir.
bentoml deploy . --access-authorization trueTüm dosyaların, yapılandırmaların ve diğer gerekli bileşenlerin gönderilmesi birkaç saniye sürecek; sonrasında geri kalan her şeyi BentoCloud yönetecek.
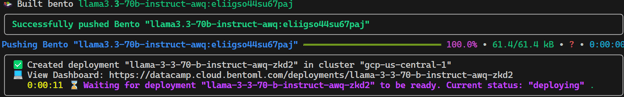
Çalışan dağıtımlarınızı görüntülemek için BentoCloud kontrol panelinize gidin ve “Deployments” sekmesine tıklayın. Örneğin, aşağıdaki görsel uygulamanın “Image Building” sürecinde olduğunu gösteriyor:
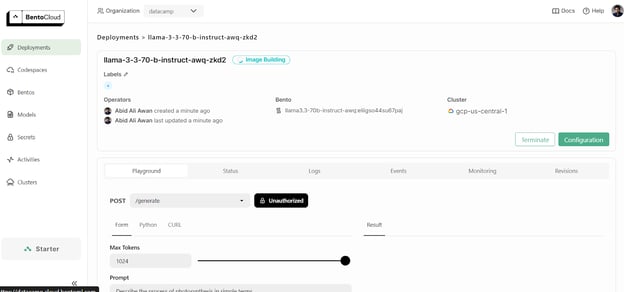
Görüntünün oluşturulması, altyapının ayarlanması ve modelin dağıtılmasının ardından birkaç dakika içinde uygulamamız kullanıma hazır!
BentoCloud, OpenAI platformuna benzer şekilde, kontrol panelinde modelinizi test etmek için bir Playground arayüzü sağlar. Servisimiz kısıtlı olduğundan, Playground’da modele erişmek için bir API anahtarı sağlamamız gerekecek; aşağıda gösterildiği gibi:
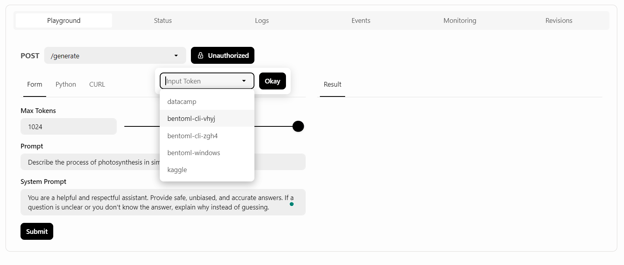
Bundan sonra istemi yazıp “Submit” düğmesine tıklayacağız.
Yanıt üretimi hızlı ve isabetliydi:
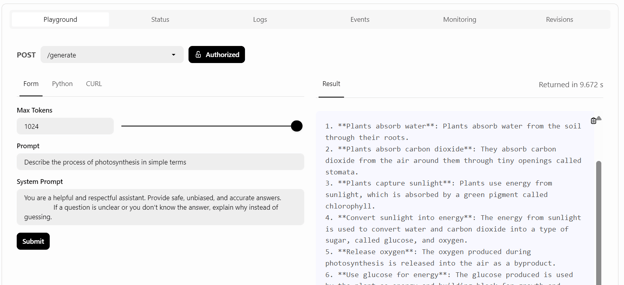
LLM servisine yerelde erişmek için terminalde bir CURL komutu kullanacağız. Ancak bundan önce, bu servisi herhangi bir sistemde kullanmak üzere yeni bir API anahtarı oluşturmamız gerekiyor:
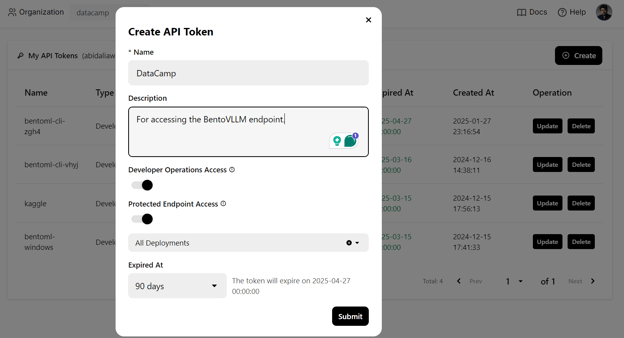
Ayrıca, “Deployments” sekmesinden kopyalayabileceğimiz uç nokta URL’sine de ihtiyacımız olacak:
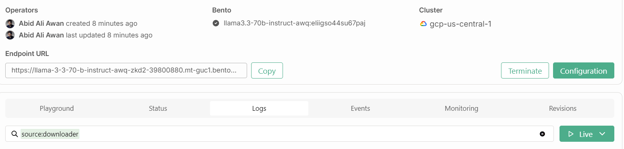
API anahtarı ve uç nokta URL’sine sahip olduğunuzda, aşağıdaki CURL komutunu kullanarak bir yanıt üretebilirsiniz.
Komut, uç nokta URL’sini, API anahtarını, max_tokens argümanını ve prompt’u içerir:
curl -s -X POST \
'https://llama-3-3-70-b-instruct-awq-zkd2-39800880.mt-guc1.bentoml.ai/generate' \
-H "Authorization: Bearer $(echo $BENTO_CLOUD_API_KEY)" \
-H 'Content-Type: application/json' \
-d '{
"max_tokens": 1024,
"prompt": "Describe the process of photosynthesis in simple terms"
}'Yanıt isabetliydi ve üretilmesi birkaç gönderim sürdü.
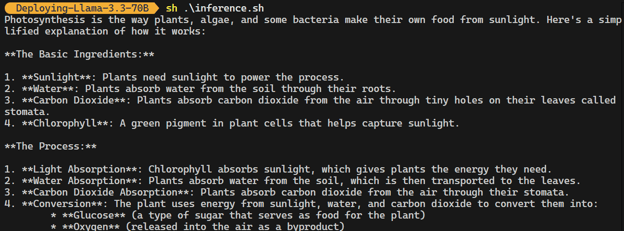
BentoML uç noktası, OpenAI Python istemcisiyle uyumludur. Bu açık kaynaklı modeli uygulamanıza entegre etmek için kodunuzda önemli değişiklikler yapmanız gerekmez.
Tek yapmanız gereken temel URL’yi değiştirmek, API anahtarını sağlamak ve model adını belirtmektir:
import os
from openai import OpenAI
BENTOML_API_KEY = os.getenv("BENTO_CLOUD_API_KEY") #
if BENTOML_API_KEY is None:
raise ValueError("BENTOML_API_KEY environment variable is not set.")
client = OpenAI(
base_url="https://llama-3-3-70-b-instruct-awq-zkd2-39800880.mt-guc1.bentoml.ai/v1",
api_key=BENTOML_API_KEY,
)
chat_completion = client.chat.completions.create(
model="casperhansen/llama-3.3-70b-instruct-awq",
messages=[
{"role": "user", "content": "What is a black hole and how does it work?"}
],
stream=True,
stop=["<|eot_id|>", "<|end_of_text|>"],
)
for chunk in chat_completion:
print(chunk.choices[0].delta.content or "", end="")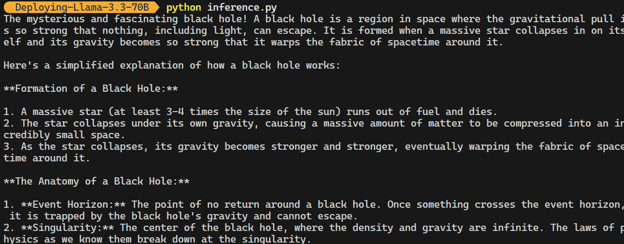
Uygulama dosyasını, yapılandırmaları ve kestirim kodlarını içeren kingabzpro/Deploying-Llama-3.3-70B GitHub deposuna göz atın.
BentCloud üzerinde, günlükleme veya izleme araçları kurmadan model performansını, gecikmeyi, donanım kullanımını, model işlem hacmini ve diğer kritik metrikleri izleyebilirsiniz.
Dağıtımlarınıza gidin ve “Monitoring” sekmesine tıklayın.
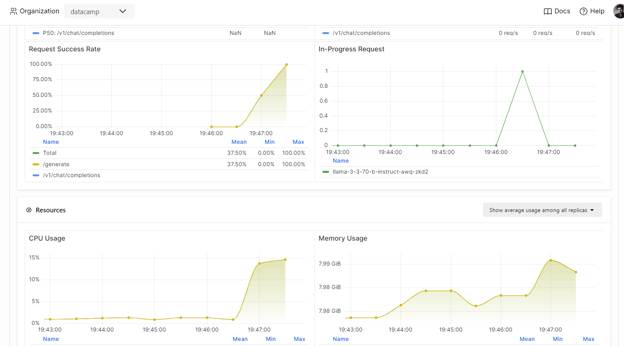
Aşağı kaydırarak servis, kaynak ve LLM ile ilgili metrikleri sezgisel ve anlaşılır grafiklerde görebilirsiniz.
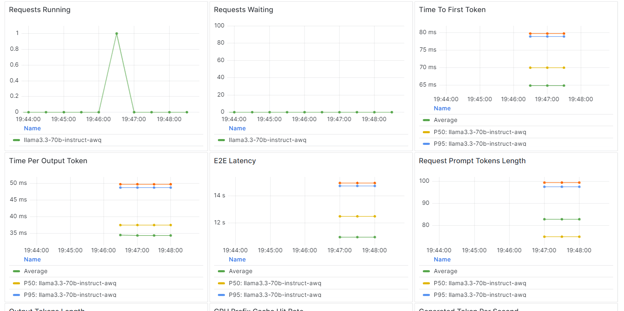
BentoML ekosistemi ile bir LLM uç noktası oluşturmak ve dağıtmak son derece kolaylaştı.
API’nizi oluşturmak için yalnızca birkaç satır kod yazarak, bir “bentofile” ayarlayarak ve modeli dağıtarak, modelinizi dakikalar içinde çalışır hale getirebilirsiniz. Dağıtımın ardından uç noktaya CURL komutları, Python requests kütüphanesi, BentoML istemcisi veya OpenAI istemcisi üzerinden erişebilirsiniz.
Ortaya çıkan sistem, aynı anda birden fazla isteği işleyebilen, yüksek işlem hacmine sahip son derece verimli ve düşük gecikmelidir. BentoCloud ayrıca yapılandırmanıza göre otomatik ölçeklendirme sunar; böylece sistem, gerekirse yukarı veya aşağı ölçeklenerek yüksek trafik hacimlerini kaldırabilir.
Daha kapsamlı bir BentoML ile LLM dağıtım kılavuzu için BentoML ile LLM’ler Nasıl Dağıtılır: Adım Adım Kılavuz yazısını takip etmenizi öneririm.
Sertifikalı bir veri bilimcisi olarak, yenilikçi makine öğrenimi uygulamaları oluşturmak için en son teknolojileri kullanmaya büyük ilgi duyuyorum. Konuşma tanıma, veri analizi ve raporlama, MLOps, konuşma yapay zekası ve NLP alanlarında güçlü bir geçmişe sahip olarak, gerçek bir etki yaratabilecek akıllı sistemler geliştirme becerilerimi geliştirdim. Teknik uzmanlığımın yanı sıra, karmaşık kavramları açık ve özlü bir dille ifade etme yeteneğine sahip, becerikli bir iletişimciyim. Sonuç olarak, veri bilimi konusunda aranan bir blog yazarı oldum ve giderek büyüyen veri profesyonelleri topluluğuyla görüşlerimi ve deneyimlerimi paylaşıyorum. Şu anda, içerik oluşturma ve düzenlemeye odaklanıyorum. Büyük dil modelleriyle çalışarak, hem işletmelerin hem de bireylerin verilerinden en iyi şekilde yararlanmalarına yardımcı olabilecek güçlü ve ilgi çekici içerikler geliştiriyorum.

blog
 Abid Ali Awan• 14 dk.

blog
 Dario Radečić• 15 dk.

Eğitim
 Adel Nehme
Bu kurslarla Yapay Zeka ve LLM’ler hakkında daha fazla bilgi edinin!
Kurs
MLOps ile makine öğrenmesi modellerini yerel not defterlerinden üretimde gerçek iş değeri yaratan işlevsel modellere dönüştürmeyi keşfedin.
Kurs
LangChain'de LLM'leri, istemleri, zincirleri ve aracıları kullanarak yapay zeka destekli uygulamaları nasıl oluşturacağınızı keşfedin.
Kurs
LLM'lerin temellerini ve onların dayandığı devrim niteliğindeki transformer mimarisini öğrenin!


Büyük dil modellerini (LLM) dağıtmak, yüksek VRAM’e sahip üst düzey GPU makineleri gerektirdikleri için giderek daha zor hale geliyor. Mühendislerin ayrıca modelleri sunma, dağıtma, test etme ve izleme gibi görevleri yönetmek için MLOps araçlarında ustalaşmaları gerekiyor. Tüm bunlara ek olarak, siber tehditlere ve prompt enjeksiyonu saldırılarına karşı koruma sağlamak için erişim kısıtlamaları uygulamaları ve güvenliği sürdürmeleri şart. Bir LLMOps mühendisi olarak hayat zor olabilir—ama endişelenmeyin; yanınızdayız!
Bu derste, Llama 3.3 70B gibi LLM’leri bulutta dağıtmak için daha basit ve verimli bir çözümü keşfedeceğiz. Yalnızca birkaç satır Python kodu ve bazı terminal komutlarıyla modelinizi çalışır hale getirebilirsiniz. BentoCloud her şeyi sadeleştirir ve yönetir; böylece dağıtım süreci hem kolay hem de güvenli olur.
Yeni başlıyorsanız, büyük dil modellerinin temellerini anlamak için Python ile LLM’lere Giriş kursunu almanızı öneririm.
Llama 3.3’e Giriş
Yeni Meta Llama 3.3, Llama 3.1 (70B) ve Llama 3.2 (90B) ile karşılaştırıldığında geliştirilmiş performans sunan, yalnızca metin (70B) ve talimatla ince ayar yapılmış çok dilli bir büyük dil modelidir (LLM). Bazı durumlarda, daha büyük Llama 3.1 (405B) modelini bile geride bırakmıştır. Bu model yalnızca metindir ve çok dilli diyalog kullanım senaryoları için optimize edilmiştir.
Llama 3.3, optimize edilmiş bir dönüştürücü (transformer) mimarisi üzerine kurulmuş otoregresif bir dil modelidir. Kullanışlılık ve güvenlik konusunda insan tercihleriyle daha iyi hizalanması için denetimli ince ayar (SFT) ve insan geri bildirimiyle pekiştirmeli öğrenme (RLHF) yöntemleriyle ince ayar yapılmıştır.
Llama 3.3 hakkında daha fazla bilgi için Meta’nın Llama 3.3 70B’si Nedir? Nasıl Çalışır, Kullanım Alanları ve Daha Fazlası blog yazısını okuyun.