

什么是 TNT-LLM?
TNT-LLM(Taxonomy and Text classification using Large Language Models)是一个两阶段框架,用于从文本文档中生成分类体系并进行分类。系统包含两个主要阶段。
阶段 1:分类体系生成
在第一阶段,系统接收一部分文本样本和一个具体的用例指令,例如“生成用于聚类新闻文章的分类体系”。它使用大语言模型(LLM)对每篇文章进行摘要,提取关键信息。通过迭代过程,LLM 基于这些摘要生成、更新并精炼分类体系,最终产出一组结构化的标签与描述,以有效地对新闻文章进行归类。
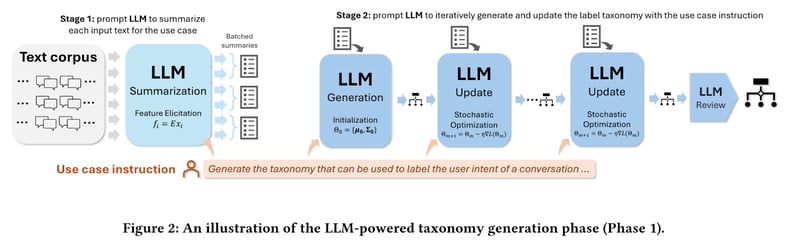
来源: Mengting Wan 等
阶段 2:文本分类
第二阶段使用已生成的分类体系为更大的数据集打标签。系统提示 LLM 应用这些标签,随后将其作为轻量级分类器(如逻辑回归)的训练数据。训练完成后,该分类器可高效地为整个语料库打标,或执行实时分类。
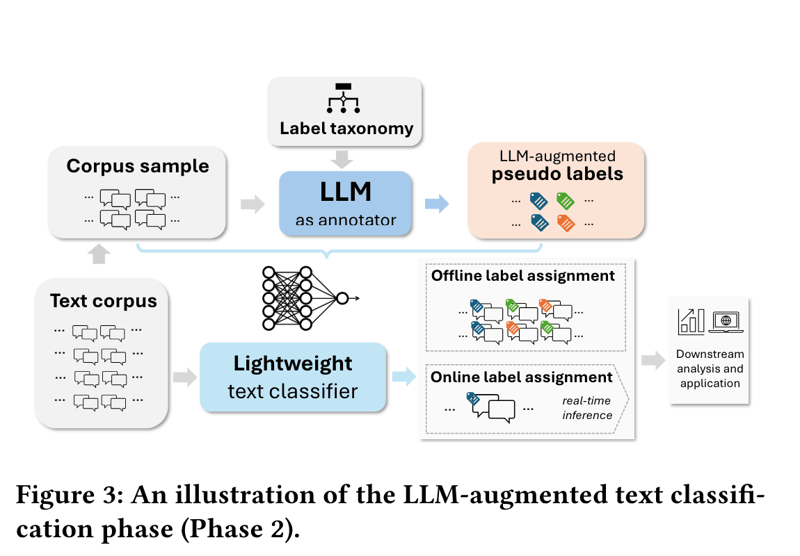
来源: Mengting Wan 等
TNT-LLM 具有很强的灵活性,适用于多种文本分类任务,包括意图识别与主题归类,其用途不仅限于对话分析。
TNT-LLM 的优势
TNT-LLM 作为大规模文本挖掘与分类的有力工具,具备多项关键优势。
自动化分类体系生成
TNT-LLM 简化了从原始文本数据中创建细致、可解释的分类体系的过程。该流程自动化了原本需要领域专家投入大量人力的工作。系统可在极少人为输入下,为特定用例生成量身定制的分类体系,显著节省时间和资源。
可扩展的分类能力
借助已生成的分类体系,TNT-LLM 支持可扩展的文本分类。它可以构建轻量级模型,高效处理大规模数据集或实时分类任务,非常适合对吞吐量要求较高的应用。
具成本效益的方法
TNT-LLM 通过分层使用不同 LLM 来优化资源利用。例如使用 GPT-4 等强大模型进行分类体系生成,而在摘要任务中采用更经济的选项如 GPT-3.5-Turbo。最终分类由高效的逻辑回归模型执行,进一步降低运营成本。
高质量输出
TNT-LLM 的迭代式分类体系生成过程确保持续打磨,最终产出高质量、相关且准确的分类结果,贴合特定数据集与用例。
最小化人工干预
在允许人工审阅与调整的同时,与传统方法相比,TNT-LLM 所需的手工输入大幅降低。这也有助于减少在构建分类体系时可能引入的偏差与不一致性。
灵活性
TNT-LLM 能很好地适配各类文本分类任务与领域,具备广泛适用性。其模块化设计支持按需集成不同的 LLM、向量化方法与分类器。
总体而言,TNT-LLM 为需要处理海量非结构化文本数据的组织提供了稳健的解决方案。
TNT-LLM 的实现
下面我们按步骤走一遍实现流程。
安装
要开始实现 TNT-LLM,您需要安装必要的依赖包。可通过以下 pip 命令完成:
pip install langgraph langchain langchain_openai此外,请设置用于 API 密钥与模型名称的环境变量:
export AZURE_OPENAI_API_KEY='your_api_key_here' export AZURE_OPENAI_MODEL='your_deployment_name_here' export AZURE_OPENAI_ENDPOINT='deployment_endpoint'基本概念
在 TNT-LLM 的语境下,理解若干基础概念对于有效发挥其能力至关重要。
文档
TNT-LLM 中的文档是指需要处理的原始文本数据,如聊天记录或文章。它们是 TNT-LLM 流水线的主要输入。每份文档使用 Doc 类进行结构化,包含 id、content 等字段,以及可选属性 summary、explanation 和 category。
分类体系
分类体系是经归类的意图或主题簇。它将数据组织到有意义的类别中,这对于意图识别与主题分类等任务至关重要。TaxonomyGenerationState 类定义了生成分类体系时的状态结构。该类包含原始文档、小批索引以及候选分类体系的簇。
构建一个简单的 TNT-LLM 应用
理解 TNT-LLM 的基础对于有效实现其功能至关重要。开始使用 TNT-LLM 时,分类体系生成过程包含以下关键步骤:
步骤 0:定义图状态类,加载数据集与 GPT-4o
首先,需要定义图状态类 TaxonomyGenerationState,用于在图执行期间管理分类体系生成与演化的有状态部分。Doc 类定义了图中单个文档的结构。
import operator
from typing import Annotated, List, TypedDict, Optional
class Doc(TypedDict):
id: str
content: str
summary: Optional[str]
explanation: Optional[str]
category: Optional[str]
class TaxonomyGenerationState(TypedDict):
# The raw docs; we inject summaries within them in the first step
documents: List[Doc]
# Indices to be concise
minibatches: List[List[int]]
# Candidate Taxonomies (full trajectory)
clusters: Annotated[List[List[dict]], operator.add]在开始生成分类体系前,我们需要加载包含原始文本数据的数据集,例如新闻文章或聊天记录。这些数据集是 TNT-LLM 的主要输入。这里我们从 Hugging Face 加载新闻文章。
import pandas as pd
from datasets import load_dataset
# Load the dataset
dataset = load_dataset("okite97/news-data")
# Access the different splits if available (e.g., train, test, validation)
train_data = dataset['train']
df = pd.DataFrame(train_data)
df = df.dropna()
df.reset_index(drop=True, inplace=True)
def run_to_doc(df: pd.DataFrame) -> Doc:
all_data = []
for i in range(len(df)):
d = df.iloc[i]
all_data.append({
"id": i,
"content": d['Title'] + "\\n\\n" + d['Excerpt']
})
return all_data
# Only clustering 100 documents
docs = run_to_doc(df[:100])
print(docs[0]){'id': 0,
'content': 'Uefa Opens Proceedings against Barcelona, Juventus and Real Madrid Over European Super League Plan\\n\\nUefa has opened disciplinary proceedings against Barcelona, Juventus and Real Madrid over their involvement in the proposed European Super League.'}最后,我们初始化一个基于 Azure 的 OpenAI GPT-4o 模型,作为 TNT-LLM 各组件的语言模型(LLM)。虽然在实践中可以为每个组件分别初始化不同的 LLM,这里为简化起见,我们在所有任务中统一使用同一个模型。
import os
from langchain_openai import AzureChatOpenAI
model = AzureChatOpenAI(
openai_api_version="2023-06-01-preview"
azure_deployment="gpt-4o-2024-05-13",
temperature=0.0
)步骤 1:文档摘要
数据集加载完成后,对每个文档进行摘要。该步骤使用语言模型生成简洁的摘要,提炼文档要点。摘要的关键在于将冗长文本压缩为更短、更易处理的形式,同时保留核心信息。
提供的代码会初始化一个用于文档摘要的 LLM 提示模板,并解析 XML 输出以提取摘要与说明。它构建了一个流水线,将文档内容映射到批处理的摘要生成过程,并通过映射与归并步骤将这些摘要回填到原始文档数据结构中。
import re
import random
from langchain import hub
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnableConfig, RunnableLambda, RunnablePassthrough
summary_prompt = hub.pull("wfh/tnt-llm-summary-generation").partial(
summary_length=20, explanation_length=30
)
def parse_summary(xml_string: str) -> dict:
summary_pattern = r"<summary>(.*?)</summary>"
explanation_pattern = r"<explanation>(.*?)</explanation>"
summary_match = re.search(summary_pattern, xml_string, re.DOTALL)
explanation_match = re.search(explanation_pattern, xml_string, re.DOTALL)
summary = summary_match.group(1).strip() if summary_match else ""
explanation = explanation_match.group(1).strip() if explanation_match else ""
return {"summary": summary, "explanation": explanation}
summary_llm_chain = (
summary_prompt | model | StrOutputParser()
).with_config(run_name="GenerateSummary")
summary_chain = summary_llm_chain | parse_summary
# Input: state
# Output: state and summaries
# Processes docs in parallel
def get_content(state: TaxonomyGenerationState):
docs = state["documents"]
return [{"content": doc["content"]} for doc in docs]
map_step = RunnablePassthrough.assign(
summaries=get_content
| RunnableLambda(func=summary_chain.batch, afunc=summary_chain.abatch)
)
def reduce_summaries(combined: dict) -> TaxonomyGenerationState:
summaries = combined["summaries"]
documents = combined["documents"]
return {
"documents": [
{
"id": doc["id"],
"content": doc["content"],
"summary": summ_info["summary"],
"explanation": summ_info["explanation"],
}
for doc, summ_info in zip(documents, summaries)
]
}
# This is the summary node
map_reduce_chain = map_step | reduce_summaries步骤 2:创建小批(minibatch)
摘要完成后,下一步是将摘要后的文档组织成小批。小批处理有助于更高效地处理海量数据。通过将数据集拆分为更小的批次,TNT-LLM 可以并行进行计算,优化时间与算力资源。
def get_minibatches(state: TaxonomyGenerationState, config: RunnableConfig):
batch_size = config["configurable"].get("batch_size", 200)
original = state["documents"]
indices = list(range(len(original)))
random.shuffle(indices)
if len(indices) < batch_size:
# Don't pad needlessly if we can't fill a single batch
return [indices]
num_full_batches = len(indices) // batch_size
batches = [
indices[i * batch_size : (i + 1) * batch_size] for i in range(num_full_batches)
]
leftovers = len(indices) % batch_size
if leftovers:
last_batch = indices[num_full_batches * batch_size :]
elements_to_add = batch_size - leftovers
last_batch += random.sample(indices, elements_to_add)
batches.append(last_batch)
return {
"minibatches": batches,
}步骤 3:生成初始分类体系
使用第一批摘要文档,TNT-LLM 开始生成分类体系。此步骤会对文档中识别出的意图或主题进行聚类。系统通过分析每个文档的内容,识别共通的主题或类别,为分类体系奠定最初的基础。
两个主要函数是:
invoke_taxonomy_chain()- 该函数通过基于 LLM 的链(chain)整合分类体系生成步骤。它从文档摘要与先前的分类体系簇构造 XML 数据表(data_table_xml)。该函数调用 LLM 链,根据给定的配置参数(config)更新分类体系,并返回包含新分类簇的更新状态。generate_taxonomy()- 该函数负责编排分类簇的生成。它调用invoke_taxonomy_chain,并使用为分类体系生成配置好的链(generate_taxonomy_chain)和初始小批文档(state["minibatches"][0])。该函数返回初始生成流程后的分类体系状态。
from typing import Dict
from langchain_core.runnables import Runnable
def parse_taxa(output_text: str) -> Dict:
"""Extract the taxonomy from the generated output."""
cluster_pattern = r"<cluster>\\s*<id>(.*?)</id>\\s*<name>(.*?)</name>\\s*<description>(.*?)</description>\\s*</cluster>"
cluster_matches = re.findall(cluster_pattern, output_text, re.DOTALL)
clusters = [
{"id": id.strip(), "name": name.strip(), "description": description.strip()}
for id, name, description in cluster_matches
]
return {"clusters": clusters}
def format_docs(docs: List[Doc]) -> str:
xml_table = "\\n"
for doc in docs:
xml_table += f'{doc["summary"]}\\n'
xml_table += ""
return xml_table
def format_taxonomy(clusters):
xml = "\\n"
for label in clusters:
xml += " \\n"
xml += f' {label["id"]}\\n'
xml += f' {label["name"]}\\n'
xml += f' {label["description"]}\\n'
xml += " \\n"
xml += ""
return xml
def invoke_taxonomy_chain(
chain: Runnable,
state: TaxonomyGenerationState,
config: RunnableConfig,
mb_indices: List[int],
) -> TaxonomyGenerationState:
configurable = config["configurable"]
docs = state["documents"]
minibatch = [docs[idx] for idx in mb_indices]
data_table_xml = format_docs(minibatch)
previous_taxonomy = state["clusters"][-1] if state["clusters"] else []
cluster_table_xml = format_taxonomy(previous_taxonomy)
updated_taxonomy = chain.invoke(
{
"data_xml": data_table_xml,
"use_case": configurable["use_case"],
"cluster_table_xml": cluster_table_xml,
"suggestion_length": configurable.get("suggestion_length", 30),
"cluster_name_length": configurable.get("cluster_name_length", 10),
"cluster_description_length": configurable.get(
"cluster_description_length", 30
),
"explanation_length": configurable.get("explanation_length", 20),
"max_num_clusters": configurable.get("max_num_clusters", 25),
}
)
return {
"clusters": [updated_taxonomy["clusters"]],
}现在,让我们看看如何将语言模型集成到分类体系生成过程中:
# We will share an LLM for each step of the generate -> update -> review cycle
# You may want to consider using Opus or another more powerful model for this
taxonomy_generation_llm = model
## Initial generation
taxonomy_generation_prompt = hub.pull("wfh/tnt-llm-taxonomy-generation").partial(
use_case="Generate the taxonomy that can be used to label the user intent in the conversation.",
)
taxa_gen_llm_chain = (
taxonomy_generation_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="GenerateTaxonomy")
generate_taxonomy_chain = taxa_gen_llm_chain | parse_taxa
def generate_taxonomy(
state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
return invoke_taxonomy_chain(
generate_taxonomy_chain, state, config, state["minibatches"][0]
)步骤 4:更新分类体系
在处理后续小批时,TNT-LLM 会迭代更新与精炼分类体系。该迭代过程使分类体系随时间演进与改进,将在新增数据批中发现的新洞见与类别纳入其中。通过不断更新,可确保分类体系覆盖全面并能反映整个数据集。
taxonomy_update_prompt = hub.pull("wfh/tnt-llm-taxonomy-update")
taxa_update_llm_chain = (
taxonomy_update_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="UpdateTaxonomy")
update_taxonomy_chain = taxa_update_llm_chain | parse_taxa
def update_taxonomy(
state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
which_mb = len(state["clusters"]) % len(state["minibatches"])
return invoke_taxonomy_chain(
update_taxonomy_chain, state, config, state["minibatches"][which_mb]
)步骤 5:审阅分类体系
当所有小批处理完毕并完成分类体系更新后,最后一步是对分类体系进行审阅。审阅对于验证分类标签的准确性与相关性至关重要。它确保分类体系能够以有意义的方式组织并归类数据集,契合目标用例(如意图识别或主题分类)。
taxonomy_review_prompt = hub.pull("wfh/tnt-llm-taxonomy-review")
taxa_review_llm_chain = (
taxonomy_review_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="ReviewTaxonomy")
review_taxonomy_chain = taxa_review_llm_chain | parse_taxa
def review_taxonomy(
state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
batch_size = config["configurable"].get("batch_size", 200)
original = state["documents"]
indices = list(range(len(original)))
random.shuffle(indices)
return invoke_taxonomy_chain(
review_taxonomy_chain, state, config, indices[:batch_size]
)步骤 6:使用 StateGraph 编排 TNT-LLM 流水线
至此,前五个步骤完成了文档摘要、小批创建、分类体系生成、更新与审阅等独立组件的准备。现在,我们将使用 StateGraph 框架把这些组件集成为一个完整的 TNT-LLM 流水线。
该图编排了任务的顺序执行:对文档进行摘要、基于小批生成分类体系、迭代更新分类体系,最后审阅并验证分类体系。条件边确保在处理完所有小批前持续进行更新,随后对最终分类体系进行审阅并定稿,用于后续的打标任务。
from langgraph.graph import StateGraph
graph = StateGraph(TaxonomyGenerationState)
graph.add_node("summarize", map_reduce_chain)
graph.add_node("get_minibatches", get_minibatches)
graph.add_node("generate_taxonomy", generate_taxonomy)
graph.add_node("update_taxonomy", update_taxonomy)
graph.add_node("review_taxonomy", review_taxonomy)
graph.add_edge("summarize", "get_minibatches")
graph.add_edge("get_minibatches", "generate_taxonomy")
graph.add_edge("generate_taxonomy", "update_taxonomy")
def should_review(state: TaxonomyGenerationState) -> str:
num_minibatches = len(state["minibatches"])
num_revisions = len(state["clusters"])
if num_revisions < num_minibatches:
return "update_taxonomy"
return "review_taxonomy"
graph.add_conditional_edges(
"update_taxonomy",
should_review,
# Optional (but required for the diagram to be drawn correctly below)
{"update_taxonomy": "update_taxonomy", "review_taxonomy": "review_taxonomy"},
)
graph.set_finish_point("review_taxonomy")
graph.set_entry_point("summarize")
app = graph.compile()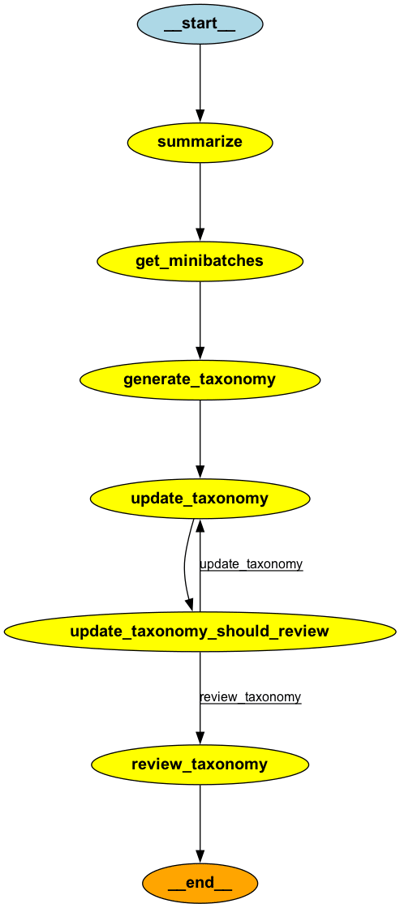
步骤 7:聚类并展示 TNT-LLM 的新闻文章分类体系
在最后一步中,我们使用 TNT-LLM 对新闻文章进行聚类。将最终的分类体系以 Markdown 表格形式展示,包含每个簇的名称与描述。
use_case = (
"Generate the taxonomy that can be used to label the news article that would benefit the user."
)
stream = app.stream(
{"documents": docs},
{
"configurable": {
"use_case": use_case,
# Optional:
"batch_size": 10,
"suggestion_length": 30,
"cluster_name_length": 10,
"cluster_description_length": 30,
"explanation_length": 20,
"max_num_clusters": 25,
},
"max_concurrency": 2,
"recursion_limit": 50,
},
)
for step in stream:
node, state = next(iter(step.items()))
print(node, str(state)[:20] + " ...")
from IPython.display import Markdown
def format_taxonomy_md(clusters):
md = "## Final Taxonomy\\n\\n"
md += "| ID | Name | Description |\\n"
md += "|----|------|-------------|\\n"
# Iterate over each inner list of dictionaries
for cluster_list in clusters:
for label in cluster_list:
id = label["id"]
name = label["name"].replace("|", "\\\\|") # Escape any pipe characters within the content
description = label["description"].replace("|", "\\\\|") # Escape any pipe characters
md += f"| {id} | {name} | {description} |\\n"
return md
markdown_table = format_taxonomy_md(step['review_taxonomy']['clusters'])
Markdown(markdown_table)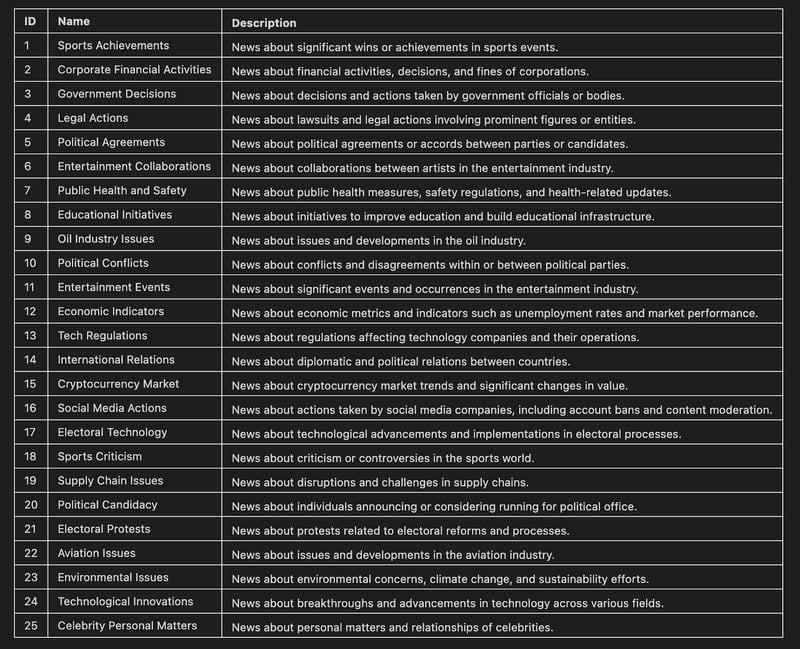
就是这样!按照上述结构化步骤,TNT-LLM 自动从原始文本数据中创建了细致且可解释的分类体系。该方法简化了传统上需要大量人工与领域知识的工作,是进行大规模文本挖掘与分类的强大工具。
结语
TNT-LLM 在文本挖掘与分类方面迈出了重要一步,为分析海量非结构化数据提供了高效方案。通过自动化生成分类体系与可扩展分类,它降低了从文本中发现洞见所需的时间与人力。
随着 TNT-LLM 的持续演进,它有潜力重塑组织分析海量文本数据的方式。该工具让跨行业的数据驱动决策成为可能,使文本数据洞见更易获取且更具影响力。
如果您想进一步学习如何开发 LLM 应用,推荐这门课程:使用 LangChain 开发 LLM 应用。

Ryan 是一名首席数据科学家,专注于使用大型语言模型构建 AI 应用。他是伦敦帝国理工学院自然语言处理与知识图谱方向的博士候选人,并在该校获得了计算机科学硕士学位。除数据科学之外,他还撰写每周的 Substack 时事通讯 The Limitless Playbook,分享来自全球顶尖思想家的一个可操作理念,并不时撰写关于核心 AI 概念的文章。
微软推出了 TNT-LLM,这是一套旨在自动化生成分类体系与文本分类的强大系统,在效率和准确性上均优于传统方法。
TNT-LLM 借助大语言模型(LLM)的能力,以极少的人为干预实现并扩展分类体系与分类器的构建。这在如 Bing Copilot 等应用场景中尤为实用,因为这些场景需要管理多样且不断演变的文本领域。
在本文中,我将带您使用 GPT-4o 和 LangGraph 实现 TNT-LLM,以高效聚类新闻文章。
如果您想进一步了解 GPT-4o 或 LangGraph,推荐阅读以下文章:
如果您想更深入了解 TNT-LLM,推荐阅读原始论文 TnT-LLM: Text Mining at Scale with Large Language Models。