

TNT-LLM Nedir?
TNT-LLM (Büyük Dil Modelleri kullanarak Taksonomi ve Metin sınıflandırma), metin belgelerinden taksonomi oluşturmak ve sınıflandırmak için geliştirilmiş iki aşamalı bir çerçevedir. Sistemin iki ana aşaması vardır.
Aşama 1: Taksonomi oluşturma
İlk aşamada, sistem bir metin belgesi örneklemi ve "haber makalelerini kümelendirecek bir taksonomi oluştur" gibi belirli bir kullanım durumu talimatını alır. Her makaleyi özetlemek ve kilit bilgileri çıkarmak için bir büyük dil modeli (LLM) kullanır. Yinelemeli bir süreçle, LLM bu özetlere dayanarak bir taksonomi üretir, günceller ve rafine eder; sonunda haber makalelerini etkili şekilde kategorize eden yapılandırılmış bir etiket ve açıklama kümesi ortaya çıkar.
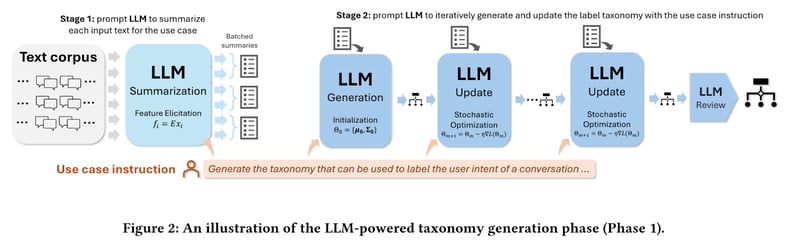
Kaynak: Mengting Wan ve diğerleri
Aşama 2: Metin sınıflandırma
İkinci aşama, oluşturulan taksonominin daha büyük bir veri kümesini etiketlemek için kullanılmasını içerir. Sistem, bu etiketleri uygulaması için bir LLM'yi yönlendirir; bu etiketler daha sonra lojistik regresyon gibi hafif bir sınıflandırıcı için eğitim verisi olarak kullanılır. Eğitildikten sonra, bu sınıflandırıcı tüm külliyatı verimli biçimde etiketlemek veya gerçek zamanlı sınıflandırma yapmak üzere dağıtılabilir.
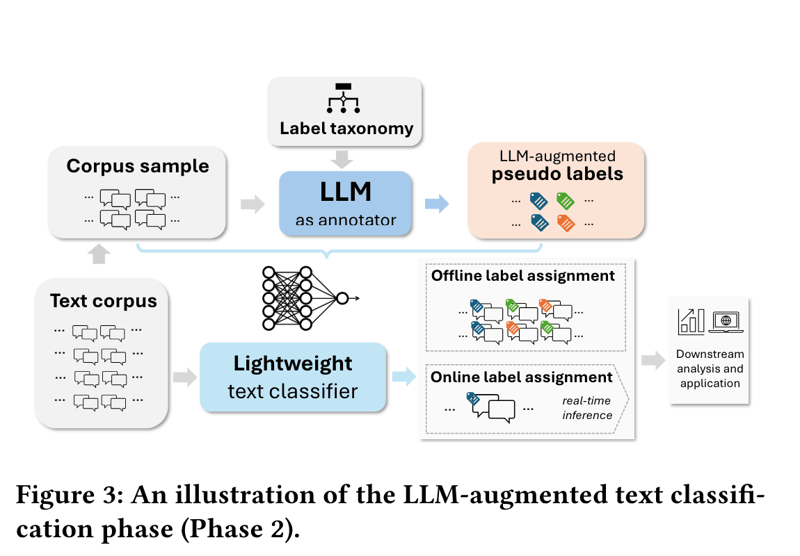
Kaynak: Mengting Wan ve diğerleri
TNT-LLM'nin esnekliği, niyet tespiti ve konu kategorilendirme dahil olmak üzere çeşitli metin sınıflandırma görevlerine uygulanabilir olmasını sağlar; bu da yalnızca konuşma analizinin ötesine uzanan bir fayda sunar.
TNT-LLM'nin Faydaları
TNT-LLM, geniş ölçekli metin madenciliği ve sınıflandırma için güçlü bir araç olarak öne çıkar ve birkaç temel avantaj sunar.
Otomatik taksonomi oluşturma
TNT-LLM, ham metin verilerinden ayrıntılı ve yorumlanabilir taksonomiler oluşturmayı basitleştirir. Bu süreç, sıklıkla alan uzmanlığı gerektiren emek yoğun bir görevi otomatikleştirmiştir. Sistem, belirli kullanım durumları için asgari insan girdisiyle özelleştirilmiş taksonomiler üretir; böylece önemli ölçüde zaman ve kaynak tasarrufu sağlar.
Ölçeklenebilir sınıflandırma
Oluşturulan taksonomileri kullanarak, TNT-LLM ölçeklenebilir metin sınıflandırma olanağı sunar. Büyük veri kümelerini veya gerçek zamanlı sınıflandırma görevlerini verimli şekilde işleyebilen hafif modellerin oluşturulmasını mümkün kılar; bu da yüksek iş hacmi gereksinimleri olan uygulamalar için idealdir.
Maliyet-etkin yaklaşım
TNT-LLM, kademeli LLM kullanımından yararlanarak kaynak kullanımını optimize eder. Taksonomi oluşturma için GPT-4 gibi güçlü modelleri, özetleme görevleri için ise GPT-3.5-Turbo gibi daha ekonomik seçenekleri kullanır. Nihai sınıflandırma, verimli bir lojistik regresyon modeliyle gerçekleştirilerek operasyonel maliyetler daha da düşürülür.
Yüksek kaliteli çıktılar
TNT-LLM'nin yinelemeli taksonomi oluşturma süreci, sürekli iyileştirme sağlar; böylece belirli veri kümeleri ve kullanım durumlarına uyarlanmış, yüksek kaliteli, ilgili ve doğru kategorilendirmeler elde edilir.
Asgari insan müdahalesi
İnsan incelemesi ve ayarlamalarına izin vermekle birlikte, TNT-LLM geleneksel yöntemlere kıyasla asgari düzeyde manuel giriş gerektirir. Bu da taksonomi oluşturmadaki potansiyel önyargıları ve tutarsızlıkları azaltır.
Esneklik
TNT-LLM, çeşitli metin sınıflandırma görevlerine ve etki alanlarına iyi uyum sağlar ve uygulamada çok yönlülük sunar. Modüler tasarımı, ihtiyaç halinde farklı LLM'ler, gömme (embedding) yöntemleri ve sınıflandırıcılarla entegrasyonu destekler.
Genel olarak, TNT-LLM, büyük miktarda yapılandırılmamış metin verisiyle uğraşan kuruluşlar için sağlam bir çözüm sunar.
TNT-LLM Uygulaması
Uygulama sürecini adım adım inceleyelim.
Kurulum
TNT-LLM uygulamalarına başlamak için gerekli paketleri kurmanız gerekir. Bunu aşağıdaki pip komutunu kullanarak yapabilirsiniz:
pip install langgraph langchain langchain_openaiAyrıca, API anahtarları ve model adları için ortam değişkenlerinizi ayarlayın:
export AZURE_OPENAI_API_KEY='your_api_key_here' export AZURE_OPENAI_MODEL='your_deployment_name_here' export AZURE_OPENAI_ENDPOINT='deployment_endpoint'Temel kavramlar
TNT-LLM bağlamında, birkaç temel kavramı anlamak, yeteneklerinden etkin şekilde yararlanmak için kritiktir.
Belgeler
TNT-LLM'deki belgeler; işlenmesi gereken sohbet kayıtları veya makaleler gibi ham metin verilerini ifade eder. Bunlar, TNT-LLM hattının birincil girdileridir. Her belge, Doc sınıfı kullanılarak yapılandırılır ve id, content gibi alanların yanı sıra summary, explanation ve category gibi isteğe bağlı öznitelikleri içerir.
Taksonomiler
Taksonomiler, kategorize edilmiş niyetler veya konuların kümeleridir. Verileri anlamlı kategoriler halinde düzenler; bu da niyet tanıma ve konu sınıflandırma gibi görevler için esastır. TaxonomyGenerationState sınıfı, taksonomi oluşturma için durum yapısını tanımlar. Bu sınıf, ham belgeleri, mini yığın indekslerini ve aday taksonomi kümelerini içerir.
Basit bir TNT-LLM uygulaması oluşturma
TNT-LLM'nin temel yönlerini anlamak, yeteneklerini etkili şekilde uygulamak için kritiktir. TNT-LLM'ye başlamak için, taksonomi oluşturma süreci birkaç kilit adımı içerir:
Adım 0: Grafik durum sınıfını tanımlayın, veri kümelerini ve GPT-4o'yu yükleyin
Öncelikle, grafiğin yürütülmesi boyunca taksonomi oluşturmanın ve evriminin durum odaklı yönlerini yöneten TaxonomyGenerationState grafik durum sınıfını tanımlamamız gerekir. Doc sınıfı, grafik içindeki bireysel belgelerin yapısını tanımlar.
import operator
from typing import Annotated, List, TypedDict, Optional
class Doc(TypedDict):
id: str
content: str
summary: Optional[str]
explanation: Optional[str]
category: Optional[str]
class TaxonomyGenerationState(TypedDict):
# The raw docs; we inject summaries within them in the first step
documents: List[Doc]
# Indices to be concise
minibatches: List[List[int]]
# Candidate Taxonomies (full trajectory)
clusters: Annotated[List[List[dict]], operator.add]Taksonomi oluşturma sürecine başlamadan önce, haber makaleleri veya sohbet kayıtları gibi ham metin verilerini içeren veri kümelerini yüklememiz gerekir. Bu veri kümeleri, TNT-LLM için birincil girdidir. Burada, Hugging Face'ten haber makaleleri yüklüyoruz.
import pandas as pd
from datasets import load_dataset
# Load the dataset
dataset = load_dataset("okite97/news-data")
# Access the different splits if available (e.g., train, test, validation)
train_data = dataset['train']
df = pd.DataFrame(train_data)
df = df.dropna()
df.reset_index(drop=True, inplace=True)
def run_to_doc(df: pd.DataFrame) -> Doc:
all_data = []
for i in range(len(df)):
d = df.iloc[i]
all_data.append({
"id": i,
"content": d['Title'] + "\\n\\n" + d['Excerpt']
})
return all_data
# Only clustering 100 documents
docs = run_to_doc(df[:100])
print(docs[0]){'id': 0,
'content': 'Uefa Opens Proceedings against Barcelona, Juventus and Real Madrid Over European Super League Plan\\n\\nUefa has opened disciplinary proceedings against Barcelona, Juventus and Real Madrid over their involvement in the proposed European Super League.'}Son olarak, Azure tabanlı bir OpenAI GPT-4o modelini, TNT-LLM'nin tüm bileşenlerinde dil modelimiz (LLM) olarak başlatıyoruz. Pratikte her bileşen için farklı LLM'ler başlatılabilse de, tüm görevler için tek bir model kullanarak basitleştiriyoruz.
import os
from langchain_openai import AzureChatOpenAI
model = AzureChatOpenAI(
openai_api_version="2023-06-01-preview"
azure_deployment="gpt-4o-2024-05-13",
temperature=0.0
)Adım 1: Belgeleri özetleyin
Veri kümeleri yüklendikten sonra, her belge bir özetleme işleminden geçer. Bu adım, her belgenin ana noktalarını yakalayan özlü özetler üretmek için dil modellerinin kullanılmasını içerir. Özetler, uzun metinleri temel bilgileri koruyarak daha kısa ve yönetilebilir formlara indirgedikleri için kritiktir.
Sağlanan kod, TNT-LLM kullanarak belgeleri özetlemek için bir LLM istemini başlatır ve özetleri ve açıklamaları çıkarmak için XML çıktısını ayrıştırır. Belge içeriğini eşleyen, özet üretimi için toplu olarak işleyen ve bu özetleri eşleme ve indirgeme adımlarını kullanarak özgün belge veri yapısına geri entegre eden bir hat kurar.
import re
import random
from langchain import hub
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnableConfig, RunnableLambda, RunnablePassthrough
summary_prompt = hub.pull("wfh/tnt-llm-summary-generation").partial(
summary_length=20, explanation_length=30
)
def parse_summary(xml_string: str) -> dict:
summary_pattern = r"<summary>(.*?)</summary>"
explanation_pattern = r"<explanation>(.*?)</explanation>"
summary_match = re.search(summary_pattern, xml_string, re.DOTALL)
explanation_match = re.search(explanation_pattern, xml_string, re.DOTALL)
summary = summary_match.group(1).strip() if summary_match else ""
explanation = explanation_match.group(1).strip() if explanation_match else ""
return {"summary": summary, "explanation": explanation}
summary_llm_chain = (
summary_prompt | model | StrOutputParser()
).with_config(run_name="GenerateSummary")
summary_chain = summary_llm_chain | parse_summary
# Input: state
# Output: state and summaries
# Processes docs in parallel
def get_content(state: TaxonomyGenerationState):
docs = state["documents"]
return [{"content": doc["content"]} for doc in docs]
map_step = RunnablePassthrough.assign(
summaries=get_content
| RunnableLambda(func=summary_chain.batch, afunc=summary_chain.abatch)
)
def reduce_summaries(combined: dict) -> TaxonomyGenerationState:
summaries = combined["summaries"]
documents = combined["documents"]
return {
"documents": [
{
"id": doc["id"],
"content": doc["content"],
"summary": summ_info["summary"],
"explanation": summ_info["explanation"],
}
for doc, summ_info in zip(documents, summaries)
]
}
# This is the summary node
map_reduce_chain = map_step | reduce_summariesAdım 2: Mini yığınlar oluşturun
Özetlemenin ardından, bir sonraki adım özetlenmiş belgeleri mini yığınlar halinde düzenlemektir. Mini yığınlama, büyük veri hacimlerinin daha verimli işlenmesine yardımcı olur. Veri kümesini daha küçük yığınlara bölerek, TNT-LLM hesaplamaları paralel olarak gerçekleştirebilir, hem zamanı hem de hesaplama kaynaklarını optimize eder.
def get_minibatches(state: TaxonomyGenerationState, config: RunnableConfig):
batch_size = config["configurable"].get("batch_size", 200)
original = state["documents"]
indices = list(range(len(original)))
random.shuffle(indices)
if len(indices) < batch_size:
# Don't pad needlessly if we can't fill a single batch
return [indices]
num_full_batches = len(indices) // batch_size
batches = [
indices[i * batch_size : (i + 1) * batch_size] for i in range(num_full_batches)
]
leftovers = len(indices) % batch_size
if leftovers:
last_batch = indices[num_full_batches * batch_size :]
elements_to_add = batch_size - leftovers
last_batch += random.sample(indices, elements_to_add)
batches.append(last_batch)
return {
"minibatches": batches,
}Adım 3: İlk Taksonomiyi Oluşturun
Özetlenmiş belgelerin ilk mini yığını kullanılarak, TNT-LLM taksonomi oluşturma sürecini başlatır. Bu adım, belgelerde belirlenen niyetlerin veya konuların kümelendirilmesini içerir. Her belgenin içeriğini analiz ederek sistem, ortak temaları veya kategorileri belirler ve taksonominin ilk temelini atar.
İki ana işlev şunlardır:
invoke_taxonomy_chain()- Bu işlev, TNT-LLM görevleri için yapılandırılmış bir LLM tabanlı zincir (chain) kullanarak taksonomi oluşturma adımlarını entegre eder. Belge özetlerinden ve önceki taksonomi kümelerinden XML veri tabloları (data_table_xml) oluşturur. İşlev, belirli yapılandırma parametrelerine (config) göre taksonomiyi güncellemek için LLM zincirini çağırır ve yeni taksonomi kümeleriyle güncellenmiş bir durumu döndürür.generate_taxonomy()- Bu işlev, taksonomi kümesi üretimini orkestre eder. İlk belge mini yığını (state["minibatches"][0]) kullanılarak taksonomi oluşturma için yapılandırılmış bir zincirle (generate_taxonomy_chain)invoke_taxonomy_chainişlevini çağırır. Başlangıç oluşturma sürecinden sonra güncellenmiş taksonomi durumunu döndürür.
from typing import Dict
from langchain_core.runnables import Runnable
def parse_taxa(output_text: str) -> Dict:
"""Extract the taxonomy from the generated output."""
cluster_pattern = r"<cluster>\\s*<id>(.*?)</id>\\s*<name>(.*?)</name>\\s*<description>(.*?)</description>\\s*</cluster>"
cluster_matches = re.findall(cluster_pattern, output_text, re.DOTALL)
clusters = [
{"id": id.strip(), "name": name.strip(), "description": description.strip()}
for id, name, description in cluster_matches
]
return {"clusters": clusters}
def format_docs(docs: List[Doc]) -> str:
xml_table = "\\n"
for doc in docs:
xml_table += f'{doc["summary"]}\\n'
xml_table += ""
return xml_table
def format_taxonomy(clusters):
xml = "\\n"
for label in clusters:
xml += " \\n"
xml += f' {label["id"]}\\n'
xml += f' {label["name"]}\\n'
xml += f' {label["description"]}\\n'
xml += " \\n"
xml += ""
return xml
def invoke_taxonomy_chain(
chain: Runnable,
state: TaxonomyGenerationState,
config: RunnableConfig,
mb_indices: List[int],
) -> TaxonomyGenerationState:
configurable = config["configurable"]
docs = state["documents"]
minibatch = [docs[idx] for idx in mb_indices]
data_table_xml = format_docs(minibatch)
previous_taxonomy = state["clusters"][-1] if state["clusters"] else []
cluster_table_xml = format_taxonomy(previous_taxonomy)
updated_taxonomy = chain.invoke(
{
"data_xml": data_table_xml,
"use_case": configurable["use_case"],
"cluster_table_xml": cluster_table_xml,
"suggestion_length": configurable.get("suggestion_length", 30),
"cluster_name_length": configurable.get("cluster_name_length", 10),
"cluster_description_length": configurable.get(
"cluster_description_length", 30
),
"explanation_length": configurable.get("explanation_length", 20),
"max_num_clusters": configurable.get("max_num_clusters", 25),
}
)
return {
"clusters": [updated_taxonomy["clusters"]],
}Şimdi, dil modelinin taksonomi oluşturma sürecine nasıl entegre edilebileceğine bakalım:
# We will share an LLM for each step of the generate -> update -> review cycle
# You may want to consider using Opus or another more powerful model for this
taxonomy_generation_llm = model
## Initial generation
taxonomy_generation_prompt = hub.pull("wfh/tnt-llm-taxonomy-generation").partial(
use_case="Generate the taxonomy that can be used to label the user intent in the conversation.",
)
taxa_gen_llm_chain = (
taxonomy_generation_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="GenerateTaxonomy")
generate_taxonomy_chain = taxa_gen_llm_chain | parse_taxa
def generate_taxonomy(
state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
return invoke_taxonomy_chain(
generate_taxonomy_chain, state, config, state["minibatches"][0]
)Adım 4: Taksonomiyi güncelleyin
Sonraki mini yığınlar işlendiğinde, TNT-LLM taksonomiyi yinelemeli olarak günceller ve rafine eder. Bu yinelemeli süreç, taksonominin zaman içinde evrilip gelişmesine, ilave veri yığınlarında keşfedilen yeni içgörü ve kategorilerin dâhil edilmesine olanak tanır. Güncellemeler, taksonominin kapsamlı kalmasını ve tüm veri kümesini yansıtmasını sağlar.
taxonomy_update_prompt = hub.pull("wfh/tnt-llm-taxonomy-update")
taxa_update_llm_chain = (
taxonomy_update_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="UpdateTaxonomy")
update_taxonomy_chain = taxa_update_llm_chain | parse_taxa
def update_taxonomy(
state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
which_mb = len(state["clusters"]) % len(state["minibatches"])
return invoke_taxonomy_chain(
update_taxonomy_chain, state, config, state["minibatches"][which_mb]
)Adım 5: Taksonomiyi gözden geçirin
Tüm mini yığınlar işlendi ve taksonomi güncellendikten sonra, son adım taksonominin gözden geçirilmesini içerir. Bu gözden geçirme, kategorize edilmiş etiketlerin doğruluğunu ve uygunluğunu doğrulamak için kritiktir. Taksonominin veri kümesini anlamlı bir şekilde düzenleyip kategorize ettiğinden ve niyet tanıma veya konu sınıflandırma gibi hedeflenen kullanım durumuyla uyumlu olduğundan emin olur.
taxonomy_review_prompt = hub.pull("wfh/tnt-llm-taxonomy-review")
taxa_review_llm_chain = (
taxonomy_review_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="ReviewTaxonomy")
review_taxonomy_chain = taxa_review_llm_chain | parse_taxa
def review_taxonomy(
state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
batch_size = config["configurable"].get("batch_size", 200)
original = state["documents"]
indices = list(range(len(original)))
random.shuffle(indices)
return invoke_taxonomy_chain(
review_taxonomy_chain, state, config, indices[:batch_size]
)Adım 6: TNT-LLM hattını StateGraph ile orkestre etmek
Şu ana kadar, ilk beş adım belge özetleme, mini yığın oluşturma, taksonomi oluşturma, güncelleme ve gözden geçirme gibi bireysel bileşenlerin hazırlanmasını içeriyordu. Artık bu bileşenleri, StateGraph çerçevesi kullanarak uyumlu bir TNT-LLM hattına entegre etmeye hazırız.
Bu grafik, görevlerin sıralı yürütülmesini orkestre eder: belgelerin özetlenmesi, mini yığınlardan taksonomi üretilmesi, taksonomilerin yinelemeli olarak güncellenmesi ve son olarak taksonominin gözden geçirilip doğrulanması. Koşullu kenarlar, tüm mini yığınlar işlenene kadar taksonomilerin güncellenmesini; ardından son taksonominin etiketleme görevlerinde kullanılmak üzere gözden geçirilip sonlandırılmasını sağlar.
from langgraph.graph import StateGraph
graph = StateGraph(TaxonomyGenerationState)
graph.add_node("summarize", map_reduce_chain)
graph.add_node("get_minibatches", get_minibatches)
graph.add_node("generate_taxonomy", generate_taxonomy)
graph.add_node("update_taxonomy", update_taxonomy)
graph.add_node("review_taxonomy", review_taxonomy)
graph.add_edge("summarize", "get_minibatches")
graph.add_edge("get_minibatches", "generate_taxonomy")
graph.add_edge("generate_taxonomy", "update_taxonomy")
def should_review(state: TaxonomyGenerationState) -> str:
num_minibatches = len(state["minibatches"])
num_revisions = len(state["clusters"])
if num_revisions < num_minibatches:
return "update_taxonomy"
return "review_taxonomy"
graph.add_conditional_edges(
"update_taxonomy",
should_review,
# Optional (but required for the diagram to be drawn correctly below)
{"update_taxonomy": "update_taxonomy", "review_taxonomy": "review_taxonomy"},
)
graph.set_finish_point("review_taxonomy")
graph.set_entry_point("summarize")
app = graph.compile()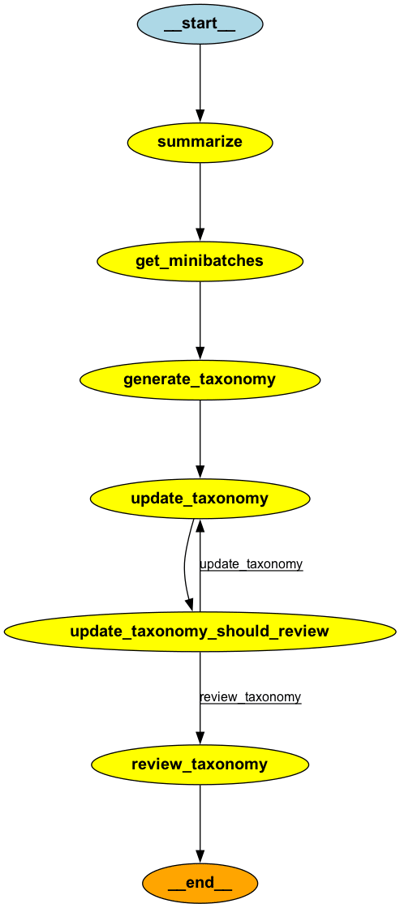
Adım 7: TNT-LLM'nin Haber Makalesi Taksonomisini Kümeleme ve Görüntüleme
Bu son adımda, haber makalelerini kümelemek için TNT-LLM'den yararlanıyoruz. Ortaya çıkan taksonomi, her kümenin ad ve açıklamalarını sergileyen bir Markdown formatında görüntülenir.
use_case = (
"Generate the taxonomy that can be used to label the news article that would benefit the user."
)
stream = app.stream(
{"documents": docs},
{
"configurable": {
"use_case": use_case,
# Optional:
"batch_size": 10,
"suggestion_length": 30,
"cluster_name_length": 10,
"cluster_description_length": 30,
"explanation_length": 20,
"max_num_clusters": 25,
},
"max_concurrency": 2,
"recursion_limit": 50,
},
)
for step in stream:
node, state = next(iter(step.items()))
print(node, str(state)[:20] + " ...")
from IPython.display import Markdown
def format_taxonomy_md(clusters):
md = "## Final Taxonomy\\n\\n"
md += "| ID | Name | Description |\\n"
md += "|----|------|-------------|\\n"
# Iterate over each inner list of dictionaries
for cluster_list in clusters:
for label in cluster_list:
id = label["id"]
name = label["name"].replace("|", "\\\\|") # Escape any pipe characters within the content
description = label["description"].replace("|", "\\\\|") # Escape any pipe characters
md += f"| {id} | {name} | {description} |\\n"
return md
markdown_table = format_taxonomy_md(step['review_taxonomy']['clusters'])
Markdown(markdown_table)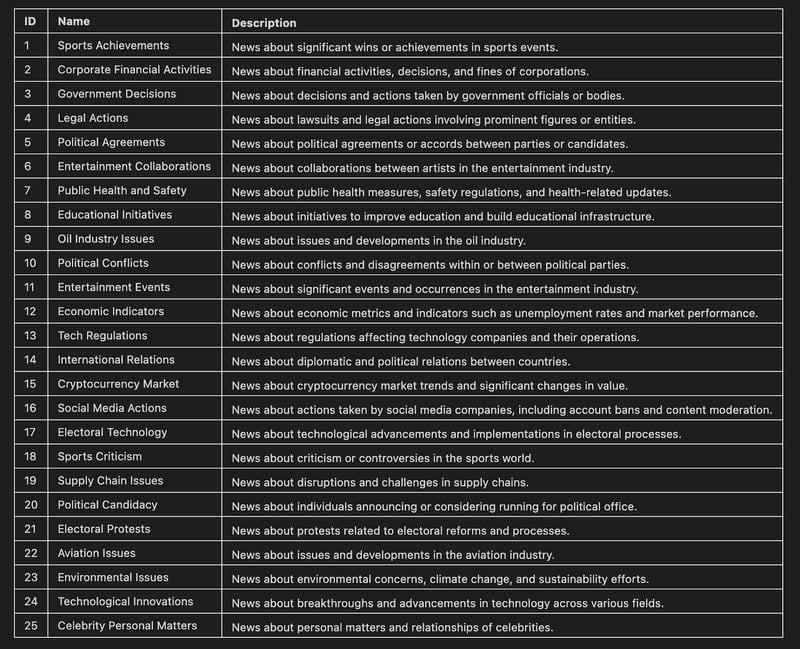
Ve işte bu kadar! Bu yapılandırılmış adımları izleyerek, TNT-LLM ham metin verilerinden ayrıntılı ve yorumlanabilir taksonomilerin oluşturulmasını otomatikleştirdi. Bu yaklaşım, geleneksel olarak ciddi insan çabası ve alan uzmanlığı gerektiren süreci basitleştirerek, geniş ölçekli metin madenciliği ve sınıflandırma görevleri için güçlü bir araç sunuyor.
Sonuç
TNT-LLM, büyük hacimli yapılandırılmamış verileri analiz etmek için verimli bir çözüm sunarak metin madenciliği ve sınıflandırmada önemli bir ilerlemeyi temsil ediyor. Taksonomi oluşturmayı ve ölçeklenebilir sınıflandırmayı otomatikleştirerek, metinden içgörü elde etmek için gereken zamanı ve çabayı azaltır.
TNT-LLM geliştikçe, kuruluşların büyük miktarda metin verisini analiz etme biçimini dönüştürme potansiyeline sahiptir. Bu araç, sektörler genelinde veriye dayalı karar almayı mümkün kılarak, metinsel verilerden elde edilen içgörüleri daha erişilebilir ve etkili hale getirir.
LLM uygulamaları geliştirme hakkında daha fazla bilgi edinmek isterseniz, LangChain ile LLM Uygulamaları Geliştirme kursunu öneririm.

Ryan, LLM'ler kullanarak yapay zeka uygulamaları geliştirme konusunda uzmanlaşmış kıdemli bir veri bilimcisidir. Imperial College London'da Doğal Dil İşleme ve Bilgi Grafiklerinde doktora adayıdır ve aynı kurumda Bilgisayar Bilimleri alanında yüksek lisansını tamamlamıştır. Veri bilimi dışında, haftalık Substack bülteni The Limitless Playbook'u yayımlar; burada dünyanın önde gelen düşünürlerinden uygulanabilir tek bir fikri paylaşır ve zaman zaman temel yapay zeka kavramları hakkında yazar.



Microsoft, taksonomi oluşturmayı ve metin sınıflandırmayı otomatikleştirmek için tasarlanmış, verimlilik ve doğrulukta geleneksel yöntemleri geride bırakan güçlü bir sistem olan TNT-LLM'yi tanıttı.
TNT-LLM, büyük dil modellerinin (LLM'ler) gücünden yararlanarak, insan müdahalesini en aza indirip taksonomiler ve sınıflandırıcılar oluşturmayı otomatikleştirir ve ölçeklendirir. Bu da, çeşitli ve sürekli evrilen metin alanlarının yönetiminin kritik olduğu Bing Copilot gibi uygulamalar için özellikle yararlıdır.
Bu yazıda, haber makalelerini etkin şekilde kümelendirmek için GPT-4o ve LangGraph kullanarak TNT-LLM'yi nasıl uygulayacağınıza rehberlik edeceğim.
GPT-4o veya LangGraph hakkında daha fazla okumak isterseniz şu makaleleri öneririm:
TNT-LLM hakkında daha fazla bilgi edinmek isterseniz, özgün makaleyi öneririm TnT-LLM: Büyük Dil Modelleriyle Ölçekte Metin Madenciliği.