
Cursus
Multi-agent systemen met LangGraph
2 uur 45 min
9K
TNT-LLM (Taxonomy and Text classification using Large Language Models) is een tweefasenframework dat is ontwikkeld om taxonomieën te genereren en teksten te classificeren op basis van documenten. Het systeem kent twee hoofdfasen.
In de eerste fase krijgt het systeem een steekproef van tekstdocumenten en een specifieke instructie voor de usecase, zoals "genereer een taxonomie om nieuwsartikelen te clusteren". Het gebruikt een large language model (LLM) om elk artikel samen te vatten en de kerninformatie te extraheren. Via een iteratief proces genereert, actualiseert en verfijnt het LLM een taxonomie op basis van deze samenvattingen, wat uiteindelijk resulteert in een gestructureerde set labels en beschrijvingen die de nieuwsartikelen effectief categoriseren.
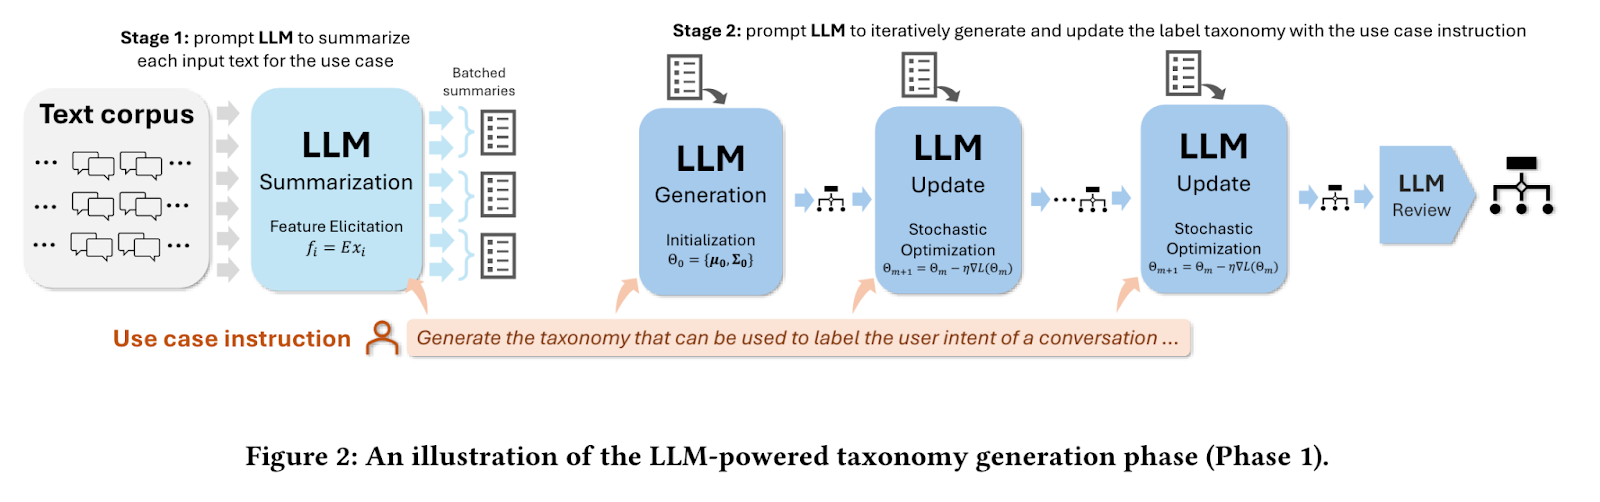
Bron: Mengting Wan et al.
De tweede fase betreft het gebruik van de gegenereerde taxonomie om een grotere dataset te labelen. Het systeem vraagt een LLM om deze labels toe te passen, die vervolgens dienen als trainingsdata voor een lichtgewicht classifier, zoals logistische regressie. Na training kan deze classifier worden ingezet om efficiënt het volledige corpus te labelen of real-time classificatie uit te voeren.
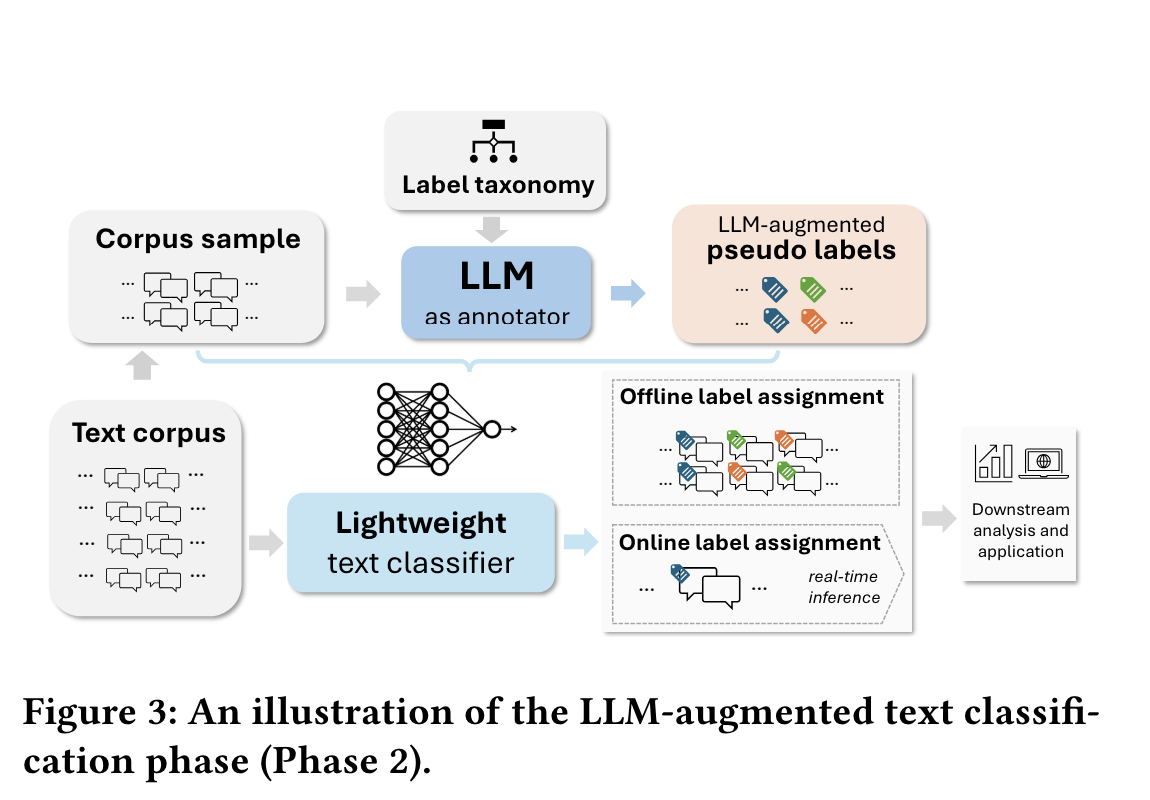
Bron: Mengting Wan et al.
De flexibiliteit van TNT-LLM maakt het toepasbaar op uiteenlopende tekstclassificatietaken, waaronder intentiedetectie en topiccategorisatie, waardoor het nut verder reikt dan alleen conversatie-analyse.
TNT-LLM is een krachtig hulpmiddel voor grootschalige text mining en classificatie, met verschillende belangrijke voordelen.
TNT-LLM vereenvoudigt het maken van gedetailleerde en interpreteerbare taxonomieën uit ruwe tekstdata. Dit proces automatiseert een arbeidsintensieve taak die vaak domeinkennis vereist. Het systeem genereert op maat gemaakte taxonomieën voor specifieke usecases met minimale menselijke input, wat aanzienlijk tijd en middelen bespaart.
Met de gegenereerde taxonomieën maakt TNT-LLM schaalbare tekstclassificatie mogelijk. Het ondersteunt het bouwen van lichtgewicht modellen die efficiënt grote datasets of real-time classificatietaken aankunnen, ideaal voor toepassingen met hoge doorvoereisen.
TNT-LLM optimaliseert het gebruik van resources door gelaagd LLM-gebruik. Het zet krachtige modellen zoals GPT-4 in voor taxonomie-generatie en meer voordelige opties zoals GPT-3.5-Turbo voor samenvattingstaken. De uiteindelijke classificatie wordt uitgevoerd door een efficiënt logistisch regressiemodel, wat de operationele kosten verder verlaagt.
Het iteratieve genereren van taxonomieën binnen TNT-LLM zorgt voor continue verfijning, met als resultaat hoogwaardige, relevante en nauwkeurige categorisaties die zijn afgestemd op specifieke datasets en usecases.
Hoewel ruimte blijft voor menselijke review en aanpassingen, vergt TNT-LLM aanzienlijk minder handwerk dan traditionele methoden. Dit verkleint de kans op vooringenomenheid en inconsistenties bij het maken van taxonomieën.
TNT-LLM past zich goed aan uiteenlopende tekstclassificatietaken en domeinen aan, en biedt flexibiliteit in de toepassing. Het modulaire ontwerp ondersteunt integratie met verschillende LLM’s, embedding-methoden en classifiers naar behoefte.
Kortom, TNT-LLM biedt een robuuste oplossing voor organisaties die met grote hoeveelheden ongestructureerde tekstdata werken.
Laten we stap voor stap door het implementatieproces lopen.
Om te starten met TNT-LLM-implementaties, installeer je de benodigde pakketten. Dat kan met het volgende pip-commando:
pip install langgraph langchain langchain_openaiStel daarnaast je omgevingsvariabelen in voor API-sleutels en modelnamen:
export AZURE_OPENAI_API_KEY='your_api_key_here' export AZURE_OPENAI_MODEL='your_deployment_name_here' export AZURE_OPENAI_ENDPOINT='deployment_endpoint'Binnen de context van TNT-LLM is het belangrijk om enkele fundamentele concepten te begrijpen om de mogelijkheden effectief te benutten.
Documenten in TNT-LLM zijn ruwe tekstdata, zoals chatlogs of artikelen, die verwerkt moeten worden. Dit zijn de primaire input voor de TNT-LLM-pijplijn. Elk document is gestructureerd met de klasse Doc, met velden zoals id, content en optionele attributen zoals summary, explanation en category.
Taxonomieën zijn clusters van gecategoriseerde intenties of onderwerpen. Ze ordenen de data in betekenisvolle categorieën, essentieel voor taken als intentieherkenning en topicclassificatie. De klasse TaxonomyGenerationState definieert de toestandsstructuur voor het genereren van taxonomieën. Deze klasse omvat ruwe documenten, minibatch-indexen en clusters van kandidaat-taxonomieën.
Inzicht in de basis van TNT-LLM is cruciaal om de mogelijkheden effectief te implementeren. De taxonomie-generatie omvat de volgende kernstappen:
Allereerst definiëren we de graf-toestandklasse TaxonomyGenerationState, die de stateful aspecten van het genereren en evolueren van de taxonomie beheert tijdens de uitvoering van de graf. De klasse Doc definieert de structuur voor afzonderlijke documenten binnen de graf.
import operator
from typing import Annotated, List, TypedDict, Optional
class Doc(TypedDict):
    id: str
    content: str
    summary: Optional[str]
    explanation: Optional[str]
    category: Optional[str]
class TaxonomyGenerationState(TypedDict):
    # The raw docs; we inject summaries within them in the first step
    documents: List[Doc]
    # Indices to be concise
    minibatches: List[List[int]]
    # Candidate Taxonomies (full trajectory)
    clusters: Annotated[List[List[dict]], operator.add]
Voordat we de taxonomie-generatie starten, laden we de datasets met ruwe tekstdata, zoals nieuwsartikelen of chatlogs. Deze datasets vormen de primaire input voor TNT-LLM. Hier laden we nieuwsartikelen van Hugging Face.
import pandas as pd
from datasets import load_dataset
# Load the dataset
dataset = load_dataset("okite97/news-data")
# Access the different splits if available (e.g., train, test, validation)
train_data = dataset['train']
df = pd.DataFrame(train_data)
df = df.dropna()
df.reset_index(drop=True, inplace=True)
def run_to_doc(df: pd.DataFrame) -> Doc:
    all_data = []
    for i in range(len(df)):
        d = df.iloc[i]
        all_data.append({
            "id": i,
            "content": d['Title'] + "\\n\\n" + d['Excerpt']
        })

    return all_data
# Only clustering 100 documents
docs = run_to_doc(df[:100])
print(docs[0])
{'id': 0,
'content': 'Uefa Opens Proceedings against Barcelona, Juventus and Real Madrid Over European Super League Plan\\n\\nUefa has opened disciplinary proceedings against Barcelona, Juventus and Real Madrid over their involvement in the proposed European Super League.'}Tot slot initialiseren we een Azure-gebaseerd OpenAI GPT-4o-model als ons language model (LLM) voor alle componenten van TNT-LLM. In de praktijk kun je voor elke component een ander LLM initialiseren, maar wij vereenvoudigen dit door één model voor alle taken te gebruiken.
import os
from langchain_openai import AzureChatOpenAI
model = AzureChatOpenAI(
    openai_api_version="2023-06-01-preview"
    azure_deployment="gpt-4o-2024-05-13",
    temperature=0.0
)Zodra de datasets zijn geladen, wordt elk document samengevat. Hierbij gebruiken we language models om beknopte samenvattingen te genereren die de hoofdpunten van elk document vangen. De samenvattingen zijn cruciaal omdat ze lange teksten terugbrengen tot kortere, hanteerbare vormen met behoud van essentiële informatie.
De meegeleverde code initialiseert een LLM-prompt voor het samenvatten van documenten met TNT-LLM, parseert XML-uitvoer om samenvattingen en toelichtingen te extraheren, zet een pijplijn op om documentinhoud te mappen, verwerkt deze in batches voor samenvattingsgeneratie en integreert de samenvattingen terug in de oorspronkelijke documentstructuur via map- en reduce-stappen.
import re
import random
from langchain import hub
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnableConfig, RunnableLambda, RunnablePassthrough
summary_prompt = hub.pull("wfh/tnt-llm-summary-generation").partial(
    summary_length=20, explanation_length=30
)
def parse_summary(xml_string: str) -> dict:
    summary_pattern = r"<summary>(.*?)</summary>"
    explanation_pattern = r"<explanation>(.*?)</explanation>"
    summary_match = re.search(summary_pattern, xml_string, re.DOTALL)
    explanation_match = re.search(explanation_pattern, xml_string, re.DOTALL)
    summary = summary_match.group(1).strip() if summary_match else ""
    explanation = explanation_match.group(1).strip() if explanation_match else ""
    return {"summary": summary, "explanation": explanation}
summary_llm_chain = (
    summary_prompt | model | StrOutputParser()
).with_config(run_name="GenerateSummary")
summary_chain = summary_llm_chain | parse_summary
# Input: state
# Output: state and summaries
# Processes docs in parallel
def get_content(state: TaxonomyGenerationState):
    docs = state["documents"]
    return [{"content": doc["content"]} for doc in docs]
map_step = RunnablePassthrough.assign(
    summaries=get_content
    | RunnableLambda(func=summary_chain.batch, afunc=summary_chain.abatch)
)
def reduce_summaries(combined: dict) -> TaxonomyGenerationState:
    summaries = combined["summaries"]
    documents = combined["documents"]
    return {
        "documents": [
            {
                "id": doc["id"],
                "content": doc["content"],
                "summary": summ_info["summary"],
                "explanation": summ_info["explanation"],
            }
            for doc, summ_info in zip(documents, summaries)
        ]
    }
# This is the summary node
map_reduce_chain = map_step | reduce_summariesNa het samenvatten worden de documenten georganiseerd in minibatches. Minibatching helpt om grote hoeveelheden data efficiënter te verwerken. Door de dataset op te delen in kleinere batches kan TNT-LLM berekeningen parallel uitvoeren en zo zowel tijd als rekenmiddelen optimaliseren.
def get_minibatches(state: TaxonomyGenerationState, config: RunnableConfig):
    batch_size = config["configurable"].get("batch_size", 200)
    original = state["documents"]
    indices = list(range(len(original)))
    random.shuffle(indices)
    if len(indices) < batch_size:
        # Don't pad needlessly if we can't fill a single batch
        return [indices]
    num_full_batches = len(indices) // batch_size
    batches = [
        indices[i * batch_size : (i + 1) * batch_size] for i in range(num_full_batches)
    ]
    leftovers = len(indices) % batch_size
    if leftovers:
        last_batch = indices[num_full_batches * batch_size :]
        elements_to_add = batch_size - leftovers
        last_batch += random.sample(indices, elements_to_add)
        batches.append(last_batch)
    return {
        "minibatches": batches,
}Met de eerste minibatch van samengevatte documenten start TNT-LLM het genereren van de taxonomie. Hierbij worden de in de documenten geïdentificeerde intenties of onderwerpen geclusterd. Door de inhoud van elk document te analyseren, identificeert het systeem gemeenschappelijke thema’s of categorieën, waarmee de basis van de taxonomie wordt gelegd.
De twee belangrijkste functies zijn:
invoke_taxonomy_chain() - Deze functie integreert stappen voor het genereren van taxonomieën met een LLM-gebaseerde keten (chain) die is geconfigureerd voor TNT-LLM-taken. Ze bouwt XML-datatabellen (data_table_xml) op uit documentsamenvattingen en eerdere taxonomieclusters. De functie roept de LLM-keten aan om de taxonomie bij te werken op basis van opgegeven configuratieparameters (config) en retourneert een bijgewerkte toestand met nieuwe taxonomieclusters.generate_taxonomy() - Deze functie orkestreert het genereren van taxonomieclusters. Ze roept invoke_taxonomy_chain aan met een keten die is geconfigureerd voor taxonomie-generatie (generate_taxonomy_chain) op basis van de initiële minibatch documenten (state["minibatches"][0]). Ze retourneert de bijgewerkte taxonomietoestand na de initiële generatie.from typing import Dict
from langchain_core.runnables import Runnable
def parse_taxa(output_text: str) -> Dict:
"""Extract the taxonomy from the generated output."""
cluster_pattern = r"<cluster>\\s*<id>(.*?)</id>\\s*<name>(.*?)</name>\\s*<description>(.*?)</description>\\s*</cluster>"
cluster_matches = re.findall(cluster_pattern, output_text, re.DOTALL)
clusters = [
{"id": id.strip(), "name": name.strip(), "description": description.strip()}
for id, name, description in cluster_matches
]
return {"clusters": clusters}
def format_docs(docs: List[Doc]) -> str:
xml_table = "\\n"
for doc in docs:
xml_table += f'{doc["summary"]}\\n'
xml_table += ""
return xml_table
def format_taxonomy(clusters):
xml = "\\n"
for label in clusters:
xml += " \\n"
xml += f' {label["id"]}\\n'
xml += f' {label["name"]}\\n'
xml += f' {label["description"]}\\n'
xml += " \\n"
xml += ""
return xml
def invoke_taxonomy_chain(
chain: Runnable,
state: TaxonomyGenerationState,
config: RunnableConfig,
mb_indices: List[int],
) -> TaxonomyGenerationState:
configurable = config["configurable"]
docs = state["documents"]
minibatch = [docs[idx] for idx in mb_indices]
data_table_xml = format_docs(minibatch)
previous_taxonomy = state["clusters"][-1] if state["clusters"] else []
cluster_table_xml = format_taxonomy(previous_taxonomy)
updated_taxonomy = chain.invoke(
{
"data_xml": data_table_xml,
"use_case": configurable["use_case"],
"cluster_table_xml": cluster_table_xml,
"suggestion_length": configurable.get("suggestion_length", 30),
"cluster_name_length": configurable.get("cluster_name_length", 10),
"cluster_description_length": configurable.get(
"cluster_description_length", 30
),
"explanation_length": configurable.get("explanation_length", 20),
"max_num_clusters": configurable.get("max_num_clusters", 25),
}
)
return {
"clusters": [updated_taxonomy["clusters"]],
}Laten we nu bekijken hoe het language model kan worden geïntegreerd in het proces van taxonomie-generatie:
# We will share an LLM for each step of the generate -> update -> review cycle
# You may want to consider using Opus or another more powerful model for this
taxonomy_generation_llm = model
## Initial generation
taxonomy_generation_prompt = hub.pull("wfh/tnt-llm-taxonomy-generation").partial(
    use_case="Generate the taxonomy that can be used to label the user intent in the conversation.",
)
taxa_gen_llm_chain = (
    taxonomy_generation_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="GenerateTaxonomy")
generate_taxonomy_chain = taxa_gen_llm_chain | parse_taxa
def generate_taxonomy(
    state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
    return invoke_taxonomy_chain(
        generate_taxonomy_chain, state, config, state["minibatches"][0]
)Naarmate volgende minibatches worden verwerkt, werkt TNT-LLM de taxonomie iteratief bij en verfijnt deze. Dit iteratieve proces laat de taxonomie in de tijd evolueren en verbeteren, met nieuwe inzichten en categorieën uit extra batches data. Bijgewerkte taxonomieën zorgen ervoor dat het geheel volledig blijft en het volledige datasetbereik weerspiegelt.
taxonomy_update_prompt = hub.pull("wfh/tnt-llm-taxonomy-update")
taxa_update_llm_chain = (
    taxonomy_update_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="UpdateTaxonomy")
update_taxonomy_chain = taxa_update_llm_chain | parse_taxa
def update_taxonomy(
    state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
    which_mb = len(state["clusters"]) % len(state["minibatches"])
    return invoke_taxonomy_chain(
        update_taxonomy_chain, state, config, state["minibatches"][which_mb]
)Als alle minibatches zijn verwerkt en de taxonomie is bijgewerkt, volgt de laatste stap: het reviewen van de taxonomie. Deze review is cruciaal om de nauwkeurigheid en relevantie van de labels te valideren. Zo weet je zeker dat de taxonomie de dataset op een zinvolle manier ordent en categoriseert, in lijn met de beoogde usecase zoals intentieherkenning of topicclassificatie.
taxonomy_review_prompt = hub.pull("wfh/tnt-llm-taxonomy-review")
taxa_review_llm_chain = (
    taxonomy_review_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="ReviewTaxonomy")
review_taxonomy_chain = taxa_review_llm_chain | parse_taxa
def review_taxonomy(
    state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
    batch_size = config["configurable"].get("batch_size", 200)
    original = state["documents"]
    indices = list(range(len(original)))
    random.shuffle(indices)
    return invoke_taxonomy_chain(
        review_taxonomy_chain, state, config, indices[:batch_size]
)Tot nu toe bestonden de eerste vijf stappen uit het voorbereiden van losse componenten zoals het samenvatten van documenten, het maken van minibatches, het genereren, bijwerken en reviewen van taxonomieën. Nu integreren we deze componenten tot één samenhangende TNT-LLM-pijplijn met een StateGraph-framework.
Deze graf orkestreert de sequentiële uitvoering van taken: documenten samenvatten, taxonomieën genereren uit minibatches, taxonomieën iteratief bijwerken en tot slot de taxonomie reviewen en valideren. Conditionele randen zorgen ervoor dat taxonomieën worden bijgewerkt tot alle minibatches zijn verwerkt; daarna wordt de definitieve taxonomie gereviewd en klaargemaakt voor labelingtaken.
from langgraph.graph import StateGraph
graph = StateGraph(TaxonomyGenerationState)
graph.add_node("summarize", map_reduce_chain)
graph.add_node("get_minibatches", get_minibatches)
graph.add_node("generate_taxonomy", generate_taxonomy)
graph.add_node("update_taxonomy", update_taxonomy)
graph.add_node("review_taxonomy", review_taxonomy)
graph.add_edge("summarize", "get_minibatches")
graph.add_edge("get_minibatches", "generate_taxonomy")
graph.add_edge("generate_taxonomy", "update_taxonomy")
def should_review(state: TaxonomyGenerationState) -> str:
    num_minibatches = len(state["minibatches"])
    num_revisions = len(state["clusters"])
    if num_revisions < num_minibatches:
        return "update_taxonomy"
    return "review_taxonomy"
graph.add_conditional_edges(
    "update_taxonomy",
    should_review,
    # Optional (but required for the diagram to be drawn correctly below)
    {"update_taxonomy": "update_taxonomy", "review_taxonomy": "review_taxonomy"},
)
graph.set_finish_point("review_taxonomy")
graph.set_entry_point("summarize")
app = graph.compile()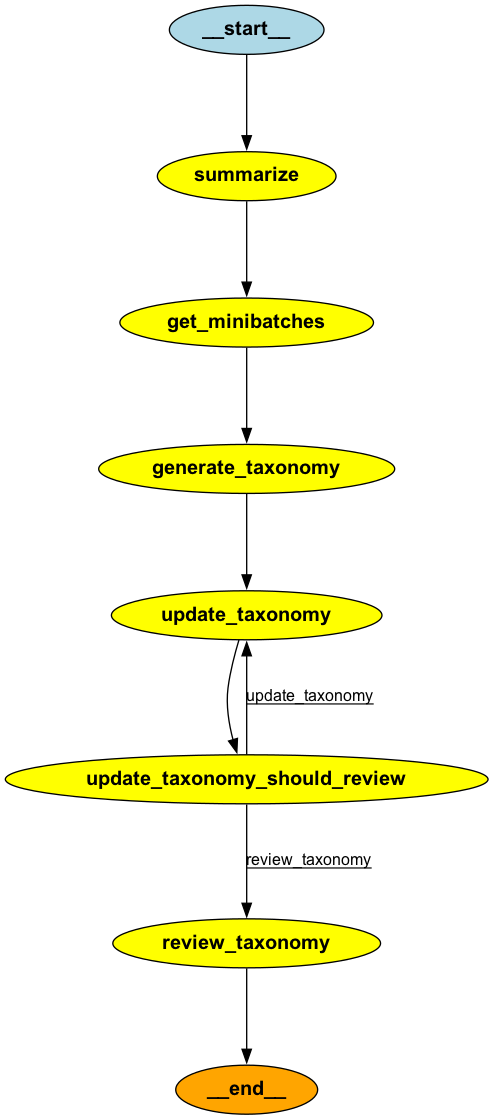
In deze laatste stap gebruiken we TNT-LLM om nieuwsartikelen te clusteren. De resulterende taxonomie wordt weergegeven in Markdown-indeling, met de namen en beschrijvingen van elke cluster.
use_case = (
    "Generate the taxonomy that can be used to label the news article that would benefit the user."
)
stream = app.stream(
    {"documents": docs},
    {
        "configurable": {
            "use_case": use_case,
            # Optional:
            "batch_size": 10,
            "suggestion_length": 30,
            "cluster_name_length": 10,
            "cluster_description_length": 30,
            "explanation_length": 20,
            "max_num_clusters": 25,
        },
        "max_concurrency": 2,
        "recursion_limit": 50,
    },
)
for step in stream:
    node, state = next(iter(step.items()))
    print(node, str(state)[:20] + " ...")
from IPython.display import Markdown
def format_taxonomy_md(clusters):
    md = "## Final Taxonomy\\n\\n"
    md += "| ID | Name | Description |\\n"
    md += "|----|------|-------------|\\n"
    # Iterate over each inner list of dictionaries
    for cluster_list in clusters:
        for label in cluster_list:
            id = label["id"]
            name = label["name"].replace("|", "\\\\|")  # Escape any pipe characters within the content
            description = label["description"].replace("|", "\\\\|")  # Escape any pipe characters
            md += f"| {id} | {name} | {description} |\\n"
    return md
markdown_table = format_taxonomy_md(step['review_taxonomy']['clusters'])
Markdown(markdown_table)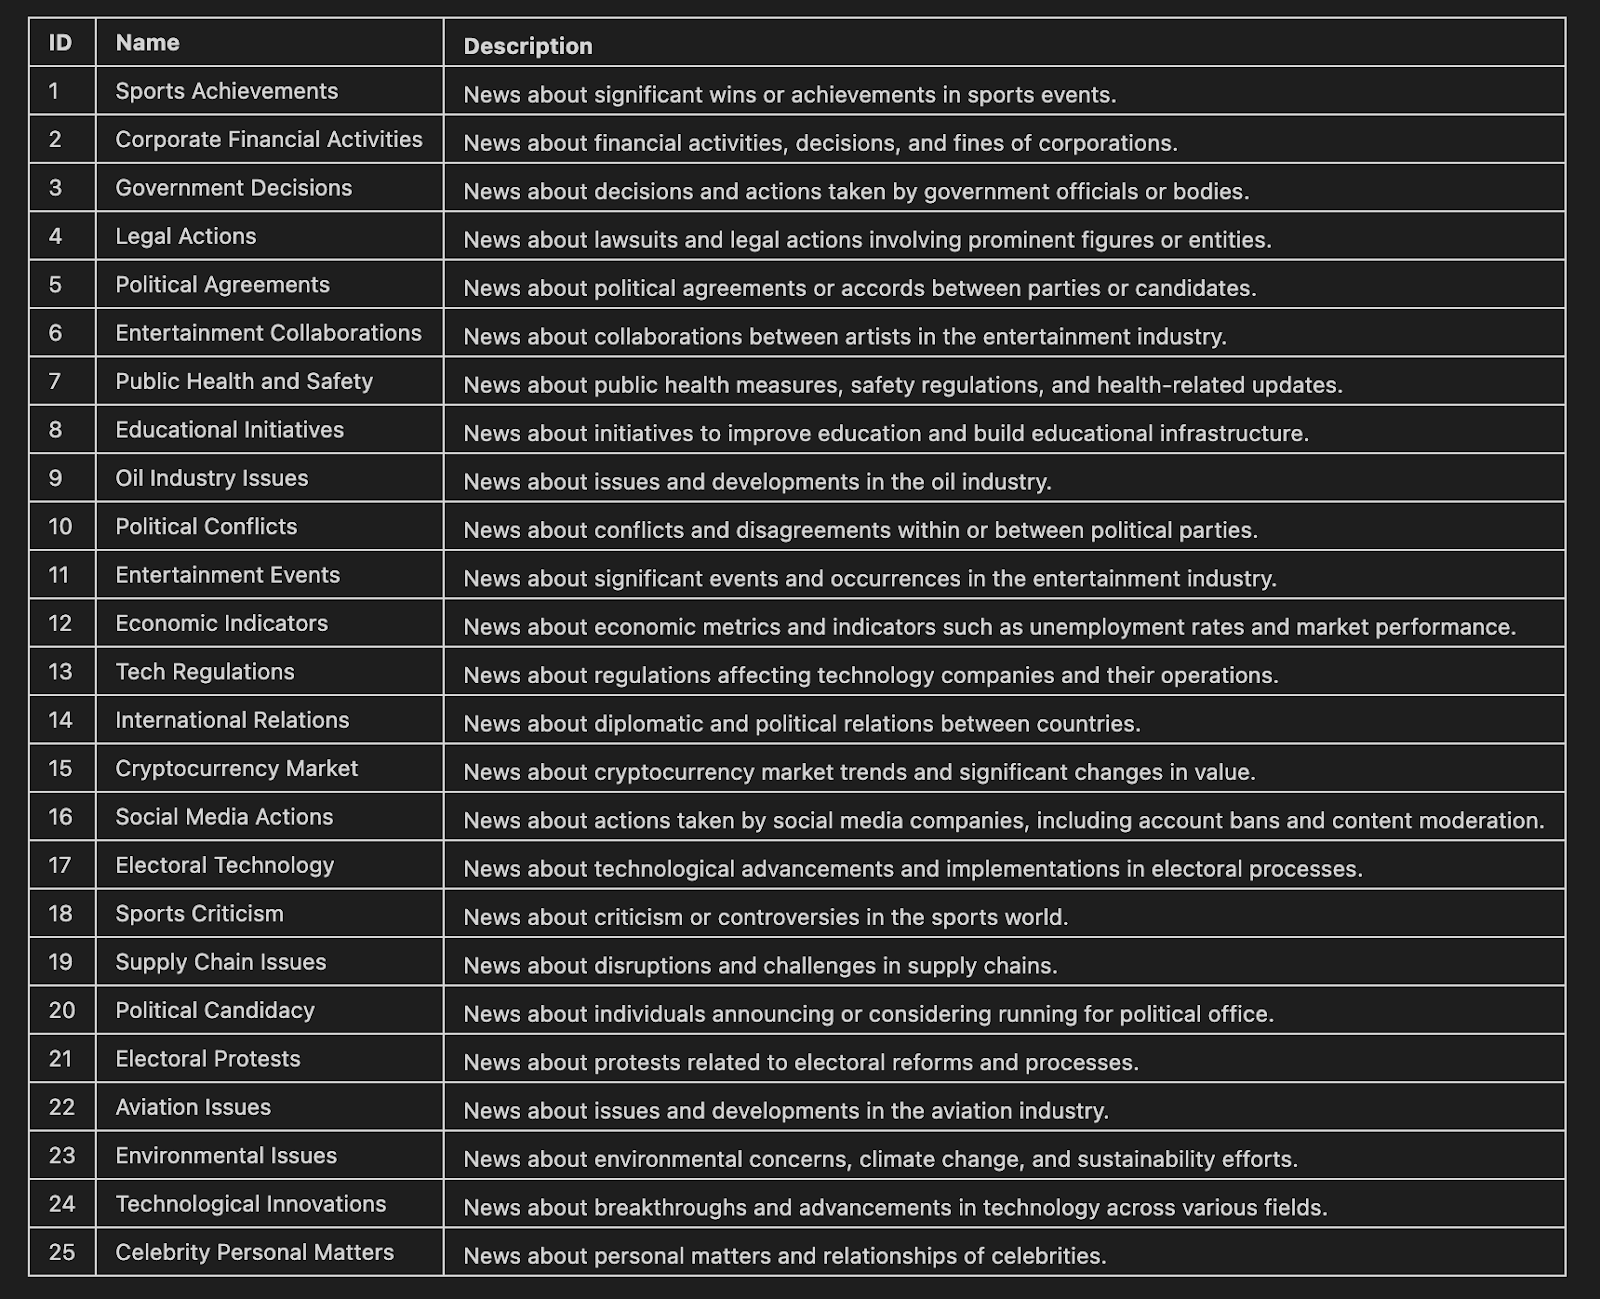
En dat is het! Door deze gestructureerde stappen te volgen, automatiseerde TNT-LLM het maken van gedetailleerde en interpreteerbare taxonomieën uit ruwe tekstdata. Deze aanpak vereenvoudigt wat traditioneel veel menselijk werk en domeinkennis vereist, en is daarmee een krachtig hulpmiddel voor grootschalige text mining en classificatie.
TNT-LLM is een belangrijke stap vooruit in text mining en classificatie en biedt een efficiënte oplossing voor het analyseren van grote hoeveelheden ongestructureerde data. Door taxonomie-generatie en schaalbare classificatie te automatiseren, verkort het de tijd en inspanning die nodig zijn om inzichten uit tekst te halen.
Naarmate TNT-LLM zich ontwikkelt, kan het de manier transformeren waarop organisaties enorme hoeveelheden tekstdata analyseren. Deze tool maakt datagedreven besluitvorming in verschillende sectoren mogelijk, waardoor inzichten uit tekst toegankelijker en impactvoller worden.
Wil je meer leren over het ontwikkelen van LLM-toepassingen? Dan raad ik deze cursus aan: Developing LLM Applications with LangChain.
Leer AI met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

