

Qu’est-ce que TNT-LLM ?
TNT-LLM (Taxonomy and Text classification using Large Language Models) est un cadre en deux phases conçu pour générer des taxonomies à partir de documents textuels et les utiliser pour la classification. Le système comporte deux grandes étapes.
Phase 1 : génération de la taxonomie
Dans la première phase, le système prend un échantillon de documents textuels et une instruction liée au cas d’usage, par exemple : « générer une taxonomie pour regrouper des articles de presse ». Un grand modèle de langage (LLM) résume chaque article pour en extraire les informations clés. Au fil d’itérations successives, le LLM génère, met à jour et affine une taxonomie à partir de ces résumés, produisant in fine un ensemble structuré d’étiquettes et de descriptions qui catégorisent efficacement les articles.
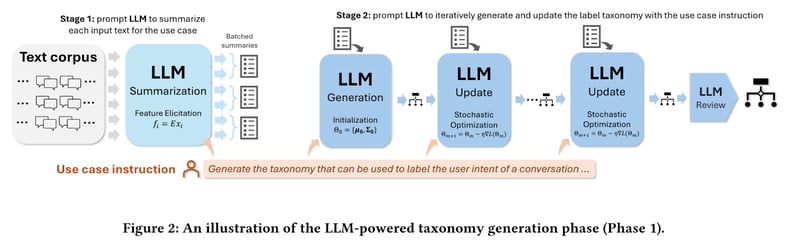
Source : Mengting Wan et al.
Phase 2 : classification de textes
La seconde phase consiste à utiliser la taxonomie générée pour étiqueter un jeu de données plus large. Le système invite un LLM à appliquer ces étiquettes, qui servent ensuite de données d’entraînement pour un classifieur léger, comme une régression logistique. Une fois entraîné, ce classifieur peut être déployé pour étiqueter efficacement l’ensemble du corpus ou effectuer une classification en temps réel.
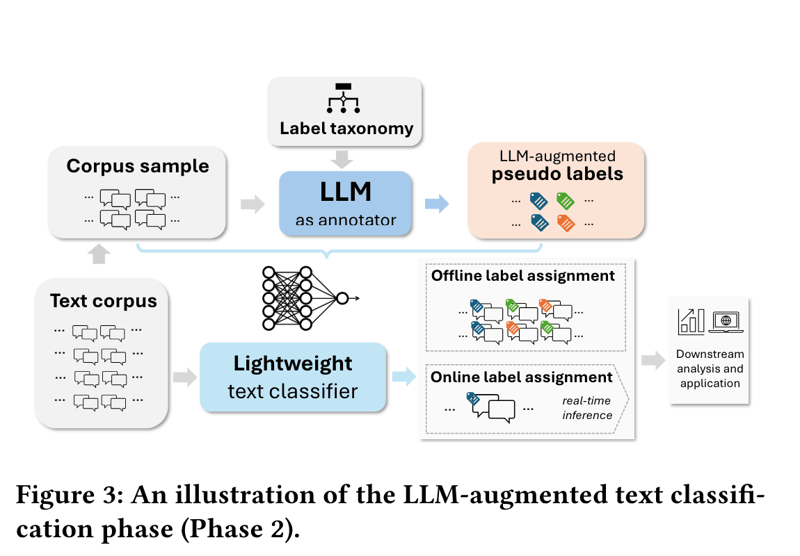
Source : Mengting Wan et al.
La flexibilité de TNT-LLM le rend adapté à diverses tâches de classification de textes, comme la détection d’intentions et la catégorisation thématique, au-delà de la simple analyse de conversations.
Les atouts de TNT-LLM
TNT-LLM s’impose comme un outil de référence pour l’exploration et la classification de textes à grande échelle, avec plusieurs avantages clés.
Génération automatisée de taxonomies
TNT-LLM simplifie la création de taxonomies détaillées et interprétables à partir de textes bruts. Il automatise un travail long et spécialisé qui nécessite souvent une expertise métier. Le système produit des taxonomies adaptées à des cas d’usage spécifiques avec un minimum d’entrées humaines, économisant un temps et des ressources considérables.
Classification à l’échelle
En s’appuyant sur les taxonomies générées, TNT-LLM permet une classification de texte à grande échelle. Il facilite la création de modèles légers capables de traiter efficacement de vastes jeux de données ou des flux en temps réel—idéal pour les applications à fort débit.
Maîtrise des coûts
TNT-LLM optimise l’usage des ressources via une stratégie de LLM par paliers. Il utilise des modèles puissants comme GPT-4 pour la génération de taxonomies et des options plus économiques comme GPT-3.5-Turbo pour les résumés. La classification finale est réalisée par une régression logistique efficace, ce qui réduit encore les coûts opérationnels.
Sorties de haute qualité
Le processus itératif de génération de taxonomie assure un affinage continu, pour des catégorisations pertinentes, précises et adaptées à chaque jeu de données et cas d’usage.
Intervention humaine minimale
Tout en permettant une relecture et des ajustements, TNT-LLM requiert beaucoup moins d’intervention manuelle que les méthodes classiques, réduisant les biais et les incohérences lors de la création de taxonomies.
Flexibilité
TNT-LLM s’adapte à de nombreux domaines et tâches de classification textuelle. Sa conception modulaire facilite l’intégration avec différents LLM, méthodes d’embeddings et classifieurs selon les besoins.
En somme, TNT-LLM offre une solution robuste pour les organisations confrontées à de grands volumes de textes non structurés.
Implémentation de TNT-LLM
Passons en revue le processus d’implémentation, étape par étape.
Installation
Pour démarrer avec TNT-LLM, installez les paquets nécessaires. Utilisez la commande pip suivante :
pip install langgraph langchain langchain_openaiDéfinissez également vos variables d’environnement pour les clés d’API et les noms de modèles :
export AZURE_OPENAI_API_KEY='your_api_key_here' export AZURE_OPENAI_MODEL='your_deployment_name_here' export AZURE_OPENAI_ENDPOINT='deployment_endpoint'Concepts de base
Dans le contexte de TNT-LLM, comprendre quelques notions fondamentales est essentiel pour en tirer pleinement parti.
Documents
Les documents dans TNT-LLM correspondent à des textes bruts, comme des conversations ou des articles, à traiter. Ce sont les entrées principales du pipeline TNT-LLM. Chaque document est structuré via la classe Doc, qui comprend des champs comme id, content, ainsi que des attributs optionnels tels que summary, explanation et category.
Taxonomies
Les taxonomies sont des regroupements d’intentions ou de thématiques. Elles organisent les données en catégories pertinentes, essentielles pour des tâches comme la reconnaissance d’intentions et la classification par sujets. La classe TaxonomyGenerationState définit l’état utilisé pour générer la taxonomie : documents bruts, index de mini-lots et clusters de taxonomies candidates.
Construire une application TNT-LLM simple
Maîtriser ces fondations est clé pour une mise en œuvre efficace de TNT-LLM. La génération de la taxonomie suit plusieurs étapes clés :
Étape 0 : définir la classe d’état du graphe, charger les jeux de données et GPT-4o
Nous définissons d’abord la classe d’état du graphe TaxonomyGenerationState, qui gère les aspects états de la génération/évolution de la taxonomie pendant l’exécution du graphe. La classe Doc décrit la structure de chaque document dans le graphe.
import operator
from typing import Annotated, List, TypedDict, Optional
class Doc(TypedDict):
id: str
content: str
summary: Optional[str]
explanation: Optional[str]
category: Optional[str]
class TaxonomyGenerationState(TypedDict):
# The raw docs; we inject summaries within them in the first step
documents: List[Doc]
# Indices to be concise
minibatches: List[List[int]]
# Candidate Taxonomies (full trajectory)
clusters: Annotated[List[List[dict]], operator.add]Avant de lancer la génération, chargeons les jeux de données textuelles (articles de presse, logs de chat, etc.). Ils servent d’entrée principale à TNT-LLM. Ici, nous chargeons des articles depuis Hugging Face.
import pandas as pd
from datasets import load_dataset
# Load the dataset
dataset = load_dataset("okite97/news-data")
# Access the different splits if available (e.g., train, test, validation)
train_data = dataset['train']
df = pd.DataFrame(train_data)
df = df.dropna()
df.reset_index(drop=True, inplace=True)
def run_to_doc(df: pd.DataFrame) -> Doc:
all_data = []
for i in range(len(df)):
d = df.iloc[i]
all_data.append({
"id": i,
"content": d['Title'] + "\\n\\n" + d['Excerpt']
})
return all_data
# Only clustering 100 documents
docs = run_to_doc(df[:100])
print(docs[0]){'id': 0,
'content': 'Uefa Opens Proceedings against Barcelona, Juventus and Real Madrid Over European Super League Plan\\n\\nUefa has opened disciplinary proceedings against Barcelona, Juventus and Real Madrid over their involvement in the proposed European Super League.'}Enfin, nous initialisons un modèle OpenAI GPT-4o via Azure pour servir de LLM à tous les composants de TNT-LLM. Même si, en pratique, on peut spécifier des LLM différents par composant, nous simplifions ici avec un seul modèle pour toutes les tâches.
import os
from langchain_openai import AzureChatOpenAI
model = AzureChatOpenAI(
openai_api_version="2023-06-01-preview"
azure_deployment="gpt-4o-2024-05-13",
temperature=0.0
)Étape 1 : résumer les documents
Une fois les données chargées, chaque document est résumé. On utilise des modèles de langage pour produire des synthèses concises qui capturent l’essentiel. Ces résumés condensent des textes longs en formats courts et exploitables, tout en préservant les informations clés.
Le code ci-dessous initialise une invite LLM pour la génération de résumés dans TNT-LLM, analyse une sortie XML pour extraire résumés et explications, met en place un pipeline pour traiter les contenus par lots, puis réinjecte ces résumés dans la structure de données d’origine via des étapes de mappage et de réduction.
import re
import random
from langchain import hub
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnableConfig, RunnableLambda, RunnablePassthrough
summary_prompt = hub.pull("wfh/tnt-llm-summary-generation").partial(
summary_length=20, explanation_length=30
)
def parse_summary(xml_string: str) -> dict:
summary_pattern = r"<summary>(.*?)</summary>"
explanation_pattern = r"<explanation>(.*?)</explanation>"
summary_match = re.search(summary_pattern, xml_string, re.DOTALL)
explanation_match = re.search(explanation_pattern, xml_string, re.DOTALL)
summary = summary_match.group(1).strip() if summary_match else ""
explanation = explanation_match.group(1).strip() if explanation_match else ""
return {"summary": summary, "explanation": explanation}
summary_llm_chain = (
summary_prompt | model | StrOutputParser()
).with_config(run_name="GenerateSummary")
summary_chain = summary_llm_chain | parse_summary
# Input: state
# Output: state and summaries
# Processes docs in parallel
def get_content(state: TaxonomyGenerationState):
docs = state["documents"]
return [{"content": doc["content"]} for doc in docs]
map_step = RunnablePassthrough.assign(
summaries=get_content
| RunnableLambda(func=summary_chain.batch, afunc=summary_chain.abatch)
)
def reduce_summaries(combined: dict) -> TaxonomyGenerationState:
summaries = combined["summaries"]
documents = combined["documents"]
return {
"documents": [
{
"id": doc["id"],
"content": doc["content"],
"summary": summ_info["summary"],
"explanation": summ_info["explanation"],
}
for doc, summ_info in zip(documents, summaries)
]
}
# This is the summary node
map_reduce_chain = map_step | reduce_summariesÉtape 2 : créer des mini-lots
Après la synthèse, on organise les documents résumés en mini-lots (minibatches). Cela facilite le traitement de gros volumes en parallèle, en optimisant à la fois le temps et les ressources de calcul.
def get_minibatches(state: TaxonomyGenerationState, config: RunnableConfig):
batch_size = config["configurable"].get("batch_size", 200)
original = state["documents"]
indices = list(range(len(original)))
random.shuffle(indices)
if len(indices) < batch_size:
# Don't pad needlessly if we can't fill a single batch
return [indices]
num_full_batches = len(indices) // batch_size
batches = [
indices[i * batch_size : (i + 1) * batch_size] for i in range(num_full_batches)
]
leftovers = len(indices) % batch_size
if leftovers:
last_batch = indices[num_full_batches * batch_size :]
elements_to_add = batch_size - leftovers
last_batch += random.sample(indices, elements_to_add)
batches.append(last_batch)
return {
"minibatches": batches,
}Étape 3 : générer la taxonomie initiale
En s’appuyant sur le premier mini-lot résumé, TNT-LLM démarre la génération de taxonomie. L’idée est d’identifier et de regrouper les intentions ou thèmes présents dans les documents, pour poser les bases de la taxonomie.
Deux fonctions principales interviennent :
invoke_taxonomy_chain()– intègre les étapes de génération de taxonomie via une chaîne basée sur LLM (chain). Elle construit des tableaux de données XML (data_table_xml) à partir des résumés et des clusters précédents, appelle la chaîne LLM pour mettre à jour la taxonomie selon la configuration (config) et renvoie un état actualisé avec les nouveaux clusters.generate_taxonomy()– orchestre la génération des clusters de taxonomie. Elle appelleinvoke_taxonomy_chainavec une chaîne configurée pour la génération (generate_taxonomy_chain) en utilisant le premier mini-lot (state["minibatches"][0]) et renvoie l’état mis à jour.
from typing import Dict
from langchain_core.runnables import Runnable
def parse_taxa(output_text: str) -> Dict:
"""Extract the taxonomy from the generated output."""
cluster_pattern = r"<cluster>\\s*<id>(.*?)</id>\\s*<name>(.*?)</name>\\s*<description>(.*?)</description>\\s*</cluster>"
cluster_matches = re.findall(cluster_pattern, output_text, re.DOTALL)
clusters = [
{"id": id.strip(), "name": name.strip(), "description": description.strip()}
for id, name, description in cluster_matches
]
return {"clusters": clusters}
def format_docs(docs: List[Doc]) -> str:
xml_table = "\\n"
for doc in docs:
xml_table += f'{doc["summary"]}\\n'
xml_table += ""
return xml_table
def format_taxonomy(clusters):
xml = "\\n"
for label in clusters:
xml += " \\n"
xml += f' {label["id"]}\\n'
xml += f' {label["name"]}\\n'
xml += f' {label["description"]}\\n'
xml += " \\n"
xml += ""
return xml
def invoke_taxonomy_chain(
chain: Runnable,
state: TaxonomyGenerationState,
config: RunnableConfig,
mb_indices: List[int],
) -> TaxonomyGenerationState:
configurable = config["configurable"]
docs = state["documents"]
minibatch = [docs[idx] for idx in mb_indices]
data_table_xml = format_docs(minibatch)
previous_taxonomy = state["clusters"][-1] if state["clusters"] else []
cluster_table_xml = format_taxonomy(previous_taxonomy)
updated_taxonomy = chain.invoke(
{
"data_xml": data_table_xml,
"use_case": configurable["use_case"],
"cluster_table_xml": cluster_table_xml,
"suggestion_length": configurable.get("suggestion_length", 30),
"cluster_name_length": configurable.get("cluster_name_length", 10),
"cluster_description_length": configurable.get(
"cluster_description_length", 30
),
"explanation_length": configurable.get("explanation_length", 20),
"max_num_clusters": configurable.get("max_num_clusters", 25),
}
)
return {
"clusters": [updated_taxonomy["clusters"]],
}Voyons maintenant comment intégrer le modèle de langage dans la génération de taxonomie :
# We will share an LLM for each step of the generate -> update -> review cycle
# You may want to consider using Opus or another more powerful model for this
taxonomy_generation_llm = model
## Initial generation
taxonomy_generation_prompt = hub.pull("wfh/tnt-llm-taxonomy-generation").partial(
use_case="Generate the taxonomy that can be used to label the user intent in the conversation.",
)
taxa_gen_llm_chain = (
taxonomy_generation_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="GenerateTaxonomy")
generate_taxonomy_chain = taxa_gen_llm_chain | parse_taxa
def generate_taxonomy(
state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
return invoke_taxonomy_chain(
generate_taxonomy_chain, state, config, state["minibatches"][0]
)Étape 4 : mettre à jour la taxonomie
Au fil du traitement des mini-lots suivants, TNT-LLM met à jour et affine la taxonomie de manière itérative. Cette évolution intègre les nouveaux enseignements et catégories découverts, pour une taxonomie complète et représentative de l’ensemble des données.
taxonomy_update_prompt = hub.pull("wfh/tnt-llm-taxonomy-update")
taxa_update_llm_chain = (
taxonomy_update_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="UpdateTaxonomy")
update_taxonomy_chain = taxa_update_llm_chain | parse_taxa
def update_taxonomy(
state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
which_mb = len(state["clusters"]) % len(state["minibatches"])
return invoke_taxonomy_chain(
update_taxonomy_chain, state, config, state["minibatches"][which_mb]
)Étape 5 : revoir la taxonomie
Une fois tous les mini-lots traités et la taxonomie mise à jour, on procède à une revue finale pour valider la pertinence et l’exactitude des étiquettes. L’objectif est de s’assurer que la taxonomie organise et catégorise les données de manière utile, en phase avec le cas d’usage visé (reconnaissance d’intention, classification thématique, etc.).
taxonomy_review_prompt = hub.pull("wfh/tnt-llm-taxonomy-review")
taxa_review_llm_chain = (
taxonomy_review_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="ReviewTaxonomy")
review_taxonomy_chain = taxa_review_llm_chain | parse_taxa
def review_taxonomy(
state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
batch_size = config["configurable"].get("batch_size", 200)
original = state["documents"]
indices = list(range(len(original)))
random.shuffle(indices)
return invoke_taxonomy_chain(
review_taxonomy_chain, state, config, indices[:batch_size]
)Étape 6 : orchestrer le pipeline TNT-LLM avec StateGraph
Jusqu’ici, nous avons préparé les briques : résumés, mini-lots, génération, mise à jour et revue de la taxonomie. Intégrons-les désormais dans un pipeline cohérent TNT-LLM à l’aide de StateGraph.
Ce graphe orchestre l’exécution séquentielle des tâches : résumer, générer la taxonomie à partir des mini-lots, l’actualiser de façon itérative, puis la passer en revue. Des arêtes conditionnelles garantissent que les mises à jour se poursuivent jusqu’à l’épuisement des mini-lots, avant la revue finale en vue des étiquetages.
from langgraph.graph import StateGraph
graph = StateGraph(TaxonomyGenerationState)
graph.add_node("summarize", map_reduce_chain)
graph.add_node("get_minibatches", get_minibatches)
graph.add_node("generate_taxonomy", generate_taxonomy)
graph.add_node("update_taxonomy", update_taxonomy)
graph.add_node("review_taxonomy", review_taxonomy)
graph.add_edge("summarize", "get_minibatches")
graph.add_edge("get_minibatches", "generate_taxonomy")
graph.add_edge("generate_taxonomy", "update_taxonomy")
def should_review(state: TaxonomyGenerationState) -> str:
num_minibatches = len(state["minibatches"])
num_revisions = len(state["clusters"])
if num_revisions < num_minibatches:
return "update_taxonomy"
return "review_taxonomy"
graph.add_conditional_edges(
"update_taxonomy",
should_review,
# Optional (but required for the diagram to be drawn correctly below)
{"update_taxonomy": "update_taxonomy", "review_taxonomy": "review_taxonomy"},
)
graph.set_finish_point("review_taxonomy")
graph.set_entry_point("summarize")
app = graph.compile()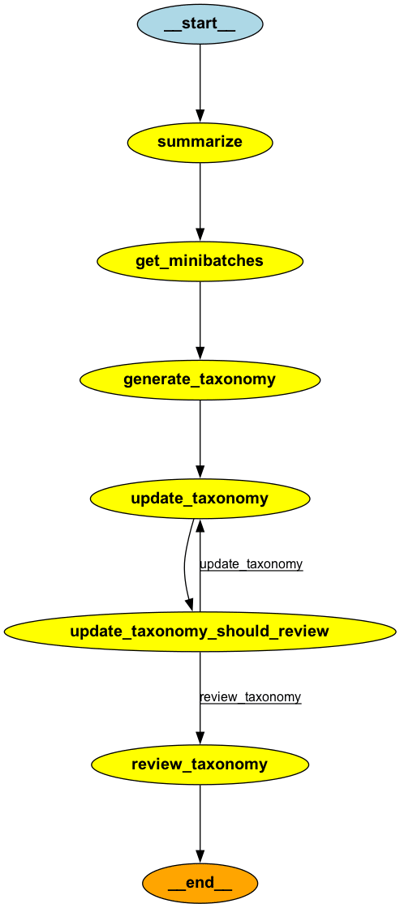
Étape 7 : regrouper et afficher la taxonomie d’articles de presse générée par TNT-LLM
Dans cette dernière étape, nous utilisons TNT-LLM pour regrouper des articles. La taxonomie résultante est affichée en Markdown, avec le nom et la description de chaque cluster.
use_case = (
"Generate the taxonomy that can be used to label the news article that would benefit the user."
)
stream = app.stream(
{"documents": docs},
{
"configurable": {
"use_case": use_case,
# Optional:
"batch_size": 10,
"suggestion_length": 30,
"cluster_name_length": 10,
"cluster_description_length": 30,
"explanation_length": 20,
"max_num_clusters": 25,
},
"max_concurrency": 2,
"recursion_limit": 50,
},
)
for step in stream:
node, state = next(iter(step.items()))
print(node, str(state)[:20] + " ...")
from IPython.display import Markdown
def format_taxonomy_md(clusters):
md = "## Final Taxonomy\\n\\n"
md += "| ID | Name | Description |\\n"
md += "|----|------|-------------|\\n"
# Iterate over each inner list of dictionaries
for cluster_list in clusters:
for label in cluster_list:
id = label["id"]
name = label["name"].replace("|", "\\\\|") # Escape any pipe characters within the content
description = label["description"].replace("|", "\\\\|") # Escape any pipe characters
md += f"| {id} | {name} | {description} |\\n"
return md
markdown_table = format_taxonomy_md(step['review_taxonomy']['clusters'])
Markdown(markdown_table)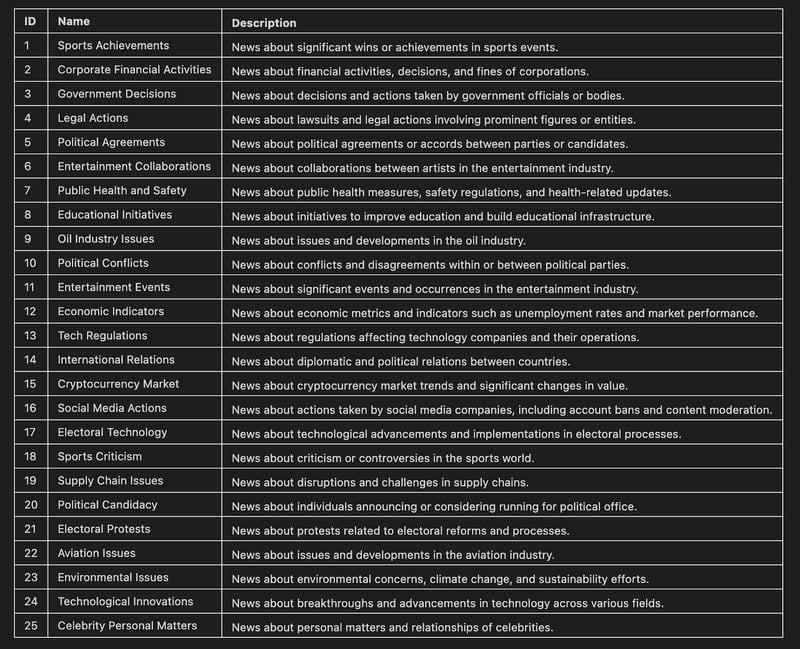
Voilà ! En suivant ces étapes structurées, TNT-LLM automatise la création de taxonomies détaillées et interprétables à partir de textes bruts. Cette démarche simplifie un travail historiquement lourd et très spécialisé, et s’avère redoutablement efficace pour l’exploration et la classification de textes à grande échelle.
Conclusion
TNT-LLM marque une avancée majeure pour l’exploration et la classification de textes, en offrant une solution efficace pour analyser de grands volumes de données non structurées. En automatisant la génération de taxonomies et la classification à l’échelle, il réduit le temps et l’effort nécessaires pour dégager des insights.
Au fur et à mesure que TNT-LLM évolue, il pourrait transformer la façon dont les organisations analysent des masses de textes. Cet outil favorise des décisions basées sur les données dans tous les secteurs, en rendant les connaissances issues du texte plus accessibles et plus impactantes.
Pour aller plus loin dans le développement d’applications LLM, je vous recommande ce cours : Developing LLM Applications with LangChain.

Ryan est un data scientist de premier plan spécialisé dans la création d'applications d'IA utilisant des LLM. Il est candidat au doctorat en traitement du langage naturel et graphes de connaissances à l'Imperial College de Londres, où il a également obtenu une maîtrise en informatique. En dehors de la science des données, il rédige une lettre d'information hebdomadaire Substack, The Limitless Playbook, dans laquelle il partage une idée exploitable provenant des plus grands penseurs du monde et écrit occasionnellement sur les concepts fondamentaux de l'IA.






Microsoft a présenté TNT-LLM, un système puissant conçu pour automatiser la génération de taxonomies et la classification de textes, plus efficace et plus précis que les approches traditionnelles.
TNT-LLM exploite la puissance des grands modèles de langage (LLM) pour automatiser et faire évoluer la création de taxonomies et de classifieurs avec un minimum d'intervention humaine. C'est particulièrement utile pour des applications comme Bing Copilot, où la gestion de domaines textuels variés et changeants est cruciale.
Dans cet article, je vous guide pas à pas pour implémenter TNT-LLM avec GPT-4o et LangGraph afin de regrouper des articles de presse de manière efficace.
Pour en savoir plus sur GPT-4o ou LangGraph, je vous recommande ces articles :
Pour approfondir TNT-LLM, référez-vous à l’article original TnT-LLM: Text Mining at Scale with Large Language Models.