

TNT-LLM क्या है?
TNT-LLM (Taxonomy and Text classification using Large Language Models) एक दो-चरणीय फ़्रेमवर्क है, जिसे पाठ दस्तावेज़ों से टैक्सोनॉमी जनरेट करने और उन्हें वर्गीकृत करने के लिए विकसित किया गया है। इस सिस्टम में दो मुख्य चरण होते हैं।
चरण 1: टैक्सोनॉमी जेनरेशन
पहले चरण में, सिस्टम टेक्स्ट दस्तावेज़ों का एक नमूना और एक विशिष्ट उपयोग-प्रकरण निर्देश लेता है, जैसे "समाचार लेखों को क्लस्टर करने के लिए एक टैक्सोनॉमी बनाएँ।" यह प्रत्येक लेख का सार निकालने के लिए बड़े भाषा मॉडल (LLM) का उपयोग करता है। एक आवर्ती प्रक्रिया के माध्यम से, LLM इन सारांशों के आधार पर टैक्सोनॉमी को जनरेट, अपडेट और परिष्कृत करता है, और अंततः ऐसे लेबल और विवरणों का संरचित सेट तैयार करता है जो समाचार लेखों का प्रभावी वर्गीकरण करें।
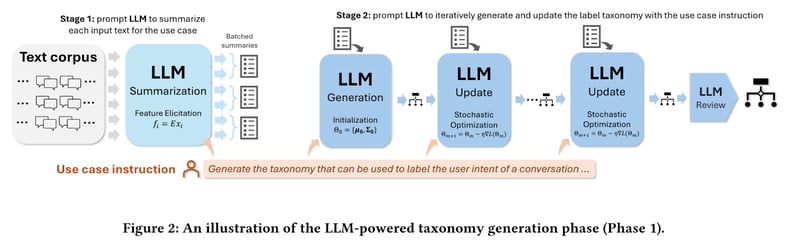
स्रोत: Mengting Wan और सहयोगी
चरण 2: टेक्स्ट क्लासिफिकेशन
दूसरे चरण में जनरेट की गई टैक्सोनॉमी का उपयोग बड़े डेटासेट को लेबल करने के लिए किया जाता है। सिस्टम एक LLM को इन लेबलों को लागू करने के लिए प्रेरित करता है, जो बाद में एक हल्के क्लासिफायर (जैसे लॉजिस्टिक रिग्रेशन) के प्रशिक्षण डेटा के रूप में काम करते हैं। प्रशिक्षित होने के बाद, यह क्लासिफायर पूरे कॉर्पस को कुशलतापूर्वक लेबल कर सकता है या रियल-टाइम क्लासिफिकेशन कर सकता है।
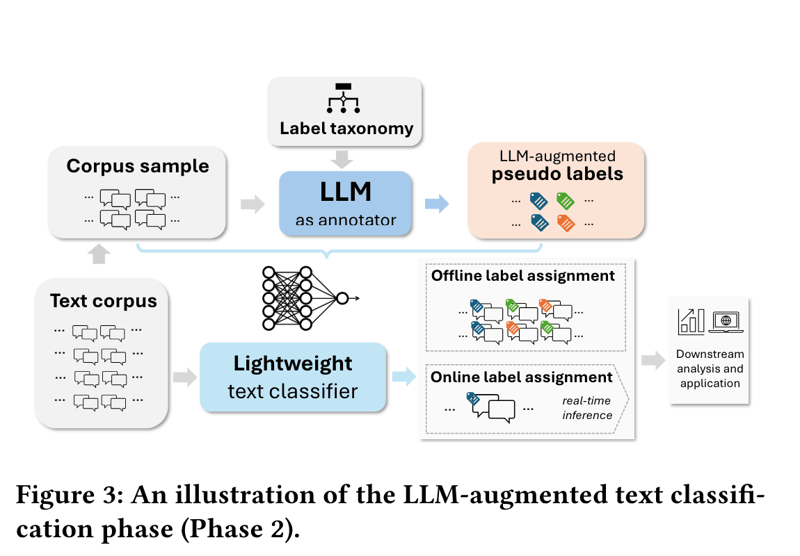
स्रोत: Mengting Wan और सहयोगी
TNT-LLM की लचीलापन इसे इंटेंट डिटेक्शन और टॉपिक कैटेगराइज़ेशन सहित विभिन्न टेक्स्ट क्लासिफिकेशन कार्यों में लागू योग्य बनाता है, जिससे इसकी उपयोगिता केवल संवाद विश्लेषण से आगे बढ़ती है।
TNT-LLM के लाभ
TNT-LLM बड़े पैमाने पर टेक्स्ट माइनिंग और क्लासिफिकेशन के लिए एक शक्तिशाली उपकरण के रूप में उभरता है और कई प्रमुख फायदे प्रदान करता है।
स्वचालित टैक्सोनॉमी जेनरेशन
TNT-LLM कच्चे पाठ्य डेटा से विस्तृत और व्याख्यायोग्य टैक्सोनॉमी बनाना सरल बनाता है। इस प्रक्रिया ने एक श्रम-सघन कार्य को स्वचालित कर दिया है, जिसके लिए अक्सर डोमेन विशेषज्ञता की आवश्यकता होती है। सिस्टम न्यूनतम मानवीय इनपुट के साथ विशिष्ट उपयोग-प्रकरणों के लिए अनुकूलित टैक्सोनॉमी जेनरेट करता है, जिससे समय और संसाधनों की बचत होती है।
स्केलेबल क्लासिफिकेशन
जनरेट की गई टैक्सोनॉमी का उपयोग करके, TNT-LLM स्केलेबल टेक्स्ट क्लासिफिकेशन सक्षम करता है। यह हल्के मॉडल बनाने में सहायक है जो बड़े डेटासेट या रियल-टाइम कार्यों को कुशलतापूर्वक संभाल सकते हैं, जिससे यह उच्च थ्रूपुट आवश्यकताओं वाले अनुप्रयोगों के लिए आदर्श बनता है।
लागत-प्रभावी दृष्टिकोण
TNT-LLM स्तरित LLM उपयोग का लाभ उठाकर संसाधनों का इष्टतम उपयोग करता है। यह टैक्सोनॉमी जेनरेशन के लिए GPT-4 जैसे शक्तिशाली मॉडलों का उपयोग करता है और सार-संक्षेपण कार्यों के लिए GPT-3.5-Turbo जैसे अधिक किफायती विकल्प अपनाता है। अंतिम क्लासिफिकेशन एक कुशल लॉजिस्टिक रिग्रेशन मॉडल द्वारा किया जाता है, जिससे परिचालन लागत और घटती है।
उच्च-गुणवत्ता वाले परिणाम
TNT-LLM की आवर्ती टैक्सोनॉमी जेनरेशन प्रक्रिया लगातार परिष्कार सुनिश्चित करती है, जिसके परिणामस्वरूप विशिष्ट डेटासेट और उपयोग-प्रकरणों के अनुरूप उच्च-गुणवत्ता, प्रासंगिक और सटीक वर्गीकरण मिलते हैं।
न्यूनतम मानवीय हस्तक्षेप
हालाँकि यह मानवीय समीक्षा और समायोजन की अनुमति देता है, TNT-LLM पारंपरिक तरीकों की तुलना में न्यूनतम मैनुअल इनपुट की आवश्यकता रखता है। इससे टैक्सोनॉमी निर्माण में संभावित पक्षपात और असंगतियाँ कम होती हैं।
लचीलापन
TNT-LLM विभिन्न टेक्स्ट क्लासिफिकेशन कार्यों और डोमेनों के अनुरूप अच्छी तरह अनुकूलित होता है, जिससे अनुप्रयोग में बहुमुखी प्रतिभा मिलती है। इसका मॉड्यूलर डिज़ाइन आवश्यकता अनुसार विभिन्न LLMs, एम्बेडिंग तरीकों, और क्लासिफायर के साथ एकीकरण का समर्थन करता है।
समग्र रूप से, TNT-LLM उन संगठनों के लिए एक सशक्त समाधान प्रदान करता है जो बड़ी मात्रा में असंरचित पाठ डेटा से निपटते हैं।
TNT-LLM का इम्प्लिमेंटेशन
आइए चरण-दर-चरण इम्प्लिमेंटेशन प्रक्रिया से गुजरते हैं।
इंस्टॉलेशन
TNT-LLM इम्प्लिमेंटेशन शुरू करने के लिए, आपको आवश्यक पैकेज इंस्टॉल करने होंगे। आप निम्न pip कमांड का उपयोग कर सकते हैं:
pip install langgraph langchain langchain_openaiइसके अतिरिक्त, अपने API कीज़ और मॉडल नामों के लिए एन्वायरनमेंट वेरिएबल्स सेट करें:
export AZURE_OPENAI_API_KEY='your_api_key_here' export AZURE_OPENAI_MODEL='your_deployment_name_here' export AZURE_OPENAI_ENDPOINT='deployment_endpoint'मूलभूत अवधारणाएँ
TNT-LLM के संदर्भ में, इसकी क्षमताओं का प्रभावी ढंग से उपयोग करने के लिए कुछ बुनियादी अवधारणाओं को समझना महत्वपूर्ण है।
दस्तावेज़
TNT-LLM में दस्तावेज़ उन कच्चे पाठ्य डेटा को संदर्भित करते हैं, जैसे चैट लॉग या लेख, जिन्हें प्रोसेस करने की आवश्यकता होती है। ये TNT-LLM पाइपलाइन के प्राथमिक इनपुट हैं। प्रत्येक दस्तावेज़ को Doc क्लास का उपयोग करके स्ट्रक्चर किया जाता है, जिसमें id, content, और वैकल्पिक एट्रीब्यूट्स जैसे summary, explanation, और category जैसे फ़ील्ड शामिल होते हैं।
टैक्सोनॉमी
टैक्सोनॉमी वर्गीकृत इंटेंट्स या विषयों के समूह होते हैं। वे डेटा को सार्थक श्रेणियों में व्यवस्थित करते हैं, जो इंटेंट पहचान और टॉपिक क्लासिफिकेशन जैसे कार्यों के लिए आवश्यक है। TaxonomyGenerationState क्लास टैक्सोनॉमी जेनरेशन के लिए स्टेट स्ट्रक्चर को परिभाषित करती है। इस क्लास में रॉ दस्तावेज़, मिनीबैच इंडेक्स और उम्मीदवार टैक्सोनॉमी के क्लस्टर शामिल होते हैं।
एक सरल TNT-LLM एप्लिकेशन बनाना
TNT-LLM के बुनियादी पहलुओं को समझना इसकी क्षमताओं को प्रभावी ढंग से लागू करने के लिए महत्वपूर्ण है। TNT-LLM के साथ शुरुआत करने के लिए, टैक्सोनॉमी जेनरेशन प्रक्रिया में कई प्रमुख चरण शामिल हैं:
चरण 0: ग्राफ स्टेट क्लास परिभाषित करें, डेटासेट लोड करें और GPT-4o सेट करें
सबसे पहले, हमें ग्राफ स्टेट क्लास TaxonomyGenerationState परिभाषित करनी होगी, जो ग्राफ के निष्पादन के दौरान टैक्सोनॉमी जेनरेशन और विकास के स्टेटफुल पहलुओं का प्रबंधन करती है। Doc क्लास ग्राफ के भीतर व्यक्तिगत दस्तावेज़ों की संरचना निर्धारित करती है।
import operator
from typing import Annotated, List, TypedDict, Optional
class Doc(TypedDict):
id: str
content: str
summary: Optional[str]
explanation: Optional[str]
category: Optional[str]
class TaxonomyGenerationState(TypedDict):
# The raw docs; we inject summaries within them in the first step
documents: List[Doc]
# Indices to be concise
minibatches: List[List[int]]
# Candidate Taxonomies (full trajectory)
clusters: Annotated[List[List[dict]], operator.add]टैक्सोनॉमी जेनरेशन शुरू करने से पहले, हमें कच्चे टेक्स्ट डेटा, जैसे समाचार लेख या चैट लॉग, वाले डेटासेट लोड करने होंगे। ये डेटासेट TNT-LLM के प्राथमिक इनपुट के रूप में काम करते हैं। यहाँ, हम Hugging Face से समाचार लेख लोड कर रहे हैं।
import pandas as pd
from datasets import load_dataset
# Load the dataset
dataset = load_dataset("okite97/news-data")
# Access the different splits if available (e.g., train, test, validation)
train_data = dataset['train']
df = pd.DataFrame(train_data)
df = df.dropna()
df.reset_index(drop=True, inplace=True)
def run_to_doc(df: pd.DataFrame) -> Doc:
all_data = []
for i in range(len(df)):
d = df.iloc[i]
all_data.append({
"id": i,
"content": d['Title'] + "\\n\\n" + d['Excerpt']
})
return all_data
# Only clustering 100 documents
docs = run_to_doc(df[:100])
print(docs[0]){'id': 0,
'content': 'Uefa Opens Proceedings against Barcelona, Juventus and Real Madrid Over European Super League Plan\\n\\nUefa has opened disciplinary proceedings against Barcelona, Juventus and Real Madrid over their involvement in the proposed European Super League.'}अंत में, हम एक Azure-आधारित OpenAI GPT-4o मॉडल को इनिशियलाइज़ करते हैं जो TNT-LLM के सभी घटकों में हमारे भाषा मॉडल (LLM) के रूप में कार्य करेगा। यद्यपि व्यवहार में प्रत्येक घटक के लिए अलग LLM इनिशियलाइज़ किए जा सकते हैं, यहाँ सरलता हेतु हम सभी कार्यों के लिए एक ही मॉडल का उपयोग करते हैं।
import os
from langchain_openai import AzureChatOpenAI
model = AzureChatOpenAI(
openai_api_version="2023-06-01-preview"
azure_deployment="gpt-4o-2024-05-13",
temperature=0.0
)चरण 1: दस्तावेज़ों का सार-संक्षेप
डेटासेट लोड होने के बाद, प्रत्येक दस्तावेज़ का सार-संक्षेप किया जाता है। इस चरण में भाषा मॉडल का उपयोग कर संक्षिप्त सारांश बनाए जाते हैं जो प्रत्येक दस्तावेज़ के मुख्य बिंदुओं को समेटें। ये सारांश लंबे पाठ को आवश्यक जानकारी बनाए रखते हुए छोटे, अधिक प्रबंधनीय रूप में ढालते हैं।
दिया गया कोड दस्तावेज़ों को संक्षेपित करने के लिए TNT-LLM हेतु एक LLM प्रॉम्प्ट इनिशियलाइज़ करता है, XML आउटपुट को पार्स कर सारांश और व्याख्याएँ निकालता है। यह एक पाइपलाइन सेट करता है जो दस्तावेज़ सामग्री को मैप करता है, सार-संक्षेपण के लिए बैचों में प्रोसेस करता है, और इन सारांशों को मैपिंग तथा रिडक्शन स्टेप्स के माध्यम से मूल दस्तावेज़ डेटा संरचना में वापस एकीकृत करता है।
import re
import random
from langchain import hub
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnableConfig, RunnableLambda, RunnablePassthrough
summary_prompt = hub.pull("wfh/tnt-llm-summary-generation").partial(
summary_length=20, explanation_length=30
)
def parse_summary(xml_string: str) -> dict:
summary_pattern = r"<summary>(.*?)</summary>"
explanation_pattern = r"<explanation>(.*?)</explanation>"
summary_match = re.search(summary_pattern, xml_string, re.DOTALL)
explanation_match = re.search(explanation_pattern, xml_string, re.DOTALL)
summary = summary_match.group(1).strip() if summary_match else ""
explanation = explanation_match.group(1).strip() if explanation_match else ""
return {"summary": summary, "explanation": explanation}
summary_llm_chain = (
summary_prompt | model | StrOutputParser()
).with_config(run_name="GenerateSummary")
summary_chain = summary_llm_chain | parse_summary
# Input: state
# Output: state and summaries
# Processes docs in parallel
def get_content(state: TaxonomyGenerationState):
docs = state["documents"]
return [{"content": doc["content"]} for doc in docs]
map_step = RunnablePassthrough.assign(
summaries=get_content
| RunnableLambda(func=summary_chain.batch, afunc=summary_chain.abatch)
)
def reduce_summaries(combined: dict) -> TaxonomyGenerationState:
summaries = combined["summaries"]
documents = combined["documents"]
return {
"documents": [
{
"id": doc["id"],
"content": doc["content"],
"summary": summ_info["summary"],
"explanation": summ_info["explanation"],
}
for doc, summ_info in zip(documents, summaries)
]
}
# This is the summary node
map_reduce_chain = map_step | reduce_summariesचरण 2: मिनीबैच बनाना
सार-संक्षेपण के बाद, अगला कदम संक्षेपित दस्तावेज़ों को मिनीबैच में व्यवस्थित करना है। मिनीबैचिंग बड़े डेटा वॉल्यूम को अधिक कुशलता से प्रोसेस करने में मदद करता है। डेटासेट को छोटे बैचों में विभाजित करके, TNT-LLM समानांतर में गणनाएँ कर सकता है, समय और संगणनात्मक संसाधनों दोनों का अनुकूलन करता है।
def get_minibatches(state: TaxonomyGenerationState, config: RunnableConfig):
batch_size = config["configurable"].get("batch_size", 200)
original = state["documents"]
indices = list(range(len(original)))
random.shuffle(indices)
if len(indices) < batch_size:
# Don't pad needlessly if we can't fill a single batch
return [indices]
num_full_batches = len(indices) // batch_size
batches = [
indices[i * batch_size : (i + 1) * batch_size] for i in range(num_full_batches)
]
leftovers = len(indices) % batch_size
if leftovers:
last_batch = indices[num_full_batches * batch_size :]
elements_to_add = batch_size - leftovers
last_batch += random.sample(indices, elements_to_add)
batches.append(last_batch)
return {
"minibatches": batches,
}चरण 3: प्रारंभिक टैक्सोनॉमी जनरेट करें
संक्षेपित दस्तावेज़ों के पहले मिनीबैच का उपयोग करके, TNT-LLM टैक्सोनॉमी जेनरेशन प्रक्रिया शुरू करता है। इस चरण में दस्तावेज़ों में पहचाने गए इंटेंट्स या विषयों का क्लस्टरिंग शामिल है। प्रत्येक दस्तावेज़ की सामग्री का विश्लेषण करके, सिस्टम सामान्य थीम्स या श्रेणियों की पहचान करता है, जो टैक्सोनॉमी की प्रारंभिक नींव रखती हैं।
दो मुख्य फ़ंक्शन हैं:
invoke_taxonomy_chain()- यह फ़ंक्शन TNT-LLM कार्यों के लिए कॉन्फ़िगर की गई LLM-आधारित चेन (chain) का उपयोग कर टैक्सोनॉमी जेनरेशन चरणों को एकीकृत करता है। यह दस्तावेज़ सारांशों और पिछली टैक्सोनॉमी क्लस्टरों से XML डेटा टेबल (data_table_xml) बनाता है। यह फ़ंक्शन निर्दिष्ट कॉन्फ़िगरेशन पैरामीटर (config) के आधार पर टैक्सोनॉमी को अपडेट करने के लिए LLM चेन को इनवोक करता है और नए टैक्सोनॉमी क्लस्टरों के साथ अपडेटेड स्टेट लौटाता है।generate_taxonomy()- यह फ़ंक्शन टैक्सोनॉमी क्लस्टर के जेनरेशन का समन्वयन करता है। यहinvoke_taxonomy_chainको टैक्सोनॉमी जेनरेशन के लिए कॉन्फ़िगर की गई चेन (generate_taxonomy_chain) के साथ और दस्तावेज़ों के प्रारंभिक मिनीबैच (state["minibatches"][0]) पर इनवोक करता है। यह प्रारंभिक जेनरेशन के बाद अपडेटेड टैक्सोनॉमी स्टेट लौटाता है।
from typing import Dict
from langchain_core.runnables import Runnable
def parse_taxa(output_text: str) -> Dict:
"""Extract the taxonomy from the generated output."""
cluster_pattern = r"<cluster>\\s*<id>(.*?)</id>\\s*<name>(.*?)</name>\\s*<description>(.*?)</description>\\s*</cluster>"
cluster_matches = re.findall(cluster_pattern, output_text, re.DOTALL)
clusters = [
{"id": id.strip(), "name": name.strip(), "description": description.strip()}
for id, name, description in cluster_matches
]
return {"clusters": clusters}
def format_docs(docs: List[Doc]) -> str:
xml_table = "\\n"
for doc in docs:
xml_table += f'{doc["summary"]}\\n'
xml_table += ""
return xml_table
def format_taxonomy(clusters):
xml = "\\n"
for label in clusters:
xml += " \\n"
xml += f' {label["id"]}\\n'
xml += f' {label["name"]}\\n'
xml += f' {label["description"]}\\n'
xml += " \\n"
xml += ""
return xml
def invoke_taxonomy_chain(
chain: Runnable,
state: TaxonomyGenerationState,
config: RunnableConfig,
mb_indices: List[int],
) -> TaxonomyGenerationState:
configurable = config["configurable"]
docs = state["documents"]
minibatch = [docs[idx] for idx in mb_indices]
data_table_xml = format_docs(minibatch)
previous_taxonomy = state["clusters"][-1] if state["clusters"] else []
cluster_table_xml = format_taxonomy(previous_taxonomy)
updated_taxonomy = chain.invoke(
{
"data_xml": data_table_xml,
"use_case": configurable["use_case"],
"cluster_table_xml": cluster_table_xml,
"suggestion_length": configurable.get("suggestion_length", 30),
"cluster_name_length": configurable.get("cluster_name_length", 10),
"cluster_description_length": configurable.get(
"cluster_description_length", 30
),
"explanation_length": configurable.get("explanation_length", 20),
"max_num_clusters": configurable.get("max_num_clusters", 25),
}
)
return {
"clusters": [updated_taxonomy["clusters"]],
}अब देखते हैं कि भाषा मॉडल को टैक्सोनॉमी जेनरेशन प्रक्रिया में कैसे एकीकृत किया जा सकता है:
# We will share an LLM for each step of the generate -> update -> review cycle
# You may want to consider using Opus or another more powerful model for this
taxonomy_generation_llm = model
## Initial generation
taxonomy_generation_prompt = hub.pull("wfh/tnt-llm-taxonomy-generation").partial(
use_case="Generate the taxonomy that can be used to label the user intent in the conversation.",
)
taxa_gen_llm_chain = (
taxonomy_generation_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="GenerateTaxonomy")
generate_taxonomy_chain = taxa_gen_llm_chain | parse_taxa
def generate_taxonomy(
state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
return invoke_taxonomy_chain(
generate_taxonomy_chain, state, config, state["minibatches"][0]
)चरण 4: टैक्सोनॉमी अपडेट करें
जैसे-जैसे बाद के मिनीबैच प्रोसेस होते हैं, TNT-LLM बारंबार टैक्सोनॉमी को अपडेट और परिष्कृत करता है। यह आवर्ती प्रक्रिया समय के साथ टैक्सोनॉमी को विकसित और बेहतर बनने देती है, और डेटा के अतिरिक्त बैचों में खोजे गए नए इनसाइट्स तथा श्रेणियों को शामिल करती है। अपडेट यह सुनिश्चित करते हैं कि टैक्सोनॉमी व्यापक बनी रहे और पूरे डेटासेट का प्रतिबिंब हो।
taxonomy_update_prompt = hub.pull("wfh/tnt-llm-taxonomy-update")
taxa_update_llm_chain = (
taxonomy_update_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="UpdateTaxonomy")
update_taxonomy_chain = taxa_update_llm_chain | parse_taxa
def update_taxonomy(
state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
which_mb = len(state["clusters"]) % len(state["minibatches"])
return invoke_taxonomy_chain(
update_taxonomy_chain, state, config, state["minibatches"][which_mb]
)चरण 5: टैक्सोनॉमी की समीक्षा
जब सभी मिनीबैच प्रोसेस हो जाएँ और टैक्सोनॉमी अपडेट हो जाए, तो अंतिम चरण में टैक्सोनॉमी की समीक्षा शामिल है। यह समीक्षा वर्गीकृत लेबलों की सटीकता और प्रासंगिकता की मान्यता के लिए महत्वपूर्ण है। यह सुनिश्चित करती है कि टैक्सोनॉमी डेटासेट को सार्थक तरीके से संगठित और वर्गीकृत करती है, और इंटेंट रिकग्निशन या टॉपिक क्लासिफिकेशन जैसे लक्षित उपयोग-प्रकरणों के अनुरूप है।
taxonomy_review_prompt = hub.pull("wfh/tnt-llm-taxonomy-review")
taxa_review_llm_chain = (
taxonomy_review_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="ReviewTaxonomy")
review_taxonomy_chain = taxa_review_llm_chain | parse_taxa
def review_taxonomy(
state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
batch_size = config["configurable"].get("batch_size", 200)
original = state["documents"]
indices = list(range(len(original)))
random.shuffle(indices)
return invoke_taxonomy_chain(
review_taxonomy_chain, state, config, indices[:batch_size]
)चरण 6: StateGraph के साथ TNT-LLM पाइपलाइन का समन्वयन
अब तक, पहले पाँच चरणों में दस्तावेज़ सार-संक्षेपण, मिनीबैच निर्माण, टैक्सोनॉमी जेनरेशन, अपडेटिंग और रिव्यू जैसी व्यक्तिगत घटकों की तैयारी शामिल थी। अब हम StateGraph फ़्रेमवर्क का उपयोग करके इन घटकों को एक संगठित TNT-LLM पाइपलाइन में एकीकृत करने के लिए तैयार हैं।
यह ग्राफ कार्यों के अनुक्रमिक निष्पादन का समन्वयन करता है: दस्तावेज़ों का सार-संक्षेप, मिनीबैच से टैक्सोनॉमी जेनरेशन, टैक्सोनॉमी का आवर्ती अपडेट, और अंत में टैक्सोनॉमी की समीक्षा और मान्यकरण। कंडीशनल एज यह सुनिश्चित करते हैं कि सभी मिनीबैच प्रोसेस होने तक टैक्सोनॉमी अपडेट होती रहे; इसके बाद अंतिम टैक्सोनॉमी की समीक्षा कर उसे लेबलिंग कार्यों में उपयोग के लिए अंतिम रूप दिया जाए।
from langgraph.graph import StateGraph
graph = StateGraph(TaxonomyGenerationState)
graph.add_node("summarize", map_reduce_chain)
graph.add_node("get_minibatches", get_minibatches)
graph.add_node("generate_taxonomy", generate_taxonomy)
graph.add_node("update_taxonomy", update_taxonomy)
graph.add_node("review_taxonomy", review_taxonomy)
graph.add_edge("summarize", "get_minibatches")
graph.add_edge("get_minibatches", "generate_taxonomy")
graph.add_edge("generate_taxonomy", "update_taxonomy")
def should_review(state: TaxonomyGenerationState) -> str:
num_minibatches = len(state["minibatches"])
num_revisions = len(state["clusters"])
if num_revisions < num_minibatches:
return "update_taxonomy"
return "review_taxonomy"
graph.add_conditional_edges(
"update_taxonomy",
should_review,
# Optional (but required for the diagram to be drawn correctly below)
{"update_taxonomy": "update_taxonomy", "review_taxonomy": "review_taxonomy"},
)
graph.set_finish_point("review_taxonomy")
graph.set_entry_point("summarize")
app = graph.compile()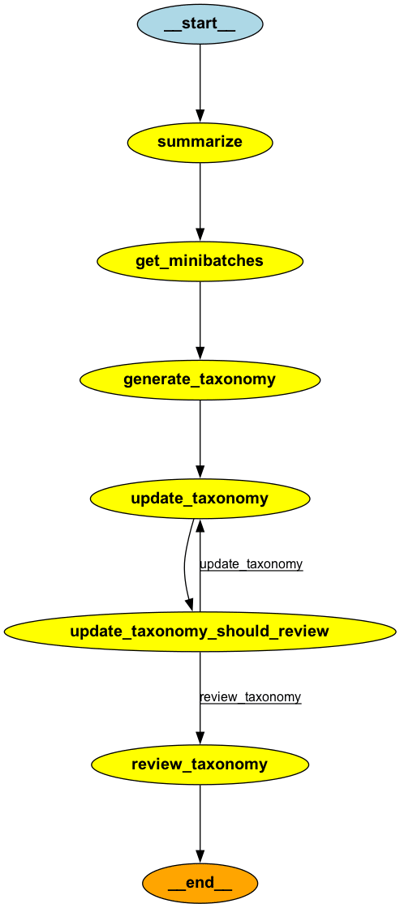
चरण 7: TNT-LLM की समाचार लेख टैक्सोनॉमी का क्लस्टरिंग और प्रदर्शन
इस अंतिम चरण में, हम TNT-LLM का उपयोग कर समाचार लेखों को क्लस्टर करते हैं। परिणामस्वरूप टैक्सोनॉमी Markdown प्रारूप में प्रदर्शित की जाती है, जिसमें प्रत्येक क्लस्टर के नाम और विवरण दिखाए जाते हैं।
use_case = (
"Generate the taxonomy that can be used to label the news article that would benefit the user."
)
stream = app.stream(
{"documents": docs},
{
"configurable": {
"use_case": use_case,
# Optional:
"batch_size": 10,
"suggestion_length": 30,
"cluster_name_length": 10,
"cluster_description_length": 30,
"explanation_length": 20,
"max_num_clusters": 25,
},
"max_concurrency": 2,
"recursion_limit": 50,
},
)
for step in stream:
node, state = next(iter(step.items()))
print(node, str(state)[:20] + " ...")
from IPython.display import Markdown
def format_taxonomy_md(clusters):
md = "## Final Taxonomy\\n\\n"
md += "| ID | Name | Description |\\n"
md += "|----|------|-------------|\\n"
# Iterate over each inner list of dictionaries
for cluster_list in clusters:
for label in cluster_list:
id = label["id"]
name = label["name"].replace("|", "\\\\|") # Escape any pipe characters within the content
description = label["description"].replace("|", "\\\\|") # Escape any pipe characters
md += f"| {id} | {name} | {description} |\\n"
return md
markdown_table = format_taxonomy_md(step['review_taxonomy']['clusters'])
Markdown(markdown_table)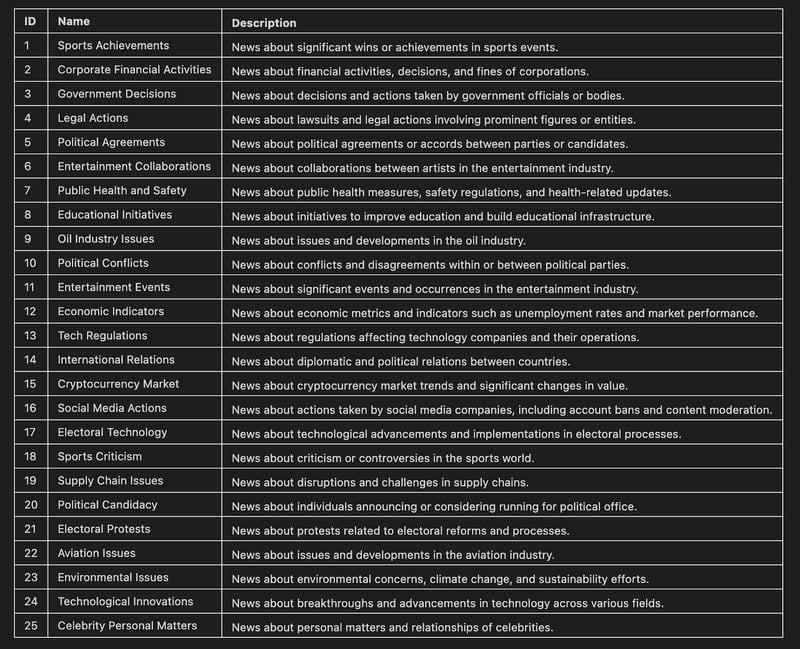
और बस! इन संरचित चरणों का पालन करके, TNT-LLM ने कच्चे पाठ्य डेटा से विस्तृत और व्याख्यायोग्य टैक्सोनॉमी का निर्माण स्वचालित कर दिया। यह तरीका उस कार्य को सरल बनाता है जिसके लिए परंपरागत रूप से महत्वपूर्ण मानवीय प्रयास और डोमेन विशेषज्ञता की आवश्यकता होती है, जिससे यह बड़े पैमाने पर टेक्स्ट माइनिंग और क्लासिफिकेशन कार्यों के लिए एक शक्तिशाली उपकरण बन जाता है।
निष्कर्ष
TNT-LLM टेक्स्ट माइनिंग और क्लासिफिकेशन में एक महत्वपूर्ण प्रगति का प्रतिनिधित्व करता है, जो असंरचित डेटा की बड़ी मात्रा का विश्लेषण करने के लिए एक कुशल समाधान प्रदान करता है। टैक्सोनॉमी जेनरेशन और स्केलेबल क्लासिफिकेशन को स्वचालित करके, यह टेक्स्ट से अंतर्दृष्टि उजागर करने में लगने वाले समय और प्रयास को कम करता है।
जैसे-जैसे TNT-LLM विकसित होता है, इसमें संगठनों के टेक्स्ट डेटा विश्लेषण के तरीके को बदलने की क्षमता है। यह उपकरण उद्योगों में डेटा-चालित निर्णय-निर्माण को सक्षम बनाता है, जिससे पाठ्य डेटा से मिलने वाली अंतर्दृष्टियाँ अधिक सुलभ और प्रभावशाली हो जाती हैं।
यदि आप LLM एप्लिकेशन विकसित करना सीखना चाहते हैं, तो मैं इस कोर्स की सलाह देता हूँ: Developing LLM Applications with LangChain।

रायन एक लीड डेटा साइंटिस्ट हैं जो LLMs का उपयोग करके एआई अनुप्रयोग बनाने में विशेषज्ञता रखते/रखती हैं। वे इम्पीरियल कॉलेज लंदन में नैचुरल लैंग्वेज प्रोसेसिंग और नॉलेज ग्राफ्स में पीएचडी उम्मीदवार हैं, जहाँ से उन्होंने कंप्यूटर साइंस में अपना मास्टर’स भी पूरा किया है। डेटा साइंस के अलावा, वे साप्ताहिक Substack न्यूज़लेटर The Limitless Playbook लिखते हैं, जिसमें वे दुनिया के अग्रणी विचारकों से एक क्रियान्वयन योग्य विचार साझा करते हैं और समय-समय पर मूलभूत एआई अवधारणाओं पर भी लिखते हैं।
Microsoft ने TNT-LLM पेश किया, एक शक्तिशाली सिस्टम जो टैक्सोनॉमी जेनरेशन और टेक्स्ट क्लासिफिकेशन को स्वचालित करने के लिए बनाया गया है, जो दक्षता और सटीकता में पारंपरिक तरीकों से बेहतर प्रदर्शन करता है।
TNT-LLM बड़े भाषा मॉडल (LLMs) की क्षमता का उपयोग करता है ताकि न्यूनतम मानवीय हस्तक्षेप के साथ टैक्सोनॉमी और क्लासिफायर को स्वचालित रूप से और बड़े पैमाने पर बनाया जा सके। यह Bing Copilot जैसे अनुप्रयोगों के लिए विशेष रूप से उपयोगी है, जहाँ विविध और विकसित होते पाठ्य डोमेनों का प्रबंधन अहम होता है।
इस लेख में, मैं आपको GPT-4o और LangGraph का उपयोग करके TNT-LLM लागू करने और समाचार लेखों को प्रभावी ढंग से क्लस्टर करने के चरणों से परिचित कराऊँगा।
यदि आप GPT-4o या LangGraph के बारे में और पढ़ना चाहते हैं, तो मैं ये लेख सुझाता हूँ:
यदि आप TNT-LLM के बारे में और सीखना चाहते हैं, तो मैं मूल शोधपत्र की सलाह देता हूँ TnT-LLM: Text Mining at Scale with Large Language Models।